
Muse Spark Open é o primeiro modelo de pesos abertos da família Muse da Meta: 816 bilhões de parâmetros, 42 bilhões ativos, uma janela de contexto de um milhão de tokens e entrada nativa de texto, imagem, áudio e vídeo. A Meta o publicou em 15 de outubro de 2026 com os pesos no Hugging Face e APIs em sete plataformas, chamando-o de "o modelo de pesos abertos dos EUA mais capaz até hoje". A primeira pergunta prática da maioria das pessoas não foi sobre benchmarks. Como escreveu um comentarista do Hacker News, a Meta sugere "um par de Mac Studio com chips M5 Ultra e 512GB de RAM. Um único Mac Studio M5 Ultra com metade dessa RAM (256GB) custa cerca de 11 mil dólares, e a opção de 512GB nem está disponível ainda. Então... é." (discussão no HN)
Este artigo faz a matemática do hardware, lê a Muse Model License linha por linha, verifica o preço de lançamento da API e os benchmarks independentes, e compara o modelo com GLM 5.3 e Kimi K3 na mesma régua. Mais adiante, veremos a terceira rota: usar um modelo assim por meio de um produto em vez de uma sala de servidores.
Pontos-chave
Muse Spark Open é a versão de pesos abertos do Muse Spark da Meta: MoE esparso de 816B no total / 42B ativos, contexto de 1.048.576 tokens, entrada multimodal e saída em texto, voltado a codificação e trabalho agêntico.
O número que importa: cada token toca 42 bilhões de parâmetros, mas servir carrega os 816 bilhões completos — cerca de 1,65TB em BF16 ou 537GB em NVFP4, mais o cache.
"Local" significa dois Mac Studio M5 Ultra de 512GB rodando MLX, ou um nó Blackwell com 4 GPUs para o NVFP4. Desktops comuns estão fora; um único Mac Studio de 256GB custa cerca de 11 mil dólares.
A Muse Model License permite uso comercial mas não é open source: o aviso "Built with Muse Spark Open" é obrigatório, e ofertas de modelo como serviço acima de 20 milhões de dólares em 12 meses exigem acordo separado com a Meta.
Leitura independente (Artificial Analysis, 19 de outubro de 2026): Intelligence Index 39, 142 tokens de saída por segundo, cerca de 0,84 dólar por tarefa do Index — rápido e bastante conciso, mas caro perto de modelos de pesos abertos de tamanho similar, e atrás de GLM 5.3 (45) e Kimi K3 (44).
O preço de lançamento nos provedores gira em torno de 1,25/M de entrada, 4,25/M de saída e cerca de 0,15/M em leituras de cache, incluindo Together AI, Fireworks, Baseten, Modal e OpenRouter.
Muse Spark Open de relance
| Item | Detalhe | Fonte |
|---|---|---|
| Lançamento | 15 de outubro de 2026, Meta Superintelligence Labs | Blog de pesquisa da Meta |
| Parâmetros | 816B no total, 42B ativos por token; MoE esparso com 256 especialistas e 8 selecionados por token (números da model card) | Documentação para desenvolvedores |
| Contexto | 1.048.576 tokens | Documentação da Meta |
| Entrada / saída | Texto, imagem, áudio e vídeo na entrada; texto na saída | Documentação da Meta |
| Checkpoints | BF16 ≈ 1,65TB (8 GPUs, ex.: 8×B300); NVFP4 ≈ 537GB (um nó Blackwell com 4 GPUs) | Documentação da Meta |
| Execução local | Dois Mac Studio M5 Ultra (512GB de memória unificada cada) com MLX; cerca de 2TB de VRAM para BF16 com cache KV | Blog de pesquisa e documentação da Meta |
| API hospedada | Baseten, Fireworks AI, Groq, Modal, Nebius, OpenRouter, Together AI | Blog da Meta |
| Canais de pesos | Hugging Face, Amazon SageMaker AI, Google Cloud Model Garden, Microsoft Foundry Models | Blog da Meta |
| Licença | Muse Model License (personalizada, comercial com condições) + Acceptable Use Policy | Documentação da Meta |
| Posicionamento | Codificação, tarefas agênticas de longo horizonte, raciocínio multi-etapa | Blog da Meta |
O número-chave: 42B ativos, 816B na fatura
Todas as manchetes abrem com 816 bilhões de parâmetros. O número que decide se você pode usar é o outro: 42 bilhões ativos. Muse Spark Open é um modelo esparso de mistura de especialistas — cada token é roteado para 8 dos 256 especialistas por camada — então a computação por token acompanha os 42B ativos. É por isso que a latência e o custo por tarefa parecem bons.
Mas a esparsidade não reduz o modelo que você precisa hospedar. A própria documentação da Meta diz sem rodeios: servir "ainda carrega os 816B completos na VRAM, o que define a pegada de hardware". O checkpoint BF16 tem cerca de 1,65TB de pesos e, somando o cache KV, ativações e sobrecarga de execução, a Meta recomenda planejar cerca de 2TB de VRAM — oito GPUs de datacenter como as B300. O checkpoint NVFP4, que guarda a maioria dos pesos em 4 bits, cai para cerca de 537GB e cabe em um único nó Blackwell com 4 GPUs.
A história do desktop é a peça central do lançamento. A memória unificada da Apple permite que um Mac Studio M5 Ultra enderece até 512GB, e duas máquinas encadeadas por Thunderbolt se comportam, nas palavras da Meta, "como um supercomputador com um terabyte de memória unificada", com 1,2TB/s de largura de banda para alimentar a pequena fatia ativa de cada token. A Meta demonstrou fluxos agênticos inteiramente no dispositivo — enviando mudanças reais para o cliente de Mastodon open source Ice Cubes e dirigindo o DaVinci Resolve quadro a quadro.
Duas ressalvas mantêm isso honesto. Primeiro, o hardware ainda não está totalmente à venda: em 19 de outubro de 2026, o Mac Studio M5 Ultra de 512GB não estava no mercado e seu preço não havia sido anunciado; um comentarista do HN estimou uma unidade de 256GB em cerca de 11 mil dólares, e a TechRepublic avaliou um conjunto de quatro máquinas de 256GB acima de 38 mil dólares. Segundo, um comentarista resumindo o post da Apple Research sobre MLX reportou um cluster de quatro Mac Studios gerando "mais de 36 tokens por segundo" — utilizável para trabalho agêntico, longe da velocidade de datacenter. (HN: custo do hardware, HN: vazão do MLX)
O veredito da comunidade sobre execuções locais foi direto: "Eu estava enganado ao pensar que modelos abertos podem ser quantizados para rodar em hardware de consumo médio; acho que eles já superaram esse conceito." (HN) Se sua máquina tem 32 ou 64GB de RAM, este modelo não está a um download de distância. As APIs hospedadas são a porta realista.
O que é, o que não é
A nomenclatura Muse é genuinamente confusa, e a comunidade disse isso no primeiro dia: "A nomenclatura é um pouco confusa, mas há duas coisas chamadas Muse... Existem os modelos, como Muse Spark, Muse Wonder e este Muse Open. E então há o 'Muse' em si, que é um 'agente pessoal' baseado na nuvem." (HN)
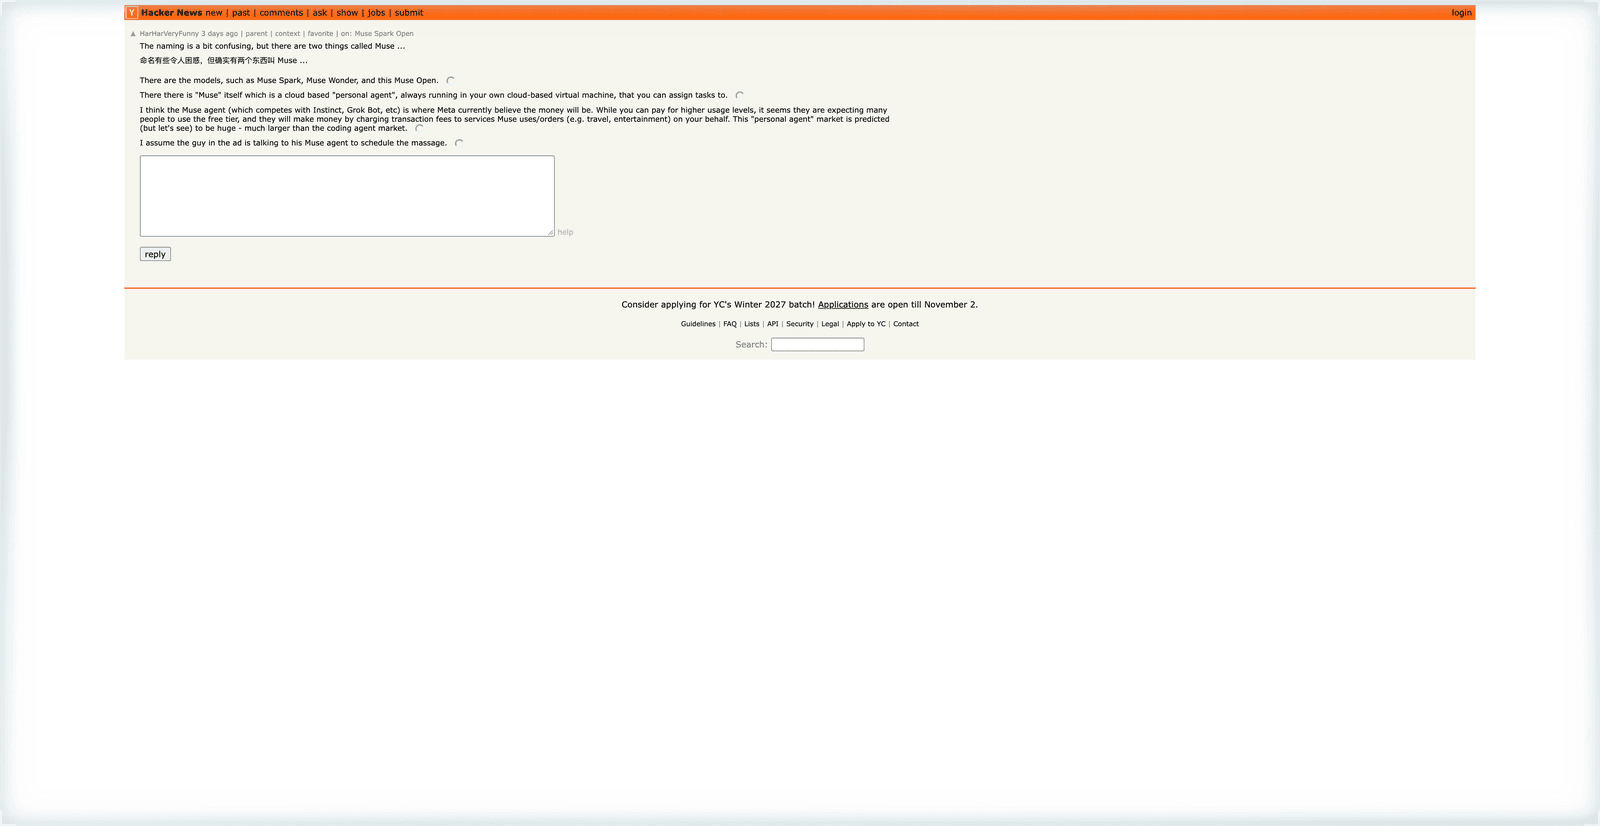
A versão limpa:
Muse Spark é a linha de modelos hospedada que estreou em 8 de abril de 2026 — a primeira família de modelos proprietários da Meta após a era Llama. As versões 1.1 (julho), 1.2 e 1.3 (setembro) permaneceram fechadas e são servidas pela API da Meta e pelo Muse Code a 1,25/M de entrada e 4,25/M de saída.
Muse Wonder, lançado em 12 de outubro de 2026, é o carro-chefe fechado acima do Spark, listado a 4/M de entrada e 20/M de saída. A própria Meta não afirma que o Spark Open supera o Wonder.
Muse Spark Open é o tema deste artigo: o irmão transferível da linha Spark, com o mesmo contexto de 1M e a mesma entrada multimodal, sob licença personalizada.
O app Muse é um produto de agente de consumo, sem relação com os pesos.
Benchmarks: rápido, conciso e caro para pesos abertos
A página independente da Artificial Analysis para Muse Spark Open (ajuste de raciocínio xhigh), verificada em 19 de outubro de 2026:
| Métrica | Muse Spark Open | Leitura |
|---|---|---|
| Intelligence Index | 39 (~posição 10 de 120 na sua classe de pesos abertos; mediana da classe 19) | Acima da mediana, atrás dos líderes chineses |
| Velocidade de saída | 142,2 tokens/s (mediana entre provedores) | Notavelmente rápido para a classe (mediana ~78) |
| Tempo até o primeiro token | 0,81 s | Competitivo |
| Preço de lista | 1,25/M entrada, 4,25/M saída, desconto de cache 88% | "Na faixa alta" para pesos abertos |
| Custo por tarefa do Index | ~0,84 dólar | Forte, graças à saída concisa |
| Verbosiade | 110M de tokens de saída em todo o Index | Bastante conciso (mediana da classe ~130M) |
O resumo da AA merece citação: "entre os líderes em inteligência, mas particularmente caro comparado a outros modelos de pesos abertos de tamanho similar. Também é notavelmente rápido e bastante conciso." Duas notas de calibração. Primeiro, o Index (v4.3.2) mistura dez avaliações incluindo conjuntos agênticos e de contexto longo; 39 não é nota de prova única. Segundo, os preços são medianas de provedores, não preço oficial da Meta — a API própria da Meta não hospeda a variante de pesos abertos. Se você está escolhendo um modelo para fluxos agênticos de navegação e codificação, una este número ao nosso guia de navegação agêntica em vez de um único número de ranking.
A licença não é open source
"Pesos abertos" está trabalhando pesado nas manchetes. Você pode baixar Muse Spark Open, fazer fine-tuning, destilar e embuti-lo em produtos comerciais. Mas a Muse Model License é uma licença personalizada, não aprovada pela OSI, e suas condições são mais estritas que Apache 2.0 ou MIT:
Atribuição, sempre. Todo produto que usa o modelo ou um derivado deve exibir "Built with Muse Spark Open" na interface, documentação, site ou configurações. Essa cláusula não tem piso de receita.
Porta de modelo como serviço. Se você e suas afiliadas ultrapassarem 20 milhões de dólares de receita bruta agregada em qualquer período de 12 meses consecutivos e oferecerem o modelo a terceiros via API, devem notificar a Meta com antecedência e assinar um acordo escrito separado. Uso interno, pesquisa e recursos dentro do seu próprio produto ficam expressamente fora.
Política de Uso Aceitável. A licença inclui uma AUP que proíbe desenvolvimento de armas, malware, operação de infraestrutura crítica, fraude, desinformação e falsificação de identidade; o modelo não é destinado a menores de 18 anos.
Saídas. A Meta não reivindica direitos sobre o que o modelo gera — a cláusula mais limpa de todas.
Fricção de download. Baixar os pesos do Hugging Face exige aceitar campos de identidade — nome legal, data de nascimento, dados da empresa — uma barreira de registro, não um clique.
Se você quer um modelo de pesos abertos genuinamente permissivo nesta classe, a licença estilo MIT do GLM 5.3 é o ponto de comparação; cobrimos isso na seção comparativa.
Como obtê-lo
API hospedada (sem hardware): Baseten, Fireworks AI, Groq, Modal, Nebius e Together AI o servem diretamente; o OpenRouter o lista como rota de gateway. O preço de lançamento nos provedores gira em torno de 1,25/M de entrada, 4,25/M de saída e cerca de 0,15/M em leituras de cache — o mesmo valor do Muse Spark 1.2 hospedado, o que sugere que a Meta fixou a âncora e os provedores acompanharam.
Auto-hospedagem em GPU: baixe o BF16 (~1,65TB) para nós de oito GPUs, ou o NVFP4 (~537GB) para um nó Blackwell com 4 GPUs. A Meta fornece kernels Helion autoajustáveis no SGLang reportando acelerações de 1,03–3,95× em nível de kernel em NVIDIA e AMD, mais 3% de ponta a ponta em AMD MI350. vLLM, TensorRT-LLM, llama.cpp e Unsloth têm suporte no dia um.
Auto-hospedagem em Mac: dois Mac Studio M5 Ultra de 512GB via MLX, com os pesos direto do Hugging Face. A Apple Research documentou separadamente um cluster de quatro Macs superando 36 tok/s.
Catálogos em nuvem: Amazon SageMaker AI, Google Cloud Model Garden e Microsoft Foundry Models carregam os pesos para equipes que querem infraestrutura gerenciada.
Essa amplitude de implantação é incomum para um lançamento de pesos abertos, e a comunidade percebeu: "Eles fizeram o trabalho real de testar e documentar implantações em várias plataformas. É um pouco como elevar o padrão dos pesos abertos em vez de jogar o binário e deixar a comunidade se virar." (HN)
Comparação com GLM 5.3 e Kimi K3
O enquadramento de "campeão americano de pesos abertos" só significa algo ao lado dos modelos abertos chineses que dominaram este ranking o ano todo. Números na mesma régua (dados da Artificial Analysis compilados em 16 de outubro de 2026; verifique antes de orçar):
| Dimensão | Muse Spark Open | GLM 5.3 | Kimi K3 |
|---|---|---|---|
| Fabricante | Meta (EUA) | Z.ai (China) | Moonshot AI (China) |
| Parâmetros | 816B no total / 42B ativos | 753B / 40B | 2,8T / 104B |
| Entrada | Texto, imagem, áudio, vídeo | Texto | Texto, imagem |
| Intelligence Index | 39 | 45 | 44 |
| Velocidade de saída | 142 tok/s | 67 tok/s | 43 tok/s |
| Custo por tarefa do Index | 0,84$ | 2,01$ | 2,00$ |
| Preço de API ($/M entrada/saída) | 1,25 / 4,25 | 1,40 / 4,40 | 3,00 / 15,00 |
| Licença | Muse Model License (aviso + porta MaaS de 20M$) | Estilo MIT (condições perto de 10B$) | Personalizada (porta MaaS similar de 20M$) |
| A principal pegadinha | Memória de classe terabyte para auto-hospedar; aviso obrigatório | Apenas entrada de texto | Preço de lista mais alto dos três |
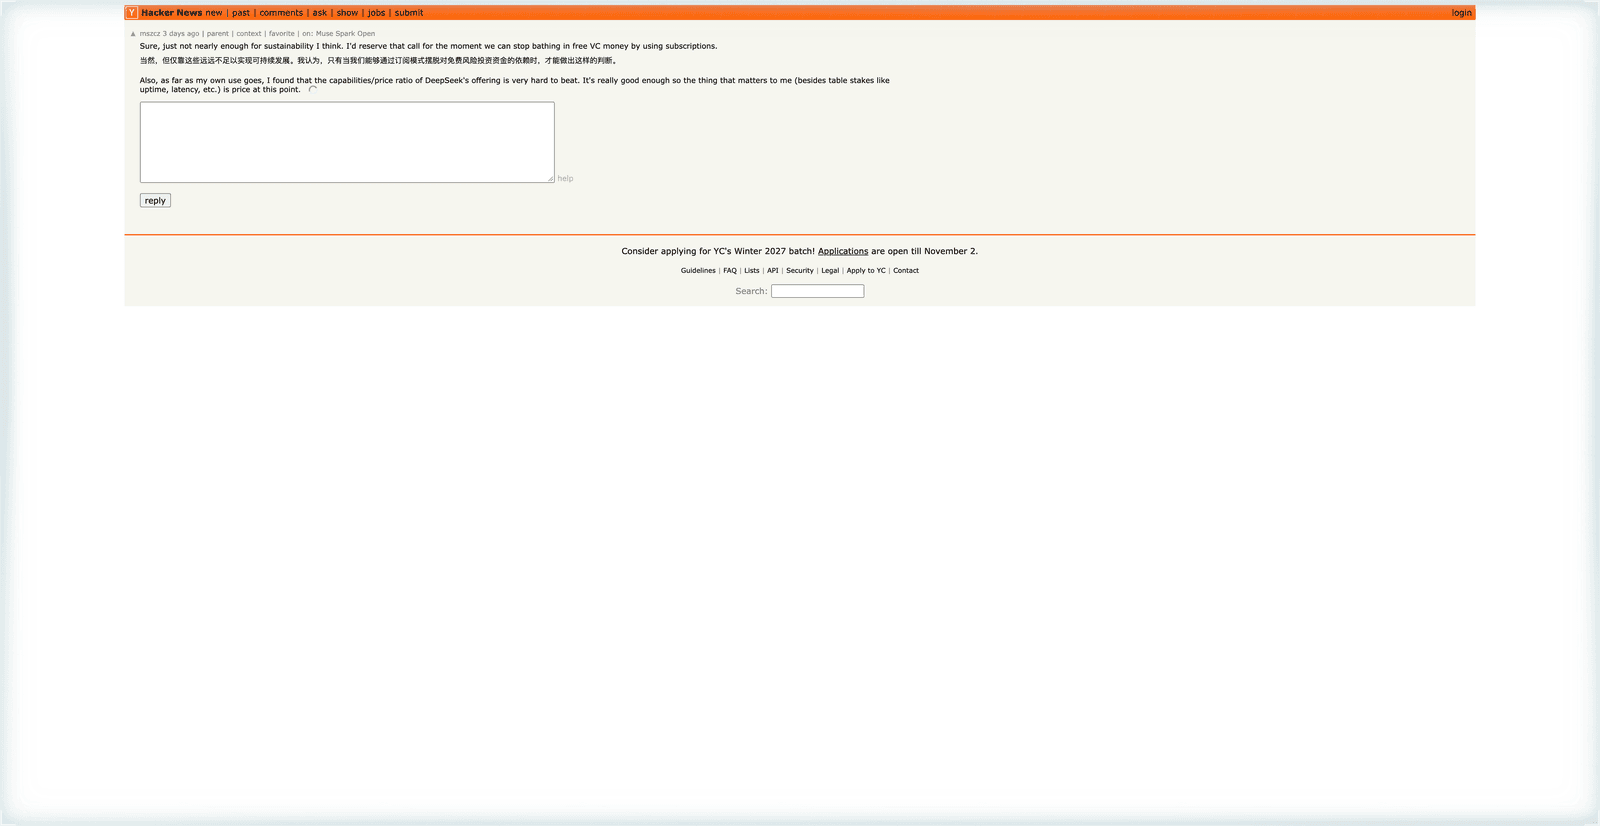
A troca é clara. Muse Spark Open fica atrás dos dois rivais no Intelligence Index, mas os esmaga em custo por tarefa concluída — escreve menos para chegar ao resultado — e é o único dos três com entrada nativa de áudio e vídeo. Um comentarista do HN formulou de forma que bate com os dados: "a relação capacidade/preço da oferta da DeepSeek é muito difícil de superar... o que importa para mim (além do básico como disponibilidade e latência) é o preço neste ponto." (HN)
Se o critério é a posição absoluta no Index, este não é o líder; se é o custo por tarefa aceita com entrada multimodal, ele compete.
Para contexto sobre como a escolha do modelo interage com a camada de ferramentas, veja nossas análises de Qwen3.8 Max, MiniMax M3 e LongCat 2.0 — cada uma apostou diferente na mesma corrida de pesos abertos.
O que as pessoas estão dizendo
O fio de lançamento no Hacker News (917 pontos, cerca de 478 comentários em 19 de outubro) mistura entusiasmo e ceticismo sobre hardware:
"Adoro ver os grandes laboratórios de IA lançando modelos de pesos abertos; espero ver mais disso da OpenAI e eventualmente da Anthropic." — shinokami (tradução livre)
"Eu estava enganado ao pensar que modelos abertos podem ser quantizados para rodar em hardware de consumo médio." — twitexplore (tradução livre)
"Alguém já testou uma versão menor/quantizada localmente em Apple Silicon? Adoraria saber sua experiência, e tok/s com quais especificações." — nico (tradução livre). Até o momento da escrita, o fio tem mais perguntas do que relatos locais de primeira mão — trate qualquer afirmação de desempenho sem detalhes de hardware como não verificada.
O r/LocalLLaMA no Reddit começou a preencher essa lacuna em poucos dias. Um usuário rodando o modelo em um único Mac Studio relatou atingir 18 t/s de decodificação: "This is text only. Output is coherent and toolcalls solid." (r/LocalLLaMA) Outro tópico transversal da mesma semana foi direto: "'Runs locally' now officially means 'runs on a computer that costs more than a car.'" (r/LocalLLaMA)
Uma terceira rota: usar por meio de um produto, não de uma sala de servidores
Esta é a decisão que a maioria dos leitores realmente enfrenta. Você não tem 22 mil a 40 mil dólares em Mac Studios sobre a mesa, e não quer operar oito GPUs de datacenter. Mas seu trabalho — pesquisa, código, tarefas de navegador — poderia usar um modelo aberto de classe fronteira com 1M de contexto. É essa lacuna que as APIs hospedadas e os clientes nativos de IA preenchem.
É aqui que um navegador como Tabbit Browser se encaixa. O padrão prático para um modelo como Muse Spark Open não é auto-hospedagem; é escolhê-lo (ou um modelo agêntico comparável) em um cliente que já detém seu contexto — a página à sua frente, um grupo de abas, um arquivo — e colocá-lo para trabalhar por meio da navegação agêntica ou da automação de navegador em vez de reconstruir cada tarefa em um chat separado.
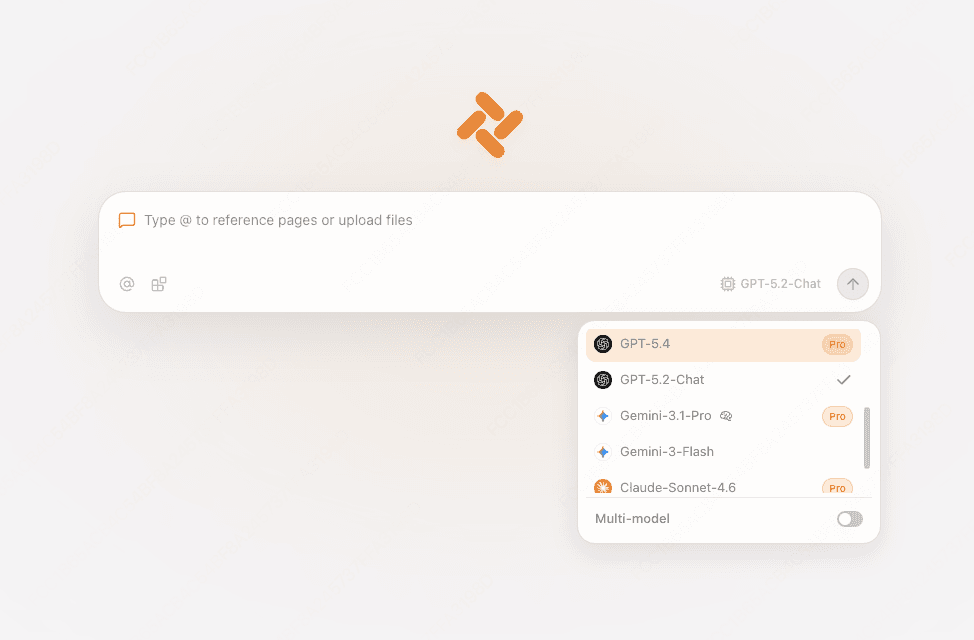
Dois limites honestos. Primeiro, não confirmamos Muse Spark Open no seletor de modelos ao vivo do Tabbit; o modelo tem três dias, a disponibilidade muda rápido, então verifique o seletor antes de planejar em torno dele. Se quiser um modelo já comprovado neste fluxo, a rota com GLM-5.2 e a história multimodal do GLM-5.3-Flash são exemplos funcionais do mesmo padrão. Segundo, a auto-hospedagem ainda vence em controle de dados e custo unitário em escala — a terceira rota troca isso por hardware zero e operação zero. Para um panorama de clientes, veja nossa comparação de navegadores de IA.
 Tabbit Browser
Veredicto
Muse Spark Open é um lançamento de pesos abertos crível e bem engenheirado cujo título esconde uma decisão binária. Se você pode pagar o terabyte, obtém um modelo agêntico rápido, conciso e multimodal com execuções documentadas em MLX, SGLang e vLLM, sob uma licença comercialmente amigável para todos exceto grandes revendedores de MaaS. Se não pode — e quase nenhum indivíduo pode ainda — a resposta honesta é a rota hospedada de 1,25/4,25 dólares, onde ele compete com GLM 5.3 e Kimi K3 em custo por tarefa, não em posição absoluta no Index.
| Sua situação | Primeiro passo |
|---|---|
| Desenvolvedor individual, sem hardware grande | Experimente a API hospedada a 1,25/4,25 em uma tarefa fixa de código ou pesquisa; compare a saída aceita com GLM 5.3 antes de migrar |
| Equipe que precisa de controle de dados | Precifique um nó NVFP4 Blackwell com 4 GPUs ou um par de Mac Studio contra um ano de gasto de API no seu volume real |
| Construtor de produtos | Lance com o aviso "Built with Muse Spark Open" planejado desde o primeiro dia; se vai cruzar a linha MaaS de 20M$, fale com a Meta cedo |
| Usuário de fluxos de navegador/agentes | Use-o (ou um modelo comparável) por meio de um cliente que já detém seu contexto de página — veja a terceira rota acima |
| Caçador de benchmarks | Espere replicação independente mais ampla; um instantâneo da AA e um fio de HN de semana de lançamento não são consenso |
Um número para lembrar: 42 bilhões de parâmetros ativos é por que este modelo parece rápido e acessível por tarefa. 816 bilhões no total é por que ele não cabe na sua mesa.
Fontes
Blog de pesquisa da Meta: Introducing Muse Spark Open (15-10-2026)
Documentação da Meta: Muse Spark Open (verificado em 19-10-2026)
Artificial Analysis: Muse Spark Open (Xhigh) (verificado em 19-10-2026)
Fio de lançamento no Hacker News e páginas de comentários vinculadas (verificado em 19-10-2026)
TechRepublic: Meta unveils Muse Spark Open (16-10-2026)
TrendingTopics: Meta's Muse Spark Open comes with strings attached (16-10-2026)
Flavio Copes: what you can run, and what it takes (16-10-2026)
Comparação Muse Spark Open vs GLM 5.3 vs Kimi K3 (16-10-2026, compilação de dados da AA)

Perguntas frequentes
O que é Muse Spark Open?
Muse Spark Open é a versão de pesos abertos do Muse Spark da Meta, lançada em 15 de outubro de 2026 pela Meta Superintelligence Labs. É um modelo esparso de mistura de especialistas com 816B de parâmetros no total e 42B ativos por token, uma janela de contexto de 1.048.576 tokens e entrada nativa de texto, imagem, áudio e vídeo com saída em texto. A Meta o posiciona para codificação e trabalho agêntico e o chama de modelo de pesos abertos dos EUA mais capaz até hoje.
Muse Spark Open é open source?
Não. Os pesos são transferíveis, mas são publicados sob a Muse Model License da Meta, uma licença personalizada não aprovada pela OSI. O uso comercial, o fine-tuning e a redistribuição são permitidos, mas o produto deve exibir o aviso 'Built with Muse Spark Open', e quem oferecer o modelo como serviço com mais de 20 milhões de dólares de receita em 12 meses consecutivos deve notificar a Meta e assinar um acordo separado.
Que hardware eu preciso para rodar Muse Spark Open localmente?
O modelo completo exige cerca de um terabyte de memória. A Meta e a Apple o otimizaram para dois Mac Studio M5 Ultra com 512GB de memória unificada cada rodando MLX; o checkpoint BF16 pesa cerca de 1,65TB e é servido em oito GPUs de datacenter, enquanto o NVFP4 de 537GB cabe em um único nó Blackwell com 4 GPUs. Com o cache KV incluído, planeje cerca de 2TB de VRAM para o BF16.
Quanto custa a API do Muse Spark Open?
O preço de lançamento em provedores como Together AI, Fireworks, Baseten, Modal e OpenRouter gira em torno de 1,25 dólar por milhão de tokens de entrada e 4,25 de saída, com cerca de 0,15 por milhão em leituras de cache. A Artificial Analysis mediu uma mediana de 142 tokens de saída por segundo e cerca de 0,84 dólar por tarefa do Intelligence Index em 19 de outubro de 2026.
Como Muse Spark Open se compara a GLM 5.3 e Kimi K3?
Segundo a Artificial Analysis, Muse Spark Open pontua 39 no Intelligence Index contra 45 do GLM 5.3 e 44 do Kimi K3, mas gera mais rápido e completou o Index a cerca de 0,84 dólar por tarefa contra cerca de 2,00 de ambos os rivais. Suas concessões são uma licença mais estrita com aviso obrigatório, download com registro e a maior pegada de memória para auto-hospedagem dos três.
Muse Spark Open é a mesma coisa que Muse Wonder ou o app Muse?
Não. Muse Wonder é o modelo fechado mais capaz da Meta, lançado em 12 de outubro de 2026 e listado a 4 dólares de entrada e 20 de saída por milhão de tokens. O app Muse é um produto separado de agente pessoal na nuvem. Muse Spark Open é o irmão transferível da linha Muse Spark hospedada, que estreou em abril de 2026.