
如果需要下载模型权重,或能把 API 任务安排在非高峰时段,先用 DeepSeek V4.1 Flash 做基线。如果任务涉及视觉输入,或接近 LongCat 领先的编码评测,可以实测 LongCat 2.5。现有榜单不足以证明哪个模型在所有任务上更好。DeepSeek 当前 API 使用的是 1017 更新版,而 LongCat 对比表没有明确标出该版本。
版本区别影响实际判断。一位 Reddit 用户用较早的 LongCat 2.5 Preview 分析五个 C# 类时,报告出现重复循环。这只是一个复杂任务的预览版体验,不能代表正式版表现,但提醒我们在选型时记录完成率、重试和成本。Tabbit Browser 可以协助整理资料、比较回答;具体模型是否可用需查看当前选择器。
本文价格和产品信息核对于 2026 年 11 月 3 日,后续可能变化。
核心结论
LongCat 限时 API 价格等于 DeepSeek 高峰价;DeepSeek 非高峰 token 单价减半。
LongCat 公布的表中,DeepSeek 在 DeepSWE v1.1 和 Terminal Bench v2.1 领先,LongCat 在 Program Bench 和 Terminal Bench v4.0 领先;数据来源与设置未必一致。
两家都提供约 1M 上下文。LongCat 当前文档列出的最大输出参数为 256K,DeepSeek 列出 384K;输入与输出仍需共同放入总窗口。
DeepSeek 提供权重下载链接;LongCat 2.5 发布页的 GitHub 和 Hugging Face 标注敬请期待。
使用同一批真实任务、固定的模型版本、工具与停止规则,比较成功率和实际账单。
LongCat 2.5 与 DeepSeek V4.1 Flash 参数对比
| 决策维度 | LongCat 2.5 | DeepSeek V4.1 Flash |
|---|---|---|
| 提供方 | 美团 LongCat | DeepSeek |
| 架构 | 总参数 1.6T,每 token 约激活 48B | 552B MoE 主体,输入激活 8B、输出激活 16B |
| 官方 API 上下文 | 1,048,576 token,包含输入与输出 | 1M token |
| 最大输出 | max_tokens 上限 262,144 | 384K |
| 视觉输入 | 文档支持图片和视频 | 支持视觉理解;所需输入类型须查对应 API |
| 权重 | 发布页标注 GitHub 和 Hugging Face 敬请期待 | 官方提供权重链接 |
| 官方 API 价格 | 限时 $0.30 / $0.006 / $1.20 | 高峰 $0.30 / $0.006 / $1.20;非高峰 $0.15 / $0.003 / $0.60 |
价格单位为美元/百万 token,依次为未缓存输入、缓存输入和输出。数据来自 LongCat 发布页、模型参数、LongCat 定价、DeepSeek 发布页和 DeepSeek 定价。部分第三方文章写 LongCat 最大输出为 128K,当前官方参数文档写 262,144;上线前应核对实际接口限制。
参数量描述的是架构,不等于质量或速度排名。模型路由和输入输出设计不同,不能仅凭 1.6T 与 552B 下结论。可先阅读 DeepSeek V4.1 Flash 介绍和 LongCat 2.0 指南。
API 成本:高峰同价,非高峰 DeepSeek 减半
DeepSeek 高峰时间为工作日 01:00–04:00、06:00–10:00 UTC,中国公共假期除外;其他时间为非高峰。LongCat 将当前价格标为限时优惠,未注明结束日期。这是直接使用官方 API 的价格,第三方平台可能不同。
假设一个任务使用 30 万未缓存输入、20 万缓存输入和 10 万输出 token:
LongCat 2.5 = 0.3 × $0.30 + 0.2 × $0.006 + 0.1 × $1.20 = $0.2112
DeepSeek 高峰 = $0.2112
DeepSeek 非高峰 = 0.3 × $0.15 + 0.2 × $0.003 + 0.1 × $0.60 = $0.1056这只比较相同 token 用量,不意味着两个模型消耗相同或成功率相同。1,000 个同类任务分别为 $211.20 和 $105.60,未计其他费用。DeepSeek 的 Search 和 Fetch 另行计费;重试、推理 token、缓存命中和渠道加价都会改变结果。旧版 DeepSeek V4 Flash 价格文章讨论的是另一代模型,实际决策请以当前官方价格为准。
编码基准:领先者随测试变化
下表来自 LongCat 发布页,是厂商公布的数据,并非 Tabbit 本次实测。
| 测试 | LongCat 2.5 | DeepSeek V4.1 Flash | 表中差距 |
|---|---|---|---|
| Terminal Bench v2.1 | 88.4 | 90.6 | DeepSeek 高 2.2 分 |
| Terminal Bench v4.0 | 38.5 | 31.2 | LongCat 高 7.3 分 |
| Program Bench | 25.5 | 20.3 | LongCat 高 5.2 分 |
| DeepSWE v1.1 | 64.6 | 74.2 | DeepSeek 高 9.6 分 |
| BrowseComp | 91.9 | 91.5 | LongCat 高 0.4 分 |
LongCat 说明,带星号的竞品分数来自公开报告、博客或官方榜单,不带星号的是 LongCat 自测;LongCat 自身结果开启 thinking,并列出部分测试的 harness。这不代表两列使用完全相同的环境、预算或模型快照。尤其是表中 DeepSeek 型号未标 1017,而 DeepSeek 当前 API 文档明确将 deepseek-flash 指向 V4.1-Flash-1017。
较大差距可以作为进一步测试的线索,不能保证在你的代码库中复现。BrowseComp 的 0.4 分差距缺少误差和同条件信息,不足以判定实际赢家。Agent 的效果还受工具、执行框架和错误恢复影响,可参考 Agent 推理与深度研究。
视觉、上下文与部署
LongCat 将 2.5 定位为原生多模态模型,并在视觉文档中列出输入能力。截图驱动的界面开发和视频分析可以作为试用场景。DeepSeek 也提供视觉能力,但不同供应商开放的格式、视频支持和限制可能不同,需要核对目标接口。
1M 上下文是容量上限,不保证模型能准确使用所有内容。长输入也可能增加延迟和成本。用自己的资料分别测试开头、中间和末尾的信息提取,并为输出留出空间。
如果必须自行部署,DeepSeek 提供 V4.1 Flash 权重。LongCat 2.5 发布页目前将仓库标为即将推出。部署前应核对许可证、硬件需求和推理框架;能下载权重不意味着普通个人电脑就能运行。
用户如何评价预览版
社区反馈适合用来设计测试,不能直接代表 11 月正式版。前述 C# 案例报告了复杂任务中的循环。另一位用户 测试 Terminal Bench 预览版时进行了三次运行,称 LongCat 2.5 Preview 在其对比中异常和超时较少;作者也说明一个任务受到本地设备故障影响,各模型测试日期不同。
还有用户在 JavaScript 向 Swift 的迁移任务中遇到循环,但表示中断提示后可以继续。实际试用时可以设置重试上限、记录重复工具调用,并检查生成代码是否通过测试。不要把预览版失败率直接套到正式版。
用 Tabbit Browser 整理对比证据
厂商文档与价格会变化。可以在 Tabbit Browser 中打开发布说明、定价页和自己的测试记录,使用 Chat with Page 提取版本与日期,再回到原文核对。Tabbit 使用指南介绍了页面上下文功能。
下图展示 Tabbit 并排比较其他模型的回答,不能证明 LongCat 2.5 或 DeepSeek V4.1 Flash 在所有账号中可用。请检查当前账号和地区的模型选择器;若没有所需模型,可通过各自 API 测试,再把结果整理到笔记中。
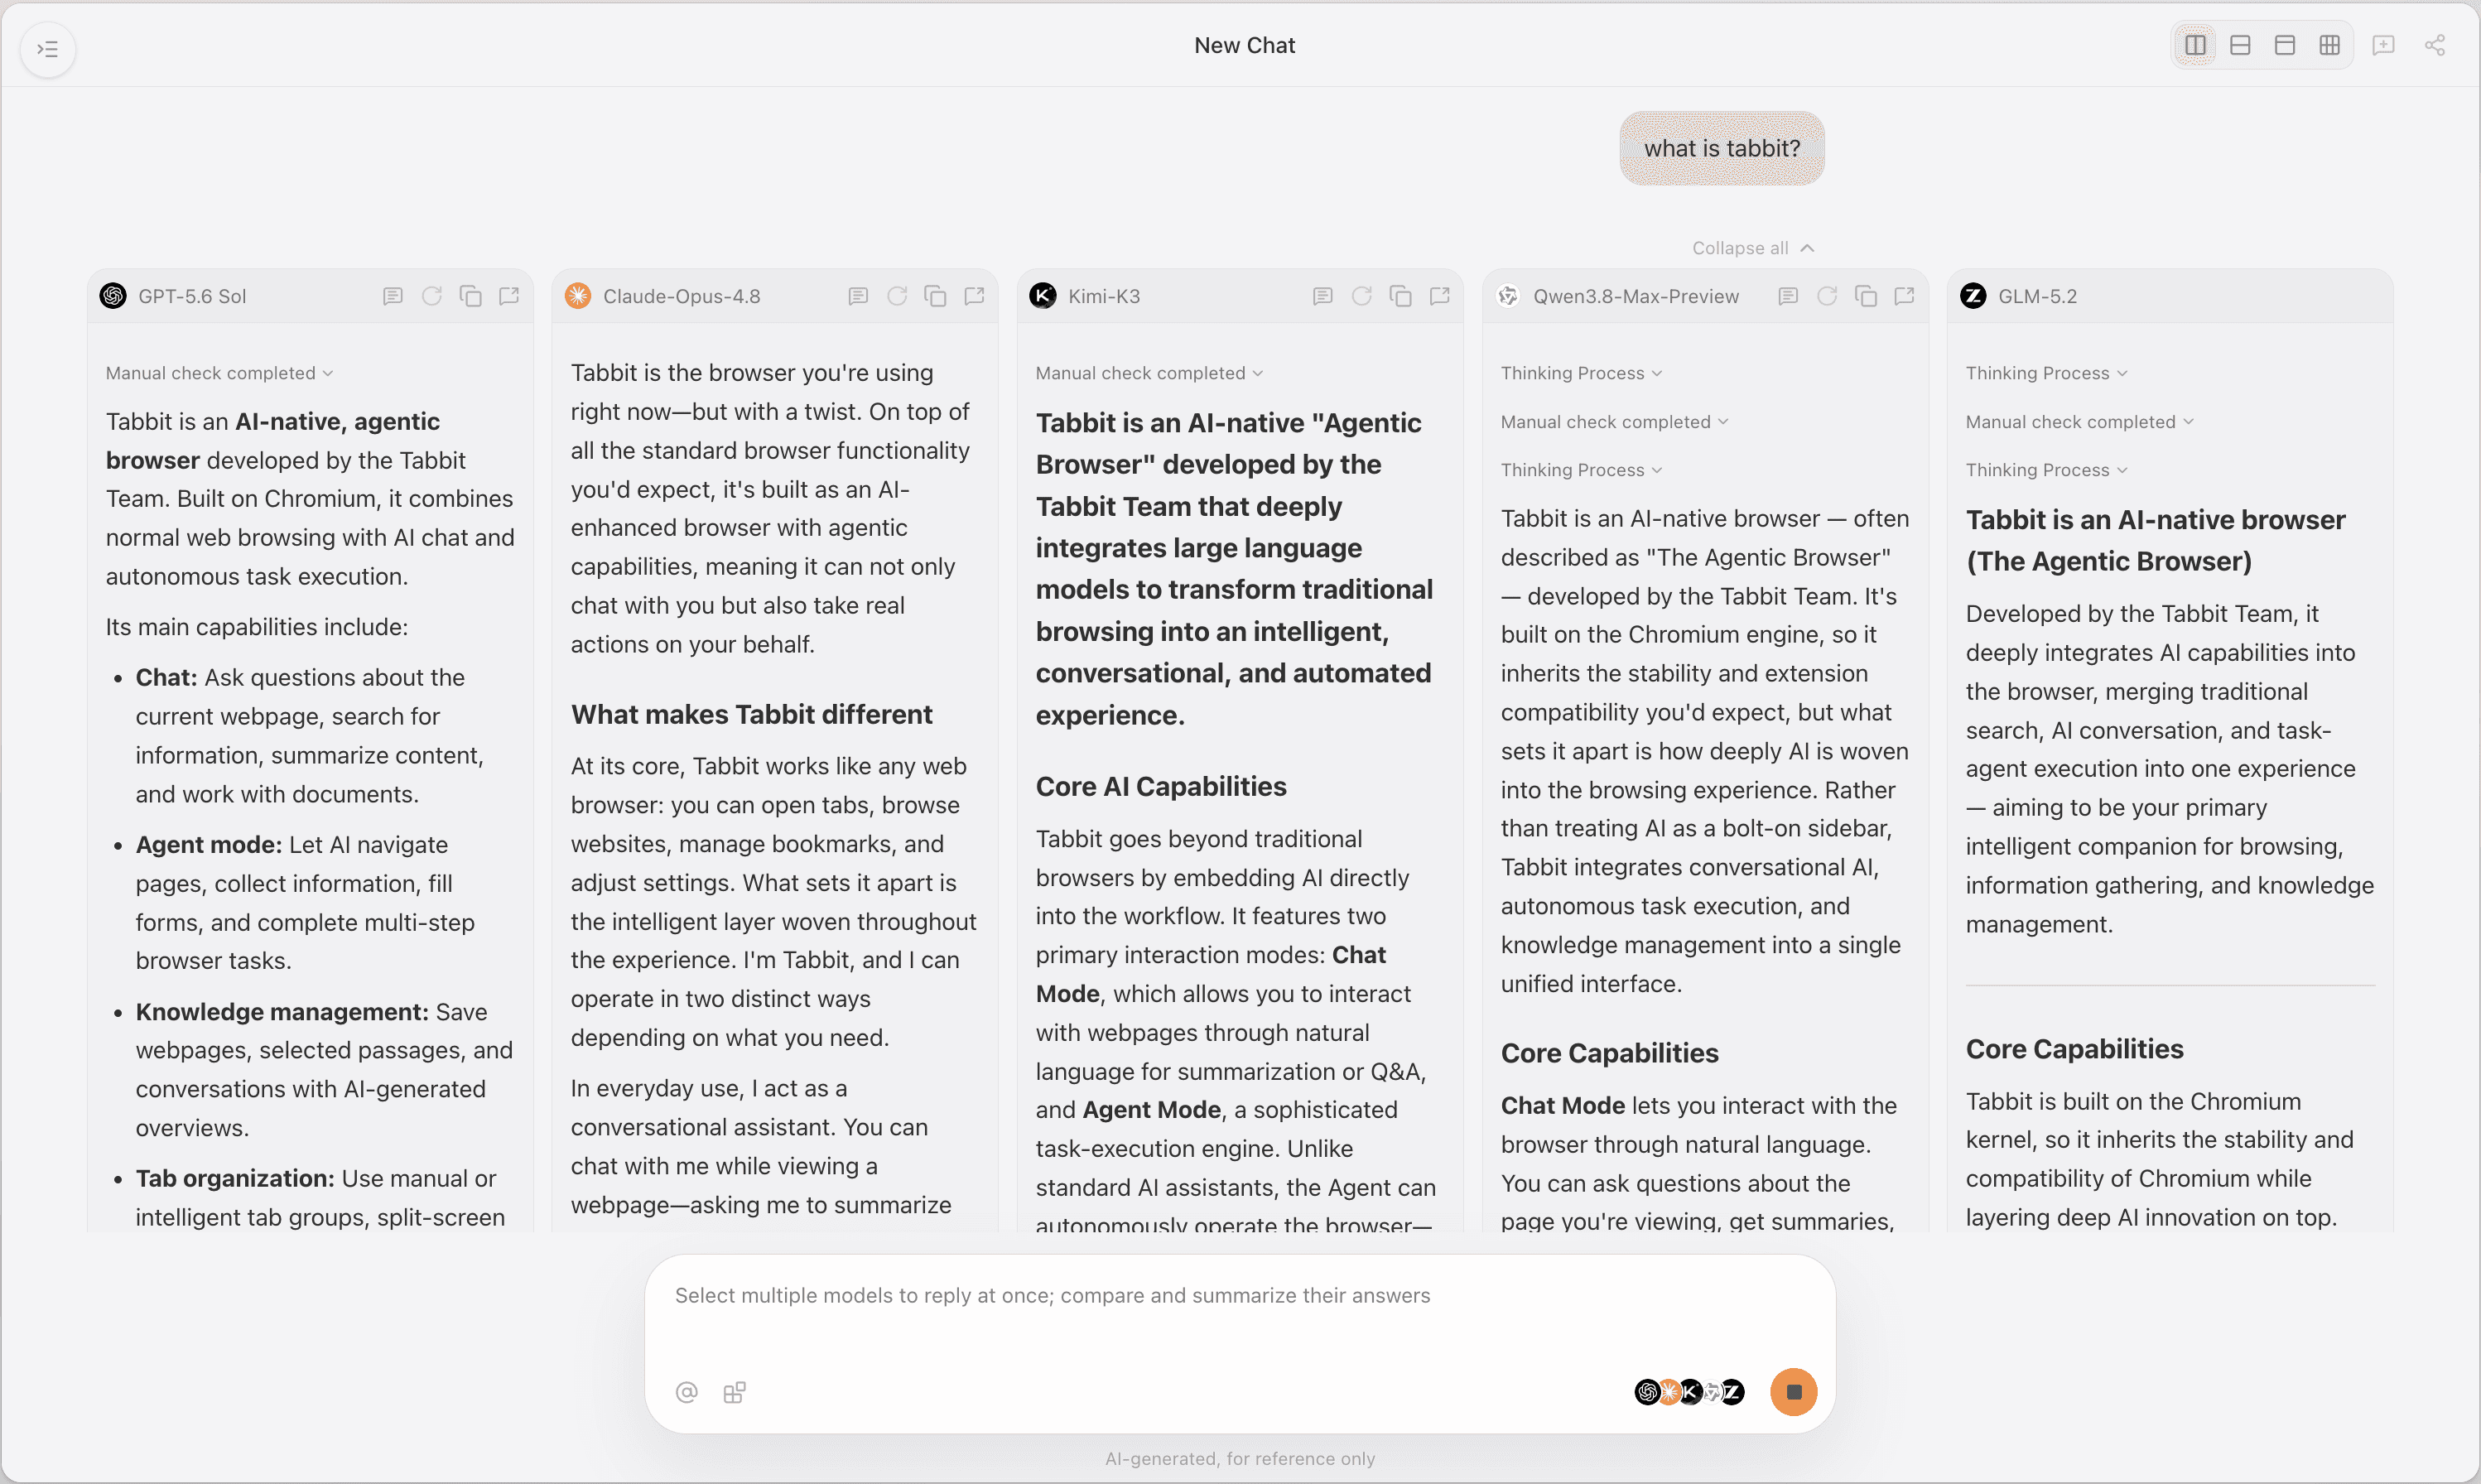
想了解浏览器如何执行多步任务,可阅读 什么是 Agent 浏览器和 AI 浏览器比较。并排回答能帮助发现分歧,不能替代受控评测和代码审查。
应该选哪个?
| 优先事项 | 起点 | 需要核对 |
|---|---|---|
| 可调度任务的官方 API 单价 | DeepSeek 非高峰 | 高峰时段、总 token 和工具费用 |
| 现在下载权重 | DeepSeek | 许可证、硬件和部署成本 |
| 视觉或视频任务 | 试用 LongCat | 输入格式、token 用量、准确率和接口限制 |
| 代码库开发 | 两者都测试 | 相同任务、工具、版本、重试预算和测试 |
| 长文档 | 两者都测试 | 不同位置的信息召回、延迟和输出预算 |
如果非高峰价格或可下载权重是决定因素,DeepSeek 是更合适的首个基线。若任务符合 LongCat 的多模态能力或某项领先基准,值得直接试用。两者都应使用留出的真实任务比较每个合格结果的成本,计入重试和人工检查。另一篇模型对比展示了不同工作负载如何影响选择。

常见问题
通过官方 API 使用哪个模型更便宜?
截至 2026 年 11 月 3 日,LongCat 的限时价格与 DeepSeek 高峰价相同。DeepSeek 非高峰价减半,但总费用还取决于 token 用量、缓存命中和额外工具费用。
LongCat 2.5 写代码比 DeepSeek V4.1 Flash 强吗?
LongCat 公布的表格中,两个模型各自在不同编码测试上领先。由于来源和配置不同,应使用相同版本与工具,在自己的任务上测试后再选择。
两个 API 支持多长的上下文和输出?
LongCat 文档写明总上下文为 1,048,576 token,max_tokens 上限为 262,144。DeepSeek 列出 1M 上下文和 384K 最大输出,输入和输出仍须共同容纳在总上下文内。
两个模型的权重都能下载吗?
DeepSeek 提供 V4.1 Flash 权重下载链接。LongCat 2.5 发布页的 GitHub 和 Hugging Face 均标为敬请期待,部署前应检查最新状态与许可证。
两个模型都能处理图片和视频吗?
两家都介绍了视觉理解能力,LongCat 文档明确支持图片和视频输入。具体格式与限制因 API 和服务商而异,视频工作流应单独核对 DeepSeek 当前文档。
Tabbit 浏览器里能使用这两个模型吗?
模型可用性取决于 Tabbit 当前的模型选择器、账号和地区。对比前请查看选择器,本文截图展示的是其他模型。