
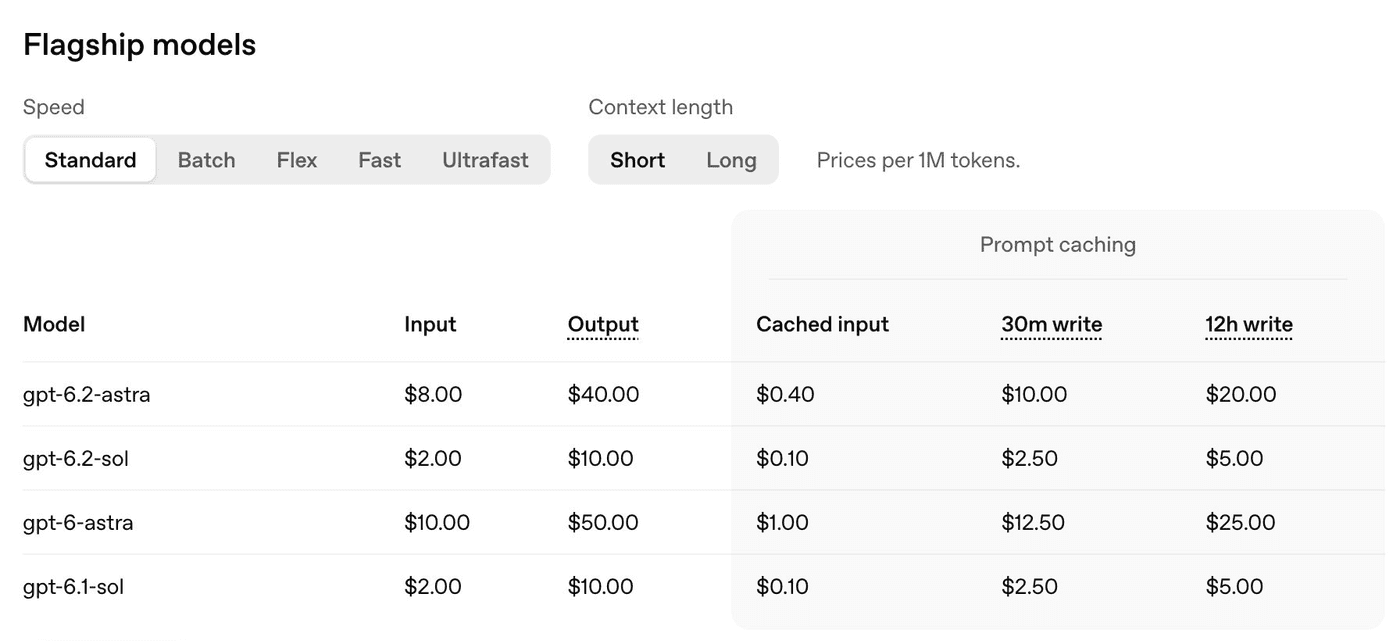
L’API de GPT-6.2 Sol coûte 2 $ par million de tokens d’entrée hors cache, 0,10 $ par million lus en cache et 10 $ par million de tokens de sortie. Ces tarifs Standard d’OpenAI valent jusqu’à 272 000 tokens d’entrée. Batch coûte moitié moins cher. L’écriture en cache a son propre tarif. Tarifs de l’API OpenAI
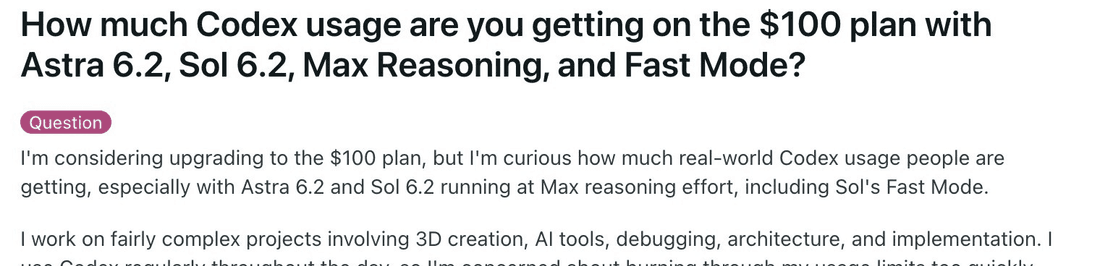
La nouveauté tarifaire concerne Ultrafast à 3 fois le tarif Standard, contre 6 fois pour GPT-6.1 Sol. La promotion dure jusqu’au 28 février 2027, heure du Pacifique. Un développeur sur Reddit cherchait à savoir combien de temps tiendrait son forfait Codex de 100 $ avec Sol, Astra et un effort de raisonnement élevé. Le quota inclus dans Codex est débité à 6 fois en Ultrafast, même pendant la promotion de l’API. Question d’origine · Tarifs Codex
Estimez le prix d’une requête ici, puis vérifiez sur une vraie page de tarifs dans Tabbit Browser combien d’essais donnent un résultat exploitable.
À retenir
Les cinq tarifs Standard sont identiques à GPT-6.1 Sol.
En contexte court, Ultrafast coûte 6 $ en entrée et 30 $ en sortie par million pendant l’offre, puis 12 $ et 60 $ dès le 1er mars 2027, heure du Pacifique.
Au-delà de 272 000 tokens d’entrée, toute la requête passe au tarif de contexte long.
La sortie facturée inclut le raisonnement. Les lectures et écritures de cache font partie de l’entrée.
Consultez le quota ou les crédits de votre forfait pour budgéter Codex.
Grille tarifaire de GPT-6.2 Sol
Prix en dollars par million de tokens vérifiés le 19 novembre 2026. Les dates Ultrafast suivent l’heure du Pacifique. Grille officielle · Fiche du modèle
| Mode API | Entrée totale | Entrée hors cache | Lecture du cache | Écriture 30 min | Écriture 12 h | Sortie |
|---|---|---|---|---|---|---|
| Standard | ≤272K | $2 | $0.10 | $2.50 | $5 | $10 |
| Standard | >272K | $4 | $0.20 | $5 | $10 | $15 |
| Batch | ≤272K | $1 | $0.05 | $1.25 | $2.50 | $5 |
| Batch | >272K | $2 | $0.10 | $2.50 | $5 | $7.50 |
| Fast | ≤272K | $4 | $0.20 | $5 | $10 | $20 |
| Fast | >272K | $8 | $0.40 | $10 | $20 | $30 |
| Ultrafast jusqu’au 28 février | ≤272K | $6 | $0.30 | $7.50 | $15 | $30 |
| Ultrafast jusqu’au 28 février | >272K | $12 | $0.60 | $15 | $30 | $45 |
| Ultrafast à partir du 1er mars | ≤272K | $12 | $0.60 | $15 | $30 | $60 |
| Ultrafast à partir du 1er mars | >272K | $24 | $1.20 | $30 | $60 | $90 |
Quand payer pour Ultrafast
Avec une consommation identique, 100 $ de tokens en Standard coûtent 200 $ en Fast, 300 $ en Ultrafast pendant la promotion, puis 600 $. Mesurez le délai jusqu’à un résultat validé, y compris l’attente des outils et les corrections. Guide Ultrafast
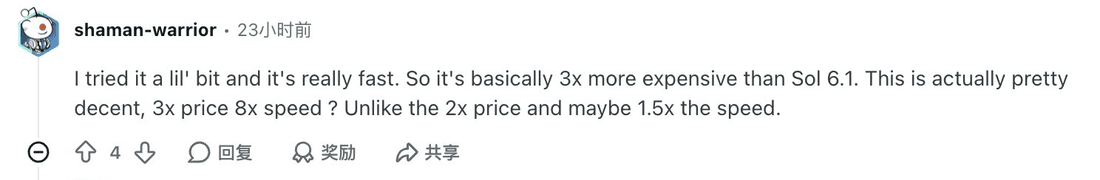
Un utilisateur de Codex a trouvé Ultrafast rapide après un bref essai et s’est demandé si le gain justifiait la dépense. Testez le mode sur une tâche où quelqu’un attend vraiment la réponse. Discussion d’origine
Pour un travail différé, examinez Batch. Les fenêtres de 2 h et 8 h de l’API Responses en bêta donnent 30 % et 40 % de remise avec un cache distinct de Standard. Sol 6.2 ne figurait pas dans la grille Flex vérifiée. Le traitement régional peut ajouter 10 %. La résidence des données en Ultrafast est limitée aux États-Unis. Exécution en arrière-plan · Résidence des données
Cache, raisonnement et seuil de 272 000 tokens
Répartissez l’entrée entre tokens ordinaires, lectures et écritures de 30 minutes ou 12 heures. L’écriture 12 h suivie d’une lecture coûte 5,10 $ par million contre 4 $ pour deux entrées ordinaires. Avec une deuxième lecture, le total de 5,20 $ devient inférieur à trois entrées de 6 $. Cela suppose que le cache reste valide et que le même tarif de contexte s’applique. Guide du cache
Dans Responses, placez les instructions stables dans un message developer au début de input. GPT-6.2 facture le champ supérieur instructions comme entrée hors cache, même si le préfixe est réutilisé. Guide de migration · Réduire les tokens d’un agent
Dès 272 001 tokens d’entrée, cache compris, la requête entière subit un doublement des tarifs d’entrée et de cache et une hausse de 50 % en sortie. Le modèle accepte jusqu’à 922 000 tokens d’entrée et 128 000 de sortie. Une sortie de 6 000 tokens comprenant 4 000 tokens de raisonnement se calcule sur 6 000 tokens. Commencez avec un effort moyen et comparez le coût par résultat validé. Coût par tâche réussie
Comparaison des tarifs des modèles GPT
Tarifs Standard en contexte court par million de tokens. À volume égal, Astra 6.2 coûte quatre fois le prix de Sol 6.2. Évaluez ce qu’il permet d’économiser en reprises sur les tâches qui bloquent. Ressources sur Sol 6.2 (English)
| Modèle | Entrée hors cache | Lecture | Écriture 30 min | Écriture 12 h | Sortie | Charge à tester en premier |
|---|---|---|---|---|---|---|
| GPT-6.2 Astra | $8 | $0.40 | $10 | $20 | $40 | Dossiers exigeant plusieurs corrections |
| GPT-6.2 Sol | $2 | $0.10 | $2.50 | $5 | $10 | Travail quotidien en plusieurs étapes |
| GPT-6.1 Sol | $2 | $0.10 | $2.50 | $5 | $10 | Référence au même tarif avant migration |
| GPT-6.1 Terra | $1 | $0.05 | $1.25 | $2.50 | $5 | Tâches répétitives à format imposé |
| GPT-6 Luna | $0.10 | $0.01 | $0.125 | $0.25 | $0.50 | Extraction avec contrôle par échantillon |
Frais en plus des tokens du modèle
Retrouvez les tarifs de GPT-6 Sol, GPT-6.1 Terra, GPT-6 Luna et GPT-6 Astra. OpenAI facture la recherche web standard 10 $ pour 1 000 appels, plus les tokens récupérés. Comptez les conteneurs, les taxes, les suppléments régionaux et l’usage facturé lors des nouvelles tentatives. La grille ne prévoit pas de remboursement général en cas de refus. Frais d’outils
Quotas et crédits de ChatGPT Work et Codex
OpenAI propose Sol 6.2 dans Work et Codex aux forfaits Plus, Pro, Business, Enterprise et Edu, selon les réglages de l’espace de travail. En Standard, Codex facture 50 crédits par million de tokens entrants, 2,5 en lecture du cache et 250 en sortie. L’écriture du cache ne donne pas lieu à un supplément distinct sur les crédits Codex. Le quota inclus baisse à un rythme de 6 fois en Ultrafast. Les crédits achetés et la facturation à l’usage admissibles sont à 3 fois jusqu’au 28 février 2027, heure du Pacifique, puis à 6 fois. Offres et crédits
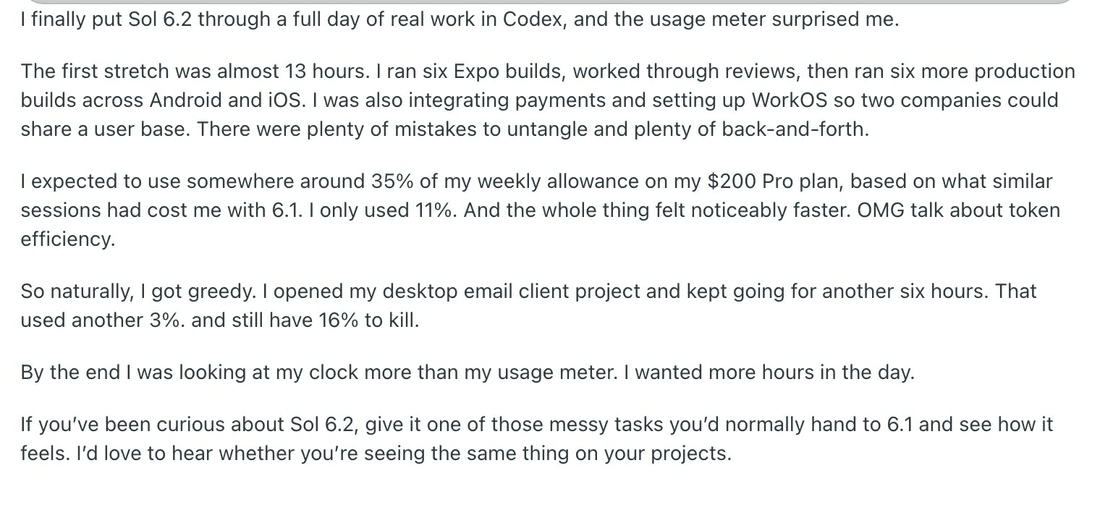
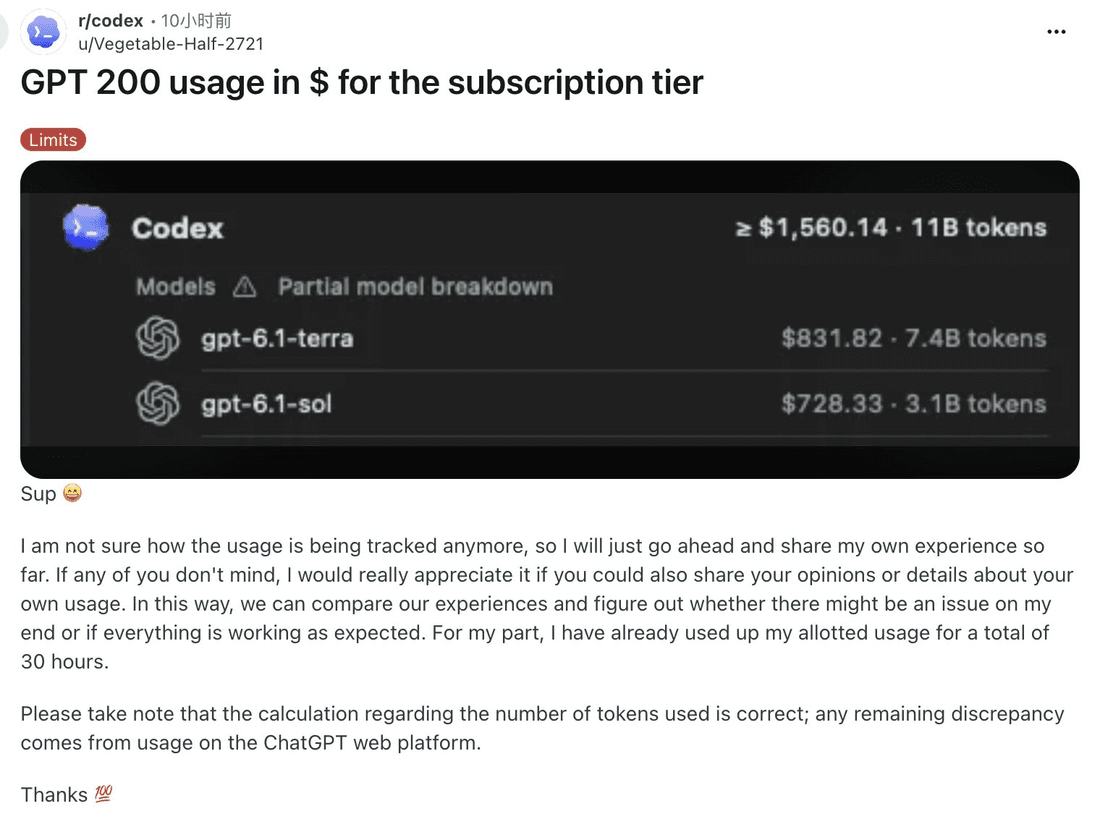
Un développeur a déclaré avoir utilisé 14 % de son quota hebdomadaire sur un forfait à 200 $ lors de compilations Expo et d’une intégration de paiements. Un autre voulait comprendre l’équivalent en dollars après épuisement de son quota. Comparez le compteur avant et après une journée représentative de votre travail. Retour sur Expo · Discussion sur les quotas
Calculer le coût d’une requête GPT-6.2 Sol
Saisissez l’entrée totale, les lectures, les écritures et la sortie facturée. Le calcul se fait dans ce navigateur. Additionnez les coûts quand une tâche exige plusieurs appels.
Estimez le prix de vos tokens
Saisissez les volumes d’une requête. Le calcul se fait dans ce navigateur.
Estimation en dollars hors outils, nouvelles tentatives, traitement régional et taxes. Tarifs OpenAI en vigueur
Requête récurrente. En Standard, 100 000 tokens entrants dont 80 000 lus en cache et 2 000 en sortie coûtent 0,068 $ sans écriture. Mille requêtes identiques coûtent 68 $. Une requête qui écrit les 80 000 tokens en cache pour 30 minutes coûte 0,26 $.
Relecture d’un long document. 300 000 tokens d’entrée hors cache et 8 000 de sortie coûtent 1,32 $ en Standard ou 0,66 $ en Batch. Si vous scindez le document, ajoutez l’appel de synthèse au calcul.
Vérifier un tarif avec Sol 6.2 dans Tabbit
Ouvrez la grille officielle dans Tabbit et joignez l’onglet à Chat with Page. Avec GPT-6.2 Sol, demandez les chiffres et vérifiez chaque ligne sur la page. Guide Tabbit · Guide navigateur de GPT-6 Sol
Relevez les cinq tarifs Standard de contexte court pour GPT-6.2 Sol. Vérifiez le seuil de contexte long, les deux coefficients Ultrafast, la date et le fuseau horaire. Citez les pages officielles.Commencez en Standard pour une API interactive. Choisissez Batch si le résultat peut attendre et essayez Ultrafast quand le délai a un coût mesurable. Pour une vérification dans le navigateur, évaluez d’abord le résultat et ses sources. Le compte Tabbit a ses propres règles d’utilisation.
 Tabbit Browser

Questions fréquentes
Combien coûte GPT-6.2 Sol par million de tokens ?
Jusqu’à 272 000 tokens d’entrée en Standard, comptez 2 $ pour l’entrée hors cache, 0,10 $ pour la lecture, 2,50 $ pour l’écriture de 30 minutes, 5 $ pour celle de 12 heures et 10 $ pour la sortie.
GPT-6.2 Sol est-il moins cher que GPT-6.1 Sol ?
Les tarifs Standard sont identiques pour les deux tailles de contexte. Ultrafast est facturé 3 fois le prix Standard de Sol 6.2 jusqu’au 28 février 2027, heure du Pacifique, contre 6 fois pour Sol 6.1. Le coefficient de Sol 6.2 passe à 6 le 1er mars.
Qu’arrive-t-il au-delà de 272 000 tokens d’entrée ?
Le tarif de contexte long s’applique à toute la requête. En Standard, il est de 4 $ pour l’entrée, 0,20 $ pour la lecture, 5 $ pour l’écriture de 30 minutes, 10 $ pour celle de 12 heures et 15 $ pour la sortie.
Les tokens de raisonnement sont-ils facturés ?
Oui. OpenAI les inclut dans le total des tokens de sortie. Utilisez directement le total du journal d’utilisation.
Mon abonnement ChatGPT ou Codex couvre-t-il les appels API ?
Les appels avec une clé API ont leur propre facturation. L’accès dans ChatGPT Work et Codex dépend du forfait et des réglages de l’espace de travail.
GPT-6.2 Sol est-il disponible en Batch ou Flex ?
Batch applique la moitié du tarif Standard à contexte égal. La grille du 19 novembre 2026 ne répertorie pas Sol 6.2 dans Flex. L’API Responses propose des fenêtres d’exécution en arrière-plan à tarif réduit en bêta publique.