
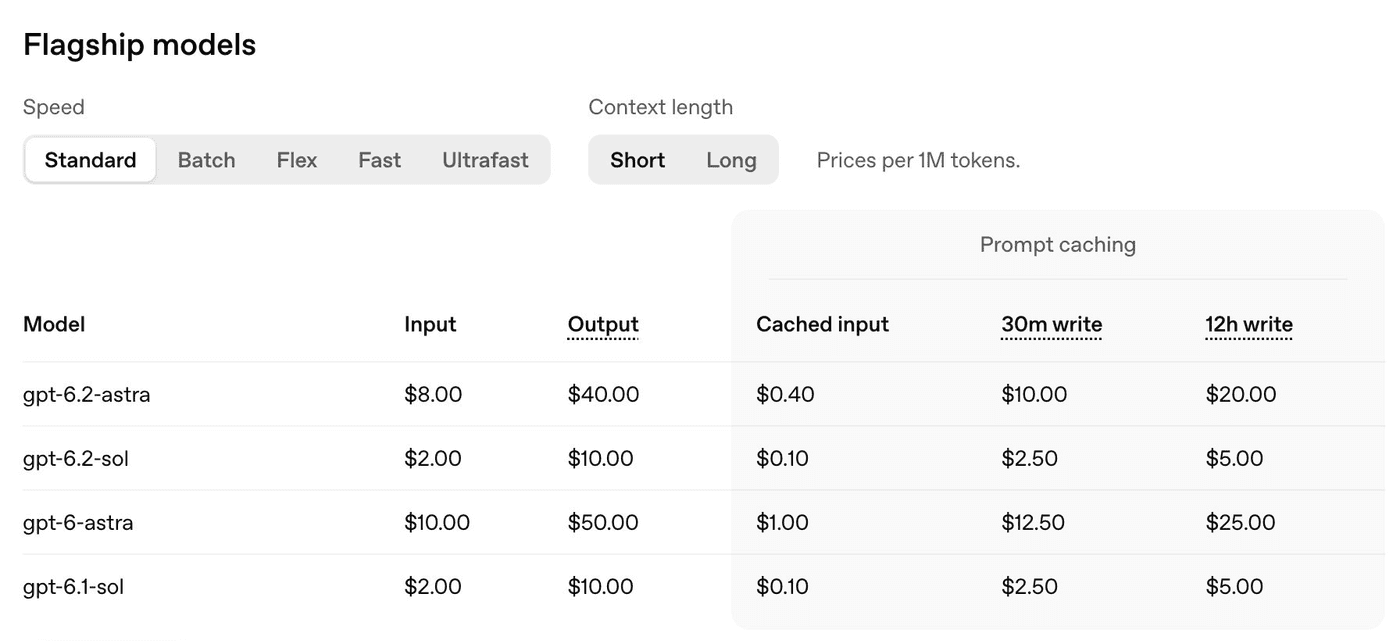
GPT-6.2 Sol 的 OpenAI API 标准价为普通输入 $2、缓存读取 $0.10、输出 $10,每项均按百万 token 计算。 适用条件是单次输入不超过 272,000 token。Batch 按标准费率五折,缓存写入有自己的费率。OpenAI API 定价
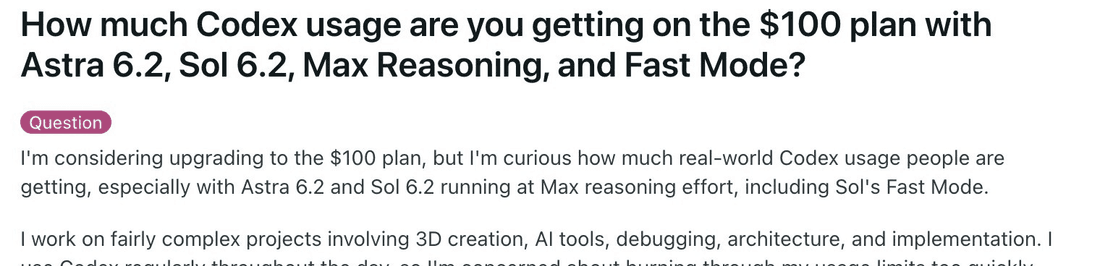
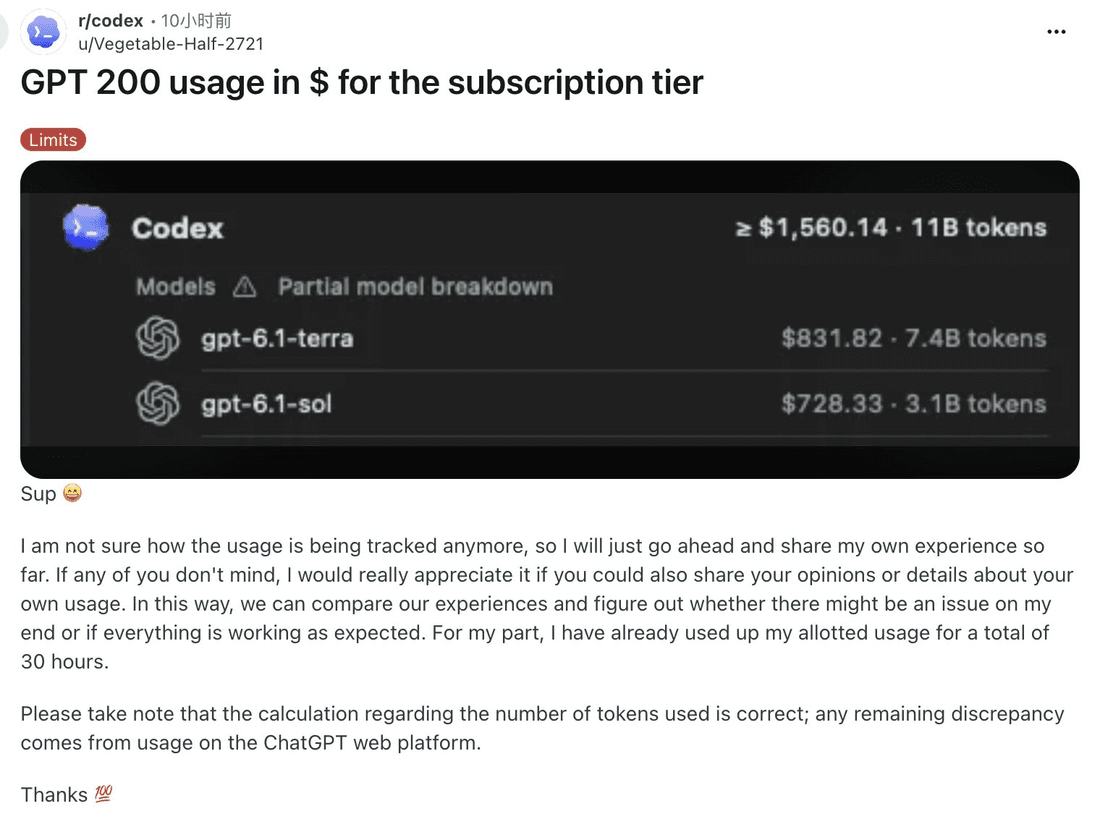
这次变化主要在 Ultrafast 限时 3 倍价,上一代 6.1 Sol 是 6 倍。优惠截至 2027 年 2 月 28 日太平洋时间。一位做 3D 和代码调试的 Codex 用户想知道,切换 Sol、Astra 和高推理档后,100 美元套餐能用多久。这个问题要看 Codex 的用量表。符合条件的 API 享受 3 倍价时,Codex 订阅内额度仍按 6 倍消耗。用户提问 · Codex 计费
先用下文的计算器估算单次请求,再到 Tabbit Browser 用同一条核价任务检查结果需要几次修改。
重点结论
GPT-6.2 Sol 和 GPT-6.1 Sol 的五项标准费率相同。升级后的账单取决于调用次数、token 用量和服务档位。
短上下文 Ultrafast 输入、输出优惠价为 $6、$30。2027 年 3 月 1 日太平洋时间起分别为 $12、$60。
超过 272,000 输入 token 后,整次请求切换档位。缓存读取和写入都计入门槛。
缓存读取单价为普通输入的 5%。推理计入输出,缓存写入单独归类。
API、Codex 点数和订阅额度各有价格和消耗规则。
GPT-6.2 Sol API 价格表
下表为 2026 年 11 月 19 日核对的美元价格,单位为每百万 token。Ultrafast 日期使用太平洋时间。6.1 Sol 在标准档的五项单价均相同。官方价格表 · Sol 模型卡
| API 档位 | 单次输入 | 普通输入 | 缓存读取 | 30 分钟写入 | 12 小时写入 | 输出 |
|---|---|---|---|---|---|---|
| Standard | ≤272K | $2 | $0.10 | $2.50 | $5 | $10 |
| Standard | >272K | $4 | $0.20 | $5 | $10 | $15 |
| Batch | ≤272K | $1 | $0.05 | $1.25 | $2.50 | $5 |
| Batch | >272K | $2 | $0.10 | $2.50 | $5 | $7.50 |
| Fast | ≤272K | $4 | $0.20 | $5 | $10 | $20 |
| Fast | >272K | $8 | $0.40 | $10 | $20 | $30 |
| Ultrafast 截至 2 月 28 日 | ≤272K | $6 | $0.30 | $7.50 | $15 | $30 |
| Ultrafast 截至 2 月 28 日 | >272K | $12 | $0.60 | $15 | $30 | $45 |
| Ultrafast 自 3 月 1 日起 | ≤272K | $12 | $0.60 | $15 | $30 | $60 |
| Ultrafast 自 3 月 1 日起 | >272K | $24 | $1.20 | $30 | $60 | $90 |
什么时候值得开 Ultrafast
在相同用量下,优惠期的 Ultrafast 是 Fast 的 1.5 倍。优惠结束后变成 3 倍。每月标准档模型费用若为 $100,切换到 Fast 为 $200,优惠期 Ultrafast 为 $300,之后为 $600。跨过截止日的项目要分别估算。Ultrafast 官方说明
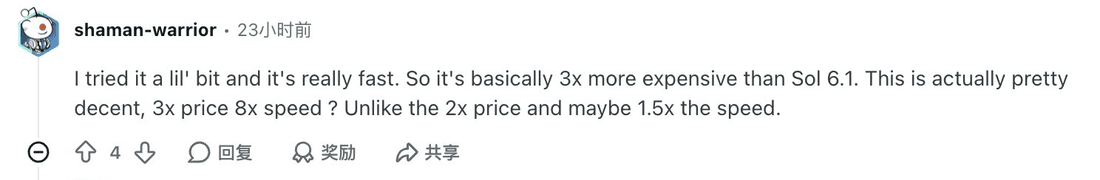
有位 Codex 用户短暂试用后认为速度提升明显,同时质疑额外消耗值不值。实际节省多少取决于工具等待和人工返工,试跑时记下结果通过验收的时间。讨论原帖
后台作业先比较 Batch。需要单条 Responses API 响应时,还有公开测试中的 2 小时和 8 小时完成窗口,模型 token 费率比标准价低 30% 和 40%,使用独立的缓存池。核对当天 Flex 表未列 6.2 Sol。区域处理可能加价 10%,Ultrafast 的数据驻留只支持美国。后台任务指南 · 区域说明
缓存、推理与 272K 门槛
输入分四类:普通 token、缓存读取、30 分钟写入、12 小时写入。写入费率替代这批 token 的普通输入费率。短上下文下,按百万 token 归一,12 小时写入的费率为 $5,加上一次完整命中,合计 $5.10,普通读两次是 $4。再完整命中一次,累计 $5.20,普通读三次是 $6。前提是读取发生在有效期内,且都用同一上下文档。OpenAI 缓存指南
迁移 Responses API 时,把稳定指令放在 input 开头的 developer 消息里。GPT-6.2 把顶层 instructions 放在可缓存前缀之后,命中时这段仍按普通输入价收费。迁移文档 · 减少浏览器 Agent 的 token 用量
272,000 输入仍用短上下文。272,001 起,整次请求的输入及缓存费率翻倍、输出涨至 1.5 倍。模型卡列出的上限为 922,000 输入和 128,000 输出。预估月账单时按请求分别判定档位,避免平均值掩盖长请求。
推理 token 已包含在输出总数里。用量显示输出 6,000,其中 4,000 为推理时,按 6,000 计一次。新接入可以从中等推理开始,记录不同档位一次通过了多少结果、返了多少次工。按成功任务算浏览器 Agent 成本
GPT 家族标准价格对比
下表适用短上下文,单位为美元/百万 token。Astra 6.2 五项费率都是 Sol 6.2 的四倍。更便宜的模型可以先跑窄任务样本,再把失败后转交和复核的成本计进去。Sol 6.2 模型资料
| 模型 | 普通输入 | 缓存读取 | 30 分钟写入 | 12 小时写入 | 输出 | 先测什么 |
|---|---|---|---|---|---|---|
| GPT-6.2 Astra | $8 | $0.40 | $10 | $20 | $40 | 多次返工的困难任务 |
| GPT-6.2 Sol | $2 | $0.10 | $2.50 | $5 | $10 | 有验收标准的日常多步骤任务 |
| GPT-6.1 Sol | $2 | $0.10 | $2.50 | $5 | $10 | 迁移前的同价对照 |
| GPT-6.1 Terra | $1 | $0.05 | $1.25 | $2.50 | $5 | 输出格式固定的重复任务 |
| GPT-6 Luna | $0.10 | $0.01 | $0.125 | $0.25 | $0.50 | 分类、路由与抽样复核 |
费率表之外还要算什么
参考初代 GPT-6 Sol、GPT-6.1 Terra、GPT-6 Luna和前代 GPT-6 Astra的独立定价。以下计算器只算模型 token。内置网页搜索另计 $10/千次,加上搜索内容 token。容器、区域加价、税费和有用量的重试应按实际记录补上。官方价目表没有对拒答承诺统一退款。工具费率
ChatGPT Work 与 Codex 怎么扣量
OpenAI 在 Work 和 Codex 的 Plus、Pro、Business、Enterprise、Edu 套餐列出 6.2 Sol,受工作区设置影响。标准点数每百万 token 为输入 50、缓存读取 2.5、输出 250。Codex 点数无单独缓存写入费。订阅内 Ultrafast 用量以 6 倍扣减。符合条件的购买点数和企业按量用量截至 2027 年 2 月 28 日太平洋时间使用 3 倍价,3 月 1 日起 6 倍。官方套餐与点数说明
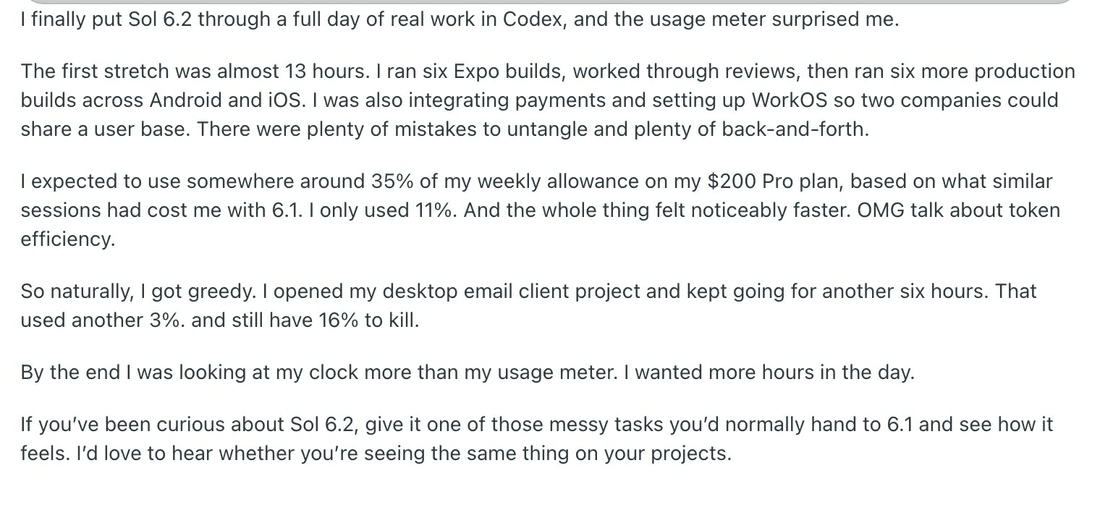
一位开发者用高推理档做 Expo 构建、支付接入和审查,自报使用了 $200 套餐每周额度的 14%。另一位用户达到额度上限后询问怎样读美元等值。两个经历仅用于说明实际用量问题。用自己的代表任务观察同一块用量面板,再估订阅容量。构建任务原帖 · 额度讨论
用计算器估算 GPT-6.2 Sol API 费用
输入一笔请求的总输入、缓存读写及输出 token。结果在当前浏览器计算。多请求任务应逐笔计费后相加。
估算模型 token 费用
按单次请求的实际用量填写,结果在浏览器内计算。
美元估算,工具、重试、区域处理及税费另计。 查看 OpenAI 最新费率
重复请求。 总输入 100,000,其中 80,000 为缓存读取,输出 2,000,无写入。标准价为 (20,000 × 2 + 80,000 × 0.10 + 2,000 × 10) / 1,000,000 = $0.068。同样的 1,000 次请求为 $68。首次将这 80,000 token 写入 30 分钟缓存时,该次为 $0.26。
长文档复核。 普通输入 300,000,输出 8,000。标准价 (300,000 × 4 + 8,000 × 15) / 1,000,000 = $1.32,Batch 为 $0.66。如果分段阅读后还需一次汇总,把汇总也计入总价。
在 Tabbit Browser 用 Sol 6.2 核一次价
打开 OpenAI 官方定价页,在 Tabbit 的网页对话里引用当前标签页,使用 GPT-6.2 Sol。让它给出五项费率和日期,再逐项与表格对照。Tabbit 使用指南 · 初代 Sol 的浏览器操作指南
请从当前 OpenAI 官方页面提取 GPT-6.2 Sol 的普通输入、缓存读取、30 分钟写入、12 小时写入和输出五项标准短上下文费率。确认长上下文门槛、Ultrafast 两个倍率及切换日期和时区。附官方链接。交互 API 先用 Standard,能等待的作业先试 Batch。有明确周转时间要求时再比较 Ultrafast。如果任务是做采购核价,先检查结果与链接,再看模型用量。Tabbit 按自己的账户规则计量。
 Tabbit Browser

常见问题
GPT-6.2 Sol 每百万 token 多少钱?
标准档单次输入不超过 272,000 token 时,普通输入 $2、缓存读取 $0.10、30 分钟缓存写入 $2.50、12 小时写入 $5、输出 $10。
GPT-6.2 Sol 比 GPT-6.1 Sol 便宜吗?
两个上下文区间的标准费率相同。6.2 Sol 的 Ultrafast 截至 2027 年 2 月 28 日太平洋时间按标准费率的 3 倍计价,6.1 Sol 为 6 倍。6.2 Sol 于 3 月 1 日升至 6 倍。
输入超过 272,000 token 怎么计费?
整次请求切换到长上下文费率。标准档每百万 token 普通输入 $4、缓存读取 $0.20、30 分钟写入 $5、12 小时写入 $10、输出 $15。
推理 token 要收费吗?
要。OpenAI 将推理 token 计入输出。用量记录的输出总量已包含推理,计算一次即可。
ChatGPT 或 Codex 订阅包含 API 用量吗?
OpenAI 对 API Key 调用单独计费。ChatGPT Work 和 Codex 的使用资格由套餐和工作区设置决定,订阅内额度和购买点数各有计量规则。
GPT-6.2 Sol 有 Batch 或 Flex 吗?
OpenAI 列出 Batch 为同上下文标准费率的五折。2026 年 11 月 19 日费率表的 Flex 栏没有 6.2 Sol。Responses API 另有公开测试中的后台任务折扣。