
Commencez par GPT-6.2 Sol pour le code courant et les tâches répétitives. Testez GPT-6.2 Astra quand un échec entraînerait une reprise coûteuse. OpenAI a lancé les deux modèles le 17 novembre 2026. Une suite de tests fiable permet d’essayer Sol en premier. Sur une modification délicate, mesurez ce que l’autre modèle change au temps de révision. Annonce d’OpenAI.
À usage égal, l’API Standard en contexte court coûte quatre fois plus cher avec Astra. Dans FrontierCode 2.0, OpenAI rapporte que Sol, réglé sur Max comme Astra, se situe à moins d’un demi-point et coûte environ un cinquième par tâche. Ce rapport dépend de la quantité de calcul facturée pour obtenir le résultat. Vous pouvez vérifier les hypothèses de prix avec le même exercice dans Tabbit Browser. Fiche API Astra, Fiche API Sol, Résultats OpenAI.
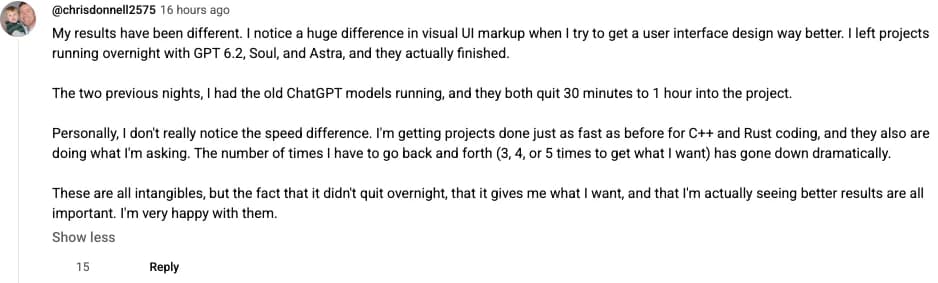
Un développeur rapporte que les deux modèles 6.2 ont terminé ses projets laissés en cours pendant la nuit et réduit les allers-retours en C++ et en Rust. Mesurez la fréquence des interventions manuelles dans votre essai. Commentaire original.
À retenir
Les frais de tokens sont 75 % plus bas avec Sol pour un même usage de l’API.
Essayez Astra sur les cas où les corrections ou les oublis coûtent cher.
Les deux modèles ont la même fenêtre de contexte. Le seuil de 272K en entrée change le prix de la requête complète.
Codex, ChatGPT Work et l’API ont leurs propres conditions d’accès et compteurs.
Rapportez la dépense au nombre de résultats validés. Incluez les essais ratés.
Astra et Sol en un coup d’œil
| Critère | GPT-6.2 Astra | GPT-6.2 Sol |
|---|---|---|
| Identifiant API | gpt-6.2-astra | gpt-6.2-sol |
| Entrée / sortie Standard par million de tokens | 8 $ / 40 $ | 2 $ / 10 $ |
| Lecture du cache / écriture 30 min | 0,40 $ / 10 $ | 0,10 $ / 2,50 $ |
| Fenêtre / entrée max. / sortie max. | 1 050 000 / 922 000 / 128 000 | 1 050 000 / 922 000 / 128 000 |
| Modalités | Texte et image en entrée, texte en sortie | Texte et image en entrée, texte en sortie |
| Effort | Low, Medium, High, Xhigh, Max | Low, Medium, High, Xhigh, Max |
| Premier essai | Changements complexes, erreurs coûteuses | Code courant, traitement répétitif |
| Accès OpenAI | API, Codex et ChatGPT Work pour comptes éligibles | API, Codex et ChatGPT Work pour comptes éligibles |
Prix vérifiés le 19 novembre 2026. Les limites du tableau concernent l’API. Ressources Astra (English), Ressources Sol (English), Tarifs de l’Astra précédent.
Combien coûte un résultat exploitable ?
Avec 100 000 tokens d’entrée hors cache et 20 000 de sortie facturée, comptez 1,60 $ avec Astra et 0,40 $ avec Sol. Si 80 000 tokens sont lus dans un cache existant, le calcul donne 0,992 $ et 0,248 $. Les tokens de raisonnement sont facturés en sortie. Ajoutez les écritures de cache et les outils selon votre usage.
Au-delà de 272K tokens en entrée, OpenAI double les tarifs d’entrée et de cache et multiplie la sortie par 1,5 sur toute la requête. Avec 300 000 tokens d’entrée hors cache et 20 000 de sortie, le total Standard est de 6 $ et 1,50 $. À contexte égal, Batch coûte la moitié du Standard et Fast le double. Ultrafast coûte trois fois le Standard jusqu’au 28 février 2027 et six fois à compter du 1er mars, heure du Pacifique. Tarifs de l’API OpenAI.
Additionnez tentatives et outils, puis divisez par les résultats validés. Ajoutez le temps passé en revue manuelle le cas échéant. Imaginons 20 tâches à 0,40 $ par essai avec Sol. Seize passent, puis les quatre autres passent avec Astra à 1,60 $ par essai. Le coût est de 14,40 $, soit 0,72 $ par tâche validée. Tout envoyer à Astra coûte 32 $ si chaque essai passe. Le scénario à deux modèles dépend d’un contrôle capable d’identifier les quatre échecs. Détail des postes de facturation de Sol.
Un autre lecteur souligne qu’un essai bon marché peut laisser le travail de correction à un autre agent. Incluez ce passage dans le calcul. Commentaire original.

Code, analyse de données et vitesse
FrontierCode 2.0 évalue des changements sur de vrais dépôts et leur aptitude à être fusionnés. Lors de son essai Max, OpenAI relève moins d’un demi-point d’écart pour un coût environ cinq fois moindre avec Sol. Au 19 novembre, l’indice d’Artificial Analysis affiche 62 pour Astra Max et 57 pour Sol Max. Son test de code FrontierCode-AA 2.0 utilise un autre environnement. Dans votre dépôt, retenez un même commit et vérifiez ensemble les tests, le périmètre du changement et la revue humaine. OpenAI, Artificial Analysis, Évaluation de l’Astra précédent, Évaluation du Sol précédent.
Plotly relève 41/43 contre 40/43 pour Astra et Sol. Le coût complet est de 4,11 $ contre 1,22 $, avec une médiane de 12,4 contre 10,5 secondes par question. Un seul passage de chaque modèle et une seule question d’écart laissent une marge d’incertitude. Ranthis a observé trois scores de 10/10 pour Astra High et trois de 9/10 pour Sol High sur un tableau de ventes. Sol ignorait la même ligne à chaque fois. Les coûts médians au tarif catalogue étaient de 0,0337 $ et de 0,0085 $. Ajoutez des cas d’exception et vérifiez les totaux si vous automatisez une extraction. Test Plotly, Test Ranthis.
Le moment où s’affiche du texte et celui où le travail est utilisable répondent à deux questions différentes. Notez les deux. Fixez outils et délais, comparez au même effort et rejouez les tâches dans la configuration retenue. Données de latence et d’effort.
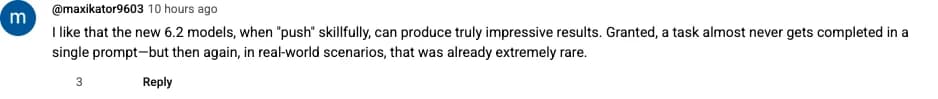
Un utilisateur rappelle que les tâches réelles exigent souvent plusieurs messages. Enregistrez les relances et les corrections dans vos mesures. Commentaire original.
Accès dans Codex, ChatGPT Work et l’API
Vérifiez le sélecteur dans le produit et l’espace de travail concernés. Les limites de l’abonnement sont propres à Codex ou Work. Pour l’API, notez l’identifiant, le niveau d’effort et le mode de traitement. Les deux modèles refusent le réglage none. Les outils disponibles dans Responses API dépendent de la configuration. Archivez des entrées et des sorties de l’ancienne version avant de migrer. Disponibilité selon OpenAI, Configuration du navigateur dans Codex, Exemple avec GPT-6.1 Sol.
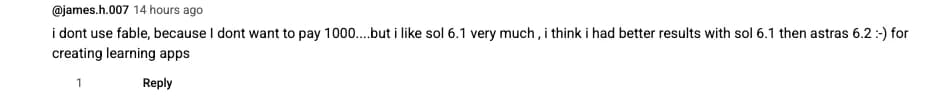
Un développeur d’applications éducatives préfère ses anciens résultats avec Sol 6.1 à ceux d’Astra 6.2. Conservez un résultat de référence avant la migration. Commentaire original.
Soumettre le même exercice dans Tabbit
Dans le chat multimodèle de Tabbit Browser, choisissez Astra et Sol et fournissez les deux mêmes fiches API. Demandez l’identifiant et les tarifs Standard d’entrée, de lecture du cache et de sortie, par million de tokens. Ajoutez le seuil du contexte long et une source par modèle. Vous devez obtenir 8 / 0,40 / 40 $ pour Astra et 2 / 0,10 / 10 $ pour Sol, avec le seuil de 272K applicable à la requête entière. Organisation d’une recherche multimodèle, Vérification des sources Web.
Utilise uniquement les deux fiches OpenAI jointes. Rends une ligne par modèle avec son identifiant API exact, les tarifs Standard en contexte court pour l’entrée hors cache, la lecture du cache et la sortie facturée, en dollars par million de tokens, puis le lien de la fiche. Sous le tableau, indique le seuil du contexte long et précise s’il concerne toute la requête. Signale toute valeur absente des sources.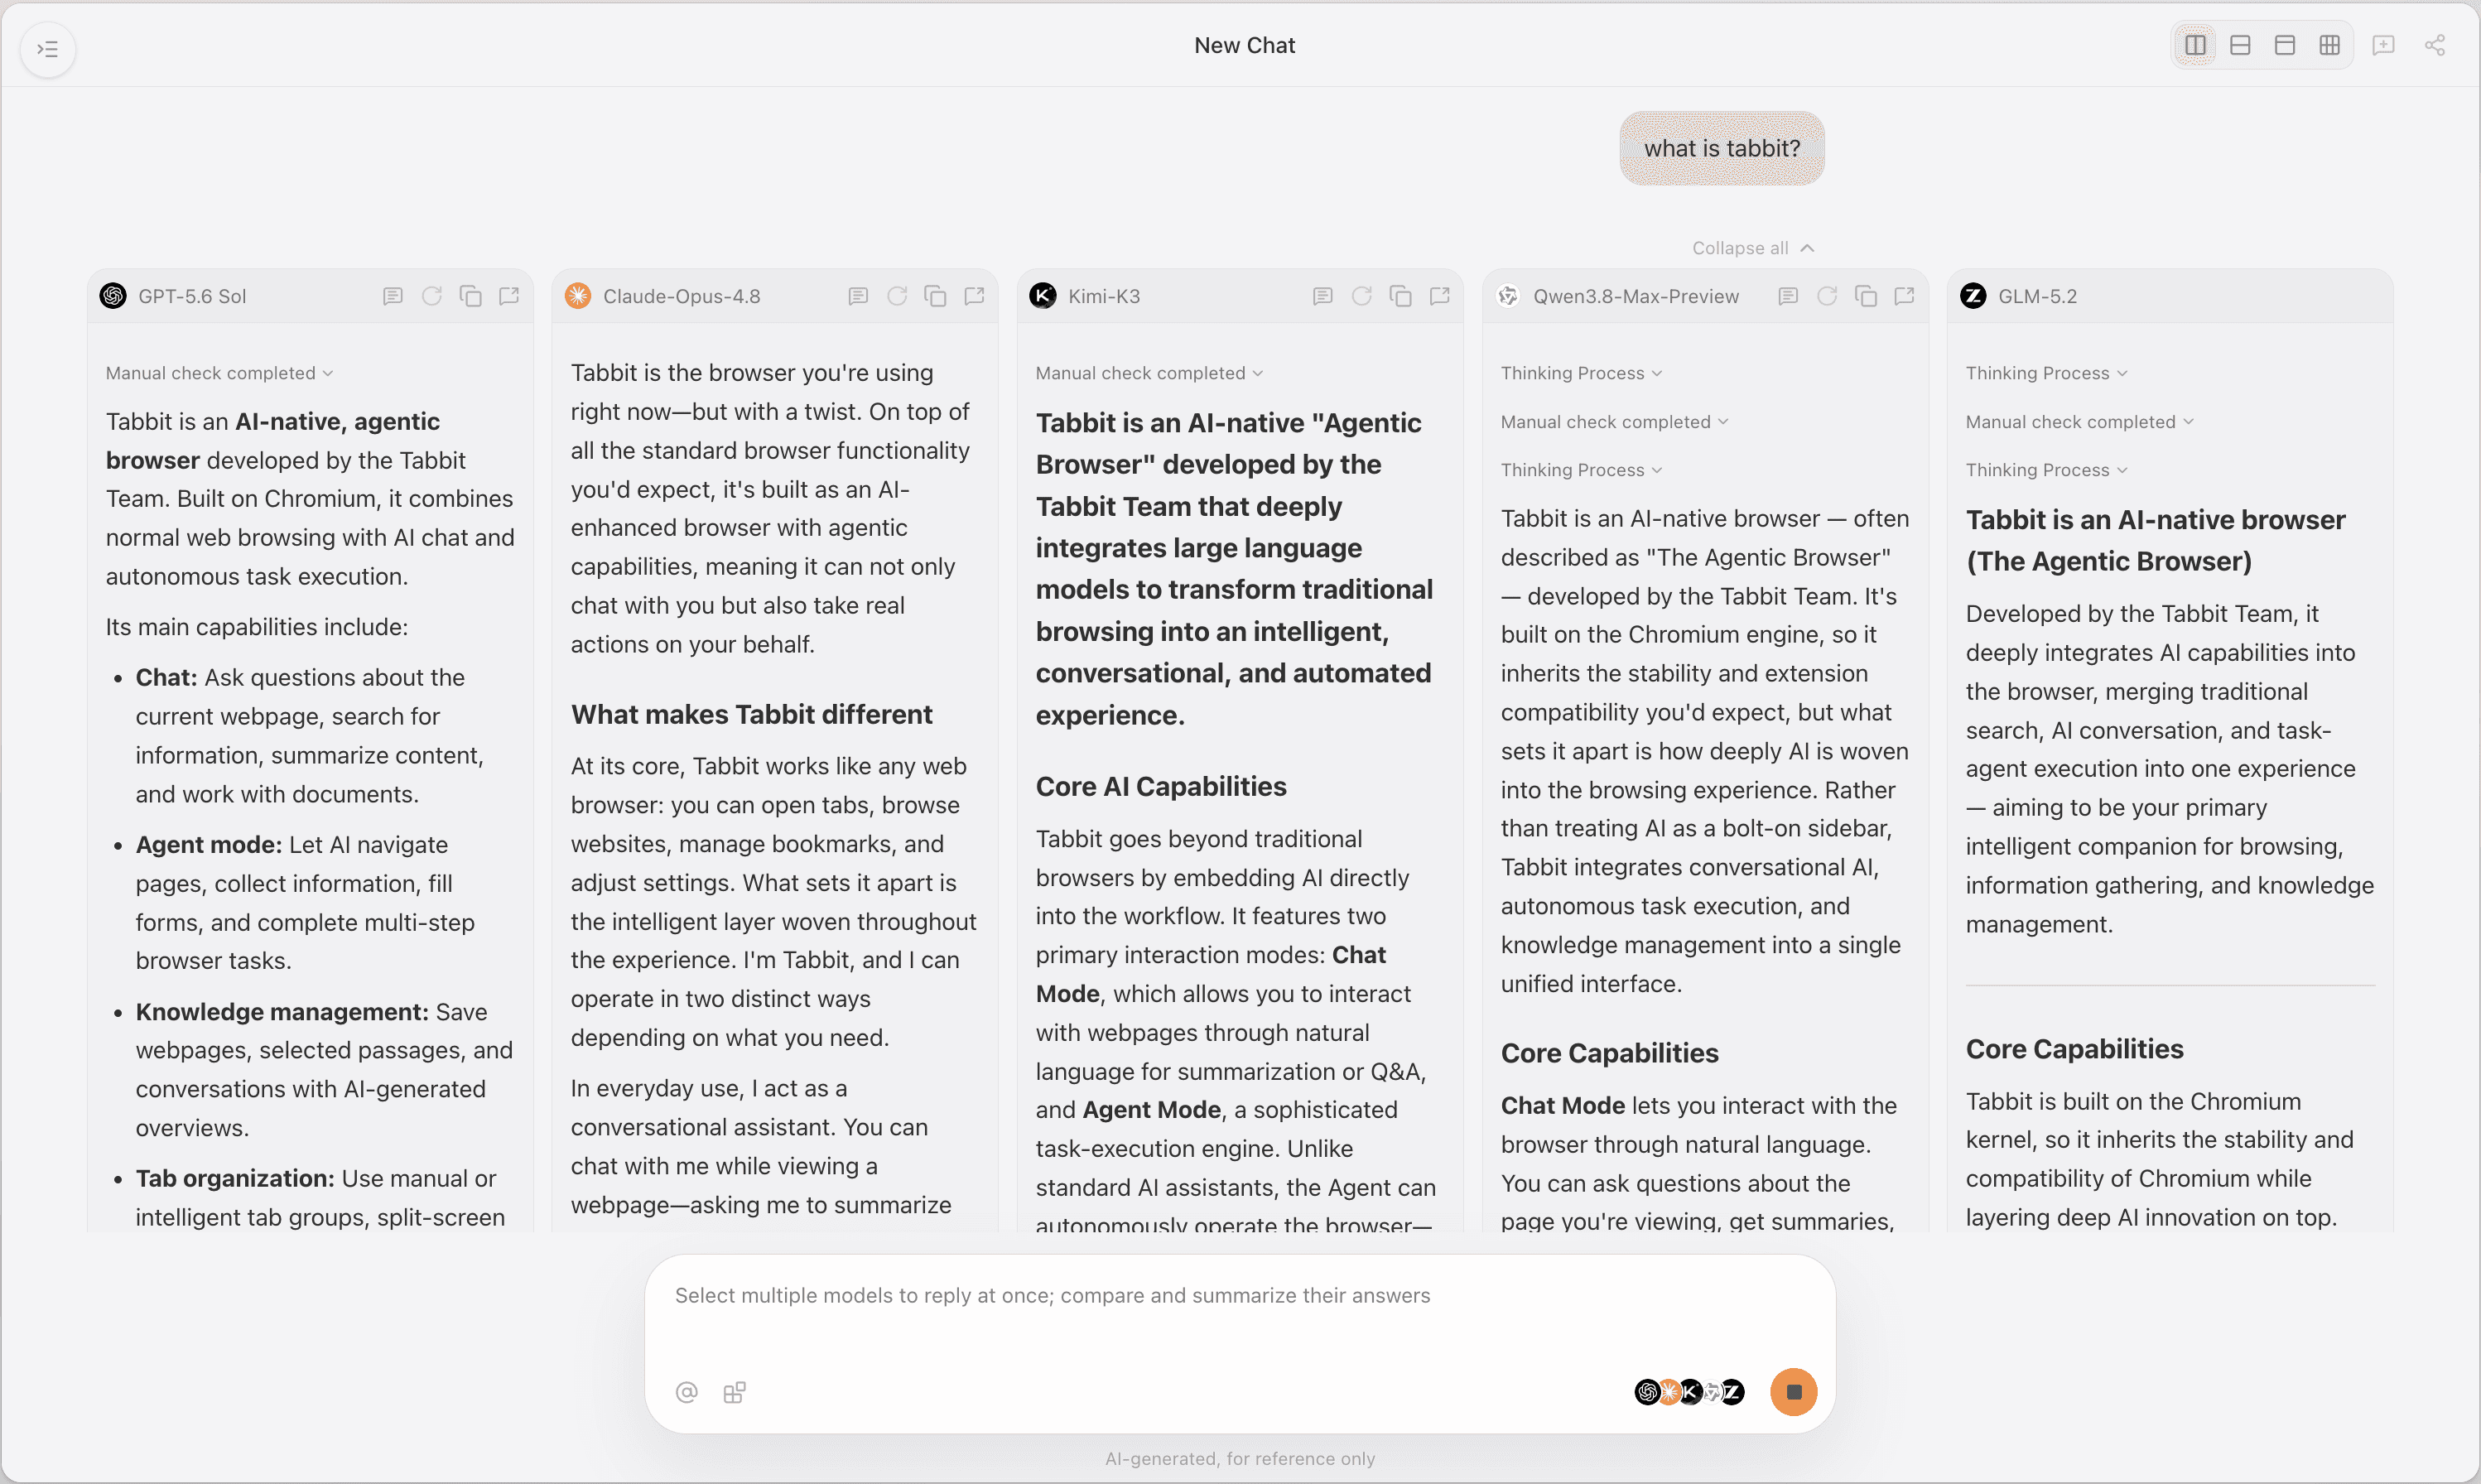
Contrôlez l’unité, l’ordre des prix et l’adresse de la source. Pour mesurer les tokens effectivement facturés et les nouvelles tentatives, consultez les journaux de l’API.
Quand le surcoût d’Astra se justifie
| Travail | Premier essai | Ce qui peut changer le choix |
|---|---|---|
| Petit correctif avec des tests précis | Sol | Astra corrige un défaut que Sol laisse passer |
| Modification de plusieurs modules | Astra sur les cas difficiles | Sol passe les mêmes contrôles en un temps comparable |
| Extraction ou classement par lots | Sol | Des lignes manquantes passent la validation |
| Document important ou recherche | Sol pour le premier passage, Astra sur les cas signalés | Mesurez couverture, citations et retouches |
| Requête à contexte long | Sol, puis un essai avec une entrée réduite | Astra justifie son coût par résultat validé |
| Flux Codex ou Work existant | L’option la moins chère qui passe la revue | L’autre réduit le temps de révision |
Évaluez Sol sur des tâches représentatives et gardez des réussites et des échecs. Faites rejouer les mêmes cas à Astra. Pour un travail fondé sur des pages Web, gardez les fiches et les résultats dans Tabbit pour pouvoir répéter le contrôle.

Questions fréquentes
Faut-il choisir GPT-6.2 Astra ou GPT-6.2 Sol ?
Commencez par Sol pour le code courant, les sorties structurées et les tâches faciles à vérifier. Essayez Astra sur les cas épineux où une correction coûterait beaucoup de temps.
De combien Sol est-il moins cher ?
À nombre de tokens et mode de traitement identiques sur l’API OpenAI, Sol réduit de 75 % les frais du modèle. Le coût par résultat validé dépend aussi du raisonnement, du cache, des outils et des nouvelles tentatives.
Peut-on utiliser les deux modèles dans Codex et ChatGPT ?
OpenAI les a lancés dans Codex et ChatGPT Work pour les comptes éligibles, ainsi que dans l’API. Vérifiez le sélecteur de votre espace de travail et les limites de l’abonnement.
Leur fenêtre de contexte est-elle identique ?
L’API prévoit 1 050 000 tokens pour chacun, dont au plus 922 000 en entrée et 128 000 en sortie. Au-delà de 272K tokens d’entrée, la requête entière passe au tarif de contexte long.
Sol est-il toujours plus rapide ?
Sol a terminé plus vite dans les essais de Plotly et Ranthis. Mesurez séparément l’attente avant le premier texte et le délai nécessaire pour obtenir un résultat validé.
Comment comparer Astra et Sol équitablement ?
Fixez les mêmes entrées, outils et critères d’acceptation. Comparez au même niveau de raisonnement, puis dans la configuration envisagée en production. Incluez les échecs dans vos mesures.