
평소 코딩과 반복 작업은 GPT-6.2 Sol로 시작하세요. 실패해서 다시 작업하는 비용이 크다면 같은 문제를 GPT-6.2 Astra로도 풀어 보세요. OpenAI는 미국 시간 2026년 11월 17일 두 모델을 출시했습니다. 테스트로 바로 판정할 수 있는 변경은 Sol을 기준으로 삼기 좋습니다. 여러 요구 사항이 얽힌 변경은 Astra가 검토 시간을 얼마나 줄이는지 확인해 볼 만합니다. OpenAI 출시 발표.
짧은 컨텍스트의 Standard API에서 같은 토큰을 쓰면 Astra의 요금은 Sol의 4배입니다. OpenAI의 FrontierCode 2.0 비교에서는 둘 다 Max로 설정했을 때 Sol이 0.5점 미만 차이로 뒤졌고 비용은 Astra의 약 5분의 1이었습니다. 뒤에서는 Tabbit Browser에서 두 모델에 같은 공식 문서를 주고 요금을 확인하는 방법도 다룹니다. Astra API 사양, Sol API 사양, OpenAI 평가.
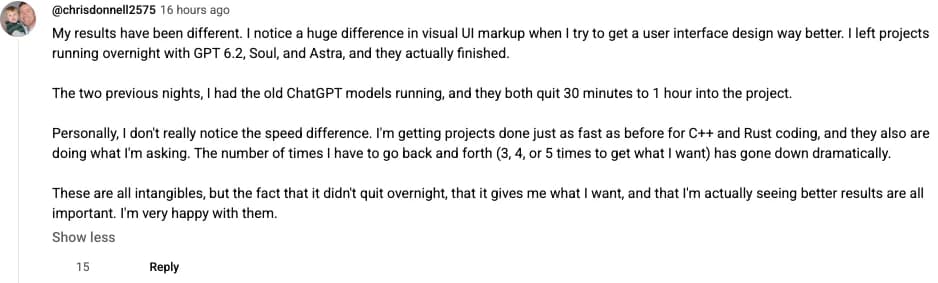
한 개발자는 6.2 두 모델이 밤새 맡겨 둔 프로젝트를 끝냈고 C++과 Rust 작업에서 수정 요청도 줄었다고 말했습니다. 테스트에서 사람이 개입한 횟수도 세어 보세요. 원문 댓글.
먼저 볼 내용
동일한 처리 등급과 토큰 사용량에선 Sol이 75% 저렴합니다.
Sol이 놓치는 조건을 Astra가 찾아내는지 같은 작업으로 확인하세요.
두 모델의 API 컨텍스트 창은 같습니다. 입력 272K를 넘으면 전체 요청의 요금이 올라갑니다.
Codex, ChatGPT Work, API의 이용 조건과 사용량은 각각 확인해야 합니다.
실패, 도구 사용, 검토를 포함해 합격한 결과당 비용과 시간을 비교하세요.
Astra와 Sol 사양 비교
| 비교 항목 | GPT-6.2 Astra | GPT-6.2 Sol |
|---|---|---|
| OpenAI API ID | gpt-6.2-astra | gpt-6.2-sol |
| Standard 입력 / 출력, 100만 토큰당 | $8 / $40 | $2 / $10 |
| 캐시 읽기 / 30분 쓰기 | $0.40 / $10 | $0.10 / $2.50 |
| API 창 / 최대 입력 / 최대 출력 | 1,050,000 / 922,000 / 128,000 | 1,050,000 / 922,000 / 128,000 |
| 입출력 | 텍스트와 이미지 입력, 텍스트 출력 | 텍스트와 이미지 입력, 텍스트 출력 |
| 추론 강도 | Low, Medium, High, Xhigh, Max | Low, Medium, High, Xhigh, Max |
| 먼저 시험할 작업 | 복잡한 변경, 실패 비용이 큰 작업 | 일상 코딩, 반복 검증 가능 작업 |
| OpenAI 이용 경로 | API, 자격을 갖춘 Codex와 ChatGPT Work | API, 자격을 갖춘 Codex와 ChatGPT Work |
요금과 API 사양은 2026년 11월 19일에 확인했습니다. 앱의 한도는 사용하는 환경에 따라 달라집니다. Astra 자료 (English), Sol 자료 (English), 이전 Astra 요금.
작업 한 건에 드는 API 비용
캐시되지 않은 입력 10만 개와 청구되는 출력 2만 개를 처리하면 Astra는 1.60달러, Sol은 0.40달러입니다. 입력 8만 개가 이미 만들어진 캐시에서 읽히면 0.992달러와 0.248달러로 내려갑니다. 추론 토큰은 출력 요금에 포함됩니다. 캐시 쓰기와 도구 비용은 따로 더하세요.
입력이 272K를 넘으면 전체 요청의 입력과 캐시 단가는 2배, 출력 단가는 1.5배가 됩니다. 캐시 없이 입력 30만 개와 출력 2만 개를 처리할 때 Standard의 모델 요금은 6.00달러와 1.50달러입니다. 같은 컨텍스트 길이에서 Batch는 Standard의 절반, Fast는 두 배입니다. Ultrafast는 태평양 시간 2027년 2월 28일까지 세 배이고 3월 1일부터 여섯 배입니다. OpenAI API 요금.
실패한 시도를 포함한 전체 모델·도구 비용을 합격 건수로 나눕니다. 사람이 검토하는 작업이라면 검토 시간도 계산합니다. 예를 들어 20건을 각각 0.40달러로 Sol에서 실행하고 16건이 통과했다고 합시다. 남은 4건을 각각 1.60달러인 Astra로 한 번씩 처리해 모두 통과하면 합계는 14.40달러, 합격 건당 0.72달러입니다. 처음부터 20건을 Astra로 처리하면 모두 처음에 통과해도 32달러가 듭니다. 이 방식은 실패한 4건을 제대로 찾을 수 있어야 합니다. 이전 Sol의 요금 항목.
다른 독자는 저렴한 실행이 실패하면 다른 에이전트가 수습해야 한다고 지적했습니다. 비용 계산에 그 과정도 넣으세요. 원문 댓글.

코딩, 데이터 분석과 속도
FrontierCode 2.0은 실제 저장소에서 수정 사항이 유지보수자의 병합 기준을 충족하는지 평가합니다. OpenAI의 Max 비교에서는 두 모델의 차이가 0.5점 미만이었고 Sol의 비용은 약 5분의 1이었습니다. 11월 19일 Artificial Analysis의 Intelligence Index는 Astra Max 62, Sol Max 57입니다. 자체 코드 평가는 FrontierCode-AA 2.0이라는 이름으로 진행됐습니다. 팀의 저장소에서 고를 때는 같은 커밋과 테스트를 쓰고, 요청과 무관한 변경도 검사하세요. OpenAI 평가, Artificial Analysis 비교, 이전 Astra 평가, 이전 Sol 평가.
Plotly의 분석 시험에서 Astra는 41/43, Sol은 40/43을 맞혔습니다. 전체 실행 비용은 4.11달러와 1.22달러, 문항당 중앙값은 12.4초와 10.5초였습니다. 모델당 한 번씩 실행했고, 차이는 숨은 패턴을 찾는 문항 하나였습니다. Ranthis는 판매 자료를 High로 세 번씩 검사했습니다. Astra는 세 번 모두 10/10, Sol은 같은 예외 행을 빠뜨려 매번 9/10이었습니다. 정가 기준 실행 비용의 중앙값은 0.0337달러와 0.0085달러였습니다. 자체 평가에도 예외 행을 넣고 개수와 합계를 확인하세요. Plotly 시험, Ranthis 실험.
두 실험에서는 Sol이 더 빨리 끝났습니다. 실제 작업에서는 첫 글자가 보일 때와 결과가 합격할 때를 따로 기록합니다. 도구 대기, 재시도, 사람의 수정은 두 번째 시간에 영향을 줍니다. 추론 강도를 맞춰서 한 차례 실행한 뒤 각자 실제 적용할 설정을 비교하세요. 처리 시간과 추론 강도별 결과.
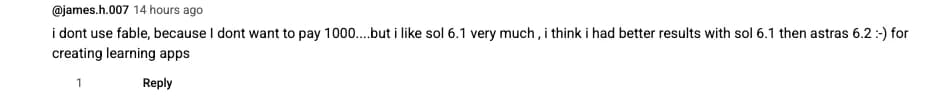
한 사용자는 실제 작업에 여러 차례 지시가 필요한 경우가 많다고 했습니다. 추가 대화와 수정까지 시간에 포함하세요. 원문 댓글.
Codex, ChatGPT Work, API에서 사용하기
자격을 갖춘 워크스페이스에서 Codex 또는 ChatGPT Work의 모델 선택 메뉴를 확인합니다. 구독 한도는 해당 제품의 기준을 따릅니다. API를 이용할 때는 ID, 추론 강도, 처리 등급을 기록하세요. 두 모델 모두 none을 거부합니다. Responses API에서 도구를 사용할 때는 두 모델에 같은 권한을 주세요. 모델을 바꾸기 전에 이전 설정에서 잘된 예시와 실패한 예시를 모두 남겨 둡니다. OpenAI 이용 안내, Codex 브라우저 도구 설정, GPT-6.1 Sol 작업 예시.
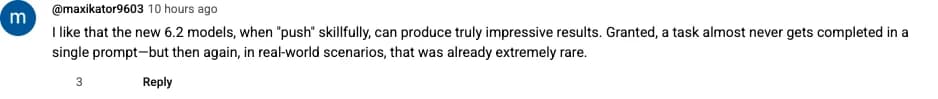
학습 앱을 만들던 한 개발자는 Astra 6.2보다 이전 Sol 6.1에서 더 좋은 결과를 얻었다고 말했습니다. 버전을 바꾸기 전에 지금 쓰는 결과를 기준으로 보관하세요. 원문 댓글.
Tabbit에서 같은 자료로 두 모델 비교하기
Tabbit Browser의 멀티 모델 채팅에서 Astra와 Sol을 고르고 두 모델에 같은 공식 API 문서를 첨부합니다. 모델 ID, 100만 토큰당 Standard 입력·캐시 읽기·출력 요금, 긴 컨텍스트 기준, 출처 링크를 요청하세요. 기대하는 값은 Astra 8 / 0.40 / 40달러, Sol 2 / 0.10 / 10달러입니다. 입력이 272K를 넘으면 두 모델 모두 전체 요청에 장문 요율이 적용됩니다. 멀티 모델 조사 방법, 웹 출처 남기는 방법.
첨부한 OpenAI 모델 사양 두 개만 사용하세요. 모델당 한 줄에 정확한 API 모델 ID, 짧은 컨텍스트 Standard의 캐시되지 않은 입력·캐시 읽기·청구 출력 요금을 100만 토큰당 미국 달러로 쓰고 출처 링크를 붙이세요. 표 아래에 긴 컨텍스트 요금이 적용되는 입력 기준과 전체 요청에 적용되는지 적으세요. 문서에 값이 없으면 미기재로 표시하세요.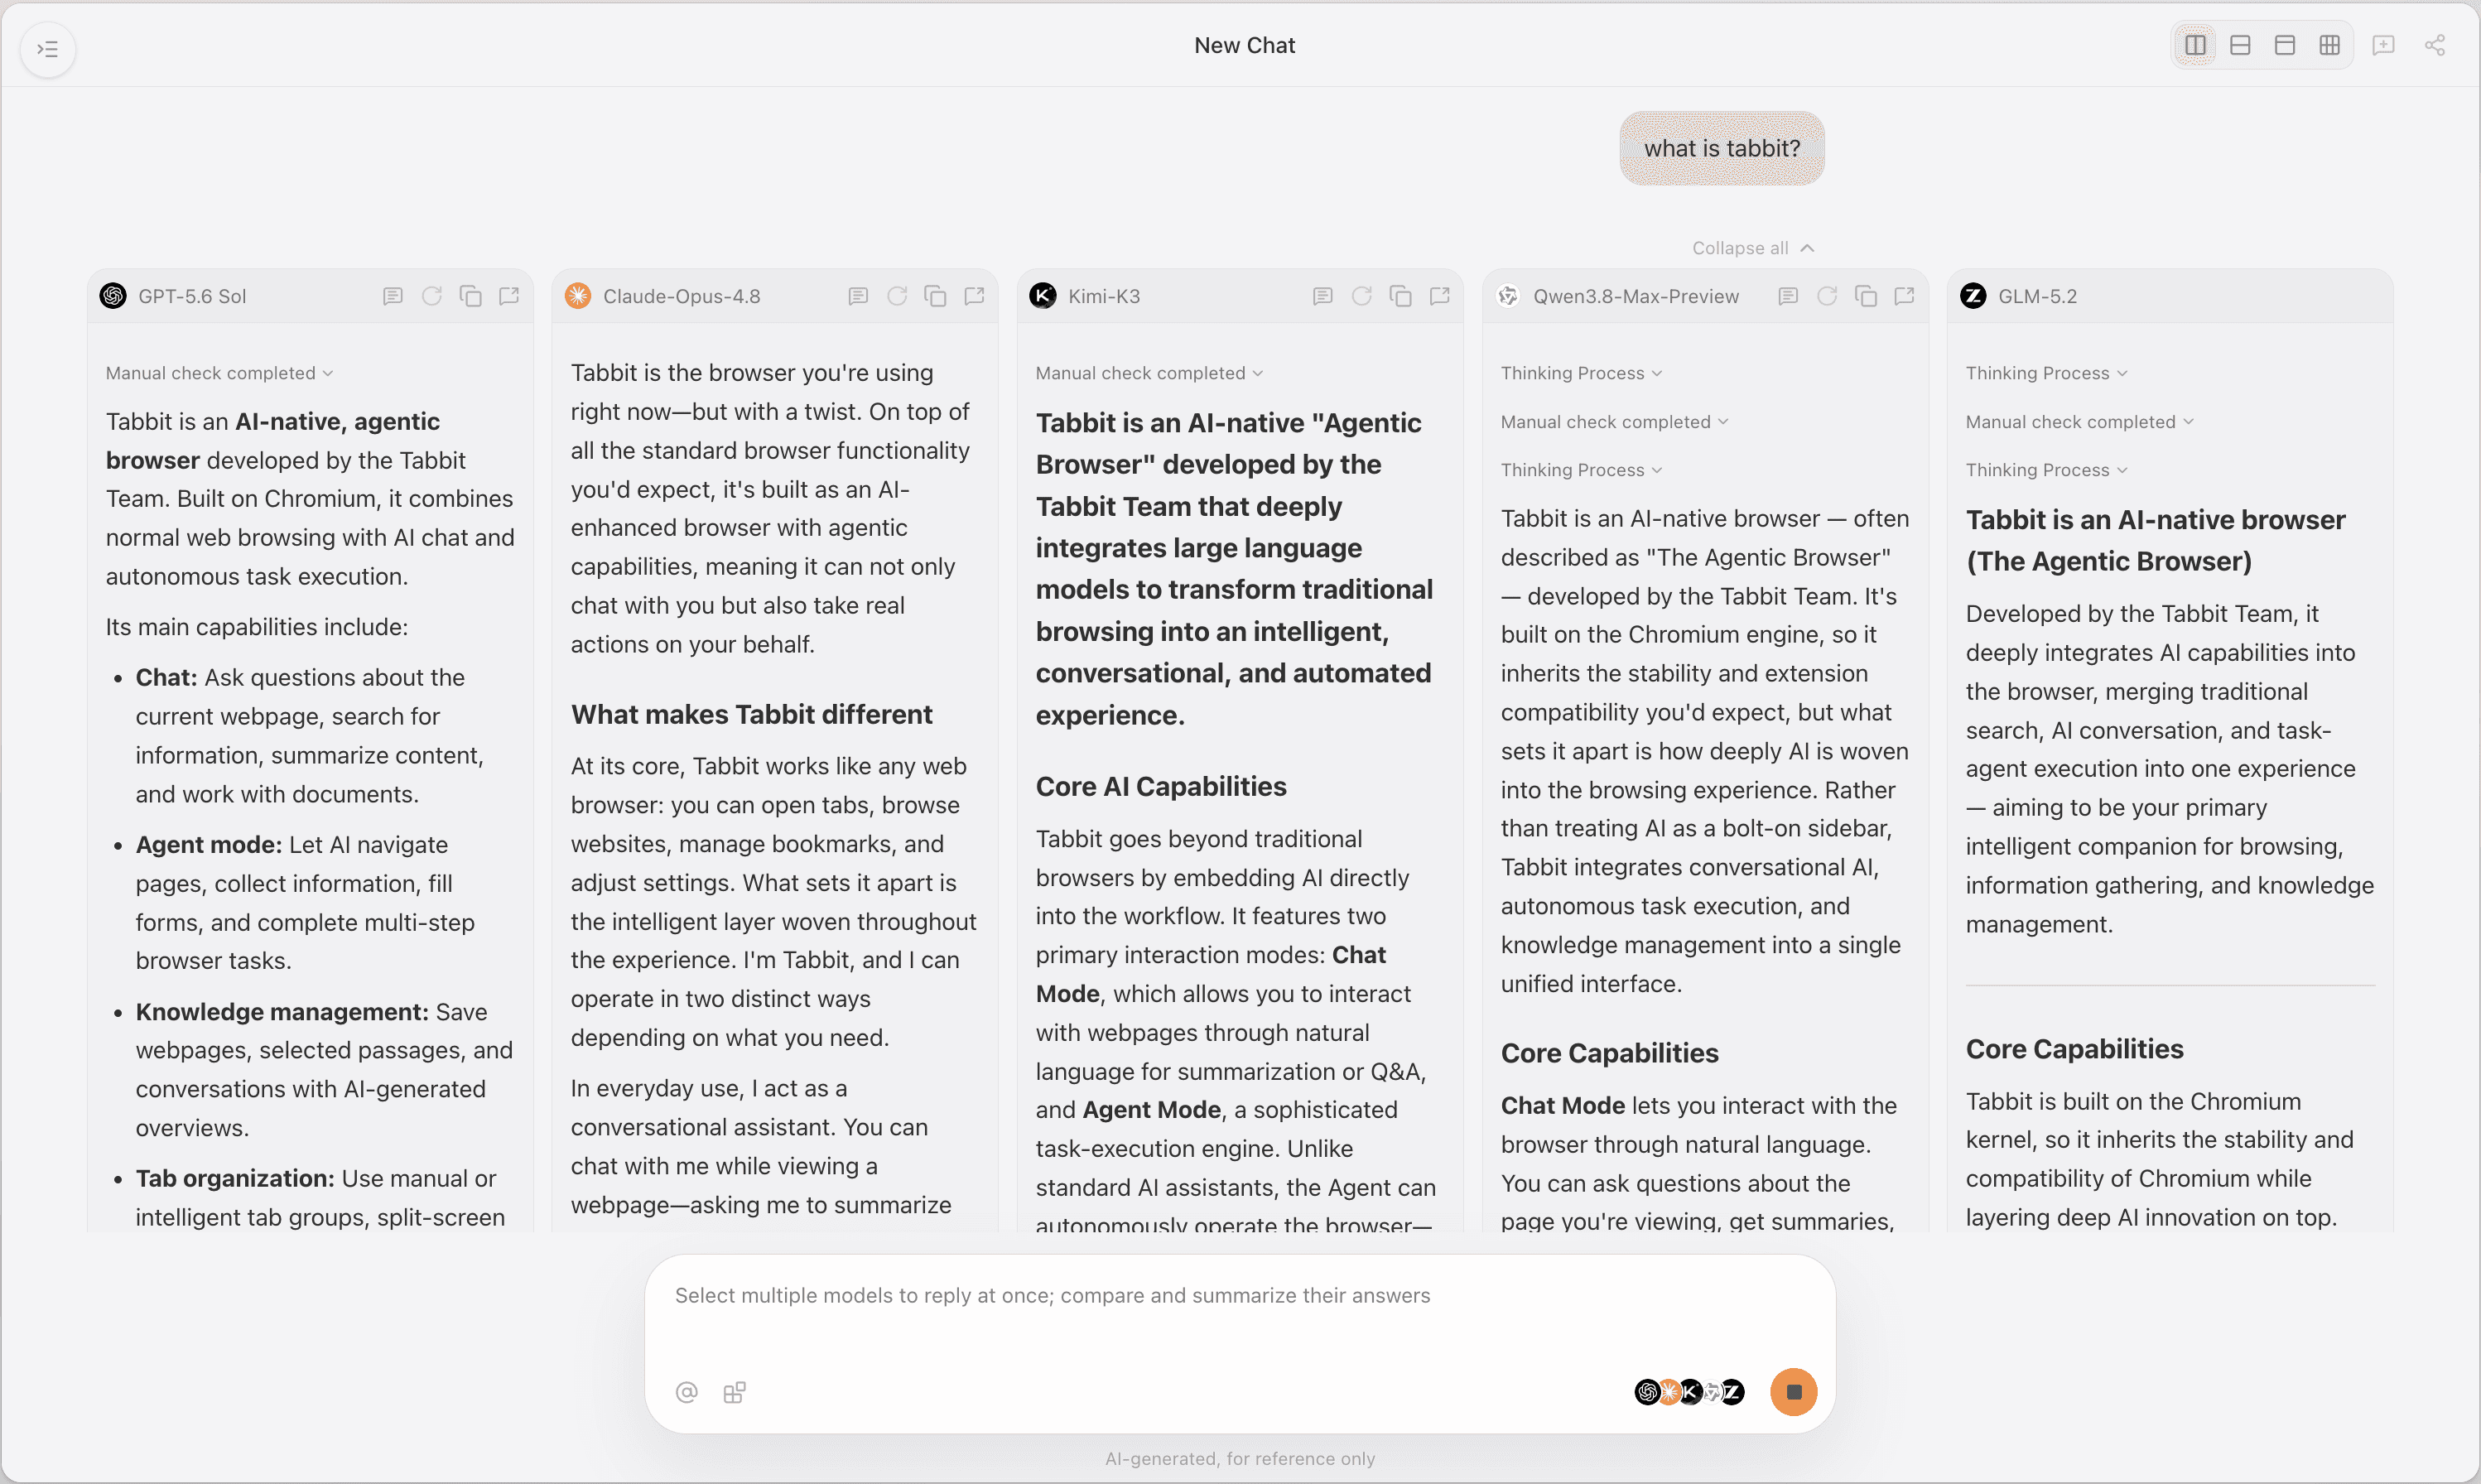
응답의 순서, 단위, 링크를 원문과 대조합니다. 실제로 청구된 추론 토큰이나 재시도 비용을 비교하려면 API 사용 기록을 확인하세요.
어떤 작업에 어떤 모델을 쓸까?
| 작업 | 먼저 시험할 선택 | 결정을 바꿀 조건 |
|---|---|---|
| 테스트가 있는 작은 수정 | Sol | Sol이 놓친 오류를 Astra가 반복해서 해결 |
| 여러 모듈에 걸친 복잡한 변경 | 난도가 높은 사례에 Astra | Sol이 같은 검토를 비슷한 시간에 통과 |
| 일괄 추출 또는 분류 | Sol | 누락이 검사 규칙을 계속 빠져나감 |
| 중요한 문서 또는 여러 출처 조사 | 초안은 Sol, 의심 사례는 Astra | 범위, 출처, 수정 시간을 비교 |
| 입력이 큰 API 요청 | Sol과 더 짧은 입력 | Astra의 합격 결과당 비용이 추가 지출을 정당화 |
| 기존 Codex 또는 Work 작업 | 검토를 통과하는 저렴한 모델 | 다른 모델에서 검토 부담이 줄어듦 |
Sol에 실제 작업을 몇 가지 맡기고 합격과 실패 사례를 남깁니다. 같은 사례를 Astra에서 다시 실행하세요. 웹 자료가 필요하다면 Tabbit에 모델 이름, 문서, 결과를 모아 같은 검사를 반복할 수 있습니다.

자주 묻는 질문
GPT-6.2 Astra와 GPT-6.2 Sol 중 무엇을 써야 하나요?
일상적인 코드 수정이나 검증이 쉬운 반복 작업에는 Sol부터 써 보세요. 요구 사항을 자주 빠뜨리거나 재작업 비용이 큰 경우에는 같은 입력을 Astra에도 넣어 보세요.
Sol은 Astra보다 얼마나 저렴한가요?
OpenAI API에서 처리 방식과 토큰 사용량이 같다면 Sol의 모델 요금이 75% 낮습니다. 합격한 결과 하나에 드는 비용은 추론, 캐시, 도구 호출, 재시도에 따라 달라집니다.
Codex와 ChatGPT에서 두 모델을 쓸 수 있나요?
OpenAI는 API와 함께 자격을 갖춘 Codex 및 ChatGPT Work 계정에 두 모델을 출시했습니다. 실제로 쓰는 워크스페이스의 모델 선택 메뉴를 확인하세요. 구독 사용량과 API 청구는 별개입니다.
두 모델의 컨텍스트 창 크기는 같은가요?
API 기준으로 두 모델 모두 105만 토큰 창을 지원합니다. 입력은 최대 92만 2,000개, 출력은 최대 12만 8,000개입니다. 입력이 272K를 넘으면 전체 요청에 더 높은 요율이 적용됩니다.
Sol은 언제나 Astra보다 빠른가요?
Plotly와 Ranthis의 테스트에서는 Sol이 먼저 끝났습니다. 실제 작업에서는 첫 글자가 보일 때까지와 검증을 통과한 결과를 얻을 때까지를 따로 측정하세요.
두 모델을 어떻게 공정하게 비교하나요?
같은 입력, 도구, 합격 조건을 사용합니다. 동일한 추론 강도로 먼저 비교한 뒤 실제 배포할 설정을 검증하세요. 실패와 재시도도 비용과 시간에 포함합니다.