
日常编码先用 GPT-6.2 Sol,返工成本高的难题再试 GPT-6.2 Astra。 两款模型由 OpenAI 在美国时间 2026 年 11 月 17 日发布。改动有明确测试、输出有固定格式时,Sol 适合做基线。需要核查多个约束、处理例外或复核交付物时,把两款放到同一组任务里比较。OpenAI 中文发布说明。
同档、同用量,Astra 的 API 模型费是 Sol 的 4 倍。 OpenAI 短上下文 Standard 单价按每百万 token 计,Astra 输入 8 美元、输出 40 美元,Sol 输入 2 美元、输出 10 美元。OpenAI 的 FrontierCode 2.0 对比中,两款都用 Max,Sol 与 Astra 相差不到半分,单次评测任务成本约为 Astra 的五分之一。后文用 Tabbit Browser 的多模型对话复核费率和长上下文条件。Astra API 规格、Sol API 规格、发布与基准测试。
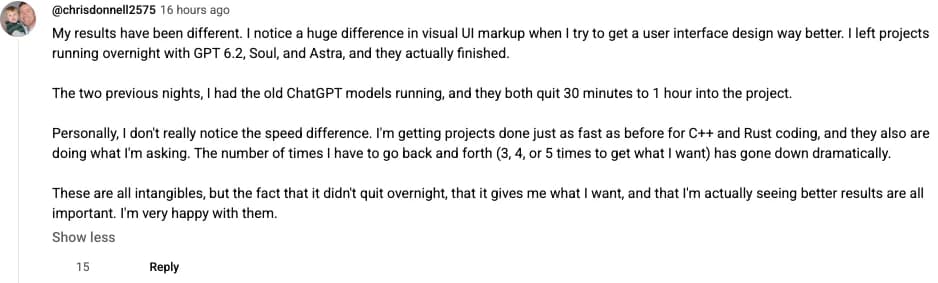
一位开发者说,两款 6.2 都跑完了他留到过夜的项目,C++ 和 Rust 任务需要反复沟通的次数也减少了。选型时可以直接测需要人工接手的频率。 原评论.
先看结论
相同 token 用量下 Sol 便宜 75%。有测试、规则或清单能验收的任务,从 Sol 开始。
对错误代价高的任务,测 Astra 能否减少具体漏项和人工复核时间。
两款 API 上下文窗口同为 105 万 token。输入超过 272K 后,整次请求提高费率。
Codex、ChatGPT Work、Tabbit 和 API 的入口与计量各自独立。选型看实际使用的环境。
总费用除以合格结果数,重试、工具费和必要的人工复核一并计算。
Astra 与 Sol 的主要区别
| 决策项 | GPT-6.2 Astra | GPT-6.2 Sol |
|---|---|---|
| OpenAI API ID | gpt-6.2-astra | gpt-6.2-sol |
| 短上下文 Standard 输入 / 输出,每百万 token | $8 / $40 | $2 / $10 |
| 缓存读取 / 30 分钟写入,每百万 token | $0.40 / $10 | $0.10 / $2.50 |
| API 窗口 / 最大输入 / 最大输出 | 1,050,000 / 922,000 / 128,000 | 1,050,000 / 922,000 / 128,000 |
| 模态 | 文本和图片输入,文本输出 | 文本和图片输入,文本输出 |
| 推理档 | Low、Medium、High、Xhigh、Max | Low、Medium、High、Xhigh、Max |
| 优先试用场景 | 复杂改动、漏项代价高的工作 | 日常编码和可重复验收的任务 |
| OpenAI 使用入口 | API、符合条件的 Codex 与 ChatGPT Work 账号 | API、符合条件的 Codex 与 ChatGPT Work 账号 |
费率和规格核对于 2026 年 11 月 19 日。客户端的实际限制取决于产品入口。Astra 提示词与测评、Sol 提示词与测评、上一代 Astra 定价。
API 价格和每个任务的实际成本
短上下文、缓存和长上下文
以 10 万未缓存输入、2 万计费输出 token 为例,Astra 花 1.60 美元,Sol 花 0.40 美元。如果 8 万输入按已存在的缓存读取计费,费用变成 0.992 美元 和 0.248 美元。这个算例未计入工具和建缓存的费用。输出账单包含推理 token,两个模型最终只写出几段话,也可能消耗不同的输出量。
输入超过 272K 后,整次请求的输入及缓存费率翻倍,输出费率乘以 1.5。30 万未缓存输入加 2 万输出,Standard 费用分别是 6.00 美元 和 1.50 美元。同样上下文长度下,Batch 按 Standard 的一半计,Fast 按两倍计。Ultrafast 到 2027 年 2 月 28 日为三倍,3 月 1 日起为六倍,按太平洋时间。预算中应记下上下文档、缓存命中和处理档位。OpenAI API 定价。
把失败和复核放进账单
每个合格结果成本 = 所有计费尝试及工具费之和 ÷ 合格结果数。需要人审时,再加上工时。假设有 20 个任务,Sol 每次 0.40 美元,先通过 16 个,剩下 4 个用每次 1.60 美元的 Astra 各补一次并通过,总计 14.40 美元,平均 0.72 美元。全部直接跑 Astra 需要 32 美元。两阶段方案的前提是验收能准确找出失败的 4 个任务。对照费用字段时也可参考上一代 Sol 的定价说明。
另一条评论提到,一次便宜的运行如果失败,仍要另一个 Agent 补做。核算成本时把补做这一步也算进去。 原评论.

编程表现、数据分析和速度
用同一验收标准判断补丁
FrontierCode 2.0 检验修改是否达到真实仓库维护者的合并要求。OpenAI 披露的 Max 测试中,Sol 与 Astra 的分差小于半分,Sol 成本约为五分之一。Artificial Analysis 使用自己的环境,11 月 19 日快照中 Astra Max 的 Intelligence Index 为 62,Sol Max 为 57。该机构的编程子项叫 FrontierCode-AA 2.0。阅读数字时一并核对评测环境和档位。上线选型应在同一提交、测试套件和评审规则下重跑,尤其要查与任务无关的修改。OpenAI 基准、Artificial Analysis 横评、上一代 Astra 测评、上一代 Sol 测评。
表格里的例外值更能说明问题
Plotly 的数据分析试卷中,Astra 答对 41/43、整套花 4.11 美元,Sol 答对 40/43、花 1.22 美元。单题中位数分别为 12.4 秒和 10.5 秒。两款各跑一次,差距来自一道隐藏模式题。Ranthis 则用固定销售表跑了多次。High 档各三次里,Astra 每次 10/10,Sol 每次 9/10,反复漏掉同一条例外记录。按标价算,单次中位费用分别为 0.0337 和 0.0085 美元。自己的验证集也应该保留例外行,并核对条数与总额。Plotly 数据分析测试、Ranthis 表格实验。
用户等的是可用结果
任务在这两项实验里都是 Sol 更快。实际运行还要分别测发出请求到首段可见文字,以及从发出请求到拿到合格结果的时间。等待工具、重试和手工修订都可能拉长后一项。先用同一推理档比较,再记录两款各自准备上线的设置。在同一个代码库里交替试跑,固定时间上限和工具权限。Artificial Analysis 档位与时延。
还有一位编码用户提到,实际任务通常需要多轮提示。记录追问和修订次数,才能看出从首段输出到可交付结果多花了多久。 原评论.
Codex、ChatGPT Work 和 API 怎么选
在符合条件的 Codex 或 ChatGPT Work 账号里,通过当前工作区的模型选择入口使用。订阅额度与 API 的美元单价分别计算。Codex 跑仓库任务时,固定可访问工具和起始提交。API 调用明确填写模型 ID,记录处理档和推理档,两款均不接受 none。Responses API 所支持的工具以官方文档和接入配置为准。迁移前保留旧模型的输入、档位与交付样本。OpenAI 使用范围、Codex 浏览器工具配置、GPT-6.1 Sol 浏览器工作流。
一位做教育应用的开发者更喜欢自己用上一代 Sol 6.1 得到的结果。切换版本时,留好旧版结果作为参照。 原评论.
在 Tabbit 用同一个任务对比 Astra 与 Sol
在 Tabbit Browser 的多模型对话里选择这两款模型,附上同样的 Astra、Sol 官方规格页。让它们提取模型 ID、短上下文 Standard 的输入/缓存读/输出费率,给出长上下文计费线和一条来源链接。预期 Astra 为 8/0.40/40 美元,Sol 为 2/0.10/10 美元,两款均在超过 272K 输入时按整次请求加价。Tabbit 多模型调研、如何保留网页出处。
只使用附上的两份 OpenAI 模型规格。每款模型一行,列出准确的 API 模型 ID、短上下文 Standard 的未缓存输入、缓存读取和计费输出费率,单位为美元/百万 token,最后附规格页链接。表格下方写明长上下文费率的输入阈值,以及是否适用于整次请求。规格没有列出的数据标为未说明。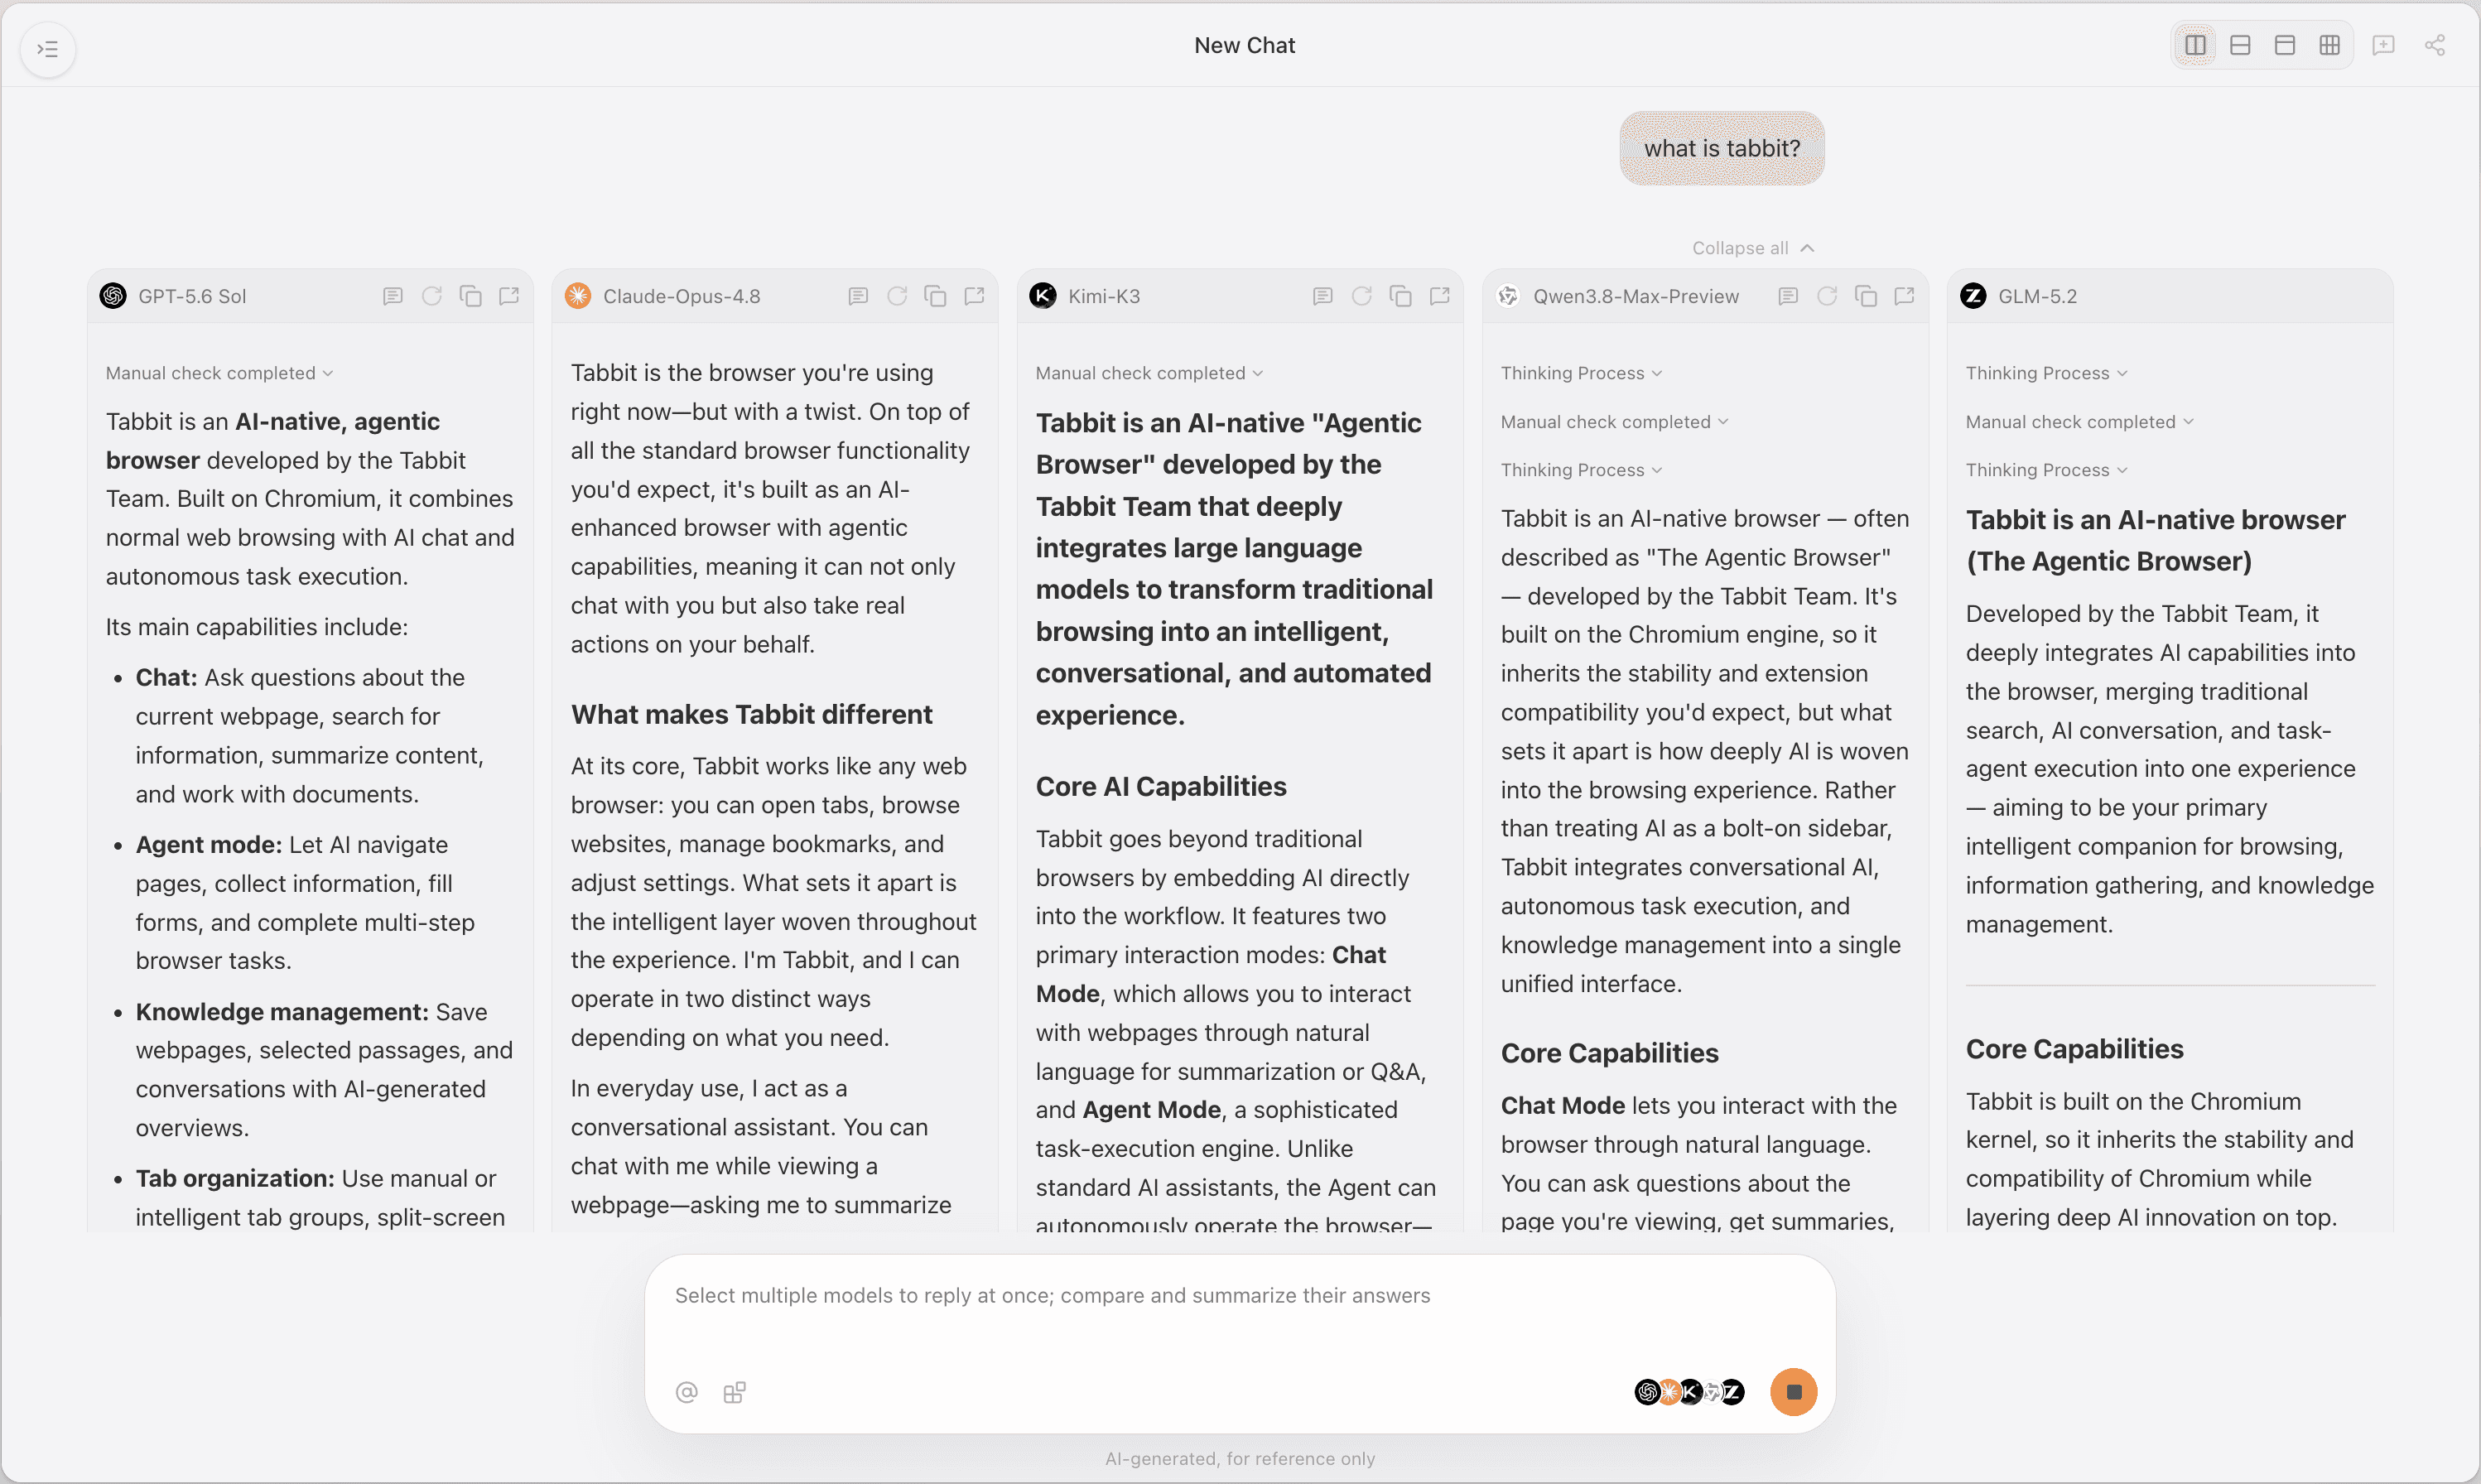
用同一份清单核对两条回答。检查顺序、单位、模型 ID,确认两条链接打开的是对应型号,并确认回答提到了「整次请求」。比较模型输出质量可以用这个例子。需要真实的推理 token、缓存账单和重试成本时,再从 API 记录取数。
哪些任务值得用 Astra?
| 任务 | 先试哪款 | 改变决定的条件 |
|---|---|---|
| 有清晰测试的小改动 | Sol | 相同测试下 Astra 能稳定修好 Sol 漏掉的问题 |
| 跨模块改动 | Astra 跑难例 | Sol 的验收率和评审时间追平 |
| 批量分类、提取或表格处理 | Sol | 漏项持续绕过规则或需要大量补录 |
| 重要文档和多源研究 | Sol 起草,Astra 复核异常 | 比较覆盖范围、出处和人工修订量 |
| 大上下文 API 调用 | Sol,再测精简输入 | Astra 通过的结果足够抵消成本 |
| 已有 Codex 或 Work 任务 | 从能验收、成本低的一款开始 | 同一任务上明显省下复核时间或返工 |
新流程先拿真实任务跑 Sol,记录具体失败,再用 Astra 重跑失败样本和一部分已通过样本。涉及网页资料时,把输入、来源和结果放在 Tabbit 同一个工作区,方便下一位复核者重做。

常见问题
GPT-6.2 Astra 和 GPT-6.2 Sol 哪个更好?
日常编码、结构化输出和可自动验收的重复任务,优先试 Sol。遇到反复漏项或返工代价高的任务,再用 Astra 跑同一组样本。
GPT-6.2 Sol 比 Astra 便宜多少?
同一 OpenAI API 档位、同样的 token 用量,Sol 的模型费用低 75%。每个合格结果的成本还取决于推理 token、缓存、工具和重试。
Codex 和 ChatGPT 可以用这两款模型吗?
OpenAI 在 Codex、ChatGPT Work 和 API 推出了两款模型。客户端可用性以对应账号及工作区为准,订阅额度与 API 费用分别计算。
两款模型的上下文窗口一样吗?
OpenAI API 给两款都列出 105 万 token 的上下文窗口,输入上限 92.2 万,输出上限 12.8 万。输入超过 272K token 后,整个请求按更高的长上下文费率计算。
GPT-6.2 Sol 一定比 Astra 快吗?
Plotly 的数据分析和 Ranthis 的表格测试都观察到 Sol 更快。自己的任务仍需分别测首段可见文字、端到端耗时和合格结果耗时。
怎么做 Astra 和 Sol 的同题对比?
固定输入、工具和验收标准,先选相同推理档位,再比较实际准备上线的配置。把失败、重试和人工复核计入每个合格结果的成本。