
GPT-6 Astra cuesta 10 dólares por millón de tokens de entrada y 50 dólares por millón de tokens de salida en el nivel estándar de la API, con entrada cacheada a 1 dólar, escritura de caché a 12,50 y todas las tarifas comprobadas en las páginas de OpenAI el 22 de septiembre de 2026. Eso es la tarjeta de tarifas. La factura es otra cosa: sobre la misma tarjeta, Artificial Analysis mide el coste de una tarea de referencia en 0,82 dólares con esfuerzo de razonamiento low y 3,26 dólares con max — una oscilación de unas 4 veces sin tocar ni un precio.
La distancia entre esos dos números es la razón de este artículo. Un desarrollador de Reddit lo resumió al lanzarse Astra: «GPT-5.6 Sol: 4 $/M de entrada, 20 $/M de salida. GPT-6 Astra: 10 $/M de entrada, 50 $/M de salida. Es literalmente un salto de precio de 2,5x en entrada y salida.» (hilo de r/codex, 456 votos). La aritmética es correcta. La conclusión —caro o barato— no la decide la aritmética, porque el nivel de esfuerzo, el nivel de servicio, la longitud del contexto y la tasa de aciertos de caché mueven la factura más que la propia elección de modelo. Más adelante presentamos Tabbit Browser como un lugar práctico para comparar rutas de modelos una vez claro el presupuesto; primero, los números.
Ideas clave
Tarifas estándar: 10 $ de entrada, 1 $ de entrada cacheada, 12,50 $ de escritura de caché, 50 $ de salida por millón de tokens; los prompts de más de 272K de entrada pasan toda la solicitud a 20/2/25/75 $.
La misma tarjeta factura con 4x de diferencia. Batch y Flex reducen cada tarifa a la mitad; Fast mode la duplica. Artificial Analysis mide la misma tarea entre 0,82 $ (esfuerzo low) y 3,26 $ (max) con precios de token idénticos.
La prima de 2,5x se mide contra una base promocional. Los 4/20 $ de Sol figuran como precio promocional «al menos hasta el 21 de noviembre de 2026»; la entrada de la anterior GPT-5.5 era de 5 $.
Las suscripciones son otra economía. ChatGPT Plus cuesta 20 $/mes con Astra limitado; Pro se muestra desde 100 $/mes. Mediciones de la comunidad sitúan el coste efectivo de Astra en la suscripción cerca de 1,9x su precio de API, con una retención de caché reportada de unos 30 minutos.
Presupuesta por forma de tarea, no por precio de token. Las respuestas cortas las domina la salida; los bucles agénticos con caché, las lecturas de caché; y todo lo que pase de 272K de entrada paga la prima de contexto largo en la solicitud completa.
El precio de GPT-6 Astra de un vistazo
La tarjeta de tarifas estándar completa, tomada de la página de precios de la API de OpenAI el 22 de septiembre de 2026. La vista general de GPT-6 Astra cubre qué es el modelo; esta tabla cubre el dinero.
| Modelo | Entrada / 1M | Entrada cacheada / 1M | Escritura caché / 1M | Salida / 1M |
|---|---|---|---|---|
| gpt-6-astra | $10,00 | $1,00 | $12,50 | $50,00 |
| gpt-5.6-sol | $4,00 | $0,40 | $5,00 | $20,00 |
| gpt-5.6-terra | $2,00 | $0,20 | $2,50 | $12,00 |
| gpt-5.6-luna | $0,20 | $0,02 | $0,25 | $1,20 |
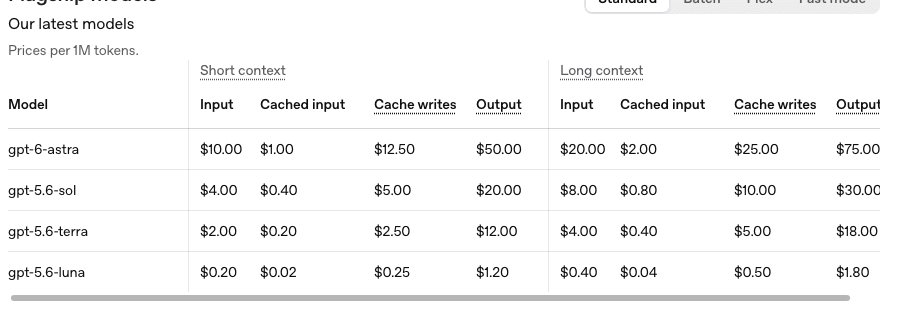
Tres cosas de esta tabla hacen el daño, y ninguna es el 10 del titular:
La salida cuesta 5x la entrada. Astra es un modelo de razonamiento; piensa en tokens de salida facturables. Un prompt modesto con una cadena larga de pensamiento es una factura de salida disfrazada de entrada.
Escribir en caché cuesta más que la entrada. Los 12,50 $ son 1,25x la tarifa sin caché — la página de precios establece la regla del 1,25x explícitamente. La caché solo compensa cuando el prefijo se reutiliza de verdad.
El salto de 272K se aplica a toda la solicitud. Al pasar de 272.000 tokens de entrada, la solicitud completa —no solo el exceso— se factura a 20 $ de entrada, 2 $ de caché, 25 $ de escritura, 75 $ de salida. Una ventana de contexto de 1,05M no es un presupuesto de 1,05M a tarifa estándar.
El número que importa: la misma tarjeta factura de 0,82 a 3,26 dólares por tarea
Si recuerdas un número de este artículo, que sea la oscilación, no la tarifa. Artificial Analysis sigue a GPT-6 Astra como cinco entradas —una por esfuerzo de razonamiento— y su coste medido por tarea del índice de inteligencia (instantánea del 22 de septiembre de 2026) queda así:
| Esfuerzo de razonamiento | Índice de inteligencia | Coste por tarea | Velocidad de salida |
|---|---|---|---|
| low | 46 | $0,82 | 55 t/s |
| medium | 50 | $1,54 | 52 t/s |
| high | 51 | $1,73 | 59 t/s |
| xhigh | 52 | $2,31 | 55 t/s |
| max | 53 | $3,26 | 67 t/s |
Lee juntas las dos columnas exteriores: max cuesta 3,98x lo que cuesta low por tarea, a cambio de 7 puntos de índice medido. En la misma instantánea, low también registra el menor tiempo hasta el primer token (2,46 s). El ajuste caro no es automáticamente el prudente; es el que piensa más tiempo en tokens facturables.
Esto pesa el doble en trabajo agéntico. El mejor resultado público de Astra —unos 40 minutos por tarea de OSWorld 2.0 en la simulación de OpenAI, frente a 75 de Sol— describe justo la carga donde esfuerzo y reintentos se componen: cada vuelta del bucle relee contexto, cada paso emite tokens de razonamiento, y un modelo que «corre para siempre» también factura para siempre. Un usuario de Hacker News报告 agotar una ventana de cinco horas de ChatGPT en 15 mensajes (discusión en HN); la misma forma sobre facturación de API es la razón por la que la guía de razonamiento agéntico exige criterios de aceptación antes de los bucles largos. Presupuesta por tarea terminada, incluyendo intentos fallidos, no por primer intento.
Traducir la prima de 2,5x sobre GPT-5.6 Sol
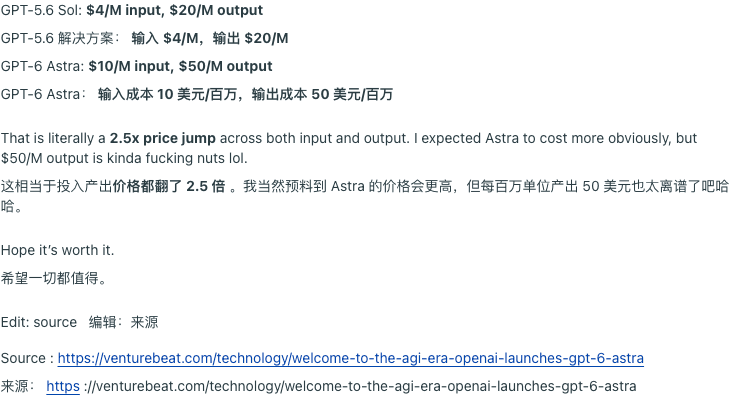
La cifra de 2,5x es aritmética honesta, pero antes de presupuestar conviene ponerle al lado dos advertencias.
Advertencia uno: la línea base es promocional. La página de Sol nota que «el precio promocional de GPT-5.6 Sol está disponible al menos hasta el 21 de noviembre de 2026», y su columna de comparación rápida muestra la entrada de la anterior GPT-5.5 en 5,00 $. La rebaja de Sol llegó el 30 de julio de 2026, cuando Sam Altman anunció Luna bajando un 80% (a 0,20/1,20 $), Terra un 20% (a 2/12 $) y Fast mode para Sol a 2x precio por hasta 2,5x velocidad (@sama). Si la promo de Sol caduca, la «prima de 2,5x» se encoge sin que Astra se abarate. El análisis de contexto de GPT-5.6 Sol sigue a esa familia por separado.
Advertencia dos: el coste por tarea puede converger. El hilo de arriba es el shock de la tarjeta. Pero los 0,82 $ por tarea de low que mide Artificial Analysis muestran hasta dónde puede caer la factura bajo el precio de lista, y la dirección se invierte del todo cuando la capacidad ahorra reintentos: un trabajo que Sol falla dos veces y Astra acaba a la primera sale más barato en Astra incluso a tarifas de 2,5x. Si eso describe tus tareas es una cuestión empírica —se responde con los ejemplos calculados de abajo, no con la tarjeta de tarifas.
Las líneas de facturación fuera del titular
Cuatro líneas deciden la mayoría de las facturas reales, y la cobertura de lanzamiento solo mencionó la primera.
Batch y Flex: la palanca del 50%. Ambos se tarifican a la mitad del estándar — 5 $ de entrada, 0,50 $ de caché, 6,25 $ de escritura, 25 $ de salida. Batch es para trabajo que puede esperar horas (la API expone v1/batch, con límites de cola desde 1,5M de tokens en el Tier 1 hasta 15B en el Tier 5); Flex es otro modo de capacidad de bajo coste con sus propias compensaciones de disponibilidad. Para evaluaciones por lotes, enriquecimiento offline y todo lo que no mira un usuario, este único interruptor ahorra más que cualquier optimización de prompts. Los descuentos no se apilan: elige un modo cada vez.
Fast mode: el acelerador de 2x. Tarificado al doble de las tarifas aplicables — 20/100 $ en estándar, y nota lo de «aplicables»: Fast sobre un trabajo Batch duplica las tarifas de Batch, no vuelve a las estándar. Priority processing pasó a llamarse Fast mode el 30 de julio de 2026, y tanto service_tier: "priority" como "fast" siguen funcionando, lo que importa si tienes código antiguo.
Procesamiento regional: +10%. Los endpoints de residencia de datos llevan un recargo del 10% para modelos publicados a partir del 5 de marzo de 2026 con elegibilidad — Astra cumple por fecha de lanzamiento. Las regiones impulsadas por cumplimiento pagan la prima en cada línea.
El salto de 272K y el reloj de caché. Por encima de 272K de entrada, la fila de contexto largo (20/2/25/75 $) se aplica a la solicitud completa — no hay cálculo de «solo el exceso». Y la caché que abarataría las relecturas tiene un reloj reportado por la comunidad: usuarios de Codex observaron una retención de unos 30 minutos en Astra frente a las 24 horas de Sol y anteriores.
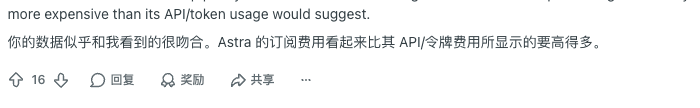
OpenAI no publica una tabla de TTL, así que trata los 30 minutos como un comportamiento reportado con dos fuentes independientes (hilo, comentario), no una garantía. Si tu bucle duerme más de eso entre pasos, la lectura de 1 $ puede volverse silenciosamente en una lectura fría de 10 $ más una escritura de 12,50 $.
Las llamadas a herramientas quedan fuera de todo esto: OpenAI indica que los modelos con herramientas facturan por llamada cosas como la búsqueda web, así que un agente que busca 40 veces lleva un segundo contador en marcha.
La escalera de la familia: qué fila es la tuya
La fila contraintuitiva de la escalera es Luna: 50 veces más barata en entrada que Astra, y existe de verdad. El catálogo oficial de modelos describe a Luna para cargas sensibles al coste y de alto volumen, y la propia guía de selección de OpenAI recomienda Terra o Luna por defecto salvo que el trabajo justifique el insignia. La fila barata no es un juguete; es un destino de enrutado, y cada token enrutado allí en vez de a Astra ahorra 50x en entrada.
El segundo hallazgo contraintuitivo viene de fuera de la familia. Astra y la Fable 5.1 de Anthropic se listan al mismo 10/50 — y cuestan cantidades opuestas en la práctica:
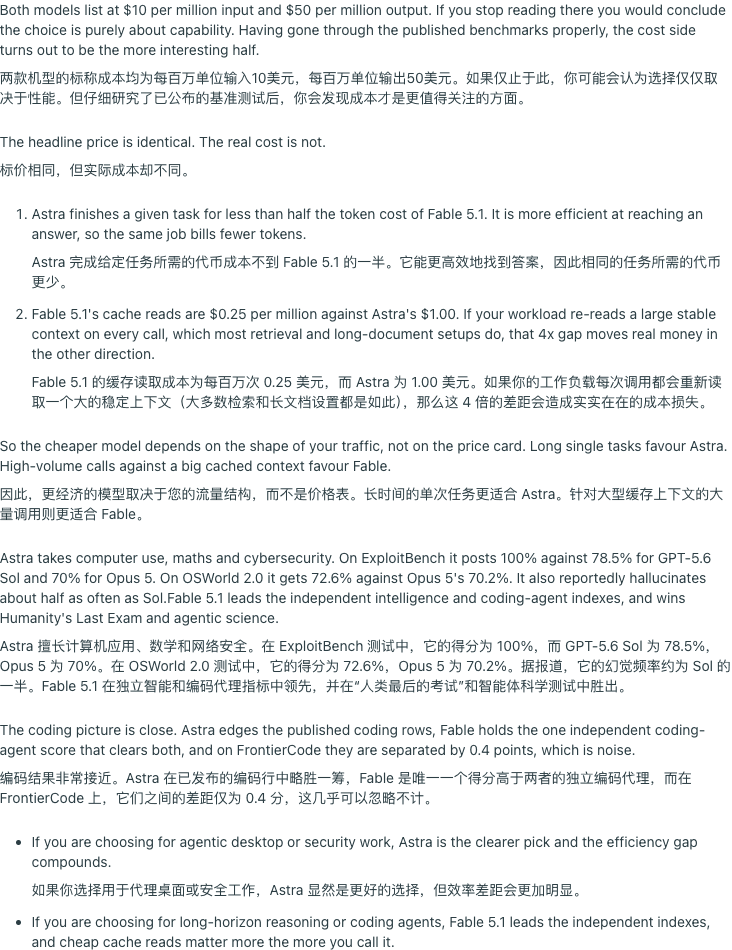
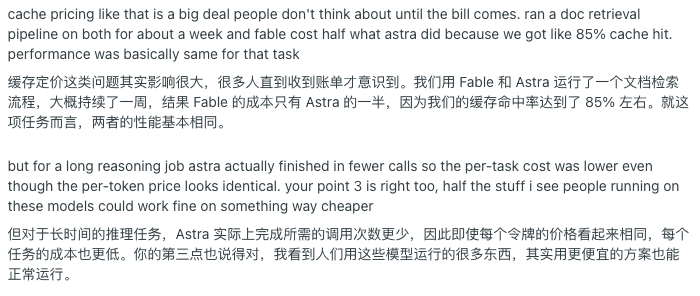
Las cuentas del autor: Astra acaba una tarea con menos tokens («menos de la mitad del coste en tokens de Fable 5.1» en sus tareas únicas largas), mientras que las lecturas de caché de Fable a 0,25 $ por millón triplican por cuatro la ventaja frente al 1,00 $ de Astra — así que el tráfico de alto volumen contra un contexto grande cacheado favorece a Fable, y las tareas únicas largas a Astra. Un comentarista ejecutó durante una semana un pipeline de recuperación documental en ambos y pagó aproximadamente la mitad en Fable con un 85% de aciertos de caché, «el rendimiento fue básicamente el mismo para esa tarea»:
La lección transferible no exige elegir laboratorio: la tarjeta de tarifas es la menor de las entradas de la función de coste. La forma del tráfico —longitud de tarea, ratio de aciertos de caché, volumen de salida— domina. La colección de reseñas comunitarias (English) guarda más informes de este tipo con sus condiciones adjuntas.
Lo que la tarjeta de tarifas no cubre
Una suscripción no es crédito de API. Los planes de ChatGPT otorgan uso, valorado en asignaciones y ventanas — la próxima sección muestra que esas asignaciones son una economía propia. Nunca dividas un plan de 20 $ entre precios de token.
Los intentos fallidos pueden facturar. En una ejecución de Codex de 33 minutos documentada en la semana de lanzamiento, dos intentos con tiempo agotado consumieron presupuesto antes del exitoso (r/ChatGPT). Los reintentos son una línea de coste, no gratis.
El nivel gratuito de la API está cerrado. La tabla de límites marca Astra como «no compatible» en Free; el pago empieza en el Tier 1 con 500 solicitudes por minuto y 500K tokens por minuto.
Impuestos, herramientas y márgenes de proveedor van aparte. La página de OpenRouter muestra a Azure y OpenAI listando ambos 10/50/1 $ para Astra con perfiles de latencia distintos (P50 hasta el primer token de 4,80 s frente a 6,92 s en la instantánea de hoy) — mismas tarifas, distinto enrutado. Las regiones comerciales de Amazon Bedrock se declaran a la par con el precio directo de OpenAI.
Disponibilidad de planes: niveles de API y planes de ChatGPT
| Nivel API | RPM | TPM | Límite de cola Batch |
|---|---|---|---|
| Free | No compatible | — | — |
| Tier 1 | 500 | 500.000 | 1,5M de tokens |
| Tier 2 | 5.000 | 1.000.000 | 3M de tokens |
| Tier 3 | 5.000 | 2.000.000 | 100M de tokens |
| Tier 4 | 10.000 | 4.000.000 | 200M de tokens |
| Tier 5 | 15.000 | 40.000.000 | 15B de tokens |
Fuente: página del modelo gpt-6-astra de OpenAI, comprobada el 22 de septiembre de 2026. Los niveles suben con el gasto, así que el techo de la semana de lanzamiento no es permanente.
En el lado de consumo, la página de precios de ChatGPT muestra hoy cuatro planes: Free a 0 $ (texto ilimitado con GPT-5.6 Luna — sin Astra), Go a 8 $/mes, Plus a 20 $/mes con «modelos de razonamiento avanzados con GPT-6 Astra y GPT-5.6» (la matriz comparativa marca Astra como limitado), y Pro mostrado como «desde 100 $/mes» con 5x uso y «razonamiento Pro impulsado por GPT-6 Astra». La comunidad sigue mencionando un Pro de 200 $, y las descripciones de YouTube listan «100 y 200 $» a la vez — la página en vivo es el único árbitro, y hoy muestra precio «desde».
La economía de las suscripciones merece su propia etiqueta de advertencia, porque tres mediciones comunitarias independientes apuntan en la misma dirección:
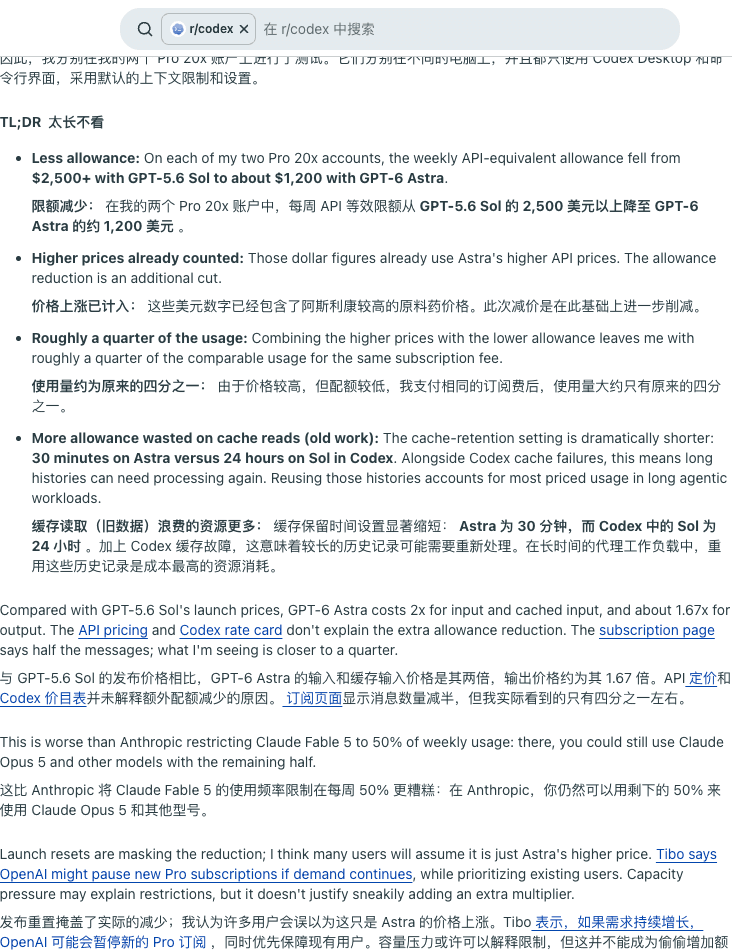
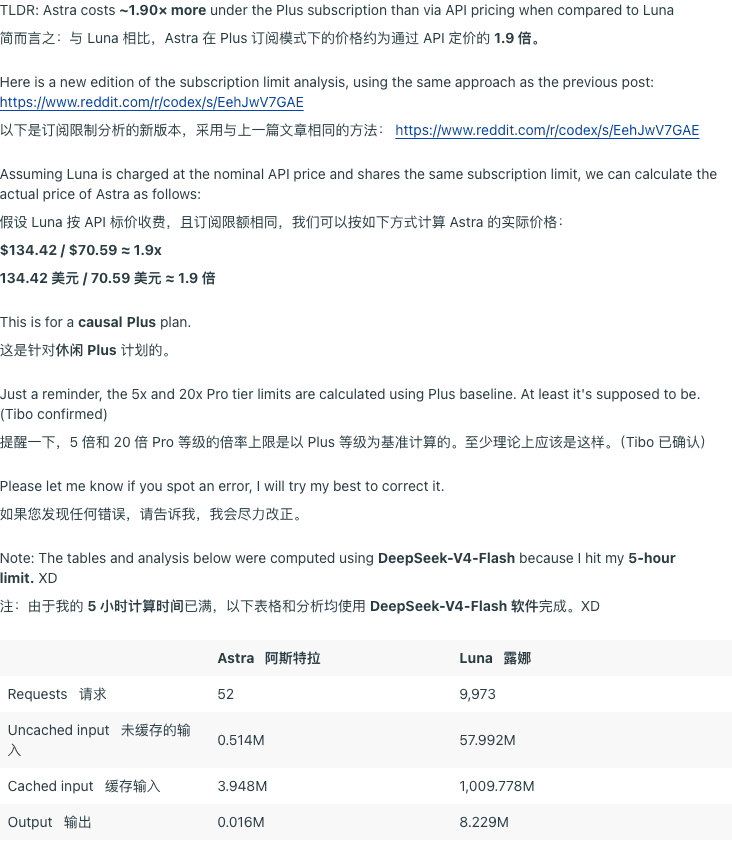
Primero, la matemática de cuotas: en dos cuentas Pro, la asignación semanal equivalente de API cayó de más de 2.500 $ con Sol a unos 1.200 $ con Astra — con los precios mayores ya descontados — dejando «aproximadamente un cuarto del uso comparable por la misma cuota de suscripción». Segundo, la tarifa efectiva: un suscriptor de Plus ingeniería inversa Astra a ~1,90x su precio de API frente a Luna con la misma asignación (134,42 $ frente a 70,59 $ de uso medido). Tercero, la experiencia de quemar cuota:
«Astra es muy bueno, pero para cualquier uso serio, la suscripción de 200 $ al mes simplemente no da suficientes tokens» es el resumen de un desarrollador de videojuegos — la capacidad y la frustración en la misma frase. Si tu uso de Astra es ocasional y supervisado, Plus puede bastar; si es el motor de un pipeline diario, la API con Batch es la ruta predecible, y la suscripción es la ruta de interacción premium.
Dos presupuestos calculados, con todos los supuestos a la vista
Usan tarifas estándar de contexto corto, sin reintentos, herramientas ni impuestos. Aritmética ilustrativa, no predicciones.
Una pregunta corta con mucho pensamiento. 10.000 tokens de entrada, 2.000 de salida:
(10.000 × $10 + 2.000 × $50) / 1.000.000 = $0,20Un bucle agéntico en frío que cruza el salto. 300.000 tokens de entrada — ya por encima de 272K, así que aplican tarifas de contexto largo a todo — con 8.000 de salida:
(300.000 × $20 + 8.000 × $75) / 1.000.000 = $6,60El mismo bucle bajo 272K (digamos 260.000 tokens) costaría 4,00 $. Cruzar el umbral encareció esta forma un 65%. Ahora la versión cálida: el mismo contexto de 300.000 tokens, 90% cacheado, escritura de caché una vez por hora, 8.000 de salida:
(270.000 × $2 + 30.000 × $20 + 8.000 × $75) / 1.000.000 = $1,68 + escriturasCálculo local
Estima el coste de tokens de la API GPT-6 Astra
Usa las tarifas oficiales en USD verificadas el 22-09-2026. Los valores permanecen en este navegador.
La escritura en caché se factura a 1,25x la tarifa de entrada. La estimación excluye reintentos, herramientas, impuestos, el recargo regional del 10% y márgenes de proveedores. Entradas above 272K cambian todas las líneas a tarifas de contexto largo automáticamente. Ver tarifas actuales
La calculadora corre por completo en esta página — no se envía nada a ninguna parte. Aplica automáticamente el cambio a contexto largo de 272K, tarifica el nivel de servicio elegido y separa las escrituras de caché de los aciertos. Lo que deliberadamente no modela: reintentos, tarifas de herramientas, el 10% regional y el reloj de caché — eso queda para tu margen. Vuelve a comprobar la tarjeta oficial antes de comprometer un presupuesto; estas son las cifras del 22 de septiembre de 2026.
Una opción práctica: ejecutar la comparación en Tabbit
Después del presupuesto viene la parte aburrida: ejecutar trabajo con forma de Astra necesita un sitio donde páginas, archivos y llamadas al modelo vivan juntos. Ese es el hueco de Tabbit Browser — un navegador con IA donde el selector de modelos, la página en vivo y el archivo local comparten una superficie, y «probar Astra en medium, caer a Luna si falla» es una selección, no un proyecto de orquestación.
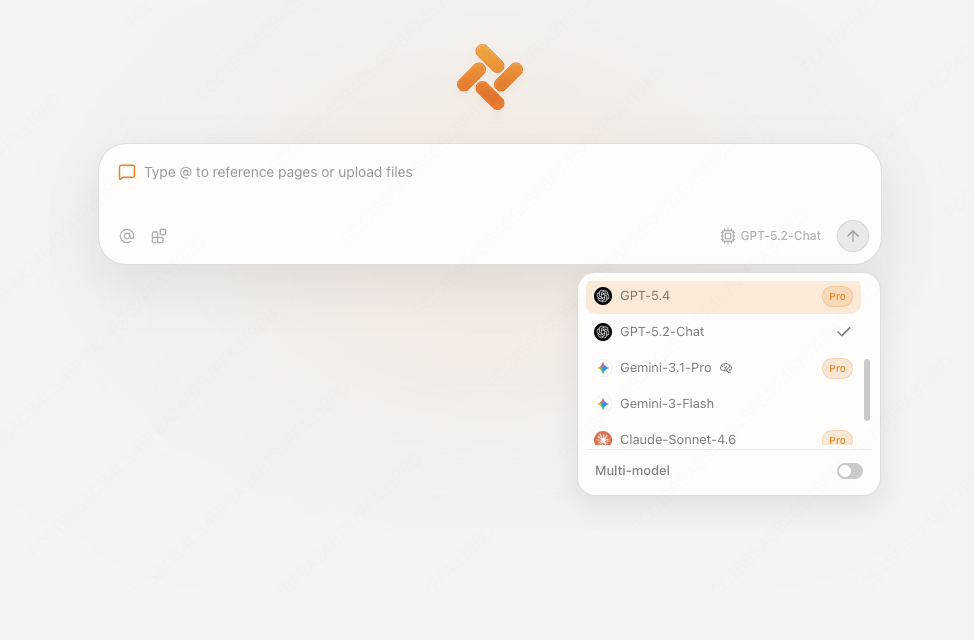
Los límites, dicho sin rodeos: Tabbit es un cliente, no una capa de facturación de OpenAI. La disponibilidad de modelos depende de tu cuenta y edición, y nada en el navegador cambia lo que OpenAI cobra — la tarjeta de arriba aplica dondequiera que corra Astra. Lo que cambia el navegador es el coste de montaje: la página de recursos de GPT-6 Astra (English) y su colección de prompts (English) describen tareas reproducibles que puedes lanzar contra el selector antes de escribir código de orquestación — la forma más barata de averiguar qué nivel de esfuerzo necesita realmente tu carga de trabajo.
 Tabbit Browser
Si el trabajo es automatización a nivel de navegador más que chat, la visión general de navegadores agénticos, qué es un navegador agéntico y la guía de automatización de navegadores cubren ese flujo; la guía de navegadores con IA es el punto de partida general.
Tabla de decisión del precio de GPT-6 Astra
| Tu carga de trabajo | Motor del coste | Mejor ruta inicial | A vigilar |
|---|---|---|---|
| Chat interactivo, respuestas cortas | Tokens de salida | API con esfuerzo low/medium, o Plus | La salida a $50/M domina; 5x la entrada |
| Evaluaciones o enriquecimiento nocturnos | Volumen | Batch al 50% | Límites de cola por nivel; resultados en horas |
| Bucles agénticos largos bajo 272K | Lecturas y escrituras de caché | Estándar con prefijos estables cacheados | Retención de caché reportada de ~30 minutos |
| Contextos por encima de 272K | El salto | Reestructurar para quedarte bajo, o presupuestar 20/75 | Toda la solicitud se retarifica, no solo el exceso |
| Producción sensible a latencia | Fast mode | Fast (2x) sobre el esfuerzo mínimo suficiente | La elección de esfuerzo mueve el coste más que el nivel |
| Uso intensivo diario de consumo | Asignación de suscripción | Pro (desde 100 $) o API+Batch | Cuota quemada ~4x más rápido que Sol según reportes |
Veredicto final
GPT-6 Astra tiene precio de ingrediente para trabajo difícil, y factura como tal. Cómpralo cuando la tarea sea de largo aliento, intensiva en herramientas y cara de supervisar — y luego cómpralo con cuidado: Batch para todo lo que pueda esperar, esfuerzo low hasta que un test de aceptación diga lo contrario, contextos diseñados por debajo de 272K y prefijos amigables con caché medidos contra un reloj de 30 minutos. Deja el volumen que no necesita el insignia para Luna o Terra; la escalera familiar existe precisamente para que el flagship sea una decisión de enrutado, no un valor por defecto.
Si Astra es tu motor diario sobre API, presupuesta por tarea terminada (incluye reintentos y tarifas de herramientas) y revisa cada mes la página oficial de precios — la base promocional de Sol lleva fecha del 21 de noviembre y toda la escalera puede moverse. La comparación dedicada de alternativas sigue en preparación; hasta que llegue, los recursos del modelo (English), la vista general y los registros comunitarios enlazados arriba son el rastro de fuentes.
Fuentes
Precios de la API de OpenAI y página del modelo gpt-6-astra — tarifas, reglas de niveles y límites, comprobados el 22 de septiembre de 2026
Precios de ChatGPT — visualización Free/Go/Plus/Pro, comprobada el 22 de septiembre de 2026
Sam Altman, 30 de julio de 2026 — anuncio de rebajas de Luna/Terra y Fast mode de Sol
Página de lanzamiento de GPT-6 Astra en Artificial Analysis — instantánea de inteligencia, velocidad y coste por tarea por esfuerzo, 22 de septiembre de 2026
OpenRouter GPT-6 Astra — instantánea de tarifas y latencia por proveedor, 22 de septiembre de 2026
Registros comunitarios con capturas y condiciones en el texto: r/codex 1w6hvo9, r/codex 1wciwc1, r/codex 1w8r103, r/LLMDevs 1w9z8nb, r/ChatGPT 1w9nya5, Ask HN

Preguntas frecuentes
¿Cuánto cuesta GPT-6 Astra?
La tarifa estándar de la API, comprobada en las páginas de OpenAI el 22 de septiembre de 2026, es de 10 dólares por millón de tokens de entrada, 1 dólar por millón de entrada en caché, 12,50 dólares por millón de escritura en caché y 50 dólares por millón de salida. Los prompts de más de 272K tokens de entrada se facturan a tarifas superiores de contexto largo (20 dólares de entrada, 2 en caché, 25 de escritura, 75 de salida) para toda la solicitud. Batch y Flex cuestan el 50% de la tarifa estándar, Fast mode el doble, y los endpoints regionales de residencia de datos añaden un 10%.
¿Hay algún plan gratuito con GPT-6 Astra?
No en el nivel gratuito de la API. La tabla de límites de OpenAI marca el nivel Free de gpt-6-astra como no compatible, y el acceso de pago empieza en el Tier 1. En el lado de consumo, el plan gratuito de ChatGPT ofrece texto ilimitado con GPT-5.6 Luna pero no incluye Astra; Plus incluye acceso limitado a Astra, y Pro se presenta como impulsado por GPT-6 Astra.
¿Por qué GPT-6 Astra cuesta 2,5 veces más que GPT-5.6 Sol?
OpenAI posiciona Astra para el trabajo más difícil de extremo a extremo (razonamiento, código, computer use e investigación) y lo tarifica a 10/50 dólares frente a los 4/20 de Sol. Ojo: las tarifas actuales de Sol son precios promocionales disponibles al menos hasta el 21 de noviembre de 2026, así que la propia línea base de comparación puede moverse. Cuando Astra termina en menos intentos, el coste por tarea converge con el de Sol.
¿Merece la pena ChatGPT Pro solo por GPT-6 Astra?
Depende de la forma de tu carga de trabajo. Pro se muestra desde 100 dólares al mes con 5x uso y razonamiento con Astra, pero mediciones de la comunidad describen un semanal equivalente en API que cae de unos 2.500 dólares con Sol a unos 1.200 con Astra, una retención de caché de unos 30 minutos y usuarios intensivos que agotan las cuotas rápido. Si tus tareas son largas y agénticas, calcula bien el presupuesto o usa la API con Batch cuando la latencia lo permita.
¿Cuál es la forma más barata de ejecutar GPT-6 Astra?
Combina las palancas: envía el trabajo no urgente por Batch o Flex al 50% del precio estándar; empieza con esfuerzo de razonamiento low o medium y sube solo cuando fallen los tests de aceptación; mantén los prompts por debajo de 272K tokens de entrada para evitar el salto de contexto largo; y cachea prefijos estables para que las lecturas se facturen a 1 dólar en vez de 10 por millón.
¿Los precios de la API de GPT-6 Astra incluyen las llamadas a herramientas?
No. Las tarifas publicadas cubren solo la entrada y salida de texto. OpenAI indica que los modelos con herramientas, como web search o computer use, tienen una tarifa por llamada que se factura aparte del precio por token, así que un agente que busca 40 veces lleva un segundo contador en marcha.