
网页列表在授权范围内可读时,可以让浏览器 Agent 整理成 CSV。先约定每行的含义、主键、字段类型与空值规则。每条记录都保存来源定位信息,方便后来逐行核对。
先定义字段与类型
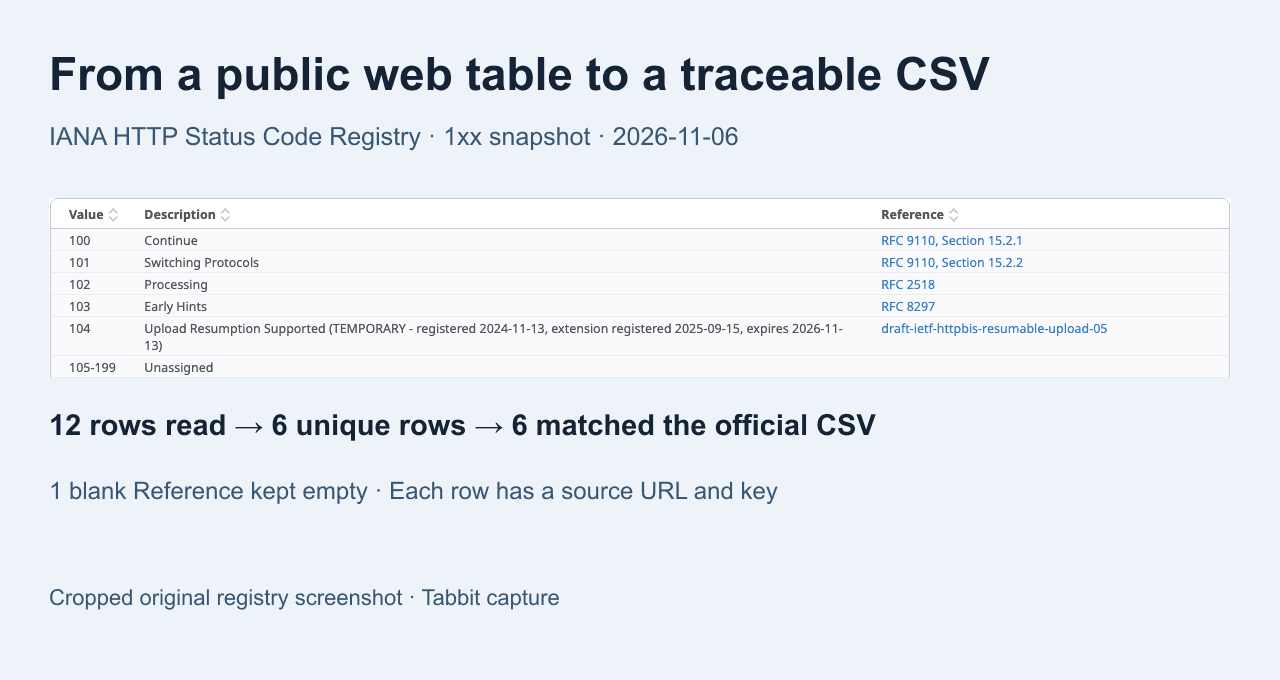
示例来自 IANA HTTP 状态码登记表。Value 用文本保存,因为 105-199 这类范围也是单行。保留 Description 和 Reference 显示内容,再加表格 URL、从 1 起算的数据行号、来源键和观察日期。开始前先确认一行代表什么。
| 字段 | 规则 |
|---|---|
value | 文本,范围值也保留 |
description, reference | 页面显示文字,缺失留空 |
source_url, source_key | 表格链接和来源键 |
source_row | 从 1 起算的数据行号 |
observed_at | 观察日期 |
IANA Registry · Browse AI 网页提取 · 适合 Agent 的浏览器
为每行保存来源定位
记录带表格锚点的真实网址和稳定来源键。行号只用于辅助定位,排序或更新后可能变化。分页列表还要记录当时的网址或游标与记录 ID。只提取事先约定范围内已加载的行,报告未能访问的页面。
只读取 IANA HTTP 状态码登记表的 1xx 行。Value 按文本保留,提取页面显示的 Description 和 Reference,空引用留空。每行附来源网址、键、行号和日期。按来源网址及键去重,并报告原始、唯一和空值数。
去重并保留真实空值
本次快照用 source_url 加 source_key 去重。两次读取共 12 行,有 6 行完全重复,每个键保留一行。遇到同键不同值先标为冲突,再回查原站。105-199 的 Reference 源单元格为空,CSV 也留空。可见的零和短横线保留原义。
核对行数与样本
打开原表核对首尾行和异常字段。将 Reference 展示用的括号归一后,导出六行与 IANA 官方 CSV 全部一致。104 的临时登记按 2026 年 11 月 6 日所见保留。本文件只是 1xx 组的六行快照。
| 检查项 | 实测 |
|---|---|
| 两次读取 | 12 |
| 移除完全重复 | 6 |
| 去重后导出 | 6 |
| 引用空值 | 1 |
| 匹配官方 CSV | 6 |
IANA CSV · 让 AI Agent 操作浏览器 · 首次浏览器任务清单
导出后重新打开
用支持引号、逗号和换行的 CSV 写入器。再用 CSV 解析器读取,核对表头、列数、行数和来源键。导入电子表格时,把代码和编号列设为文本。来源不受信任时,交付前先处理电子表格公式解释风险。
RFC 4180 · OWASP CSV Injection · Tabbit CLI 教程
交付可复查的结果
同时交付 CSV、范围、观察日期、重复与空值数,以及未覆盖内容的说明。网站自带且获准使用的导出满足需求时,可以直接使用。这里用网页表演示追溯,再用官方 CSV 独立复核。
Tableport 开发者提到,虚拟列表可能只导出已渲染行,文件看起来却完整。另一条讨论里,Power BI 用户遇到表头未识别的问题。接收文件前核对实际数据行和声明的范围。 Reddit Tableport · Reddit Power BI

常见问题
提示词要指定什么?
指定来源、行范围、字段名称、类型、去重键和空值规则。
以后怎么追溯某一行?
保留实际 URL、来源键和观察日期。行号只辅助定位。
空白单元格要让 Agent 补全吗?
源字段为空就留空并计数,页面实际显示的零和短横线照实保留。
跨页数据怎样去重?
用稳定记录标识。遇到同键不同值要标记冲突并回查。
怎样确认导出完整?
解析后核对范围与行数,再验证分页和代表性样本。
CSV 在表格软件中为何会改写编号?
表格软件可能自动识别日期或数字。把代码和编号列按文本导入。