
MiMo-V2.6-Pro merece una prueba seria para ejecuciones agénticas largas, automatización y, sorprendentemente, prosa. También es el modelo que más paciencia exige: el día de su lanzamiento, la puntuación abierta más alta vino acompañada de una de las esperas más largas antes de la primera palabra. En pocas horas, un desarrollador contó que arregló un script que un modelo rival no pudo, y otro contó que quedó atrapado en un bucle de terminal durante treinta minutos. Ambos informes son reales. Esta revisión los ordena.
Esta revisión solo cuenta evidencia que puedes abrir y comprobar: afirmaciones oficiales, datos medidos de forma independiente y reportes fechados de la comunidad, cada uno etiquetado por lo que demuestra. Los datos de lanzamiento están en la página del modelo MiMo-V2.6-Pro (English); el lado del dinero, en el análisis de precios. Aquí respondemos una pregunta más estrecha: si vale la pena, para quién y a qué costo de espera.
Al final miro qué significan estos hallazgos para los flujos de trabajo a nivel de navegador, donde cada vez más se ejecutan modelos como este. Esa parte importa si tu trabajo es investigación multi-página, extracción y automatización en vez de una sola caja de chat.
Conclusiones clave
MiMo-V2.6-Pro puntúa 46 en el Índice de Inteligencia de Artificial Analysis: #1 de 114 en su clase y la mejor puntuación de pesos abiertos, al costo más bajo por tarea del conjunto comparado (0,13 USD). (Artificial Analysis, verificado 2026-09-22)
La contracara es la espera: 18,17 segundos hasta el primer token de respuesta en el proveedor Xiaomi (carga de 10k tokens de entrada), casi todo razonamiento silencioso. La generación corre a unos 125 tokens/s. (benchmarks de proveedor AA)
Los tokens de pensamiento se facturan como salida a 0,87 USD por millón. En el conjunto del índice, los tokens de razonamiento superaron a los de respuesta por unos 37.500 frente a 26.800.
Los reportes reales del día de lanzamiento se parten en dos: un script Python roto arreglado donde GPT-6 Astra Light falló, y un bucle de grep de treinta minutos donde DeepSeek V4.1 Flash tuvo éxito. Una ejecución en cada dirección.
La escritura es la sorpresa: los usuarios de rol y prosa larga elogian el flujo de las escenas y el diálogo. El bucle de herramientas es el riesgo. Veredicto por carga de trabajo en la tabla de decisión.
Qué es realmente MiMo-V2.6-Pro
Xiaomi lanzó MiMo-V2.6-Pro y MiMo-V2.6-Flash (English) el 2026-09-22 como modelos "nativos omnimodales" de pesos abiertos construidos en torno al aprendizaje por refuerzo a escala. El checkpoint Pro es un MoE disperso con unos 1,02 billones de parámetros totales y 42 mil millones activos por token, ventana de contexto de 1M de tokens, entrada de texto, imagen, audio y video, salida de texto y licencia MIT. Los pesos están en Hugging Face (XiaomiMiMo/MiMo-V2.6-Pro-RL); el id de API es mimo-v2.6-pro, con mimo-v2.6-pro-ultraspeed como nivel de velocidad con precio propio. Los endpoints V2.5 se cierran el 2026-10-21 (contexto de migración).
Una cautela antes de cualquier número: los resúmenes de parámetros discrepan. El informe técnico dice 1,02 billones totales / 42 mil millones activos; el resumen de Hugging Face muestra además una línea de 524 mil millones; los datos estructurados de Artificial Analysis listan 978 mil millones pasivos. Toma 1,02T/42B como la línea de arquitectura del informe técnico oficial y verifica el checkpoint exacto antes de dimensionar hardware.
La pregunta que responde esta revisión no es "¿es inteligente?" — el leaderboard ya dice que sí. Es si un modelo con este perfil de velocidad, esta estructura de facturación y estas características de bucle de herramientas pertenece a tu flujo de trabajo, frente a rivales como GPT-6 Astra, Claude Fable 5.1 o el más barato Gemini 3.8 Flash.
El número que decide esta revisión: 18 segundos de silencio
Este par de números ordena todo lo demás. MiMo-V2.6-Pro logra la puntuación de inteligencia abierta más alta que mide Artificial Analysis (46, #1 de 114) al costo más bajo por tarea del conjunto (0,13 USD). También tarda 18,17 segundos en producir su primer token de respuesta en el único proveedor listado (Xiaomi, carga de 10.000 tokens de entrada, verificado 2026-09-22).
Esos dos números describen dos modelos distintos según quién espera. Para un agente de fondo que procesa treinta turnos de herramientas, 18 segundos de razonamiento inicial se diluyen en minutos de trabajo no supervisado, y los 125 tokens/s que siguen solo quedan por detrás de uno o dos modelos en la misma instantánea. Para un humano que hace una pregunta y mira el cursor, 18 segundos son una eternidad, y los 22,2 segundos de extremo a extremo para una respuesta de 500 tokens son peor de lo que suenan.
Una instantánea anterior del mismo día de Artificial Analysis descompone la espera: 15,41 segundos de pensamiento más 2,17 segundos de procesamiento de entrada — el 87,7% de la espera es el modelo razonando antes de hablar. Los mismos datos estructurados explican la factura: unos 37.520 tokens de razonamiento frente a 26.756 tokens de respuesta por tarea del índice. Pagas unos 1,4 tokens de pensamiento oculto por cada token de respuesta visible.
Los usuarios de Reddit chocaron con el mismo muro en pocas horas:
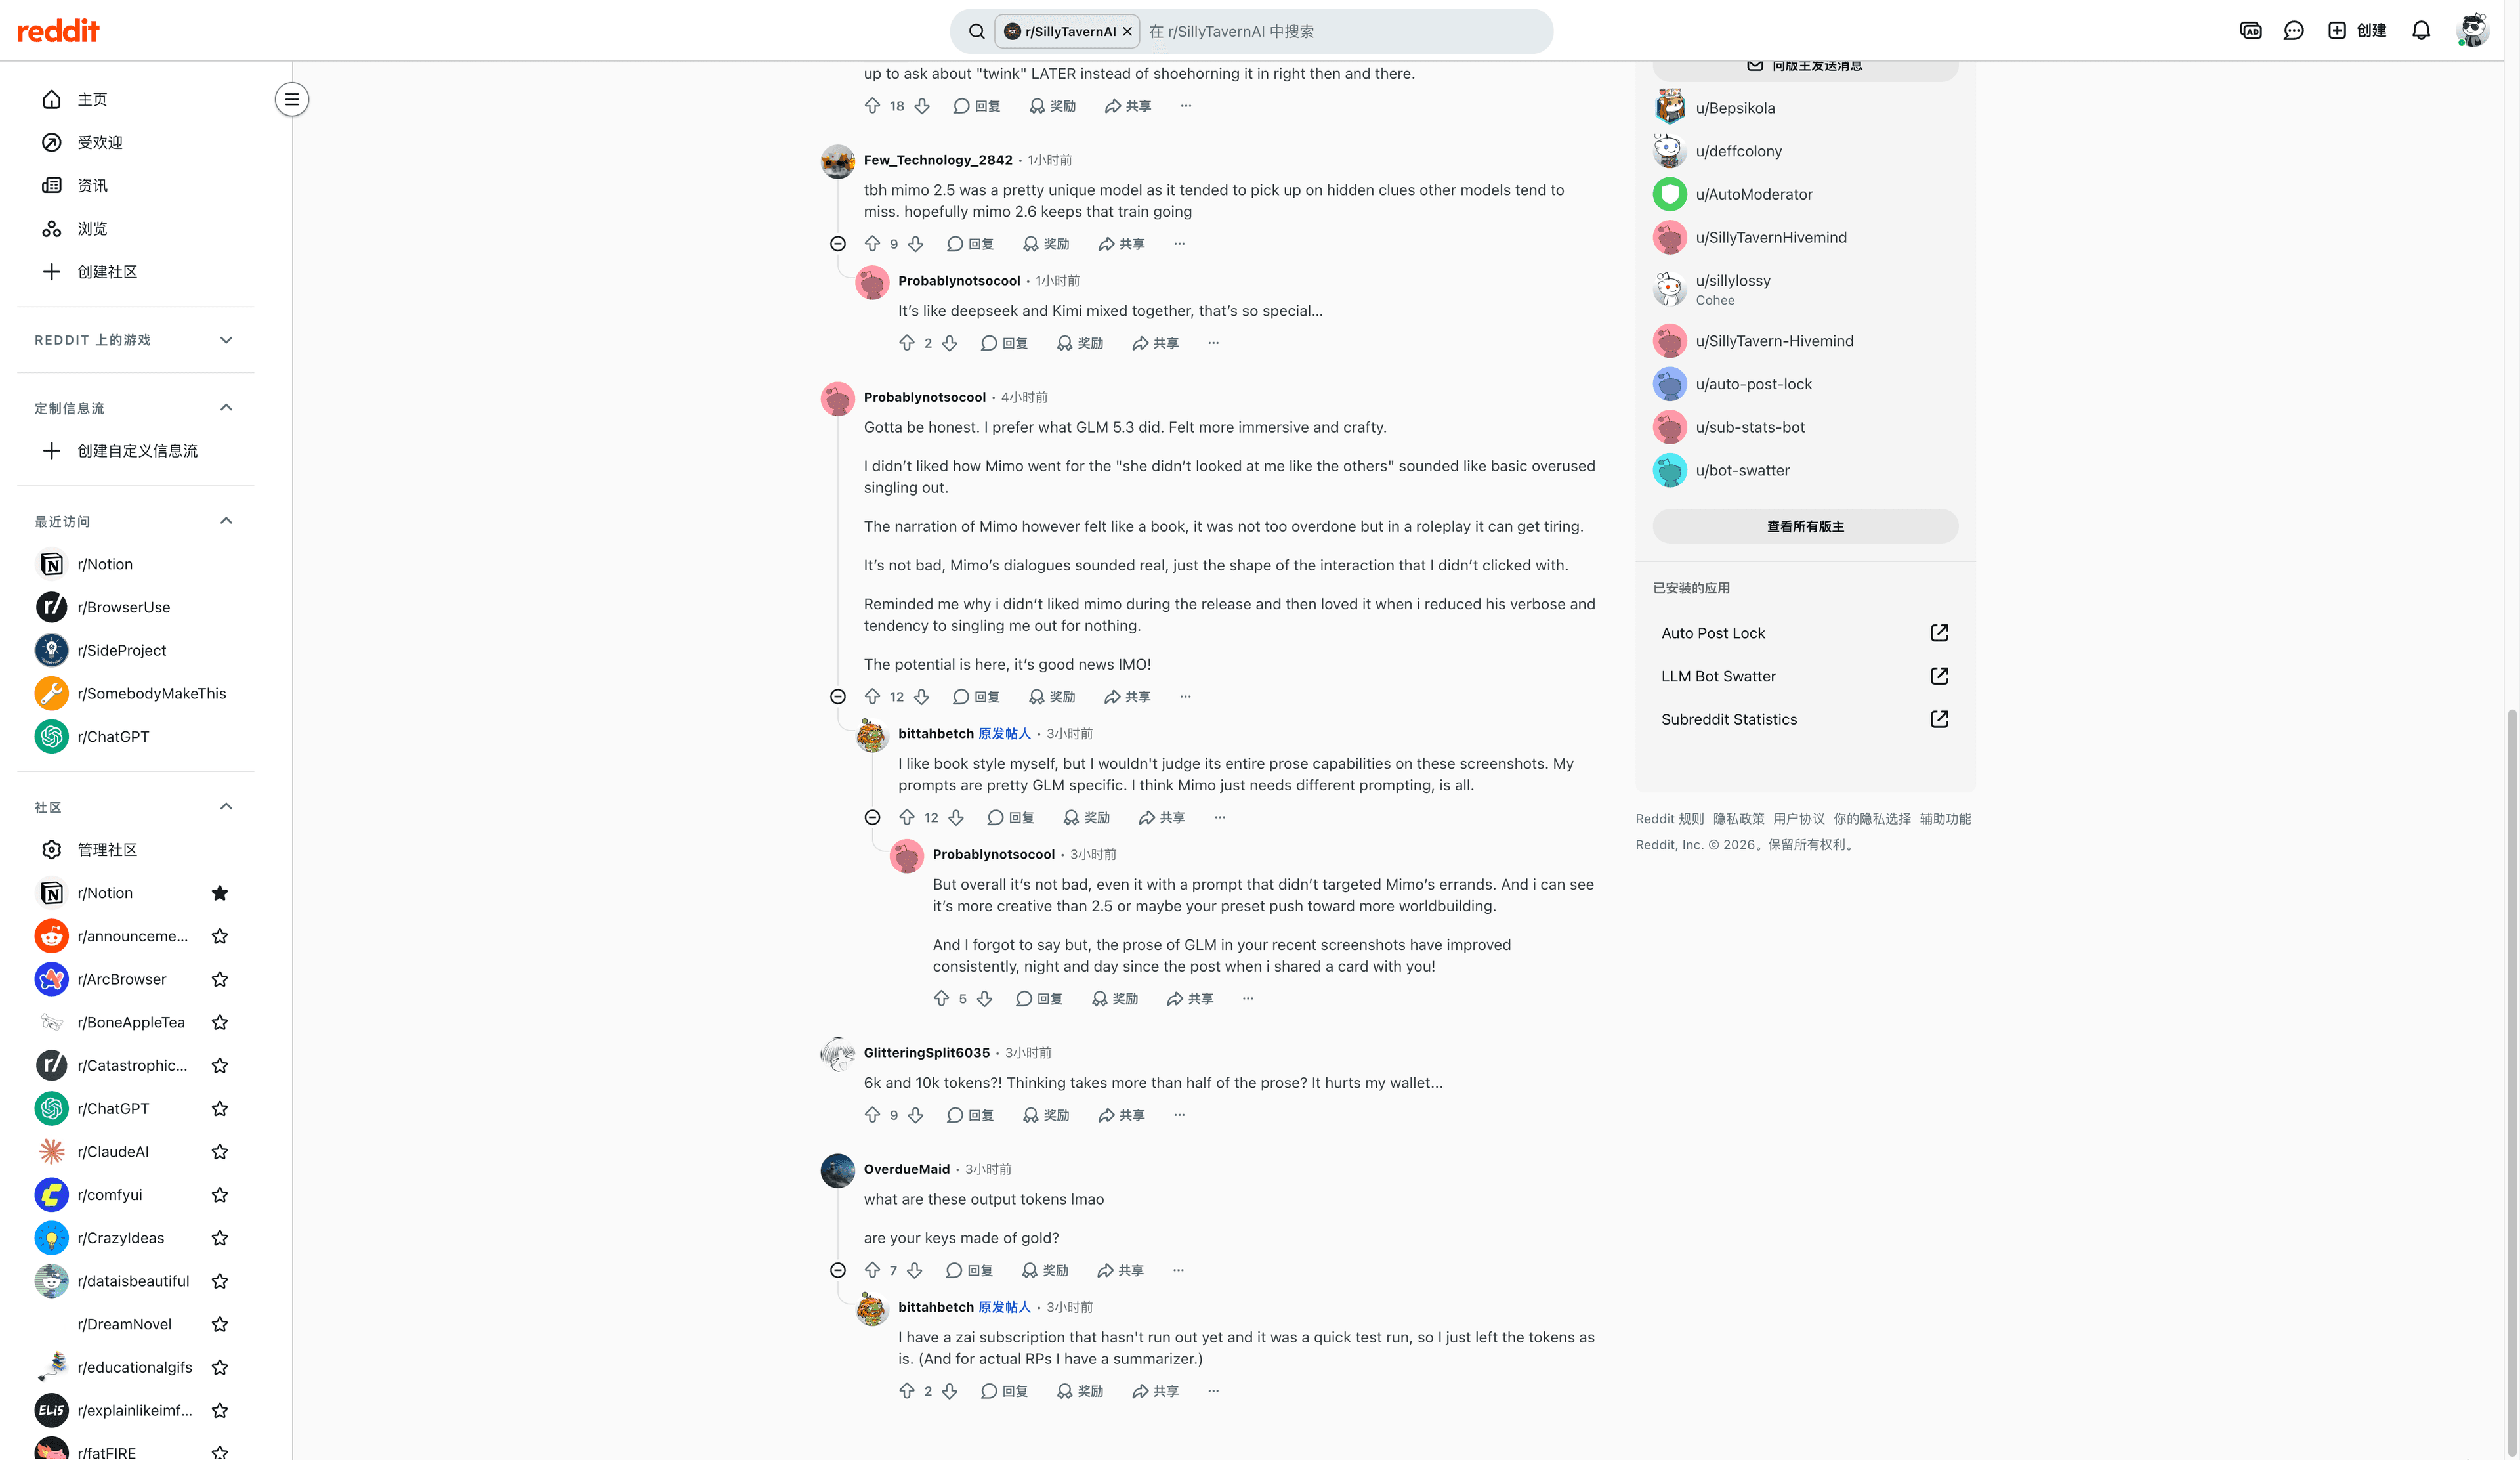
"6k and 10k tokens?! Thinking takes more than half of the prose? It hurts my wallet..." — u/GlitteringSplit6035 (r/SillyTavernAI, 2026-09-22)
"what are these output tokens lmao are your keys made of gold?" — u/OverdueMaid (mismo hilo)
Usa el ancla para ordenar tu carga de trabajo: si la unidad de trabajo es una ejecución larga, cómprale el cerebro y aguanta la espera. Si la unidad es un turno humano, la espera es el producto.
Qué pasó en trabajo real, antes del leaderboard
La evidencia más útil del día de lanzamiento no es una fila de benchmark. Son dos historias pequeñas con herramientas y resultados concretos.
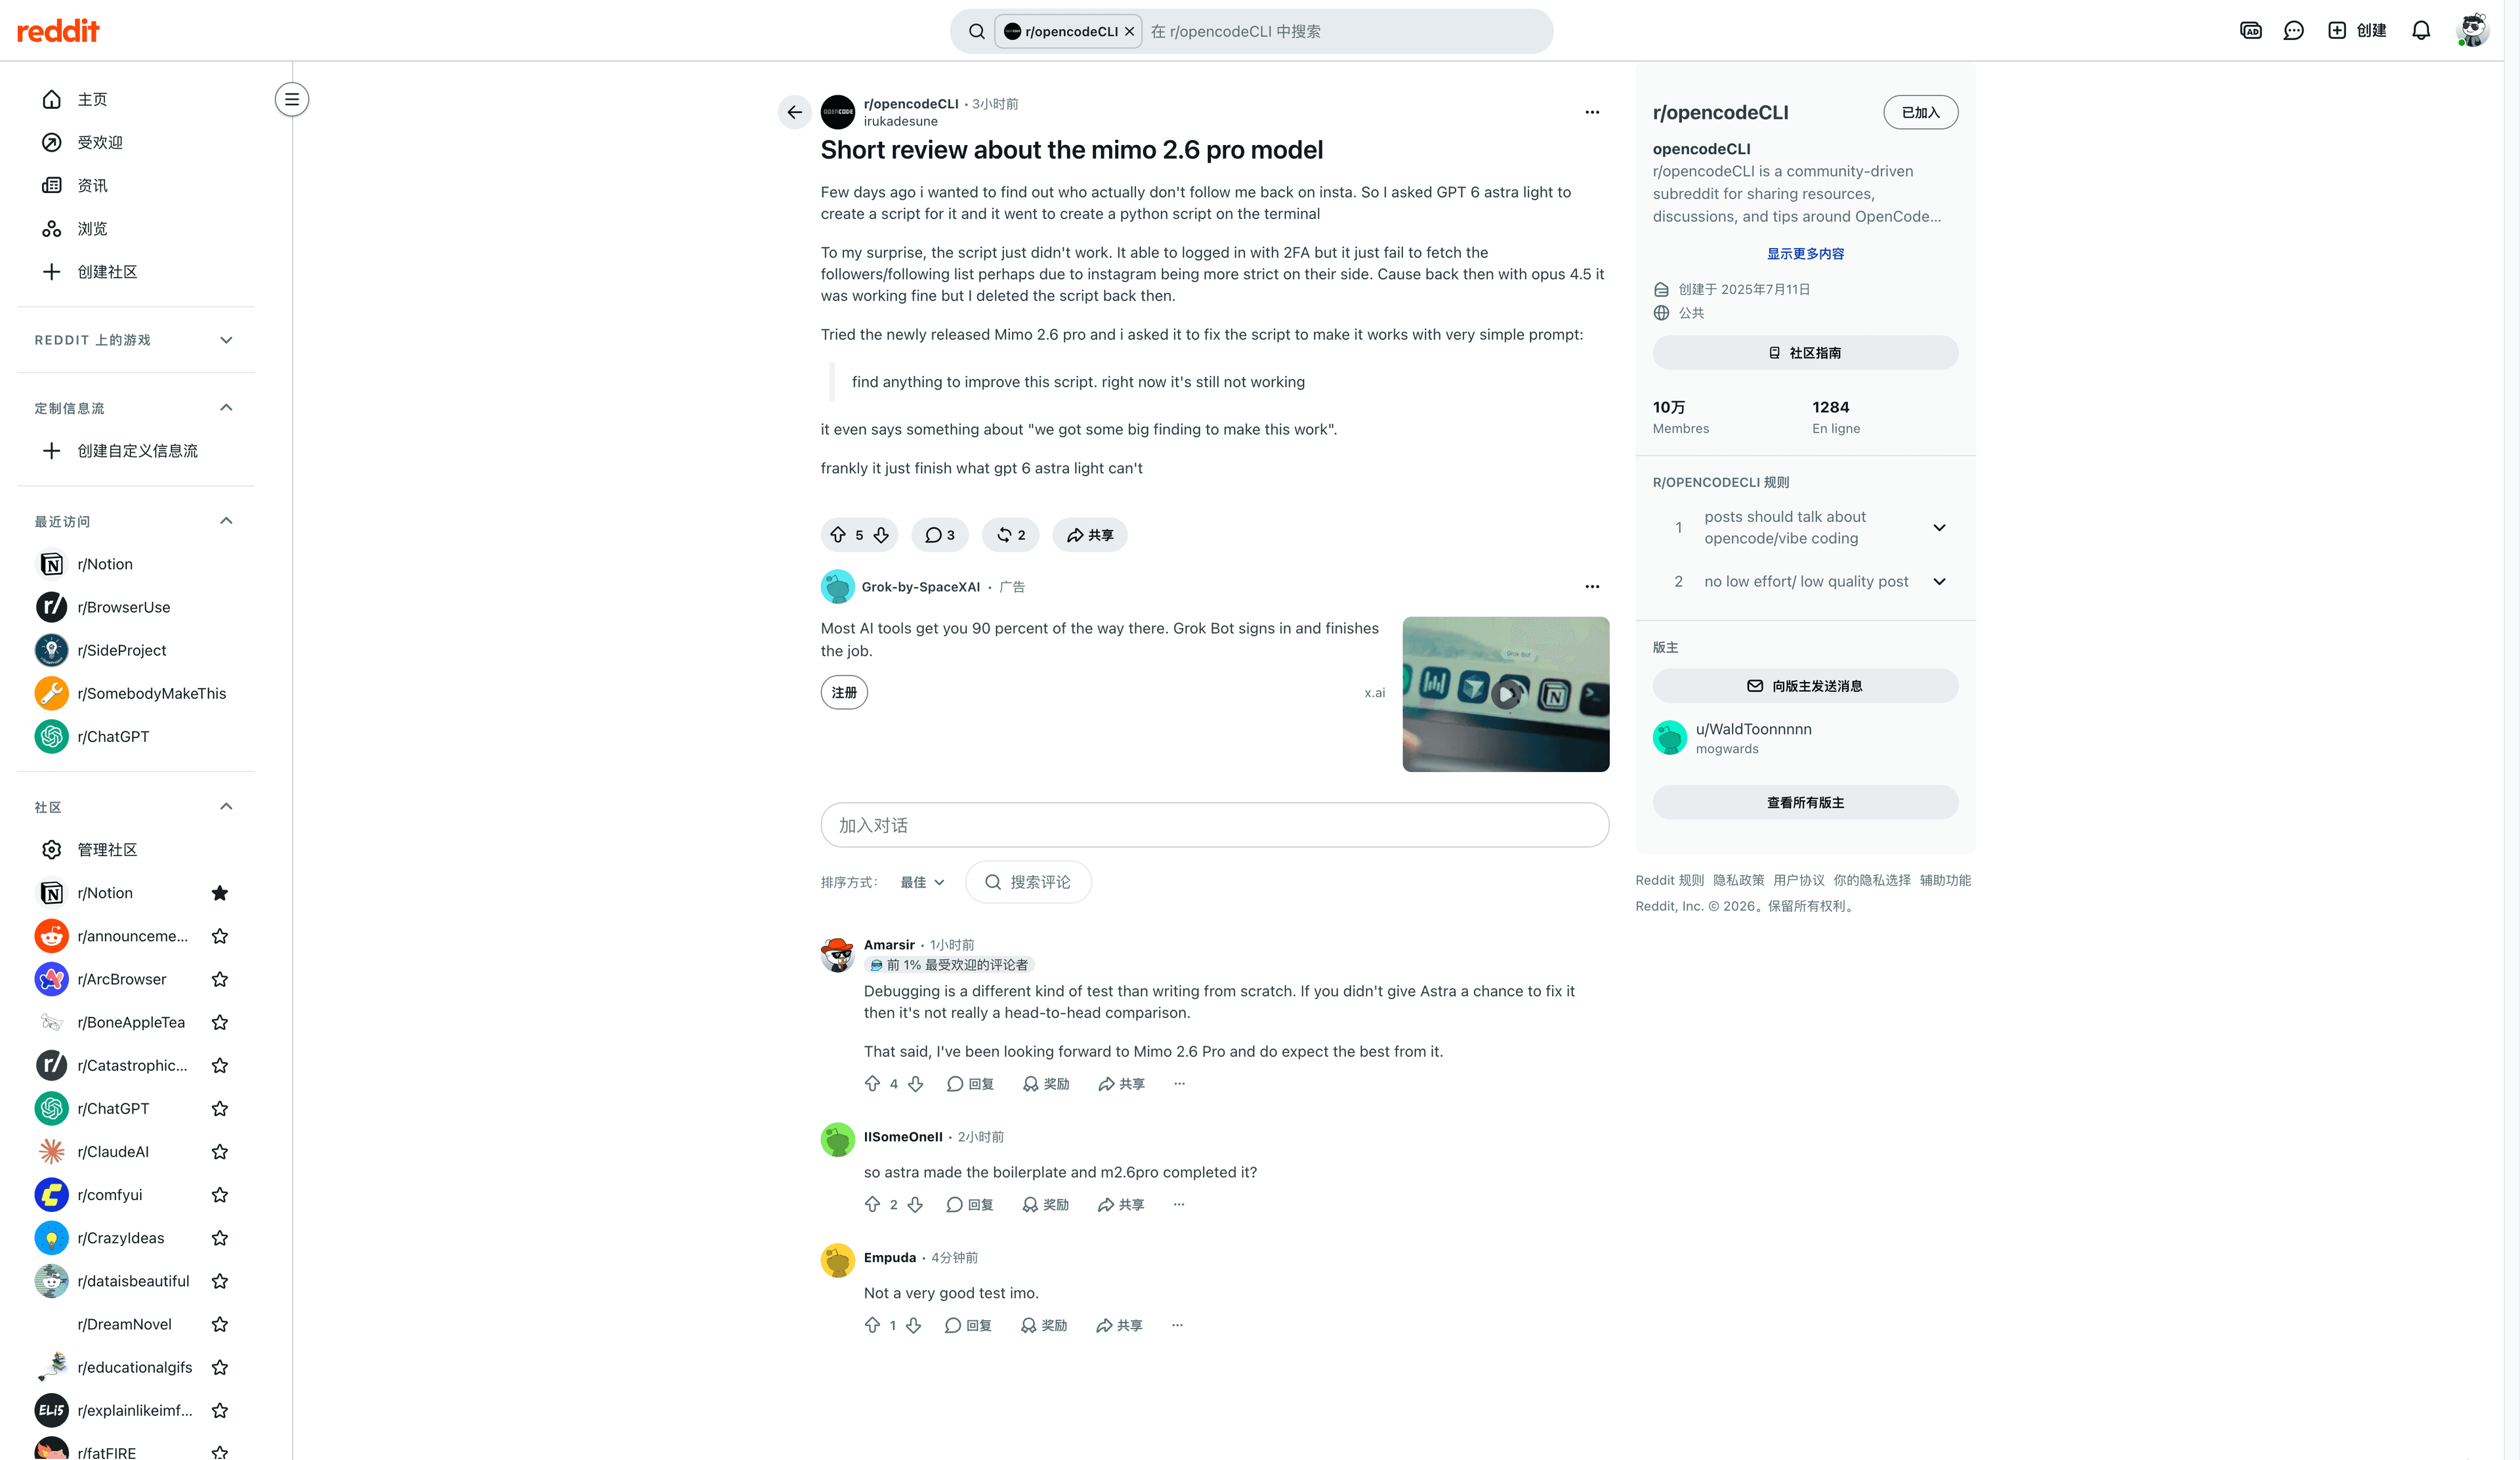
La victoria. u/irukadesune tenía un script Python que comprueba quién no lo sigue de vuelta en Instagram. GPT-6 Astra Light lo reescribió y el script seguía fallando al obtener la lista de seguidores. La instrucción dada a MiMo-V2.6-Pro fue una línea: "find anything to improve this script. right now it's still not working." Lo arregló.
"frankly it just finish what gpt 6 astra light can't" — u/irukadesune (r/opencodeCLI, 2026-09-22)
La crítica. La respuesta más votada señala lo que esa historia puede y no puede probar:
"Debugging is a different kind of test than writing from scratch. If you didn't give Astra a chance to fix it then it's not really a head-to-head comparison." — u/Amarsir (mismo hilo)
La derrota. u/choiyoh encargó el mismo cambio de UI/UX web a MiMo-V2.6-Flash y MiMo-V2.6-Pro en una herramienta de código por terminal. Ambos entraron en un bucle de grep sin avanzar.
"for 30 minutes no code was fixed." … "DS 4.1 Flash is still much better.." — u/choiyoh (r/CommandCode, 2026-09-22)
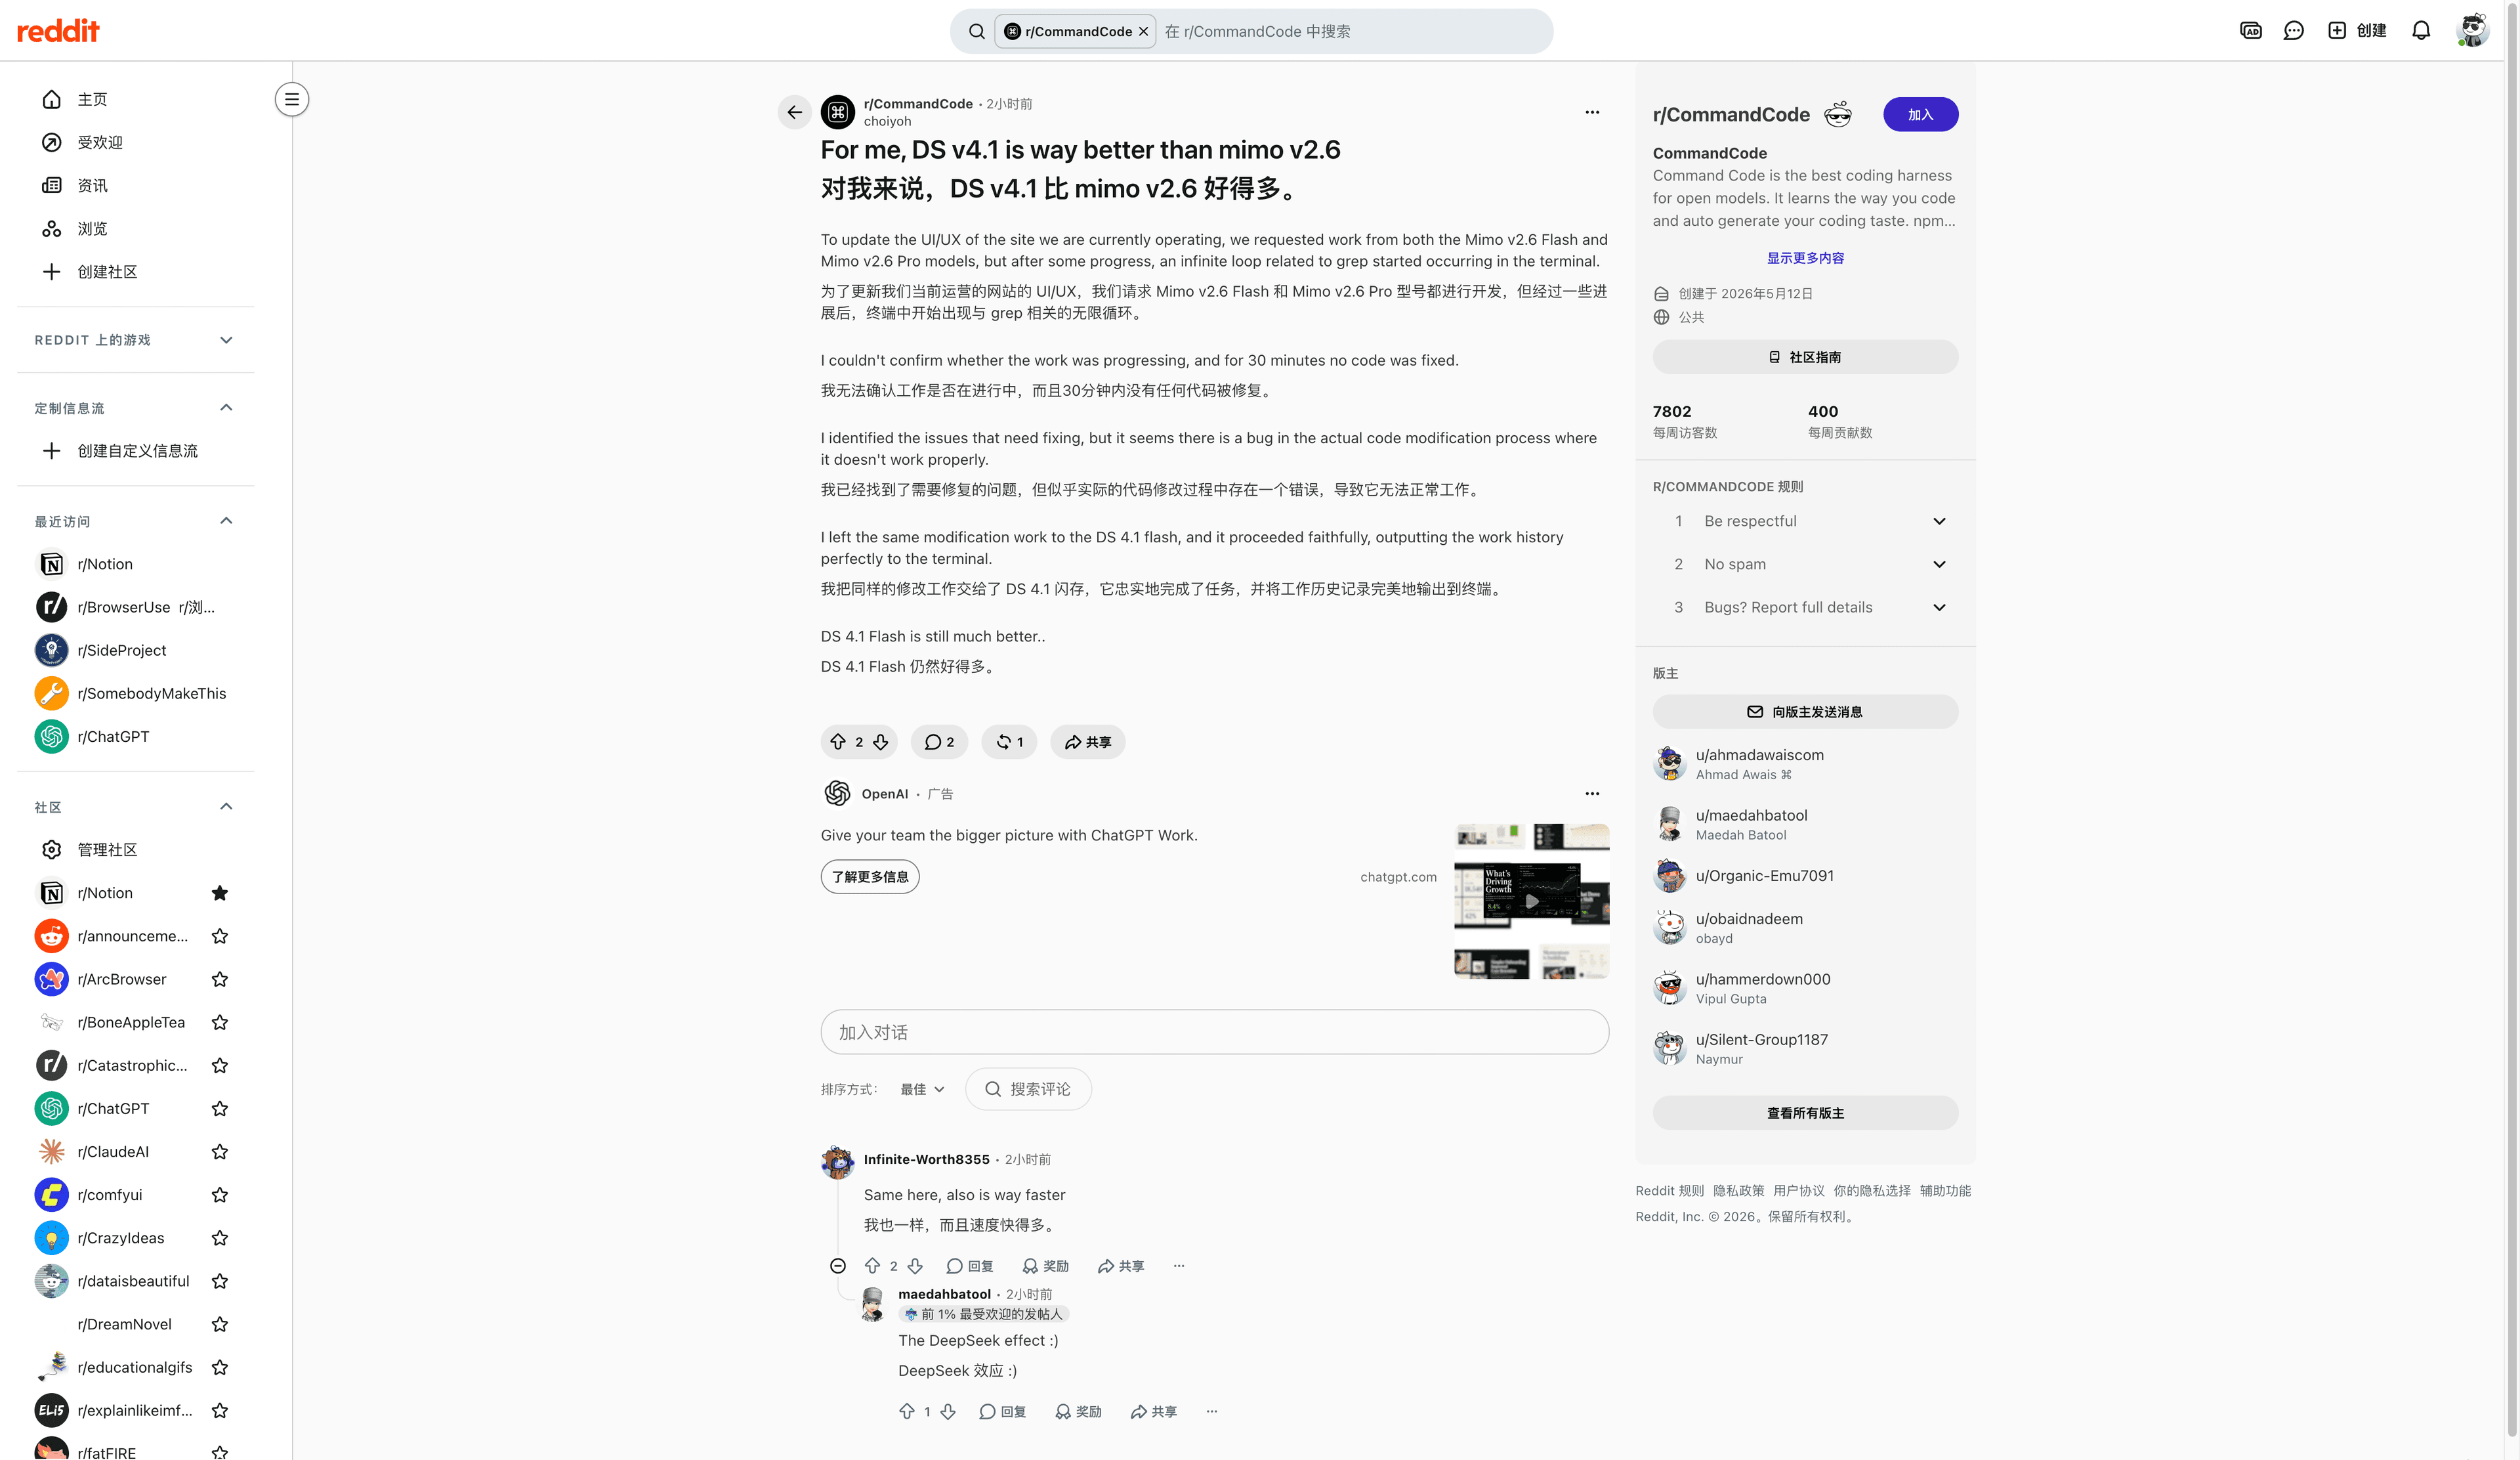
Una ejecución cada uno, sin registros, sin repositorios, sin recuentos de tokens. Establecen que ambos resultados existen en la realidad — una depuración que superó a un rival y un bucle de treinta minutos — y nada sobre con qué frecuencia ocurre cada uno. Ese es exactamente el hueco que los benchmarks deberían llenar. Veamos cuánto llenan.
Los benchmarks, y cuánto confiar en ellos
El informe técnico de Xiaomi (Tabla 3, reportado por el fabricante, verificado 2026-09-22) compara Pro con su propia familia y tres buques insignia cerrados. Valores tal como se reportaron; - significa no proporcionado:
| Benchmark | MiMo-V2.6-Pro | MiMo-V2.6-Flash | MiMo-V2.5-Pro | Claude Opus 5 | GPT-5.6 Sol | Claude Fable 5 |
|---|---|---|---|---|---|---|
| DeepSWE v1.1 | 71.9 | 67.9 | 19.0 | 74.0 | 73.0 | 70.0 |
| AutomationBench v1.0.6 | 53.1 | 52.3 | 16.0 | 50.3 | 45.8 | 46.2 |
| Toolathlon-Verified | 76.9 | 73.6 | 49.1 | 80.6 | 74.9 | 77.9 |
| Agents' Last Exam | 31.6 | 27.6 | 13.2 | 31.6 | 30.8 | 25.7 |
| Terminal Bench 2.1 | 89.9 | 87.6 | 65.2 | 89.1 | 88.8 | 84.3 |
| Terminal Bench 4.0 | 34.9 | 28.8 | 1.5 | 49.0 | 39.9 | 42.4 |
| OSWorld-Verified | 82.0 | 80.8 | - | 83.4 | 83.0 | 86.0 |
| JobBench | 62.0 | 61.2 | 25.0 | 65.7 | 45.4 | 57.4 |
| MiMo Visual Coding (interno) | 72.3 | 71.5 | - | 70.0 | 73.4 | 69.1 |
Ahora el agua fría, en tres partes.
Las condiciones de medición son débiles. El informe publica puntajes agregados pero no registros por pregunta, prompts, semillas, tamaños de muestra ni intervalos de confianza. Tres filas (MiMo Code Bench, MiMo Cyber Bench, MiMo Visual Coding) son benchmarks propios de Xiaomi. El muy repetido "58.4 → 72.6 en DeepSWE" es un cambio de curva dentro de una misma ejecución de RL — unos 30 pasos y 2,62 millones de dólares de cómputo — no una comparación modelo contra modelo. El "comparable a Claude Opus 5 y GPT-5.6 Sol en la mayoría de benchmarks de agentes" de la página oficial es posicionamiento, y su "de 1/20 a 1/60 del precio" omite el conjunto comparado y el conteo de tokens.
La comunidad desconfía por defecto de los leaderboards de entrenamiento:
"We'll see how it works on real code. DeepSeek-V4.1-Flash was technically a lot more capable than GLM-5.3-Flash but it's worse in the real-world … The benchmarks don't care if it's a code spaghetti." — u/lilian_moraru (r/LocalLLaMA, 2026-09-22)
"i mostly care about roleplay so those benchmark wins dont mean much if it still forgets details after a few messages." — u/Pure-Summer2818 (mismo hilo)
Las fuentes independientes concuerdan en la forma, no en la precisión. Artificial Analysis ejecutó su propio hardware y da a MiMo-V2.6-Pro 46 en el Índice de Inteligencia (v4.3.2, 10 evaluaciones), mientras la fila de Arena Code Arena WebDev muestra un AutoEval de 1628 (+18/-18) con Rank y Votes en N/A: es un resultado con script en un leaderboard de votos ciegos, y no puede escribirse como "clasificado N-ésimo". La observación metodológica de Amarsir aplica a cada fila: depurar no es crear, un harness no es tu harness, y una señal direccional no es una regla.
Lo que sobrevive al agua fría: el salto respecto a V2.5-Pro (DeepSWE 19.0 → 71.9) es demasiado grande para ser un truco de redondeo, y el experimento de transferencia entre harnesses del informe (cuatro harnesses de entrenamiento y luego Codex, Claude Code y mini-swe-agent nunca vistos, con unos 50% → 66% de tasa de éxito) es el tipo de evidencia que importa para el despliegue real. Solo no leas ninguna fila como tu tasa de éxito.
Donde MiMo-V2.6-Pro es genuinamente bueno
La escritura es la sorpresa
Rara vez se elogia primero la prosa de un modelo de código. El día de lanzamiento, los elogios más fuertes vinieron de escritores de rol de formato largo, un público que castiga duro los patrones repetitivos.
"honestly I'm really enjoying it for RP so far. The responses have been surprisingly good, especially when it comes to keeping the flow of a scene going and actually giving me something interesting to work with instead of falling into the usual repetitive RP patterns." — u/Electrical_Mode_2489 (r/SillyTavernAI, 47 votos)
Otro escritor comparándolo cara a cara con GLM 5.3 valoró el diálogo y la contención: el modelo "set[] up to ask about 'twink' LATER instead of shoehorning it in right then and there". Si vives de escribir — ficción, copy de marketing, historias interactivas largas — esta mejora puede importarte más que cualquier puntaje de código.
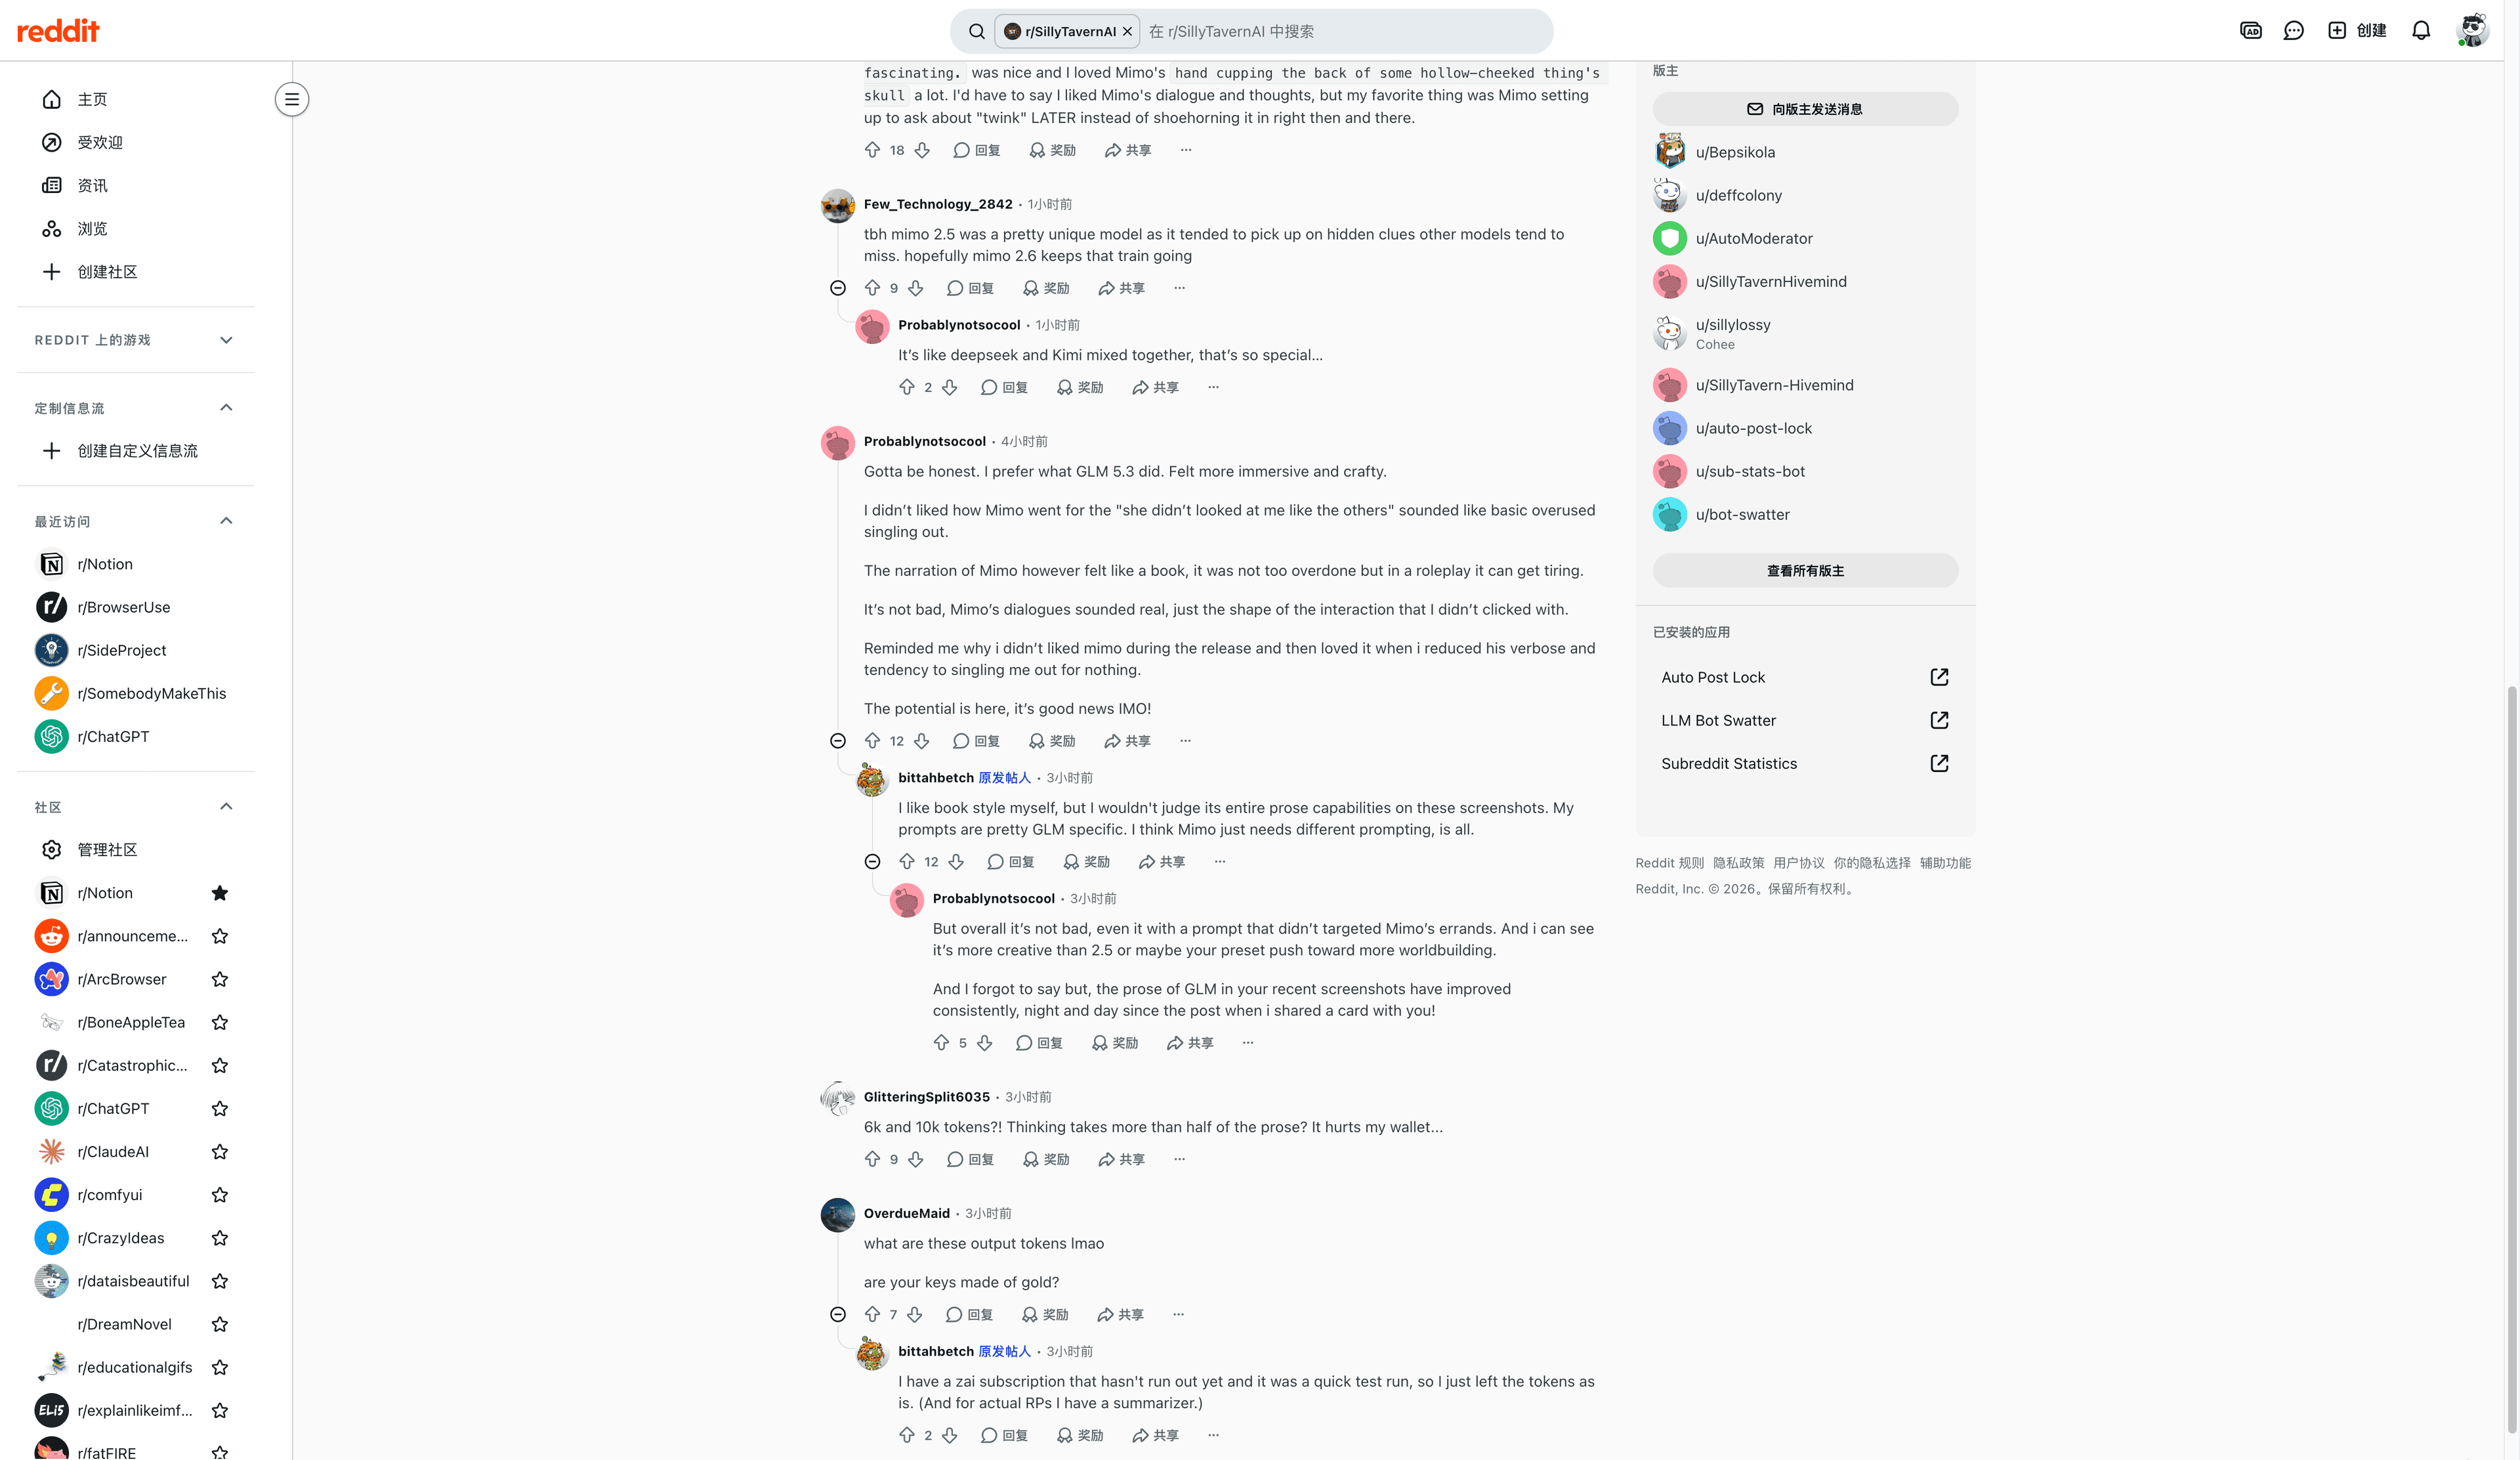
El límite: el gusto es personal. En ese mismo hilo, u/Probablynotsocool prefirió GLM 5.3 ("Felt more immersive and crafty") y encontró la narración de MiMo "like a book … in a roleplay it can get tiring". Dos usuarios experimentados, veredictos opuestos, las mismas salidas.
Automatización y flujos con herramientas superan a los buques insignia en el papel
Aquí la forma de los benchmarks sí favorece a MiMo. AutomationBench v1.0.6: 53,1, por delante de Claude Opus 5 (50,3) y GPT-5.6 Sol (45,8). Toolathlon-Verified: 76,9, a tres puntos de Opus 5 y por delante de Sol. Terminal Bench 2.1: 89,9, el mejor del conjunto. JobBench 62,0 casi duplica los 45,4 de GPT-5.6 Sol.
El detalle de ingeniería detrás de esas filas importa para el despliegue: la etapa de RL entrenó con cuatro harnesses mínimos y luego comprobó transferencia en tres no vistos (Codex, Claude Code, mini-swe-agent). Un modelo que solo funciona en su propio harness es una demo; un modelo que transfiere es infraestructura. Para quien construye bucles de herramientas multi-paso — agentes de navegador, arreglos de CI, automatizaciones internas — esta es la razón más fuerte para probarlo.
Inteligencia de frontera a precio de commodity, con pesos MIT
La instantánea de Artificial Analysis del 2026-09-22 sitúa a MiMo-V2.6-Pro en 46 del Índice de Inteligencia — a la par con Grok 4.7 (46) y por debajo de Claude Opus 5 (51) — mientras es el modelo más barato por tarea del índice del conjunto, con 0,13 USD. La tarifa es 0,435 USD de entrada / 0,87 USD de salida por millón de tokens, y los aciertos de caché bajan a 0,0036 USD, un descuento de 120× que transforma la economía multi-turno (cálculo de precios aquí; para contrastar presupuestos frente a otro abierto reciente, ver el análisis de precios de Kimi K3).
Una comparación comunitaria de los buques insignia del mismo día lo concreta: frente a Grok 4.7, MiMo ofrece contexto de 1M frente a 500k tokens, unos 125 frente a 42 tokens/s, pesos MIT frente a cerrado, y 0,435/0,87 frente a 2/6 USD — con ambos modelos en 46 del índice. Si tu restricción es capacidad por dólar — agentes por lotes, pipelines de investigación, cargas de razonamiento agéntico — esa es la propuesta de valor del lanzamiento.
Donde muerde
El impuesto al pensamiento: pagas el silencio dos veces
Una en la espera y otra en la factura. 18,17 segundos hasta el primer token de respuesta; unos 37.520 tokens de razonamiento frente a 26.756 de respuesta por tarea del índice, todos facturados como salida a 0,87 USD por millón. En prompts intensivos en razonamiento, usuarios reportan que el pensamiento supera la mitad de la generación total — el material de esas reacciones de "6k and 10k tokens?!".
La válvula de escape oficial es mimo-v2.6-pro-ultraspeed: hasta 20× de velocidad de generación a exactamente 10× el precio (4,35 USD entrada / 8,70 USD salida). Es una opción real para productos interactivos con presupuesto, pero reprecia el modelo al territorio frontera, lo que borra la principal ventaja de valor. No hay documentado hoy un interruptor de "pensar menos" en la API oficial; el análisis de precios hace los números.
Los bucles de herramientas se desbocan
El bucle de grep de arriba es la forma de fallo que más duele en trabajo agéntico: no es una respuesta incorrecta, es ninguna respuesta, con el contador corriendo. El informe técnico admite que su propia infraestructura de entrenamiento sufrió OOM, evaluadores inalcanzables y fallos de rollout parcial, y no publica una tasa de fallo unificada por benchmark. Otro usuario corrobora el patrón ("Same here, also is way faster", sobre el rival). Si lo adoptas para ejecuciones no supervisadas, presupuesta supervisión, timeouts de herramientas y un modelo de respaldo — la misma disciplina que aplicarías a cualquier stack de navegador agéntico.
Cumplimiento, endpoints y peso de despliegue
Tres tropiezos prácticos que no aparecen en los puntajes:
Tratamiento de datos. El día de lanzamiento, usuarios señalaron que el único endpoint activo es de primera parte y, en su lectura, no cumple retención cero de datos (ZDR): "very interesting, but 2.6 Pro's only endpoint is non-ZDR compliant" (u/total_ty), contestado con "How trustworthy is a random tag on a website, honestly? How do we verify none of our data has been retained by the endpoint?" (u/starliteburnsbrite). Los pesos abiertos significan que el hosting de terceros está en camino — "the weights are already up on huggingface" — pero hoy la ruta cumplida es autoalojarse o un proveedor cuyos términos hayas leído.
Autoalojarse es pesado. 1,02T de MoE disperso; los ejemplos oficiales de vLLM asumen
--tensor-parallel-size 8. Esto no es un modelo portátil. Presupuesta nodos multi-GPU y lee la letra pequeña de los parámetros.Deriva de versiones y precios. Los endpoints V2.5 mueren el 2026-10-21; los números de Artificial Analysis se movieron dentro del mismo día al refrescarse las mediciones (17,58 → 18,17 s). Fija versiones y re-verifica tarifas antes de presupuestar.
Lo que dijo la gente de verdad
La conversación del día de lanzamiento se parte sobre dos ejes, no uno.
Eje uno: encantados frente a quemados. La victoria de depuración y el bucle de grep están a cuatro horas de distancia en Reddit, y ambos bandos se llenaron al instante. El prompt de una línea de u/irukadesune arregló lo que un buque insignia rival no pudo; u/choiyoh perdió treinta minutos en un bucle de terminal y se mudó a DeepSeek V4.1 Flash. Los entusiastas leen la misma evidencia y extrapolan — "I believe in mimo, mimo will replace GLM as THE rp model" (u/stopaskingforloginn) — mientras los escépticos piden registros.
Eje dos: emocionados con el precio, molestos con el pensamiento. La primera sorpresa del hilo de lanzamiento fue económica — "They kept the prices!? It's over." (u/Pink_da_Web) — y luego llegaron los recuentos de tokens:
Incluso el público más satisfecho del modelo, los escritores, discrepa entre sí:
Dónde cae esta revisión: u/Amarsir cayó en el mismo lugar — entusiasmo por el modelo, impaciencia con las comparaciones chapuceras. El patrón de nueve voces verificadas coincide con los números: capacidad seria, fricción seria en la espera y la fiabilidad del bucle de herramientas sin probar en n=1 en ambas direcciones.
El veredicto: elige por carga de trabajo, no por el puntaje
| Forma de carga de trabajo | Veredicto | Por qué | Reserva principal |
|---|---|---|---|
| Ejecuciones agénticas largas de código, arreglos por lotes, bucles no supervisados | Pruébalo | AutomationBench 53,1 supera a Opus 5 y Sol; evidencia de transferencia entre harnesses; contexto 1M; 0,13 USD/tarea diluye la espera | Los fallos en bucle tipo grep son reales; supervisa y mantén un respaldo |
| Chat interactivo, rol y prosa larga | Sí, con reservas | Los elogios a la prosa son concretos y repetidos; el contexto 1M mantiene escenas largas coherentes | 18 s al primer token + tokens de pensamiento encarecen latencia y costo por escena; algunos prefieren GLM 5.3 |
| Automatización de computadora y navegador | Candidato fuerte | OSWorld-Verified 82,0, JobBench 62,0, código visual 72,3 (interno); entrada omnimodal | La evidencia es mayormente del fabricante; verifica primero en tu conjunto de tareas |
| Datos regulados / requisitos de retención cero | Todavía no | Los pesos MIT permiten en principio autoalojarse o proveedores cumplidos | Hoy el único endpoint activo es de primera parte y su estado ZDR no está verificado |
| Inferencia local en una GPU o portátil | No | 1,02T de MoE disperso; el serving oficial asume paralelismo de tensores en 8 vías | La familia Flash o destilados más pequeños son la opción local real |
Dos notas con fecha. Primera: Grok 4.7 se lanzó el mismo día con 46 en el índice de Artificial Analysis, y una comparación comunitaria concluyó que "neither one decisively dominates the other": la comparación que debes correr es la de tu carga de trabajo, idealmente con dos candidatos respondiendo en paralelo. Segunda: los endpoints V2.5 se cierran el 2026-10-21, así que planificar la migración no es opcional si construiste sobre ellos.
Una ruta práctica: ejecútalo donde ocurre el trabajo
Todo en esta revisión apunta a un mismo perfil: la espera castiga a los humanos y no a los agentes; los tokens de pensamiento castigan los turnos sueltos y premian las ejecuciones sostenidas; el riesgo de bucle exige supervisión. Ese perfil encaja mal en una caja de chat pegada a un documento y bien en un flujo de trabajo a nivel de navegador que lee páginas, sostiene 1M de tokens de contexto y trabaja mientras tú haces otra cosa.
Ese es el flujo para el que está construido Tabbit Browser: investigación multi-página, extracción y automatización como tarea de agentic browser, no como un solo prompt. El límite honesto: esta ronda de revisión no pudo verificar que MiMo-V2.6-Pro aparezca hoy en el selector de modelos en vivo de Tabbit, y aquí no se reclama ninguna prueba práctica en Tabbit. Comprueba el selector de tu cuenta antes de planificar en torno a él, como harías con la disponibilidad de cualquier modelo en cualquier cliente.
Si el perfil de arriba coincide con tu trabajo — ejecuciones largas, contexto pesado, llamadas a herramientas, disciplina de costos — la pregunta correcta no es "qué modelo puntúa más" sino "qué modelo termina mi trabajo". Corre un conjunto fijo de tareas tuyas con dos candidatos y cuenta trabajo terminado por dólar. Esa prueba gana a cualquier fila de leaderboard de este artículo.
 Tabbit Browser

Preguntas frecuentes
¿Merece la pena usar MiMo-V2.6-Pro?
Sí, para cargas de trabajo largas de código agéntico, automatización y escritura creativa donde importa más la calidad del resultado que la respuesta inmediata. Piénsalo dos veces si necesitas primeras respuestas rápidas, puntos de conexión con retención cero verificada o despliegue local en una sola GPU, y compara al menos un rival antes de decidir.
¿Cuánto tarda MiMo-V2.6-Pro en responder?
Artificial Analysis midió 18,17 segundos hasta el primer token de respuesta en el proveedor Xiaomi con una carga de trabajo de 10.000 tokens de entrada, verificado el 22 de septiembre de 2026. Después de la espera genera a unos 125 tokens por segundo, así que casi toda la demora es razonamiento silencioso.
¿Los tokens de pensamiento cuestan dinero en MiMo-V2.6-Pro?
Sí. Xiaomi factura el razonamiento interno como tokens de salida estándar a 0,87 USD por millón. Artificial Analysis registró unos 37.500 tokens de pensamiento frente a 26.800 tokens de respuesta por tarea del índice, así que buena parte de la factura paga pensamiento que nunca ves.
¿Cómo se compara MiMo-V2.6-Pro con Grok 4.7 y Claude Opus 5?
En el Índice de Inteligencia de Artificial Analysis verificado el 22 de septiembre de 2026, MiMo-V2.6-Pro y Grok 4.7 puntúan 46 y Claude Opus 5 puntúa 51. El informe de Xiaomi sitúa DeepSWE v1.1 en 71,9 frente a unos 73 de Grok 4.7 y 74 de Opus 5, a 0,435 USD por millón de tokens de entrada frente a 2 y 15 USD.
¿Es MiMo-V2.6-Pro de código abierto y puedo ejecutarlo yo mismo?
Los pesos son de licencia MIT y se descargan de Hugging Face, un acceso más fuerte que el de la mayoría de modelos frontera. El autoalojamiento es exigente: el checkpoint es un MoE disperso de 1,02 billones de parámetros con 42 mil millones activos, y los ejemplos oficiales de vLLM y SGLang asumen configuraciones multi-GPU. Los resúmenes de parámetros difieren entre fuentes, así que verifica el checkpoint exacto antes de dimensionar hardware.
¿Puedo usar MiMo-V2.6-Pro en Tabbit Browser?
Tabbit ejecuta flujos de trabajo de IA a nivel de navegador con los modelos de tu selector en vivo. Esta revisión no pudo verificar si MiMo-V2.6-Pro aparece hoy en ese selector, así que comprueba tu propio selector y los términos de tu cuenta antes de planificar en torno a él.