
MiMo-V2.6-Pro 值得認真試一次:長程 Agent 批量任務、自動化工作流,以及出人意料的——寫文章。它同時也是最消耗你耐心的模型:發布當天,最強的開源智慧分數背後,是開口前最長的等待之一。幾個小時內,一位開發者說它修好了一個競品旗艦模型修不動的腳本;另一位說它在終端裡空轉了三十分鐘。這兩則回饋都是真的。這篇評測負責把它們分揀清楚。
本文只計入你能點開核對的證據:官方口徑、獨立測量資料和有日期的社群回饋,各自標明它能證明什麼。發布資訊在 MiMo-V2.6-Pro 模型頁 (简体中文),錢的事在定價分析。這裡回答一個更窄的問題——它值不值得用、適合誰、代價是怎樣的等待。
文末我會看這些結論對瀏覽器級工作流意味著什麼。如果你的日常是多頁面調研、資訊抽取和自動化,而不是守著一個聊天框,這部分與你有關。
核心結論
MiMo-V2.6-Pro 在 Artificial Analysis 智慧指數上得 46 分,同類 114 個模型中排名第一,是得分最高的開放權重模型;每項指數任務成本 0.13 美元,為對比組最低。(Artificial Analysis,2026-09-22 核對)
另一面是等待:Xiaomi 供應商 1 萬輸入 token 工作負載下,首個答案 token 需 18.17 秒,其中大部分是靜默思考;之後的生成速度約每秒 125 token。(AA 供應商基準)
思考 token 按輸出計費,每百萬 0.87 美元(6.00 元)。指數任務集上思考 token 約 37,500 個,答案 token 約 26,800 個。
發布當天的真實回饵兩極:一個壞掉的 Python 腳本在 GPT-6 Astra Light 失手後被它修好;一次 grep 迴圈三十分鐘,DeepSeek V4.1 Flash 完成了同樣的任務。兩個方向都只有單次樣本。
寫作是最大的意外驚喜——角色扮演與長文使用者盛讚場景推進和對話質感。工具迴圈失控是最大的風險。按工作負載的裁決見文末決策表。
MiMo-V2.6-Pro 到底是什麼
小米在 2026-09-22 發布 MiMo-V2.6-Pro 與 MiMo-V2.6-Flash (简体中文),定位是圍繞大規模強化學習打造的「原生全模態」開放權重模型。Pro 是稀疏 MoE:約 1.02T 總參數、每 token 啟用 42B,100 萬 token 上下文視窗,支援文字、圖片、音訊、視訊輸入、文字輸出,MIT 授權。權重在 Hugging Face(XiaomiMiMo/MiMo-V2.6-Pro-RL);API 名稱是 mimo-v2.6-pro,另有單獨定價的高速檔 mimo-v2.6-pro-ultraspeed。V2.5 系列端點將於 2026-10-21 下線(遷移背景)。
看任何數字之前先注意一件事:參數口徑互相矛盾。技術報告寫 1.02T 總參數 / 42B 啟用;Hugging Face 摘要另有一行 524B;Artificial Analysis 結構化資料寫 978B passive。把 1.02T/42B 當作官方技術報告的架構口徑,但給硬體做預算前要核對具體 checkpoint。
本文回答的不是「它聰明嗎」——排行榜已經回答了。而是:一個有著這樣的速度畫像、這樣的計費結構、這樣的工具迴圈特性的模型,是否適合進入你的工作流,尤其是對比 GPT-6 Astra、Claude Fable 5.1 或更便宜的 Gemini 3.8 Flash 時。
決定這篇評測的那一個數字:18 秒的沉默
下面這組數字統攝全文。MiMo-V2.6-Pro 拿下 Artificial Analysis 測得的最高開放權重智慧分(46 分,114 個同類第一),同時是對比組裡每任務成本最低的模型(0.13 美元)。它也是名單供應商(Xiaomi,1 萬輸入 token 工作負載,2026-09-22 核對)上首個答案 token 需要 18.17 秒的模型。
這兩個數字描述的是兩個完全不同的模型,取決於等的是誰。對一個要跑三十輪工具呼叫的後台 Agent 來說,18 秒的前置思考攤薄在幾分鐘的無人值守工作裡幾乎無感,之後 125 token/秒的生成速度在同一快照裡只落後一兩個模型。對一個提了問題盯著游標的人來說,18 秒無比漫長,而 500 token 回答的端到端 22.2 秒更糟。
同日早些時候的 Artificial Analysis 快照把等待拆開:思考 15.41 秒 + 輸入處理 2.17 秒——87.7% 的等待是模型開口前的推理。同一份結構化資料也解釋了帳單的怪相:每項指數任務約 37,520 個推理 token 對 26,756 個答案 token。每看到 1 個 token 的答案,你要為約 1.4 個 token 的隱藏思考付錢。
Reddit 使用者在發布幾小時內就撞上了同一堵牆:
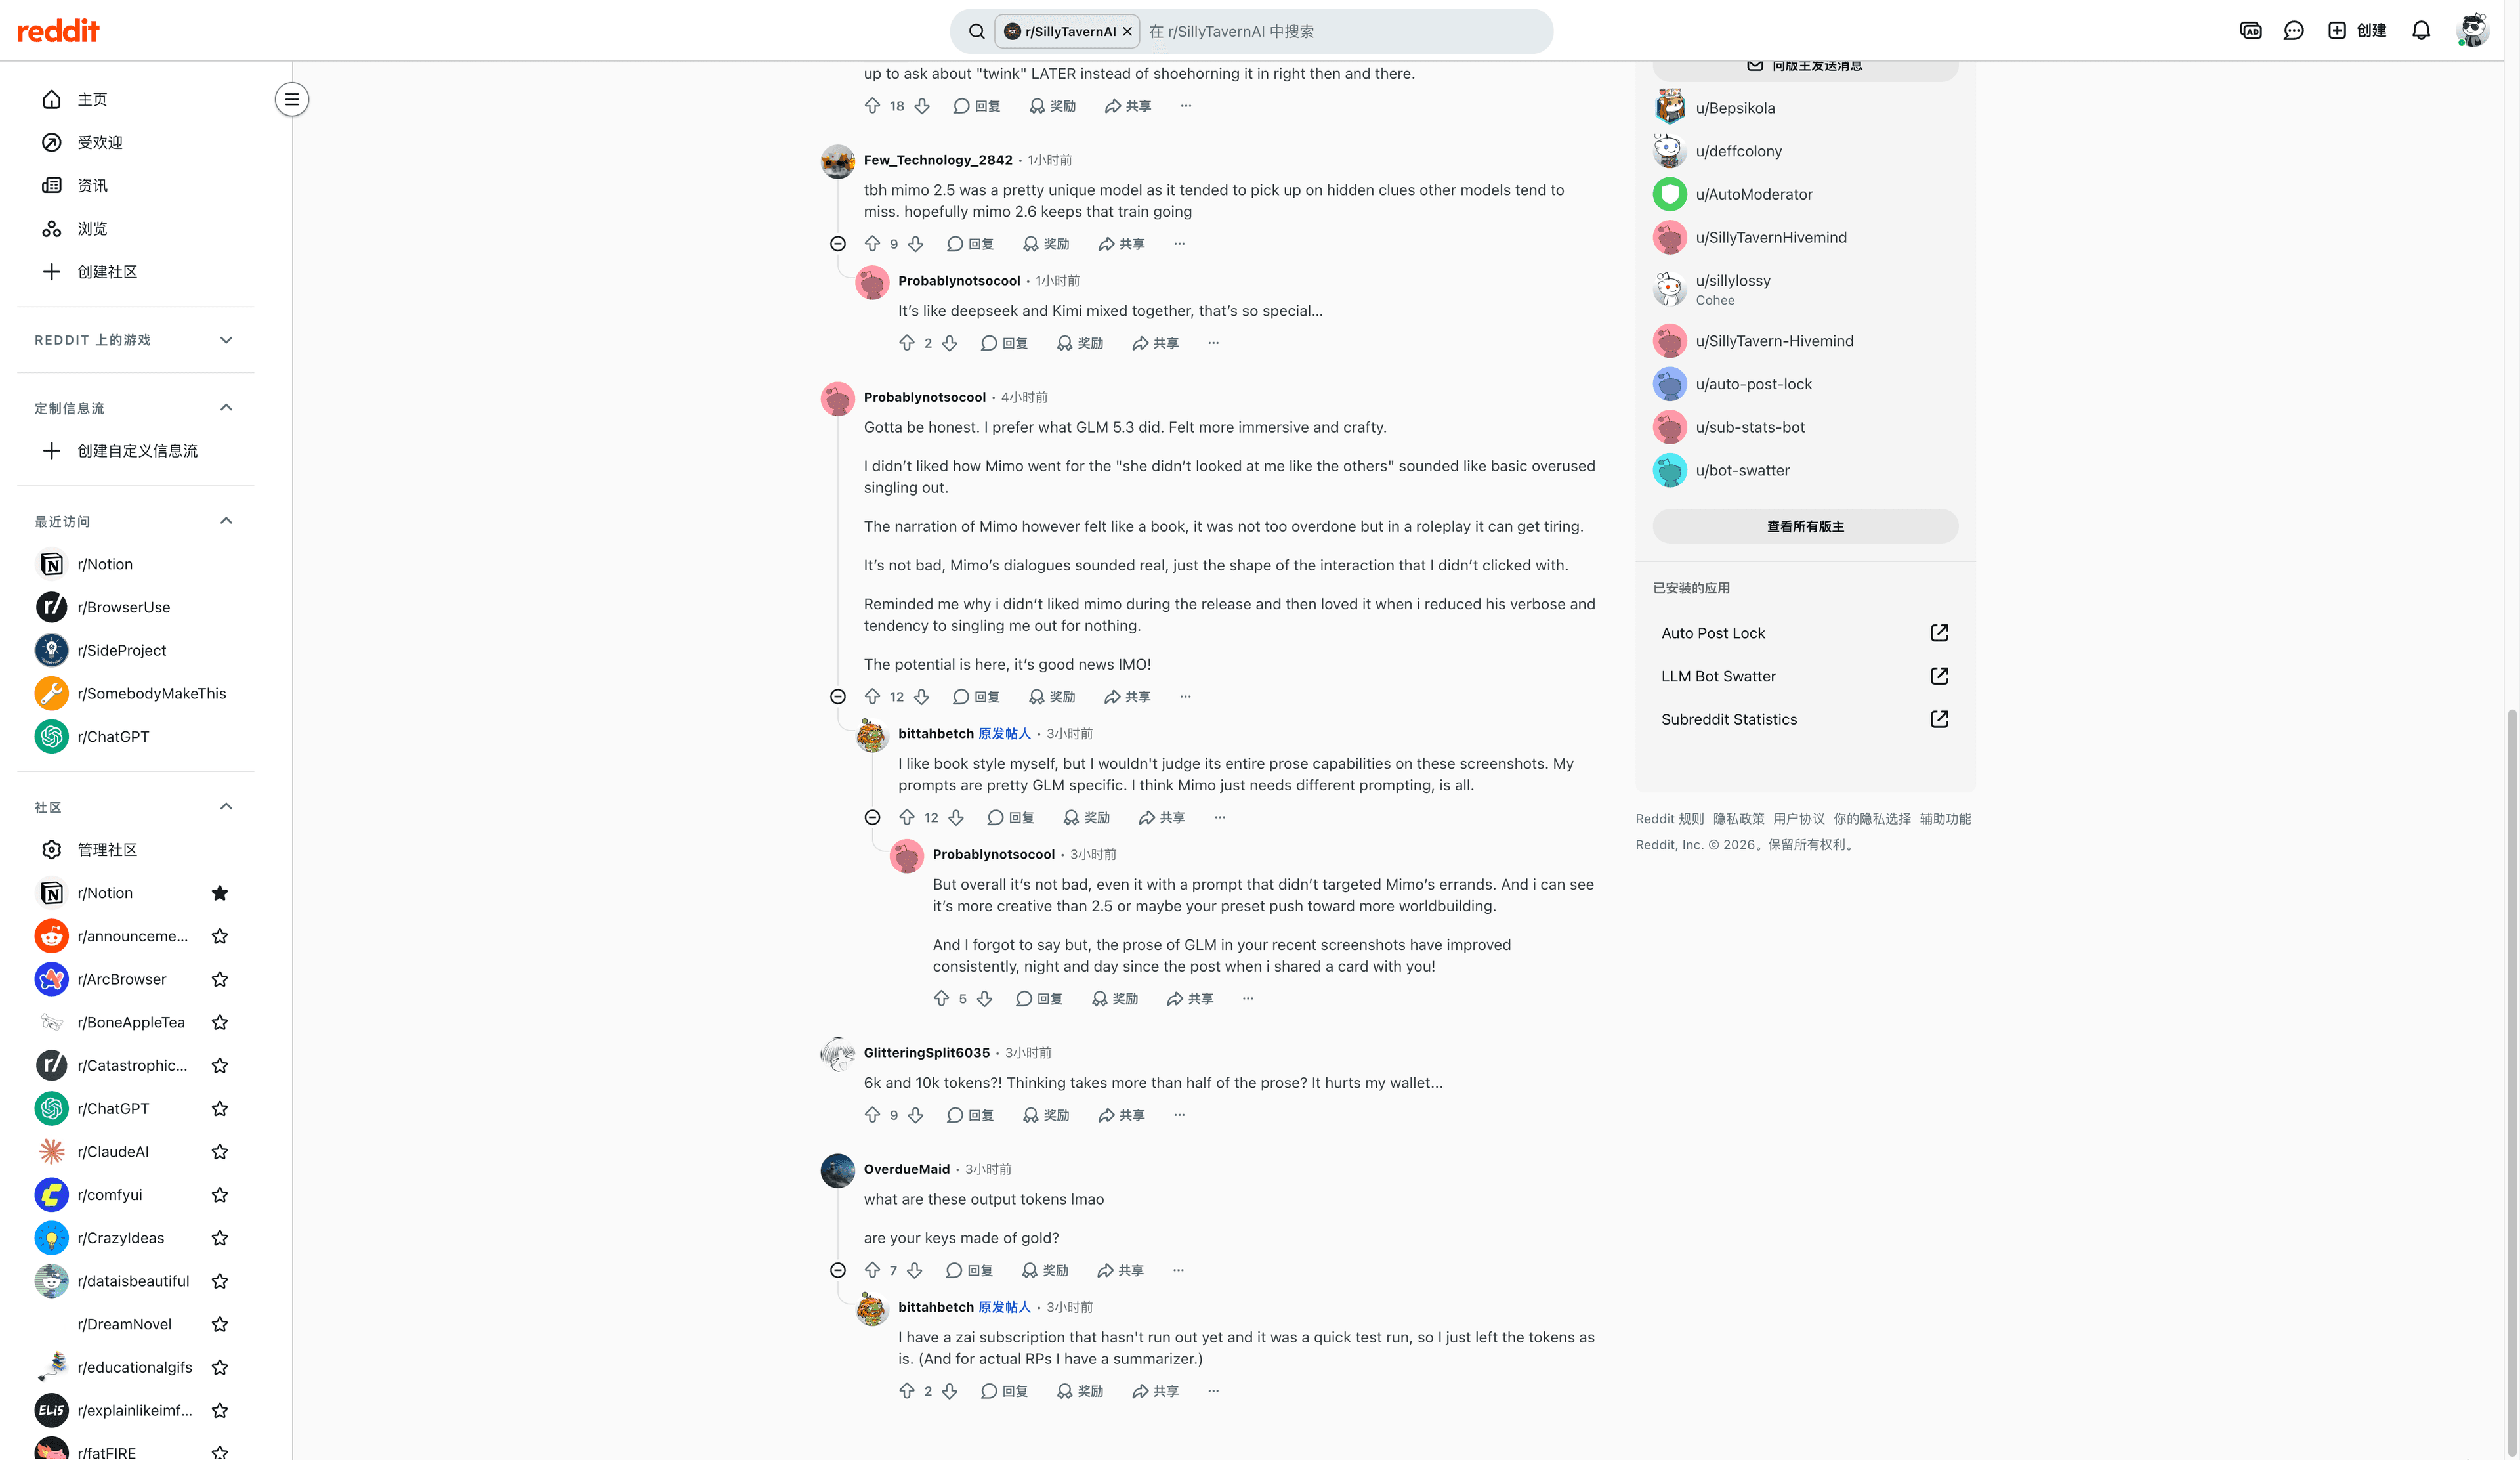
"6k and 10k tokens?! Thinking takes more than half of the prose? It hurts my wallet..." ——u/GlitteringSplit6035(r/SillyTavernAI,2026-09-22;譯:六千一萬個 token?思考佔了正文的一半多?我的錢包在滴血……)
"what are these output tokens lmao are your keys made of gold?" ——u/OverdueMaid(同帖;譯:這些輸出 token 是什麼鬼,你的 key 是金子做的嗎?)
用這個錨點分揀你的工作負載:工作單位是長跑,就買它的腦子、忍它的等待;工作單位是人的一個回合,那等待本身就是產品。
先看真實工作上的成敗,再看排行榜
發布當天最有用的證據不是基準行,而是兩個有具體工具、具體結果的小故事。
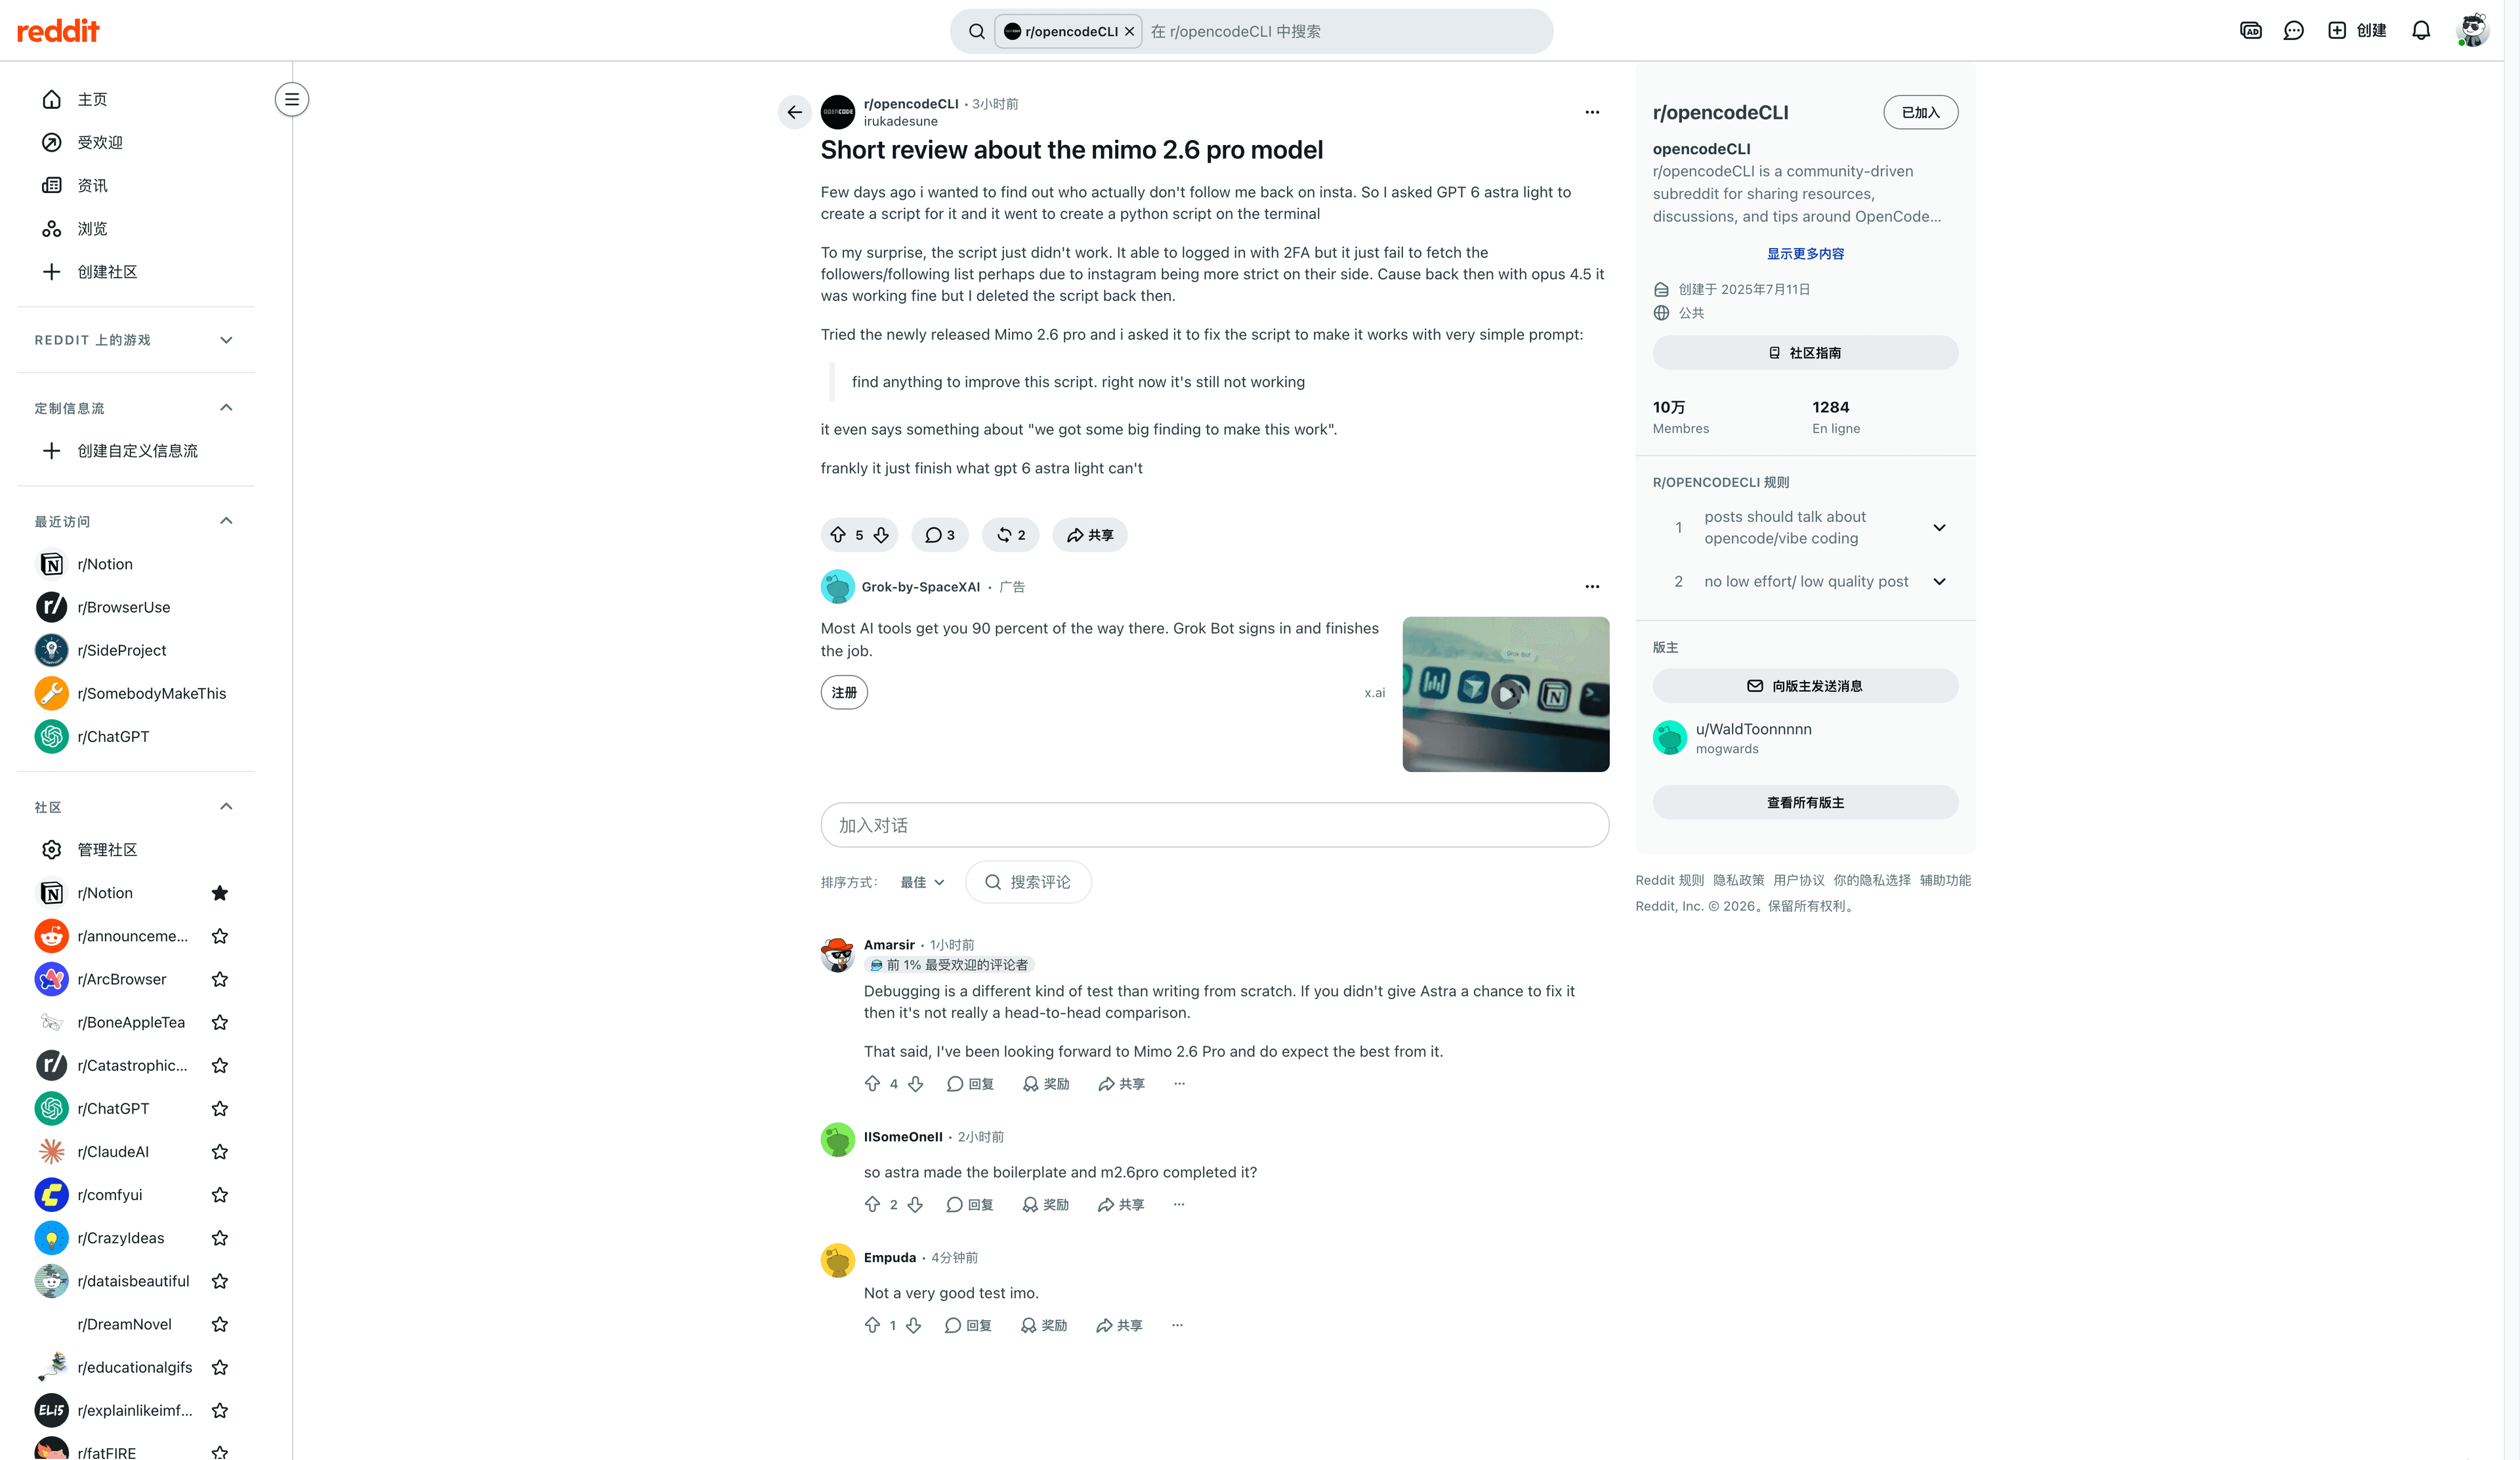
贏的那次。 u/irukadesune 有個查 Instagram 回關的 Python 腳本。GPT-6 Astra Light 重寫後依然在拉取粉絲列表時失敗。給 MiMo-V2.6-Pro 的提示只有一句:"find anything to improve this script. right now it's still not working." 它修好了。
"frankly it just finish what gpt 6 astra light can't" ——u/irukadesune(r/opencodeCLI,2026-09-22;譯:說白了,它就是把 GPT-6 Astra Light 幹不完的活幹完了)
潑冷水的回覆。 該帖最高讚回覆指出了這個故事能與不能證明什麼:
"Debugging is a different kind of test than writing from scratch. If you didn't give Astra a chance to fix it then it's not really a head-to-head comparison." ——u/Amarsir(同帖;譯:偵錯和從零寫是兩種不同的考驗;沒給 Astra 修的機會,就談不上正面對比)
輸的那次。 u/choiyoh 把同一個網站 UI/UX 修改任務交給 MiMo-V2.6-Flash 和 MiMo-V2.6-Pro,在終端編碼工具裡執行。兩個模型都陷入 grep 迴圈,毫無進展。
"for 30 minutes no code was fixed." ……"DS 4.1 Flash is still much better.." ——u/choiyoh(r/CommandCode,2026-09-22;譯:三十分鐘沒有修好任何程式碼……DS 4.1 Flash 還是好用得多)
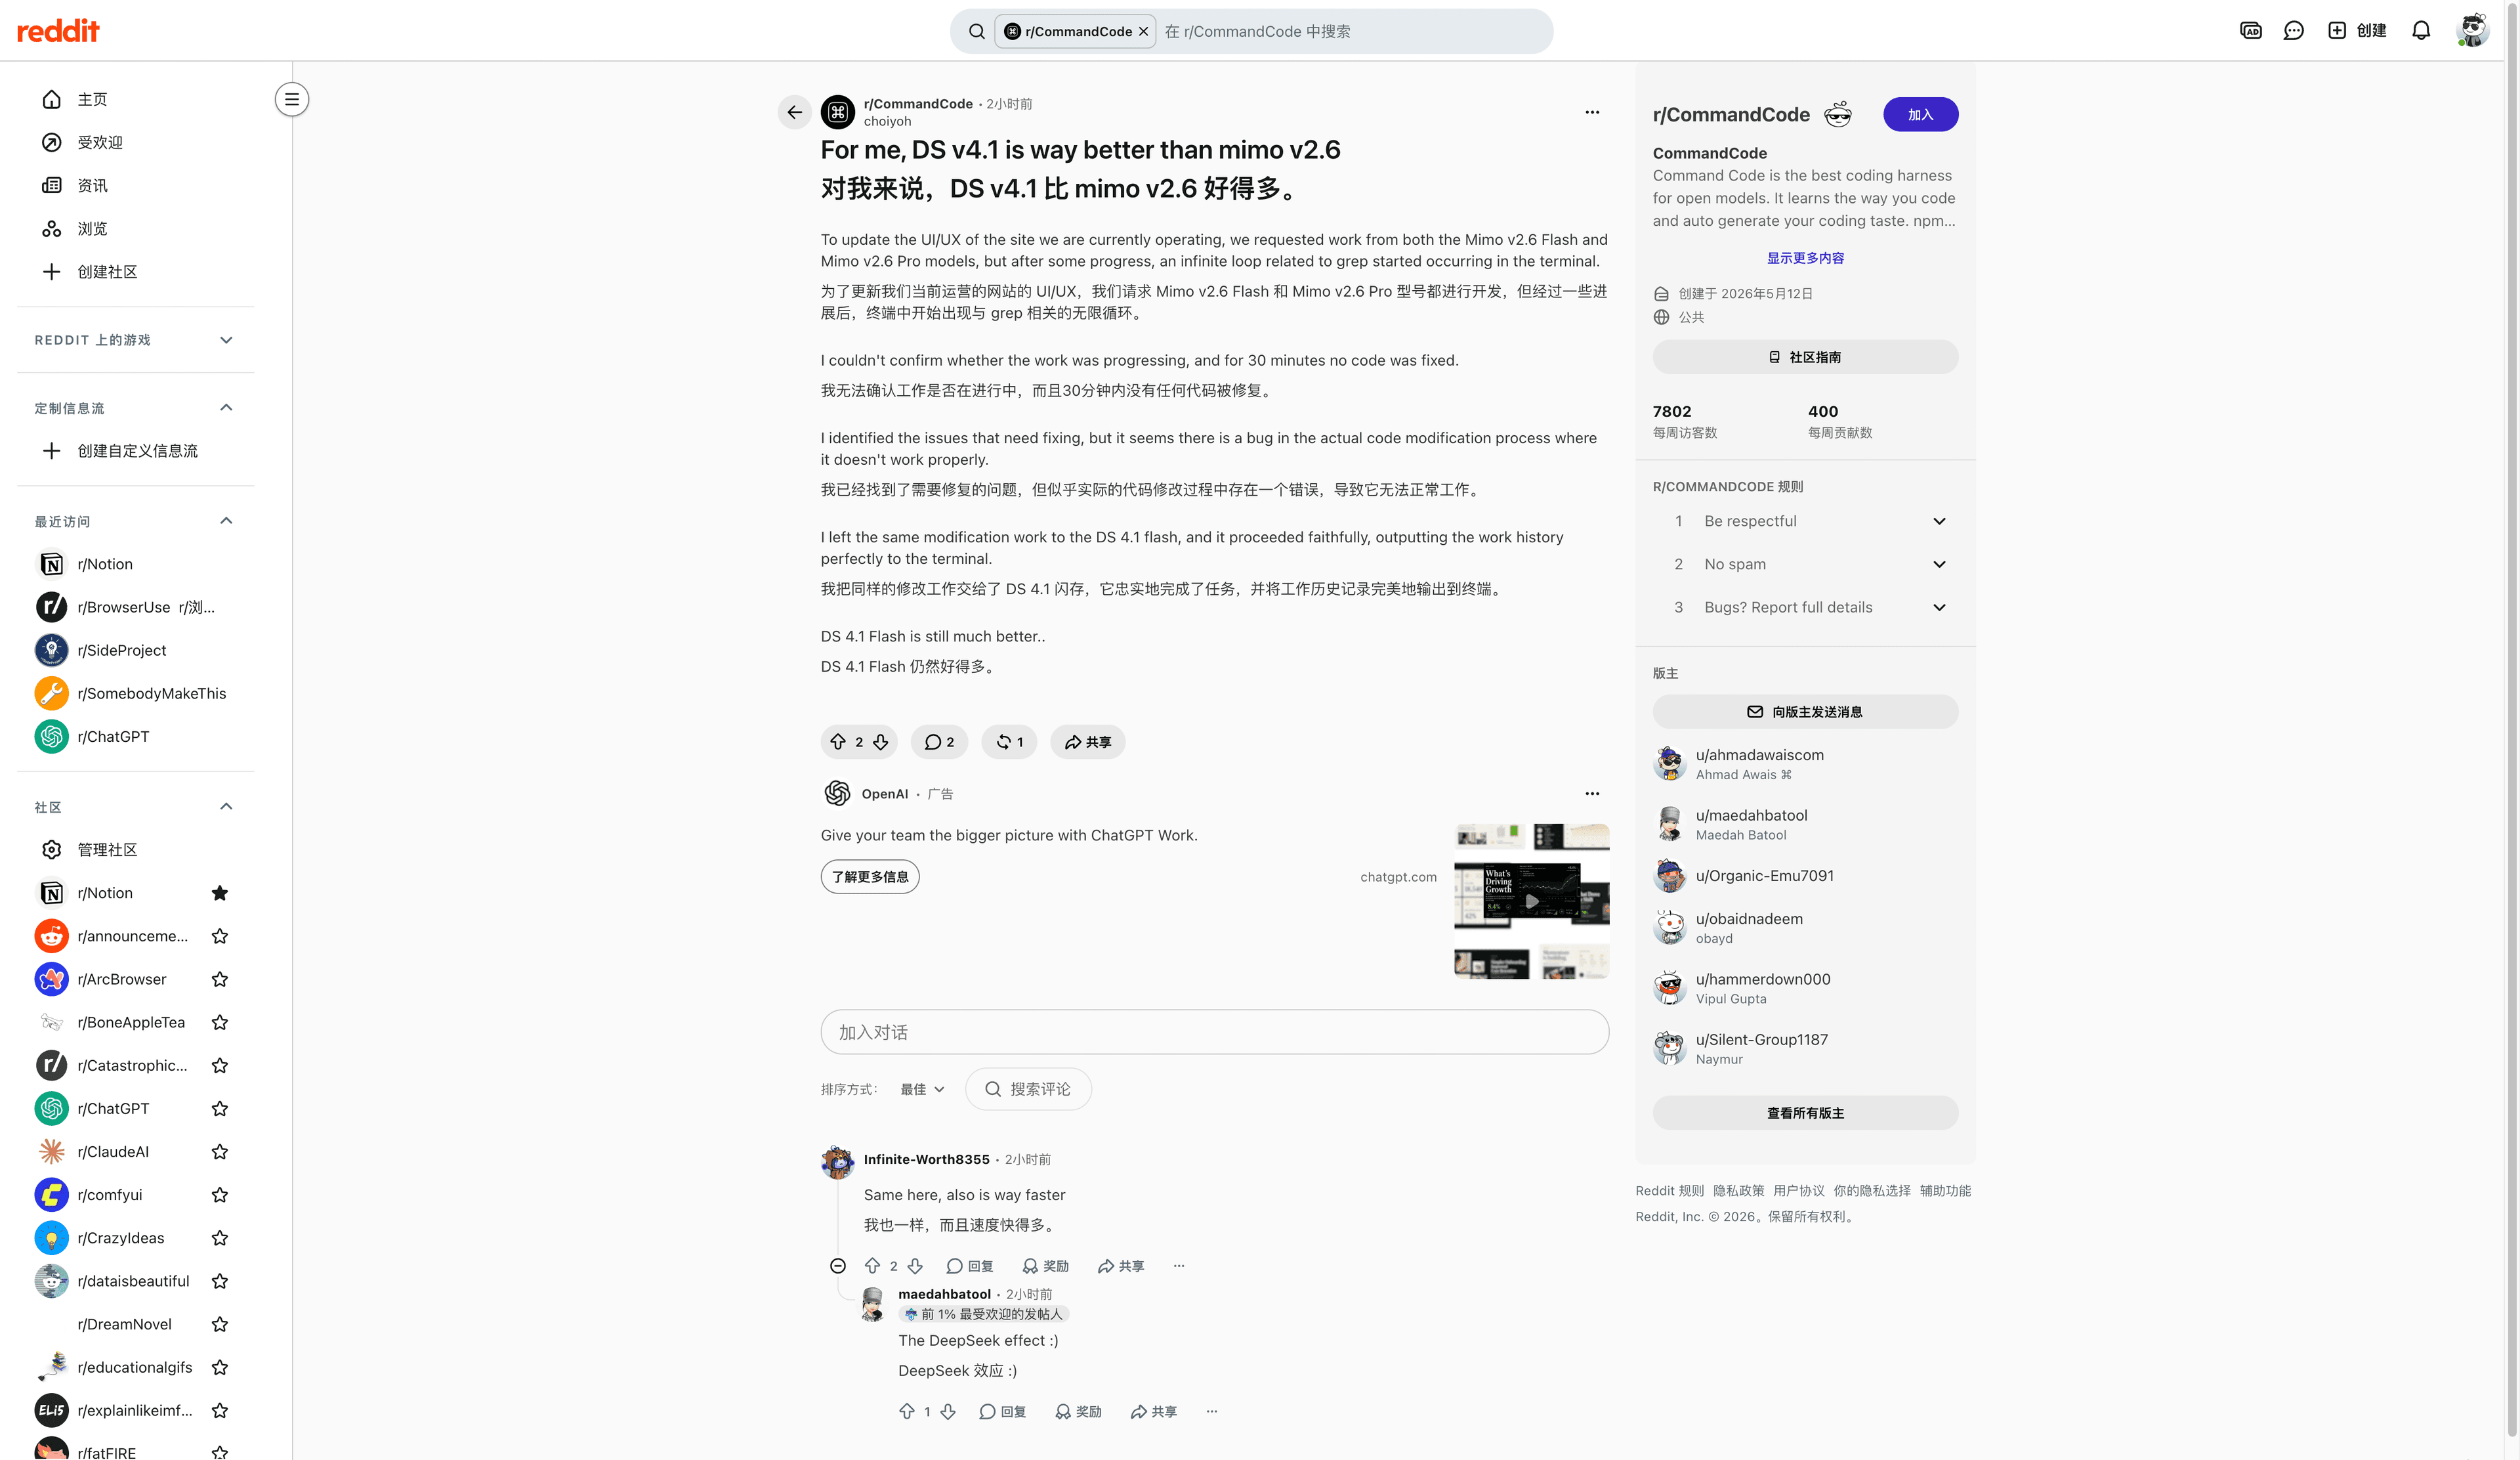
各一次執行,沒有日誌、沒有 repo、沒有 token 統計。它們只能證明兩種結果都真實存在——贏過競品的偵錯修復,和三十分鐘的工具空轉——證明不了各自的發生頻率。這正是基準應該填補的空白。來看看它們到底填了多少。
基準數據,以及該信幾分
小米技術報告(Table 3,廠商自報,2026-09-22 核對)把 Pro 與自家家族和三個閉源旗艦做了對比。數值按報告原樣記錄,- 表示未提供:
| 基準 | MiMo-V2.6-Pro | MiMo-V2.6-Flash | MiMo-V2.5-Pro | Claude Opus 5 | GPT-5.6 Sol | Claude Fable 5 |
|---|---|---|---|---|---|---|
| DeepSWE v1.1 | 71.9 | 67.9 | 19.0 | 74.0 | 73.0 | 70.0 |
| AutomationBench v1.0.6 | 53.1 | 52.3 | 16.0 | 50.3 | 45.8 | 46.2 |
| Toolathlon-Verified | 76.9 | 73.6 | 49.1 | 80.6 | 74.9 | 77.9 |
| Agents' Last Exam | 31.6 | 27.6 | 13.2 | 31.6 | 30.8 | 25.7 |
| Terminal Bench 2.1 | 89.9 | 87.6 | 65.2 | 89.1 | 88.8 | 84.3 |
| Terminal Bench 4.0 | 34.9 | 28.8 | 1.5 | 49.0 | 39.9 | 42.4 |
| OSWorld-Verified | 82.0 | 80.8 | - | 83.4 | 83.0 | 86.0 |
| JobBench | 62.0 | 61.2 | 25.0 | 65.7 | 45.4 | 57.4 |
| MiMo Visual Coding(自研) | 72.3 | 71.5 | - | 70.0 | 73.4 | 69.1 |
現在按慣例潑三盆冷水。
測量條件很薄。 報告只給彙總分,沒有逐題日誌、提示詞、隨機種子、樣本量和信賴區間。三行(MiMo Code Bench、MiMo Cyber Bench、MiMo Visual Coding)是小米自己的基準。被反覆轉述的「DeepSWE 58.4 → 72.6」是同一次 RL 訓練內的曲線變化——約 30 步、262 萬美元算力——不是模型對模型的比較。官方發布頁「在多數 Agent 基準上與 Claude Opus 5 和 GPT-5.6 Sol 相當」是定位話術,「價格是其 1/20 到 1/60」的說法沒有給出對比集和 token 口徑。
社群預設不信任訓練期排行榜:
"We'll see how it works on real code. DeepSeek-V4.1-Flash was technically a lot more capable than GLM-5.3-Flash but it's worse in the real-world … The benchmarks don't care if it's a code spaghetti." ——u/lilian_moraru(r/LocalLLaMA,2026-09-22;譯:真實程式碼裡見分曉……基準測試並不在意程式碼是否混亂不堪)
"i mostly care about roleplay so those benchmark wins dont mean much if it still forgets details after a few messages." ——u/Pure-Summer2818(同帖;譯:我主要看角色扮演,聊了幾句就忘細節的話,基準贏了也沒意義)
獨立來源印證的是形狀,不是精度。 Artificial Analysis 在自有硬體上跑出 46 分智慧指數(v4.3.2,10 項評測);Arena 的 Code Arena WebDev 行是 AutoEval 1628(+18/-18),Rank 與 Votes 均為 N/A——那是盲測投票榜上的腳本結果,不能寫成「排名第 N」。上文 Amarsir 的方法論提醒適用於這裡的每一行:偵錯不是創作,一個 harness 不是你的 harness,方向性訊號不是標尺。
潑完冷水還站得住的:相對 V2.5-Pro 的代差(DeepSWE 19.0 → 71.9)大到不可能是統計花招;報告裡跨 harness 遷移實驗(四個訓練 harness,再測沒見過的 Codex、Claude Code、mini-swe-agent,通過率約 50% → 66%)是真正貼近部署的證據。只是別把任何一行讀成你的成功率。
MiMo-V2.6-Pro 真正強的地方
寫作是最大的意外
編碼模型很少先被誇文筆。發布當天最響亮的讚美來自長文角色扮演寫手——這是一群對重複套路極其苛刻的使用者。
"honestly I'm really enjoying it for RP so far. The responses have been surprisingly good, especially when it comes to keeping the flow of a scene going and actually giving me something interesting to work with instead of falling into the usual repetitive RP patterns." ——u/Electrical_Mode_2489(r/SillyTavernAI,47 讚;譯:RP 體驗真的好,尤其擅長推著場景走,給我有意思的東西接戲,而不是掉進重複套路)
另一位與 GLM 5.3 正面對比的寫手喜歡它的對話和克制:它「set[] up to ask about 'twink' LATER instead of shoehorning it in right then and there」(譯:把關鍵資訊留到後面再問,而不是硬塞進當下)。如果你以寫作為生——小說、行銷文案、長互動故事——這個升級對你可能比任何編碼分都重要。
邊界:文風是個人口味。在同一個對比帖裡,u/Probablynotsocool 更喜歡 GLM 5.3("Felt more immersive and crafty"),覺得 MiMo 的敘事「like a book … in a roleplay it can get tiring」(譯:像讀小說,放在 RP 裡容易累)。兩位都是有經驗的使用者,同樣的輸出,相反的結論。
自動化與工具工作流,紙面上勝過旗艦
基準的形狀在這裡是真偏向 MiMo 的。AutomationBench v1.0.6:53.1,超過 Claude Opus 5(50.3)和 GPT-5.6 Sol(45.8)。Toolathlon-Verified:76.9,距 Opus 5 僅 3 分並領先 Sol。Terminal Bench 2.1:89.9,對比組第一。JobBench 62.0 是 GPT-5.6 Sol(45.4)的近一倍半。
這些行背後的工程細節對部署更重要:RL 階段在四個極簡 harness 上訓練,再在三個沒見過的 harness(Codex、Claude Code、mini-swe-agent)上驗證遷移。只在自家 harness 裡好用的模型是展示品,能遷移的模型才是基礎設施。對搭建多步工具迴圈的人——瀏覽器 Agent、CI 修復器、內部自動化——這是試用它的最強理由。
商品級價格上的旗艦智慧,還帶 MIT 權重
2026-09-22 核對的 Artificial Analysis 快照裡,MiMo-V2.6-Pro 智慧指數 46 分——與 Grok 4.7(46)持平、低於 Claude Opus 5(51)——同時是對比組每指數任務成本最低的模型(0.13 美元)。牌價是每百萬 token 輸入 0.435 美元 / 輸出 0.87 美元(3.00 / 6.00 元),快取命中降到 0.0036 美元——120 倍折扣悄悄改寫了多輪對話的經濟性(定價精算見此;想橫向比較開放旗艦預算,可看 Kimi K3 定價拆解)。
同日旗艦的社群對比把這筆帳算得很具體:對 Grok 4.7,MiMo 上下文 100 萬對 50 萬 token、約 125 對 42 token/秒、MIT 權重對閉源、0.435/0.87 對 2/6 美元——而兩者智慧指數同為 46 分。如果你的約束是「每美元買到多少能力」——批量 Agent、研究流水線、Agentic 推理工作負載——這就是本次發布的價值主張。
它會咬人的地方
思考稅:沉默你付兩次錢
一次付在等待,一次付在帳單。首個答案 token 18.17 秒;每項指數任務約 37,520 個推理 token 對 26,756 個答案 token,全部按每百萬 0.87 美元的輸出計費。推理密集的提示詞上,社群使用者回饋思考量超過總生成量的一半——正是上文「6k and 10k tokens?!」式反應的由來。
小米官方的逃生口是 mimo-v2.6-pro-ultraspeed:最高 20 倍生成速度,價格恰好 10 倍(輸入 4.35 美元 / 輸出 8.70 美元)。對有預算的互動式產品是真選項,但它把模型重新定價回了前沿區間,抵消了最大的性價比賣點。官方 API 材料裡目前沒有「少想點」的開關——定價分析裡把這筆帳算完了。
工具迴圈會跑飛
上文 grep 迴圈是 Agent 工作裡最疼的失敗形態:不是答案錯,而是沒有答案,計費還在走。技術報告坦誠其訓練基礎設施遇到過 OOM、評分器不可達和部分 rollout 失敗,但沒有給出各基準的統一失敗率。同帖另一位使用者印證了同樣的體驗("Same here, also is way faster",說的是競品)。如果拿它跑無人值守任務,就要配監督、工具呼叫逾時和備選模型——與你對待任何 Agent 瀏覽器棧的紀律相同。
合規、端點與部署重量
三個不進分數的現實麻煩:
資料處理。 發布當天就有使用者指出當前唯一線上端點是第一方的,且在他們的理解裡不符合零資料保留(ZDR):"very interesting, but 2.6 Pro's only endpoint is non-ZDR compliant"(u/total_ty),緊接著是"How trustworthy is a random tag on a website, honestly? How do we verify none of our data has been retained by the endpoint?"(u/starliteburnsbrite)。開源權重意味著第三方託管會來——"the weights are already up on huggingface"——但今天合規路線是自建,或者找一個你讀過條款的提供商。
自建很重。 1.02T 稀疏 MoE,官方 vLLM 範例預設
--tensor-parallel-size 8。這不是筆電模型。預算按多卡節點算,先讀參數口徑的細則。版本與價格漂移。 V2.5 端點 2026-10-21 關閉;Artificial Analysis 的數字同一天內就隨測量刷新漂移過(17.58 → 18.17 秒)。鎖定版本,做預算前重新核價。
大家到底怎麼說
發布當天的討論沿兩條軸分裂,而不是一條。
軸一:驚喜派對上燒手派。 修腳本的勝利和 grep 的翻車在 Reddit 上只隔四小時,兩邊陣營立刻滿員。u/irukadesune 一句提示修好了競品旗艦修不動的東西;u/choiyoh 在終端迴圈裡丟了三十分鐘,轉投 DeepSeek V4.1 Flash。興奮的人讀同樣的證據往外推——"I believe in mimo, mimo will replace GLM as THE rp model"(u/stopaskingforloginn)——懷疑的人則要日誌。
軸二:價格驚喜派對思考帳單派。 發布帖的第一波衝擊是經濟帳——"They kept the prices!? It's over."(u/Pink_da_Web,譯:價格沒漲?!別的模型沒戲了)——然後 token 數來了:
就連這個模型最滿意的使用者群——寫手們——內部也吵不出一致:
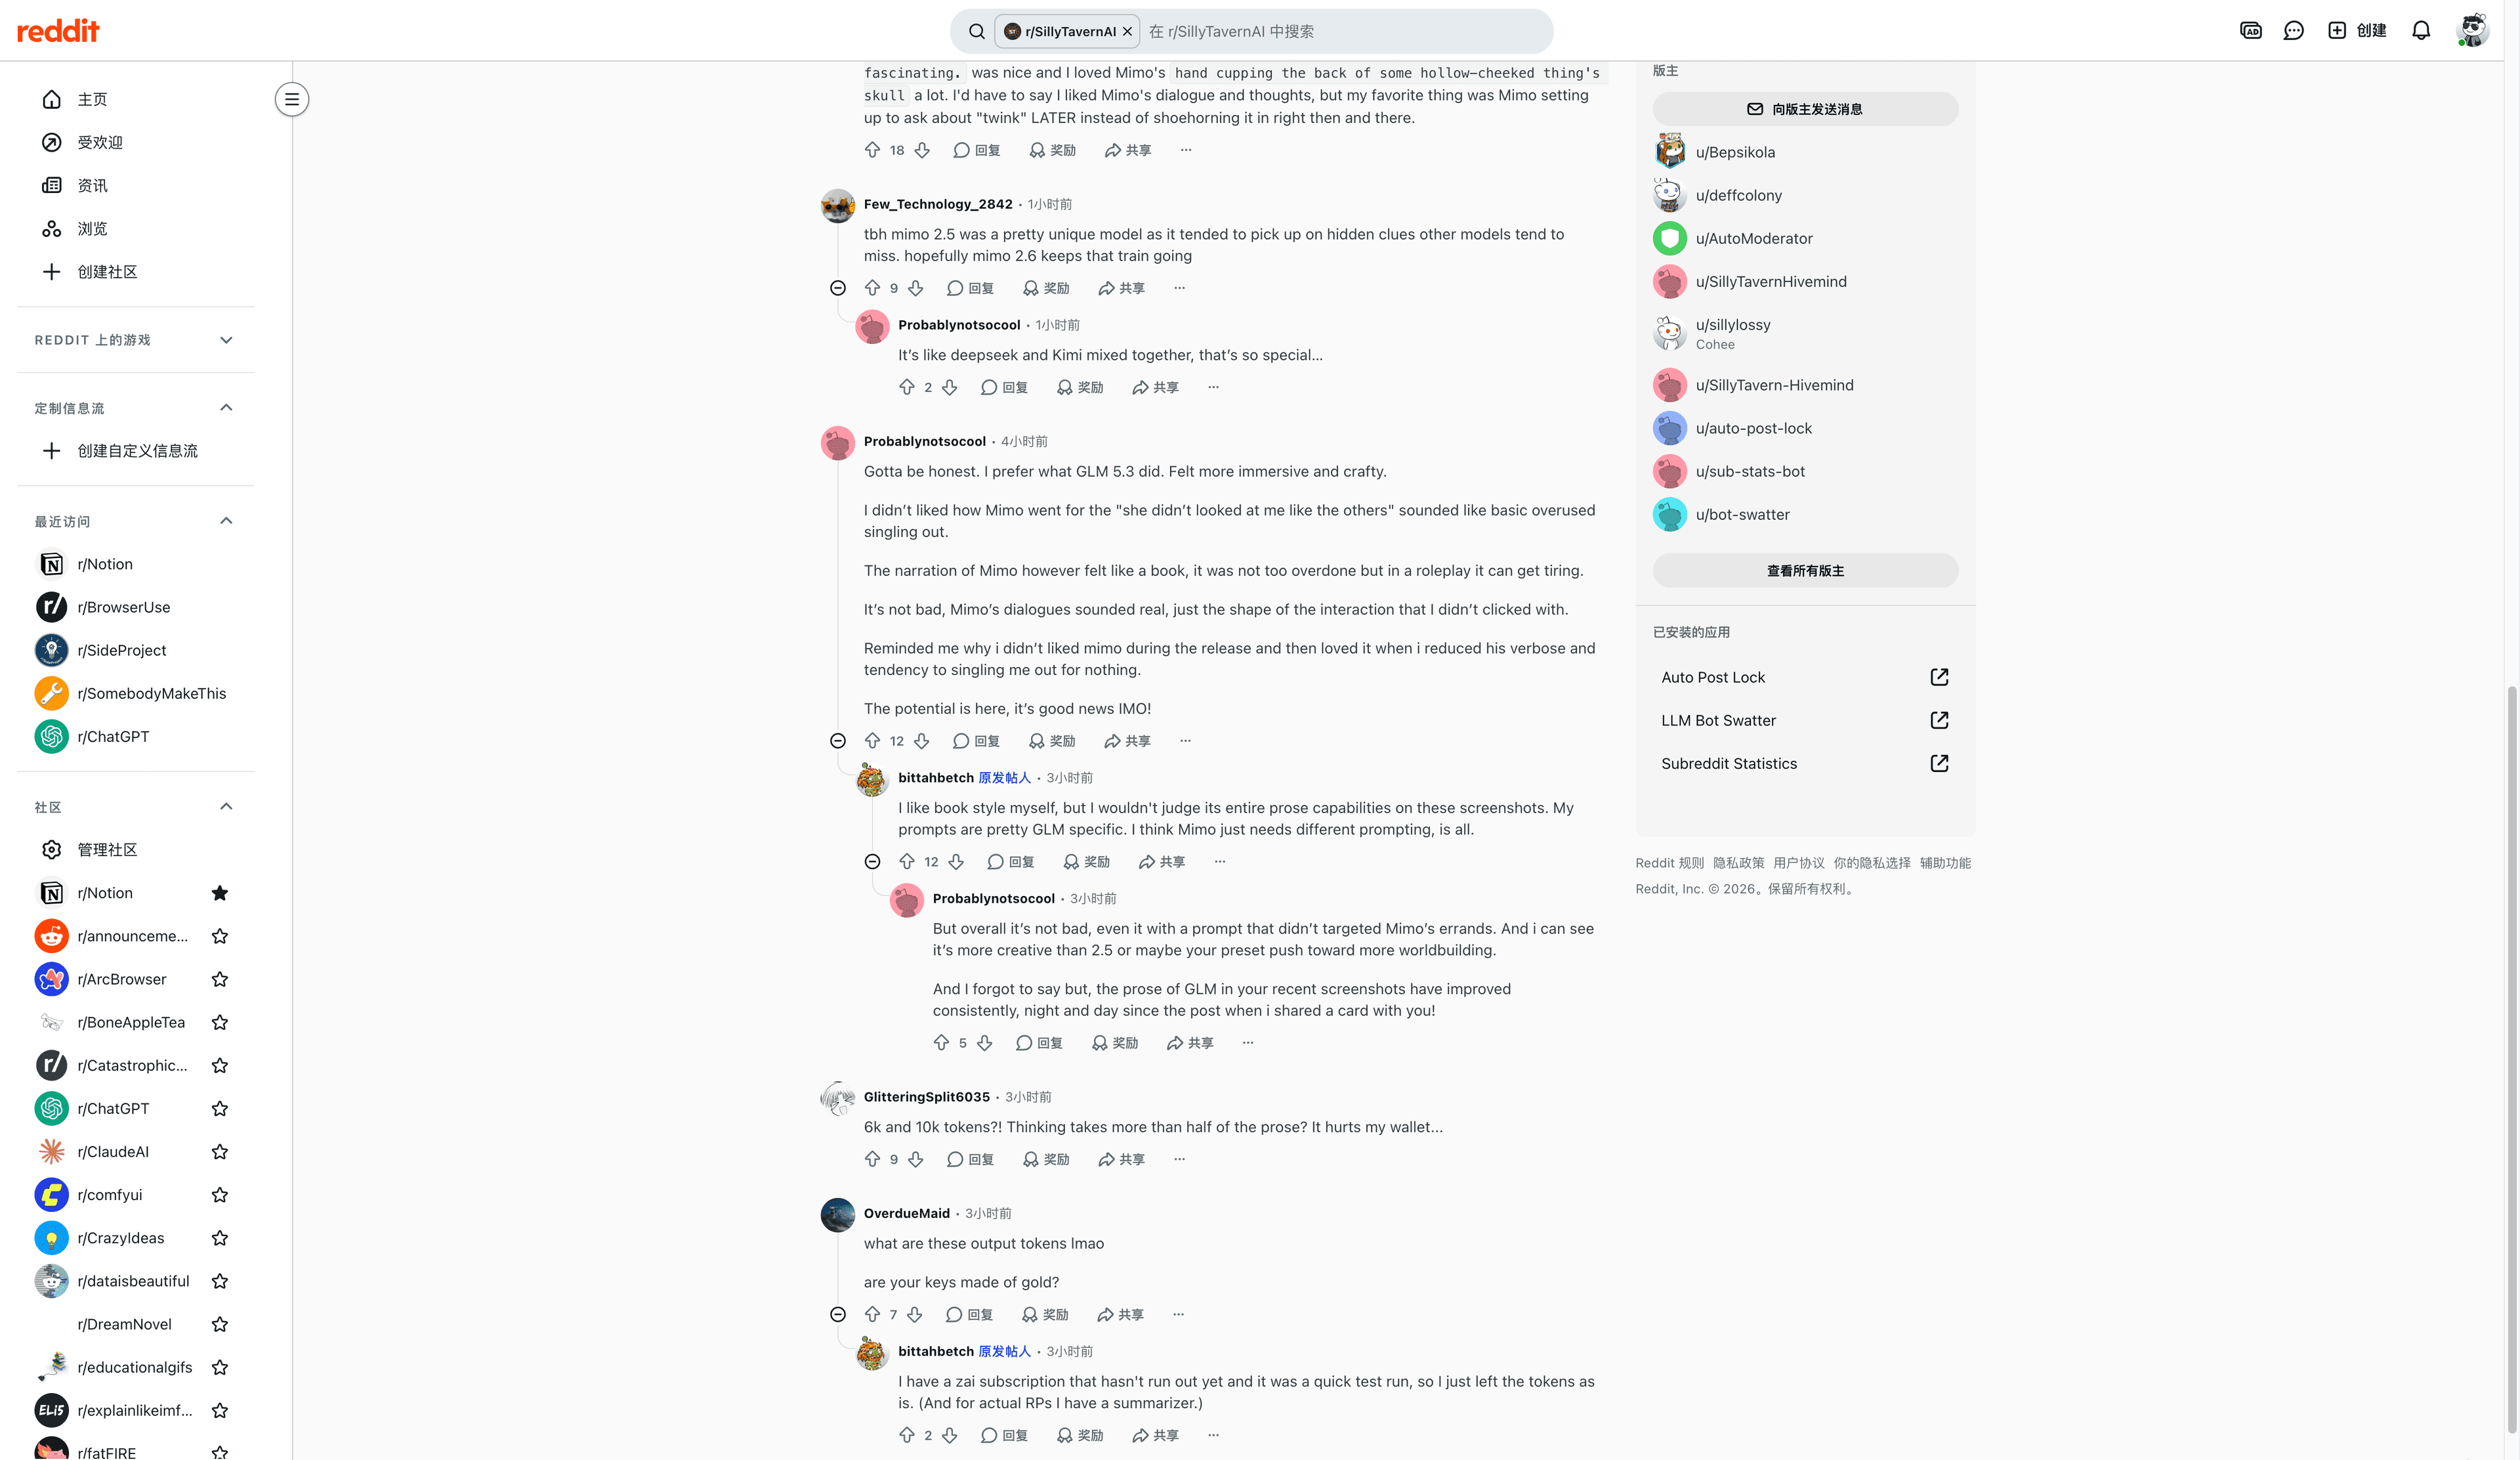
本文的立場:與 u/Amarsir 落點相同——欣賞這個模型,但對草率的對比不耐煩。九條可核對的聲音呈現的模式與數字一致:能力是真的,等待和帳單的摩擦是真的,工具迴圈的可靠性兩個方向都還停留在 n=1。
裁決:按工作負載選,不按分數選
| 工作負載形狀 | 裁決 | 為什麼 | 主要保留 |
|---|---|---|---|
| 長程 Agent 編碼、批量修復、無人值守工具迴圈 | 值得試 | AutomationBench 53.1 超過 Opus 5 與 Sol;有 harness 遷移證據;1M 上下文;0.13 美元/任務攤薄等待 | grep 式迴圈失敗真實存在;跑批要監督並留備選模型 |
| 互動對話、角色扮演與長文寫作 | 可以,帶條件 | 寫作讚美具體且重複出現;1M 上下文保住長場景連貫 | 18 秒首響 + 思考 token 同時抬高每場戲的延遲和成本;部分寫手更喜歡 GLM 5.3 的文風 |
| 電腦操作與瀏覽器自動化 | 強候選 | OSWorld-Verified 82.0、JobBench 62.0、視覺編碼 72.3(自研);全模態輸入 | 證據以廠商資料為主;先在你自己的任務集上驗證 |
| 受監管資料 / 零保留需求 | 暫不 | MIT 權重原則上允許自建或合規提供商 | 今天線上只有第一方端點,其 ZDR 狀態未經核實 |
| 單卡或筆電本地推理 | 不行 | 1.02T 稀疏 MoE;官方推理範例按 8 路張量平行 | Flash 家族或更小的蒸餾版才是現實的本地選項 |
兩個時效提醒。第一,Grok 4.7 同日發布,在 Artificial Analysis 指數上同為 46 分,社群對比的結論是「neither one decisively dominates the other」(譯:誰也不能穩壓誰)——你該做的是用你的工作負載跑對比,最好讓兩個模型並排作答。第二,V2.5 端點 2026-10-21 關閉,如果你建在它上面,遷移規劃沒有可選項。
一條務實路線:讓它在幹活的地方跑
這篇評測的所有結論都指向同一個畫像:等待傷人不傷 Agent;思考 token 懲罰閒聊式單輪、獎勵持續長跑;工具迴圈風險需要監督。這個畫像塞進文件旁邊的小聊天框是錯配,放進瀏覽器級工作流則是順理成章——讀頁面、裝下 100 萬 token 上下文、在你幹別的時候把活幹完。
這正是 Tabbit Browser 圍繞的工作方式:把多頁面調研、資訊抽取和自動化當作 agentic browser 任務,而不是一次提示詞。誠實的邊界:本輪評測未能核實 MiMo-V2.6-Pro 目前是否出現在 Tabbit 的即時模型選擇器中,本文不宣稱任何 Tabbit 實測。像對待任何模型在任何用戶端的可用性一樣,先檢查你帳戶裡的模型選擇器再做規劃。
如果上面的畫像和你的工作吻合——長跑、重上下文、工具呼叫、成本紀律——正確的問題就不是「哪個模型分最高」,而是「哪個模型把我的活幹完」。用你自己的固定任務集讓兩個候選跑一輪,按每美元完成的工作量結算。這個測試勝過本文裡的任何一行排行榜。
 Tabbit Browser

常見問題
MiMo-V2.6-Pro 值不值得用?
如果你跑的是長程 Agent 編碼、自動化任務或創意寫作這類更看重完成品質而非即時回應的工作負載,值得認真試一次。如果你需要快速首個回應、可驗證的零資料保留端點或單卡本地部署,就要謹慎,拍板前至少對比一個競品。
MiMo-V2.6-Pro 多久能給出回答?
Artificial Analysis 在 Xiaomi 供應商、1 萬輸入 token 工作負載下測得首個答案 token 為 18.17 秒(2026 年 9 月 22 日核對)。等待之後生成速度約每秒 125 token,因此絕大部分延遲是開口之前的靜默思考時間。
MiMo-V2.6-Pro 的思考 token 計費嗎?
計費。小米把內部推理 token 按標準輸出計費,每百萬 6.00 元(0.87 美元)。Artificial Analysis 記錄到每項指數任務約 37,500 個思考 token 對 26,800 個答案 token,你付的輸出費用有很大一部分花在看不到的思考上。
MiMo-V2.6-Pro 跟 Grok 4.7、Claude Opus 5 比怎麼樣?
在 2026 年 9 月 22 日核對的 Artificial Analysis 智慧指數上,MiMo-V2.6-Pro 與 Grok 4.7 同為 46 分,Claude Opus 5 為 51 分。小米自己的報告裡 DeepSWE v1.1 為 71.9,Grok 4.7 約 73、Opus 5 為 74;輸入價格則是每百萬 3.00 元對 2 美元和 15 美元。
MiMo-V2.6-Pro 是真開源嗎,能自己部署嗎?
權重採用 MIT 授權並可在 Hugging Face 下載,開放程度高於多數前沿模型。但自建門檻很高:這是約 1.02T 總參數、42B 啟用參數的稀疏 MoE,官方 vLLM 與 SGLang 範例都按多卡配置。各處參數摘要口徑不一致,選型前務必核對具體 checkpoint。
能在 Tabbit Browser 裡用 MiMo-V2.6-Pro 嗎?
Tabbit 透過帳戶即時模型選擇器來執行瀏覽器級 AI 工作流。本輪評測未能核實 MiMo-V2.6-Pro 目前是否出現在該選擇器中,請先檢查你自己的選擇器和帳戶條款再做規劃。不要根據模型頁想當然地認為可用。