
MiMo-V2.6-Pro는 긴 에이전트 실행과 자동화, 그리고 뜻밖에도 글쓰기에서 진지하게 시험해볼 가치가 있다. 동시에 당신의 인내심을 가장 많이 소비하는 모델이기도 하다. 출시 당일, 오픈 가중치 최고 지능 점수에는 첫 마디 전 가장 긴 대기 시간 중 하나가 따라붙었다. 출시 몇 시간 안에 한 개발자는 경쟁 프런티어 모델이 고치지 못한 스크립트를 고쳤다고 보고했고, 다른 이는 터미널에서 삼십 분째 공회전했다고 보고했다. 두 보고는 모두 사실이다. 이 리뷰는 그것들을 분류한다.
이 기사는 당신이 열어 확인할 수 있는 증거만 계산한다: 공식 주장, 독립 측정 데이터, 날짜가 붙은 커뮤니티 보고. 각각 무엇을 증명하는지 표기한다. 출시 정보는 MiMo-V2.6-Pro 모델 페이지 (English), 돈 이야기는 가격 분석에 있다. 여기서 답하는 더 좁은 질문—쓸 가치가 있는가, 누구에게 맞는가, 대기라는 대가는 무엇인가.
글의 끝에서 이 결론들이 브라우저급 워크플로에 무엇을 의미하는지 본다. 일상이 채팅창을 지키는 것이 아니라 다중 페이지 조사·정보 추출·자동화라면 이 부분이 당신 이야기다.
핵심 요약
MiMo-V2.6-Pro는 Artificial Analysis 지능 지수 46점으로 동급 114개 모델 중 1위, 최고 점수의 오픈 가중치 모델이며, 비교 세트에서 지수 과제당 비용이 가장 저렴하다($0.13). (Artificial Analysis, 2026-09-22 확인)
뒷면은 대기: Xiaomi 공급자, 1만 입력 토큰 워크로드에서 첫 답변 토큰까지 18.17초, 대부분은 침묵의 사고. 생성 자체는 초당 약 125토큰. (AA 공급자 벤치마크)
사고 토큰은 출력으로 과금된다(100만 토큰 $0.87). 지수 과제에서 사고 토큰 약 37,500개가 답변 약 26,800개를 넘어섰다.
출시 당일 실제 보고는 양극단: GPT-6 Astra Light가 실패한 파이썬 스크립트를 고친 사례와, DeepSeek V4.1 Flash가 성공한 바로 그 작업에서 grep 무한 루프 30분을 보낸 사례. 방향마다 n=1.
가장 놀라운 점은 글쓰기—롤플레이·장문 사용자가 장면 흐름과 대화를 극찬했다. 가장 큰 리스크는 도구 루프의 폭주. 워크로드별 결론은 하단의 의사결정표.
MiMo-V2.6-Pro는 무엇인가
샤오미는 2026-09-22에 MiMo-V2.6-Pro와 MiMo-V2.6-Flash (English)를 대규모 강화학습으로 만든 "네이티브 옴니모달" 오픈 가중치 모델로 공개했다. Pro는 희소 MoE: 총 약 1.02T 파라미터, 토큰당 활성 42B, 100만 토큰 컨텍스트, 텍스트·이미지·오디오·비디오 입력과 텍스트 출력, MIT 라이선스. 가중치는 Hugging Face(XiaomiMiMo/MiMo-V2.6-Pro-RL)에 있고, API 이름은 mimo-v2.6-pro, 별도 가격의 고속 티어 mimo-v2.6-pro-ultraspeed가 있다. V2.5 계열 엔드포인트는 2026-10-21에 종료된다(이전 배경).
숫자를 보기 전에 주의할 점 하나: 파라미터 표기가 서로 어긋난다. 기술 보고서는 총 1.02T / 활성 42B, Hugging Face 요약에는 524B 행이 따로 있고, Artificial Analysis 구조화 데이터는 978B passive로 적는다. 공식 기술 보고서의 아키텍처 값으로 1.02T/42B를 쓰되, 하드웨어를 산정하기 전에 정확한 checkpoint를 확인할 것.
이 리뷰가 답하는 것은 "똑똑하느냐"가 아니다—리더보드가 이미 답했다. 이런 속도 프로필, 이런 과금 구조, 이런 도구 루프 특성의 모델이 당신의 워크플로에 들어맞는가. 비교 상대는 GPT-6 Astra, Claude Fable 5.1, 더 저렴한 Gemini 3.8 Flash다.
이 리뷰를 결정하는 단 하나의 숫자: 18초의 침묵
아래 숫자 쌍이 글 전체를 관통한다. MiMo-V2.6-Pro는 Artificial Analysis가 측정한 최고 오픈 가중치 지능 점수(46, 114개 중 1위)를 비교 세트 최저 과제 비용($0.13)으로 달성한다. 동시에 등재 공급자(Xiaomi, 1만 입력 토큰, 2026-09-22 확인)에서 첫 답변 토큰에 18.17초가 걸린다.
이 두 숫자는 누가 기다리느냐에 따라 완전히 다른 두 모델을 그린다. 서른 번의 도구 호출을 도는 백그라운드 에이전트에게 도입부 18초의 사고는 수 분짜리 무인 작업에 희석될 뿐이고, 이어지는 초당 125토큰은 같은 스냅숏에서 한두 모델을 빼고 가장 빠르다. 질문하고 커서를 지켜보는 사람에게 18초는 영겁이고, 500토큰 답변의 엔드투엔드 22.2초는 더 나쁘다.
같은 날 오전의 Artificial Analysis 스냅숏은 대기를 분해한다: 사고 15.41초 + 입력 처리 2.17초—대기의 87.7%가 입을 여는 앞의 추론이다. 같은 구조화 데이터가 청구서의 수수께끼도 설명한다: 지수 과제당 추론 약 37,520토큰 대 답변 26,756토큰. 보이는 답변 1토큰마다 안 보이는 사고에 약 1.4토큰 값을 치르는 셈이다.
Reddit 사용자들은 출시 몇 시간 만에 같은 벽에 부딪혔다:
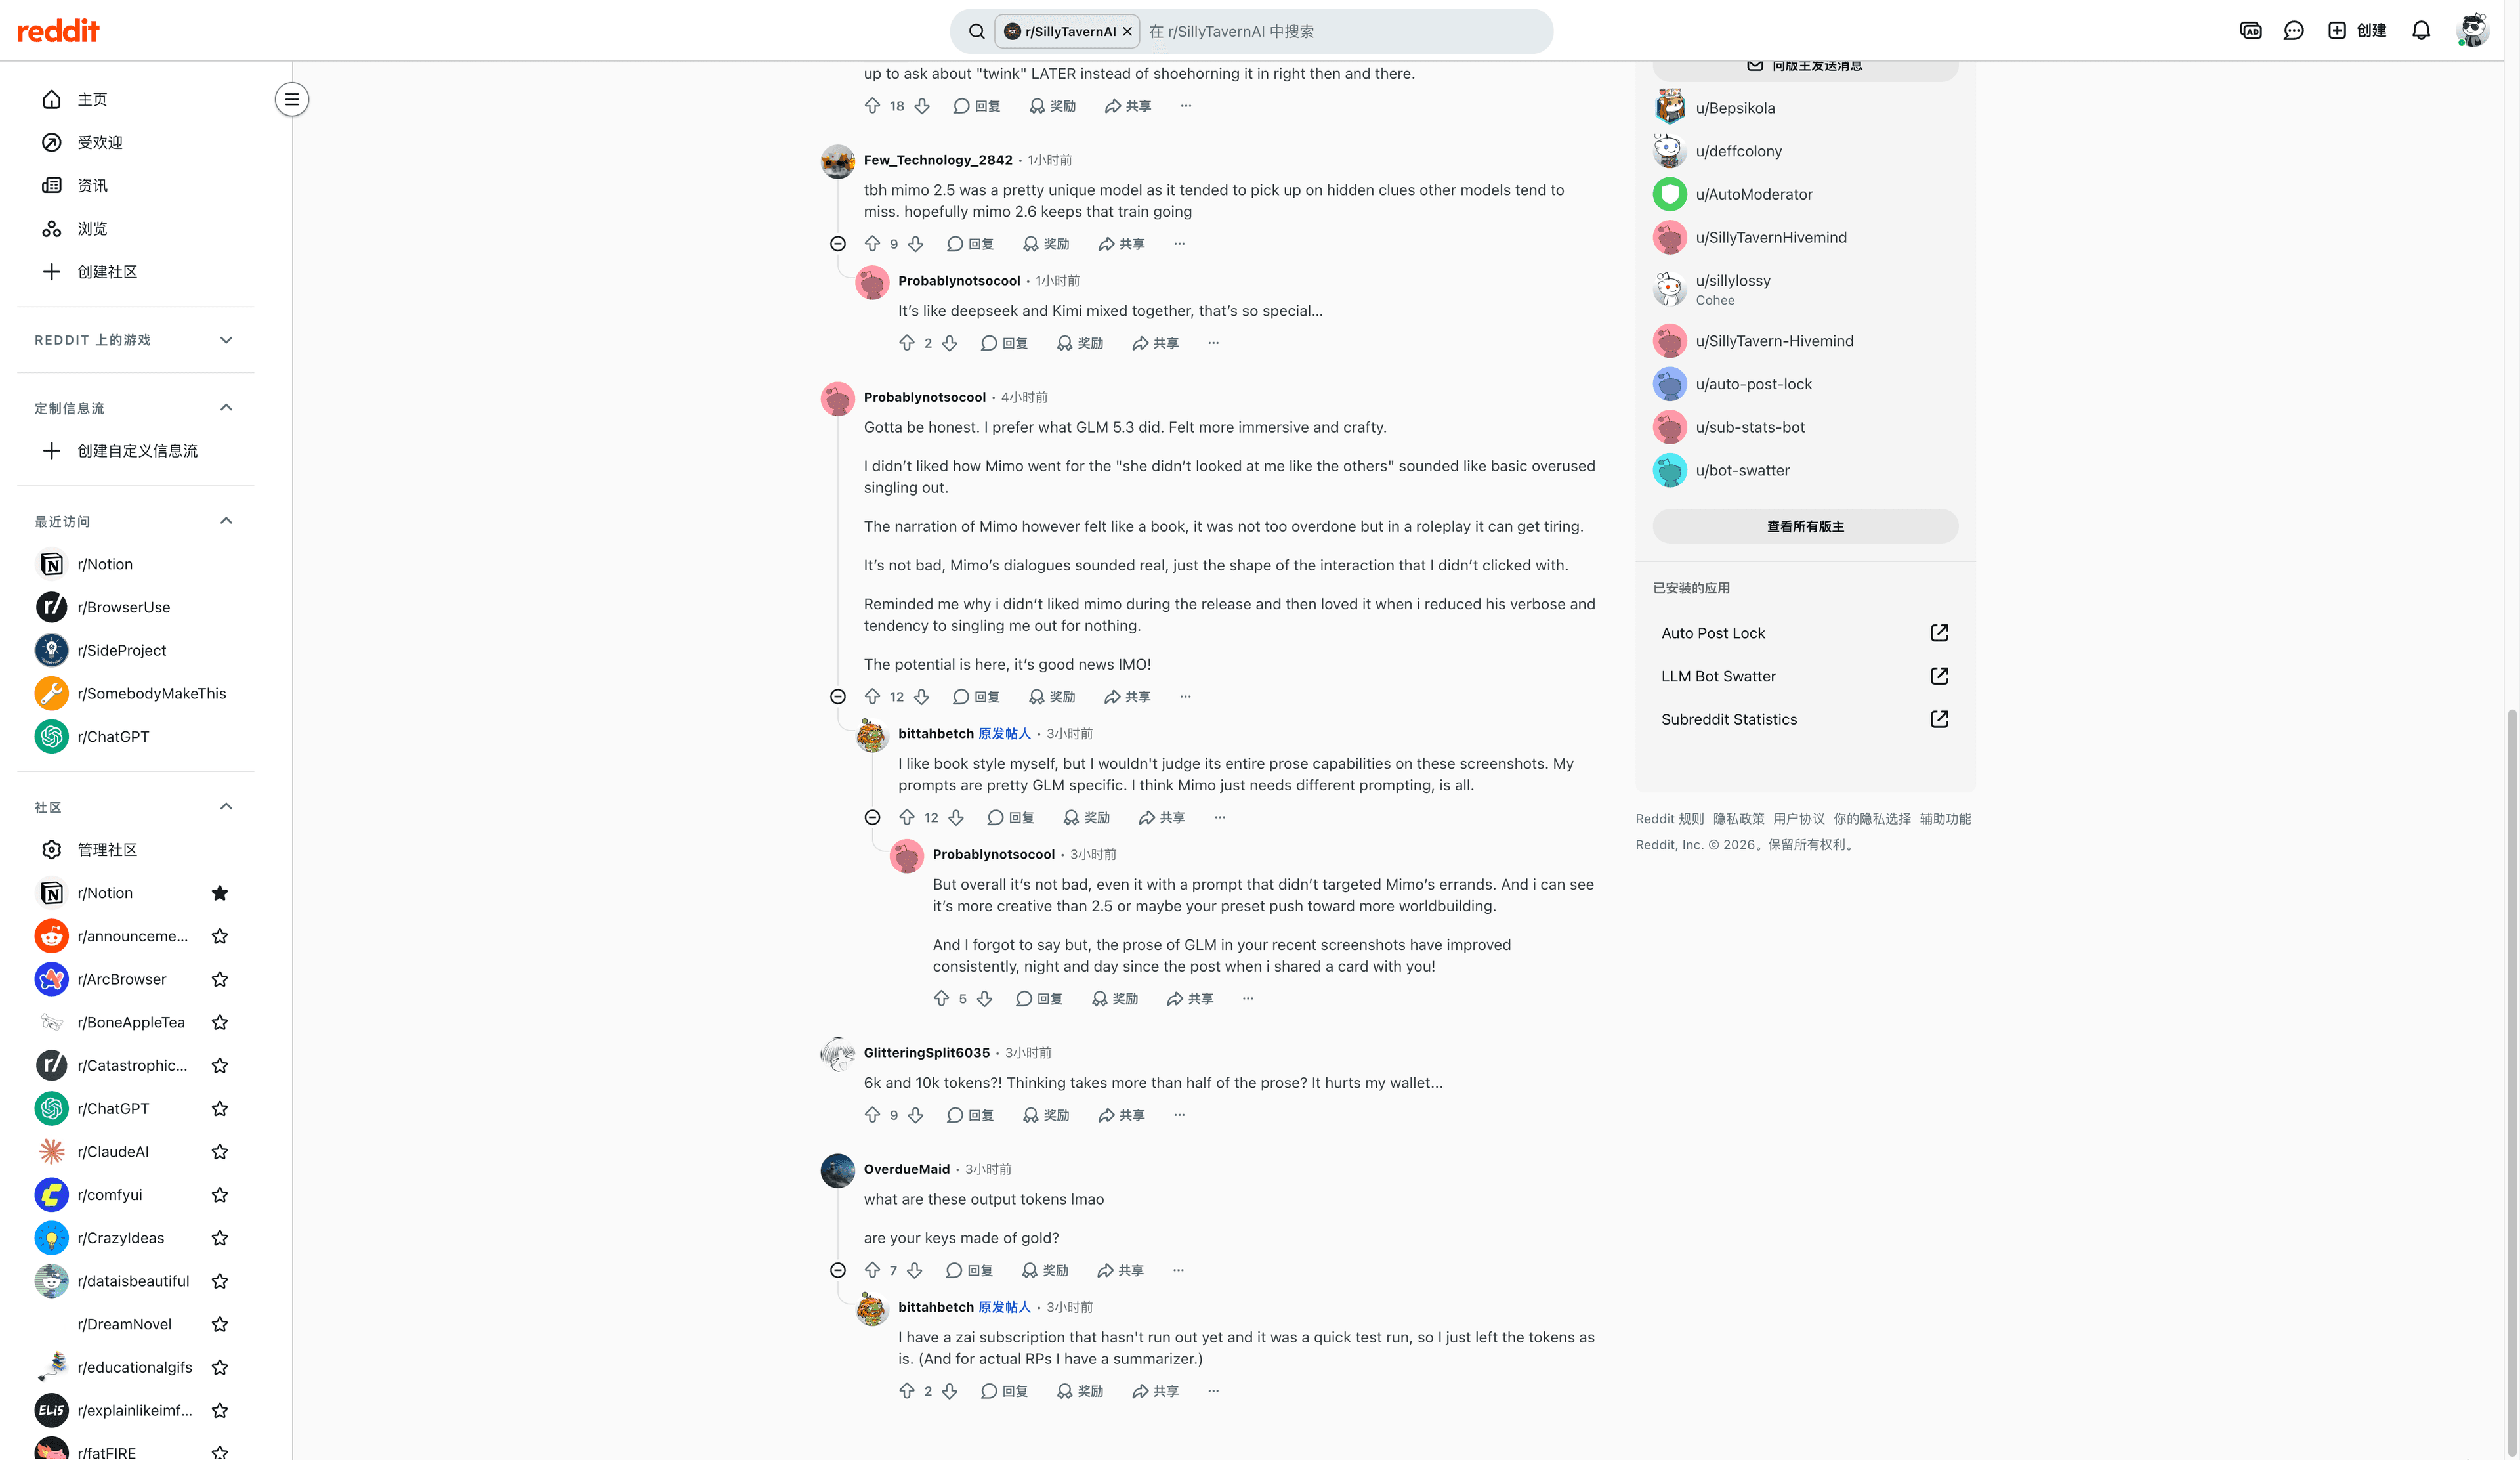
"6k and 10k tokens?! Thinking takes more than half of the prose? It hurts my wallet..." — u/GlitteringSplit6035 (r/SillyTavernAI, 2026-09-22. 번역: 6천, 1만 토큰?! 사고가 본문의 절반을 넘는다고? 지갑이 아파……)
"what are these output tokens lmao are your keys made of gold?" — u/OverdueMaid (같은 스레드. 번역: 이 출력 토큰들이 뭐야, 키가 금으로 만들었어?)
이 앵커로 워크로드를 분류하라: 작업 단위가 긴 런이면 두뇌를 사고 대기를 삼키고, 작업 단위가 사람의 한 턴이면 대기 자체가 제품이다.
리더보드 전에, 실제 작업의 성패
출시 당일 가장 유용한 증거는 벤치마크 행이 아니다. 구체적인 도구와 결과를 가진 두 편의 작은 이야기다.
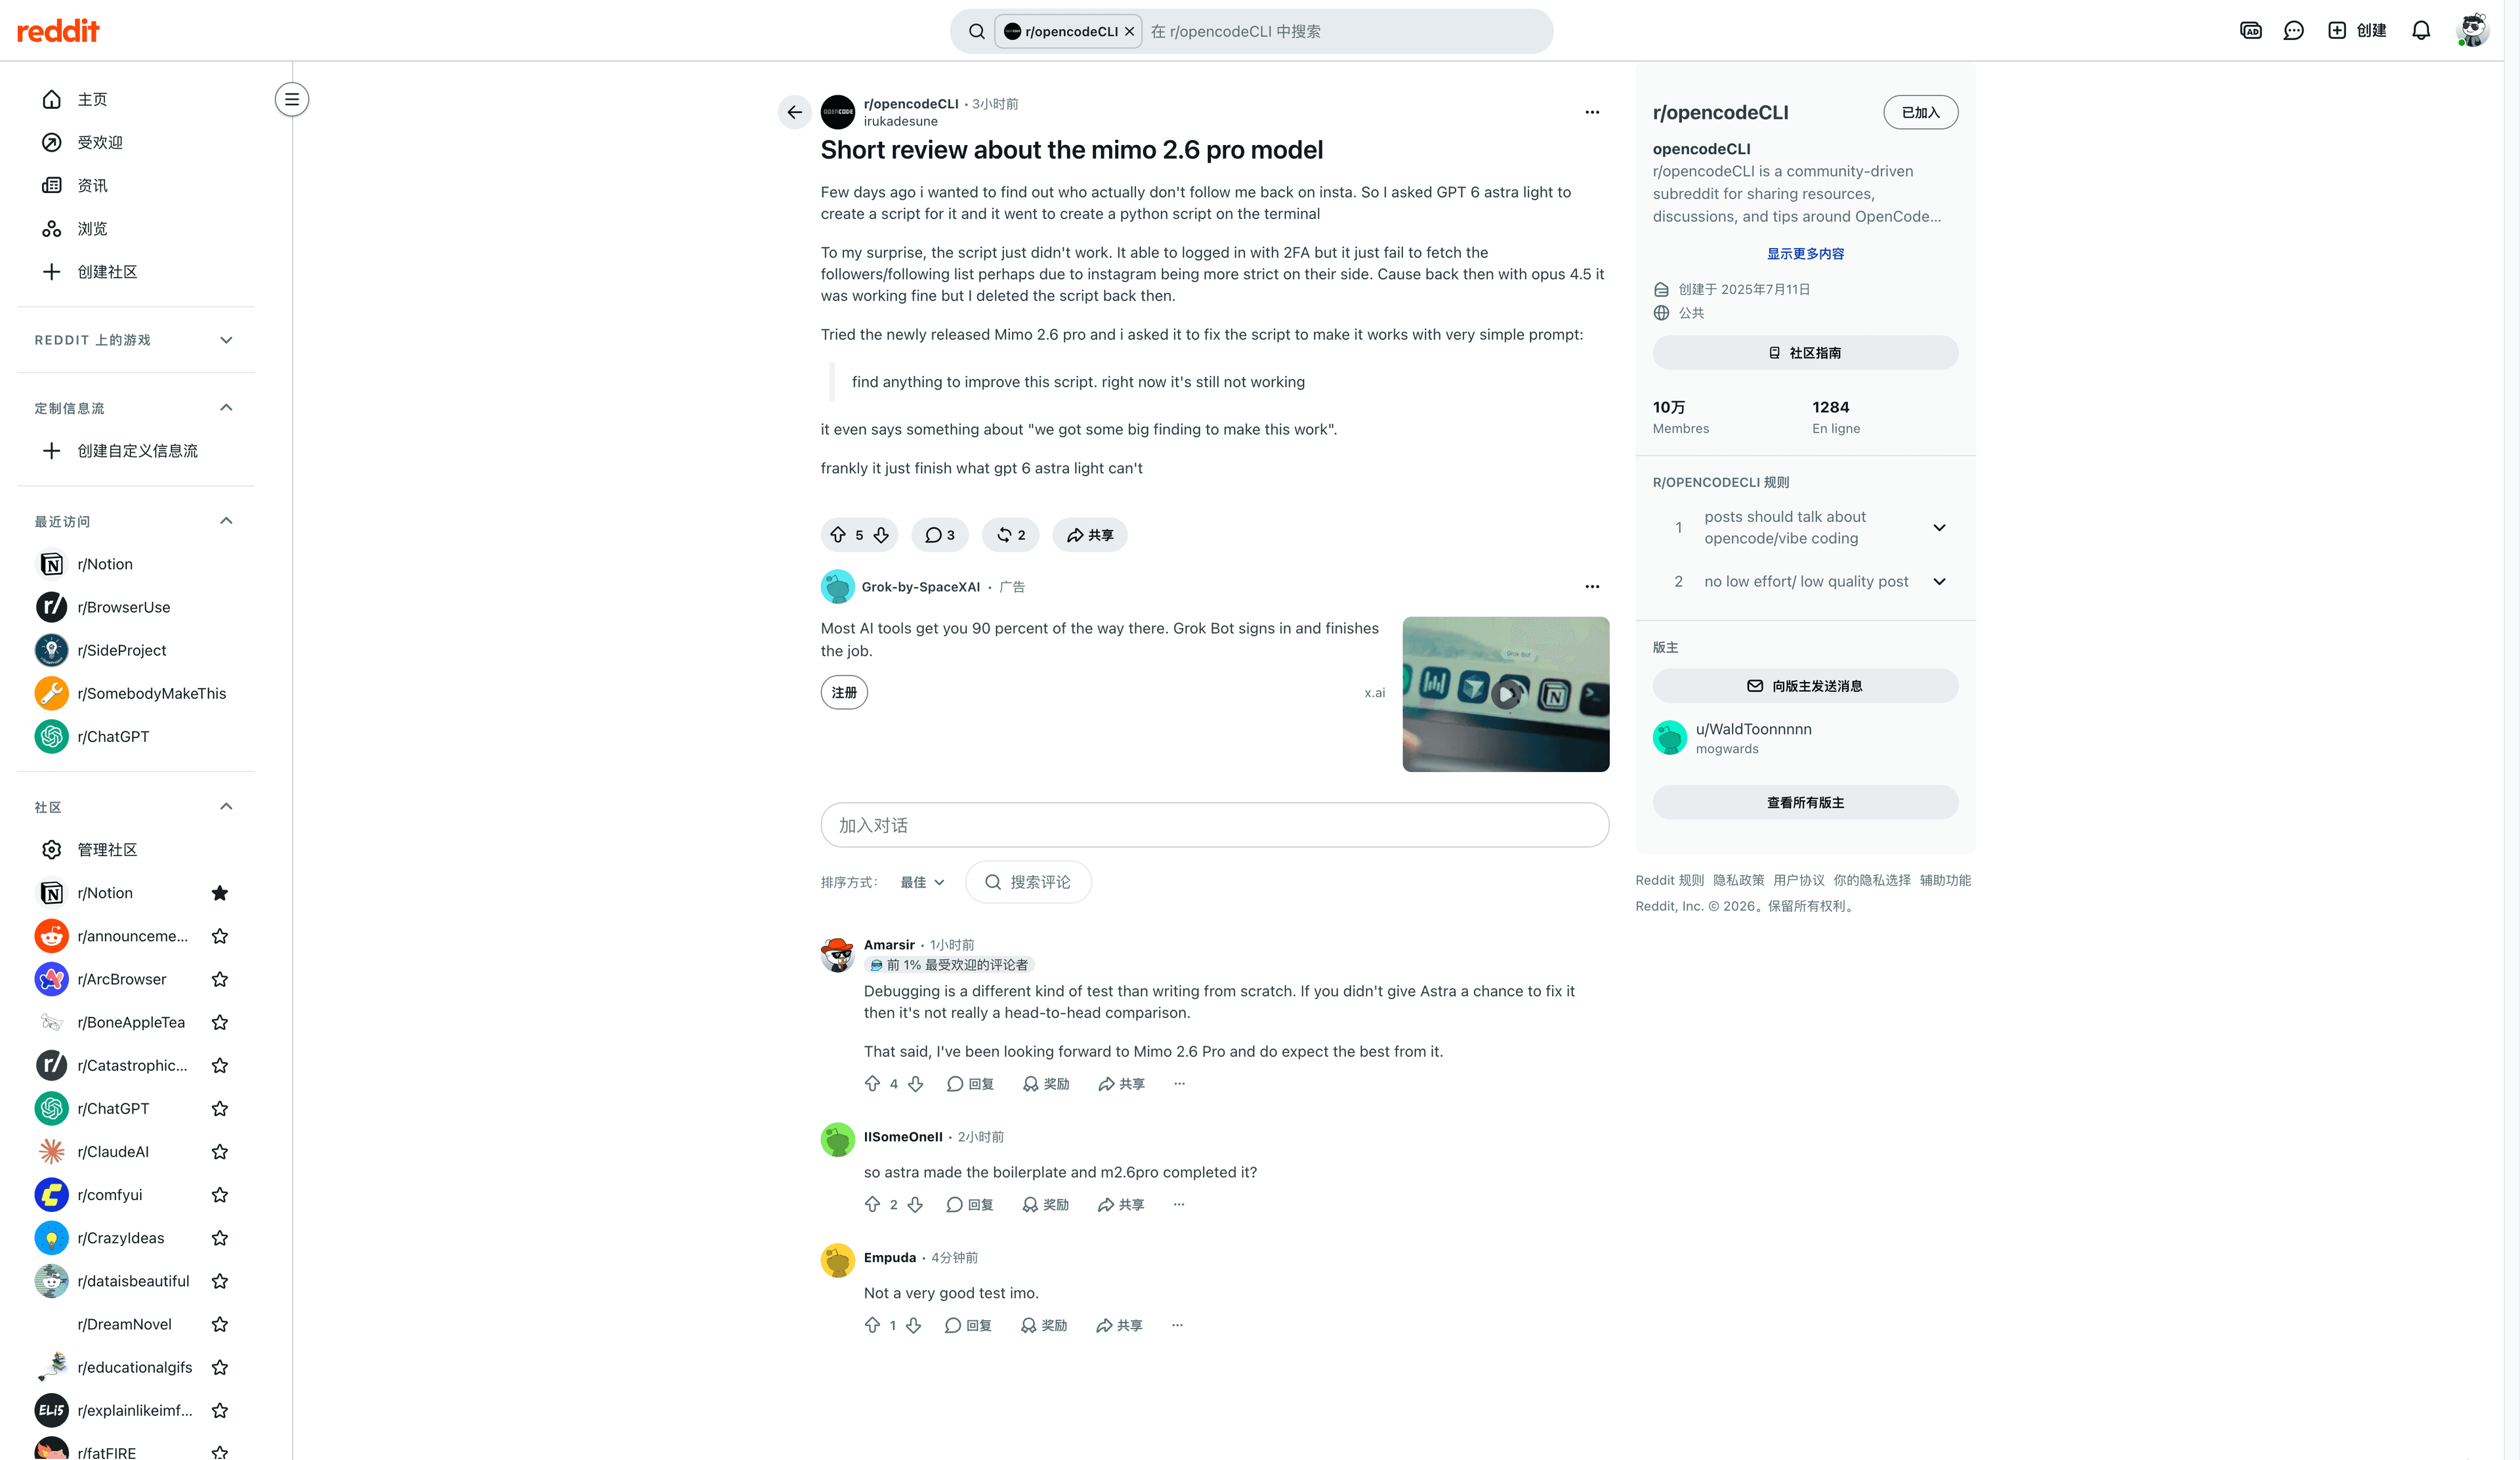
이긴 쪽. u/irukadesune는 인스타그램 맞팔 확인용 파이썬 스크립트를 갖고 있었다. GPT-6 Astra Light가 다시 썼지만 팔로워 목록을 가져오는 데 계속 실패했다. MiMo-V2.6-Pro에 준 지시는 한 줄: "find anything to improve this script. right now it's still not working." 고쳤다.
"frankly it just finish what gpt 6 astra light can't" — u/irukadesune (r/opencodeCLI, 2026-09-22. 번역: 솔직히 말해 GPT-6 Astra Light가 못 끝낸 일을 끝냈을 뿐)
찬물을 끼얹은 답글. 해당 스레드의 최상위 답글은 이 이야기가 무엇을 증명하고 증명하지 못하는지 짚는다:
"Debugging is a different kind of test than writing from scratch. If you didn't give Astra a chance to fix it then it's not really a head-to-head comparison." — u/Amarsir (같은 스레드. 번역: 디버깅과 처음부터 쓰기는 다른 종류의 시험이다. Astra에게 고칠 기회를 주지 않았다면 정면 비교가 아니다)
진 쪽. u/choiyoh는 같은 웹사이트 UI/UX 변경을 MiMo-V2.6-Flash와 MiMo-V2.6-Pro에, 터미널 코딩 하네스로 맡겼다. 둘 다 grep 루프에 빠져 진전이 없었다.
"for 30 minutes no code was fixed." … "DS 4.1 Flash is still much better.." — u/choiyoh (r/CommandCode, 2026-09-22. 번역: 30분 동안 코드는 한 줄도 고쳐지지 않았다……DS 4.1 Flash가 훨씬 낫다)
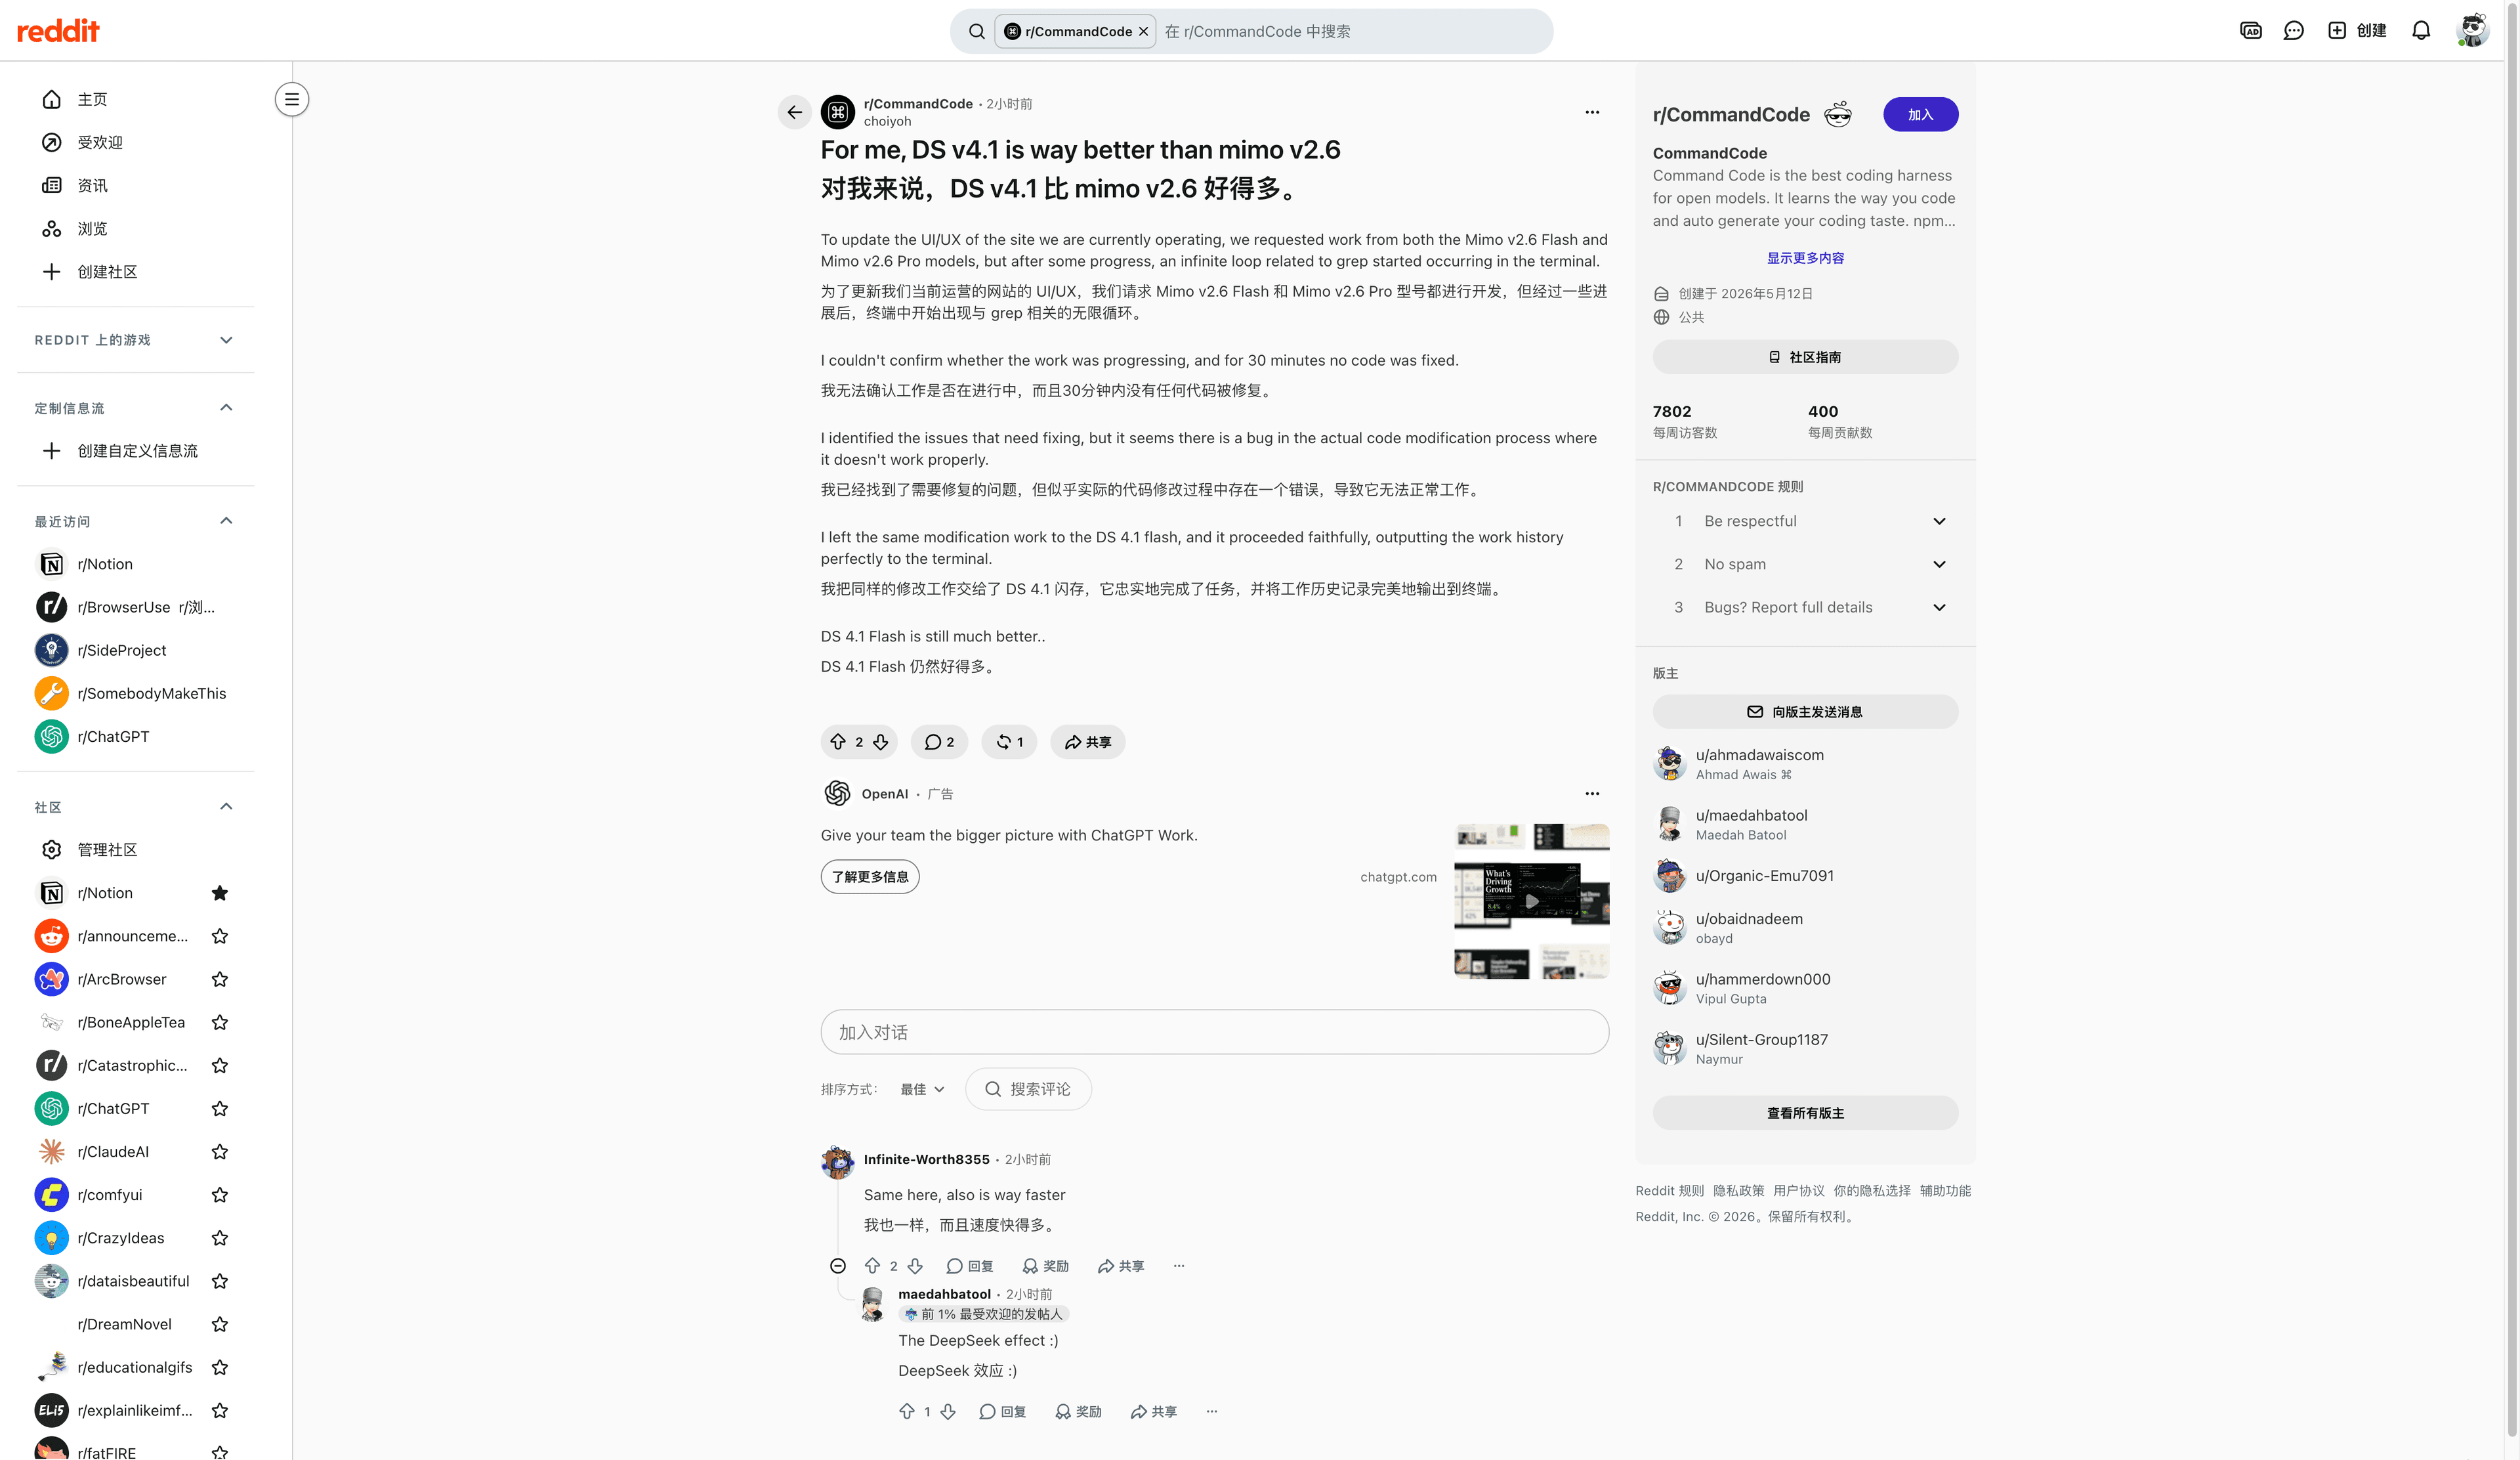
각각 한 번의 실행. 로그도, 저장소도, 토큰 집계도 없다. 두 결과—경쟁자를 이긴 디버그 수정과 삼십 분의 도구 공회전—가 실재함만 증명할 뿐, 빈도는 증명하지 못한다. 바로 이 틈을 벤치마크가 메워야 한다. 실제로 얼마나 메웠는지 보자.
벤치마크와, 그 신뢰도
샤오미 기술 보고서(Table 3, 벤더 보고값, 2026-09-22 확인)는 Pro를 자사 패밀리와 세 개의 클로즈드 프런티어와 비교한다. 값은 보고된 그대로, -는 미제공:
| 벤치마크 | MiMo-V2.6-Pro | MiMo-V2.6-Flash | MiMo-V2.5-Pro | Claude Opus 5 | GPT-5.6 Sol | Claude Fable 5 |
|---|---|---|---|---|---|---|
| DeepSWE v1.1 | 71.9 | 67.9 | 19.0 | 74.0 | 73.0 | 70.0 |
| AutomationBench v1.0.6 | 53.1 | 52.3 | 16.0 | 50.3 | 45.8 | 46.2 |
| Toolathlon-Verified | 76.9 | 73.6 | 49.1 | 80.6 | 74.9 | 77.9 |
| Agents' Last Exam | 31.6 | 27.6 | 13.2 | 31.6 | 30.8 | 25.7 |
| Terminal Bench 2.1 | 89.9 | 87.6 | 65.2 | 89.1 | 88.8 | 84.3 |
| Terminal Bench 4.0 | 34.9 | 28.8 | 1.5 | 49.0 | 39.9 | 42.4 |
| OSWorld-Verified | 82.0 | 80.8 | - | 83.4 | 83.0 | 86.0 |
| JobBench | 62.0 | 61.2 | 25.0 | 65.7 | 45.4 | 57.4 |
| MiMo Visual Coding(자체) | 72.3 | 71.5 | - | 70.0 | 73.4 | 69.1 |
이제 찬물을 세 국자.
측정 조건이 얄팍하다. 보고서는 집계 점수만 낼 뿐 문항별 로그, 프롬프트, 시드, 표본 수, 신뢰구간이 없다. 세 행(MiMo Code Bench, MiMo Cyber Bench, MiMo Visual Coding)은 샤오미 자체 벤치마크다. 널리 인용되는 "DeepSWE 58.4 → 72.6"은 같은 RL 실행 안의 학습 곡선 변화(약 30 스텝, 262만 달러 연산)이지 모델 대 모델 비교가 아니다. 공식 페이지의 "대부분의 Agent 벤치마크에서 Claude Opus 5와 GPT-5.6 Sol에 견준다"는 포지셔닝이고, "가격은 1/20~1/60"은 비교 세트와 토큰 계산 방식을 밝히지 않는다.
커뮤니티는 기본적으로 학습기 리더보드를 믿지 않는다:
"We'll see how it works on real code. DeepSeek-V4.1-Flash was technically a lot more capable than GLM-5.3-Flash but it's worse in the real-world … The benchmarks don't care if it's a code spaghetti." — u/lilian_moraru (r/LocalLLaMA, 2026-09-22. 번역: 실제 코드에서 봐야 안다……벤치마크는 스파게티 코드인지 신경 쓰지 않는다)
"i mostly care about roleplay so those benchmark wins dont mean much if it still forgets details after a few messages." — u/Pure-Summer2818 (같은 스레드. 번역: 몇 마디에 세부를 잊는다면 벤치 승리에 의미가 없다)
독립 출처가 합치하는 것은 형상이지 정밀도가 아니다. Artificial Analysis는 자체 하드웨어에서 지능 지수 46(v4.3.2, 10개 평가)을 측정했고, Arena의 Code Arena WebDev 행은 AutoEval 1628(+18/-18)에 Rank와 Votes가 모두 N/A—블라인드 투표 리더보드 위의 스크립트 결과이므로 "N위"라고 쓸 수 없다. 위 Amarsir의 방법론 지적은 모든 행에 적용된다: 디버깅은 창작이 아니고, 하나의 하네스는 당신의 하네스가 아니며, 방향성 신호는 자가 아니다.
물을 끼얹고도 남는 것: V2.5-Pro 대비 격차(DeepSWE 19.0 → 71.9)는 반올림 속기에는 너무 크고, 보고서의 하네스 전이 실험(네 개의 미니 하네스로 학습 후 못 본 Codex·Claude Code·mini-swe-agent에서 통과율 약 50% → 66%)는 실제 배포에 가까운 증거다. 단 어떤 행도 너의 성공률로 읽지 말 것.
MiMo-V2.6-Pro가 진짜 강한 곳
글쓰기가 가장 놀라운 점
코딩 모델이 문장력을 먼저 칭찬받는 일은 드물다. 출시 당일 가장 큰 환호는 장문 롤플레이 작가들에서 나왔다—반복 패턴을 가장 가혹하게 벌하는 사용자층이다.
"honestly I'm really enjoying it for RP so far. The responses have been surprisingly good, especially when it comes to keeping the flow of a scene going and actually giving me something interesting to work with instead of falling into the usual repetitive RP patterns." — u/Electrical_Mode_2489 (r/SillyTavernAI, 47점. 번역: RP가 정말 좋다. 장면의 흐름을 이어가고, 반복 패턴에 빠지지 않게 흥미로운 거리를 준다)
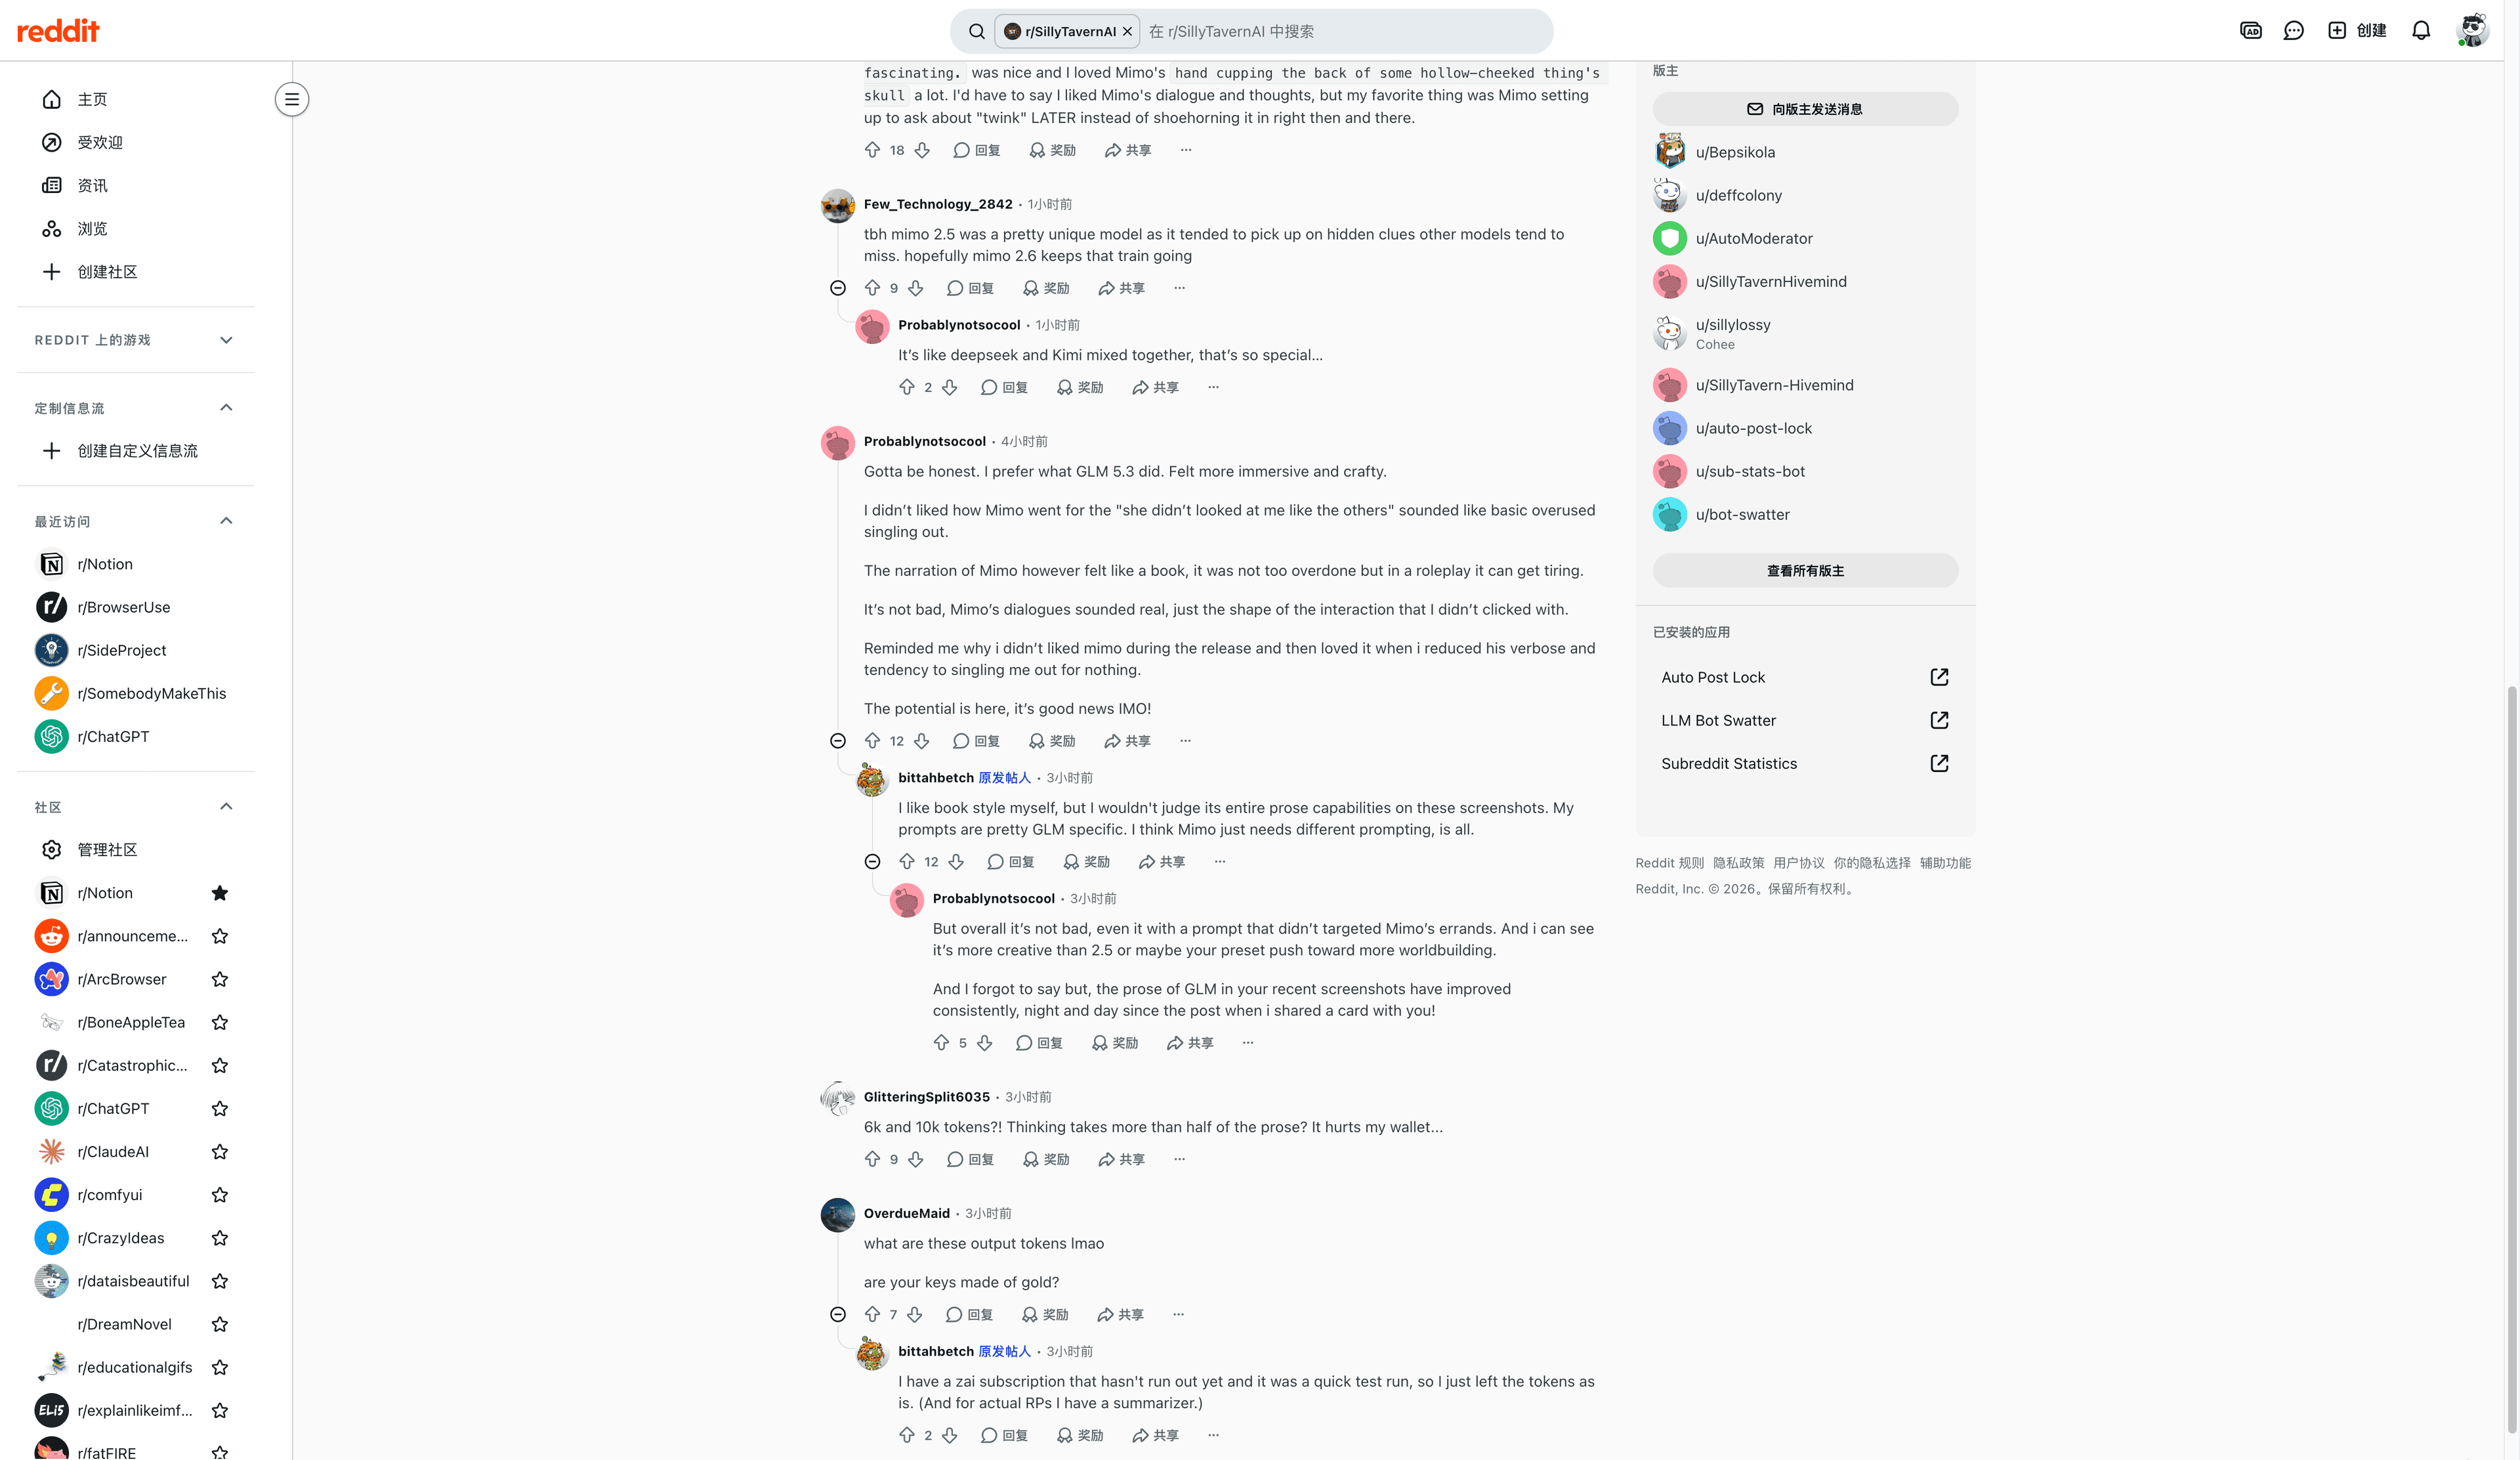
GLM 5.3과 정면 비교한 다른 작가는 대화와 절제를 높이 샀다: 모델이 "set[] up to ask about 'twink' LATER instead of shoehorning it in right then and there"(번역: 그 자리에 끼워 넣지 않고 나중에 물을 복선으로 깔았다). 글로 먹고 산다면—소설, 마케팅 카피, 긴 인터랙티브 스토리—이 개선이 어떤 코딩 점수보다 클 수 있다.
한계: 취향의 문제다. 같은 비교 스레드에서 u/Probablynotsocool는 GLM 5.3을 더 좋아했고("Felt more immersive and crafty") MiMo의 서술을 "like a book … in a roleplay it can get tiring"(번역: 책 읽는 같아 RP에서는 피곤해진다)고 했다. 둘 다 숙련자, 같은 출력, 정반대의 판정.
자동화와 도구 워크플로는 종이 위에서 프런티어를 이긴다
여기서는 벤치 형상이 정말 MiMo에게 유리하다. AutomationBench v1.0.6: 53.1로 Claude Opus 5(50.3), GPT-5.6 Sol(45.8)을 앞선다. Toolathlon-Verified: 76.9로 Opus 5에 3점 차, Sol보다 위. Terminal Bench 2.1: 89.9로 비교 세트 1위. JobBench 62.0은 GPT-5.6 Sol(45.4)의 1.4배.
그 행들 뒤의 공학적 디테일이 배포에 중요하다: RL 단계는 네 개의 미니멀 하네스로 학습한 뒤 못 본 세 하네스(Codex, Claude Code, mini-swe-agent)로 전이를 확인했다. 자기 하네스에서만 도는 모델은 데모이고, 전이되는 모델이 인프라다. 다단 도구 루프—브라우저 에이전트, CI 수정기, 사내 자동화—를 짜는 사람에게 이게 시험의 최대 근거다.
커모디티 가격의 프런티어급 지능, MIT 가중치 포함
2026-09-22 확인 스냅숏에서 MiMo-V2.6-Pro의 지능 지수는 46—Grok 4.7(46)과 동률, Claude Opus 5(51) 아래—이면서 비교 세트에서 지수 과제당 최저 비용($0.13)이다. 정가는 입력 $0.435 / 출력 $0.87(3.00 / 6.00위안), 캐시 히트는 $0.0036로 120배 할인이 멀티턴 경제를 바꾼다(가격 계산은 여기; 다른 오픈 신형과 예산을 견주려면 Kimi K3 가격 분해).
같은 날 경쟁 모델과의 커뮤니티 비교가 구체화한다: Grok 4.7 대비 컨텍스트 100만 대 50만 토큰, 초당 약 125 대 42토큰, MIT 대 클로즈드, $0.435/$0.87 대 $2/$6—지수는 둘 다 46. 제약이 "달러당 능력"이라면—배치 에이전트, 리서치 파이프라인, 에이전틱 추론 워크로드—이것이 이번 릴리스의 가치 제안이다.
물리는 곳
사고세: 침묵에 두 번 낸다
한 번은 대기로, 한 번은 청구서로. 첫 답변 토큰까지 18.17초. 지수 과제당 추론 약 37,520토큰 대 답변 26,756토큰, 전부 출력 요율 100만 토큰 $0.87로 과금. 추론이 무거운 프롬프트에서 사고가 총 생성량의 절반을 넘는다는 보고가 잇따른다—위 "6k and 10k tokens?!" 반응의 실체다.
공식 탈출구는 mimo-v2.6-pro-ultraspeed: 생성 최대 20배 속도에 가격은 정확히 10배(입력 $4.35 / 출력 $8.70). 예산 있는 대화형 제품에는 현실적 선택지지만 모델을 프런티어 가격대로 되돌려 최대 매력을 지운다. "덜 생각하는" 스위치는 현재 공식 API 자료에 없다(가격 분석에서 계산 완료).
도구 루프는 폭주한다
위의 grep 루프는 에이전트 작업에서 가장 아픈 실패 형태다: 답이 틀린 게 아니라 답이 없고, 계량기는 계속돈다. 기술 보고서는 자사 학습 인프라의 OOM, 평가기 도달 불가, 부분 롤아웃 실패를 인정하되 벤치별 통일된 실패율은 내지 않는다. 같은 스레드의 다른 사용자도 같은 경험을 방증한다("Same here, also is way faster", 경쟁 모델에 대해). 무인 실행에 쓸 거면 감독, 도구 호출 타임아웃, 대체 모델을 예산화하라—어떤 에이전틱 브라우저 스택에든 같은 규율이다.
컴플라이언스, 엔드포인트, 배포의 무게
점수에 안 나오는 실무 함정 셋:
데이터 처리. 출시 당일부터 현재 유일한 라이브 엔드포인트가 1자(첫째 당사자)이며 커뮤니티의 독해로는 제로 데이터 보존(ZDR) 비준수라는 지적이 있다: "very interesting, but 2.6 Pro's only endpoint is non-ZDR compliant"(u/total_ty), 뒤이어 "How trustworthy is a random tag on a website, honestly? How do we verify none of our data has been retained by the endpoint?"(u/starliteburnsbrite). 오픈 가중치는 서드파티 호스팅이 온다는 뜻이다("the weights are already up on huggingface")—하지만 오늘의 준수 경로는 자체 호스팅이거나 약관을 읽은 공급자다.
자체 호스팅은 무겁다. 1.02T 희소 MoE, 공식 vLLM 예제는
--tensor-parallel-size 8전제. 노트북 모델이 아니다. 멀티 GPU 노드로 예산을 잡고 파라미터 표기의 세목을 먼저 읽어라.버전과 가격의 표류. V2.5 엔드포인트는 2026-10-21 종료. Artificial Analysis 숫자는 같은 날 안에 측정 갱신으로 움직였다(17.58 → 18.17초). 버전을 고정하고 예산 전에 요율을 재확인하라.
사람들은 실제로 뭐라고 했나
출시 당일 논쟁은 하나가 아니라 두 축으로 갈렸다.
축 하나: 환호파 대 화상파. 디버그 승리와 grep 침몰은 Reddit에서 네 시간 간격이었고 두 진영은 즉시 만원이 됐다. u/irukadesune의 한 줄 프롬프트가 경쟁 프런티어가 못 고친 것을 고쳤고, u/choiyoh는 터미널 루프에서 삼십 분을 잃고 DeepSeek V4.1 Flash로 옮겼다. 열광파는 같은 증거에서 외삽한다—"I believe in mimo, mimo will replace GLM as THE rp model"(u/stopaskingforloginn)—회의파는 로그를 요구한다.
축 둘: 가격 환호파 대 사고 청구파. 출시 스레드의 첫 충격은 경제—"They kept the prices!? It's over."(u/Pink_da_Web. 번역: 가격 그대로!? 끝났다)—그리고 토큰 수가 도착했다:
이 모델의 가장 행복한 사용자층인 작가들끼리도 합의가 안 된다:
이 리뷰가 서는 자리: u/Amarsir와 같은 곳이다—모델에는 열광, 조잡한 비교에는 참을성 없음. 검증된 아홉 개의 목소리가 보여주는 패턴은 숫자와 일치한다: 능력은 진짜, 대기와 청구서의 마찰은 진짜, 도구 루프의 신뢰성은 어느 방향이든 아직 n=1.
판정: 점수가 아니라 워크로드로 고른다
| 워크로드 형태 | 판정 | 이유 | 주요 단서 |
|---|---|---|---|
| 장기 에이전트 코딩, 배치 수정, 무인 도구 루프 | 시험해볼 것 | AutomationBench 53.1이 Opus 5와 Sol을 상회. 하네스 전이 증거. 1M 컨텍스트. $0.13/과제가 대기를 희석 | grep형 루프 실패는 실재. 감독하고 대체 모델 확보 |
| 대화 채팅, 롤플레이, 장문 창작 | 조건부 가능 | 글쓰기 칭찬이 구체적이고 반복적으로 나타난다. 1M 컨텍스트가 긴 장면의 일관성 유지 | 18초 초응답 + 사고 토큰이 장면당 지연과 비용을 동시에 상승. GLM 5.3 문체를 선호하는 작가도 존재 |
| 컴퓨터 조작·브라우저 자동화 | 강력 후보 | OSWorld-Verified 82.0, JobBench 62.0, 시각 코딩 72.3(자체). 옴니모달 입력 | 증거가 벤더 수치 중심. 먼저 자기 과제 세트에서 검증 |
| 규제 데이터 / 보존 제로 요건 | 아직 불가 | MIT 가중치로 자체 호스팅이나 준수 공급자는 원리상 가능 | 오늘 라이브는 1자 엔드포인트뿐이고 ZDR 상태 미검증 |
| 단일 GPU·노트북 로컬 추론 | 불가 | 1.02T 희소 MoE. 공식 서빙은 8-way 텐서 병렬 전제 | 현실적 로컬 선택지는 Flash 계열이나 소형 증류판 |
시의성 메모 둘. 첫째, Grok 4.7이 같은 날 출시되어 Artificial Analysis 지수도 46점이고 커뮤니티 비교의 결론은 "neither one decisively dominates the other"(번역: 어느 쪽도 결정적으로 압도 못한다)—해야 할 비교는 당신의 워크로드로 두 후보를 나란히 세우는 것이다. 둘째, V2.5 엔드포인트는 2026-10-21 종료. 그 위에 지었다면 이전 계획은 선택이 아니다.
실용적 경로: 일이 일어나는 곳에서 돌려라
이 리뷰의 모든 결론은 같은 프로필을 가리킨다: 대기는 사람을 아프게 하고 에이전트는 아프게 하지 않는다. 사고 토큰은 잡담성 단발 턴을 벌하고 지속적 장기 런에 보상한다. 도구 루프 리스크는 감독을 요구한다. 이 프로필은 문서 옆의 작은 채팅창과는 안 맞고, 브라우저급 워크플로—페이지를 읽고 100만 토큰 컨텍스트를 안고, 당신이 다른 일을 하는 동안 일한다—와는 맞는다.
그것이 Tabbit Browser가 전제하는 일하는 방식이다: 다중 페이지 조사·추출·자동화를 프롬프트 한 번이 아니라 agentic browser의 과제로 다룬다. 정직한 경계: 이번 리뷰 라운드에서는 MiMo-V2.6-Pro가 Tabbit의 실시간 모델 선택기에 현재 있는지 확인하지 못했고, Tabbit 핸즈온 실행도 주장하지 않는다. 어떤 클라이언트에서 어떤 모델의 가용성에 대해서든 그렇듯, 계획 전에 계정의 모델 선택기를 확인하라.
위 프로필이 당신의 일과 맞다면—장기 런, 무거운 컨텍스트, 도구 호출, 비용 규율—올바른 질문은 "어느 모델이 점수가 제일 높은가"가 아니라 "어느 모델이 내 일을 끝내는가"다. 고정 과제 세트로 두 후보를 한 바퀴 돌리고 달러당 완료한 일을 세라. 그 시험이 이 글의 어떤 리더보드 행보다 낫다.
 Tabbit Browser

자주 묻는 질문
MiMo-V2.6-Pro는 써볼 가치가 있나요?
완성 품질이 중요한 장기 에이전트 코딩, 자동화, 창작 워크로드라면 충분히 시험할 가치가 있습니다. 즉각 응답이 필요하거나 검증된 제로 데이터 보존 엔드포인트, 단일 GPU 로컬 배포가 조건이라면 신중해야 하며, 결정 전에 최소 한 개의 경쟁 모델과 비교하세요.
MiMo-V2.6-Pro는 응답까지 얼마나 걸리나요?
Artificial Analysis가 Xiaomi 공급자, 1만 입력 토큰 워크로드에서 첫 답변 토큰까지 18.17초를 측정했습니다(2026년 9월 22일 확인). 대기 후 생성 속도는 초당 약 125토큰이라, 지연의 대부분은 입을 여는 앞의 침묵 사고 시간입니다.
사고 토큰도 과금되나요?
됩니다. 샤오미는 내부 추론 토큰을 표준 출력 토큰으로 100만 토큰당 $0.87에 과금합니다. Artificial Analysis 기록에서 지수 과제당 사고 약 37,500토큰 대 답변 약 26,800토큰으로, 보이지 않는 사고에 돈을 내는 구조입니다.
Grok 4.7, Claude Opus 5와 비교하면?
2026년 9월 22일 확인한 Artificial Analysis 지능 지수에서 MiMo-V2.6-Pro와 Grok 4.7은 둘 다 46점, Claude Opus 5는 51점입니다. 샤오미 자체 보고서의 DeepSWE v1.1은 71.9로 Grok 4.7 약 73, Opus 5의 74와 견주며, 입력 가격은 100만 토큰당 $0.435 대 $2와 $15입니다.
정말 오픈소스인가요, 직접 돌릴 수 있나요?
가중치는 MIT 라이선스로 Hugging Face에서 내려받을 수 있어 대부분의 프런티어 모델보다 개방적입니다. 다만 자체 호스팅은 무겁습니다: 총 1.02T·활성 42B 파라미터의 희소 MoE이고, 공식 vLLM·SGLang 예제는 멀티 GPU 전제입니다. 파라미터 요약치가 출처마다 달라 하드웨어 산정 전에 정확한 checkpoint를 확인하세요.
Tabbit Browser에서 MiMo-V2.6-Pro를 쓸 수 있나요?
Tabbit는 계정의 실시간 모델 선택기에서 브라우저급 AI 워크플로를 실행합니다. 이번 리뷰에서는 그 선택기에 MiMo-V2.6-Pro가 현재 있는지 확인하지 못했으니, 계획을 세우기 전에 본인의 선택기와 계정 약관을 확인하세요.