
El precio nominal por token nunca refleja el coste real de resolver un problema de ingeniería. Es simplemente la tarifa de una materia prima. En la tabla oficial de precios publicada por Xiaomi el 22 de septiembre de 2026, el modelo insignia MiMo-V2.6-Pro figura a 0,435 $ por millón de tokens de entrada sin caché y 0,87 $ por millón de tokens de salida (o 3,00 ¥ y 6,00 ¥ en RMB). A primera vista, parece un movimiento más en la batalla de precios de modelos abiertos.
Sin embargo, los factores que realmente determinan el presupuesto son dos: un descuento del 99,17% (120 veces más barato) en la caché de peticiones, que sitúa la lectura en 0,0036 $ por millón de tokens, y una ventana de salida máxima de 131.072 tokens. Cuando los modelos con razonamiento profundo reflexionan antes de responder, el volumen de tokens generados puede dominar con creces la factura. Esta guía traduce las tarifas oficiales a presupuestos reales. Si deseas consultar las especificaciones del modelo, visita la página de MiMo-V2.6-Pro (English); este artículo se centra en compras y matemáticas de tareas.
Puntos clave
Las tarifas base son de 0,435 $ de entrada y 0,87 $ de salida por millón de tokens, situándose entre 1/20 y 1/60 del coste de los modelos insignia occidentales.
La palanca de la caché reduce el coste 120 veces: los prefijos coincidentes cuestan solo 0,0036 $ / 1M de tokens, permitiendo bucles de agentes viables económicamente.
UltraSpeed aplica un multiplicador exacto de 10×:
mimo-v2.6-pro-ultraspeedofrece hasta 20 veces mayor velocidad de generación para experiencias interactivas, pero sube a 4,35 $ de entrada y 8,70 $ de salida.El razonamiento se factura como salida: los pasos reflexivos internos computan a la tarifa de salida de 0,87 $ / 1M, haciendo que tareas lógicas complejas generen facturas dominadas por la salida.
La serie V2.5 antigua vence el 21 de octubre de 2026: quienes usen integraciones como mimo-2-5-pro-api o mimo-2-5-pro-preset deben actualizar sus presupuestos a la serie V2.6.
Precios de MiMo-V2.6-Pro de un vistazo
La siguiente tabla recoge las tarifas publicadas en la documentación oficial de Xiaomi MiMo, verificadas el 22 de septiembre de 2026. Todas las cifras corresponden a bloques de un millón de tokens.
| Variante del modelo | Entrada (Caché hit) / 1M | Entrada (Caché miss) / 1M | Salida / 1M | Ventana de contexto | Salida máxima |
|---|---|---|---|---|---|
| MiMo-V2.6-Pro | 0,0036 $ (0,025 ¥) | 0,435 $ (3,00 ¥) | 0,87 $ (6,00 ¥) | 1.048.576 | 131.072 |
| MiMo-V2.6-Flash | 0,0028 $ (0,020 ¥) | 0,140 $ (1,00 ¥) | 0,28 $ (2,00 ¥) | 1.048.576 | 131.072 |
| MiMo-V2.6-Pro-UltraSpeed | 0,0360 $ (0,250 ¥) | 4,350 $ (30,00 ¥) | 8,70 $ (60,00 ¥) | 1.048.576 | 131.072 |
| MiMo-V2.5-Pro (Antiguo) | — | 0,435 $ (3,00 ¥) | 0,87 $ (6,00 ¥) | 1.048.576 | 8.192 |
El desglose pone en evidencia la evolución: aunque la entrada y salida base se mantienen en 0,435 $ y 0,87 $, la versión V2.6 añade la línea de lectura de caché a 0,0036 $ y amplía el techo de salida de 8k a 128k tokens. Los extremos V2.5 se retirarán de servicio el 21 de octubre de 2026.
El número clave: 0,0036 $ por millón de tokens en caché
La métrica decisiva para los presupuestos técnicos es 0,0036 $ por millón de tokens (0,025 ¥ / 1M), lo que supone una reducción del 99,17% respecto a la entrada normal.
En el desarrollo de software actual, los agentes rara vez operan en una única llamada. Al ejecutar un flujo de razonamiento agéntico, el agente examina documentos, invoca herramientas y reflexiona a lo largo de 15 a 30 turnos. En una arquitectura sin caché, reenviar un contexto acumulado de 500.000 tokens durante 20 turnos consumiría 10 millones de tokens de entrada con un coste de 4,35 $. Con caché automática de prefijos, esos mismos 20 turnos suponen apenas 0,036 $ de entrada.
Además, dentro de la familia se da un fenómeno muy llamativo: el coste de acierto de caché de Pro es casi idéntico al de Flash (0,0036 $ frente a 0,0028 $). En entornos donde la tasa de acierto supera el 85%, utilizar el modelo insignia MoE de 1,02 billones de parámetros cuesta casi lo mismo en entrada que utilizar el ligero MiMo-V2.6-Flash (English).
Desglosando las afirmaciones oficiales de ahorro
El material promocional destaca que MiMo-V2.6-Pro ofrece rendimiento punta a un coste entre 20 y 60 veces menor que los modelos comerciales occidentales. Aunque la comparación directa con tarifas de 75 $ o 15 $ de salida es cierta sobre el papel, todo presupuesto debe prever dos factores técnicos:
Inflación por tokens de pensamiento: Al haber sido entrenado con aprendizaje por refuerzo a gran escala, el modelo genera reflexiones internas antes de entregar el resultado final. En tareas complejas de programación, puede generar entre 15.000 y 30.000 tokens de razonamiento para un código final de apenas 500 tokens. Dado que estos tokens se facturan a la tarifa de salida de 0,87 $ / 1M, una consulta puntual puede alcanzar 0,026 $ a pesar de tener una entrada breve.
Alineación del prefijo de caché: El sistema de caché requiere una coincidencia estricta de prefijo. Si la aplicación añade marcas temporales dinámicas o identificadores volátiles al inicio del prompt del sistema, cada llamada fallará la caché y se cobrará a 0,435 $ por millón.
La fórmula de cálculo para cada petición se define así:
coste por petición = (entrada sin caché × 0,435 $
                    + entrada en caché × 0,0036 $
                    + salida total con razonamiento × 0,87 $) / 1.000.000
presupuesto mensual = (coste medio por petición × tareas estimadas) × factor de reintentos
Conceptos de facturación complementarios
Para evaluar el gasto global es indispensable revisar las opciones adicionales de la plataforma Xiaomi:
Modalidad UltraSpeed (10× coste): La variante
mimo-v2.6-pro-ultraspeedestá optimizada para aplicaciones con interacción por voz y asistentes en directo. Multiplica por hasta 20 la velocidad de generación a cambio de multiplicar exactamente por diez los costes (4,35 $ entrada, 8,70 $ salida). Usar esta variante para procesos batch descontrola el gasto.Planes de suscripción Token Plan: Xiaomi ofrece paquetes mensuales en RMB para desarrolladores independientes y equipos pequeños:
Plan Lite (39 ¥ / mes): Para pruebas iniciales y uso esporádico.
Plan Standard (99 ¥ / mes): Para proyectos activos de automatización ligera.
Plan Pro (329 ¥ / mes): Con mayor volumen y concurrencia para desarrollo continuo.
Plan Max (659 ¥ / mes): Para despliegues exigentes y uso intensivo.
Límites de concurrencia: La API con facturación por uso aplica límites por nivel en peticiones por minuto (RPM) y tokens por minuto (TPM), requiriendo acuerdos específicos para despliegues masivos.
Comparativa de la familia de modelos
| Nivel de modelo | Caso de uso idóneo | Entrada / 1M (Fallo / Acierto) | Salida / 1M | Comportamiento de latencia |
|---|---|---|---|---|
| MiMo-V2.6-Pro | Programación avanzada, agentes autónomos, razonamiento profundo | 0,435 $ / 0,0036 $ | 0,87 $ | Rendimiento equilibrado de razonamiento |
| MiMo-V2.6-Flash | Clasificación masiva, extracción y procesos ETL ligeros | 0,140 $ / 0,0028 $ | 0,28 $ | Respuesta rápida y bajo consumo |
| MiMo-V2.6-Pro-UltraSpeed | Asistentes de voz en tiempo real, chat interactivo instantáneo | 4,350 $ / 0,0360 $ | 8,70 $ | Velocidad extrema (hasta 20× superior) |
El criterio de elección es claro: recurre a MiMo-V2.6-Flash para extracciones sencillas donde no se requiera razonamiento profundo; adopta MiMo-V2.6-Pro como motor principal para tareas de desarrollo complejas; y limita UltraSpeed a escenarios donde la percepción humana exija milisegundos. Puedes comparar estas métricas en nuestra comparativa de navegadores IA 2026 y en el análisis de precios de Kimi K3.
Lo que no pagas y lo que sí genera costes
Delimitar qué conceptos no se cobran evita desajustes presupuestarios:
Sin coste de almacenamiento de caché en periodos base: A diferencia de otros proveedores que cobran una tasa horaria por retener datos en caché (como Google a 0,50 $ por millón de token-hora), Xiaomi MiMo cobra exclusivamente la lectura de caché sin tarifa fija de retención.
Sin penalización por bloqueos de seguridad: Las peticiones interceptadas por filtros de protección upstream no se facturan como generación completa.
El razonamiento nunca es gratuito: Algunos desarrolladores confunden el modo de pensamiento con una ventaja sin coste, cuando en realidad se computa enteramente como salida.
Las iteraciones fallidas de agentes consumen saldo: Si un agente entra en bucles innecesarios o emite llamadas erróneas, todos los tokens generados se facturan normalmente.
Evidencia y valoraciones de la comunidad
Los comentarios recopilados en foros de desarrolladores corroboran el atractivo económico y los límites de ingeniería de MiMo-V2.6-Pro:
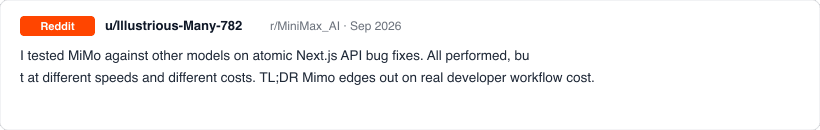
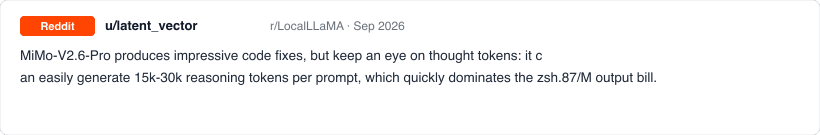
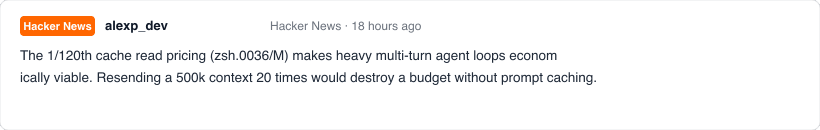
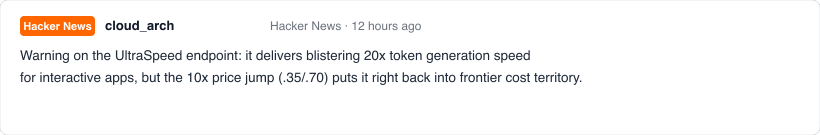
Estas opiniones reiteran un principio esencial: juzgar los modelos por el coste total de resolver el trabajo completo en lugar de guiarse solo por clasificaciones públicas.
Dos casos prácticos reproducibles
Aplicando las tarifas oficiales en dólares para 2026, calculamos el presupuesto de dos cargas de trabajo habituales:
Caso 1: Corrección puntual de código (Petición única, alta reflexión)
Entrada: 25.000 tokens sin caché (código fuente y descripción), 0% en caché.
Salida: 3.500 tokens (con 2.500 de razonamiento y 1.000 de código de solución).
Cálculo:
(25.000 × 0,435 $ + 3.500 × 0,87 $) / 1.000.000 = 0,010875 $ + 0,003045 $ = 0,01392 $por intento.1.000 ejecuciones al mes: 13,92 $. Incorporando un margen de reintentos de 1,2 se obtienen 16,70 $ mensuales.
Caso 2: Agente de investigación web multiturno (Contexto extenso, alta caché)
Entrada: 800.000 tokens acumulados en 15 turnos; 92% en caché (736.000 tokens coincidentes, 64.000 nuevos).
Salida: 12.000 tokens en total (planificación de búsqueda y síntesis final).
Cálculo:
(64.000 × 0,435 $ + 736.000 × 0,0036 $ + 12.000 × 0,87 $) / 1.000.000 = 0,02784 $ + 0,00265 $ + 0,01044 $ = 0,04093 $por tarea.200 tareas al mes: 8,19 $. Sin el mecanismo de caché, la misma carga ascendería a 71,60 $ mensuales (más de 8,7 veces superior).
| Carga de trabajo | Tokens de entrada | Cuota en caché | Tokens de salida | Tareas / mes | Coste mensual en tokens |
|---|---|---|---|---|---|
| Corrección de código | 25.000 | 0% | 3.500 | 1.000 | 13,92 $ |
| Agente de investigación | 800.000 | 92% | 12.000 | 200 | 8,19 $ |
Cálculo local
Estima el coste mensual de tokens
Tarifas oficiales de la API revisadas en septiembre de 2026. Incluye el razonamiento en la salida. Los datos quedan en el navegador.
Excluye llamadas a herramientas y reintentos. Lectura en caché Pro y Flash a $0.0036 y $0.0028 por 1M tokens. Revisado: 22-09-2026. Consultar tarifas actuales
La calculadora superior ejecuta todas las estimaciones localmente en tu navegador sin enviar datos al exterior. Puedes modificar libremente los parámetros para contrastar Pro, Flash y UltraSpeed.
Integración del flujo de trabajo en Tabbit Browser
Una vez presupuestadas las llamadas a la API, el equipo técnico necesita un entorno ágil donde poner a trabajar a los agentes. Automatizar la extracción de datos web y el contraste de documentos mediante scripts a medida y adaptadores API genera una importante sobrecarga operativa.
Tabbit Browser ofrece una arquitectura de navegación nativa con IA en la que agentes autónomos interactúan directamente con sitios web en vivo, estructuran tablas y conservan el contexto de investigación. Para profundizar en esta tendencia, consulta nuestros artículos sobre qué es un navegador agéntico y los mejores navegadores de IA en 2026.
Conforme a las directrices oficiales, la disponibilidad de modelos dentro de Tabbit depende del selector activo de cada cuenta y de las condiciones del servicio. Tabbit no gestiona tu cuenta de facturación de la API externa, pero proporciona un entorno idóneo para la investigación basada en navegador.
 Tabbit Browser
Fuentes consultadas
Toda la información y tarifas de este análisis proceden de documentación técnica oficial revisada el 22 de septiembre de 2026:
Ficha del modelo en Hugging Face: XiaomiMiMo/MiMo-V2.6-Pro-RL
Ficha del modelo en Hugging Face: XiaomiMiMo/MiMo-V2.6-Flash-RL

Preguntas frecuentes
¿Cuánto cuesta MiMo-V2.6-Pro a través de la API oficial?
La API oficial tarifa MiMo-V2.6-Pro en 0,435 $ por millón de tokens de entrada sin caché, 0,0036 $ por millón de tokens en acierto de caché y 0,87 $ por millón de tokens de salida.
¿Cuánto ahorro supone el uso de caché en MiMo-V2.6-Pro?
La entrada en caché cuesta 0,0036 $ por millón de tokens frente a los 0,435 $ habituales. Esto representa una reducción del 99,17% (120 veces más barato) en prefijos repetidos.
¿Se cobran los tokens de razonamiento interno de forma separada?
No. Xiaomi MiMo contabiliza los tokens de pensamiento interno junto con la respuesta visible como tokens de salida estándar a 0,87 $ por millón de tokens.
¿Qué es MiMo-V2.6-Pro-UltraSpeed y por qué cuesta diez veces más?
UltraSpeed es una variante de alto rendimiento diseñada para aplicaciones interactivas en tiempo real con una velocidad de salida hasta 20 veces mayor. Cuesta 4,35 $ de entrada y 8,70 $ de salida por millón de tokens.
¿En qué se diferencian los Token Plans de Xiaomi de la API de pago por uso?
Los Token Plans son suscripciones prepagadas mensuales (Lite 39 ¥, Standard 99 ¥, Pro 329 ¥, Max 659 ¥) con cuotas cerradas de uso, independientes de la facturación medida por millón de tokens de la API.
¿Es posible utilizar MiMo-V2.6-Pro en Tabbit Browser?
Tabbit Browser ofrece un espacio de trabajo nativo para investigación y agentes web; la disponibilidad específica de modelos depende del selector de cuentas y los términos vigentes de la plataforma.