
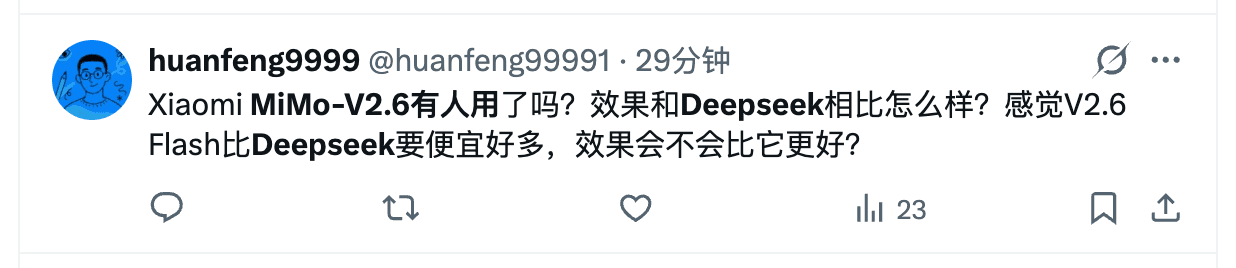
O MiMo-V2.6-Pro merece ficar na sua lista curta. A Xiaomi o lançou e abriu em 22 de setembro de 2026, e o carro-chefe marca 46 no Artificial Analysis Intelligence Index — o mais alto entre os modelos de pesos abertos naquele momento — com preço oficial de US$ 0,435 por milhão de tokens de entrada e US$ 0,87 de saída. O teste independente no OpenCode da Kingy AI da véspera deu 23 de 23 verificações ocultas de código por cerca de US$ 0,03 por execução, igualando a precisão do Claude Opus 5 por cerca de um trinta e cinco avos do custo. No próprio dia do lançamento, uma pergunta no X resumiu toda a comparação em uma frase: "Has anyone used Xiaomi MiMo-V2.6? How does it compare to DeepSeek? V2.6 Flash looks much cheaper than DeepSeek — could it actually be better?"
A razão para olhar além vem da própria Xiaomi. O anúncio oficial diz literalmente: "However, there is still a gap when compared with the strongest closed-source models Claude Fable 5.1 and GPT-6 Astra." Um fornecedor dizer que seu novíssimo carro-chefe ainda não alcança a fronteira fechada é raro o bastante para ser levado a sério — no mesmo índice, o Fable 5.1 e o GPT-6 Astra estão em 53, sete pontos acima do MiMo-V2.6-Pro, e o Claude Opus 5 com esforço máximo chega a 51 a US$ 5,86 por tarefa do índice, contra cerca de US$ 0,13 do MiMo.
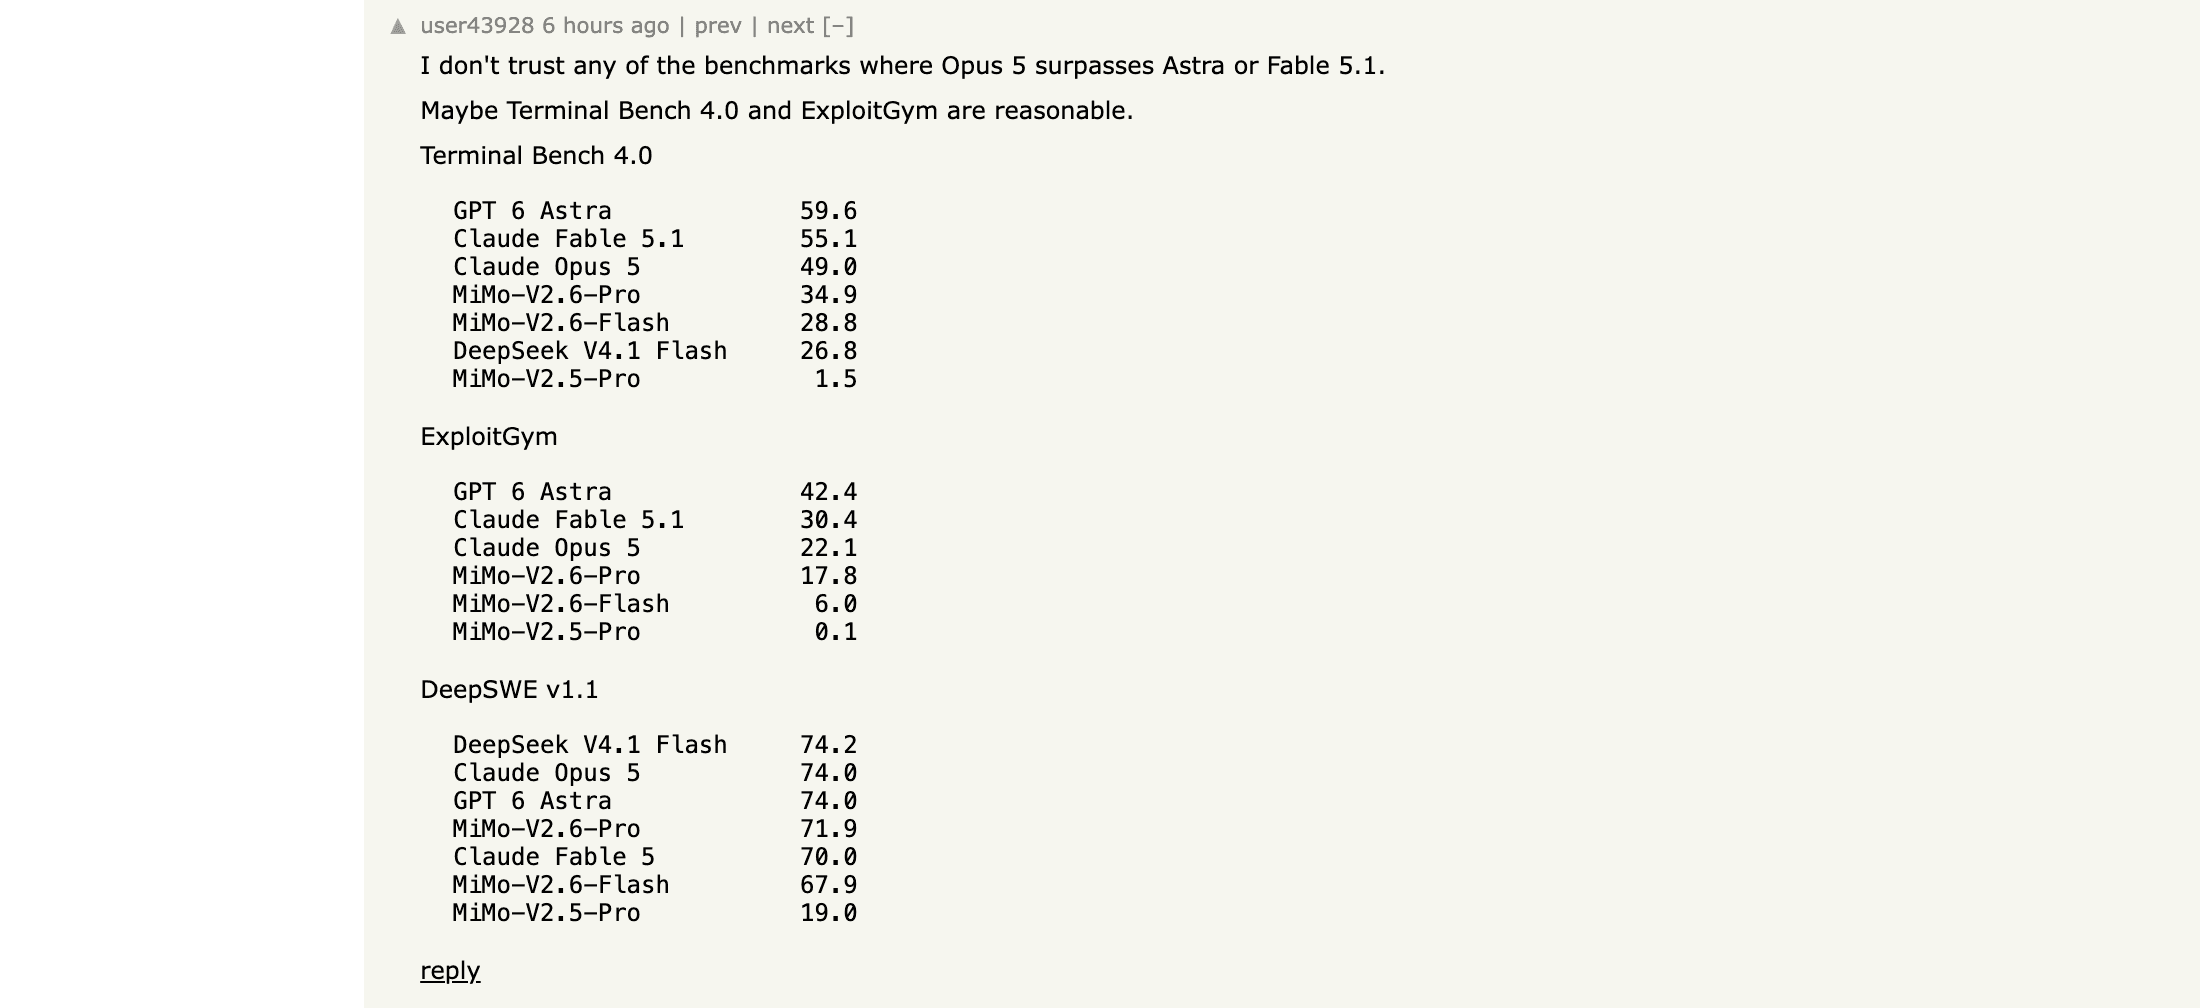
Esses sete pontos escondem dois custos mensuráveis. No Terminal Bench 4.0 — um benchmark agêntico que opera o terminal — a própria tabela da Xiaomi dá 34,9 ao MiMo-V2.6-Pro contra 49,0 do Claude Opus 5 e 59,6 do GPT-6 Astra. E o raciocínio que sustenta a pontuação aparece na sua fatura: um testador do Hacker News só conseguiu completar as execuções nos ajustes de menor esforço porque "the other ones (medium/high) used way too many tokens and all requests timed out." Não é uma acusação de fraqueza. É a constatação de que "carro-chefe de pesos abertos mais barato" esconde dois custos reais — uma lacuna agêntica e uma conta de tokens que cresce com o pensamento — e ambos têm alternativas concretas.
Se a sua frustração não é o modelo, mas a tubulação ao redor — gerenciar chaves de API, comparar preços, brigar com cinco abas — a última seção oferece um terceiro caminho: executar a comparação dentro do Tabbit Browser. Primeiro, os candidatos.
Conclusões principais
O MiMo-V2.6-Flash é a primeira alternativa a testar: mesmo contexto de 1M, mesma entrada omnimodal e mesma API a US$ 0,14/US$ 0,28 por milhão de tokens, com o aval do próprio fabricante: "superou de forma abrangente o MiMo-V2.5-Pro".
O DeepSeek V4.1 Flash é a jogada de agendamento: fora de pico, US$ 0,15 de entrada e US$ 0,60 de saída são difíceis de bater, e ele lidera a tabela compartilhada do DeepSWE v1.1 com 74,2.
O Kimi K3 é o rival premium de pesos abertos: um modelo de raciocínio de 2,8T de parâmetros que custa cerca de 17 vezes mais por tarefa de avaliação e compra outro perfil de benchmark, não uma vitória clara.
O Qwen3.8 Max (0902) é o carro-chefe fechado equivalente a US$ 2/US$ 6 por milhão de tokens — a rota para equipes que querem o topo da Alibaba sem operações de pesos abertos.
O GLM-5.3 é o raciocinador sempre ativo para qualidade de código: a comunidade elogia suas "soluções limpas", a preço promocional de US$ 0,78/US$ 2,46 no OpenRouter.
Trate cada benchmark aqui como relatado pelo fabricante ou indexado por terceiros, e cada comentário da comunidade como a experiência de uma pessoa. As pontuações da semana de lançamento se movem.
Como escolhi essas alternativas
Quatro critérios, aplicados em ordem:
Custo por tarefa concluída, não preço de etiqueta. Um modelo pela metade do preço que pensa o triplo não é barato. Cada candidato é precificado em sua rota oficial ou listada, com cache, horários de pico e descontos de lote anotados quando mudam a conta.
Confiabilidade agêntica em trabalho real. O índice da Artificial Analysis ordena bem o clube open-weights, mas o Terminal Bench 4.0, o ExploitGym e o DeepSWE v1.1 mostram o que o índice esconde. Os candidatos precisavam trazer evidência de pelo menos um deles.
Pesos abertos e adequação de implantação. A hospedagem própria muda residência de dados, estrutura de custos e dependência. Cada candidato é marcado como aberto ou fechado: essa única linha decide metade da migração.
Evidência comunitária nominal. Preferências e modos de falha vêm de publicações específicas no HN, Reddit e X — não de comunicados de imprensa.
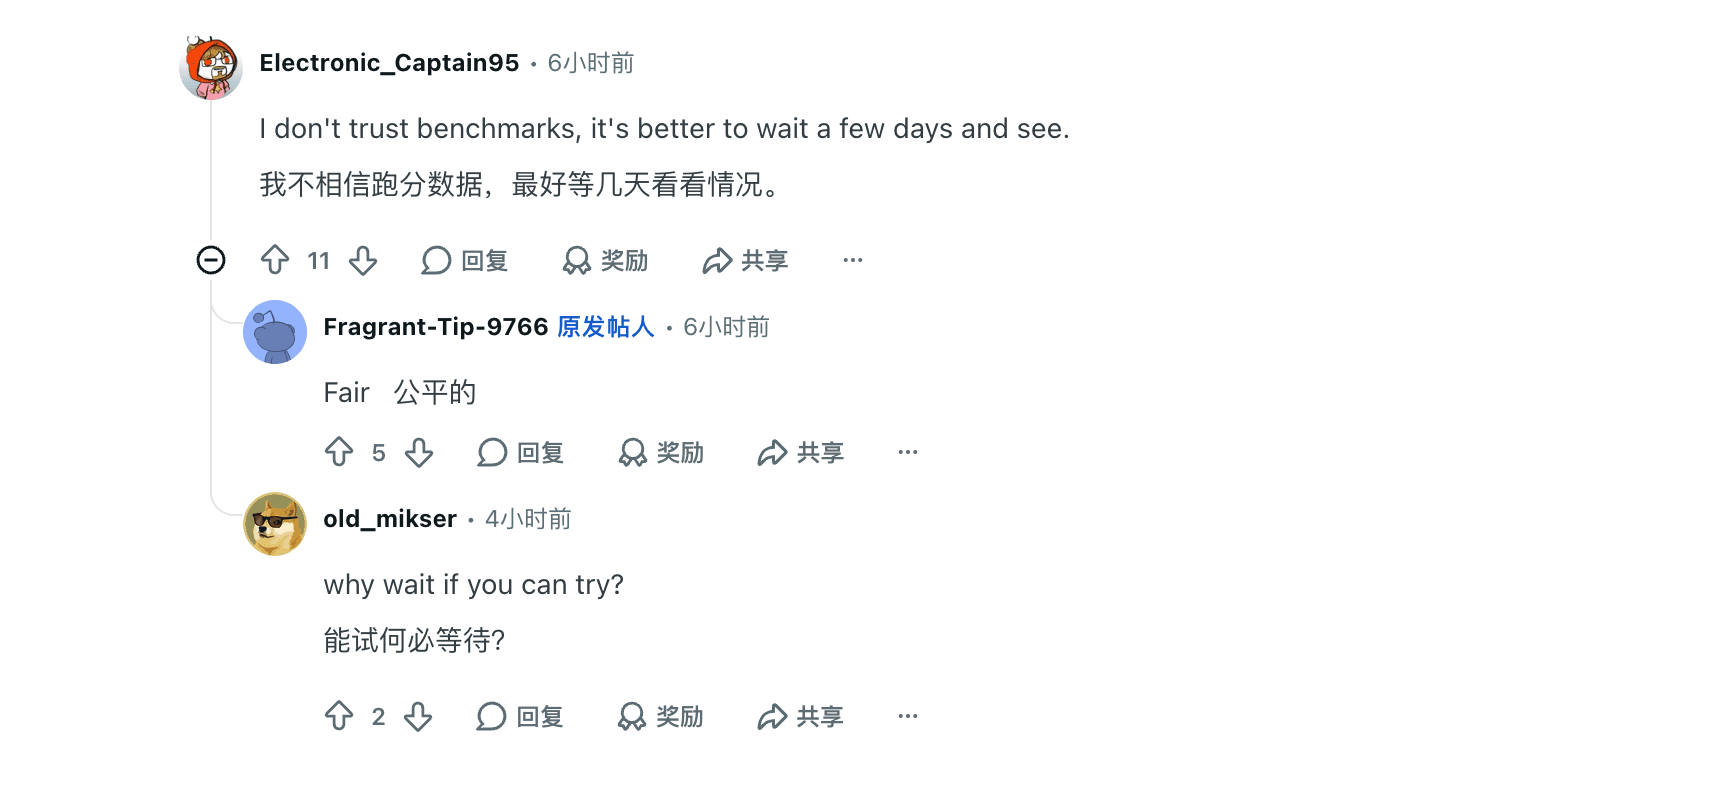
As capturas de tela são publicações originais capturadas em 22 de setembro de 2026. Em um fio que avaliava adotar o MiMo para código, uma usuária do Reddit resumiu a postura: "I don't trust benchmarks, it's better to wait a few days and see."
Os cinco candidatos de relance
| Candidato | Melhor para | Rota publicada | Preço por 1M (verificado em 22/09/2026) | A principal armadilha |
|---|---|---|---|---|
| MiMo-V2.6-Flash | Corte de custo na mesma família | mimo-v2.6-flash; contexto 1M / saída 131K; pesos abertos | US$ 0,14 entrada / US$ 0,0028 acerto de cache / US$ 0,28 saída | Menos folga de raciocínio que o Pro em tarefas agênticas difíceis |
| DeepSeek V4.1 Flash | Lotes agendados e orçamentos fora de pico | deepseek-flash; 1M / 384K; apenas API | Fora de pico US$ 0,15 / US$ 0,60; pico US$ 0,30 / US$ 1,20; acerto de cache US$ 0,003–0,006 | Os horários de pico (01h00–04h00 e 06h00–10h00 UTC em dias úteis) dobram entrada e saída |
| Kimi K3 | Raciocínio premium de pesos abertos e agentes de longo prazo | kimi-k3; contexto 1,0M; pesos abertos | O OpenRouter lista US$ 1,50 / US$ 7,50 (50% off; tabela US$ 3 / US$ 15) | Cerca de 17 vezes o custo de avaliação do MiMo por 2 pontos a menos no índice |
| Qwen3.8 Max (0902) | Carro-chefe fechado da Alibaba com entrada multimodal | qwen3.8-max-0902; contexto 1,0M | US$ 2 / US$ 6 | Pesos fechados — sem hospedagem própria, sem plano B no nível dos pesos |
| GLM-5.3 | Raciocínio sempre ativo para qualidade de código | glm-5.3; contexto listado de 1,3M | O OpenRouter lista US$ 0,78 / US$ 2,46 (44% off) | O raciocínio não pode ser desativado; servir localmente é caro |
Fontes: preços da Xiaomi MiMo (atualizado em 21 de setembro de 2026), preços da DeepSeek e as listagens do OpenRouter para Kimi K3, GLM-5.3 e Qwen3.8 Max. Os preços de saída incluem tokens de raciocínio. Os preços do OpenRouter trazem selos de promoção do dia; as páginas de preços próprias da Moonshot e da Alibaba estiveram inacessíveis nesta sessão, então suas listagens no OpenRouter servem como fonte com essa ressalva anotada.
A matemática completa da família MiMo — cache, UltraSpeed, API Batch — está no nosso guia de preços do MiMo-V2.6-Pro. Esta página fica na decisão de ficar ou trocar.
MiMo-V2.6-Flash
Melhor para: cortar dois terços da fatura sem sair da API, da janela de contexto nem dos tipos de entrada da Xiaomi.
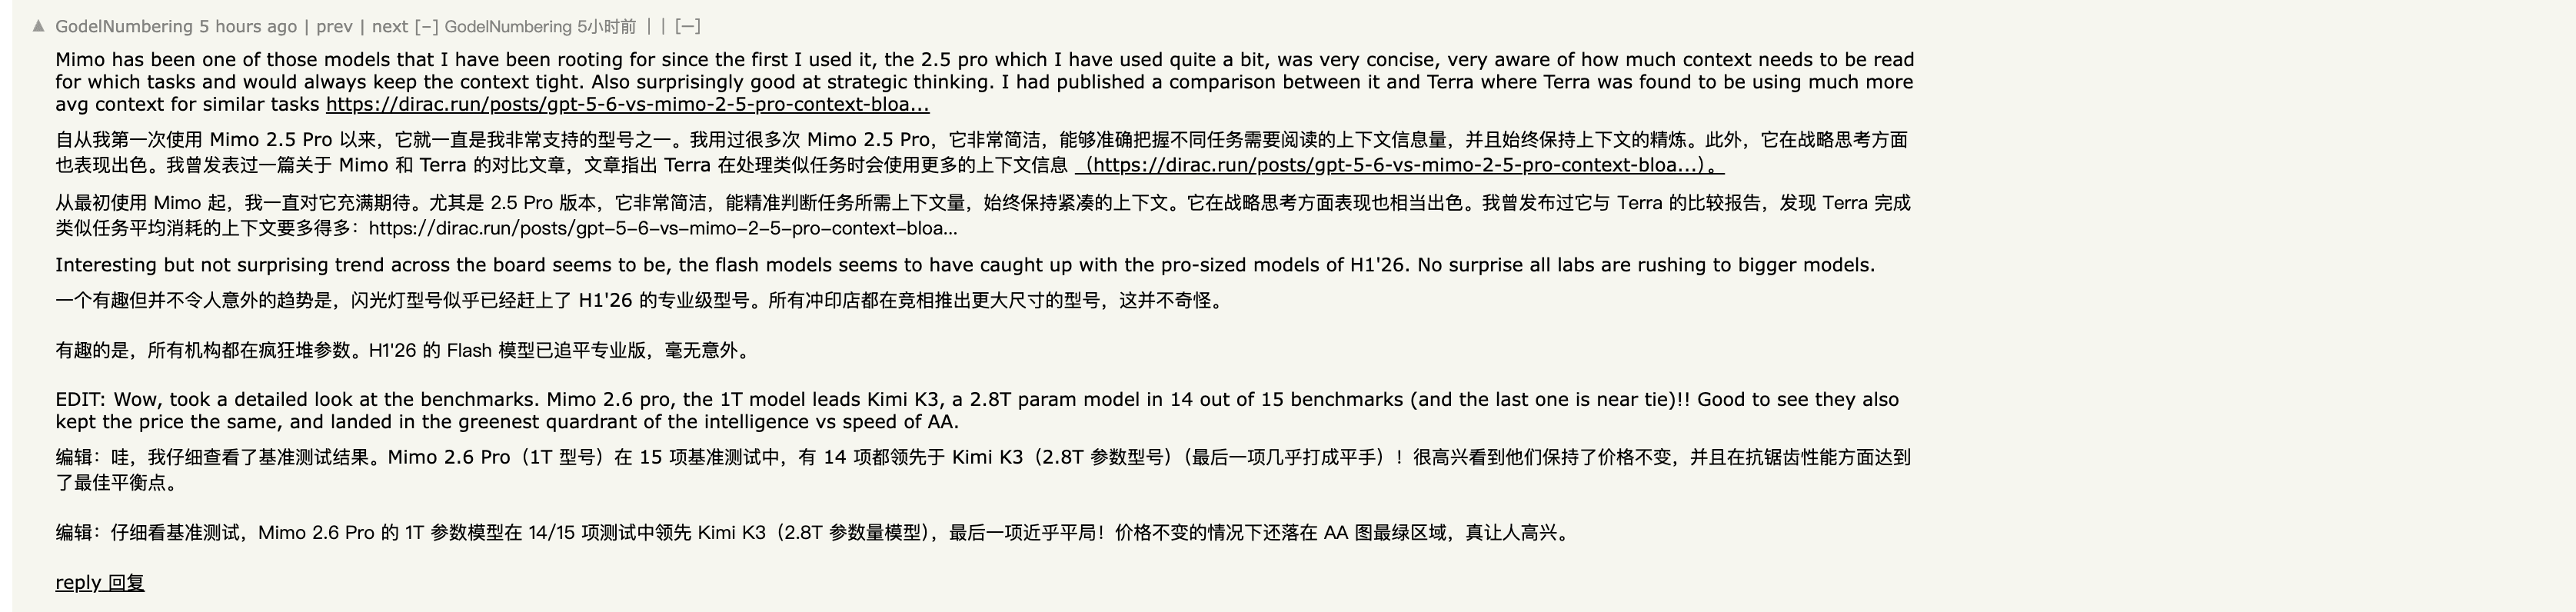
Prós: o Flash compartilha o contexto de 1.048.576 tokens, o teto de saída de 131.072 tokens e a entrada multimodal nativa do Pro, a US$ 0,14 de entrada e US$ 0,28 de saída por milhão de tokens — e US$ 0,07/US$ 0,14 pela API Batch. É o único candidato da lista cujo respaldo de melhoria vem do próprio anúncio do fabricante: "MiMo-V2.6-Flash has comprehensively outperformed MiMo-V2.5-Pro." Na tabela agêntica compartilhada da Xiaomi, marca 28,8 no Terminal Bench 4.0 — acima dos 26,8 do DeepSeek V4.1 Flash — e o teste independente da Kingy no OpenCode deu 21 de 23 numa rota gratuita, duas verificações a menos que o irmão mais velho. Um comentarista do Hacker News que acompanha a família desde o V2.5 resumiu: "the 2.5 pro… was very concise, very aware of how much context needs to be read for which tasks and would always keep the context tight", acrescentando numa edição que "Mimo 2.6 pro, the 1T model leads Kimi K3, a 2.8T param model in 14 out of 15 benchmarks (and the last one is near tie)!!"
Contras: é o modelo pequeno. Com 309B de parâmetros totais / 15B ativados contra 1,02T / 42B do Pro, o raciocínio profundo de múltiplas etapas tem menos folga — o mesmo teste do OpenCode descontou duas verificações, e no ExploitGym ele marca 6,0 contra 17,8 do Pro. Se a sua carga vive da profundidade de raciocínio do Pro, o Flash é uma falsa economia.
Preços: US$ 0,14 de entrada / US$ 0,0028 de acerto de cache / US$ 0,28 de saída por milhão de tokens; metade disso novamente pela API Batch; o multiplicador de 10× do UltraSpeed pertence só ao Pro. Exemplos resolvidos na tabela de tarifas da família.
Veredito: se a sua reclamação sobre o MiMo-V2.6-Pro é a fatura e não o teto, teste o Flash primeiro — é a resposta barata do próprio fabricante. Se a sua reclamação é qualidade em tarefas agênticas difíceis, o Flash não resolve; olhe o DeepSeek ou o Kimi K3.
A página do modelo MiMo-V2.6-Flash (English) guarda as especificações junto das notas de migração.
DeepSeek V4.1 Flash
Melhor para: cargas de alto volume que podem rodar fora do horário de pico e equipes que querem uma API de 1M de contexto, com visão, a preços de piso.
Prós: a página de preços atual da DeepSeek lista o deepseek-flash (DeepSeek-V4.1-Flash) com modos de pensamento e não pensamento, contexto de 1M, saída máxima de 384K, visão, saída JSON, chamadas de ferramenta e endpoints compatíveis com OpenAI e Anthropic. Fora de pico, a entrada custa US$ 0,15 e a saída US$ 0,60 por milhão de tokens — com o cache quente, prefixos repetidos são cobrados a US$ 0,003. Nos benchmarks agênticos publicados pela Xiaomi, o DeepSeek V4.1 Flash marca 74,2 no DeepSWE v1.1, o maior número da tabela compartilhada, à frente do Claude Opus 5 e do GPT-6 Astra (74,0) e do MiMo-V2.6-Pro (71,9). A concorrência documentada é de 2.500, o nível mais alto da página.
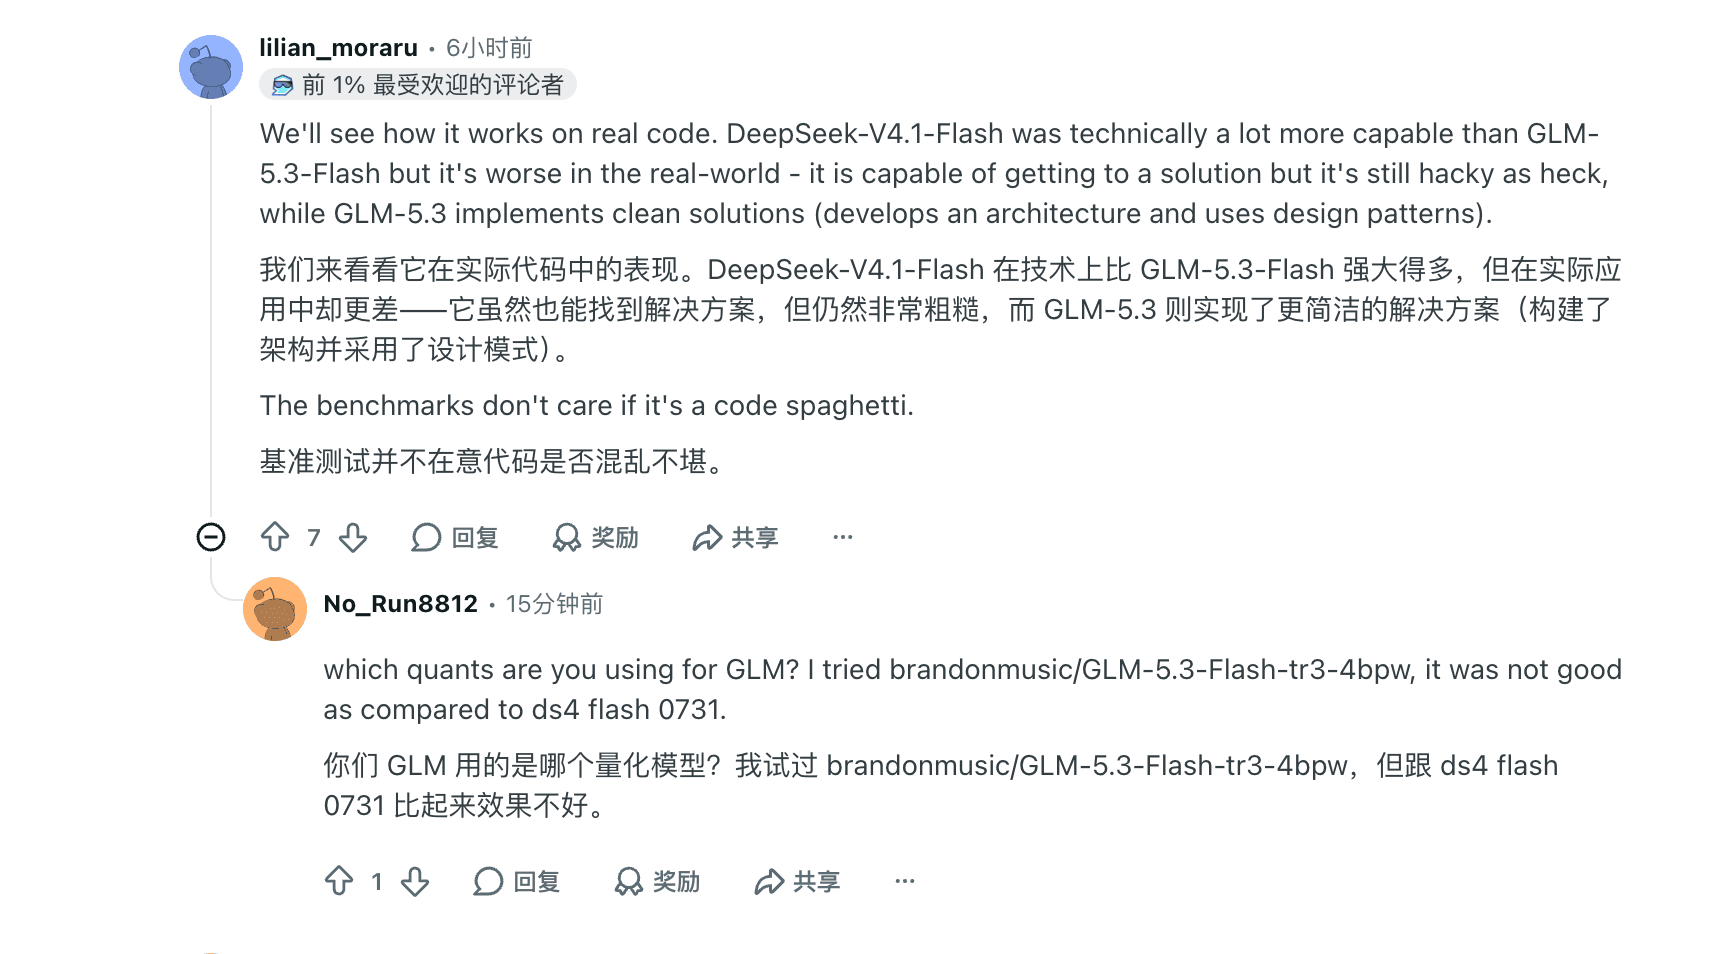
Contras: o horário. Os horários de pico — 01h00–04h00 e 06h00–10h00 UTC em dias úteis, exceto feriados chineses — dobram exatamente todas as tarifas, e um erro de cache no pico custa US$ 0,30 por milhão. A qualidade do código no mundo real divide a comunidade: num fio do LocalLLaMA que comparava modelos abertos pequenos, uma comentarista veterana argumentou que "DeepSeek-V4.1-Flash was technically a lot more capable than GLM-5.3-Flash but it's worse in the real-world - it is capable of getting to a solution but it's still hacky as heck". A DeepSeek também se reserva o direito de mudar preços: cite a página dela, não este artigo, ao orçar.
Preços: fora de pico US$ 0,003 acerto de cache / US$ 0,15 erro / US$ 0,60 saída; no pico US$ 0,006 / US$ 0,30 / US$ 1,20 por milhão de tokens. A tarifa fora de pico é exatamente a metade.
Veredito: escolha a DeepSeek quando a carga for agendável — enriquecimento em lote, resumos noturnos, agentes programados — e seus testes de aceitação passarem nas saídas dela. Fique com o MiMo-V2.6-Pro quando precisar de latência interativa no pico a preços estáveis, ou quando o raciocínio mais profundo dele vencer no seu próprio conjunto de tarefas.
A página do modelo DeepSeek V4.1 Flash (English) e nossa análise de preços do DeepSeek V4 Flash cobrem o horário em detalhe.
Kimi K3
Melhor para: equipes já investidas no ecossistema da Moonshot que querem a alternativa de pesos abertos mais forte fora da Xiaomi — e podem pagá-la.
Prós: o Kimi K3 é um modelo de raciocínio multimodal de pesos abertos com 2,8T de parâmetros, janela de contexto de 1,0M e arquitetura KDA com resíduos de atenção, listado no OpenRouter a US$ 1,50 de entrada / US$ 7,50 de saída por milhão de tokens sob uma promoção de 50% (tabela: US$ 3 / US$ 15). Na Artificial Analysis, segue como modelo aberto de elite: 43,6 no Intelligence Index com esforço máximo, 76,2 no Coding Index e 50,0 no Agentic Index — esse número agêntico supera o equivalente do MiMo-V2.6-Pro em vários conjuntos compartilhados. Para trabalho de repositório de longo prazo, conserva uma base de fãs genuína.
Contras: a matemática preço-índice é brutal neste mês. Uma análise da OrcaRouter mediu o custo de rodar o mesmo conjunto de avaliação em US$ 3.658,07 para o Kimi K3 contra US$ 206,66 para o MiMo-V2.6-Pro — um fator de dezessete — com 44 pontos contra 46. E o alarde tem críticos: "the 'best' models available from chinese labs right now (GLM 5.3 and Kimi K3) fall apart completely when you try to do real work with them. K3 is especially embarrassing…", argumentou um comentarista do Hacker News no dia do lançamento. É uma opinião forte sem detalhes de teste publicados — não conseguimos verificá-la — mas lembra que o prêmio do K3 compra outro perfil, não uma vitória garantida.

Preços: US$ 1,50 / US$ 7,50 por milhão de tokens na listagem promovida do OpenRouter em 22 de setembro de 2026; o preço de tabela é US$ 3 / US$ 15. A página de preços da Moonshot estava inacessível durante esta pesquisa; verifique lá antes de comprometer orçamentos.
Veredito: escolha o Kimi K3 quando um pipeline K existente, suas forças agênticas específicas ou seu perfil multimodal vencerem o seu conjunto de tarefas e o orçamento estiver aprovado. Escolha o MiMo-V2.6-Pro quando o desempenho no mesmo índice pesar mais que o nome do laboratório — a diferença de dezessete vezes é toda a decisão.
Nosso guia de preços do Kimi K3 e a página do modelo Kimi K3 (English) cobrem a estrutura de tarifas e as especificações.
Qwen3.8 Max (0902)
Melhor para: equipes que querem o carro-chefe fechado da Alibaba — entrada multimodal, raciocínio por padrão, contexto de 1M — como API gerenciada sem operações de pesos abertos.
Prós: o snapshot 0902 do Qwen3.8 Max é um modelo de mistura de especialistas de 2,4T de parâmetros que aceita texto, imagem e vídeo, com janela de contexto de 1,0M e suporte a chamadas de ferramenta, saídas estruturadas e esforço de raciocínio configurável. No índice da Artificial Analysis marca 45 — um ponto de diferença dos 46 do MiMo-V2.6-Pro — com um Coding Index de 76 que emparelha com a faixa de fronteira. A US$ 2 / US$ 6 por milhão de tokens, fica várias vezes abaixo de qualquer carro-chefe ocidental sem nenhuma responsabilidade de hospedagem de pesos. O próprio anúncio da Xiaomi nomeia o Qwen3.8 Max como um dos dois modelos de pesos abertos que o MiMo-V2.6-Pro superou: a comparação está escrita pelo fabricante, não inferida por nós.
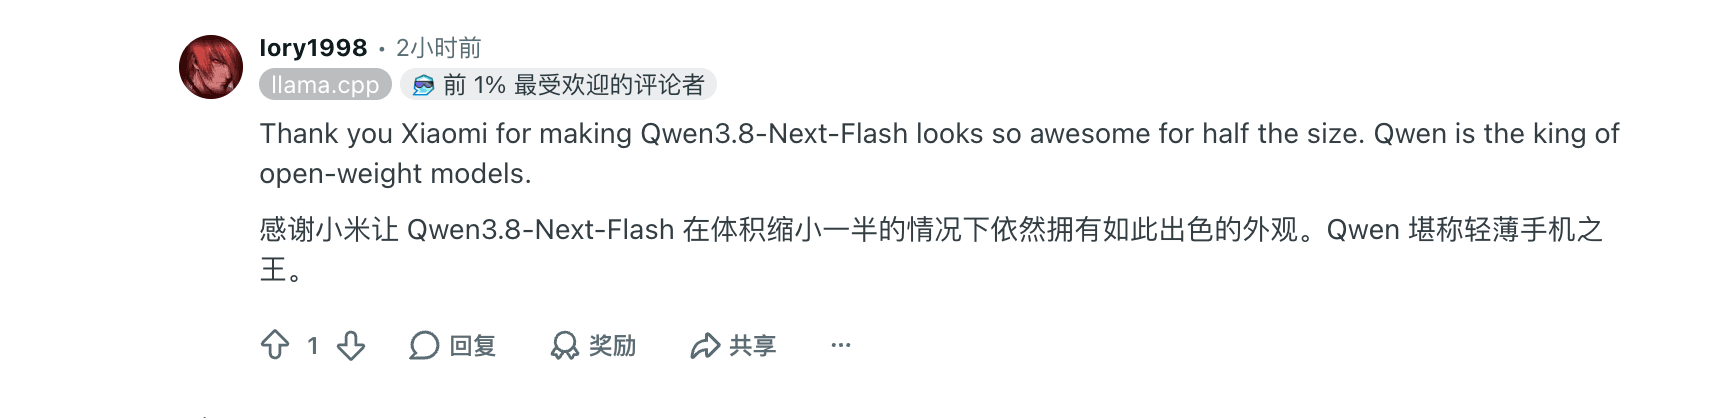
Contras: os pesos fechados encerram a conversa sobre hospedagem própria — não há checkpoint, nem arquivo de licença, nem plano B se a Alibaba mudar os termos de acesso. Os próprios fãs open-weights da Qwen prefeririam mandar você para os modelos menores: "Thank you Xiaomi for making Qwen3.8-Next-Flash looks so awesome for half the size. Qwen is the king of open-weight models", escreveu uma veterana do r/LocalLLaMA no dia do lançamento do MiMo — um elogio à família aberta da Qwen que lembra que o Max é a exceção fechada da família.
Preços: US$ 2 de entrada / US$ 6 de saída por milhão de tokens na listagem do OpenRouter para o snapshot 0902, verificado em 22 de setembro de 2026. A página de preços própria da Alibaba Cloud não renderizou nesta sessão; verifique lá antes de contratar.
Veredito: escolha o Qwen3.8 Max quando quiser um carro-chefe fechado, gerenciado e multimodal e os termos de conta da Alibaba se encaixarem na sua região e conformidade. Fique com o MiMo-V2.6-Pro quando pesos abertos, licença MIT ou a tabela mais baixa pesarem — ou quando seus re-testes reproduzirem a tabela da Xiaomi e favorecerem o checkpoint mais barato.
A página do modelo Qwen3.8 Max (English) acompanha as especificações do snapshot.
GLM-5.3
Melhor para: geração de código onde a qualidade da solução importa mais que velocidade ou preço — com raciocínio sempre ativo.
Prós: o GLM-5.3 é o modelo de raciocínio em larga escala da Z.ai, construído para engenharia de software complexa e tarefas agênticas de longo prazo, com esforços low, high e max (máximo por padrão) e um contexto listado de 1,3M no OpenRouter. Na Artificial Analysis, marca 44,8 no Intelligence Index e — mais revelador — 53,1 no Agentic Index, um número agêntico de elite. O feedback qualitativo é a parte interessante: a mesma comentarista do LocalLLaMA que chamou a saída da DeepSeek de "hacky" elogiou a GLM na mesma frase: "GLM-5.3 implements clean solutions (develops an architecture and uses design patterns)." Na listagem promovida do OpenRouter, saía a US$ 0,7826 / US$ 2,46 por milhão de tokens — 44% de desconto — caindo entre o MiMo-V2.6-Pro e o Kimi K3.
Contras: o raciocínio não pode ser desativado, então não há modo barato sem pensamento para extração ou classificação — cada chamada paga o imposto de pensar. Servir localmente é outro projeto: "GLM 5.3 flash should already not be on there. Extremely expensive to run local", como disse um comentarista do fio de comparação do MiMo. E o site de documentação da Z.ai estava inacessível nesta sessão, então o preço listado carrega só a fronteira do OpenRouter.
Preços: US$ 0,7826 / US$ 2,46 por milhão de tokens na listagem com 44% de desconto do OpenRouter, verificado em 22 de setembro de 2026; o preço de tabela gira em torno de US$ 1,40 / US$ 4,39.
Veredito: escolha o GLM-5.3 quando a qualidade da revisão de código, o senso de arquitetura ou o número agêntico vencerem o seu piloto e um orçamento de raciocínio permanente for aceitável. Escolha o MiMo-V2.6-Pro quando precisar de uma API comutável e compatível com cache por menos da metade do preço de tabela — ou o Flash quando a fatura dominar.
A página do modelo GLM-5.3 (English) guarda as especificações e as notas de rota.
Um terceiro caminho: execute a comparação dentro do Tabbit
A maioria dos projetos de troca falha na logística, não na qualidade do modelo: abrir chaves de API de cinco provedores, normalizar saídas, comparar resultados em cinco abas. O Tabbit Browser ataca essa camada. A visão multi-modelo envia um prompt a vários modelos ao mesmo tempo e dispõe as respostas em colunas que se leem como uma planilha, e o seletor de modelos da omnibox troca o modelo ativo por chat sem reautenticar nada.
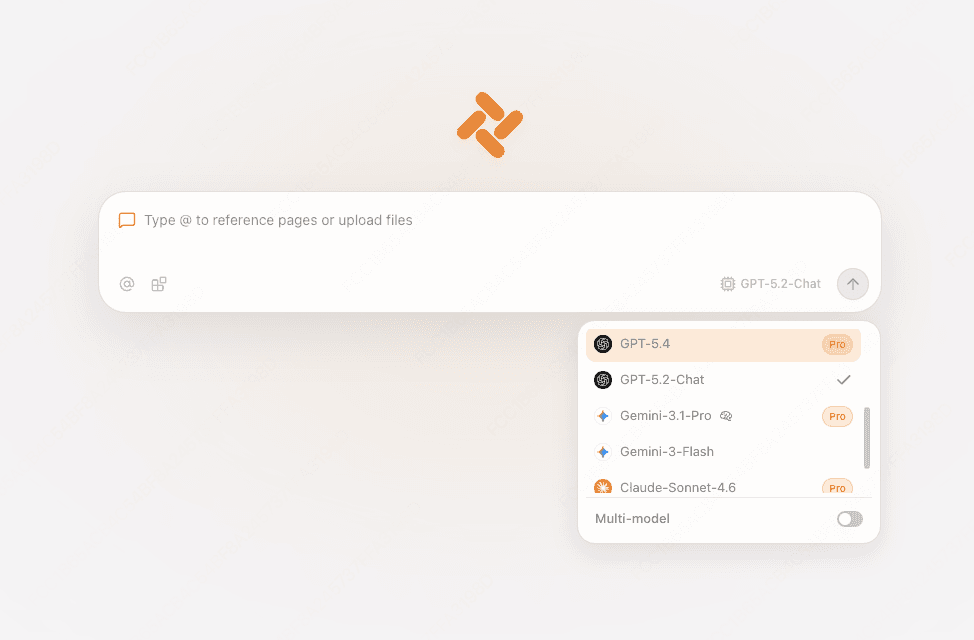
O laço prático de piloto: referencie a página ou o arquivo que importa com @, marque dois ou três modelos candidatos e compare as respostas numa única visão — depois repita nas cinco tarefas reais que você já roda. É uma amostra de nível de decisão em uma tarde, sem planilhas de faturamento. Para o que a navegação agêntica adiciona a esse fluxo, leia o que é um navegador agêntico e a comparação de navegadores de IA 2026.
Dois limites mantêm a honestidade. Primeiro, a disponibilidade real de modelos no Tabbit depende do seletor ativo da sua conta e dos termos da plataforma — este artigo não afirma que qualquer modelo específico, incluindo o MiMo-V2.6-Pro, venha embutido em todas as contas, e o Tabbit não substitui sua relação de faturamento externo. Segundo, uma comparação no navegador é um piloto, não um benchmark: ela controla prompt e página, não a contabilidade de tokens nem a variância. Use-a para a lista curta; use o guia de preços para o orçamento.
 Tabbit Browser
Execute o piloto de tarefa idêntica
O candidato que sobreviver à lista curta, teste da mesma forma. Congele duas ou três tarefas reais com suas entradas, instruções, ferramentas, contrato de saída e orçamento de tentativas. Registre tokens, tempo até o primeiro token, tempo de conclusão, falhas de ferramenta e correções manuais — e calcule o custo por tarefa concluída, incluindo os tokens de raciocínio que são cobrados como saída. Uma execução limpa não prova nada sobre tarifas nem confiabilidade; repita até a variância parar de surpreender. Mudar o contexto ou a rota de ferramentas é uma diferença de rota, não prova de que um modelo é universalmente melhor.
Veredito: ficar ou trocar, conforme o cenário
Não há vencedor geral nesta página, e os placares do dia de lançamento não sobreviverão ao mês. A decisão segue a sua restrição:
| Restrição principal | Primeiro piloto | Critério de sucesso | Aviso principal |
|---|---|---|---|
| Cortar a fatura, manter o fluxo | MiMo-V2.6-Flash | As mesmas tarefas passam com dois terços do orçamento de tokens | Menos folga de raciocínio em tarefas agênticas difíceis |
| Lote agendado mais barato | DeepSeek V4.1 Flash | Aceitação fora de pico abaixo de US$ 0,20/1M misturados | No pico tudo dobra; agende ou pague |
| Paridade open-weights sem limite de preço | Kimi K3 | Os ganhos no conjunto justificam 17× o custo | O prêmio compra um perfil, não uma vitória garantida |
| Carro-chefe fechado gerenciado, multimodal | Qwen3.8 Max (0902) | Conformidade e termos de conta encaixam; tarefas passam | Sem plano B hospedado; o snapshot rotaciona |
| Qualidade de código acima de velocidade | GLM-5.3 | Notas de revisão superam rivais nos seus repositórios reais | Raciocínio sempre ativo; sem modo barato |
| Raciocínio compatível com cache a US$ 0,435/US$ 0,87 | Ficar com o MiMo-V2.6-Pro | O custo por tarefa concluída fica abaixo dos rivais | Cuidado com os níveis de esforço; a conta cresce com o pensamento |
Se ficar com o MiMo-V2.6-Pro, ajuste os níveis de esforço de propósito — os níveis médio e alto são onde vive o apetite por tokens dele — e mantenha os prefixos de prompt estáveis para que a camada de cache de US$ 0,0036 trabalhe.

Se trocar, deixe a restrição escolher o destino, não o placar. O guia de preços do MiMo-V2.6-Pro e as alternativas ao Gemini 3.8 Flash são as leituras complementares para o quadro completo de tarifas e famílias.
Fontes
Todos os fatos, preços e citações deste guia foram verificados em 22 de setembro de 2026:
Anúncio de lançamento da Xiaomi MiMo-V2.6 e preços oficiais da API
Listagens do OpenRouter: Kimi K3, GLM-5.3, Qwen3.8 Max (0902)
Publicações da comunidade conforme capturas e links no texto: X (@huanfeng9999), Reddit (r/DeepSeek, r/LocalLLaMA), Hacker News (itens 49793293, 49794307, 49795049, 49795769)

Perguntas frequentes
Qual é a alternativa mais próxima do MiMo-V2.6-Pro?
O MiMo-V2.6-Flash é a alternativa mais próxima da mesma família: mesma janela de contexto de 1M, mesma entrada omnimodal e mesma API por um terço do preço por token. O rival de pesos abertos de outro laboratório é o Kimi K3, mas seu preço de tabela é várias vezes maior e seu perfil de benchmarks é diferente.
Qual alternativa tem o menor preço de API anunciado?
O DeepSeek V4.1 Flash tem as tarifas de fora de pico mais baixas: US$ 0,003 em acerto de cache, US$ 0,15 em erro e US$ 0,60 de saída por milhão de tokens. O MiMo-V2.6-Flash desce a US$ 0,14 na entrada sem cache, e ambas as famílias ficam mais baratas com API Batch ou execução fora do horário de pico. A rota mais barata depende da sua taxa de acerto de cache e do horário em que você roda.
Continuar com o MiMo-V2.6-Pro ainda faz sentido?
Muitas vezes, sim. A Xiaomi o apresenta como o modelo de pesos abertos mais bem colocado no Artificial Analysis Intelligence Index, a US$ 0,435 de entrada e US$ 0,87 de saída por milhão de tokens, e um teste independente no OpenCode deu 23 de 23 acertos por cerca de três centavos. Fique quando suas tarefas são de raciocínio intenso, seus prompts aproveitam o cache e você não precisa dos últimos pontos dos benchmarks agênticos.
Posso hospedar essas alternativas por conta própria?
O MiMo-V2.6-Pro, o MiMo-V2.6-Flash e o Kimi K3 publicam pesos abertos, e a família GLM da Z.ai tem tradição open source, então a implantação local é viável com hardware sério. O Qwen3.8 Max é um modelo de API com pesos fechados, e o DeepSeek V4.1 Flash é consumido pela API da DeepSeek. Verifique cada licença e checkpoint antes de planejar a implantação.
Preciso migrar para fora do MiMo-V2.5-Pro?
Sim. A Xiaomi documenta que o mimo-v2.5-pro e o mimo-v2.5 serão descontinuados às 10h00 (horário de Pequim) de 21 de outubro de 2026. A série V2.6 mantém o mesmo preço de API, de modo que a maioria das migrações é uma troca de ID de modelo mais re-testes, sem mudança de orçamento.
O MiMo-V2.6-Pro está disponível no Tabbit Browser?
A disponibilidade real de modelos no Tabbit depende do seletor de modelos da sua conta e dos termos da plataforma, então este artigo não afirma acesso integrado. A visão multi-modelo do Tabbit permite comparar lado a lado os modelos que sua conta expõe, uma forma prática de testar alternativas em páginas reais.