
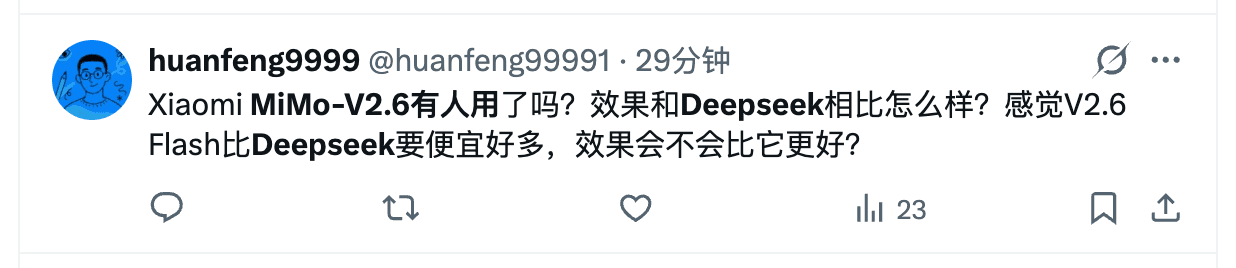
MiMo-V2.6-Pro mérite de rester dans votre liste restreinte. Xiaomi l'a lancé et ouvert le 22 septembre 2026, et le flagship affiche 46 à l'Artificial Analysis Intelligence Index — le meilleur score des modèles à poids ouverts à ce moment — pour un tarif officiel de 0,435 $ par million de tokens en entrée et 0,87 $ en sortie. Le test indépendant OpenCode de Kingy AI de la veille lui a donné 23 contrôles de code cachés sur 23 pour environ 0,03 $ l'exécution, égalant la précision de Claude Opus 5 pour environ un trente-cinquième du coût. Le jour même du lancement, une question sur X résumait toute la comparaison : « Has anyone used Xiaomi MiMo-V2.6? How does it compare to DeepSeek? V2.6 Flash looks much cheaper than DeepSeek — could it actually be better? »
La raison de regarder ailleurs vient de Xiaomi elle-même. L'annonce officielle indique : « However, there is still a gap when compared with the strongest closed-source models Claude Fable 5.1 and GPT-6 Astra. » Qu'un fournisseur vous dise que son tout nouveau flagship ne rejoint pas encore la frontière fermée est assez rare pour le croire — sur le même indice, Fable 5.1 et GPT-6 Astra siègent à 53, sept points au-dessus de MiMo-V2.6-Pro, et Claude Opus 5 à effort maximal atteint 51 à 5,86 $ par tâche d'indice contre environ 0,13 $ pour MiMo.
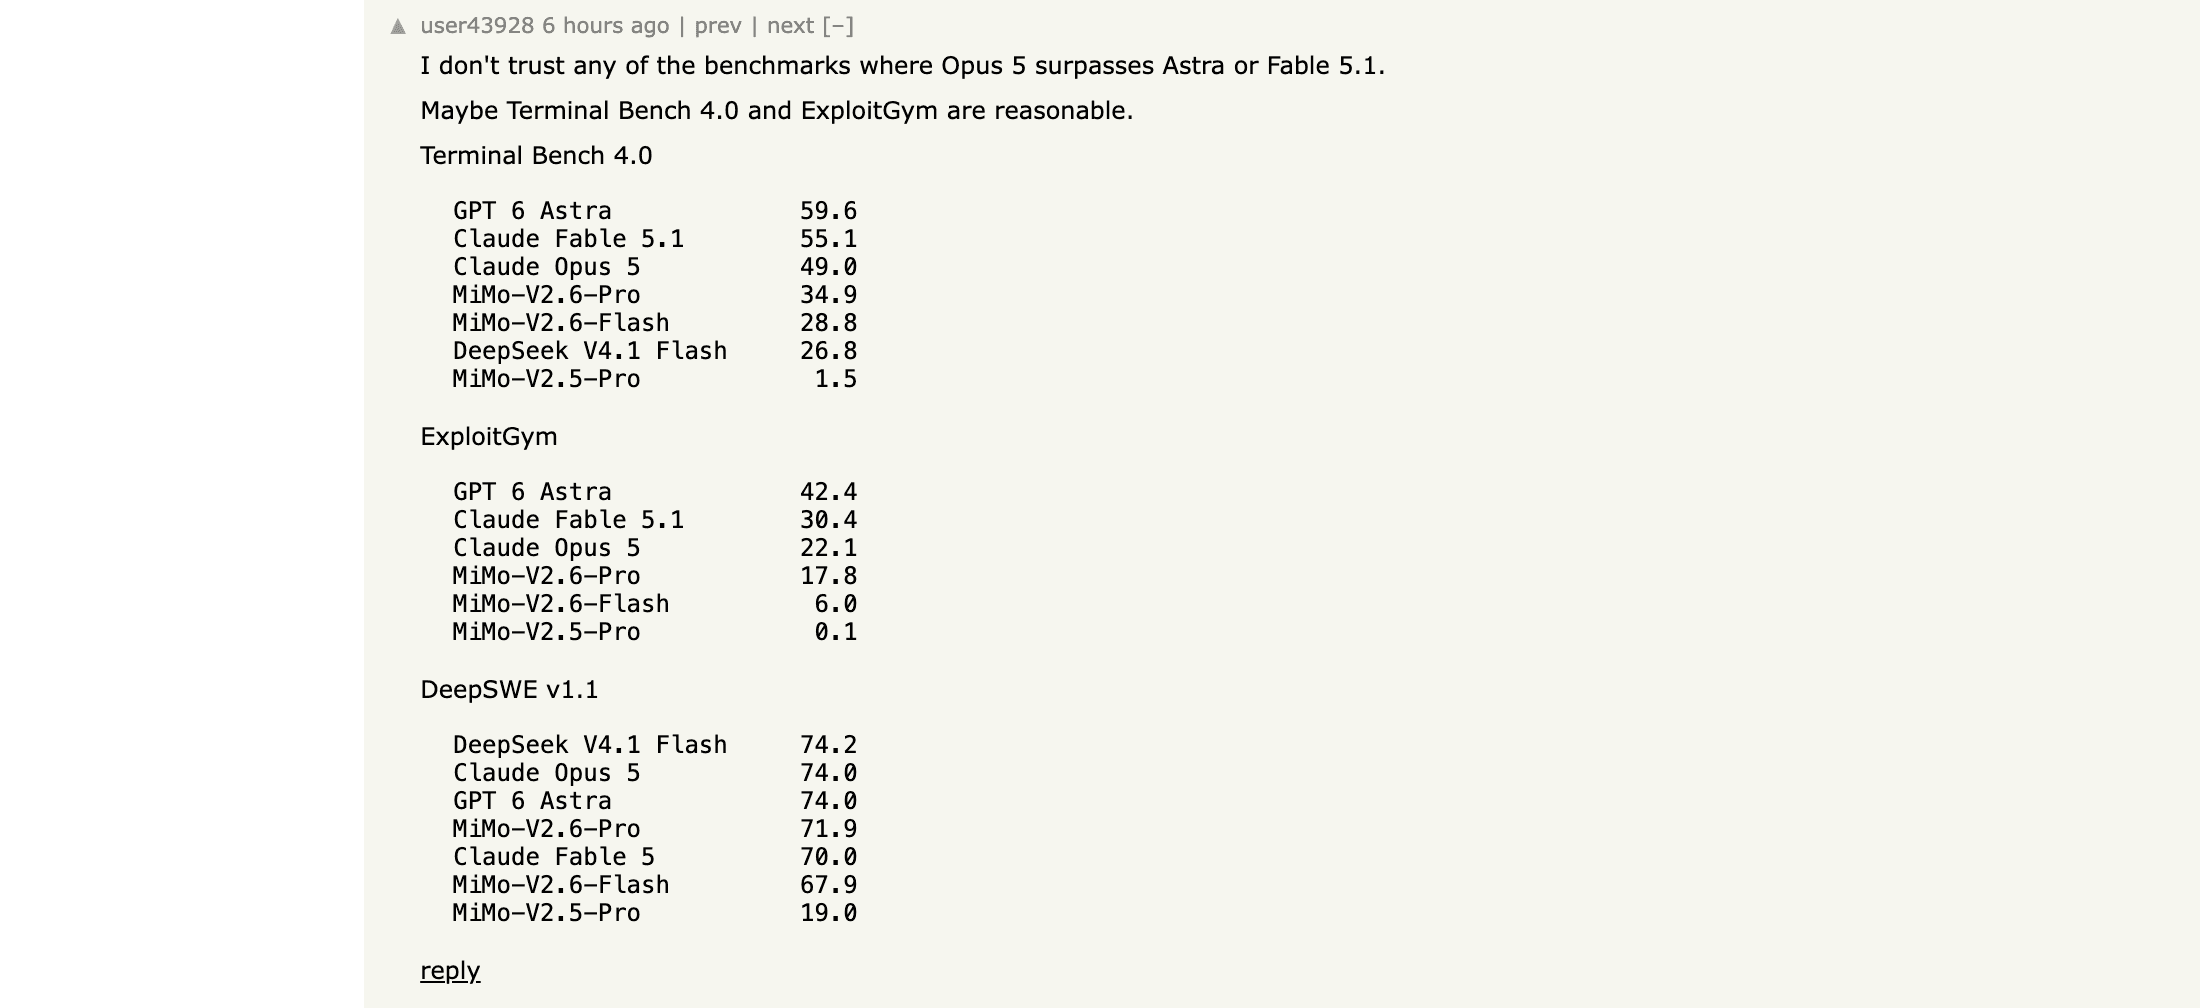
Ces sept points cachent deux coûts mesurables. Sur Terminal Bench 4.0 — un benchmark agentique qui pilote le terminal — le tableau même de Xiaomi donne 34,9 à MiMo-V2.6-Pro contre 49,0 à Claude Opus 5 et 59,6 à GPT-6 Astra. Et le raisonnement qui porte le score finit sur votre facture : un testeur de Hacker News n'a pu terminer ses essais qu'aux réglages d'effort les plus bas car « the other ones (medium/high) used way too many tokens and all requests timed out. » Ce n'est pas dire que MiMo-V2.6-Pro est faible. C'est dire que l'étiquette « flagship open-weights le moins cher » masque deux coûts réels — un écart agentique et une note de tokens qui grossit avec la réflexion — et les deux ont des alternatives concrètes.
Si votre frustration n'est pas le modèle mais la plomberie autour — gérer des clés d'API, comparer les prix, lutter avec cinq onglets — la dernière section propose une troisième voie : exécuter la comparaison dans Tabbit Browser. D'abord, les candidats.
Points clés
MiMo-V2.6-Flash est la première alternative à tester : même contexte de 1M, même entrée omnimodale et même API à 0,14 $/0,28 $ par million de tokens, avec le aval du fabricant lui-même : il « a surpassé de manière complète MiMo-V2.5-Pro ».
DeepSeek V4.1 Flash est le coup de la planification : hors pointe, 0,15 $ d'entrée et 0,60 $ de sortie sont difficiles à battre, et il mène la tableau partagé de DeepSWE v1.1 à 74,2.
Kimi K3 est le rival premium à poids ouverts : un modèle de raisonnement de 2,8T de paramètres qui coûte environ 17 fois plus par tâche d'évaluation, et achète un autre profil de benchmark, pas une victoire claire.
Qwen3.8 Max (0902) est le flagship fermé équivalent à 2 $/6 $ par million de tokens — la route des équipes qui veulent le sommet d'Alibaba sans opérations de poids ouverts.
GLM-5.3 est le raisonneur toujours actif pour la qualité de code : la communauté salue ses « solutions propres », à prix promotionnel de 0,78 $/2,46 $ sur OpenRouter.
Traitez chaque benchmark ici comme rapporté par le fabricant ou indexé par un tiers, et chaque commentaire communautaire comme l'expérience d'une personne. Les scores de la semaine de lancement bougent.
Comment j'ai choisi ces alternatives
Quatre critères, appliqués dans l'ordre :
Le coût par tâche accomplie, pas le prix affiché. Un modèle à moitié prix qui réfléchit trois fois plus n'est pas bon marché. Chaque candidat est tarifé sur sa route officielle ou listée, avec cache, heures de pointe et remises Batch notées quand elles changent le calcul.
La fiabilité agentique sur du travail réel. L'indice d'Artificial Analysis ordonne bien le club open-weights, mais Terminal Bench 4.0, ExploitGym et DeepSWE v1.1 montrent ce que l'indice cache. Les candidats devaient apporter des preuves d'au moins un de ces trois-là.
Les poids ouverts et l'adéquation de déploiement. L'auto-hébergement change la résidence des données, la structure des coûts et la dépendance. Chaque candidat est marqué ouvert ou fermé : cette seule ligne décide de la moitié de la migration.
Des preuves communautaires nominatives. Les préférences et modes d'échec viennent de publications précises sur HN, Reddit et X — pas de communiqués de presse.
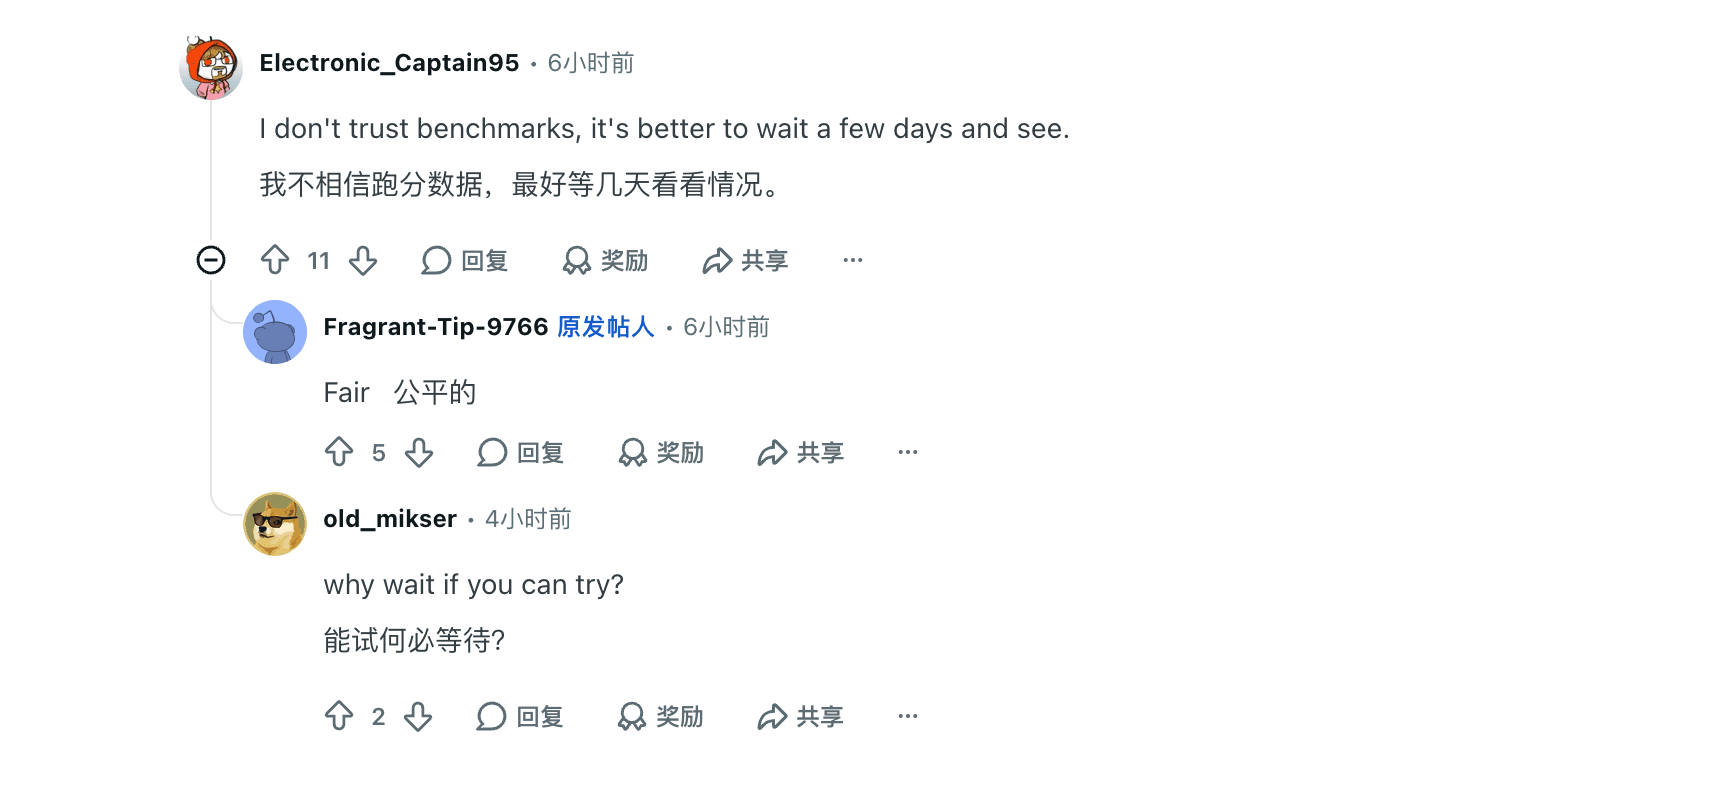
Les captures d'écran sont des publications originales capturées le 22 septembre 2026. Sur un fil qui évaluait l'adoption de MiMo pour le code, une utilisatrice de Reddit a résumé l'état d'esprit : « I don't trust benchmarks, it's better to wait a few days and see. »
Les cinq candidats en un coup d'œil
| Candidat | Idéal pour | Route publiée | Prix par 1M (vérifié le 22/09/2026) | Le principal piège |
|---|---|---|---|---|
| MiMo-V2.6-Flash | Réduction de coût dans la même famille | mimo-v2.6-flash ; contexte 1M / sortie 131K ; poids ouverts | 0,14 $ entrée / 0,0028 $ réussite de cache / 0,28 $ sortie | Moins de marge de raisonnement que Pro sur les tâches agentiques dures |
| DeepSeek V4.1 Flash | Lots planifiés et budgets hors pointe | deepseek-flash ; 1M / 384K ; API seule | Hors pointe 0,15 $ / 0,60 $ ; pointe 0,30 $ / 1,20 $ ; réussite de cache 0,003–0,006 $ | Les heures de pointe (01h00–04h00 et 06h00–10h00 UTC en semaine) doublent entrée et sortie |
| Kimi K3 | Raisonnement premium à poids ouverts et agents de longue haleine | kimi-k3 ; contexte 1,0M ; poids ouverts | OpenRouter liste 1,50 $ / 7,50 $ (−50 % ; liste 3 $ / 15 $) | Environ 17 fois le coût d'évaluation de MiMo pour 2 points de moins à l'indice |
| Qwen3.8 Max (0902) | Flagship fermé d'Alibaba à entrée multimodale | qwen3.8-max-0902 ; contexte 1,0M | 2 $ / 6 $ | Poids fermés — pas d'auto-hébergement, pas de plan B au niveau des poids |
| GLM-5.3 | Raisonnement toujours actif pour la qualité de code | glm-5.3 ; contexte listé 1,3M | OpenRouter liste 0,78 $ / 2,46 $ (−44 %) | Le raisonnement ne peut pas être désactivé ; le servir en local est cher |
Sources : tarifs Xiaomi MiMo (mis à jour le 21 septembre 2026), tarifs DeepSeek et les listages OpenRouter de Kimi K3, GLM-5.3 et Qwen3.8 Max. Les prix de sortie incluent les tokens de raisonnement. Les prix OpenRouter portent des badges promotionnels du jour ; les pages tarifaires propres de Moonshot et d'Alibaba étaient inaccessibles lors de cette session, leurs listages OpenRouter tiennent donc lieu de source avec cette limite notée.
Les mathématiques complètes de la famille MiMo — cache, UltraSpeed, API Batch — vivent dans notre guide de prix MiMo-V2.6-Pro. Cette page reste sur la décision de rester ou de partir.
MiMo-V2.6-Flash
Idéal pour : rogner les deux tiers de la facture sans quitter l'API, la fenêtre de contexte ni les types d'entrée de Xiaomi.
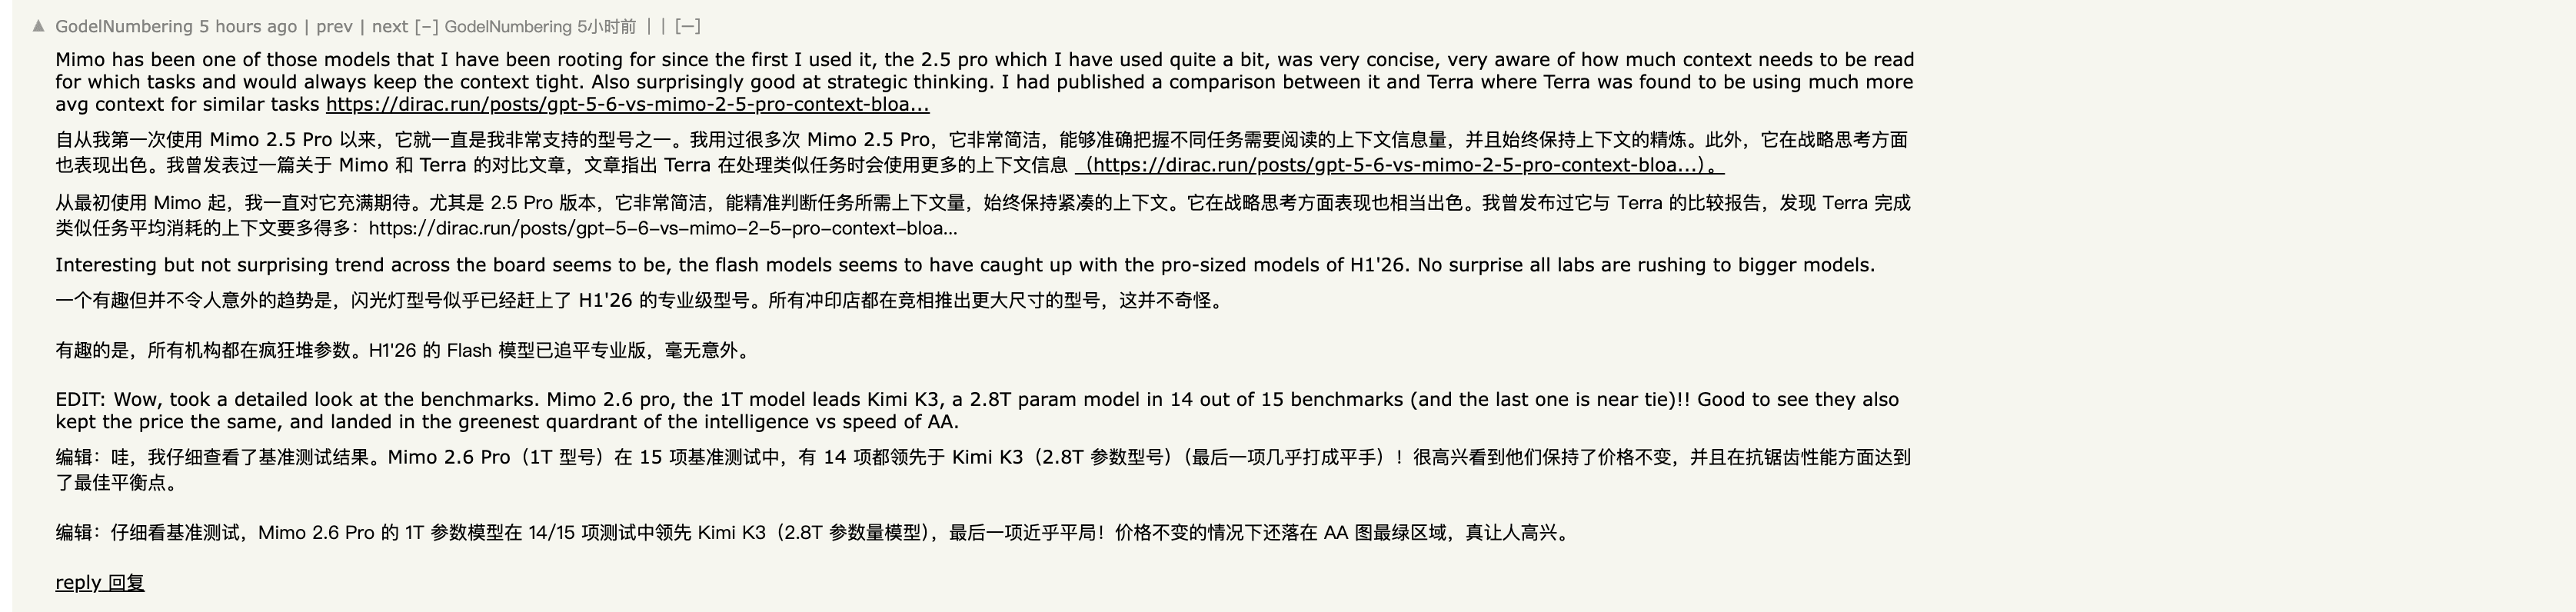
Avantages : Flash partage le contexte de 1 048 576 tokens, le plafond de sortie de 131 072 tokens et l'entrée multimodale native de Pro, à 0,14 $ d'entrée et 0,28 $ de sortie par million de tokens — et 0,07 $/0,14 $ via l'API Batch. C'est le seul candidat de la liste dont la promesse d'amélioration vient de l'annonce même du fabricant : « MiMo-V2.6-Flash has comprehensively outperformed MiMo-V2.5-Pro. » Sur la table agentique partagée de Xiaomi, il marque 28,8 à Terminal Bench 4.0 — au-dessus du 26,8 de DeepSeek V4.1 Flash — et le test indépendant OpenCode de Kingy lui a donné 21 sur 23 sur une route gratuite, deux contrôles de moins que son grand frère. Un commentateur de Hacker News qui suit la famille depuis V2.5 a résumé : « the 2.5 pro… was very concise, very aware of how much context needs to be read for which tasks and would always keep the context tight », ajoutant en édition que « Mimo 2.6 pro, the 1T model leads Kimi K3, a 2.8T param model in 14 out of 15 benchmarks (and the last one is near tie)!! »
Inconvénients : c'est le petit modèle. Avec 309B de paramètres totaux / 15B activés contre 1,02T / 42B pour Pro, le raisonnement profond multi-étapes a moins de marge — le même test OpenCode lui a retiré deux contrôles, et à ExploitGym il marque 6,0 contre 17,8 pour Pro. Si votre charge vit dans la profondeur de raisonnement de Pro, Flash est une fausse économie.
Tarifs : 0,14 $ entrée / 0,0028 $ réussite de cache / 0,28 $ sortie par million de tokens ; encore la moitié via l'API Batch ; le multiplicateur de 10× d'UltraSpeed appartient à Pro seul. Exemples chiffrés dans la grille tarifaire familiale.
Verdict : si votre grief contre MiMo-V2.6-Pro est la facture et non le plafond, testez Flash d'abord — c'est la réponse bon marché du fabricant lui-même. Si votre grief est la qualité sur les tâches agentiques dures, Flash ne le réglera pas ; regardez DeepSeek ou Kimi K3.
La page du modèle MiMo-V2.6-Flash (English) garde ses spécifications à côté des notes de migration.
DeepSeek V4.1 Flash
Idéal pour : les charges de gros volume pouvant tourner hors pointe, et les équipes qui veulent une API à 1M de contexte, avec vision, à prix plancher.
Avantages : la page de tarifs actuelle de DeepSeek liste deepseek-flash (DeepSeek-V4.1-Flash) avec modes réflexion et non-réflexion, 1M de contexte, 384K de sortie maximale, la vision, la sortie JSON, les appels d'outils et des points de terminaison compatibles OpenAI et Anthropic. Hors pointe, l'entrée coûte 0,15 $ et la sortie 0,60 $ par million de tokens — cache chaud, les préfixes répétés sont facturés 0,003 $. Sur les benchmarks agentiques publiés par Xiaomi, DeepSeek V4.1 Flash affiche 74,2 à DeepSWE v1.1, le meilleur chiffre du tableau partagé, devant Claude Opus 5 et GPT-6 Astra à 74,0 et MiMo-V2.6-Pro à 71,9. La concurrence documentée est de 2 500, le plus haut niveau de la page.
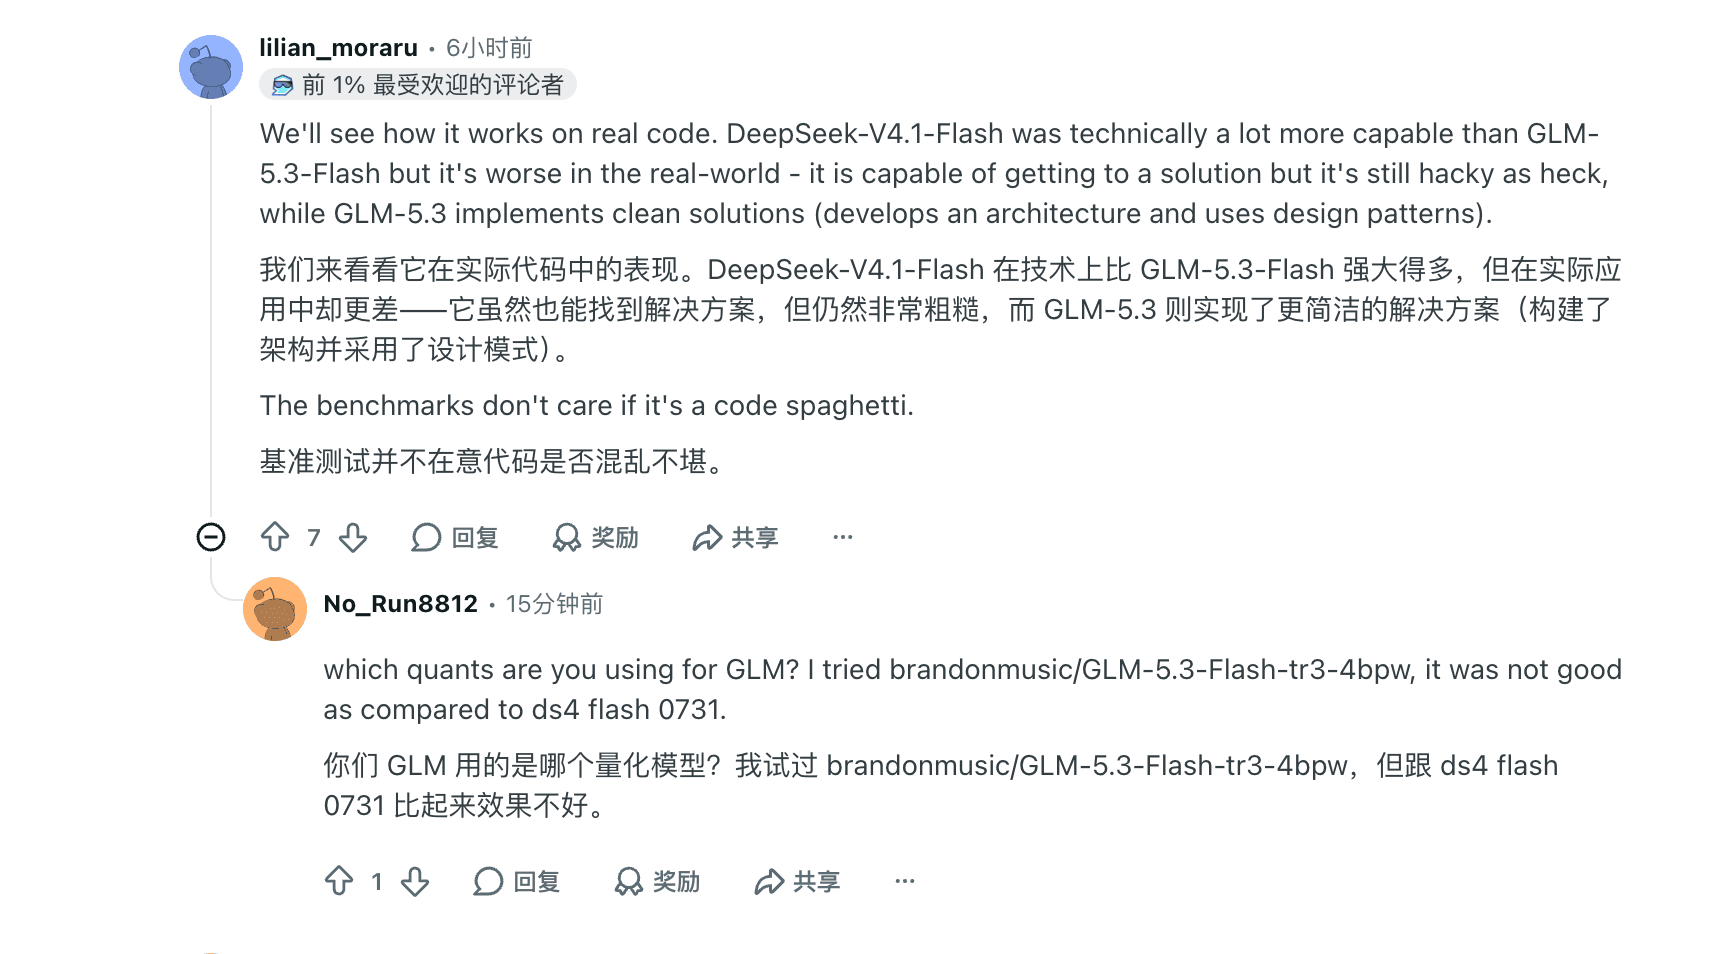
Inconvénients : l'horaire. Les heures de pointe — 01h00–04h00 et 06h00–10h00 UTC en semaine, hors jours fériés chinois — doublent exactement tous les tarifs, et un échec de cache en pointe coûte 0,30 $ par million. La qualité du code en conditions réelles divise la communauté : sur un fil LocalLLaMA comparant les petits modèles ouverts, une commentatrice chevronnée a soutenu que « DeepSeek-V4.1-Flash was technically a lot more capable than GLM-5.3-Flash but it's worse in the real-world - it is capable of getting to a solution but it's still hacky as heck ». DeepSeek se réserve aussi le droit de changer ses prix : citez sa page, pas cet article, pour budgéter.
Tarifs : hors pointe 0,003 $ réussite de cache / 0,15 $ échec / 0,60 $ sortie ; en pointe 0,006 $ / 0,30 $ / 1,20 $ par million de tokens. Le tarif hors pointe est exactement la moitié.
Verdict : choisissez DeepSeek quand votre charge est planifiable — enrichissement par lots, résumés nocturnes, agents programmés — et que vos tests d'acceptation passent sur ses sorties. Restez sur MiMo-V2.6-Pro quand vous avez besoin d'une latence interactive en pointe à prix stable, ou quand son raisonnement plus profond gagne sur votre propre suite de tâches.
La page du modèle DeepSeek V4.1 Flash (English) et notre analyse des prix de DeepSeek V4 Flash couvrent l'horaire en détail.
Kimi K3
Idéal pour : les équipes déjà investies dans l'écosystème de Moonshot qui veulent la meilleure alternative à poids ouverts hors de Xiaomi — et peuvent la payer.
Avantages : Kimi K3 est un modèle de raisonnement multimodal à poids ouverts de 2,8T de paramètres, avec une fenêtre de contexte de 1,0M et une architecture KDA à résidus d'attention, listé sur OpenRouter à 1,50 $ d'entrée / 7,50 $ de sortie par million de tokens sous une promotion de 50 % (liste : 3 $ / 15 $). Sur Artificial Analysis, il reste un modèle ouvert d'élite : 43,6 à l'Intelligence Index à effort maximal, 76,2 au Coding Index et 50,0 à l'Agentic Index — ce chiffre agentique dépasse l'équivalent de MiMo-V2.6-Pro sur plusieurs suites partagées. Pour le travail de dépôt à longue portée, il conserve une vraie base de fans.
Inconvénients : la mathématique prix-indice est brutale ce mois-ci. Une analyse d'OrcaRouter a mesuré le coût d'exécution de la même suite d'évaluation à 3 658,07 $ pour Kimi K3 contre 206,66 $ pour MiMo-V2.6-Pro — un facteur dix-sept — pour 44 points contre 46. Et le battage a ses critiques : « the 'best' models available from chinese labs right now (GLM 5.3 and Kimi K3) fall apart completely when you try to do real work with them. K3 is especially embarrassing… », a soutenu un commentateur de Hacker News le jour du lancement. C'est une opinion forte sans détails de test publiés — nous n'avons pas pu la vérifier — mais elle rappelle que la prime de K3 achète un autre profil, pas une victoire garantie.

Tarifs : 1,50 $ / 7,50 $ par million de tokens sur le listage promotionnel d'OpenRouter au 22 septembre 2026 ; le prix de liste est de 3 $ / 15 $. La page de prix de Moonshot était inaccessible pendant cette recherche ; vérifiez-la avant d'engager des budgets.
Verdict : choisissez Kimi K3 quand un pipeline K existant, ses forces agentiques spécifiques ou son profil multimodal gagnent votre suite de tâches et que le budget est approuvé. Choisissez MiMo-V2.6-Pro quand la performance au même indice compte plus que le nom du laboratoire — l'écart de dix-sept fois est toute la décision.
Notre guide de prix Kimi K3 et la page du modèle Kimi K3 (English) couvrent la structure tarifaire et les spécifications.
Qwen3.8 Max (0902)
Idéal pour : les équipes qui veulent le flagship fermé d'Alibaba — entrée multimodale, raisonnement par défaut, contexte de 1M — comme API gérée sans opérations de poids ouverts.
Avantages : l'instantané 0902 de Qwen3.8 Max est un modèle de mélange d'experts de 2,4T de paramètres qui accepte du texte, des images et des vidéos, avec une fenêtre de contexte de 1,0M et la prise en charge des appels d'outils, des sorties structurées et d'un effort de raisonnement configurable. À l'indice d'Artificial Analysis, il marque 45 — un point d'écart avec les 46 de MiMo-V2.6-Pro — avec un Coding Index de 76 qui égale la tranche frontière. À 2 $ / 6 $ par million de tokens, il sous-cote plusieurs fois plusieurs fois le prix de tout flagship occidental sans aucune responsabilité d'hébergement de poids. L'annonce même de Xiaomi nomme Qwen3.8 Max comme l'un des deux modèles à poids ouverts que MiMo-V2.6-Pro a surpassés : la comparaison est écrite par le fabricant, pas inférée par nous.
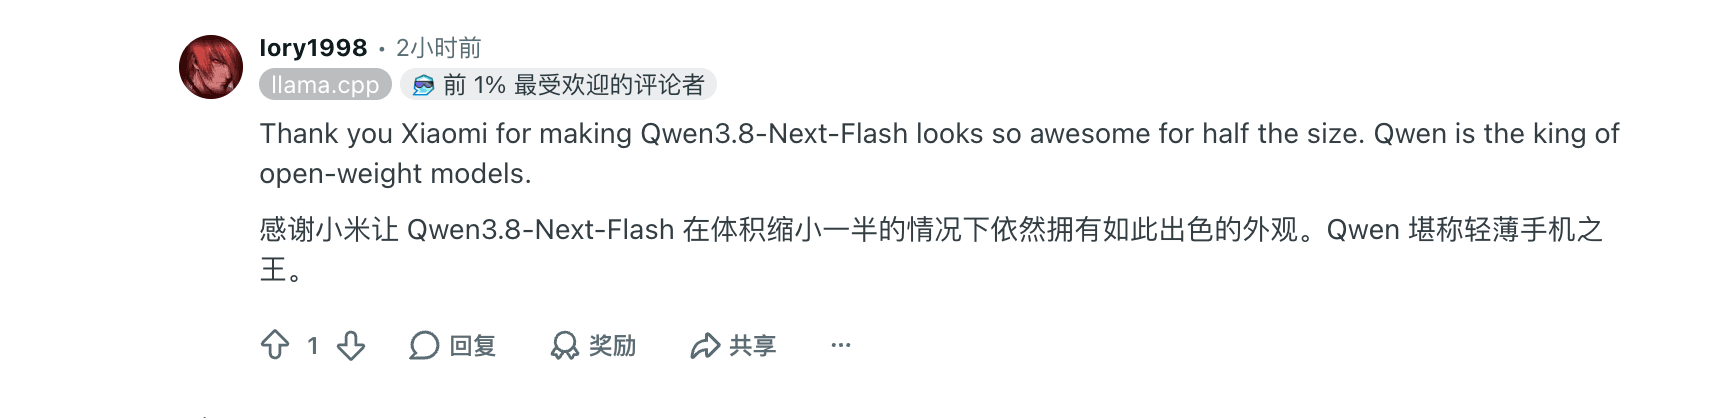
Inconvénients : les poids fermés mettent fin à la conversation pour l'auto-hébergement — pas de checkpoint, pas de fichier de licence, pas de plan B si Alibaba change les conditions d'accès. Les propres fans open-weights de Qwen préféreraient vous orienter vers les petits modèles : « Thank you Xiaomi for making Qwen3.8-Next-Flash looks so awesome for half the size. Qwen is the king of open-weight models », a écrit une habituée de r/LocalLLaMA le jour du lancement de MiMo — un compliment à la famille ouverte de Qwen qui rappelle que Max est l'exception fermée de la famille.
Tarifs : 2 $ d'entrée / 6 $ de sortie par million de tokens sur le listage OpenRouter de l'instantané 0902, vérifié le 22 septembre 2026. La page de prix propre d'Alibaba Cloud n'a pas rendu durant cette session ; vérifiez-la avant de contractualiser.
Verdict : choisissez Qwen3.8 Max quand vous voulez un flagship fermé, géré et multimodal et que les conditions de compte d'Alibaba conviennent à votre région et à votre conformité. Restez sur MiMo-V2.6-Pro quand les poids ouverts, la licence MIT ou la grille tarifaire plus basse pèsent — ou quand vos re-tests reproduisent le tableau de Xiaomi et favorisent le checkpoint le moins cher.
La page du modèle Qwen3.8 Max (English) suit les spécifications de l'instantané.
GLM-5.3
Idéal pour : la génération de code où la qualité de la solution compte plus que la vitesse ou le prix — avec le raisonnement toujours actif.
Avantages : GLM-5.3 est le modèle de raisonnement à grande échelle de Z.ai, construit pour l'ingénierie logicielle complexe et les tâches agentiques de longue haleine, avec des efforts low, high et max (max par défaut) et un contexte listé de 1,3M sur OpenRouter. Sur Artificial Analysis, il affiche 44,8 à l'Intelligence Index et — plus parlant — 53,1 à l'Agentic Index, un chiffre agentique d'élite. Le retour qualitatif est la partie intéressante : la même commentatrice de LocalLLaMA qui appelait la sortie de DeepSeek « hacky » louait GLM dans la même phrase : « GLM-5.3 implements clean solutions (develops an architecture and uses design patterns). » Sur le listage promotionnel d'OpenRouter, il s'affichait à 0,7826 $ / 2,46 $ par million de tokens — 44 % de réduction — se plaçant entre MiMo-V2.6-Pro et Kimi K3.
Inconvénients : le raisonnement ne peut pas être désactivé, donc pas de mode bon marché sans réflexion pour l'extraction ou la classification — chaque appel paie l'impôt de la réflexion. Le servir en local est un autre projet : « GLM 5.3 flash should already not be on there. Extremely expensive to run local », comme l'a dit un commentateur du fil de comparaison de MiMo. Et le site de documentation de Z.ai était inaccessible lors de cette session : le prix listé ne porte que la limite d'OpenRouter.
Tarifs : 0,7826 $ / 2,46 $ par million de tokens sur le listage à −44 % d'OpenRouter, vérifié le 22 septembre 2026 ; le prix de liste tourne autour de 1,40 $ / 4,39 $.
Verdict : choisissez GLM-5.3 quand la qualité de revue de code, le sens de l'architecture ou le chiffre agentique gagnent votre pilote et qu'un budget de réflexion permanente est acceptable. Choisissez MiMo-V2.6-Pro quand vous avez besoin d'une API commutable et compatible cache à moins de la moitié du prix de liste — ou Flash quand la facture domine.
La page du modèle GLM-5.3 (English) garde ses spécifications et ses notes de route.
Une troisième voie : exécuter la comparaison dans Tabbit
La plupart des projets de changement échouent sur la logistique, pas sur la qualité du modèle : ouvrir des clés d'API chez cinq fournisseurs, normaliser les sorties, comparer les résultats dans cinq onglets. Tabbit Browser attaque cette couche. Sa vue multi-modèles envoie un prompt à plusieurs modèles à la fois et dispose les réponses en colonnes qui se lisent comme une feuille de calcul, et le sélecteur de modèles de l'omnibox change le modèle actif par chat sans rien réauthentifier.
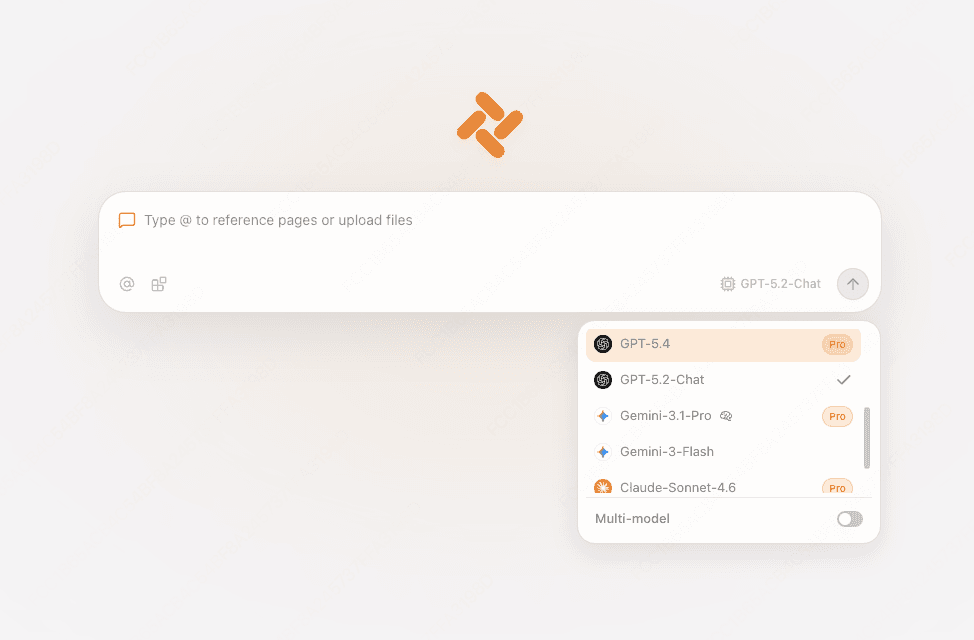
La boucle de pilote pratique : référencez la page ou le fichier qui vous importe avec @, cochez deux ou trois modèles candidats et comparez leurs réponses dans une seule vue — puis répétez sur les cinq tâches réelles que vous exécutez déjà. Un échantillon de niveau décisionnel en un après-midi, sans tableur de facturation. Pour ce que la navigation agentique ajoute à ce flux, lisez qu'est-ce qu'un navigateur agentique et la comparaison des navigateurs IA 2026.
Deux limites maintiennent l'honnêteté. D'abord, la disponibilité réelle des modèles dans Tabbit dépend du sélecteur actif de votre compte et des conditions de la plateforme — cet article ne prétend qu'aucun modèle précis, MiMo-V2.6-Pro inclus, soit intégré à tous les comptes, et Tabbit ne remplace pas votre relation de facturation externe. Ensuite, une comparaison dans le navigateur est un pilote, pas un benchmark : elle contrôle le prompt et la page, pas la comptabilité des tokens ni la variance. Servez-vous en pour la liste restreinte ; servez-vous du guide de prix pour le budget.
 Tabbit Browser
Exécutez le pilote à tâche identique
Quel que soit le candidat qui survit à la liste restreinte, testez-le pareil. Figez deux ou trois tâches réelles avec leurs entrées, instructions, outils, contrat de sortie et budget de réessais. Enregistrez les tokens, le temps jusqu'au premier token, le temps d'achèvement, les échecs d'outils et les corrections manuelles — puis calculez le coût par tâche accomplie, tokens de raisonnement compris puisqu'ils se facturent en sortie. Une exécution propre ne prouve rien sur les tarifs ni la fiabilité ; répétez jusqu'à ce que la variance cesse de surprendre. Un contexte ou une route d'outils changée est une différence de route, pas la preuve qu'un modèle est universellement meilleur.
Verdict : rester ou partir, selon le scénario
Il n'y a pas de grand vainqueur sur cette page, et les classements du jour de lancement ne survivront pas au mois. La décision suit votre contrainte :
| Contrainte principale | Premier pilote | Critère de réussite | Avertissement principal |
|---|---|---|---|
| Rogner la facture, garder le flux | MiMo-V2.6-Flash | Les mêmes tâches passent dans les deux tiers du budget de tokens | Moins de marge de raisonnement sur les tâches agentiques dures |
| Lot planifié le moins cher | DeepSeek V4.1 Flash | Acceptation hors pointe sous 0,20 $/1M mélangés | En pointe, tout double ; planifiez ou payez |
| Parité open-weights sans limite de prix | Kimi K3 | Les gains de la suite justifient 17× le coût | La prime achète un profil, pas une victoire assurée |
| Flagship fermé géré, multimodal | Qwen3.8 Max (0902) | Conformité et conditions de compte adaptées ; tâches passées | Pas de plan B auto-hébergé ; l'instantané tourne |
| Qualité de code avant vitesse | GLM-5.3 | Les scores de revue dépassent les rivaux sur vos dépôts réels | Raisonnement toujours actif ; pas de mode bon marché |
| Raisonnement compatible cache à 0,435 $/0,87 $ | Rester sur MiMo-V2.6-Pro | Le coût par tâche accomplie reste sous vos rivaux | Surveillez les niveaux d'effort ; la note grimpe avec la réflexion |
Si vous restez sur MiMo-V2.6-Pro, réglez les niveaux d'effort délibérément — les niveaux moyen et haut sont là où vit son appétit de tokens — et gardez les préfixes de prompts stables pour que la couche de cache à 0,0036 $ travaille.

Si vous partez, laissez la contrainte choisir la destination, pas le classement. Le guide de prix MiMo-V2.6-Pro et les alternatives à Gemini 3.8 Flash sont les lectures complémentaires pour une vision tarifaire et multi-familles complète.
Sources
Tous les faits, prix et citations de ce guide ont été vérifiés le 22 septembre 2026 :
Annonce de lancement Xiaomi MiMo-V2.6 et tarifs officiels de l'API
Listages OpenRouter : Kimi K3, GLM-5.3, Qwen3.8 Max (0902)
Publications communautaires selon les captures et liens dans le texte : X (@huanfeng9999), Reddit (r/DeepSeek, r/LocalLLaMA), Hacker News (éléments 49793293, 49794307, 49795049, 49795769)

Questions fréquentes
Quelle est l'alternative la plus proche de MiMo-V2.6-Pro ?
MiMo-V2.6-Flash est l'alternative de la même famille la plus proche : même fenêtre de contexte de 1M, même entrée omnimodale et même API pour un tiers du prix au token. Le rival open-weights d'un autre laboratoire est Kimi K3, mais son prix catalogue est plusieurs fois supérieur et son profil de benchmarks diffère.
Quelle alternative a le prix d'API affiché le plus bas ?
DeepSeek V4.1 Flash affiche les tarifs hors pointe les plus bas : 0,003 $ en réussite de cache, 0,15 $ en échec et 0,60 $ en sortie par million de tokens. MiMo-V2.6-Flash descend à 0,14 $ en entrée sans cache, et les deux familles se réduisent encore via l'API Batch ou la planification hors pointe. La route la moins chère dépend de votre taux de réussite de cache et de vos heures d'exécution.
Rester sur MiMo-V2.6-Pro est-il toujours un bon choix ?
Souvent, oui. Xiaomi le présente comme le premier modèle open-weights de l'Artificial Analysis Intelligence Index, à 0,435 $ d'entrée et 0,87 $ de sortie par million de tokens, et un test indépendant sur OpenCode lui a donné 23 réussites sur 23 pour environ trois cents. Restez si vos tâches sont gourmandes en raisonnement, vos prompts exploitent le cache et vous ne cherchez pas les derniers points des benchmarks agentiques.
Puis-je auto-héberger ces alternatives ?
MiMo-V2.6-Pro, MiMo-V2.6-Flash et Kimi K3 publient des poids ouverts, et la famille GLM de Z.ai a une tradition open source : le déploiement local est donc possible avec du matériel sérieux. Qwen3.8 Max est un modèle d'API à poids fermés et DeepSeek V4.1 Flash se consomme via l'API de DeepSeek. Vérifiez chaque licence et chaque checkpoint avant de planifier.
Dois-je migrer hors de MiMo-V2.5-Pro ?
Oui. Xiaomi documente que mimo-v2.5-pro et mimo-v2.5 seront retirés à 10 h 00 (heure de Pékin) le 21 octobre 2026. La série V2.6 conserve le même tarif d'API : la plupart des migrations sont un changement d'identifiant de modèle plus des re-tests, sans impact budgétaire.
MiMo-V2.6-Pro est-il disponible dans Tabbit Browser ?
La disponibilité réelle des modèles dans Tabbit dépend du sélecteur de modèles de votre compte et des conditions de la plateforme ; cet article ne promet aucun accès intégré. La vue multi-modèles de Tabbit permet de comparer côte à côte les modèles exposés par votre compte, un moyen concret de tester des alternatives sur de vraies pages.