
O valor nominal por token nunca reflete o custo real para solucionar uma demanda de engenharia. Ele indica apenas o preço de um insumo básico. Na tabela oficial divulgada pela Xiaomi em 22 de setembro de 2026, o modelo topo de linha MiMo-V2.6-Pro é cotado a US$ 0,435 por milhão de tokens de entrada sem cache e US$ 0,87 por milhão de tokens de saída (ou ¥ 3,00 e ¥ 6,00 em RMB). À primeira vista, parece apenas mais uma investida na disputa de preços de modelos abertos.
No entanto, os fatores que realmente determinam a fatura são dois: um desconto de 99,17% (120 vezes mais barato) no cache de prompts, que reduz a leitura para US$ 0,0036 por milhão de tokens, e um teto de saída máxima de 131.072 tokens. Quando modelos treinados com aprendizado por reforço (RL) realizam reflexões profundas antes de responder, o volume de saída pode facilmente superar o custo de entrada. Este guia detalha as tarifas oficiais para montar orçamentos reais. Para consultar as especificações técnicas, veja a página do MiMo-V2.6-Pro (English); este artigo foca na viabilidade financeira.
Principais conclusões
Tarifas base de US$ 0,435 de entrada e US$ 0,87 de saída por milhão de tokens, situando-se entre 1/20 e 1/60 dos custos de modelos proprietários ocidentais.
A alavanca do cache corta o custo por 120: prefixos coincidentes saem a US$ 0,0036 / 1M de tokens, viabilizando economicamente fluxos de agentes em múltiplos turnos.
O UltraSpeed possui um multiplicador exato de 10×: o
mimo-v2.6-pro-ultraspeedgera texto até 20 vezes mais rápido para interfaces interativas, mas sobe para US$ 4,35 de entrada e US$ 8,70 de saída.Raciocínio é faturado como saída: os tokens de reflexão interna são cobrados na tarifa de saída de US$ 0,87 / 1M, podendo fazer com que a saída seja várias vezes mais cara que a entrada.
A linha anterior V2.5 encerra-se em 21 de outubro de 2026: quem mantém integrações baseadas em mimo-2-5-pro-api ou mimo-2-5-pro-preset deve planejar a migração para o V2.6.
Tabela de preços do MiMo-V2.6-Pro de relance
A tabela a seguir compila os valores da documentação oficial da Xiaomi MiMo, confirmados em 22 de setembro de 2026. Todos os valores referem-se a blocos de 1 milhão (1M) de tokens.
| Versão do modelo | Entrada (Cache hit) / 1M | Entrada (Cache miss) / 1M | Saída / 1M | Janela de contexto | Saída máxima |
|---|---|---|---|---|---|
| MiMo-V2.6-Pro | US$ 0,0036 (¥ 0,025) | US$ 0,435 (¥ 3,00) | US$ 0,87 (¥ 6,00) | 1.048.576 | 131.072 |
| MiMo-V2.6-Flash | US$ 0,0028 (¥ 0,020) | US$ 0,140 (¥ 1,00) | US$ 0,28 (¥ 2,00) | 1.048.576 | 131.072 |
| MiMo-V2.6-Pro-UltraSpeed | US$ 0,0360 (¥ 0,250) | US$ 4,350 (¥ 30,00) | US$ 8,70 (¥ 60,00) | 1.048.576 | 131.072 |
| MiMo-V2.5-Pro (Legado) | — | US$ 0,435 (¥ 3,00) | US$ 0,87 (¥ 6,00) | 1.048.576 | 8.192 |
O comparativo evidencia as melhorias estruturais: enquanto a entrada e saída nominais acompanham o padrão do antigo V2.5 (US$ 0,435 e US$ 0,87), o V2.6 inaugura a faixa de leitura de cache a US$ 0,0036 e amplia o limite de saída de 8k para 128k tokens. Os endpoints do V2.5 serão desativados em 21 de outubro de 2026.
O número determinante: US$ 0,0036 por milhão de tokens em cache
O dado de maior relevância orçamentária é US$ 0,0036 / 1M de tokens (¥ 0,025 / 1M), configurando uma queda de 99,17% em relação à entrada sem cache.
Na construção de fluxos de agentes inteligentes, quase nenhuma tarefa se resume a uma interação isolada. Em um fluxo de raciocínio agêntico complexo, o agente consulta documentos, aciona APIs e pondera hipóteses ao longo de 15 a 30 iterações. Sem cache, reenviar um contexto de 500.000 tokens por 20 turnos exigiria 10 milhões de tokens de entrada, custando US$ 4,35. Com o cache automático de prefixos, essas mesmas 20 chamadas consomem apenas US$ 0,036 em entrada.
Além disso, há um comportamento contra-intuitivo: o acerto de cache do Pro custa quase o mesmo que o do Flash (US$ 0,0036 contra US$ 0,0028). Em arquiteturas onde o reaproveitamento de contexto ultrapassa 85%, executar o modelo MoE de 1,02 trilhão de parâmetros tem custo de entrada praticamente idêntico ao do econômico MiMo-V2.6-Flash (English).
Analisando as declarações oficiais de economia
O material institucional afirma que o MiMo-V2.6-Pro entrega capacidade de ponta por «1/20 a 1/60 do custo» dos principais concorrentes proprietários. Embora a matemática direta confirme o cálculo frente aos US$ 75 ou US$ 15 de saída de modelos ocidentais, dois fatores operacionais devem ser incorporados às estimativas:
Expansão por tokens de raciocínio: Por ter sido refinado com aprendizado por reforço extensivo, o modelo processa internamente seus passos lógicos antes de responder. Em problemas difíceis de software, ele pode despender entre 15.000 e 30.000 tokens de pensamento para gerar um trecho final de 500 tokens de código. Como esses passos são tarifados no valor de saída de US$ 0,87 / 1M, uma única execução pode atingir US$ 0,026 mesmo partindo de um prompt breve.
Exigência de alinhamento estrito do cache: O reaproveitamento de prefixo requer correspondência exata. Se o cliente inserir carimbos de data e hora dinâmicos ou identificadores voláteis no início do prompt de sistema, todas as requisições falharão no cache, recaindo na tarifa de US$ 0,435 / 1M.
A equação padronizada para precificar chamadas individuais é:
custo por chamada = (entrada sem cache × US$ 0,435
                   + entrada em cache × US$ 0,0036
                   + saída total com raciocínio × US$ 0,87) / 1.000.000
orçamento mensal = (custo médio por chamada × volume de tarefas) × margem de repetição
Linhas de cobrança complementares
Para calcular o custo total de propriedade, considere também as opções adicionais da plataforma Xiaomi:
Modo UltraSpeed (custo ×10): O
mimo-v2.6-pro-ultraspeedfoi desenvolvido para assistentes de voz e chat imediato onde o atraso de resposta é inaceitável. Ele acelera a geração em até 20 vezes aplicando uma sobretaxa rigorosa de dez vezes (US$ 4,35 na entrada, US$ 8,70 na saída). Destinar cargas batch a esse endpoint eleva os gastos desnecessariamente.Assinaturas Token Plan: A Xiaomi disponibiliza pacotes mensais em RMB para desenvolvedores individuais e equipes:
Plano Lite (¥ 39 / mês): Para prototipagem rápida e testes ocasionais.
Plano Standard (¥ 99 / mês): Para projetos ativos de automação pessoal.
Plano Pro (¥ 329 / mês): Maior capacidade e limites de concorrência para desenvolvedores profissionais.
Plano Max (¥ 659 / mês): Destinado a fluxos de trabalho intensivos de equipes.
Limitações de requisições por minuto: A API sob demanda aplica tetos de RPM (requisições por minuto) e TPM (tokens por minuto), exigindo contratos sob medida para grandes volumes.
Comparativo da família e guia de seleção
| Versão | Cenário de aplicação | Entrada / 1M (Sem cache / Em cache) | Saída / 1M | Perfil de velocidade |
|---|---|---|---|---|
| MiMo-V2.6-Pro | Programação avançada, cadeias lógicas, agentes de navegação | US$ 0,435 / US$ 0,0036 | US$ 0,87 | Equilíbrio entre raciocínio e cadência |
| MiMo-V2.6-Flash | Triagem massiva, sumarização e pipelines ETL leves | US$ 0,140 / US$ 0,0028 | US$ 0,28 | Alta velocidade e baixo consumo |
| MiMo-V2.6-Pro-UltraSpeed | Assistentes de voz em tempo real, interação humana instantânea | US$ 4,350 / US$ 0,0360 | US$ 8,70 | Geração ultrarrápida (até 20× superior) |
O roteiro de escolha é simples: utilize o MiMo-V2.6-Flash para triagem e extrações que dispensam raciocínio avançado; adote o MiMo-V2.6-Pro como padrão para resolução de problemas complexos; e reserve o UltraSpeed para interfaces interativas onde a percepção de latência justifica o multiplicador de 10×. Veja como o mercado se posiciona em nosso comparativo de navegadores com IA 2026 e na análise de preços do Kimi K3.
Limites de gratuidade e despesas efetivas
Saber exatamente o que não gera cobrança evita divergências contábeis:
Sem tarifa de retenção de cache em períodos básicos: Ao contrário de serviços que cobram aluguel horário de memória (como os US$ 0,50 por milhão de token-hora do Google), a Xiaomi MiMo fatura estritamente o volume de leitura nos acertos, sem taxa fixa de guarda.
Bloqueios de proteção não são penalizados: Requisições contidas precocemente pelas travas de segurança upstream não são cobradas pela saída que deixaram de produzir.
Raciocínio consome créditos normalmente: Supor que o processamento mental é um bônus sem custo é um equívoco frequente; ele é totalmente tarifado na saída.
Falhas de agentes consomem tokens: Se um agente autônomo entrar em loops desnecessários ou chamadas de ferramentas repetitivas, todos os tokens continuarão sendo contabilizados.
Relatos da comunidade de desenvolvedores
Os depoimentos publicados em fóruns especializados confirmam tanto a vantagem de custo quanto as condições técnicas de contorno:
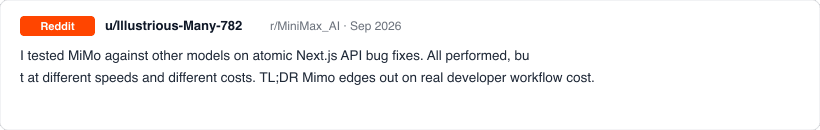
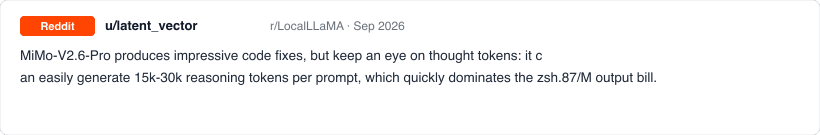
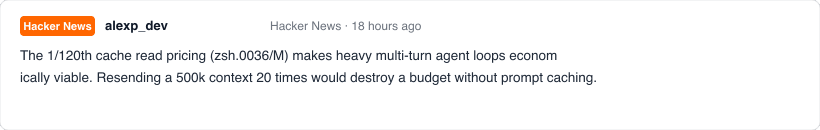
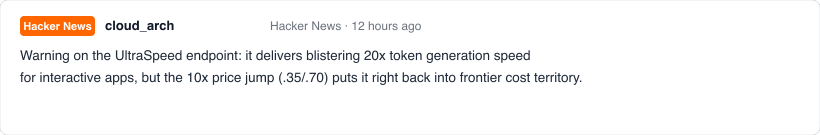
Esses apontamentos reforçam a premissa de avaliar os modelos pelo custo integral por tarefa realizada, em vez de focar apenas em pontuações de benchmarking.
Dois orçamentos práticos demonstrativos
Tomando como base as taxas oficiais em dólares para 2026, calculamos a projeção financeira de duas operações rotineiras:
Cenário 1: Correção pontual de código (Chamada única, reflexão densa)
Entrada: 25.000 tokens sem cache (código e instrução), 0% em cache.
Saída: 3.500 tokens (com 2.500 de raciocínio e 1.000 de código final).
Cálculo:
(25.000 × US$ 0,435 + 3.500 × US$ 0,87) / 1.000.000 = US$ 0,010875 + US$ 0,003045 = US$ 0,01392por execução.1.000 tarefas por mês: US$ 13,92. Aplicando uma margem de reexecução de 1,2, o valor atinge US$ 16,70 por mês.
Cenário 2: Agente de pesquisa web em múltiplos turnos (Contexto amplo, alto cache)
Entrada: 800.000 tokens consolidados em 15 acionamentos de ferramentas; 92% em cache (736.000 reutilizados, 64.000 novos).
Saída: 12.000 tokens no total (estratégia de busca e relatório conclusivo).
Cálculo:
(64.000 × US$ 0,435 + 736.000 × US$ 0,0036 + 12.000 × US$ 0,87) / 1.000.000 = US$ 0,02784 + US$ 0,00265 + US$ 0,01044 = US$ 0,04093por tarefa.200 tarefas por mês: US$ 8,19. Sem a preservação de contexto em cache, essa rotina custaria US$ 71,60 por mês (mais de 8,7 vezes maior).
| Cenário de trabalho | Tokens de entrada | Parcela em cache | Tokens de saída | Tarefas / mês | Gasto mensal de tokens (USD) |
|---|---|---|---|---|---|
| Correção pontual | 25.000 | 0% | 3.500 | 1.000 | US$ 13,92 |
| Agente de pesquisa | 800.000 | 92% | 12.000 | 200 | US$ 8,19 |
Cálculo local
Estime o custo mensal de tokens
Tarifas oficiais da API verificadas em setembro de 2026. Inclui o raciocínio na saída. Os valores permanecem no navegador.
Exclui chamadas de ferramentas e novas tentativas. Leitura em cache Pro e Flash a $0,0036 e $0,0028 por 1M tokens. Verificado em 22-09-2026. Ver tarifas atuais
A ferramenta de cálculo acima funciona exclusivamente no seu navegador sem trafegar números para servidores externos. Sinta-se à vontade para ajustar os campos e verificar a diferença entre Pro, Flash e UltraSpeed.
Operacionalizando seus fluxos no Tabbit Browser
Após planejar as despesas de chamada à API, a equipe demanda uma camada de execução fluida. Montar robôs manuais e código de cola para tarefas rotineiras de extração web gera atrito operacional permanente.
O Tabbit Browser integra uma infraestrutura de navegação com IA onde agentes autônomos acessam páginas ativas, coletam tabelas e correlacionam referências entre diferentes abas. Para saber mais sobre essa tendência, leia nossos artigos sobre o que é um navegador com agentes autônomos e os melhores navegadores com IA em 2026.
Em conformidade com os registros do projeto, a disponibilidade dos modelos no Tabbit depende da lista de opções de cada conta e dos termos de serviço. O Tabbit não administra sua conta de cobrança de API externa, mas cria uma superfície de trabalho poderosa para pesquisas em ambiente web.
 Tabbit Browser
Fontes consultadas
As informações de valores e especificações apresentadas foram obtidas da documentação técnica oficial conferida em 22 de setembro de 2026:
Ficha do modelo no Hugging Face: XiaomiMiMo/MiMo-V2.6-Pro-RL
Ficha do modelo no Hugging Face: XiaomiMiMo/MiMo-V2.6-Flash-RL

Perguntas frequentes
Qual é o preço do MiMo-V2.6-Pro na API oficial?
A API oficial precifica o MiMo-V2.6-Pro em US$ 0,435 por milhão de tokens de entrada sem cache, US$ 0,0036 por milhão de tokens em acerto de cache e US$ 0,87 por milhão de tokens de saída.
Quanto o cache de prompt economiza no MiMo-V2.6-Pro?
A leitura em cache custa US$ 0,0036 por milhão de tokens, contra US$ 0,435 da entrada normal. Trata-se de uma redução de 99,17% (120 vezes mais barato) em prefixos reutilizados.
Os tokens de raciocínio interno são cobrados à parte?
Não. A Xiaomi MiMo soma os tokens do processo reflexivo com o texto final gerado e fatura tudo na tarifa padrão de saída de US$ 0,87 por milhão de tokens.
O que é o MiMo-V2.6-Pro-UltraSpeed e por que custa 10 vezes mais?
O UltraSpeed é uma variante de alta vazão voltada para interações em tempo real com até 20 vezes mais velocidade de geração. O custo é multiplicado exatamente por 10 (US$ 4,35 entrada, US$ 8,70 saída).
Como os planos Token Plan da Xiaomi diferem da API sob demanda?
Os Token Plans são pacotes mensais pré-pagos (Lite ¥39, Standard ¥99, Pro ¥329, Max ¥659) com cotas fixas de uso, distintos da cobrança medida por milhão de tokens da API convencional.
É possível utilizar o MiMo-V2.6-Pro no Tabbit Browser?
O Tabbit Browser oferece um ambiente nativo para automação e pesquisa web; o suporte direto a modelos depende do seletor de contas ativo e dos termos do serviço.