
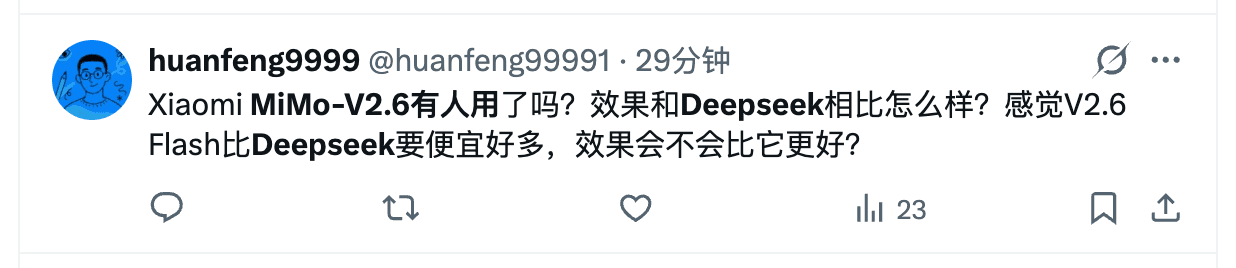
MiMo-V2.6-Pro merece quedarse en tu lista corta. Xiaomi lo lanzó y liberó el 22 de septiembre de 2026, y el flagship marca 46 en el Artificial Analysis Intelligence Index — el más alto entre los modelos de pesos abiertos en ese momento — con precio oficial de 0,435 $ por millón de tokens de entrada y 0,87 $ de salida. La prueba independiente en OpenCode de Kingy AI del día anterior le dio 23 de 23 comprobaciones ocultas de código por unos 0,03 $ por ejecución, igualando la precisión de Claude Opus 5 a una trigésima quinta parte del coste. El mismo día del lanzamiento, una pregunta en X resumió toda la comparación en una frase: "Has anyone used Xiaomi MiMo-V2.6? How does it compare to DeepSeek? V2.6 Flash looks much cheaper than DeepSeek — could it actually be better?"
La razón para mirar más allá viene de la propia Xiaomi. El anuncio dice literalmente: "However, there is still a gap when compared with the strongest closed-source models Claude Fable 5.1 and GPT-6 Astra." Que un proveedor te diga que su nuevo flagship aún no alcanza la frontera cerrada es tan raro que conviene creérselo — en ese mismo índice, Fable 5.1 y GPT-6 Astra se sitúan en 53, siete puntos por encima de MiMo-V2.6-Pro, y Claude Opus 5 con esfuerzo máximo llega a 51 a 5,86 $ por tarea del índice frente a unos 0,13 $ de MiMo.
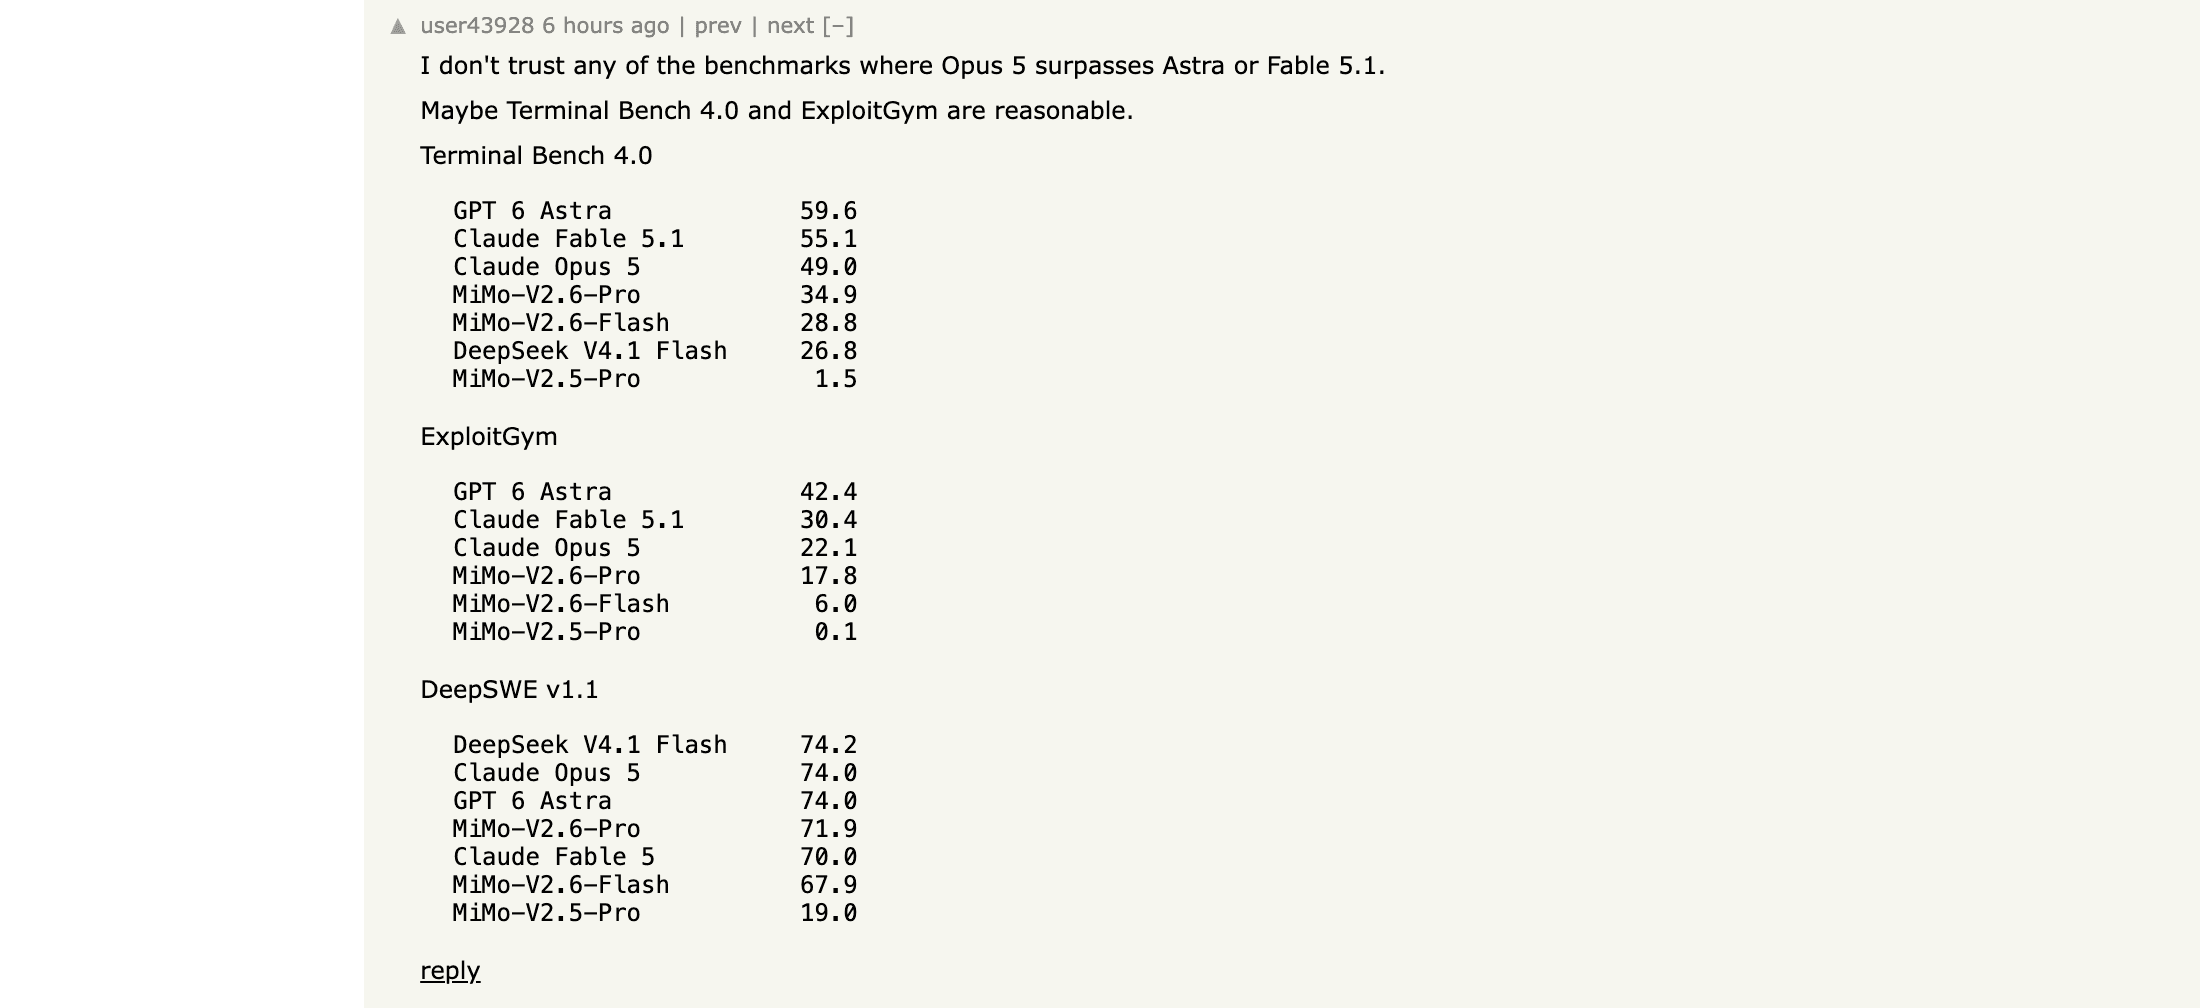
Esos siete puntos esconden dos costes medibles. En Terminal Bench 4.0 — un benchmark agéntico que maneja la terminal — la propia tabla de Xiaomi asigna a MiMo-V2.6-Pro un 34,9 frente al 49,0 de Claude Opus 5 y el 59,6 de GPT-6 Astra. Y el razonamiento que sostiene la puntuación aparece en tu factura: un tester de Hacker News solo pudo completar las pruebas en los ajustes de menor esfuerzo porque "the other ones (medium/high) used way too many tokens and all requests timed out." No es una acusación de debilidad. Es la constatación de que "el flagship open-weights más barato" esconde dos costes reales — una brecha agéntica y una cuenta de tokens que crece con el pensamiento — y ambos tienen alternativas concretas.
Si tu frustración no es el modelo sino la fontanería alrededor — gestionar claves de API, comparar precios y pelear con cinco pestañas — la última sección ofrece una tercera vía: ejecutar la comparación dentro de Tabbit Browser. Primero, los candidatos.
Conclusiones clave
MiMo-V2.6-Flash es la primera alternativa que debes probar: mismo contexto de 1M, misma entrada omnimodal y misma API a 0,14 $/0,28 $ por millón de tokens, con el aval del propio fabricante: "superó de forma completa a MiMo-V2.5-Pro".
DeepSeek V4.1 Flash es la jugada de programación: fuera de hora punta, 0,15 $ de entrada y 0,60 $ de salida son difíciles de batir, y lidera la tabla compartida de DeepSWE v1.1 con 74,2.
Kimi K3 es el rival premium de pesos abiertos: un modelo de razonamiento de 2,8T de parámetros que cuesta unas 17 veces más por tarea de evaluación, y compra otro perfil de benchmark, no una victoria clara.
Qwen3.8 Max (0902) es el flagship cerrado equivalente a 2 $/6 $ por millón de tokens — la ruta para equipos que quieren el tope de Alibaba sin operaciones de pesos abiertos.
GLM-5.3 es el razonador siempre activo para calidad de código: la comunidad elogia sus "soluciones limpias", a precio promocional de 0,78 $/2,46 $ en OpenRouter.
Trata cada benchmark aquí como reportado por el fabricante o indexado por terceros, y cada comentario de la comunidad como la experiencia de una persona. Las puntuaciones de la semana de lanzamiento se mueven.
Cómo elegí estas alternativas
Cuatro criterios, aplicados en orden:
Coste por tarea completada, no precio de etiqueta. Un modelo a mitad de precio que piensa el triple no es barato. Cada candidato se precio en su ruta oficial o listada, anotando caché, horas punta y descuentos por lotes.
Fiabilidad agéntica en trabajo real. El índice de Artificial Analysis ordena bien el club open-weights, pero Terminal Bench 4.0, ExploitGym y DeepSWE v1.1 muestran lo que el índice esconde. Los candidatos debían aportar evidencia de al menos uno.
Pesos abiertos y encaje de despliegue. El autoalojamiento cambia residencia de datos, estructura de costes y dependencia. Cada candidato se marca como abierto o cerrado: esa sola línea decide la mitad de la migración.
Evidencia comunitaria con nombre y apellidos. Las preferencias y modos de fallo vienen de publicaciones concretas en HN, Reddit y X — no de notas de prensa.
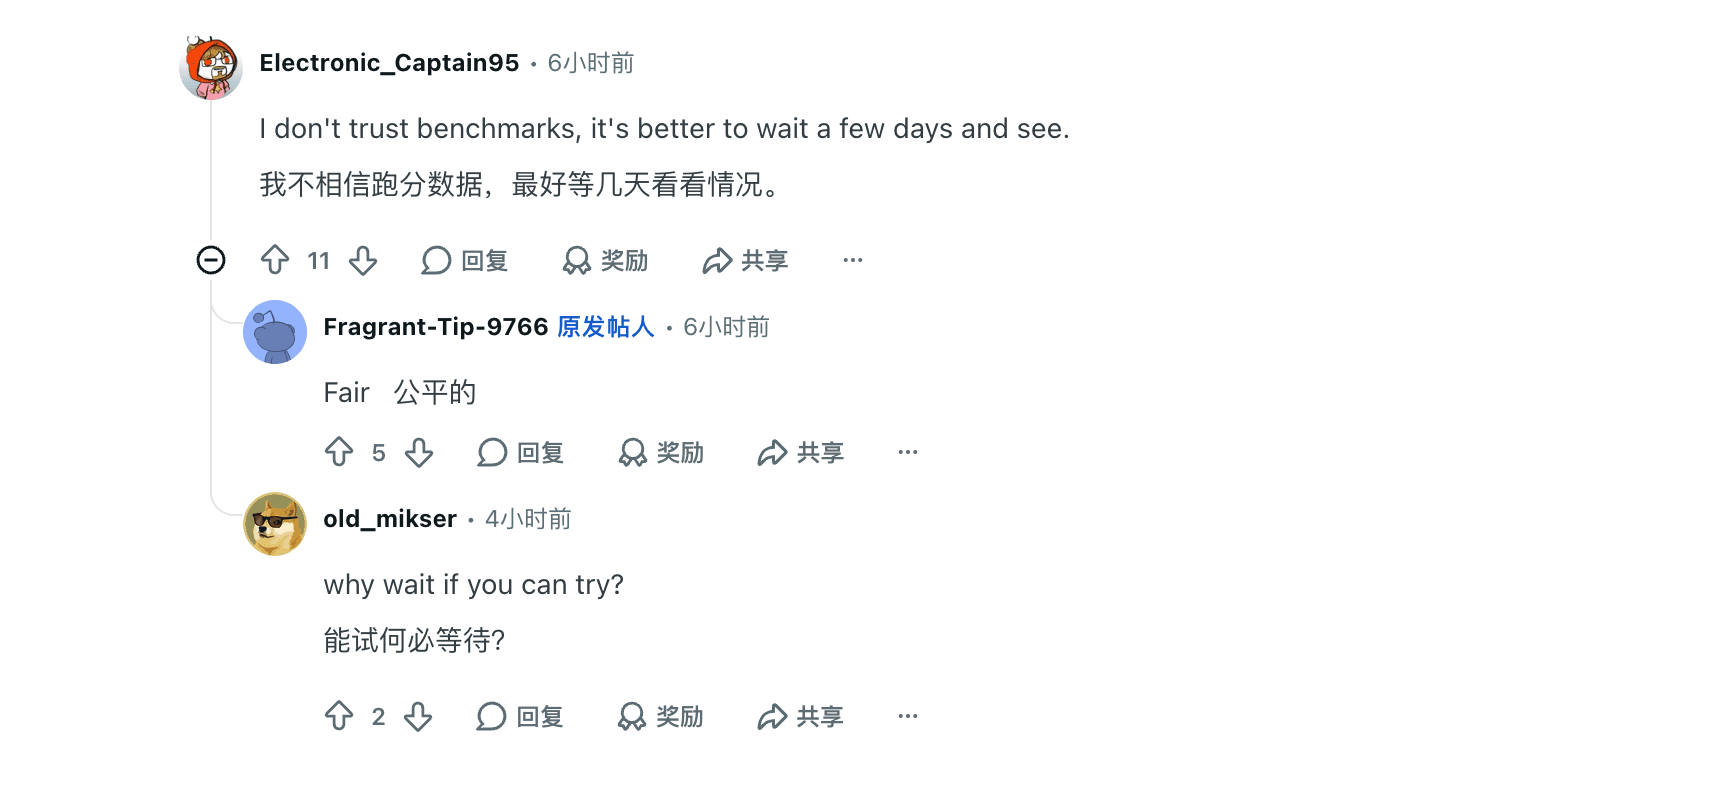
Las capturas son publicaciones originales capturadas el 22 de septiembre de 2026. Sobre un hilo que evaluaba adoptar MiMo para código, una usuaria de Reddit lo resumió: "I don't trust benchmarks, it's better to wait a few days and see."
Los cinco candidatos de un vistazo
| Candidato | Mejor para | Ruta publicada | Precio por 1M (verificado 22-09-2026) | El principal problema |
|---|---|---|---|---|
| MiMo-V2.6-Flash | Recorte de coste en la misma familia | mimo-v2.6-flash; contexto 1M / salida 131K; pesos abiertos | 0,14 $ entrada / 0,0028 $ acierto de caché / 0,28 $ salida | Menos margen de razonamiento que Pro en tareas agénticas duras |
| DeepSeek V4.1 Flash | Lotes programados y presupuestos fuera de punta | deepseek-flash; 1M / 384K; solo API | Fuera de punta 0,15 $ / 0,60 $; punta 0,30 $ / 1,20 $; acierto de caché 0,003–0,006 $ | Las horas punta (01:00–04:00 y 06:00–10:00 UTC entre semana) duplican entrada y salida |
| Kimi K3 | Razonamiento premium de pesos abiertos y agentes de largo alcance | kimi-k3; contexto 1,0M; pesos abiertos | OpenRouter lista 1,50 $ / 7,50 $ (50 % dto.; lista 3 $ / 15 $) | Unas 17 veces el coste de evaluación de MiMo por 2 puntos menos en el índice |
| Qwen3.8 Max (0902) | Flagship cerrado de Alibaba con entrada multimodal | qwen3.8-max-0902; contexto 1,0M | 2 $ / 6 $ | Pesos cerrados — sin autoalojamiento ni plan B a nivel de pesos |
| GLM-5.3 | Razonamiento siempre activo para calidad de código | glm-5.3; contexto listado 1,3M | OpenRouter lista 0,78 $ / 2,46 $ (44 % dto.) | El razonamiento no se puede desactivar; servirlo en local es caro |
Fuentes: precios de Xiaomi MiMo (actualizado el 21 de septiembre de 2026), precios de DeepSeek y los listados de OpenRouter para Kimi K3, GLM-5.3 y Qwen3.8 Max. Los precios de salida incluyen tokens de razonamiento. Los precios de OpenRouter llevan insignias de promoción del día; las páginas de precios propias de Moonshot y Alibaba no estuvieron accesibles en esta sesión, así que sus listados de OpenRouter hacen de sustituto con esa advertencia.
Las matemáticas completas de la familia MiMo — caché, UltraSpeed, Batch API — están en nuestra guía de precios de MiMo-V2.6-Pro. Esta página se queda en la decisión de quedarse o cambiar.
MiMo-V2.6-Flash
Mejor para: recortar dos tercios de la factura sin salir de la API, la ventana de contexto ni los tipos de entrada de Xiaomi.
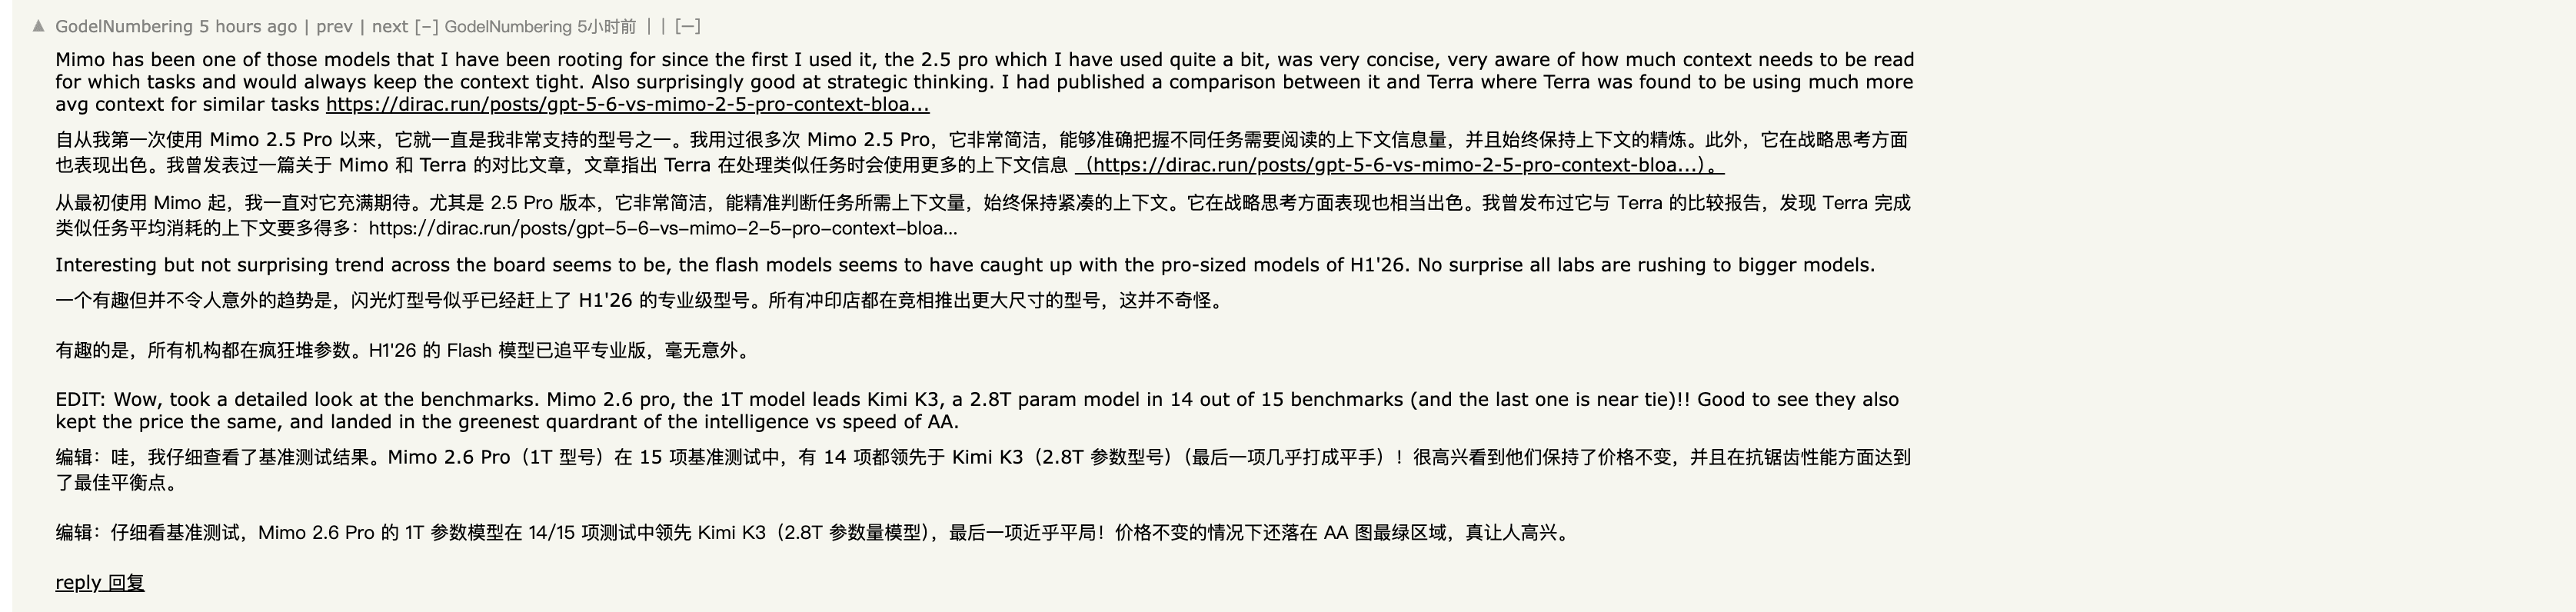
Pros: Flash comparte el contexto de 1.048.576 tokens, el techo de salida de 131.072 y la entrada multimodal nativa de Pro, a 0,14 $ de entrada y 0,28 $ de salida por millón de tokens — y 0,07 $/0,14 $ vía Batch API. Es el único candidato de la lista cuyo respaldo de mejora viene del propio anuncio del fabricante: "MiMo-V2.6-Flash has comprehensively outperformed MiMo-V2.5-Pro." En la tabla agéntica compartida de Xiaomi marca 28,8 en Terminal Bench 4.0 — por encima del 26,8 de DeepSeek V4.1 Flash — y la prueba independiente de Kingy en OpenCode le dio 21 de 23 en una ruta gratuita, dos comprobaciones menos que su hermano mayor. Un comentarista de Hacker News que sigue a la familia desde V2.5 lo resumió: "the 2.5 pro… was very concise, very aware of how much context needs to be read for which tasks and would always keep the context tight," añadiendo en una edición que "Mimo 2.6 pro, the 1T model leads Kimi K3, a 2.8T param model in 14 out of 15 benchmarks (and the last one is near tie)!!"
Contras: es el modelo pequeño. Con 309B de parámetros totales / 15B activados frente a los 1,02T / 42B de Pro, el razonamiento profundo multi-paso tiene menos margen — la misma prueba de OpenCode le restó dos comprobaciones, y en ExploitGym marca 6,0 frente al 17,8 de Pro. Si tu carga vive de la profundidad de razonamiento de Pro, Flash es un falso ahorro.
Precios: 0,14 $ entrada / 0,0028 $ acierto de caché / 0,28 $ salida por millón de tokens; la mitad otra vez vía Batch API; el multiplicador de 10× de UltraSpeed es solo de Pro. Ejemplos resueltos en la tarjeta de tarifas familiar.
Veredicto: si tu queja sobre MiMo-V2.6-Pro es la factura y no el techo, prueba Flash primero — es la respuesta barata del propio fabricante. Si tu queja es la calidad en tareas agénticas duras, Flash no lo arregla; mira DeepSeek o Kimi K3.
La página del modelo MiMo-V2.6-Flash (English) guarda sus especificaciones junto a las notas de migración.
DeepSeek V4.1 Flash
Mejor para: cargas de alto volumen que pueden ejecutarse fuera de hora punta y equipos que quieren una API de 1M de contexto, con visión, a precios de saldo.
Pros: la página de precios actual de DeepSeek lista deepseek-flash (DeepSeek-V4.1-Flash) con modos de pensamiento y no-pensamiento, 1M de contexto, 384K de salida máxima, visión, salida JSON, llamadas a herramientas y endpoints compatibles con OpenAI y Anthropic. Fuera de punta, la entrada cuesta 0,15 $ y la salida 0,60 $ por millón de tokens — con caché caliente, los prefijos repetidos se facturan a 0,003 $. En los benchmarks agénticos que publicó Xiaomi, DeepSeek V4.1 Flash marca 74,2 en DeepSWE v1.1, la cifra más alta de la tabla compartida, por delante de Claude Opus 5 y GPT-6 Astra (74,0) y de MiMo-V2.6-Pro (71,9). La concurrencia documentada es de 2.500, el nivel más alto de la página.
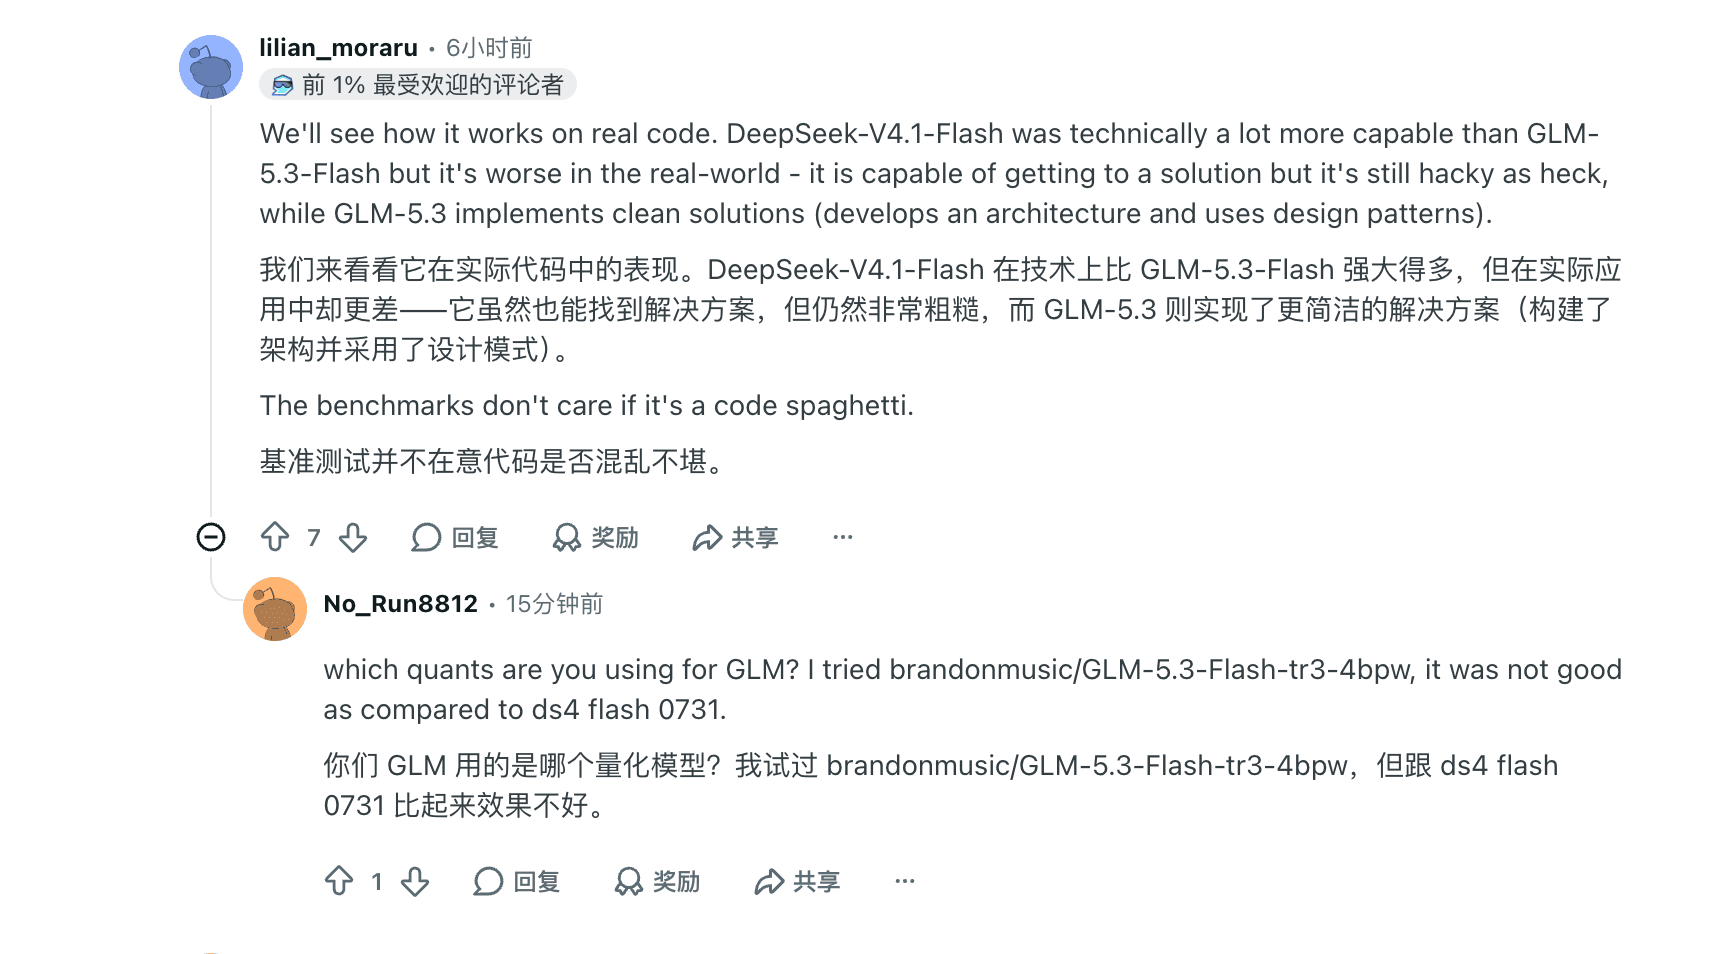
Contras: el horario. Las horas punta — 01:00–04:00 y 06:00–10:00 UTC de lunes a viernes, salvo festivos chinos — duplican exactamente todas las tarifas, y un fallo de caché en punta cuesta 0,30 $ por millón. La calidad del código en el mundo real divide a la comunidad: en un hilo de LocalLLaMA sobre modelos abiertos pequeños, una comentarista veterana argumentó que "DeepSeek-V4.1-Flash was technically a lot more capable than GLM-5.3-Flash but it's worse in the real-world - it is capable of getting to a solution but it's still hacky as heck". DeepSeek también se reserva el derecho a cambiar precios: cita su página, no este artículo, al presupuestar.
Precios: fuera de punta 0,003 $ acierto de caché / 0,15 $ fallo / 0,60 $ salida; en punta 0,006 $ / 0,30 $ / 1,20 $ por millón de tokens. La tarifa fuera de punta es exactamente la mitad.
Veredicto: elige DeepSeek cuando tu carga sea programable — enriquecimiento por lotes, resúmenes nocturnos, agentes programados — y tus pruebas de aceptación pasen con sus salidas. Quédate con MiMo-V2.6-Pro cuando necesites latencia interactiva en hora punta a precios estables, o cuando su razonamiento más profundo gane en tu propio conjunto de tareas.
La página del modelo DeepSeek V4.1 Flash (English) y nuestro análisis de precios de DeepSeek V4 Flash cubren el horario en detalle.
Kimi K3
Mejor para: equipos ya invertidos en el ecosistema de Moonshot que quieren la alternativa de pesos abiertos más fuerte fuera de Xiaomi — y pueden pagarla.
Pros: Kimi K3 es un modelo de razonamiento multimodal de pesos abiertos con 2,8T de parámetros, ventana de contexto de 1,0M y arquitectura KDA con residuos de atención, listado en OpenRouter a 1,50 $ de entrada / 7,50 $ de salida por millón de tokens con una promoción del 50 % (lista: 3 $ / 15 $). En Artificial Analysis sigue siendo un modelo abierto de élite: 43,6 en el Intelligence Index con esfuerzo máximo, 76,2 en el Coding Index y 50,0 en el Agentic Index — esa cifra agéntica supera el equivalente de MiMo-V2.6-Pro en varios suites compartidos. Para trabajo de repositorio a largo alcance conserva una base de fans genuina.
Contras: la matemática precio-índice es brutal este mes. Un análisis de OrcaRouter midió el coste de ejecutar el mismo suite de evaluación en 3.658,07 $ para Kimi K3 frente a 206,66 $ para MiMo-V2.6-Pro — un factor de diecisiete — con 44 puntos de K3 frente a 46 de MiMo. Y el bombo tiene críticos: "the 'best' models available from chinese labs right now (GLM 5.3 and Kimi K3) fall apart completely when you try to do real work with them. K3 is especially embarrassing…", argumentó un comentarista de Hacker News el día del lanzamiento. Es una opinión fuerte sin detalles de prueba publicados — no pudimos verificarla — pero recuerda que la prima de K3 compra otro perfil, no una victoria garantizada.

Precios: 1,50 $ / 7,50 $ por millón de tokens en el listado promocionado de OpenRouter el 22 de septiembre de 2026; el precio de lista es 3 $ / 15 $. La página de precios de Moonshot no estuvo accesible durante esta investigación; verifícala antes de comprometer presupuestos.
Veredicto: elige Kimi K3 cuando un pipeline K existente, sus fortalezas agénticas específicas o su perfil multimodal ganen tu suite de tareas y el presupuesto esté aprobado. Elige MiMo-V2.6-Pro cuando el rendimiento en el mismo índice pese más que el nombre del laboratorio — la brecha de diecisiete veces es toda la decisión.
Nuestra guía de precios de Kimi K3 y la página del modelo Kimi K3 (English) cubren la estructura de tarifas y especificaciones.
Qwen3.8 Max (0902)
Mejor para: equipos que quieren el flagship cerrado de Alibaba — entrada multimodal, razonamiento por defecto, contexto de 1M — como API gestionada sin operaciones de pesos abiertos.
Pros: la instantánea 0902 de Qwen3.8 Max es un modelo de mezcla de expertos de 2,4T de parámetros que acepta texto, imagen y vídeo, con ventana de contexto de 1,0M y soporte de llamadas a herramientas, salidas estructuradas y esfuerzo de razonamiento configurable. En el índice de Artificial Analysis marca 45 — un punto de diferencia con los 46 de MiMo-V2.6-Pro — con un Coding Index de 76 que iguala la franja fronteriza. A 2 $ / 6 $ por millón de tokens recorta varias veces el precio de cualquier flagship occidental sin responsabilidad alguna de alojamiento de pesos. El propio anuncio de Xiaomi nombra a Qwen3.8 Max como uno de los dos modelos de pesos abiertos que MiMo-V2.6-Pro superó: la comparación está escrita por el fabricante, no inferida por nosotros.
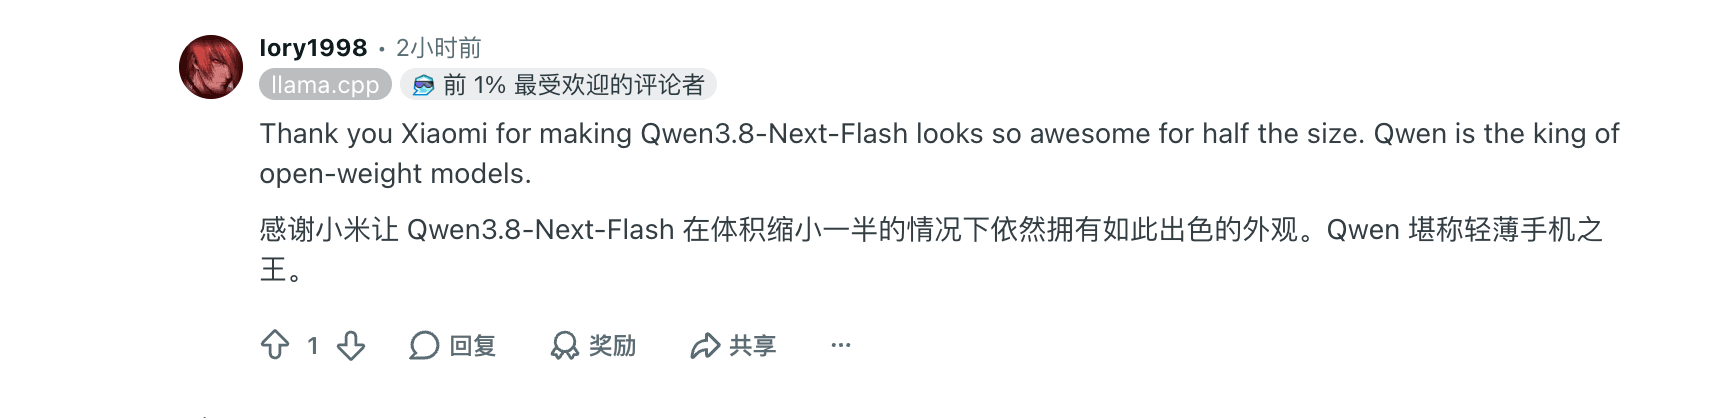
Contras: los pesos cerrados acaban la conversación para el autoalojamiento — no hay checkpoint, ni archivo de licencia, ni plan B si Alibaba cambia los términos de acceso. Los propios fans open-weights de Qwen prefieren mandarte a los modelos pequeños: "Thank you Xiaomi for making Qwen3.8-Next-Flash looks so awesome for half the size. Qwen is the king of open-weight models," escribió un habitual de r/LocalLLaMA el día del lanzamiento de MiMo — un cumplido a la familia abierta de Qwen que recuerda que Max es la excepción cerrada de la familia.
Precios: 2 $ de entrada / 6 $ de salida por millón de tokens en el listado de OpenRouter para la instantánea 0902, verificado el 22 de septiembre de 2026. La página de precios propia de Alibaba Cloud no renderizó en esta sesión; verifícala antes de contratar.
Veredicto: elige Qwen3.8 Max cuando quieras un flagship cerrado, gestionado y multimodal y los términos de cuenta de Alibaba encajen con tu región y cumplimiento. Quédate con MiMo-V2.6-Pro cuando pesen los pesos abiertos, la licencia MIT o la tarifa más baja — o cuando tus re-pruebas repliquen la tabla de Xiaomi y favorezcan el checkpoint más barato.
La página del modelo Qwen3.8 Max (English) sigue las especificaciones de la instantánea.
GLM-5.3
Mejor para: generación de código donde la calidad de la solución importa más que la velocidad o el precio — con razonamiento siempre activo.
Pros: GLM-5.3 es el modelo de razonamiento a gran escala de Z.ai, construido para ingeniería de software compleja y tareas agénticas de largo alcance, con esfuerzos low, high y max (máximo por defecto) y un contexto listado de 1,3M en OpenRouter. En Artificial Analysis marca 44,8 en el Intelligence Index y — más revelador — 53,1 en el Agentic Index, una cifra agéntica de élite. El feedback cualitativo es lo interesante: la misma comentarista de LocalLLaMA que llamó "hacky" a la salida de DeepSeek elogió a GLM en la misma frase: "GLM-5.3 implements clean solutions (develops an architecture and uses design patterns)." En el listado promocionado de OpenRouter salió a 0,7826 $ / 2,46 $ por millón de tokens — 44 % de descuento — encajando entre MiMo-V2.6-Pro y Kimi K3.
Contras: el razonamiento no se puede desactivar, así que no hay modo barato sin pensamiento para extracción o clasificación — cada llamada paga el impuesto de pensar. Servirlo en local es otro proyecto: "GLM 5.3 flash should already not be on there. Extremely expensive to run local," como dijo un comentarista del hilo de comparación de MiMo. Y el sitio de documentación de Z.ai no estuvo accesible en esta sesión, así que el precio listado solo tiene la frontera de OpenRouter.
Precios: 0,7826 $ / 2,46 $ por millón de tokens en el listado con 44 % de descuento de OpenRouter, verificado el 22 de septiembre de 2026; el precio de lista ronda 1,40 $ / 4,39 $.
Veredicto: elige GLM-5.3 cuando la calidad de revisión de código, el sentido arquitectónico o la cifra agéntica ganen tu piloto y un presupuesto de razonamiento permanente sea aceptable. Elige MiMo-V2.6-Pro cuando necesites una API conmutable y cacheable a menos de la mitad del precio de lista — o Flash cuando la factura domine.
La página del modelo GLM-5.3 (English) guarda sus especificaciones y notas de ruta.
Una tercera vía: ejecuta la comparación dentro de Tabbit
La mayoría de los proyectos de cambio fallan por logística, no por calidad del modelo: abrir claves de API de cinco proveedores, normalizar salidas y comparar resultados en cinco pestañas. Tabbit Browser ataca esa capa. Su vista multi-modelo envía un prompt a varios modelos a la vez y coloca las respuestas en columnas que se leen como una hoja de cálculo, y el selector de modelos del omnibox cambia el modelo activo por chat sin re-autenticar nada.
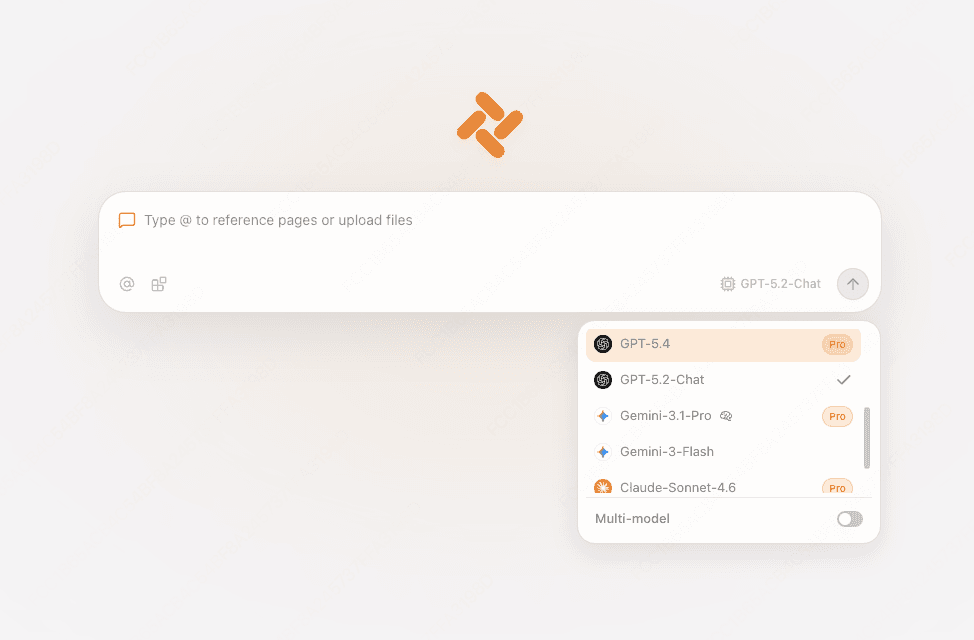
El bucle práctico de piloto: referencia la página o archivo que te importa con @, marca dos o tres modelos candidatos y compara sus respuestas en una vista — luego repite en las cinco tareas reales que ya ejecutas. Es una muestra de nivel decisorio en una tarde, sin hojas de facturación. Para saber qué añade la navegación agéntica a este flujo, lee qué es un navegador agéntico y la comparación de navegadores IA 2026.
Dos límites mantienen la honestidad. Primero, la disponibilidad real de modelos en Tabbit depende del selector activo de tu cuenta y de los términos de la plataforma — este artículo no afirma que ningún modelo concreto, incluido MiMo-V2.6-Pro, venga integrado en todas las cuentas, y Tabbit no sustituye tu relación de facturación externa. Segundo, una comparación en el navegador es un piloto, no un benchmark: controla prompt y página, no contabilidad de tokens ni varianza. Úsala para la lista corta; usa la guía de precios para el presupuesto.
 Tabbit Browser
Ejecuta el piloto de misma tarea
El candidato que sobreviva a la lista corta, pruébalo igual. Congela dos o tres tareas reales con sus entradas, instrucciones, herramientas, contrato de salida y presupuesto de reintentos. Registra tokens, tiempo hasta el primer token, tiempo de finalización, fallos de herramientas y correcciones manuales — y calcula el coste por tarea completada, incluidos los tokens de razonamiento que facturan como salida. Una ejecución limpia no prueba nada sobre tarifas ni fiabilidad; repite hasta que la varianza deje de sorprenderte. Cambiar el contexto o la ruta de herramientas es una diferencia de ruta, no prueba de que un modelo sea universalmente mejor.
Veredicto: quedarse o cambiar, según el escenario
No hay ganador global en esta página, y las tablas del día de lanzamiento no sobrevivirán al mes. La decisión sigue a tu restricción:
| Restricción principal | Primer piloto | Criterio de éxito | Advertencia principal |
|---|---|---|---|
| Recortar la factura, mantener el flujo | MiMo-V2.6-Flash | Las mismas tareas pasan con dos tercios del presupuesto de tokens | Menos margen de razonamiento en tareas agénticas duras |
| Lote programado más barato | DeepSeek V4.1 Flash | Aceptación fuera de punta por debajo de 0,20 $/1M mezclados | En punta se duplica; programa o paga |
| Paridad open-weights sin límite de precio | Kimi K3 | Las ganancias del suite justifican 17× el coste | La prima compra un perfil, no una victoria segura |
| Flagship cerrado gestionado, multimodal | Qwen3.8 Max (0902) | Cumplimiento y términos de cuenta encajan; tareas pasan | Sin plan B autoalojado; la instantánea rota |
| Calidad de código sobre velocidad | GLM-5.3 | Puntuaciones de revisión superan a rivales en tus repos | Razonamiento siempre activo; sin modo barato |
| Razonamiento cache-friendly a 0,435 $/0,87 $ | Quédate con MiMo-V2.6-Pro | El coste por tarea completada queda bajo tus rivales | Vigila los niveles de esfuerzo; la cuenta crece con el pensamiento |
Si te quedas con MiMo-V2.6-Pro, ajusta los niveles de esfuerzo a propósito — los niveles medio y alto son donde vive su apetito de tokens — y mantén los prefijos de prompt estables para que la capa de caché de 0,0036 $ trabaje.

Si cambias, deja que la restricción elija el destino, no la tabla de líderes. Y en cualquier dirección, la guía de precios de MiMo-V2.6-Pro y las alternativas a Gemini 3.8 Flash son las lecturas complementarias para la imagen completa de tarifas y familias.
Fuentes
Todos los hechos, precios y citas de esta guía fueron verificados el 22 de septiembre de 2026:
Anuncio de lanzamiento de Xiaomi MiMo-V2.6 y precios oficiales de la API
Listados de OpenRouter: Kimi K3, GLM-5.3, Qwen3.8 Max (0902)
Publicaciones comunitarias según las capturas y enlaces en el texto: X (@huanfeng9999), Reddit (r/DeepSeek, r/LocalLLaMA), Hacker News (elementos 49793293, 49794307, 49795049, 49795769)

Preguntas frecuentes
¿Cuál es la alternativa más cercana a MiMo-V2.6-Pro?
MiMo-V2.6-Flash es la alternativa de la misma familia más cercana: comparte la ventana de contexto de 1M, la entrada omnimodal y la misma API a un tercio del precio por token. El rival de pesos abiertos de otro laboratorio es Kimi K3, pero su precio de lista es varias veces mayor y su perfil de benchmarks difiere.
¿Qué alternativa tiene el precio de API más bajo?
DeepSeek V4.1 Flash ofrece las tarifas fuera de hora punta más bajas: 0,003 $ en acierto de caché, 0,15 $ en fallo y 0,60 $ de salida por millón de tokens. MiMo-V2.6-Flash baja a 0,14 $ en entrada sin caché, y ambas familias abaratan más con Batch API o programación fuera de punta. La ruta más barata depende de tu tasa de acierto de caché y de las horas en que ejecutes.
¿Sigue siendo buena idea quedarse con MiMo-V2.6-Pro?
A menudo sí. Xiaomi lo presenta como el modelo de pesos abiertos mejor situado en el Artificial Analysis Intelligence Index, a 0,435 $ de entrada y 0,87 $ de salida por millón de tokens, y una prueba independiente en OpenCode le dio 23 de 23 aciertos por unos tres céntimos. Quédate si tus tareas son de razonamiento intenso, tus prompts aprovechan la caché y no necesitas los últimos puntos de los benchmarks agénticos.
¿Puedo autoalojar estas alternativas?
MiMo-V2.6-Pro, MiMo-V2.6-Flash y Kimi K3 publican pesos abiertos, y la familia GLM de Z.ai tiene tradición open source, así que el despliegue local es viable con hardware serio. Qwen3.8 Max es un modelo de API con pesos cerrados, y DeepSeek V4.1 Flash se consume vía API de DeepSeek. Verifica cada licencia y checkpoint antes de planificar el despliegue.
¿Tengo que migrar fuera de MiMo-V2.5-Pro?
Sí. Xiaomi documenta que mimo-v2.5-pro y mimo-v2.5 se retirarán a las 10:00 (hora de Pekín) del 21 de octubre de 2026. La serie V2.6 mantiene el mismo precio de API, así que la mayoría de las migraciones son un cambio de ID de modelo más re-pruebas, sin cambio de presupuesto.
¿Está MiMo-V2.6-Pro disponible en Tabbit Browser?
La disponibilidad real de modelos en Tabbit depende del selector de modelos de tu cuenta y de los términos de la plataforma, así que este artículo no afirma acceso integrado. La vista multi-modelo de Tabbit te permite comparar lado a lado los modelos que tu cuenta exponga, una forma práctica de pilotar alternativas sobre páginas reales.