
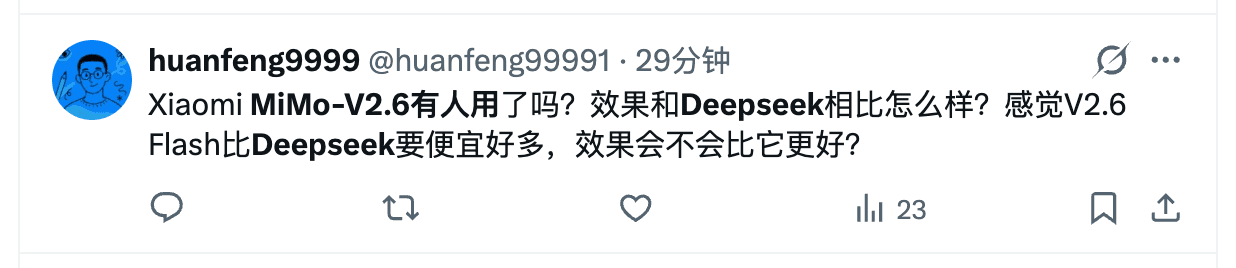
MiMo-V2.6-Pro 值得留在你的候选名单里。小米在 2026 年 9 月 22 日发布并开源了这款旗舰,它在 Artificial Analysis 智能指数上拿到 46 分——当时开源权重模型里的最高分——官方挂牌价是每百万 token 输入 $0.435、输出 $0.87。发布前一天,Kingy AI 的独立 OpenCode 实测给它打出 23 项隐藏编码检查全过、单次约 $0.03 的成绩,准确率追平 Claude Opus 5,成本只有后者的约三十五分之一。发布当天,X 上有用户一句话问出了所有对比需求:"Xiaomi MiMo-V2.6有人用了吗?效果和Deepseek相比怎么样?感觉V2.6 Flash比Deepseek要便宜好多,效果会不会比它更好?"
要离开它的理由,恰恰来自小米自己。官方公告原文写着:"However, there is still a gap when compared with the strongest closed-source models Claude Fable 5.1 and GPT-6 Astra."(与最强闭源模型 Claude Fable 5.1 和 GPT-6 Astra 相比仍有差距。)厂商亲口承认新旗舰还没追上闭源前沿,这种话反而可信——同一指数上,Fable 5.1 和 GPT-6 Astra 坐在 53 分,比 MiMo-V2.6-Pro 高 7 分;Claude Opus 5 在 max effort 下拿 51 分,每个指数任务成本 $5.86,约是 MiMo($0.13)的 45 倍。
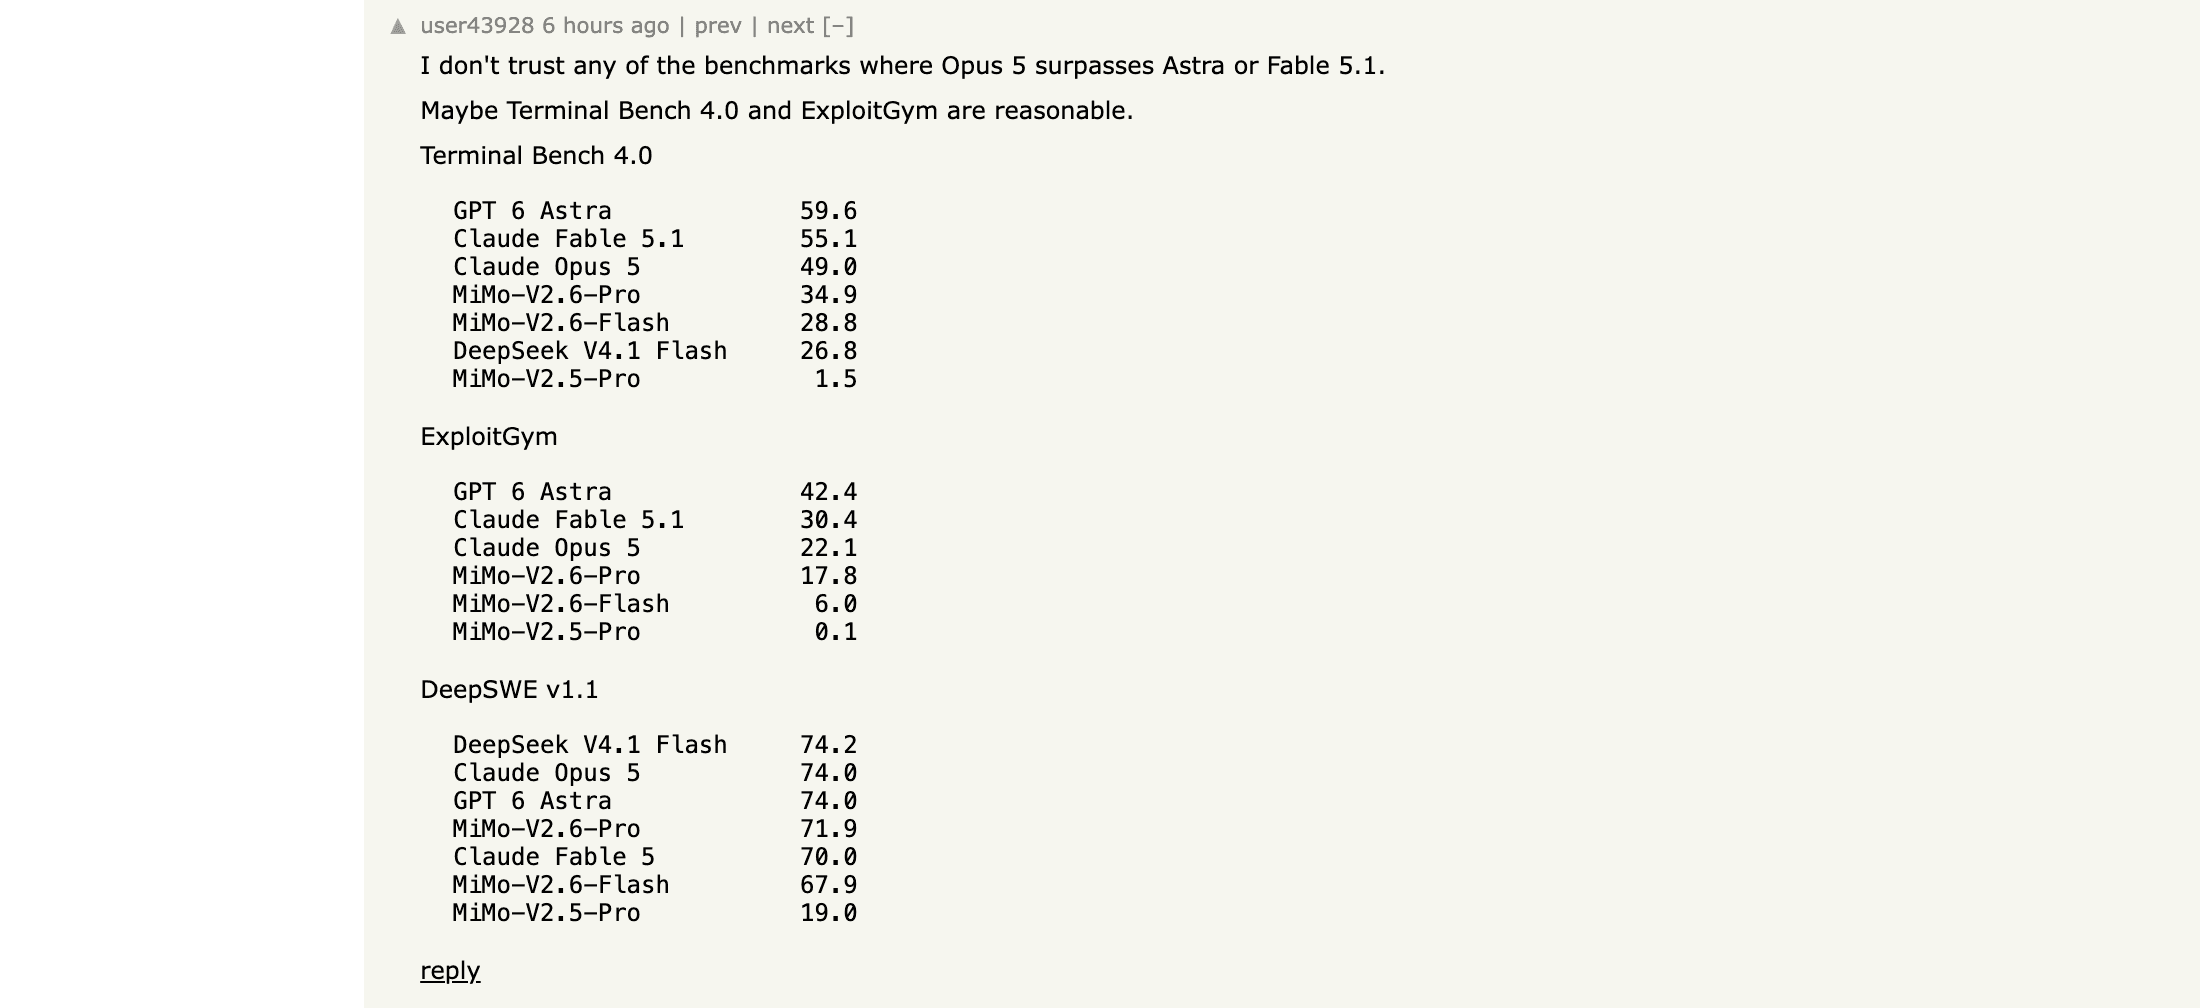
这 7 分差距背后藏着两笔真实的账。在 agent 类、要驱动终端的 Terminal Bench 4.0 上,小米自己的表格给 MiMo-V2.6-Pro 打了 34.9 分,对面 Claude Opus 5 是 49.0、GPT-6 Astra 是 59.6。而支撑分数的推理过程会体现在账单上:一位 Hacker News 测试者只能跑最低推理档,因为"其他档位(中/高)消耗的 token 太多,所有请求全部超时"。这不是说 MiMo-V2.6-Pro 不行,而是说“最便宜的开源旗舰”掩盖了两笔隐性成本——agent 能力差距,以及随思考变长的 token 账单。这两笔成本都有对应的替代方案。
如果你不满的其实不是模型,而是模型外围的折腾——管理 API key、比价、开五个标签页人工对比——文末第 7 节给出第三条路:在 Tabbit 浏览器里直接跑对比。先看候选。
核心结论
MiMo-V2.6-Flash 是第一个该测的替代品:同样的 1M 上下文、同样的全模态输入、同样的 API 接口,价格 $0.14/$0.28(每百万 token),小米官方还给了"全面超越 MiMo-V2.5-Pro"的背书。
DeepSeek V4.1 Flash 是调度型选手:错峰 $0.15 输入 / $0.60 输出几乎无对手,而且在共享的 DeepSWE v1.1 表上以 74.2 分领跑。
Kimi K3 是高端开源权重对手:2.8T 参数推理模型,每个评测任务的成本约是 MiMo 的 17 倍,买到的是不同的基准画像,不是全面碾压。
Qwen3.8 Max(0902)是闭源同档旗舰,$2/$6 每百万 token——适合想要阿里旗舰又不想碰开源运维的团队。
GLM-5.3 是"代码质量优先"的常开推理模型:社区反馈认可它"方案干净",OpenRouter 促销价 $0.78/$2.46。
本文所有基准都是厂商口径或第三方指数口径,所有社区评论都是个人经验。发布周的数据会变。
我怎么选出的这些替代品
四条标准,按顺序应用:
完成任务的成本,不是标价。 半价但思考三倍时间的模型并不便宜。每个候选都按自己的官方或挂牌路线计价,标注缓存、峰时和 Batch 折扣。
真实工作中的 agent 可靠性。 Artificial Analysis 指数把开源阵营排得很清楚,但 Terminal Bench 4.0、ExploitGym 和 DeepSWE v1.1 能看到指数掩盖的差距。候选必须至少有其中一项的证据。
开源权重与部署条件。 自托管改变数据驻留、成本结构和绑定程度。每个候选都标明开源或闭源,这一行直接决定一半的迁移工作量。
具名的社区证据。 使用场景和失败模式来自 HN、Reddit、X 上可点开的具体帖子,不来自发布稿。
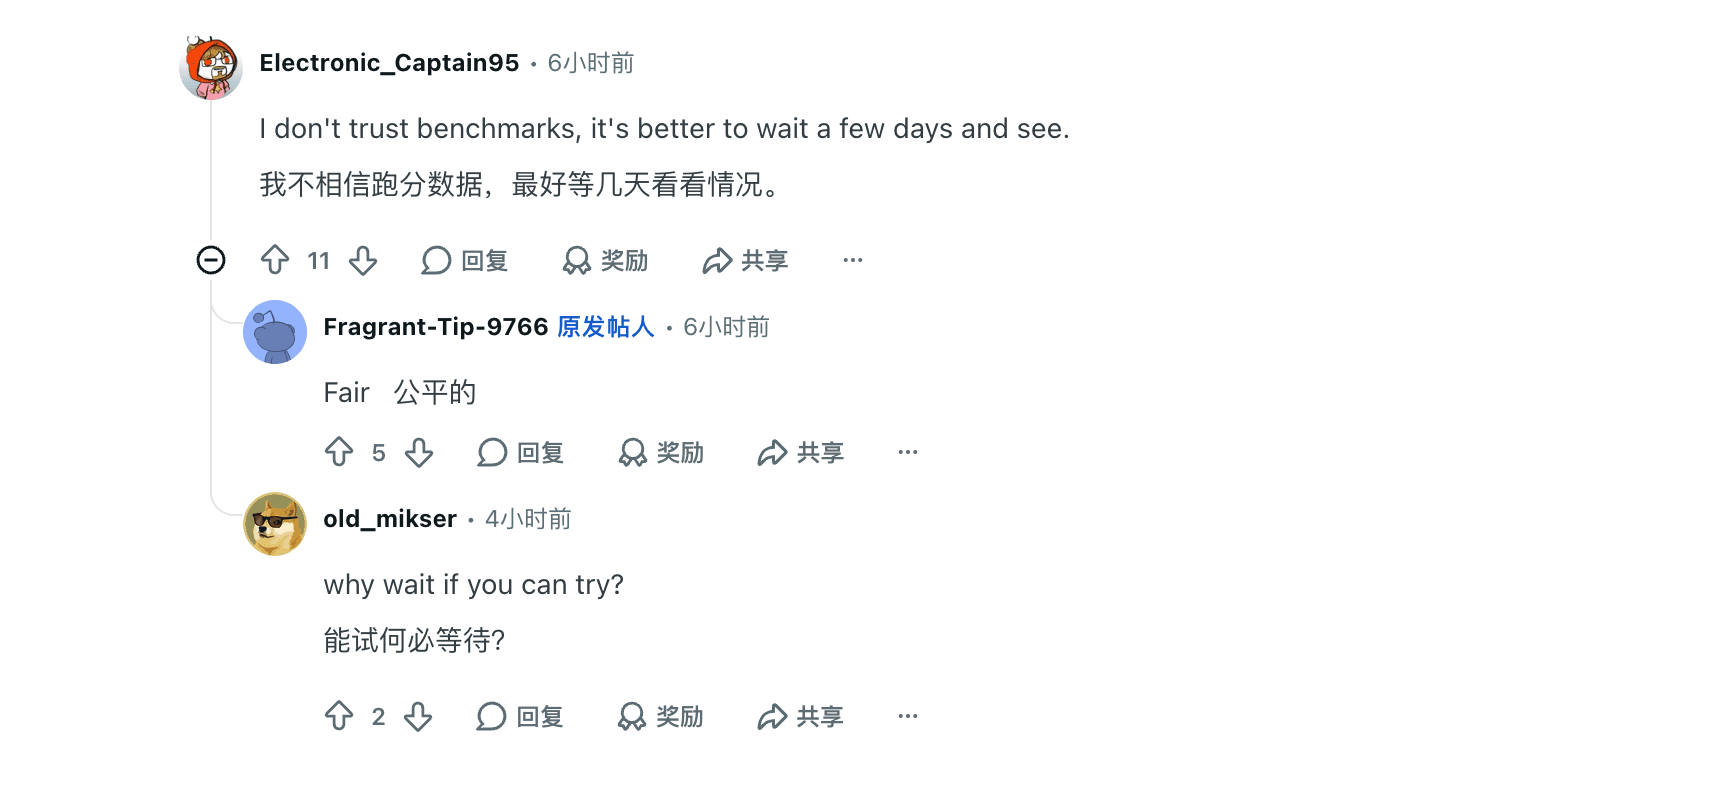
下面的截图都是 2026 年 9 月 22 日实拍的原帖。在讨论是否采用 MiMo 的帖子里,一位 Reddit 网友把校准态度说得很直白:"I don't trust benchmarks, it's better to wait a few days and see."(我不信跑分,最好等几天再看看。)
五个候选一览
| 候选 | 最适合 | 官方路线 | 每 1M token 价格(2026-09-22 核对) | 主要的坑 |
|---|---|---|---|---|
| MiMo-V2.6-Flash | 同门降价,迁移成本最小 | mimo-v2.6-flash;1M 上下文 / 131K 输出;开源权重 | 输入 $0.14 / 缓存命中 $0.0028 / 输出 $0.28 | 高难 agent 任务上推理余量不如 Pro |
| DeepSeek V4.1 Flash | 错峰批量与调度型预算 | deepseek-flash;1M / 384K;仅 API | 错峰 $0.15 / $0.60;峰时 $0.30 / $1.20;缓存命中 $0.003–$0.006 | 峰时时段(工作日 UTC 01:00–04:00、06:00–10:00)输入输出全部翻倍 |
| Kimi K3 | 高端开源推理与长程 agent | kimi-k3;1.0M 上下文;开源权重 | OpenRouter 挂牌 $1.50 / $7.50(5 折;目录价 $3 / $15) | 评测任务成本约是 MiMo 的 17 倍,指数反而低 2 分 |
| Qwen3.8 Max (0902) | 阿里闭源旗舰,多模态输入 | qwen3.8-max-0902;1.0M 上下文 | $2 / $6 | 闭源——不能自托管,没有权重级退路 |
| GLM-5.3 | 常开推理,代码质量优先 | glm-5.3;挂牌 1.3M 上下文 | OpenRouter 挂牌 $0.78 / $2.46(44% 折扣) | 推理无法关闭;本地部署成本高 |
来源:小米 MiMo 定价页(更新时间 2026 年 9 月 21 日)、DeepSeek 定价页,以及 Kimi K3、GLM-5.3、Qwen3.8 Max 的 OpenRouter 挂牌。输出价包含推理 token。OpenRouter 价格带有当日促销徽标;Moonshot 与阿里自有的价格页本次会话无法访问,因此以 OpenRouter 挂牌代替并注明这一边界。
MiMo 家族的完整价目数学——缓存杠杆、UltraSpeed、Batch API——见MiMo-V2.6-Pro 定价指南。本文只回答"留还是换"。
MiMo-V2.6-Flash
最适合: 不离开小米的 API、上下文窗口和输入类型,把 token 账单砍掉三分之二。
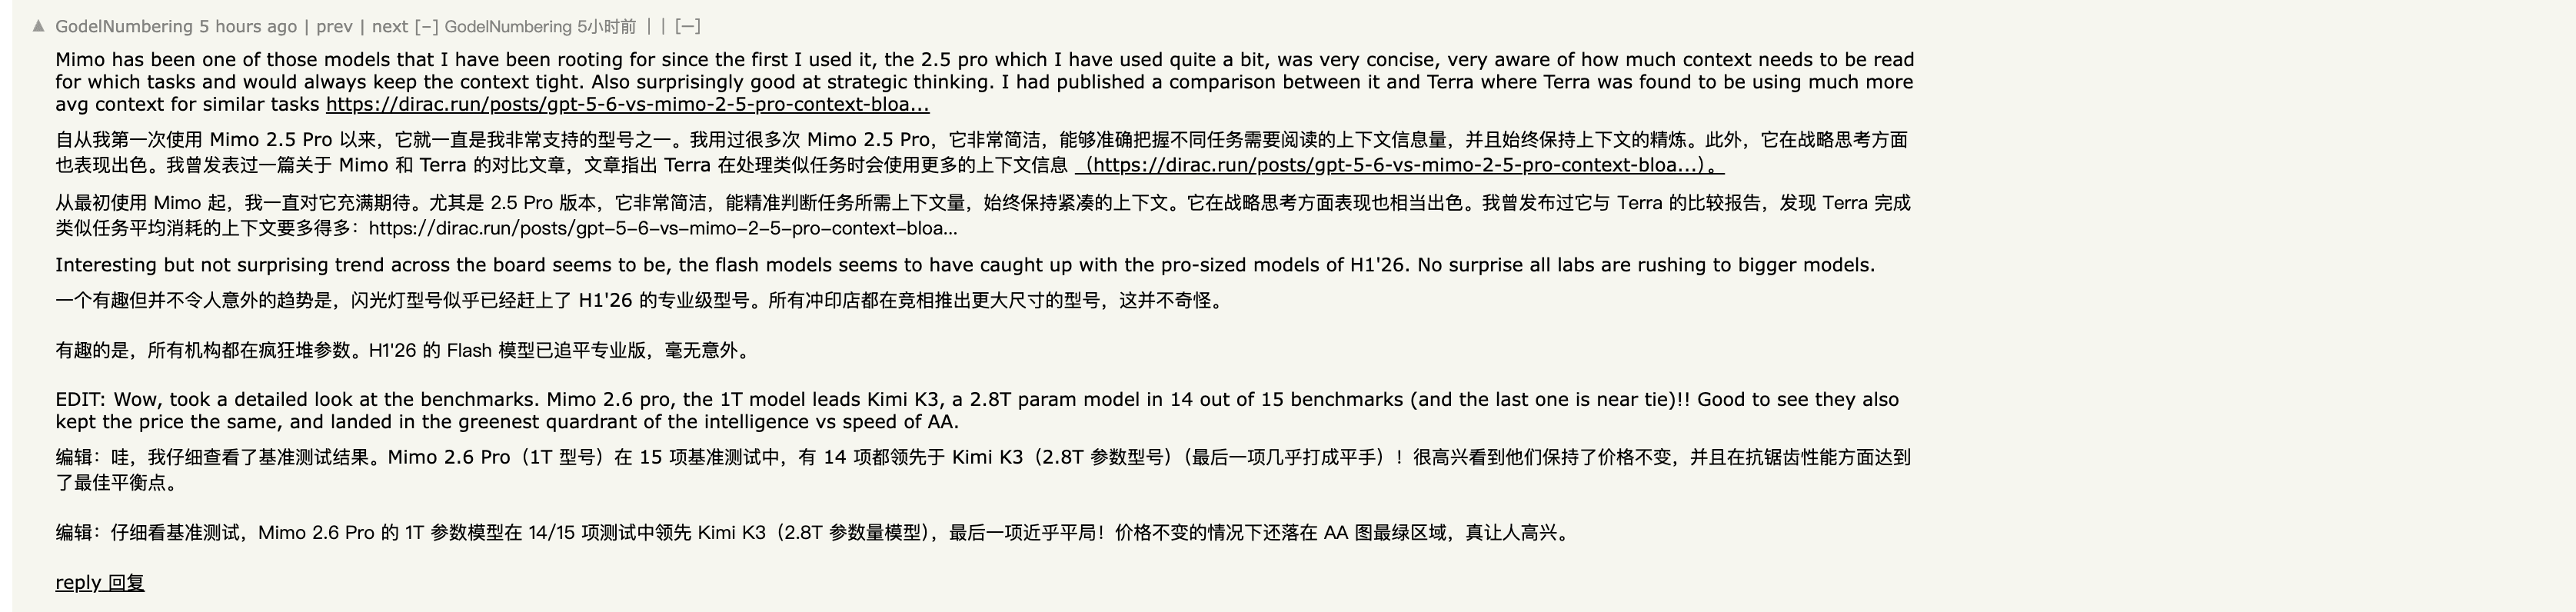
优点: Flash 与 Pro 共享 1,048,576 token 上下文、131,072 token 输出上限和原生多模态输入,价格为每百万 token 输入 $0.14、输出 $0.28——走 Batch API 再降到 $0.07/$0.14。它是本清单里唯一一个升级背书来自厂商发布稿本身的候选:"MiMo-V2.6-Flash has comprehensively outperformed MiMo-V2.5-Pro."(全面超越 MiMo-V2.5-Pro。)在小米公布的共享 agent 表上,它 Terminal Bench 4.0 拿 28.8 分,高于 DeepSeek V4.1 Flash 的 26.8;Kingy 的独立 OpenCode 实测在免费线路上拿下 23 项中的 21 项,只比大哥少两项。一位从 V2.5 一路追过来的 HN 网友总结得很到位:"the 2.5 pro… was very concise, very aware of how much context needs to be read for which tasks and would always keep the context tight"(2.5 Pro 非常简洁,清楚每个任务该读多少上下文,始终保持上下文精炼),并在编辑中补充:"Mimo 2.6 pro, the 1T model leads Kimi K3, a 2.8T param model in 14 out of 15 benchmarks (and the last one is near tie)!!"(1T 的 MiMo 2.6 Pro 在 15 项基准里的 14 项都领先 2.8T 参数的 Kimi K3,最后一项也接近打平!!)
缺点: 它是小模型。309B 总参 / 15B 激活,对上 Pro 的 1.02T / 42B,深度多步推理的余量更小——同一场 OpenCode 实测里它被扣掉两检查项,ExploitGym 上 6.0 分对 Pro 的 17.8 分。如果你的工作负载吃的是 Pro 的推理深度,Flash 是假省钱。
定价: 每百万 token 输入 $0.14 / 缓存命中 $0.0028 / 输出 $0.28;Batch API 再打对折;UltraSpeed 的 10 倍加价只属于 Pro。算例见家族价目。
结论: 如果你对 MiMo-V2.6-Pro 的不满是账单而不是上限,先测 Flash——这是官方自己给出的更便宜答案。如果你的不满是高难 agent 任务的质量,Flash 解决不了,去看 DeepSeek 或 Kimi K3。
MiMo-V2.6-Flash 模型页把规格和迁移注意事项放在了一起。
DeepSeek V4.1 Flash
最适合: 能跑错峰的大批量任务,以及想要 1M 上下文、带视觉、地板价 API 的团队。
优点: DeepSeek 当前定价页列出的 deepseek-flash(DeepSeek-V4.1-Flash)同时支持非思考与思考模式,1M 上下文、384K 最大输出,带视觉、JSON 输出、工具调用,以及 OpenAI 和 Anthropic 两种兼容接口。错峰时段输入 $0.15、输出 $0.60 每百万 token——缓存热了之后,重复前缀只按 $0.003 计费。在小米公布的 agent 基准表上,DeepSeek V4.1 Flash 的 DeepSWE v1.1 拿到 74.2 分,是整张共享表的最高分,超过 74.0 的 Claude Opus 5 和 GPT-6 Astra,也超过 71.9 的 MiMo-V2.6-Pro。并发上限写在页面上的 2,500,是该页最高档。
缺点: 时段表。峰时——工作日 UTC 01:00–04:00 和 06:00–10:00,中国法定假日除外——所有费率精确翻倍,峰时缓存未命中要 $0.30 每百万。真实代码质量上社区意见分裂:在 LocalLLaMA 对比小开源模型的帖子里,一位资深评论者认为"DeepSeek-V4.1-Flash was technically a lot more capable than GLM-5.3-Flash but it's worse in the real-world - it is capable of getting to a solution but it's still hacky as heck"(技术上比 GLM-5.3-Flash 强得多,但实际用起来更差——能找到方案,但很粗糙)。DeepSeek 还保留调价权利,做预算时引用它的页面,别引用本文。
定价: 错峰 $0.003 缓存命中 / $0.15 未命中 / $0.60 输出;峰时 $0.006 / $0.30 / $1.20 每百万 token。错峰价就是峰时的一半。
结论: 工作负载可调度——批量富化、夜间摘要、定时 agent——并且你的验收测试在它的输出上通过时,选 DeepSeek。需要峰时交互延迟和可预测价格,或者它的推理深度在你的任务集上确实赢时,留在 MiMo-V2.6-Pro。
DeepSeek V4.1 Flash 模型页和DeepSeek V4 Flash 定价拆解详细覆盖了时段表。
Kimi K3
最适合: 已经投入月之暗面生态、想要小米之外最强开源权重选项、并且付得起价的团队。
优点: Kimi K3 是 2.8T 参数的开源权重多模态推理模型,1.0M 上下文,采用 KDA 加注意力残差架构,OpenRouter 挂牌 $1.50 输入 / $7.50 输出(5 折促销;目录价 $3 / $15)。在 Artificial Analysis 上它依然是精英级开源模型:max effort 下智能指数 43.6、编码指数 76.2、agent 指数 50.0——这个 agent 分数在多个共享套件里高于 MiMo-V2.6-Pro 的对应表现。做长程仓库级工作,它有真实的拥趸。
缺点: 这个月的价格-指数数学很残酷。OrcaRouter 的分析测出同一套评测的成本:Kimi K3 $3,658.07,MiMo-V2.6-Pro $206.66——17 倍的差距——而分数是 44 对 46。热度也有反对者:"the 'best' models available from chinese labs right now (GLM 5.3 and Kimi K3) fall apart completely when you try to do real work with them. K3 is especially embarrassing…"(现在中国实验室最好的模型 GLM 5.3 和 Kimi K3,真拿去干实际工作就彻底崩掉,K3 尤其尴尬……)这是发布日一位 HN 网友的激烈观点,没有公开测试细节、我们无法核实,但它提醒你:K3 的溢价买到的是另一种画像,不是稳赢。

定价: 2026 年 9 月 22 日 OpenRouter 促销挂牌 $1.50 / $7.50 每百万 token;目录价 $3 / $15。本次调研中 Moonshot 官方价格页无法访问,下单预算前请到官方页面核实。
结论: 已有 K 系流水线、它的 agent 特长或多模态画像能赢得你的任务集、且预算已批——选 Kimi K3。同样关心指数表现、更在乎成本——选 MiMo-V2.6-Pro,17 倍的价差就是全部决策依据。
我们的Kimi K3 定价指南和 Kimi K3 模型页覆盖了费率结构和规格。
Qwen3.8 Max (0902)
最适合: 想要阿里闭源旗舰——多模态输入、默认开推理、1M 上下文——作为纯托管 API、完全不碰开源运维的团队。
优点: Qwen3.8 Max 的 0902 快照是 2.4T 参数的混合专家模型,接受文本、图像、视频输入,1.0M 上下文,支持工具调用、结构化输出和可配置推理档位。在 Artificial Analysis 指数上它拿 45 分,编码指数 76,与前沿档打平。$2 / $6 每百万 token 的价格相对所有西方旗舰低了数倍,同时完全不承担权重托管责任。小米自己的发布稿点名 MiMo-V2.6-Pro 超越的就是它和 Kimi K3——这层对比是官方写明的,不是我们推断的。
缺点: 闭源直接终结了自托管讨论——没有 checkpoint、没有许可证文件,阿里调整接入条款时也没有权重级退路。Qwen 自家的开源粉反而会劝你看小模型:"Thank you Xiaomi for making Qwen3.8-Next-Flash looks so awesome for half the size. Qwen is the king of open-weight models."(感谢小米,让体积减半的 Qwen3.8-Next-Flash 显得更香了。Qwen 才是开源权重之王。)MiMo 发布当天一位 r/LocalLLaMA 老用户的这句"感谢",既是对 Qwen 开源家族的夸奖,也提醒你 Max 是这个家族里的闭源例外。
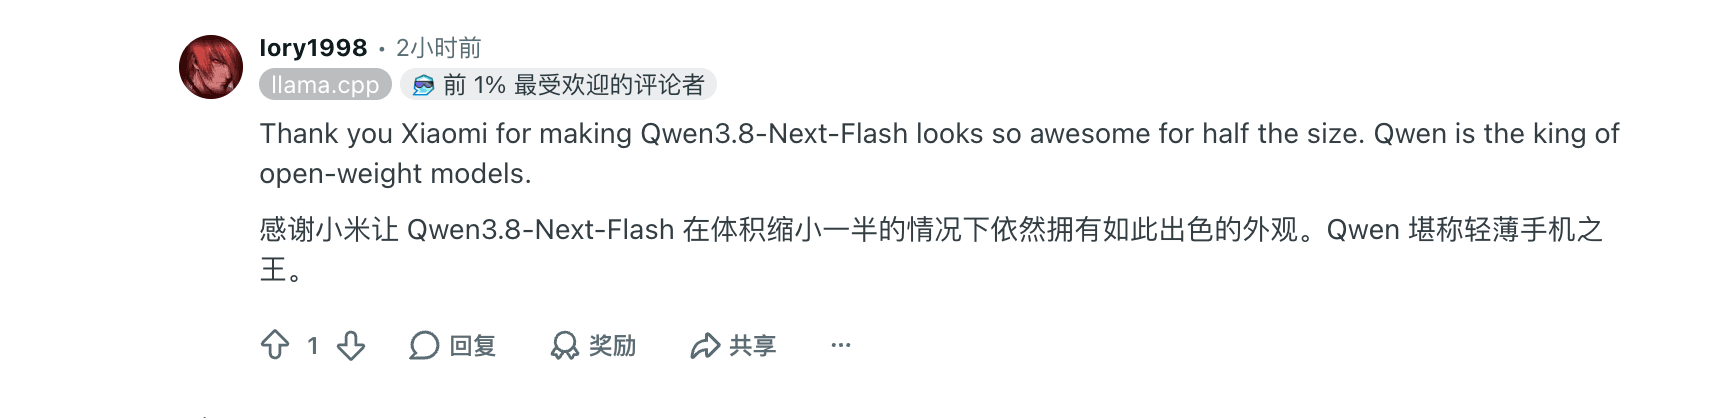
定价: 2026 年 9 月 22 日核对,OpenRouter 上 0902 快照挂牌 $2 输入 / $6 输出每百万 token。本次调研会话中阿里云自有价格页未能渲染,签约前请到官方页面核实。
结论: 想要闭源、托管、多模态的旗舰,且阿里的账号条款符合你的地区与合规需求——选 Qwen3.8 Max。开源权重、MIT 许可或更低的价目表对你有分量——留在 MiMo-V2.6-Pro;或者当你的复测结果和小米的表格一致时,选那个更便宜的 checkpoint。
Qwen3.8 Max 模型页跟踪该快照的规格。
GLM-5.3
最适合: 方案质量比速度和价格更重要的代码生成——推理常开。
优点: GLM-5.3 是智谱 Z.ai 的大型推理模型,面向复杂软件工程和长程 agent 任务,推理档位分 low / high / max(默认 max),OpenRouter 挂牌 1.3M 上下文。在 Artificial Analysis 上,它智能指数 44.8,更有说服力的是 agent 指数 53.1——精英级。 定性反馈更有意思:那位说 DeepSeek 输出"粗糙"的 LocalLLaMA 评论者,同一句话里夸了 GLM:"GLM-5.3 implements clean solutions (develops an architecture and uses design patterns)."(GLM-5.3 给出干净的方案——会先搭架构、用设计模式。)OpenRouter 促销挂牌 $0.7826 / $2.46 每百万 token——44% 折扣——价格正好落在 MiMo-V2.6-Pro 和 Kimi K3 之间。
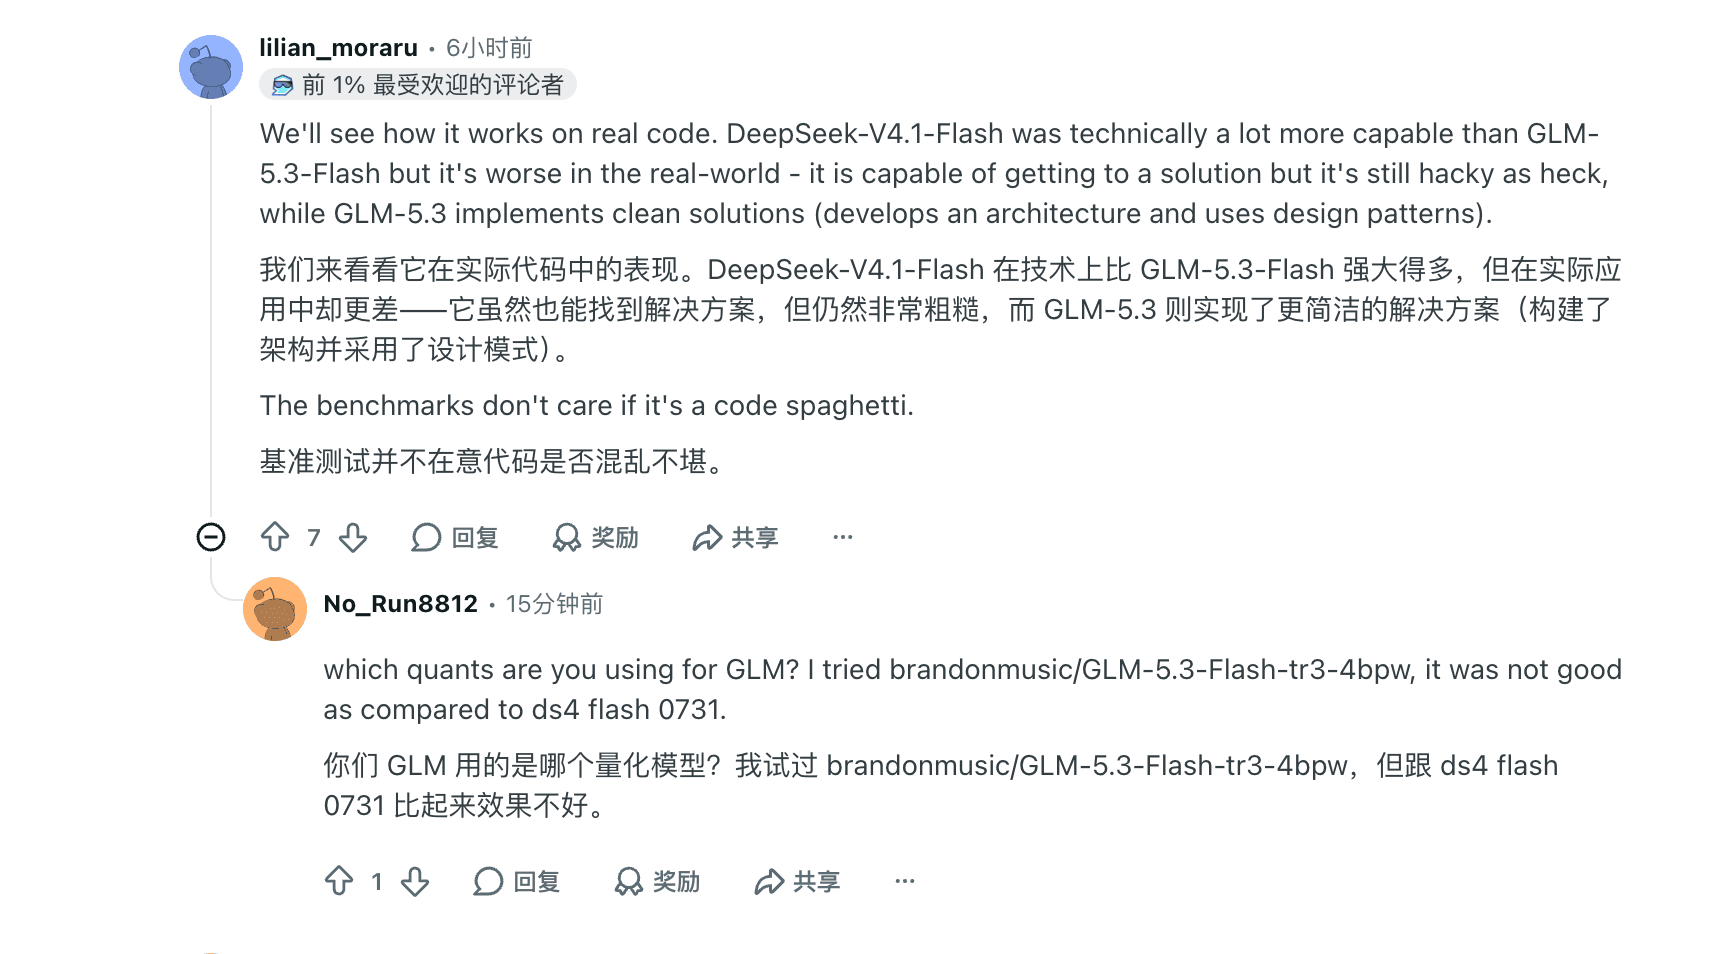
缺点: 推理无法关闭,没有廉价的非思考模式可以跑抽取或分类——每次调用都付思考税。本地服务是另一个工程:"GLM 5.3 flash should already not be on there. Extremely expensive to run local."(GLM 5.3 flash 根本不该出现在那个名单里,本地跑太贵了。)MiMo 对比帖里这位网友的话可以直接引用。另外本次调研会话中 Z.ai 自家文档站无法访问,挂牌价只有 OpenRouter 一个来源边界。
定价: 2026 年 9 月 22 日核对,OpenRouter 44% 折扣挂牌 $0.7826 / $2.46 每百万 token;目录价约 $1.40 / $4.39。
结论: 代码评审质量、架构感或 agent 指数能赢得你的试点,且常开推理的预算可以接受——选 GLM-5.3。需要可切换、缓存友好的 API 且价格不到其目录价一半——选 MiMo-V2.6-Pro;账单主导——选 Flash。
GLM-5.3 模型页保存了它的规格与路线说明。
第三条路:在 Tabbit 里直接跑对比
多数换模型的项目卡在物流而不是模型质量:为五家供应商开 API key、统一输出格式、开五个标签页人肉对比。Tabbit 浏览器攻击的就是这一层。它的多模型视图把一条提示词同时发给多个模型,答案并排成列,读起来像表格;输入框里的模型选择器可以在不同会话间切换当前模型,不需要反复认证。
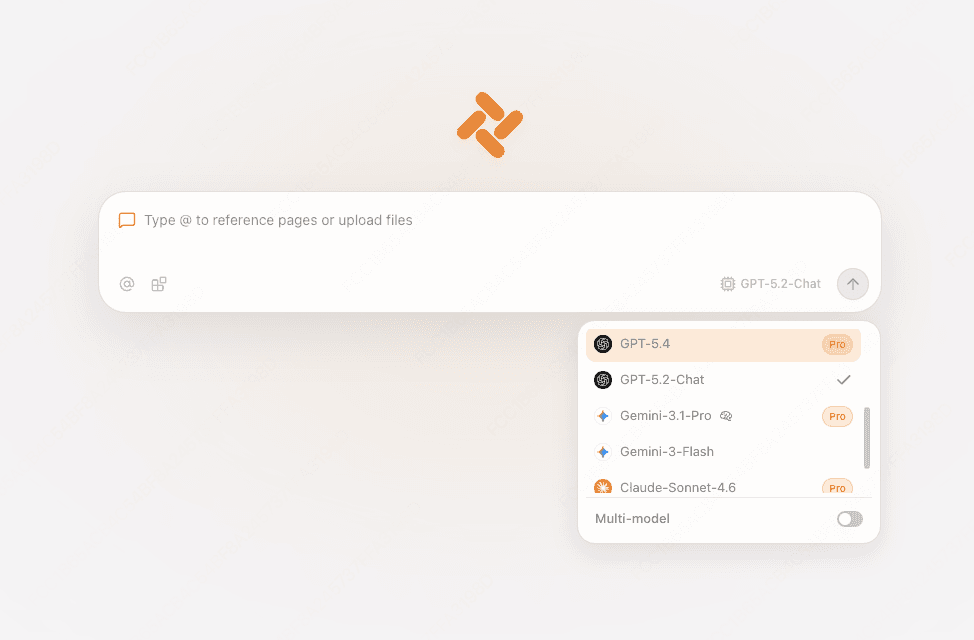
实用试点循环是这样的:用 @ 引用你关心的页面或文件,勾选两三个候选模型,在一个视图里对比答案——然后在你真实跑的五个任务上重复。一个下午就能拿到决策级样本,还不用做对账表格。想了解 agent 化浏览如何加强这套流程,见什么是 agentic browser 和 2026 AI 浏览器对比。
两条边界保持诚实。第一,Tabbit 中的实际可用模型取决于账号的模型选择器和平台条款——本文不声称包括 MiMo-V2.6-Pro 在内的任何具体型号内置于所有账号,Tabbit 也不替代你的外部 API 计费关系。第二,浏览器侧对比是试点不是基准:它控制了提示词和页面变量,不控制 token 计量和方差。用它筛短名单,用定价指南定预算。
 Tabbit Browser
跑一次同任务试点
无论短名单里剩下谁,测试方法都一样:固定两三个真实任务,连同输入、指令、工具、输出契约和重试预算一起冻结;记录 token、首 token 时间、完成时间、工具失败和人工修正——然后算完成任务的成本,包括按输出计费的推理 token。一次干净的运行证明不了任何费率或可靠性;重复到方差不再让你惊讶为止。换了上下文或工具路线,是路线差异,不是某个模型全面更好的证据。
结论:按场景决定留还是换
本页没有总冠军,发布日的排行榜也活不过这个月。决策跟着约束走:
| 主要约束 | 先试点 | 通过标准 | 主要提醒 |
|---|---|---|---|
| 砍账单,留工作流 | MiMo-V2.6-Flash | 同样任务在三分之二 token 预算内通过 | 高难 agent 任务推理余量变小 |
| 最便宜的错峰批量 | DeepSeek V4.1 Flash | 错峰混合单价低于 $0.20/1M 且验收通过 | 峰时翻倍;要么调度要么付钱 |
| 不限价的开源基准对标 | Kimi K3 | 任务集收益能撑住 17 倍评测成本 | 溢价买到的是画像,不是稳赢 |
| 托管闭源旗舰,多模态 | Qwen3.8 Max (0902) | 合规与账号条款匹配且任务通过 | 无自托管退路;快照会轮换 |
| 代码质量优先 | GLM-5.3 | 真实仓库上的评审得分超过对手 | 推理常开;没有省钱档 |
| 缓存友好的推理,$0.435/$0.87 | 留在 MiMo-V2.6-Pro | 自己跑的完成任务成本低于对手 | 盯住档位;token 账单随思考变长 |
如果你留在 MiMo-V2.6-Pro,认真设置推理档位——中高两档就是它 token 胃口所在——并保持提示词前缀稳定,让 $0.0036 的缓存层发挥作用。

如果你决定换,让约束选目的地,别让排行榜选。MiMo-V2.6-Pro 定价指南和 Gemini 3.8 Flash 替代品对比是更完整的价目与跨家族阅读材料。
来源
本文所有事实、价格和引用核对于 2026 年 9 月 22 日:
OpenRouter 挂牌:Kimi K3、GLM-5.3、Qwen3.8 Max (0902)
社区帖子以文中截图和链接为准:X(@huanfeng9999)、Reddit(r/DeepSeek、r/LocalLLaMA)、Hacker News(条目 49793293、49794307、49795049、49795769)

常见问题
MiMo-V2.6-Pro 最接近的替代品是什么?
同门师弟 MiMo-V2.6-Flash 是最接近的替代品:同样 1M 上下文、同样的全模态输入和 API 接口,token 单价只有三分之一。另一家的开源权重对手是 Kimi K3,但目录价高出数倍,基准画像也不相同。
哪个替代品的官方标价最低?
DeepSeek V4.1 Flash 的错峰价最低:缓存命中 $0.003、未命中 $0.15、输出 $0.60(每百万 token)。MiMo-V2.6-Flash 的未命中输入价 $0.14 更低,两家也都能通过 Batch API 或错峰调度进一步压价。最便宜的路线取决于你的缓存命中率和运行时段。
如果继续用 MiMo-V2.6-Pro,它还合适吗?
很多情况下依然合适。小米官方口径是开源权重里 Artificial Analysis 智能指数第一名,价格 $0.435 输入 / $0.87 输出(每百万 token),第三方 OpenCode 实测 23 项检查全过、单次约 3 美分。只要你的任务是重推理型、提示词对缓存友好、也不追求 agent 基准的最后几分,留在 MiMo 就是理性选择。
这些替代品都能自己部署吗?
MiMo-V2.6-Pro、MiMo-V2.6-Flash 和 Kimi K3 都开放了权重,Z.ai 的 GLM 系列也有开源传统,本地部署在硬件充足时可行。Qwen3.8 Max 是闭源 API 模型,DeepSeek V4.1 Flash 通过 DeepSeek API 使用。落地前请逐个核对许可证和 checkpoint 条款。
MiMo-V2.5-Pro 必须迁移吗?
是。小米官方文档写明 mimo-v2.5-pro 和 mimo-v2.5 将于北京时间 2026 年 10 月 21 日 10:00 正式停用。V2.6 系列沿用 V2.5 的 API 定价,多数迁移只是改模型 ID 加回归测试,不涉及预算变化。
MiMo-V2.6-Pro 在 Tabbit 浏览器里能用吗?
Tabbit 中的实际可用模型取决于账号的模型选择器和平台条款,本文不做内置承诺。Tabbit 的多模型视图可以把账号内可用模型并排对比,是在真实页面上试跑替代方案的现实办法。