
El precio nominal por token nunca refleja el coste real de resolver un problema de ingeniería. Es simplemente el precio de una materia prima. En la lista de tarifas oficial publicada por Xiaomi el 22 de septiembre de 2026, el modelo de alta eficiencia MiMo-V2.6-Flash figura a 0,140 $ por millón de tokens de entrada no almacenados en caché y 0,280 $ por millón de tokens de salida (o 1,00 ¥ y 2,00 ¥ en RMB). Al ser más de 3 veces más barato que su hermano insignia Pro, Flash se posiciona como una de las opciones omnimodales ligeras más competitivas del mercado.
Sin embargo, el verdadero impacto en la arquitectura de costes reside en dos mecanismos: un descuento del 98,0 % (50 veces más barato) en la caché de prompts, que reduce la entrada en caché a 0,0028 $ por millón de tokens, y un diseño MoE (Mixture-of-Experts) disperso que activa solo 15B de parámetros de un total de 309B, sosteniendo una velocidad de generación superior a los 140 tokens por segundo. Para la extracción masiva de datos web o agentes de navegación de alta frecuencia, estas tarifas transforman la economía de escala. Esta guía traduce la lista de tarifas oficial en presupuestos empresariales reproducibles. Si deseas consultar antes las especificaciones, visita la página del modelo MiMo-V2.6-Flash (English); para la versión insignia de 1,02T, consulta nuestro análisis de precios de MiMo-V2.6-Pro.
Puntos clave
Las tarifas base son de 0,14 $ en entrada y 0,28 $ en salida por millón de tokens, lo que hace que Flash sea más de 3 veces más económico en ambos ejes que el buque insignia MiMo-V2.6-Pro (English) (0,435 $ / 0,87 $).
El almacenamiento en caché reduce el coste de entrada en un 98,0 %: los prefijos coincidentes cuestan solo 0,0028 $/M de tokens (0,02 ¥/M), permitiendo consultar repetidamente esquemas largos y documentación de referencia por fracciones de céntimo.
UltraSpeed es exclusivo de Pro: Flash no cuenta ni necesita un nivel UltraSpeed 10x, ya que sus 15B parámetros activos proporcionan nativamente baja latencia y alto rendimiento de streaming.
Los tokens de razonamiento se facturan como salida: en los puntos de control de razonamiento RL, las cadenas de pensamiento interno se miden bajo la tarifa de salida de 0,28 $/M.
La convergencia contraintuitiva en la caché: en flujos de trabajo de agentes con más del 85 % de aciertos de caché, el coste de lectura de Pro (0,0036 $) está a solo 0,0008 $ de Flash (0,0028 $), lo que convierte al volumen de salida en el verdadero factor de decisión económica entre ambos niveles.
Precios de MiMo-V2.6-Flash de un vistazo
La siguiente tabla refleja las tarifas oficiales de la plataforma según la documentación oficial de Xiaomi MiMo, verificadas el 22 de septiembre de 2026. Todas las tarifas se expresan por millón de tokens (1M).
| Variante del modelo | Entrada (Caché hit) / 1M | Entrada (Caché miss) / 1M | Salida / 1M | Ventana de contexto | Salida máxima |
|---|---|---|---|---|---|
| MiMo-V2.6-Flash | 0,0028 $ (0,02 ¥) | 0,140 $ (1,00 ¥) | 0,280 $ (2,00 ¥) | 1.048.576 | 131.072 |
| MiMo-V2.6-Pro | 0,0036 $ (0,025 ¥) | 0,435 $ (3,00 ¥) | 0,870 $ (6,00 ¥) | 1.048.576 | 131.072 |
| DeepSeek V4.1 Flash | 0,0030 $ (0,021 ¥) | 0,150 $ (1,05 ¥) | 0,300 $ (2,10 ¥) | 1.048.576 | 8.192 |
| Gemini 3.8 Flash | 0,0375 $ | 0,150 $ | 0,600 $ | 1.048.576 | 8.192 |
La tabla de tarifas revela una clara estrategia comercial: MiMo-V2.6-Flash compite frontalmente con modelos ligeros como DeepSeek V4.1 Flash y Gemini 3.8 Flash, ofreciendo a la vez una capacidad de salida de hasta 131.072 tokens dentro de un contexto de 1 millón de tokens.
La cifra determinante: 0,0028 $ por millón de tokens en caché
El dato fundamental para dimensionar infraestructuras es 0,0028 $ / 1M tokens (0,02 ¥ / 1M). Esto representa una reducción exacta del 98,0 % (50 veces menos) en comparación con la tarifa de entrada sin caché de 0,140 $.
En flujos de trabajo automatizados, como en un proceso de razonamiento con agentes, un agente autónomo analiza con frecuencia capturas del DOM, extrae información estructurada y evalúa formularios. Si un contexto web de 100.000 tokens se reenvía a lo largo de 20 turnos sin caché, se consumen 2 millones de tokens de entrada (0,28 $). Con el almacenamiento en caché automático de prefijos, esos mismos 20 turnos cuestan menos de 0,006 $ en la línea de entrada.
Además, la arquitectura MoE dispersa de Flash activa solo 15B de parámetros de los 309B totales. Esto mantiene muy bajo el tiempo hasta el primer token (TTFT) y sostiene una velocidad superior a los 140 tokens por segundo.
Desglosando las afirmaciones oficiales de eficiencia
Xiaomi presenta a MiMo-V2.6-Flash como la herramienta ideal para tuberías de datos empresariales donde la calidad del razonamiento debe compaginarse con un coste unitario muy estricto. Si bien las matemáticas por token son favorables, deben tenerse en cuenta dos límites operativos:
Medición de tokens de razonamiento en modo RL: El punto de control
MiMo-V2.6-Flash-RLutiliza aprendizaje por refuerzo. Aunque el precio de salida de Flash es muy accesible (0,28 $/M), instrucciones complejas pueden generar de 3.000 a 6.000 tokens de pensamiento interno antes de entregar una salida JSON de 200 tokens. Como los tokens de pensamiento se facturan como salida, el coste real depende de la profundidad de razonamiento.Estabilidad del prefijo de caché: Para beneficiarse de la tarifa de 0,0028 $, los prefijos deben mantenerse idénticos entre peticiones. Añadir marcas de tiempo dinámicas o identificadores aleatorios al inicio del prompt invalidará la caché y provocará la tarifa completa de 0,140 $/M.
Fórmula verificada para estimar costes:
coste por petición = (entrada sin caché × 0,140
                    + entrada en caché × 0,0028
                    + salida total incl. razonamiento × 0,280) / 1.000.000
presupuesto mensual = (coste medio por petición × tareas facturables) + margen de reintentos
Conceptos de facturación fuera de la tabla principal
Calcular el coste total de propiedad exige considerar reglas adicionales de la plataforma Xiaomi MiMo:
Exclusividad de UltraSpeed en Pro: A diferencia del nivel insignia que ofrece una variante
mimo-v2.6-pro-ultraspeedcon un recargo de 10x (4,35 $ entrada, 8,70 $ salida), Flash no ofrece ni necesita este modo. Sus 15B parámetros activos ofrecen de forma natural un streaming muy veloz.Planes de suscripción Token Plan: Para equipos y desarrolladores que prefieren cuotas fijas mensuales en RMB:
Plan Lite (39 ¥ / mes): Para pruebas personales y scripts ligeros.
Plan Standard (99 ¥ / mes): Capacidad para desarrolladores activos y extracción diaria.
Plan Pro (329 ¥ / mes): Mayor concurrencia para tuberías en producción.
Plan Max (659 ¥ / mes): Capacidad dedicada para ingesta masiva empresarial.
Límites de concurrencia: Las claves de API de pago por uso están sujetas a umbrales de RPM y TPM. Tuberías paralelas de gran escala deben solicitar ampliaciones de cuota.
Fin de ciclo de versiones anteriores: Los modelos de la serie MiMo-V2.5 quedarán obsoletos el 21 de octubre de 2026. Se aconseja migrar inmediatamente a V2.6.
Comparación escalonada de la familia MiMo
| Nivel de modelo | Ideal para | Entrada / 1M (Miss / Hit) | Salida / 1M | Perfil de latencia y concurrencia |
|---|---|---|---|---|
| MiMo-V2.6-Flash | Extracción web masiva, clasificación frecuente, resúmenes | 0,140 $ / 0,0028 $ | 0,280 $ | Muy alto rendimiento (140+ tok/s), 15B activos MoE |
| MiMo-V2.6-Pro | Programación compleja, demostraciones lógicas, razonamiento profundo | 0,435 $ / 0,0036 $ | 0,870 $ | Razonamiento profundo, 42B activos / 1,02T totales MoE |
| MiMo-V2.6-Pro-UltraSpeed | Agentes de voz en tiempo real, chat interactivo de soporte | 4,350 $ / 0,0360 $ | 8,700 $ | Generación ultrarrápida (hasta 20x velocidad, coste 10x) |
El hallazgo contraintuitivo de esta escala se encuentra en la dinámica de la caché: en tareas de una sola vuelta sin caché, Flash es 3,1 veces más económico que Pro. Sin embargo, en un bucle iterativo de agente con un 90 % de aciertos de caché, la diferencia de coste de entrada entre Flash (0,0028 $) y Pro (0,0036 $) es de apenas 0,0008 $ por millón de tokens. En ese escenario, la elección entre ambos modelos se basa casi por completo en el precio de salida (0,28 $ frente a 0,87 $) y en si la tarea requiere la capacidad de razonamiento de un modelo de 1,02T. Puedes comparar otras opciones en nuestra comparativa de navegadores con IA de 2026.
Lo que no pagas y los costes indirectos
Establecer fronteras claras evita imprevistos presupuestarios:
Sin recargos por retención de caché en ventanas base: A diferencia de proveedores que cobran almacenamiento por hora para contextos guardados, Xiaomi MiMo solo factura las lecturas efectivas con acierto de caché.
Sin costes por interrupciones de seguridad: Las solicitudes detenidas por los filtros de seguridad de la plataforma no abonan tokens especulativos no generados.
Los tokens de razonamiento no son gratuitos: Las etapas de pensamiento interno se facturan dentro de la línea de tokens de salida a 0,28 $/M.
Los fallos de ejecución consumen saldo: Si un scraper se topa con CAPTCHAs o bucles de reintento infinitos, todos los tokens procesados se facturarán con normalidad.
Lo que revelan los debates en la comunidad
Las opiniones recopiladas en foros técnicos ilustran cómo los desarrolladores utilizan MiMo-V2.6-Flash en entornos reales:
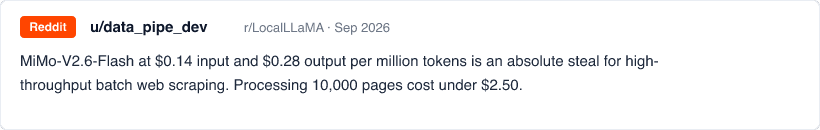
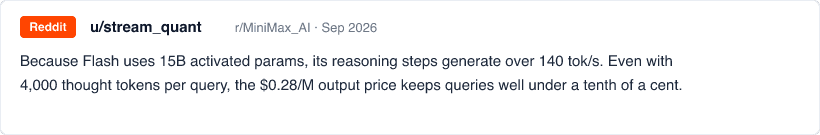
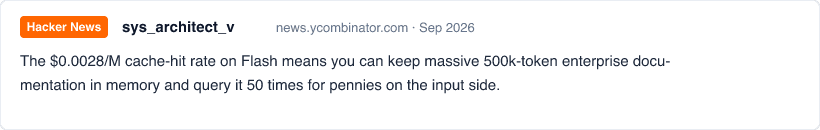
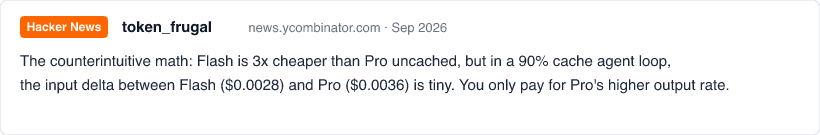
Estas opiniones coinciden en una regla clara: usa Flash para tareas masivas de extracción y clasificación, y acude a Pro únicamente cuando la lógica compleja lo justifique.
Dos casos prácticos reproducibles
Para aplicar estas tarifas a números concretos, examinamos dos flujos de trabajo empresariales bajo las tarifas oficiales de 2026 en USD:
Caso 1: Extracción masiva de páginas web (Alto volumen, baja tasa de caché)
Entrada: 15.000 tokens por página (HTML + esquema); 25 % de prefijo en caché (3.750 tokens en caché, 11.250 tokens sin caché).
Salida: 800 tokens (registro estructurado JSON).
Cálculo:
(11.250 × 0,140 $ + 3.750 × 0,0028 $ + 800 × 0,280 $) / 1.000.000 = 0,001575 $ + 0,0000105 $ + 0,000224 $ = 0,00181 $por página.10.000 páginas / mes: 18,10 $ / mes. (El mismo volumen en MiMo-V2.6-Pro costaría 55,97 $ / mes; ¡Flash ahorra un 68 %!).
Caso 2: Agente de investigación y comparación de documentos (Alta tasa de caché)
Entrada: 300.000 tokens acumulados a lo largo de 10 turnos de herramientas; 85 % de prefijo en caché (255.000 tokens en caché, 45.000 nuevos tokens).
Salida: 5.000 tokens en total (planificación, filtrado y resumen final).
Cálculo:
(45.000 × 0,140 $ + 255.000 × 0,0028 $ + 5.000 × 0,280 $) / 1.000.000 = 0,00630 $ + 0,000714 $ + 0,00140 $ = 0,00841 $por tarea.500 tareas / mes: 4,21 $ / mes. Sin almacenamiento en caché, solo los tokens de entrada costarían 0,042 $ por ejecución, elevando el gasto mensual a 21,70 $ / mes (más de 5 veces más).
| Carga de trabajo | Tokens de entrada | Cuota de caché | Tokens de salida | Tareas al mes | Coste mensual en tokens |
|---|---|---|---|---|---|
| Extracción web masiva | 15.000 | 25 % | 800 | 10.000 | 18,10 $ |
| Agente de investigación multivuelta | 300.000 | 85 % | 5.000 | 500 | 4,21 $ |
Cálculo local
Estima el coste mensual de tokens
Tarifas oficiales de la API revisadas en septiembre de 2026. Incluye el razonamiento en la salida. Los datos quedan en el navegador.
Excluye llamadas a herramientas y reintentos. Lectura en caché Pro y Flash a $0.0036 y $0.0028 por 1M tokens. Revisado: 22-09-2026. Consultar tarifas actuales
La calculadora anterior funciona íntegramente en tu navegador sin enviar datos a servidores externos. Te permite comparar los costes estimados entre Flash, Pro y UltraSpeed según tus parámetros reales.
Orquestación de flujos de trabajo en Tabbit Browser
Calcular los costes de los tokens es solo la mitad del desafío de ingeniería. Sigue siendo necesario un entorno operativo para ejecutar tareas en la web real. Mantener scripts headless, gestionar sesiones y solventar la paginación dinámica genera una gran fricción de mantenimiento.
Tabbit Browser proporciona un entorno de trabajo nativo de IA donde los agentes de navegación inteligentes recorren aplicaciones web complejas, extraen datos en tablas limpias y consolidan información entre pestañas. Para profundizar en cómo estas arquitecturas transforman las operaciones cotidianas, te invitamos a consultar nuestros artículos sobre qué es un navegador con agentes y los mejores navegadores de IA en 2026.
Según los registros oficiales del proyecto, la disponibilidad de modelos dentro de Tabbit depende del selector de modelos en vivo y de los términos de tu cuenta. Tabbit no sustituye tu suscripción de API externa, sino que te ofrece una plataforma cliente de alto rendimiento para la investigación web.
 Tabbit Browser
Fuentes oficiales
Las tarifas y especificaciones de esta guía fueron verificadas a partir de la documentación oficial de los proveedores el 22 de septiembre de 2026:
Ficha del modelo en Hugging Face: XiaomiMiMo/MiMo-V2.6-Flash-RL
Ficha del modelo en Hugging Face: XiaomiMiMo/MiMo-V2.6-Pro-RL

Preguntas frecuentes
¿Cuánto cuesta MiMo-V2.6-Flash a través de la API oficial?
La API oficial lista MiMo-V2.6-Flash a 0,140 $ por millón de tokens de entrada no almacenados en caché, 0,0028 $ por millón de tokens de entrada en caché (acierto de caché) y 0,280 $ por millón de tokens de salida en USD (1,00 ¥, 0,02 ¥ y 2,00 ¥ en RMB).
¿Cuánto más barata es la entrada en caché en MiMo-V2.6-Flash?
La entrada en caché cuesta 0,0028 $ por millón de tokens frente a 0,140 $ de la entrada estándar. Esto supone una reducción de precio del 98,0 % (50 veces más barata) en los prefijos recurrentes.
¿Cómo se comparan los precios de MiMo-V2.6-Flash con los de MiMo-V2.6-Pro?
Flash es más de 3 veces más barato en entrada sin caché (0,14 $ frente a 0,435 $) y en salida (0,28 $ frente a 0,87 $). En entrada en caché, Flash cuesta 0,0028 $/M frente a 0,0036 $/M de Pro.
¿Se cobran por separado los tokens de razonamiento interno en Flash RL?
No. Xiaomi MiMo factura los tokens de razonamiento interno junto con el texto visible como tokens de salida estándar a 0,28 $ por millón de tokens. No hay ningún recargo independiente.
¿Ofrece MiMo-V2.6-Flash un modo UltraSpeed?
No. UltraSpeed es un nivel exclusivo con un recargo de 10x para MiMo-V2.6-Pro. Flash opera de forma nativa a altas velocidades (más de 140 tok/s) gracias a su arquitectura MoE de 15B parámetros activos.
¿Puedo utilizar MiMo-V2.6-Flash en Tabbit Browser?
Tabbit Browser proporciona un entorno nativo de IA para la investigación web y la automatización. La disponibilidad en directo depende del selector de modelos de tu cuenta y de las condiciones de la plataforma.