
Le tarif nominal par token ne représente jamais le coût total de résolution d'un problème d'ingénierie. Il s'agit simplement du prix d'un ingrédient brut. Sur la grille tarifaire officielle publiée par Xiaomi le 22 septembre 2026, le modèle haute efficacité MiMo-V2.6-Flash est proposé à 0,140 $ par million de tokens d'entrée sans cache et 0,280 $ par million de tokens de sortie (soit 1,00 ¥ et 2,00 ¥ en RMB). En étant plus de 3 fois plus abordable que son équivalent de pointe Pro, Flash s'impose comme l'une des options omnimodales légères les plus attractives du marché.
Cependant, la véritable rupture d'architecture repose sur deux leviers : une remise de 98,0 % (50 fois moins cher) sur la mise en cache des prompts, réduisant l'entrée en cache à 0,0028 $ par million de tokens, et une architecture MoE (Mixture-of-Experts) activant seulement 15 milliards de paramètres sur 309 milliards au total pour maintenir un débit supérieur à 140 tokens par seconde. Pour l'extraction web de masse ou les agents de navigation à haute fréquence, ces conditions transforment l'équation économique. Ce guide traduit la grille officielle en budgets opérationnels vérifiables. Pour consulter au préalable les spécifications, visitez la page du modèle MiMo-V2.6-Flash (English) ; pour la variante 1,02T, consultez notre analyse tarifaire de MiMo-V2.6-Pro.
Points clés à retenir
Tarifs de base de 0,14 $ en entrée et 0,28 $ en sortie par million de tokens, rendant Flash plus de 3 fois moins cher sur les deux axes que le modèle phare MiMo-V2.6-Pro (English) (0,435 $ / 0,87 $).
Le cache de prompts réduit les coûts d'entrée de 98,0 % : les préfixes correspondants ne coûtent que 0,0028 $/M de tokens (0,02 ¥/M), permettant de réinterroger de longs contextes d'entreprise pour quelques centimes.
UltraSpeed reste exclusif à Pro : Flash ne propose pas de niveau UltraSpeed à coût 10x, car ses 15B paramètres actifs offrent nativement une faible latence et une génération en continu très rapide.
Les tokens de raisonnement sont facturés comme de la sortie : dans les modèles RL, les chaînes de pensée internes sont comptabilisées au tarif de sortie de 0,28 $/M.
Convergence des coûts en cas de cache élevé : dans les boucles d'agents avec plus de 85 % de succès de cache, l'écart de lecture entre Pro (0,0036 $) et Flash (0,0028 $) n'est que de 0,0008 $, faisant du volume de sortie le véritable critère de choix entre les deux modèles.
Aperçu des tarifs de MiMo-V2.6-Flash
Le tableau ci-dessous synthétise les tarifs officiels vérifiés le 22 septembre 2026 sur la documentation officielle Xiaomi MiMo. Tous les montants s'entendent par million de tokens (1M).
| Variante du modèle | Entrée (Cache hit) / 1M | Entrée (Cache miss) / 1M | Sortie / 1M | Fenêtre de contexte | Sortie maximale |
|---|---|---|---|---|---|
| MiMo-V2.6-Flash | 0,0028 $ (0,02 ¥) | 0,140 $ (1,00 ¥) | 0,280 $ (2,00 ¥) | 1 048 576 | 131 072 |
| MiMo-V2.6-Pro | 0,0036 $ (0,025 ¥) | 0,435 $ (3,00 ¥) | 0,870 $ (6,00 ¥) | 1 048 576 | 131 072 |
| DeepSeek V4.1 Flash | 0,0030 $ (0,021 ¥) | 0,150 $ (1,05 ¥) | 0,300 $ (2,10 ¥) | 1 048 576 | 8 192 |
| Gemini 3.8 Flash | 0,0375 $ | 0,150 $ | 0,600 $ | 1 048 576 | 8 192 |
Ce comparatif met en évidence une stratégie claire : MiMo-V2.6-Flash rivalise directement avec DeepSeek V4.1 Flash et Gemini 3.8 Flash tout en proposant une capacité de sortie atteignant 131 072 tokens sur un contexte complet de 1 million de tokens.
Le chiffre déterminant : 0,0028 $ par million de tokens en cache
Pour les ingénieurs d'infrastructure, l'indicateur décisif est 0,0028 $ / 1M tokens (0,02 ¥ / 1M). Cela représente une réduction exacte de 98,0 % (50 fois moins cher) par rapport au tarif d'entrée sans cache de 0,140 $.
Dans les environnements d'automatisation, tels qu'un flux de raisonnement d'agent, un agent autonome consulte à répétition la structure DOM, extrait des données complexes et valide des formulaires. Renvoyer un contexte web de 100 000 tokens pendant 20 tours sans mise en cache consomme 2 millions de tokens d'entrée (0,28 $). Avec la mise en cache automatique, ces 20 tours coûtent moins de 0,006 $ sur la ligne d'entrée.
De plus, l'architecture MoE dispersée de Flash n'active que 15B paramètres sur 309B, garantissant un délai d'émission du premier token (TTFT) très bas et une vitesse de croisière excédant 140 tokens par seconde.
Décryptage des promesses d'efficacité officielles
Xiaomi positionne MiMo-V2.6-Flash comme la solution idéale pour les pipelines de données d'entreprise où la qualité de raisonnement doit s'accorder avec des contraintes de coût strictes. Malgré des coûts unitaires favorables, deux règles opérationnelles doivent être prises en compte :
Comptabilisation des tokens de raisonnement en mode RL : La version
MiMo-V2.6-Flash-RLintègre des étapes d'évaluation par apprentissage par renforcement. Même si le coût de sortie est bas (0,28 $/M), des requêtes complexes peuvent produire de 3 000 à 6 000 tokens de réflexion interne avant d'émettre une réponse finale de 200 tokens. Les tokens de pensée étant facturés comme de la sortie, la dépense réelle dépend de la profondeur d'analyse.Alignement rigoureux des préfixes : Pour bénéficier du tarif de 0,0028 $, le début du prompt doit rester identique. L'insertion d'horodatages dynamiques ou d'identifiants aléatoires au début de l'instruction invalide le cache et applique le plein tarif de 0,140 $/M.
Formules validées pour calculer vos coûts :
coût par requête = (entrée sans cache × 0,140
                  + entrée en cache × 0,0028
                  + sortie totale avec réflexion × 0,280) / 1 000 000
budget mensuel = (coût moyen par requête × volume de requêtes) + marge de retry
Lignes de facturation hors tableau principal
L'estimation du coût total de possession (TCO) exige d'intégrer les règles complémentaires de l'API Xiaomi MiMo :
Absence d'UltraSpeed sur Flash : Contrairement au modèle Pro qui propose une variante
mimo-v2.6-pro-ultraspeedavec multiplicateur 10x (4,35 $ entrée, 8,70 $ sortie), Flash ne requiert aucun palier accéléré grâce à la vitesse naturelle de son architecture 15B active.Abonnements mensuels Token Plan : Pour les développeurs préférant des forfaits fixes en RMB :
Plan Lite (39 ¥ / mois) : Pour les tests individuels et scripts légers.
Plan Standard (99 ¥ / mois) : Pour les tâches quotidiennes d'extraction de données.
Plan Pro (329 ¥ / mois) : Concurrence accrue pour les chaînes de production.
Plan Max (659 ¥ / mois) : Volume garanti pour les ingestions massives d'entreprise.
Limites de débit et concurrence : Les clés API standard sont soumises à des quotas RPM et TPM. Les équipes déployant de grands parcs de crawlers doivent solliciter un relèvement de plafond.
Fin de vie des versions V2.5 : La gamme MiMo-V2.5 sera arrêtée le 21 octobre 2026. Les projets en production doivent basculer sans délai vers V2.6.
Comparatif de la gamme MiMo
| Niveau de modèle | Idéal pour | Entrée / 1M (Miss / Hit) | Sortie / 1M | Profil de débit et latence |
|---|---|---|---|---|
| MiMo-V2.6-Flash | Extraction web massive, tri d'informations, résumés | 0,140 $ / 0,0028 $ | 0,280 $ | Très haut débit (140+ tok/s), 15B actifs MoE |
| MiMo-V2.6-Pro | Programmation avancée, logique complexe, démonstrations | 0,435 $ / 0,0036 $ | 0,870 $ | Raisonnement approfondi, 42B actifs / 1,02T total MoE |
| MiMo-V2.6-Pro-UltraSpeed | Agents vocaux interactifs, support client temps réel | 4,350 $ / 0,0360 $ | 8,700 $ | Débit maximal (vitesse jusqu'à 20x, coût 10x) |
La conclusion contre-intuitive de cette grille réside dans la gestion du cache : sur des requêtes uniques sans cache, Flash est 3,1 fois moins cher que Pro. Mais dans une boucle d'agent avec 90 % de cache, l'écart de coût d'entrée entre Flash (0,0028 $) et Pro (0,0036 $) ne représente que 0,0008 $ par million de tokens. Le choix dépend alors presque exclusivement du volume de sortie (0,28 $ contre 0,87 $) et du besoin en puissance logique. Retrouvez d'autres comparaisons dans notre comparatif des navigateurs IA 2026.
Ce qui n'est pas facturé et les coûts indirects
Définir des frontières claires préserve votre budget des surprises :
Aucun frais horaire de stockage de cache en fenêtre de base : Contrairement aux fournisseurs qui facturent la conservation horaire des contextes, Xiaomi MiMo facture uniquement les lectures effectives lors des accès au cache.
Aucun coût sur les rejets de sécurité : Les requêtes stoppées par les filtres de sécurité ne facturent pas les tokens de complétion non générés.
Les tokens de réflexion sont payants : En mode RL, les étapes d'analyse interne sont facturées comme de la sortie ordinaire à 0,28 $/M.
Les échecs d'exécution consomment du crédit : Si votre robot rencontre des boucles de captcha ou des erreurs d'analyse, l'ensemble des tokens émis reste exigible.
Retours d'expérience de la communauté
Les témoignages recueillis sur les plateformes techniques confirment les comportements constatés en production :
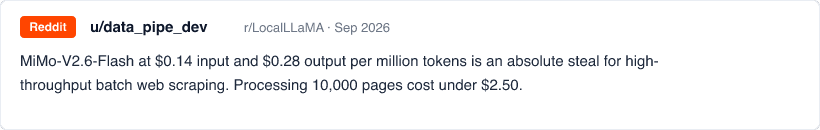
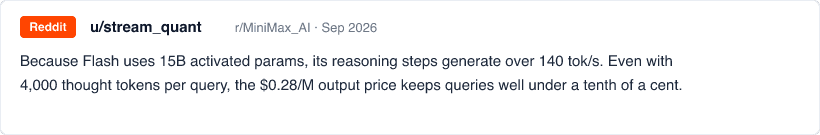
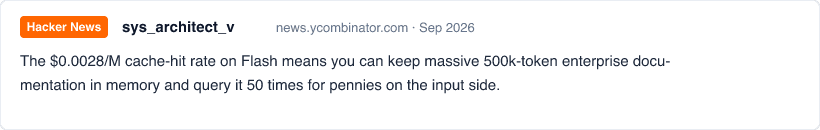
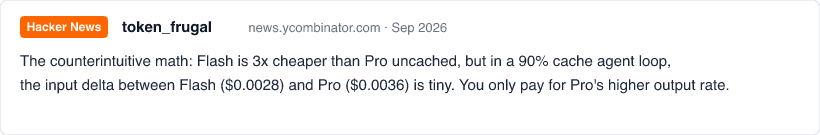
Ces retours confirment une règle simple : utilisez Flash pour le traitement en masse et basculez vers Pro uniquement lorsqu'une complexité algorithmique élevée l'impose.
Deux exemples de charges de travail reproductibles
Pour illustrer ces tarifs dans des scénarios réels, nous présentons deux calculs basés sur les tarifs officiels en USD :
Cas 1 : Extraction par lots de pages web (Gros volume, cache modéré)
Entrée : 15 000 tokens par page (HTML brut et règles d'extraction) ; 25 % de cache (3 750 tokens en cache, 11 250 sans cache).
Sortie : 800 tokens (données JSON structurées).
Coût unitaire :
(11 250 × 0,140 $ + 3 750 × 0,0028 $ + 800 × 0,280 $) / 1 000 000 = 0,001575 $ + 0,0000105 $ + 0,000224 $ = 0,00181 $par page.10 000 pages / mois : 18,10 $ / mois. (Le même travail sur MiMo-V2.6-Pro s'élèverait à 55,97 $ / mois, soit 68 % d'économie avec Flash !).
Cas 2 : Agent d'analyse documentaire multi-tours (Cache élevé)
Entrée : 300 000 tokens cumulés sur 10 interactions d'outils ; 85 % de cache (255 000 tokens en cache, 45 000 nouveaux tokens).
Sortie : 5 000 tokens au total (filtrage, synthèse et conclusion).
Coût unitaire :
(45 000 × 0,140 $ + 255 000 × 0,0028 $ + 5 000 × 0,280 $) / 1 000 000 = 0,00630 $ + 0,000714 $ + 0,00140 $ = 0,00841 $par tâche.500 tâches / mois : 4,21 $ / mois. Sans mise en cache, l'entrée coûterait 0,042 $ par exécution, portant la facture à 21,70 $ / mois (plus de 5 fois plus cher).
| Type de charge | Tokens d'entrée | Part de cache | Tokens de sortie | Volume mensuel | Coût mensuel estimé |
|---|---|---|---|---|---|
| Extraction web de masse | 15 000 | 25 % | 800 | 10 000 | 18,10 $ |
| Agent d'analyse documentaire | 300 000 | 85 % | 5 000 | 500 | 4,21 $ |
Calcul local
Estimez le coût mensuel des tokens
Tarifs officiels de l'API vérifiés en septembre 2026. Comptez la réflexion dans la sortie. Vos données restent dans le navigateur.
Exclut les appels d'outils et nouvelles tentatives. Lecture de cache Pro et Flash à 0,0036 $ et 0,0028 $ par million de tokens. Vérifié le 22-09-2026. Vérifier les tarifs actuels
Le simulateur ci-dessus s'exécute localement dans votre navigateur sans transférer de données. Vous pouvez y ajuster vos volumes pour comparer les coûts entre Flash, Pro et UltraSpeed.
Orchestration de vos flux dans le navigateur Tabbit
Évaluer vos coûts de tokens n'est que la première étape. Vos agents ont ensuite besoin d'un environnement pour interagir avec le web réel. Déployer des instances headless et gérer les sessions demande des efforts d'ingénierie constants.
Tabbit Browser offre un espace de travail natif d'IA où les agents automatisés naviguent sur des sites interactifs, collectent des données propres et comparent des informations d'un onglet à l'autre. Pour comprendre l'apport de ces technologies, consultez nos articles sur qu'est-ce qu'un navigateur d'agents et les meilleurs navigateurs IA en 2026.
Comme le rappellent nos documentations de projet, la disponibilité effective des modèles dans Tabbit dépend du sélecteur actif de votre compte et des conditions du service. Tabbit ne se substitue pas à votre compte d'API externe, mais procure une interface client hautement productive pour vos tâches web.
 Tabbit Browser
Sources officielles
Les tarifs et spécifications mentionnés dans cette étude ont été relevés le 22 septembre 2026 sur les canaux officiels :

Questions fréquentes
Combien coûte MiMo-V2.6-Flash via l'API officielle ?
La grille tarifaire officielle indique 0,140 $ par million de tokens d'entrée sans cache, 0,0028 $ par million de tokens d'entrée en cache (succès de cache) et 0,280 $ par million de tokens de sortie en USD (1,00 ¥, 0,02 ¥ et 2,00 ¥ en RMB).
Quelle est l'économie réalisée grâce au cache de prompts sur MiMo-V2.6-Flash ?
L'entrée en cache coûte 0,0028 $ par million de tokens, contre 0,140 $ sans cache. Cela représente une réduction de 98,0 % (50 fois moins cher) sur les préfixes récurrents.
Comment se comparent les prix de MiMo-V2.6-Flash et MiMo-V2.6-Pro ?
Flash est plus de 3 fois moins cher sur l'entrée sans cache (0,14 $ contre 0,435 $) et sur la sortie (0,28 $ contre 0,87 $). En entrée en cache, Flash est à 0,0028 $/M contre 0,0036 $/M pour Pro.
Les tokens de raisonnement interne sont-ils facturés séparément dans Flash RL ?
Non. Xiaomi MiMo facture les tokens de raisonnement avec le texte de sortie au tarif standard de sortie de 0,28 $ par million de tokens. Il n'y a pas de surtaxe dédiée à la réflexion.
MiMo-V2.6-Flash propose-t-il un mode UltraSpeed ?
Non. UltraSpeed est un palier à coût 10x exclusif à MiMo-V2.6-Pro. Flash génère nativement plus de 140 tok/s grâce à ses 15B paramètres actifs au sein de son architecture MoE.
Puis-je utiliser MiMo-V2.6-Flash dans le navigateur Tabbit ?
Le navigateur Tabbit offre un environnement natif d'IA pour la recherche web et l'automatisation. La disponibilité en direct dépend du sélecteur de modèle de votre compte et des conditions de la plateforme.