
官方标出的 Token 单价永远不是解决工程问题的全部成本,它仅仅是原材料的价格。在小米于 2026 年 9 月 22 日正式发布的官方费率表中,面向高效率与高吞吐场景的 MiMo-V2.6-Flash 定价为每百万未缓存输入 token 1.00 元(0.140 美元),每百万输出 token 2.00 元(0.280 美元)。相比旗舰兄弟模型 Pro 便宜了超过 3 倍,这一极具竞争力的定价直接向轻量级模型市场发起冲击。
然而,真正决定大规模落地可行性的底层机制在于两点:一是高达 50 倍(98.0% 折扣)的 Prompt 缓存优惠,将缓存命中输入的成本压低至每百万 token 0.020 元(0.0028 美元);二是其稀疏混合专家(MoE)设计在 309B 总参数中仅激活 15B 参数,保证了超过 140 tok/s 的极速生成吞吐。对于大规模批量数据抓取、实时信息分类与高频浏览器智能体来说,这彻底改变了单位工作量的成本公式。本指南旨在将官方费率表转化为可复算的工程预算。如需查看技术规格,请访问 MiMo-V2.6-Flash 模型页;如需了解 1.02T 旗舰版,可参阅 MiMo-V2.6-Pro 定价解析。
核心结论
基础按量费率为输入 1.00 元/M、输出 2.00 元/M,名义调用成本较旗舰级 MiMo-V2.6-Pro(3 元/M 输入、6 元/M 输出)直降超过 3 倍。
Prompt 缓存带来 98.0% 的输入成本削减:匹配的前缀仅需 0.020 元/M(0.0028 美元),使长前缀与参考文档的多轮查询成本几乎归零。
无需额外购买 UltraSpeed 档位:Flash 凭借 15B 激活参数的 MoE 架构原生具备 140+ tok/s 吞吐,官方未设置也不需要 10 倍加价的极速端点。
思考推理 Token 计入输出行:在 RL 推理版本中,思维链消耗同样按 2.00 元/M 输出计费,无上限的深度发散推理依然会增加账单。
反直觉的高缓存成本收敛:在缓存命中率超过 85% 的深层 Agent 循环中,Pro 的缓存读取成本(0.025 元/M)与 Flash(0.020 元/M)仅差 0.005 元,两者的实际成本差异几乎全在输出端。
MiMo-V2.6-Flash 费率全貌速查
下表整理自 小米 MiMo 官方开发者文档,核验日期为 2026 年 9 月 22 日。所有费率均以每 100 万 token(1M)为单位标示。
| 模型型号 | 输入(缓存命中)/ 1M | 输入(缓存未命中)/ 1M | 输出 / 1M | 上下文窗口 | 最大输出限制 |
|---|---|---|---|---|---|
| MiMo-V2.6-Flash | ¥0.020 ($0.0028) | ¥1.00 ($0.140) | ¥2.00 ($0.280) | 1,048,576 | 131,072 |
| MiMo-V2.6-Pro | ¥0.025 ($0.0036) | ¥3.00 ($0.435) | ¥6.00 ($0.870) | 1,048,576 | 131,072 |
| DeepSeek V4.1 Flash | ¥0.021 ($0.0030) | ¥1.05 ($0.150) | ¥2.10 ($0.300) | 1,048,576 | 8,192 |
| Gemini 3.8 Flash | ¥0.263 ($0.0375) | ¥1.05 ($0.150) | ¥4.20 ($0.600) | 1,048,576 | 8,192 |
这张费率表展现了明确的市场定位:MiMo-V2.6-Flash 在价格上全面对标并略微超越 DeepSeek V4.1 Flash 与 Gemini 3.8 Flash,同时在 100 万 token 上下文内提供了高达 131,072 token 的最大输出空间。
变化的关键数字:0.020 元/百万缓存 Token
对于高并发与高频任务的基础设施架构师而言,核心指标是 0.020 元 / 1M token(0.0028 美元)。相比未缓存输入的 1.00 元/M,降幅高达 98.0%(即降低至 1/50)。
在实际的网页智能体场景中,例如执行 长程智能体推理工作流 时,智能体往往需要对同一页面的 DOM 结构、全局指令或知识库进行多轮反思、工具调用与结果比对。如果一段 10 万 token 的网页上下文在 20 轮交互中反复提交且未开启缓存,将消耗 200 万未缓存输入 token(花费 2.00 元)。而在 Prompt 自动缓存机制下,这 20 轮中的重复前缀输入成本仅需约 0.04 元。
与此同时,Flash 模型的轻量 MoE 设计使其首字延迟(TTFT)极低,生成吞吐保持在 140 tok/s 以上,确保大规模批量爬虫抽取与实时信息过滤不会受制于排队等待。
拆解官方“极致性价比”声明
小米在发布通稿中强调 MiMo-V2.6-Flash 是企业级大规模数据管线的理想选择。虽然按量单价优势显著,但在生产级系统架构设计中必须警惕两个实际约束:
RL 推理模式下的思维链计费:
MiMo-V2.6-Flash-RL检查点引入了强化学习推理能力。虽然 Flash 的输出单价低至 2 元/M,但在复杂的多步骤指令下,模型可能在给出 200 字结构化输出前生成 3,000 到 6,000 字的思考过程。由于思考 token 全部归入输出计费行,单个请求的实际花费取决于推理发散程度,而非 Prompt 长度。前缀缓存的对齐稳定性:只有请求前缀严格匹配时才能触发 0.020 元/M 的优惠价。如果在 Prompt 头部插入动态时间戳、随机请求标识或变动不定的系统变量,将导致全量缓存失效,直接退回 1.00 元/M 的未缓存费率。
单次调用与月度预算的复算公式如下:
单次调用成本 = (未缓存输入 × 1.00
              + 缓存命中输入 × 0.020
              + 包含思考在内的输出 × 2.00) / 1,000,000
月度总预算 = (平均单次成本 × 月度计费任务数) + 重试容灾余量
主线费率表之外的细则
全面评估 TCO(总体拥有成本)还需要关注小米 MiMo 平台的边缘规则:
Flash 无需且没有 UltraSpeed 档位:与旗舰级 Pro 提供 10 倍加价的
mimo-v2.6-pro-ultraspeed(输入 30 元/M、输出 60 元/M)不同,Flash 凭借 15B 激活参数的 MoE 特性本身就具备极速吞吐,不存在也不需要昂贵的极速加价模式。Token Plan 包月订阅套餐:针对中小型团队与独立开发者,小米提供人民币定价的固定额度套餐:
Lite 版(39 元/月):适合个人轻量测试与脚本实验;
Standard 版(99 元/月):适合日常爬虫清洗与中频任务;
Pro 版(329 元/月):提供更高并发通道,满足生产流水线需求;
Max 版(659 元/月):企业级吞吐保障,满足海量数据摄入。
并发与频次限制(Rate Limits):按量计费 API 受平台 RPM(每分钟请求数)与 TPM(每分钟 token 数)限制约束,高并发批量抽取需提前申请提额。
初代 V2.5 生命周期截止:旧版 MiMo-V2.5 模型将于 2026 年 10 月 21 日正式停止服务,调用方应尽快迁移至 V2.6 端点。
家族阶梯对比与选型决策
| 模型型号 | 最佳适用工作负载 | 输入 / 1M(未命中 / 命中) | 输出 / 1M | 吞吐与延迟表现 |
|---|---|---|---|---|
| MiMo-V2.6-Flash | 海量网页清洗、高频分类过滤、文档初筛与摘要 | ¥1.00 / ¥0.020 | ¥2.00 | 极高吞吐(140+ tok/s),15B 激活 MoE |
| MiMo-V2.6-Pro | 复杂代码重构、多步数学证明、深度逻辑推理 | ¥3.00 / ¥0.025 | ¥6.00 | 深度推理,42B 激活 / 1.02T 总参数 MoE |
| MiMo-V2.6-Pro-UltraSpeed | 实时语音对齐、毫秒级交互式客服系统 | ¥30.00 / ¥0.250 | ¥60.00 | 极速响应(生成速度提速最高 20 倍,成本 10 倍) |
这一梯队中存在一个反直觉的决策拐点:在单轮零缓存任务中,Flash 相比 Pro 便宜整整 3.1 倍;但当进入多轮深度 Agent 循环、Prompt 缓存命中率达到 90% 以上时,Flash 与 Pro 的输入端成本相差无几(0.020 元 vs 0.025 元)。此时,是否升级为 1.02T 参数的 Pro 模型,几乎只取决于输出 token 量(2 元 vs 6 元)以及任务对高难度逻辑的硬性要求。更多模型对比可参考我们的 2026 年 AI 浏览器横评指南。
不收钱的边界与隐性开销
明确计费边界是避免账单失控的关键:
基础窗口内免收缓存常驻保留费:与部分云厂商按小时收取缓存存储费不同,小米 MiMo 目前仅按缓存读取命中量收费,空闲等待不按小时叠加存储费。
平台安全合规拦截免收生成费:因平台护栏触发或安全策略主动截断的请求,后续未生成的投机 token 不予扣费。
思考 Token 属于正规计费项:RL 模式下的内省思维链不是免费赠品,统一按 2 元/M 输出标准全额扣费。
业务失败与重试同样消耗资金:若爬虫遭遇验证码死循环、解析脚本异常导致多轮重试,产生的全部 token 均需如实结账。
开发者真实反馈台账
来自技术社区的一手实测记录反映了 MiMo-V2.6-Flash 在生产环境中的真实表现:
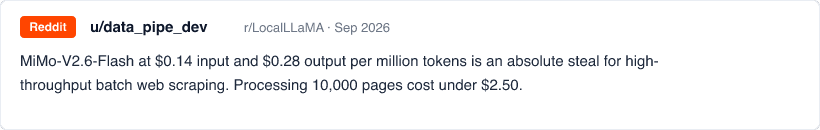
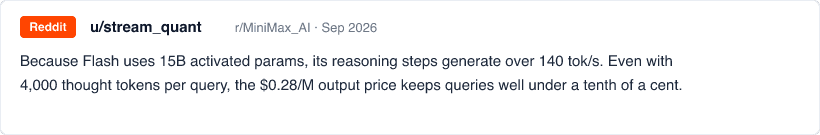
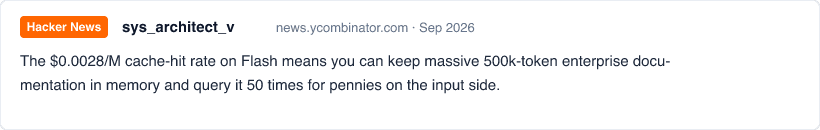
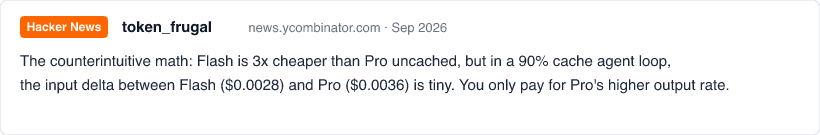
这些实践经验指明了统一的最佳实践:用 Flash 承揽海量抽取与清洗,仅在遇到高难度复杂代码与逻辑瓶颈时再切回 Pro。
两个可复现的真实业务算例
为了将抽象单价落实为企业预算,我们给出基于 2026 年官方费率的两个代表性算例:
算例 1:高并发网页数据批量结构化提取(海量请求、低缓存复用)
单任务输入:每页 15,000 token(HTML 源码及抽取规范);25% 缓存命中(3,750 命中 token,11,250 未命中 token)。
单任务输出:800 token(结构化 JSON 清洗结果)。
单次成本:
11,250 × ¥1.00/M + 3,750 × ¥0.020/M + 800 × ¥2.00/M = ¥0.01125 + ¥0.000075 + ¥0.0016 = ¥0.012925(约 1.29 分钱)。每月 10,000 页:¥129.25 / 月(约 18.10 美元)。同等业务若调用 MiMo-V2.6-Pro 则需花费 ¥399.75 / 月,Flash 直接节省 68%!
算例 2:多轮长文档对比与研报总结(深度上下文、高缓存命中)
单任务输入:跨 10 轮工具交互累积 300,000 token;85% 缓存命中(255,000 命中 token,45,000 新增 token)。
单任务输出:5,000 token(规划、清洗与最终总结文本)。
单次成本:
45,000 × ¥1.00/M + 255,000 × ¥0.020/M + 5,000 × ¥2.00/M = ¥0.045 + ¥0.0051 + ¥0.010 = ¥0.0601(约 6 分钱)。每月 500 次任务:¥30.05 / 月(约 4.21 美元)。若无 Prompt 缓存,仅输入端就需要花费 ¥0.21/次,月开销将飙升至 ¥155.00 / 月,成本高出 5 倍以上。
| 业务场景 | 输入 Token | 缓存比例 | 输出 Token | 每月任务量 | 每月 Token 费用 |
|---|---|---|---|---|---|
| 高频批量网页清洗 | 15,000 | 25% | 800 | 10,000 次 | ¥129.25 ($18.10) |
| 多轮长文档智能体 | 300,000 | 85% | 5,000 | 500 次 | ¥30.05 ($4.21) |
本地计算
估算每月 token 成本
使用 2026 年 9 月核对的官方 API 费率。思考 token 计入输出,无需重复加算。所有输入均在本地浏览器处理。
不含工具调用、重试和网络开销。Pro 与 Flash 缓存读取费率分别为 $0.0036 与 $0.0028/百万 token。核对日期:2026-09-22。 核对最新费率
上方计算器完全在本地浏览器中运行,无需向外部传输任何业务数据。您可以在其中自由调整输入规模与缓存比例,对比 Flash、Pro 与 UltraSpeed 的成本差异。
在 Tabbit 浏览器中编排真实业务流
算清 Token 账单仅仅是第一步,智能体仍然需要一个能够稳定运行的网页环境。自行维护无头浏览器池、处理登录鉴权与复杂滚动加载,往往需要耗费大量基础设施运维精力。
Tabbit 浏览器 提供了原生 AI 浏览器工作空间,智能体可以直接在真实浏览器标签页中执行多源信息检索、表格结构化提取与跨会话事实核对。如果您正在探索智能体浏览器的前沿架构,欢迎阅读我们的深度解析 什么是智能体浏览器 以及 2026 年最佳 AI 浏览器横向横评。
依据项目公开记录,Tabbit 内的模型可用性以您登录账号的实时模型选择器与平台条款为准。Tabbit 并不替代您外部的独立 API 账户,而是为您提供高杠杆的网页级自动化操作台。
 Tabbit Browser
官方来源与参考
本文费率与模型规格均核验自 2026 年 9 月 22 日官方发布信息:

常见问题
MiMo-V2.6-Flash 官方 API 的调用价格是多少?
官方公布的 API 费率显示,MiMo-V2.6-Flash 未缓存输入为每百万 token 1.00 元(0.140 美元),缓存命中输入为每百万 token 0.020 元(0.0028 美元),输出为每百万 token 2.00 元(0.280 美元)。
MiMo-V2.6-Flash 的 Prompt 缓存能便宜多少?
Prompt 缓存命中输入费率为每百万 token 0.020 元(0.0028 美元),相比未缓存的 1.00 元降低了整整 50 倍(即 98.0% 的折扣),能极大削减多轮交互中的重复输入成本。
MiMo-V2.6-Flash 的定价与旗舰 Pro 相比如何?
在未缓存输入(1.00 元 vs 3.00 元)和输出(2.00 元 vs 6.00 元)上,Flash 比 Pro 便宜超过 3 倍;在缓存命中输入上,Flash 为 0.020 元/M,Pro 为 0.025 元/M,两者的缓存读取成本极为接近。
Flash RL 模型的思考推理(Reasoning)Token 会单独收费吗?
不会单独设立计费项。小米 MiMo 将思考推理生成的 token 与正式输出文本合并,统一按照每百万 token 2.00 元(0.280 美元)的标准输出费率计费。
MiMo-V2.6-Flash 是否提供 UltraSpeed 极速模式?
不提供。UltraSpeed 模式是旗舰 MiMo-V2.6-Pro 独占的 10 倍加价档位。Flash 本身依靠 15B 激活参数的轻量 MoE 架构,原生输出速度即可稳定在 140+ tok/s,无需额外加价极速档。
可以在 Tabbit 浏览器中直接调用 MiMo-V2.6-Flash 吗?
Tabbit 浏览器为网页研究与智能体工作流提供了原生环境;模型在 Tabbit 内的具体可用性以当前登录账号的模型选择器与平台条款为准。