
如果任務需要讀取截圖,或者你優先考慮較低的公開 API 價格,可以先試 LongCat 2.5。如果必須自己部署模型權重,先看 GLM-5.3。程式設計能力則需要用相同任務驗證:發布會上的分數和價格表都無法替你判斷程式碼庫裡的實際結果。
價格差異值得算清。2026 年 11 月 3 日,LongCat 限時價格為每百萬未命中快取輸入 token 0.30 美元、輸出 token 1.20 美元;Z.ai 的 GLM-5.3 分別為 1.40 美元和 4.40 美元。這是各自官方 API 的單價,並非 Tabbit 訂閱價格,也沒有說明完成任務分別需要多少 token。
一位 Reddit 使用者讓 LongCat 2.5 Preview 在 OpenCode 中分析五個 C# 類,報告了重複推理和長時間未完成請求。這只是一次預覽版體驗,不能代表正式版;它提醒我們在自己的測試中設定停止條件和驗收標準。下文也會用 Tabbit Browser 展示一次費用計算樣例。
主要結論
LongCat 2.5 支援視覺輸入;Z.ai 文件將 GLM-5.3 描述為僅接受文字輸入。
調研時 LongCat 2.5 發布頁仍將權重標為即將推出;GLM-5.3 已公開模型倉庫,使用前需核對專屬授權條款。
美團表格中的程式設計任務各有領先者;部分 GLM 分數來自其他公開報告,並非同條件重新測試。
LongCat 官方 API 的當前價格更低,但屬於限時折扣;應比較每個合格任務的總成本。
Preview 社群回饋有助於發現風險,不能作為正式版成績。
LongCat 2.5 與 GLM-5.3 速覽
| 決策項 | LongCat 2.5 | GLM-5.3 | 使用前檢查 |
|---|---|---|---|
| 輸入 | 文字和視覺輸入 | 文字輸入 | 客戶端和介面是否開放所需輸入型別。 |
| 上下文 | 1,048,576 token,含輸入和輸出 | 約 100 萬 token | 大視窗不保證檢索準確。 |
| 思考 | 參數指南支援開啟或關閉 | 始終開啟,可選 low、high、max | 不同思考強度會改變用量與結果。 |
| 權重 | 發布頁稱 GitHub 和 Hugging Face 即將推出 | 已公開權重與部署說明 | 核查授權和硬體成本。 |
| 官方 API 每百萬輸入 / 輸出 | $0.30 / $1.20,限時折扣 | $1.40 / $4.40 | 購買前重查價格及快取條件。 |
上表依據 LongCat 發布頁、參數文件、GLM-5.3 文件 和 GLM 模型卡。想了解各自的發展背景,可閱讀 GLM-5.3 總覽和 LongCat 2.0 總覽;後者是上一代,不能直接當作 2.5 的規格。
程式設計基準:分數要連同測試條件看
下表來自美團發布頁。星號表示 GLM 分數取自公開報告或榜單,不一定與 LongCat 在完全相同條件下重新執行。
| 基準 | LongCat 2.5 | 美團表中的 GLM-5.3 | 可對應的任務 |
|---|---|---|---|
| Terminal-Bench 2.1 | 88.4 | 88.2* | 多步驟終端操作 |
| Terminal-Bench 4.0 | 38.5 | 41.8* | 更復雜的終端任務 |
| DeepSWE v1.1 | 64.6 | 66.9* | 軟體工程問題 |
| NL2Repo | 60.5 | 58.0* | 根據描述構建程式碼庫 |
來源:美團評測表,核對日期為 2026 年 11 月 3 日。美團稱 LongCat 的 Terminal-Bench 2.1 使用 Claude Code 2.1.280,結果為三次平均;GLM 模型卡對應測試則列出 Claude Code 2.1.207。代理版本、工具、超時、提示詞和輸出預算都會影響結果,第一行的微小差距不足以決定哪個更適合你的專案。
把這些指標轉成可檢查的實際任務。對於現有程式碼庫,可以選一個已有失敗測試的缺陷,檢查測試能否透過以及 diff 是否修改了無關程式碼。對於新專案,先寫清驗收行為,再讓模型實現。GLM 提示詞資源和測評資料可以輔助設計任務,但不能代替你自己的驗收條件。
API 價格:比較完成任務的成本
LongCat 價格頁將當前價格標為限時折扣;Z.ai 價格頁列出了 GLM 價格。以下均為 2026 年 11 月 3 日核對的美元價格,單位是每百萬 token,不含其他工具或服務商費用。
| 官方 API | 未命中快取輸入 | 快取輸入 | 輸出 |
|---|---|---|---|
| LongCat 2.5,限時折扣 | $0.30 | $0.006 | $1.20 |
| Z.ai GLM-5.3 | $1.40 | $0.26 | $4.40 |
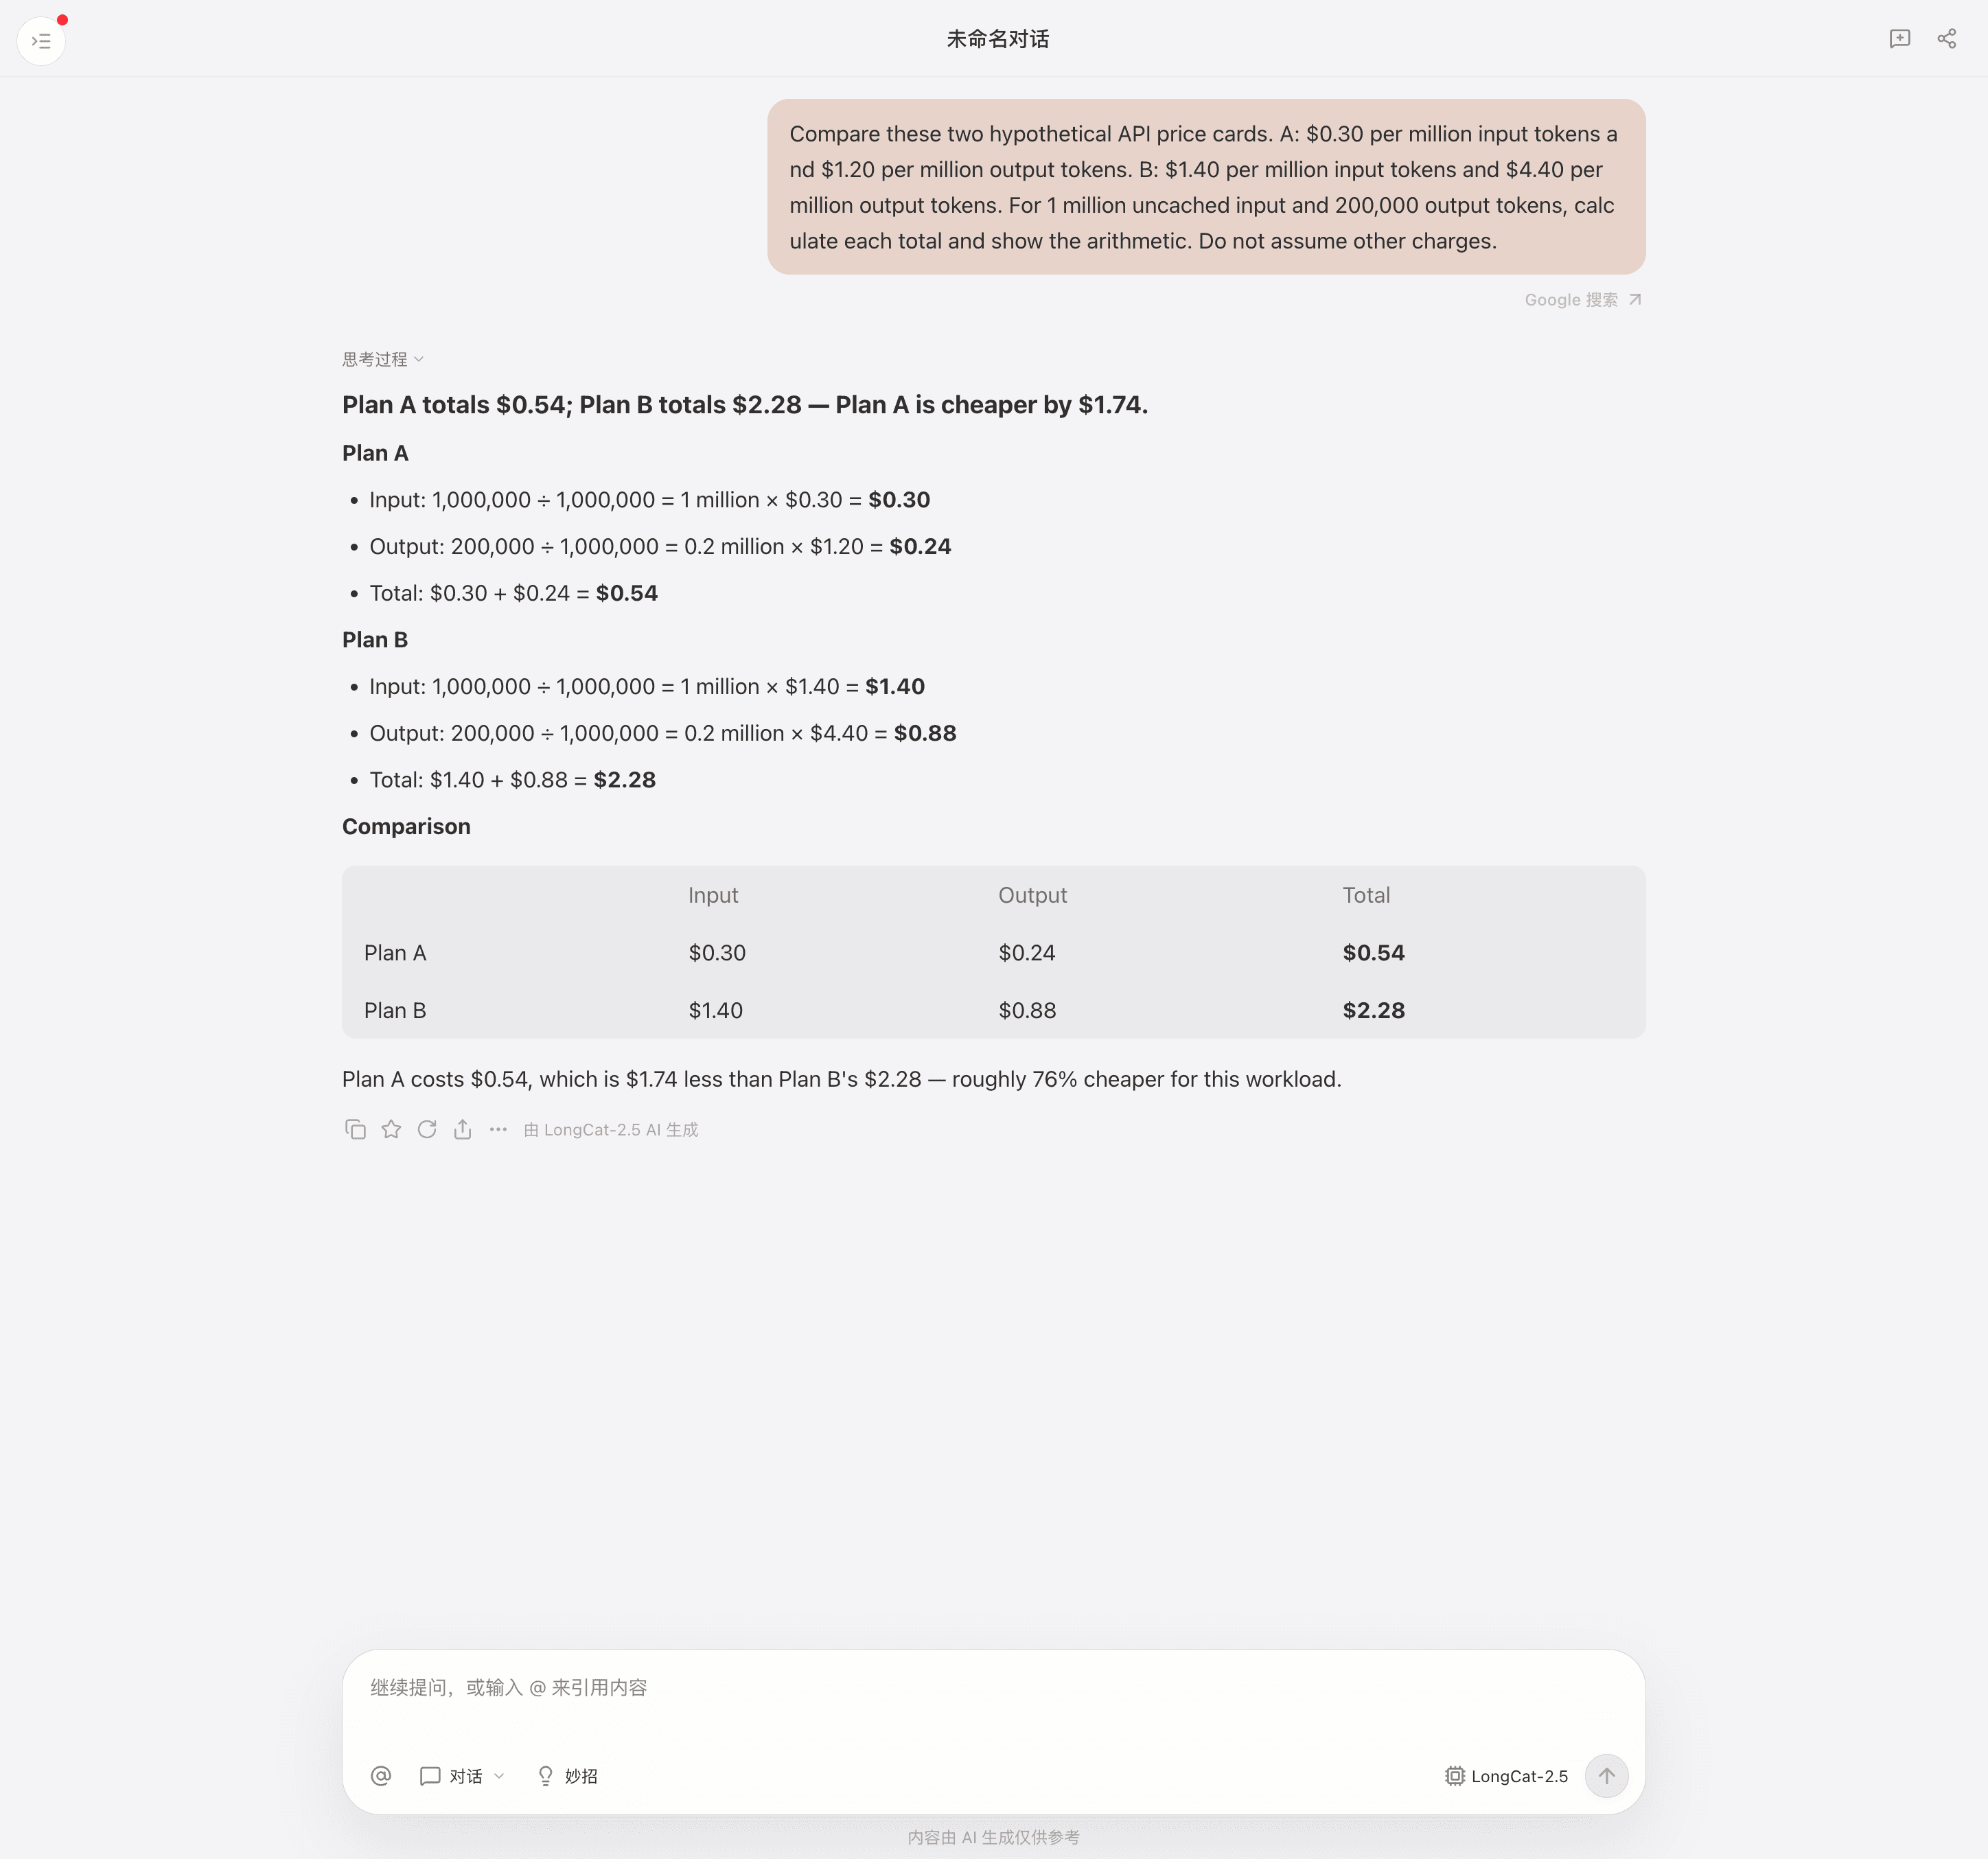
假設兩者都使用 100 萬未命中快取的輸入 token 和 20 萬輸出 token,不計工具費用:LongCat 為 $0.54,GLM-5.3 為 $2.28。這只是相同 token 數量下的算術,不意味著兩個模型的實際用量或成功率相同。
每個合格任務的成本 = 模型和工具總支出 / 透過驗收的任務數如果可以測量,應納入失敗、重試、重複上下文、快取未命中和人工稽核成本。Z.ai 還單列內建搜尋費用;Coding Plan、第三方服務商和 Tabbit 賬戶各有計費方式,不能混用。
截圖輸入、上下文和輸出限制
LongCat 2.5 的發布說明介紹了原生視覺理解。可以用介面截圖、相關檔案和明確的視覺驗收條件做測試,隨後仍需在瀏覽器檢查生成結果和可訪問性。支援看圖不代表生成的介面一定正確。
Z.ai 的文件稱 GLM-5.3 僅支援文字輸入。截圖任務需要額外的視覺元件,或先提供經過核驗的文字描述。這是模型輸入的區別,不代表所有基於 GLM 的產品都無法處理圖片。
兩家都公佈約 100 萬 token 上下文。LongCat 明確指出輸入與輸出共享視窗,其參數頁列出 max_tokens 上限 262,144,而快速入門寫最大輸出 128K。兩處尚有衝突,依賴具體數值前請驗證使用的介面。Z.ai 文件稱 GLM-5.3 最大輸出為 128K;客戶端也可能設定更低上限。
權重和部署
調研當天,LongCat 2.5 發布頁的 GitHub 與 Hugging Face 連結仍標記為即將推出。這不能證明未來的發布日期或授權。若必須自行部署,應重新確認官方倉庫和條款;LongCat 2.0 的 MIT 授權不能自動套用到 2.5。
GLM-5.3 已公開 Hugging Face 模型卡,列出 vLLM、SGLang 等部署方式。頁面授權條款標籤為 glm-5.3,應按自己的用途閱讀條款。可下載權重仍需要支付硬體、運維、安全與支援成本。模型卡列出 753B 參數,應根據量化方式和上下文估算實際記憶體,而不是把啟用參數直接當作硬體需求。
Preview 使用者回饋的邊界
在上述 C# 報告中,作者描述了重複和未完成請求。可以據此檢查自己的工具呼叫日誌,並在反覆無進展時停止;不能據此斷定正式版也有同樣問題。
另一位 Reddit 使用者對 Preview 執行 Terminal-Bench 2.1,每項任務跑三次,並報告該配置中的異常與超時較少。作者同時提到一項任務在本機持續失敗;測試物件中也沒有 GLM-5.3。這兩條回饋來自不同環境,不能合併成正式版排名。
怎樣做一次公平測試
選五個有代表性、可回滾的任務,覆蓋實際工作中常見的缺陷、多檔案修改或失敗恢復。
固定程式碼版本、工具權限、時間預算和驗收測試。測試環境不要放入金鑰或生產憑據。
記錄模型與服務商、代理版本、思考設定、提示詞、上下文、token、工具錯誤、耗時和最終 diff。
先檢查測試與無關修改,再看模型自己的總結。視覺任務還要檢查截圖和實際介面。
重複測試以觀察波動,並把失敗和重試納入總成本。
一次成功只是樣例,不是成功率。代理瀏覽器指南解釋了為什麼工具權限和應用本身也會影響多步驟任務。
用 Tabbit Browser 整理對比資料
如果當前要做的是資料調研,可以在 Tabbit Browser 中開啟兩家的模型文件和價格頁,要求它整理來源連結、日期、型號和未解決問題。整理後仍需逐項回到原文核對,尤其是限時折扣和輸出上限衝突。
2026 年 11 月 3 日,我們在 Tabbit 測試環境選擇 LongCat-2.5,提供兩組假設價格,並讓它計算 100 萬輸入和 20 萬輸出 token 的費用。一次回答得到 $0.54 和 $2.28,與上面的算術一致。價格由提示詞提供,模型沒有獨立核實價格;一次答對也不能說明整體可靠性或程式設計能力。
該測試帳號的選擇器列出了 LongCat-2.5,沒有列出完整 GLM-5.3。GLM-5.3-FlashX 是不同型號,因此沒有拿它替代。截圖來自測試環境,不能證明生產帳號一定可用。
瀏覽器工作流可以參考 Tabbit 使用方法和 AI 瀏覽器對比。瀏覽器助手不能替代程式碼庫測試;帳號可用性、額度與資料條款也需要分別確認。
按場景選擇
| 你的要求 | 優先調查 | 理由 |
|---|---|---|
| 根據截圖修改介面 | LongCat 2.5 | 官方支援視覺輸入;仍需驗證介面和最終介面。 |
| 現在就需要自行部署權重 | GLM-5.3 | 模型卡提供權重與部署方式;先審查授權和硬體。 |
| 較低的官方 API 標價 | LongCat 2.5 | 當前折扣單價較低;應計算合格任務成本。 |
| 現有長任務程式設計代理 | 兩者都測試 | 已公佈的基準並未控制所有條件。 |
| 客戶端必須關閉思考 | 檢查 LongCat 介面 | Z.ai 稱 GLM-5.3 必須開啟思考;需要測試相容性。 |
先確定不能妥協的要求,再做小規模評估。如果結果接近,保留備選模型,並在服務商、代理或模型版本變化時重新測試。

常見問題
LongCat 2.5 和 GLM-5.3 哪個更適合程式設計?
兩者都可以作為程式設計代理的候選模型,但現有基準資料混用了不同測試配置。正式遷移前,應使用相同程式碼庫任務、工具和驗收測試比較實際結果。
LongCat 2.5 比 GLM-5.3 便宜嗎?
截至 2026 年 11 月 3 日,LongCat 的限時價格為每百萬未命中快取輸入 token 0.30 美元、輸出 token 1.20 美元;Z.ai 的 GLM-5.3 分別為 1.40 美元和 4.40 美元。實際任務成本還取決於 token 用量、快取命中、工具和服務商條款。
兩個模型都能讀取截圖嗎?
LongCat 將 2.5 描述為支援視覺輸入的原生多模態模型。Z.ai 文件稱 GLM-5.3 僅接受文字輸入,因此需要額外的視覺元件或其他模型處理截圖。
能在自己的硬體上執行這兩個模型嗎?
Z.ai 已公開 GLM-5.3 權重和部署說明,使用時仍需審查其授權條款並準備足夠硬體。調研當天,LongCat 2.5 發布頁上的 GitHub 和 Hugging Face 連結仍標記為即將推出。
兩個模型的上下文有多大?
雙方均公佈約 100 萬 token 的上下文,但輸入和輸出需要共享請求預算,客戶端也可能設更低的限制。LongCat 官方頁面對最大輸出長度的說明存在衝突,使用前應確認具體介面。
LongCat 2.5 Preview 與正式版相同嗎?
Preview 是 2026 年 11 月正式版發布之前的預覽版本。預覽版回饋可以幫助設計測試,但不能證明正式版會有相同行為。