
Prueba primero LongCat 2.5 si tu agente necesita leer capturas o buscas un precio de API publicado más bajo. Empieza por GLM-5.3 si necesitas acceder a los pesos. Para elegir por calidad de código, ejecuta las mismas tareas con ambos y revisa los cambios: una tabla de lanzamiento no resuelve esa decisión.
El 3 de noviembre de 2026, la tarifa temporal de LongCat era de 0,30 USD por millón de tokens de entrada sin caché y 1,20 USD por millón de salida. Z.ai indicaba 1,40 y 4,40 USD. Son tarifas de las API oficiales, no precios de suscripción de Tabbit, y no indican cuántos tokens consumirá cada modelo por tarea.
Un usuario de Reddit pidió a LongCat 2.5 Preview que analizara cinco clases C# en OpenCode y describió razonamiento repetitivo y una petición sin terminar. Es una sola experiencia con Preview, no una prueba de la versión final. Sirve para recordar la necesidad de definir una condición de parada y pruebas de aceptación. Más adelante mostramos un cálculo concreto en Tabbit Browser.
Puntos clave
LongCat 2.5 acepta entradas visuales; Z.ai documenta GLM-5.3 como modelo de entrada de texto.
En la fecha consultada, LongCat anunciaba los pesos de 2.5 como próximos. GLM-5.3 tiene un repositorio público y una licencia propia.
Los modelos lideran tareas distintas en la tabla de Meituan. Algunas cifras de GLM proceden de informes externos y no son una prueba controlada conjunta.
La tarifa oficial de LongCat es menor, pero temporal. Compara el coste por tarea aceptada.
Los comentarios sobre Preview identifican riesgos; no miden la versión final.
Comparación rápida
| Decisión | LongCat 2.5 | GLM-5.3 | Qué comprobar |
|---|---|---|---|
| Entrada | Texto e imagen | Texto | El cliente y el endpoint deben admitir el tipo necesario. |
| Contexto | 1.048.576 tokens entre entrada y salida | 1 millón de tokens | Una ventana amplia no garantiza una recuperación precisa. |
| Razonamiento | Se puede activar o desactivar según la guía de parámetros | Siempre activo, con esfuerzo low, high o max | El esfuerzo modifica el uso de tokens y los resultados. |
| Pesos | GitHub y Hugging Face figuran como próximos en el anuncio | Pesos e instrucciones públicos | Revisa la licencia y el hardware necesario. |
| API oficial por millón de entrada / salida | 0,30 / 1,20 USD, descuento temporal | 1,40 / 4,40 USD | Confirma precios actuales y condiciones de caché. |
Fuentes: anuncio de LongCat, parámetros, guía de GLM-5.3 y ficha del modelo. Consulta también nuestra guía de GLM-5.3 y el análisis de LongCat 2.0, que trata una versión anterior.
Pruebas de código y sus condiciones
Meituan publicó las cifras siguientes. El asterisco indica que el dato de GLM procede de un informe o clasificación pública, no necesariamente de una ejecución paralela con la misma configuración.
| Prueba | LongCat 2.5 | GLM-5.3 en la tabla de Meituan | Tarea que ayuda a evaluar |
|---|---|---|---|
| Terminal-Bench 2.1 | 88,4 | 88,2* | Trabajo de terminal de varios pasos |
| Terminal-Bench 4.0 | 38,5 | 41,8* | Tareas de terminal más difíciles |
| DeepSWE v1.1 | 64,6 | 66,9* | Problemas de ingeniería de software |
| NL2Repo | 60,5 | 58,0* | Crear un repositorio a partir de una descripción |
Fuente: tabla de evaluación de Meituan, consultada el 3 de noviembre de 2026. LongCat comunica una media de tres ejecuciones de Terminal-Bench 2.1 con Claude Code 2.1.280; la ficha de GLM indica Claude Code 2.1.207. El agente, las herramientas, el tiempo y los límites de salida pueden alterar el resultado. La pequeña diferencia de la primera fila no decide qué modelo funcionará mejor en tu repositorio.
Convierte cada dato en una prueba verificable. Para un repositorio existente, elige un error con una prueba fallida y revisa tanto el resultado como los cambios ajenos a la tarea. Para un proyecto nuevo, define el comportamiento esperado antes de empezar. Los prompts de GLM y las reseñas ayudan a diseñar tareas, pero no sustituyen tus criterios de aceptación.
Precios de API: calcula el coste de la tarea
La tarifa de LongCat es un descuento por tiempo limitado. La tarifa de Z.ai y la anterior se consultaron el 3 de noviembre de 2026. Son dólares por millón de tokens y excluyen cargos adicionales.
| API oficial | Entrada sin caché | Entrada en caché | Salida |
|---|---|---|---|
| LongCat 2.5, descuento temporal | $0.30 | $0.006 | $1.20 |
| Z.ai GLM-5.3 | $1.40 | $0.26 | $4.40 |
Con un millón de tokens de entrada sin caché y 200.000 de salida, sin herramientas ni otros cargos, LongCat costaría $0.54 y GLM-5.3 $2.28. El ejemplo usa la misma cantidad de tokens; no presupone igual consumo ni igual tasa de éxito.
coste por tarea aceptada = gasto total en modelos y herramientas / tareas que pasan las pruebasIncluye intentos fallidos, reintentos, contexto repetido, fallos de caché y revisión humana cuando puedas medirlos. Z.ai cobra por separado su herramienta de búsqueda. Un Coding Plan, un proveedor externo y una cuenta de Tabbit tienen condiciones propias.
Imágenes, contexto y límite de salida
El anuncio de LongCat describe comprensión visual nativa. Para una prueba de interfaz, entrega una captura, los archivos relevantes y un criterio visual verificable. Después inspecciona la interfaz y su accesibilidad en el navegador.
La guía de Z.ai describe GLM-5.3 con entrada solo de texto. Para usar una imagen, necesitas otro componente visual o una descripción textual verificada. Eso no significa que todas las aplicaciones construidas alrededor de GLM carezcan de funciones visuales.
Ambos anuncian aproximadamente un millón de tokens de contexto. LongCat define ese límite como entrada más salida. Su referencia de parámetros indica un máximo de 262.144 para max_tokens, mientras que la guía rápida menciona 128K de salida. Confirma el límite en el endpoint concreto. Z.ai documenta 128K de salida para GLM-5.3 y cada cliente puede imponer un límite menor.
Pesos y despliegue
Al investigar, el anuncio de LongCat 2.5 marcaba GitHub y Hugging Face como próximos. No confirma fecha ni licencia futura. Si necesitas alojarlo por tu cuenta, vuelve a comprobar el repositorio oficial y sus condiciones. La licencia MIT de LongCat 2.0 no se aplica automáticamente a 2.5.
La ficha de GLM-5.3 publica los pesos y opciones como vLLM y SGLang. La etiqueta de licencia es glm-5.3: lee las condiciones para tu uso. Descargar pesos no elimina gastos de hardware, operación, seguridad ni soporte. La ficha indica 753.000 millones de parámetros; calcula memoria según cuantización y contexto, no solo según parámetros activos.
Qué nos dicen las opiniones sobre Preview
En el caso de C#, el autor describe repeticiones y una tarea inacabada. Puedes registrar llamadas a herramientas y detener ejecuciones sin progreso, pero no atribuir automáticamente ese comportamiento a la versión final.
Otro usuario de Reddit probó Preview en Terminal-Bench 2.1 con tres ejecuciones por tarea y observó menos excepciones y tiempos de espera que en los otros modelos de su comparación. También indicó que su equipo falló de forma recurrente en una tarea; GLM-5.3 no participó. Las dos experiencias no establecen una clasificación de las versiones finales.
Cómo hacer una prueba justa
Elige cinco tareas representativas y reversibles, como un error ordinario, un cambio en varios archivos y una recuperación tras un fallo.
Fija la revisión del repositorio, permisos, tiempo y pruebas de aceptación. Mantén fuera las claves y credenciales de producción.
Registra versión del modelo y proveedor, versión del agente, esfuerzo, prompt, contexto, tokens, errores de herramientas, duración y diff.
Revisa las pruebas y los cambios ajenos a la tarea antes de leer la valoración del modelo. En trabajo visual, comprueba también la interfaz.
Repite las pruebas para observar variaciones y suma los intentos fallidos al coste.
Un solo acierto es un ejemplo, no una tasa de éxito. La guía de navegadores con agentes explica cómo influyen las herramientas y la aplicación en una tarea de varios pasos.
Organiza la comparación en Tabbit Browser
Para investigar, abre la documentación y las tarifas oficiales en Tabbit Browser y pide una tabla con fuente, fecha, versión y preguntas pendientes. Verifica los datos en las páginas originales, en especial el descuento y el límite de salida contradictorio.
El 3 de noviembre ejecutamos un cálculo en un entorno de pruebas de Tabbit con LongCat-2.5 seleccionado. Proporcionamos las dos tarifas y pedimos calcular un millón de tokens de entrada y 200.000 de salida. El resultado fue $0.54 y $2.28, correcto para esos datos. El modelo no verificó los precios de forma independiente; una sola respuesta correcta no mide fiabilidad general ni capacidad de programación.
La cuenta de pruebas mostraba LongCat-2.5, pero no el GLM-5.3 completo. GLM-5.3-FlashX es otro modelo y no lo usamos como sustituto. La disponibilidad puede variar según cuenta y edición; la captura no demuestra disponibilidad en producción.
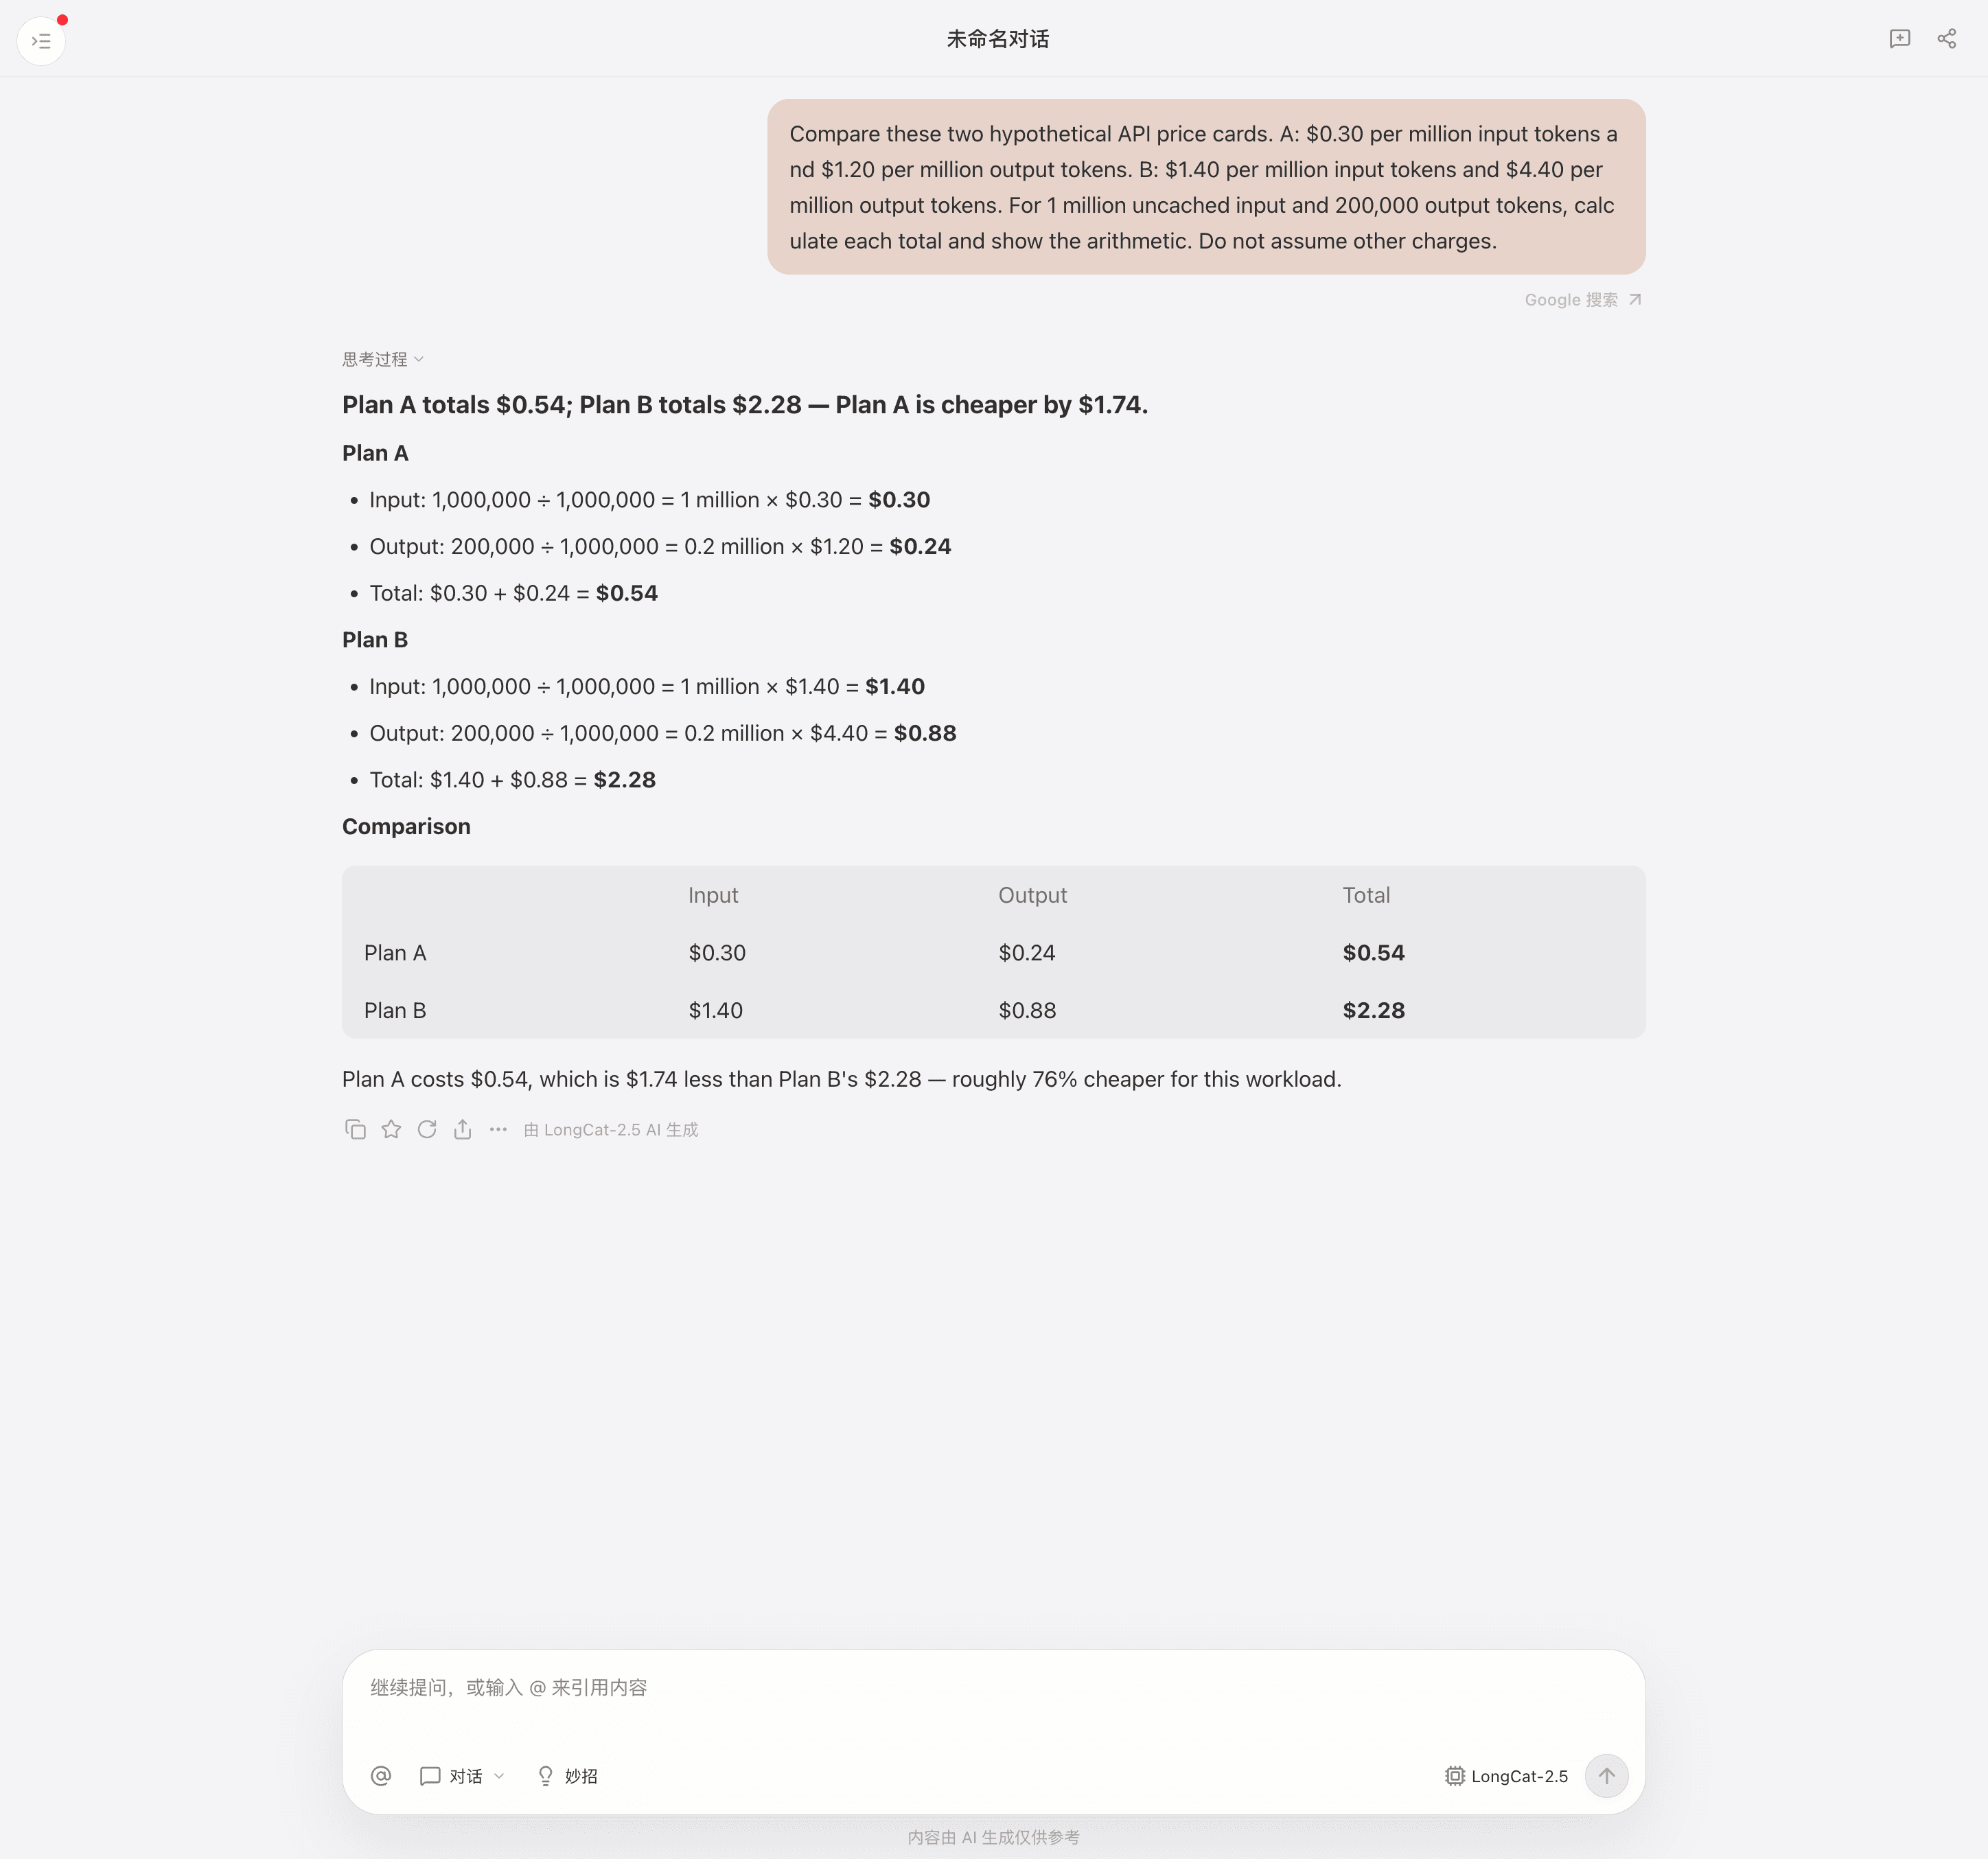
Consulta las prácticas de Tabbit y la comparación de navegadores con IA. Un asistente de navegador no sustituye las pruebas del repositorio; comprueba también disponibilidad, cuotas y condiciones de datos.
Qué elegir según la tarea
| Requisito | Primera opción para investigar | Motivo |
|---|---|---|
| Trabajo de interfaz a partir de capturas | LongCat 2.5 | Admite entrada visual; verifica el endpoint y la interfaz generada. |
| Pesos para alojar hoy | GLM-5.3 | Tiene pesos y guías de despliegue; revisa licencia y hardware. |
| Menor tarifa oficial publicada | LongCat 2.5 | La tarifa actual es menor; calcula el coste por tarea aceptada. |
| Agente de código para tareas largas | Prueba ambos | Las pruebas publicadas no controlan todas las condiciones. |
| Cliente que exige desactivar razonamiento | Comprueba el endpoint de LongCat | Z.ai exige razonamiento activo en GLM-5.3. |
Empieza por el requisito que no puedes negociar y haz una evaluación pequeña. Si los resultados son parecidos, conserva una alternativa y repite la prueba cuando cambien el proveedor, el agente o el modelo.

Preguntas frecuentes
¿Qué modelo es mejor para programar, LongCat 2.5 o GLM-5.3?
Ambos son candidatos para agentes de programación, pero los resultados publicados mezclan configuraciones de prueba distintas. Compara tareas, herramientas y pruebas de aceptación iguales antes de elegir uno para producción.
¿LongCat 2.5 cuesta menos que GLM-5.3?
El 3 de noviembre de 2026, LongCat ofrecía temporalmente un precio de 0,30 USD por millón de tokens de entrada sin caché y 1,20 USD por millón de salida. Z.ai indicaba 1,40 y 4,40 USD respectivamente; el coste real también depende del uso de tokens, la caché, las herramientas y el proveedor.
¿Los dos modelos pueden leer capturas de pantalla?
LongCat describe 2.5 como un modelo multimodal que acepta entradas visuales. Z.ai documenta GLM-5.3 como un modelo de entrada solo de texto, por lo que necesita otro componente visual u otro modelo para procesar imágenes.
¿Puedo ejecutar cualquiera de los dos en mi propio equipo?
Z.ai publica los pesos y las instrucciones de despliegue de GLM-5.3, sujetos a su licencia y a importantes requisitos de hardware. En la fecha de la investigación, LongCat marcaba los enlaces de GitHub y Hugging Face de 2.5 como próximos.
¿De cuánto contexto disponen los dos modelos?
Ambos proveedores anuncian aproximadamente un millón de tokens de contexto, pero la entrada y la salida comparten el presupuesto de una petición y cada cliente puede limitarlo. Las páginas oficiales de LongCat discrepan sobre el máximo de salida, así que conviene confirmarlo en el endpoint concreto.
¿LongCat 2.5 Preview es igual que la versión final?
Preview precedió al lanzamiento de LongCat 2.5 en noviembre de 2026. Las experiencias con Preview ayudan a diseñar pruebas, pero no demuestran el comportamiento de la versión final.