
O GPT-6 Astra custa 10 dólares por milhão de tokens de entrada e 50 dólares por milhão de tokens de saída no nível padrão da API, com entrada em cache a 1 dólar, gravação de cache a 12,50, e todas as tarifas verificadas nas páginas da OpenAI em 22 de setembro de 2026. Essa é a tabela de tarifas. A fatura é outra coisa: sobre a mesma tabela, a Artificial Analysis mede o custo de uma tarefa de referência em 0,82 dólar com esforço de raciocínio low e 3,26 dólares com max — uma oscilação de cerca de 4x sem tocar em nenhum preço.
A distância entre esses dois números é a razão deste artigo existir. Um desenvolvedor do Reddit resumiu no lançamento: «GPT-5.6 Sol: $4/M de entrada, $20/M de saída. GPT-6 Astra: $10/M de entrada, $50/M de saída. É literalmente um salto de preço de 2,5x na entrada e na saída.» (thread do r/codex, 456 votos). A aritmética está certa. A conclusão — caro ou barato — a aritmética não decide, porque o nível de esforço, o nível de serviço, o comprimento do contexto e a taxa de acertos de cache movem a fatura mais do que a própria escolha do modelo. Mais adiante, o Tabbit Browser aparece como um lugar prático para comparar rotas de modelos depois que o orçamento estiver claro; primeiro, os números.
Pontos principais
Tarifas padrão: 10 $ de entrada, 1 $ de entrada em cache, 12,50 $ de gravação de cache, 50 $ de saída por milhão de tokens; prompts acima de 272K de entrada passam a solicitação inteira para 20/2/25/75 $.
A mesma tabela fatura com 4x de diferença. Batch e Flex cortam cada tarifa pela metade; Fast mode dobra. A Artificial Analysis mede a mesma tarefa entre 0,82 $ (esforço low) e 3,26 $ (max) com preços de token idênticos.
O prêmio de 2,5x é medido contra uma base promocional. Os 4/20 $ do Sol figuram como preço promocional «pelo menos até 21 de novembro de 2026»; a entrada da GPT-5.5 anterior era 5 $.
Assinaturas são outra economia. O ChatGPT Plus custa 20 $/mês com Astra limitado; o Pro aparece a partir de 100 $/mês. Medições da comunidade situam o custo efetivo do Astra na assinatura perto de 1,9x seu preço de API, com retenção de cache relatada de cerca de 30 minutos.
Faça orçamento pelo formato da tarefa, não pelo preço do token. Respostas curtas são dominadas pela saída; loops agênticos com cache, pelas leituras de cache; tudo acima de 272K de entrada paga o prêmio de contexto longo na solicitação inteira.
O preço do GPT-6 Astra de relance
A tabela padrão completa, renderizada da página de preços da API da OpenAI em 22 de setembro de 2026. O panorama do GPT-6 Astra cobre o que o modelo é; esta tabela cobre o dinheiro.
| Modelo | Entrada / 1M | Entrada em cache / 1M | Gravação cache / 1M | Saída / 1M |
|---|---|---|---|---|
| gpt-6-astra | $10,00 | $1,00 | $12,50 | $50,00 |
| gpt-5.6-sol | $4,00 | $0,40 | $5,00 | $20,00 |
| gpt-5.6-terra | $2,00 | $0,20 | $2,50 | $12,00 |
| gpt-5.6-luna | $0,20 | $0,02 | $0,25 | $1,20 |
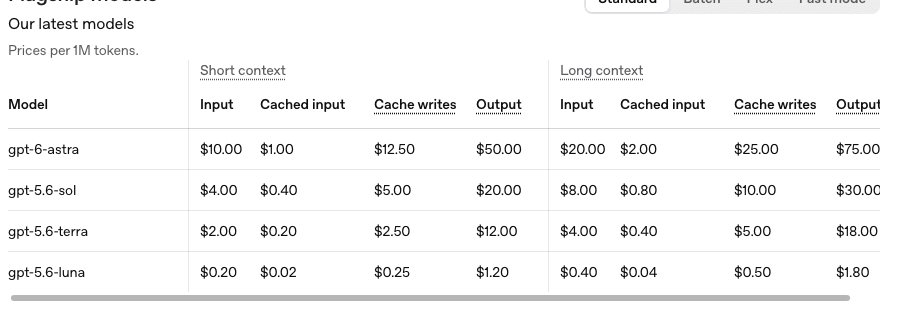
Três coisas nesta tabela fazem o estrago, e nenhuma é o 10 do título:
A saída custa 5x a entrada. Astra é um modelo de raciocínio; ele pensa em tokens de saída faturáveis. Um prompt modesto com uma longa cadeia de pensamento é uma fatura de saída vestida de entrada.
Gravar em cache custa mais que a entrada. Os 12,50 $ são 1,25x a tarifa sem cache — a página de preços declara a regra de 1,25x explicitamente. O cache só compensa quando o prefixo é realmente reutilizado.
O salto de 272K vale para a solicitação inteira. Passando de 272.000 tokens de entrada, a solicitação completa — não só o excedente — é faturada a 20 $ de entrada, 2 $ de cache, 25 $ de gravação, 75 $ de saída. Uma janela de contexto de 1,05M não é um orçamento de 1,05M a tarifa padrão.
O número que importa: a mesma tabela cobra de 0,82 a 3,26 dólares por tarefa
Se você lembrar um número deste artigo, lembre da oscilação, não da tarifa. A Artificial Analysis acompanha o GPT-6 Astra como cinco entradas — uma por esforço de raciocínio — e seu custo medido por tarefa do índice de inteligência (instantâneo de 22 de setembro de 2026) fica assim:
| Esforço de raciocínio | Índice de inteligência | Custo por tarefa | Velocidade de saída |
|---|---|---|---|
| low | 46 | $0,82 | 55 t/s |
| medium | 50 | $1,54 | 52 t/s |
| high | 51 | $1,73 | 59 t/s |
| xhigh | 52 | $2,31 | 55 t/s |
| max | 53 | $3,26 | 67 t/s |
Leia juntas as duas colunas externas: max custa 3,98x o custo de low por tarefa, em troca de 7 pontos de índice medidos. No mesmo instantâneo, low também registra o menor tempo até o primeiro token (2,46 s). O ajuste caro não é automaticamente o cauteloso; é o que pensa por mais tempo em tokens faturáveis.
Isso pesa em dobro no trabalho agêntico. O melhor resultado público do Astra — cerca de 40 minutos por tarefa OSWorld 2.0 na simulação da OpenAI, contra 75 do Sol — descreve exatamente a carga onde esforço e tentativas se compõem: cada volta do loop relê contexto, cada passo emite tokens de raciocínio, e um modelo que «roda para sempre» também fatura para sempre. Um usuário do Hacker News relatou queimar uma janela de cinco horas do ChatGPT em 15 mensagens (discussão no HN); o mesmo formato sobre faturamento de API é o motivo pelo qual o guia de raciocínio agêntico exige critérios de aceitação antes de loops longos. Faça orçamento por tarefa concluída, incluindo tentativas falhas, não por primeira tentativa.
Traduzindo o prêmio de 2,5x sobre o GPT-5.6 Sol
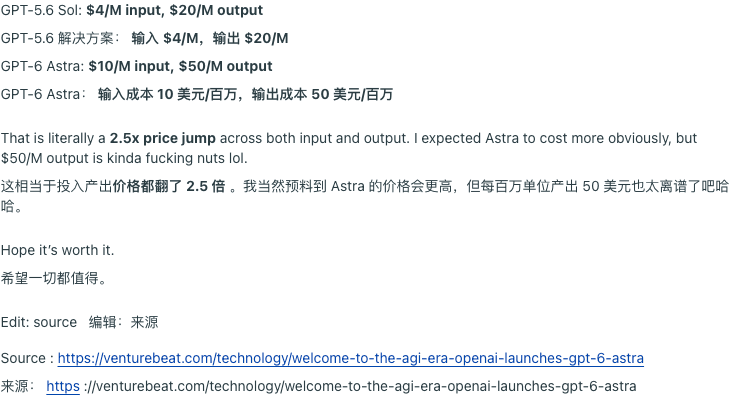
O número de 2,5x é aritmética honesta, mas antes de orçar duas ressalvas merecem ficar ao lado dele.
Ressalva um: a base é promocional. A página do Sol nota que «o preço promocional do GPT-5.6 Sol está disponível pelo menos até 21 de novembro de 2026», e sua coluna de comparação rápida mostra a entrada da GPT-5.5 anterior a 5,00 $. A queda do Sol veio em 30 de julho de 2026, quando Sam Altman anunciou Luna caindo 80% (para 0,20/1,20 $), Terra 20% (para 2/12 $) e Fast mode para Sol a 2x o preço por até 2,5x a velocidade (@sama). Se a promo do Sol expirar, o «prêmio de 2,5x» encolhe sozinho sem o Astra ficar mais barato. A análise de contexto do GPT-5.6 Sol acompanha essa família à parte.
Ressalva dois: o custo por tarefa pode convergir. A thread acima é o choque da tabela. Mas os 0,82 $ por tarefa no low medidos pela Artificial Analysis mostram até onde a fatura pode cair abaixo do preço de tabela, e a direção se inverte por completo quando a capacidade poupa tentativas: um trabalho que o Sol falha duas vezes e o Astra conclui na primeira sai mais barato no Astra mesmo a tarifas de 2,5x. Saber se isso descreve suas tarefas é uma questão empírica — respondida com os exemplos calculados abaixo, não com a tabela de tarifas.
As linhas de faturamento fora do título
Quatro linhas decidem a maioria das faturas reais, e a cobertura de lançamento só mencionou a primeira.
Batch e Flex: a alavanca dos 50%. Ambos são tarifados à metade do padrão — 5 $ de entrada, 0,50 $ de cache, 6,25 $ de gravação, 25 $ de saída. Batch é para trabalho que pode esperar horas (a API expõe v1/batch, com limites de fila de 1,5M de tokens no Tier 1 a 15B no Tier 5); Flex é outro modo de capacidade de baixo custo com seus próprios compromissos de disponibilidade. Para avaliações em lote, enriquecimento offline e tudo que um usuário não vê, este único interruptor economiza mais do que qualquer otimização de prompt. Os descontos não se acumulam: escolha um modo por vez.
Fast mode: o acelerador de 2x. Tarifado ao dobro das tarifas aplicáveis — 20/100 $ no padrão, e note o «aplicáveis»: Fast sobre um trabalho Batch dobra as tarifas do Batch, não volta às padrão antes de dobrar. O Priority processing foi renomeado Fast mode em 30 de julho de 2026, e tanto service_tier: "priority" quanto "fast" ainda funcionam — o que importa se você tem código antigo.
Processamento regional: +10%. Endpoints de residência de dados carregam um acréscimo de 10% para modelos lançados a partir de 5 de março de 2026 elegíveis — o Astra se qualifica pela data de lançamento. Regiões guiadas por conformidade pagam o prêmio em cada linha.
O salto de 272K e o relógio do cache. Acima de 272K de entrada, a linha de contexto longo (20/2/25/75 $) aplica-se à solicitação inteira — não há cálculo de «só o excedente». E o cache que baratearia as releituras tem um relógio relatado pela comunidade: usuários do Codex observaram retenção de cerca de 30 minutos no Astra contra 24 horas no Sol e anteriores.
A OpenAI não publica uma tabela de TTL, então trate os 30 minutos como um comportamento relatado com duas fontes independentes (thread, comentário), não uma garantia. Se o seu loop dorme mais que isso entre passos, a leitura de 1 $ pode silenciosamente virar uma leitura fria de 10 $ mais uma gravação de 12,50 $.
Chamadas de ferramentas ficam fora de tudo isso: a OpenAI afirma que modelos com ferramentas faturam por chamada coisas como busca na web, então um agente que busca 40 vezes tem um segundo medidor rodando.
A escada da família: qual linha é a sua
A linha contraintuitiva da escada é a Luna: 50 vezes mais barata na entrada que a Astra, e ela existe de verdade. O catálogo oficial de modelos descreve a Luna para cargas sensíveis a custo e de alto volume, e a própria orientação de seleção da OpenAI recomenda Terra ou Luna por padrão, salvo trabalho difícil o bastante para justificar o principal. A linha barata não é um brinquedo; é um destino de roteamento, e cada token roteado para lá em vez da Astra economiza 50x na entrada.
A segunda descoberta contraintuitiva vem de fora da família. Astra e a Fable 5.1 da Anthropic listam no mesmo 10/50 — e custam valores opostos na prática:
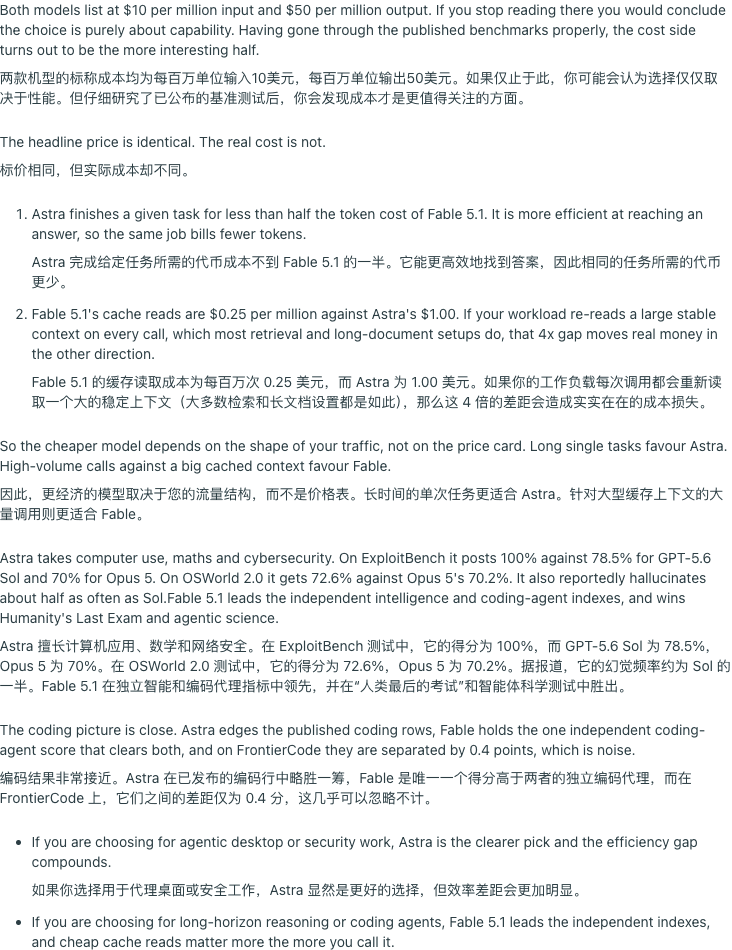
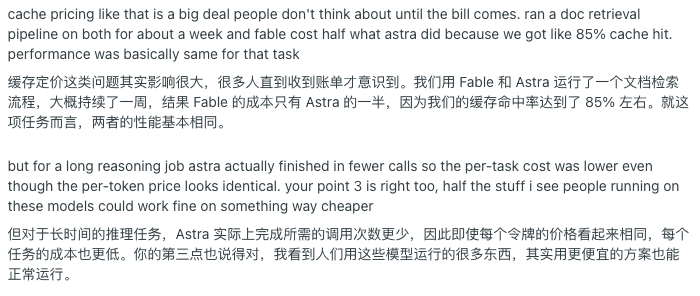
As contas do autor: o Astra termina uma tarefa com menos tokens («menos da metade do custo em tokens da Fable 5.1» em suas tarefas únicas longas), enquanto as leituras de cache da Fable a 0,25 $ por milhão abrem uma vantagem de 4x sobre o 1,00 $ do Astra — então tráfego de alto volume contra um grande contexto em cache favorece a Fable, e tarefas únicas longas favorecem o Astra. Um comentarista rodou por uma semana um pipeline de recuperação documental em ambos e pagou cerca da metade na Fable com 85% de acertos de cache, «o desempenho foi basicamente o mesmo para essa tarefa»:
A lição transferível não exige escolher laboratório: a tabela de tarifas é a menor das entradas da função de custo. O formato do tráfego — duração da tarefa, proporção de acertos de cache, volume de saída — domina. A coleção de avaliações da comunidade (English) guarda mais relatos desses com suas condições anexadas.
O que a tabela de tarifas não cobre
Assinatura não é crédito de API. Os planos do ChatGPT dão uso, precificado em cotas e janelas — a próxima seção mostra que essas cotas são uma economia própria. Nunca divida um plano de 20 $ por preços de token.
Tentativas falhas podem faturar. Numa execução de Codex de 33 minutos documentada na semana de lançamento, duas tentativas expiradas consumiram orçamento antes da bem-sucedida (r/ChatGPT). Tentativas são uma linha de custo, não grátis.
O nível gratuito da API está fechado. A tabela de limites marca o Astra como «não suportado» no Free; o pago começa no Tier 1 com 500 solicitações por minuto e 500K tokens por minuto.
Impostos, ferramentas e margens de provedor vão à parte. A página do OpenRouter mostra Azure e OpenAI listando ambos 10/50/1 $ para o Astra com perfis de latência diferentes (P50 até o primeiro token de 4,80 s contra 6,92 s no instantâneo de hoje) — mesmas tarifas, roteamento diferente. As regiões comerciais do Amazon Bedrock são declaradas equivalentes ao preço direto da OpenAI.
Disponibilidade de planos: níveis de API e planos do ChatGPT
| Nível de API | RPM | TPM | Limite de fila Batch |
|---|---|---|---|
| Free | Não suportado | — | — |
| Tier 1 | 500 | 500.000 | 1,5M de tokens |
| Tier 2 | 5.000 | 1.000.000 | 3M de tokens |
| Tier 3 | 5.000 | 2.000.000 | 100M de tokens |
| Tier 4 | 10.000 | 4.000.000 | 200M de tokens |
| Tier 5 | 15.000 | 40.000.000 | 15B de tokens |
Fonte: página do modelo gpt-6-astra da OpenAI, verificada em 22 de setembro de 2026. Os níveis sobem com o gasto, então o teto da semana de lançamento não é permanente.
Do lado do consumidor, a página de preços do ChatGPT exibe hoje quatro planos: Free a 0 $ (texto ilimitado com GPT-5.6 Luna — sem Astra), Go a 8 $/mês, Plus a 20 $/mês com «modelos de raciocínio avançados com GPT-6 Astra e GPT-5.6» (a matriz comparativa marca o Astra como limitado), e Pro exibido como «a partir de 100 $/mês» com 5x de uso e «raciocínio Pro movido pelo GPT-6 Astra». A comunidade ainda menciona um Pro de 200 $, e descrições no YouTube listam «100 e 200 $» juntas — a página ao vivo é a única árbitra, e hoje exibe preço «a partir de».
A economia das assinaturas merece sua própria etiqueta de aviso, porque três medições independentes da comunidade apontam na mesma direção:
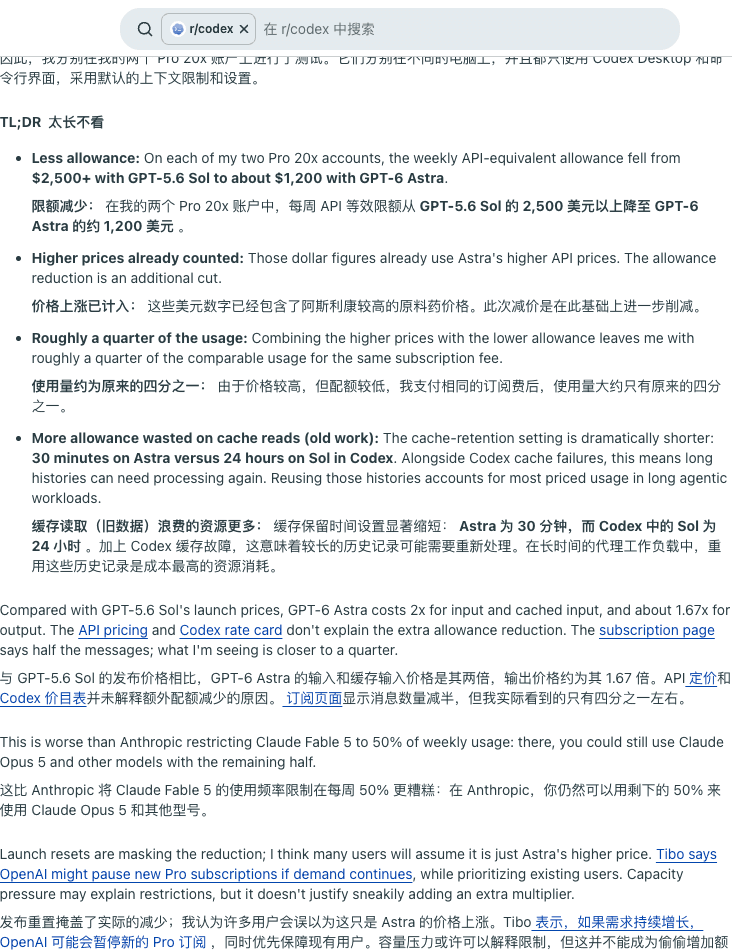
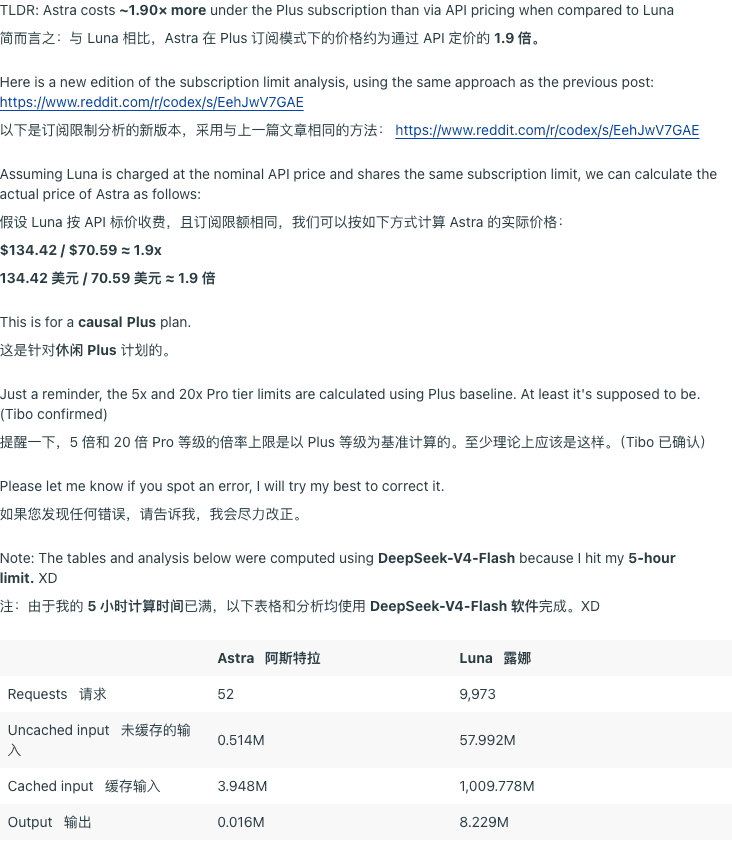
Primeiro, a matemática das cotas: em duas contas Pro, a cota semanal equivalente em API caiu de 2.500 $+ com Sol para cerca de 1.200 $ com Astra — com os preços maiores já descontados — deixando «aproximadamente um quarto do uso comparável pela mesma taxa de assinatura». Segundo, a tarifa efetiva: um assinante do Plus decompôs o Astra em ~1,90x seu preço de API contra a Luna na mesma cota (134,42 $ contra 70,59 $ de uso medido). Terceiro, a experiência de queima:
«O Astra é muito bom, mas para qualquer uso sério, a assinatura de 200 $ por mês simplesmente não dá tokens suficientes» é o resumo de um desenvolvedor de jogos — a capacidade e a frustração na mesma frase. Se seu uso do Astra é ocasional e supervisionado, o Plus pode bastar; se é o motor de um pipeline diário, a API com Batch é a rota previsível, e a assinatura é a rota de interação premium.
Dois orçamentos calculados, com todas as premissas visíveis
Usam tarifas padrão de contexto curto, sem tentativas, ferramentas ou impostos. Aritmética ilustrativa, não previsões.
Uma pergunta curta com muito pensamento. 10.000 tokens de entrada, 2.000 de saída:
(10.000 × $10 + 2.000 × $50) / 1.000.000 = $0,20Um loop agêntico a frio que cruza o salto. 300.000 tokens de entrada — já acima de 272K, logo tarifas de contexto longo em tudo — com 8.000 de saída:
(300.000 × $20 + 8.000 × $75) / 1.000.000 = $6,60O mesmo loop abaixo de 272K (digamos 260.000 tokens) custaria 4,00 $. Cruzar o limiar encareceu esse formato em 65%. Agora a versão aquecida: o mesmo contexto de 300.000 tokens, 90% em cache, gravação uma vez por hora, 8.000 de saída:
(270.000 × $2 + 30.000 × $20 + 8.000 × $75) / 1.000.000 = $1,68 + gravaçõesCálculo local
Estime o custo de tokens da API GPT-6 Astra
Usa as tarifas oficiais em USD verificadas em 22/09/2026. Os valores ficam neste navegador.
A gravação no cache é cobrada a 1,25x a tarifa de entrada. A estimativa exclui novas tentativas, ferramentas, impostos, o acréscimo regional de 10% e margens de provedores. Entradas acima de 272K mudam todas as linhas para tarifas de contexto longo automaticamente. Ver tarifas atuais
A calculadora roda inteiramente nesta página — nada é enviado a lugar algum. Ela aplica automaticamente a mudança para contexto longo acima de 272K, precifica o nível de serviço escolhido e separa gravações de cache de acertos. O que ela deliberadamente não modela: tentativas, taxas de ferramentas, os 10% regionais e o relógio do cache — isso fica para a sua margem. Reverifique a tabela oficial antes de comprometer um orçamento; estes são os números de 22 de setembro de 2026.
Uma opção prática: rodar a comparação no Tabbit
Depois do orçamento vem a parte chata: executar trabalho com formato Astra precisa de um lugar onde páginas, arquivos e chamadas de modelo vivam juntos. Esse é o espaço do Tabbit Browser — um navegador com IA onde o seletor de modelos, a página ao vivo e o arquivo local dividem uma superfície, e «tentar Astra no medium, cair para Luna se falhar» é uma seleção, não um projeto de orquestração.
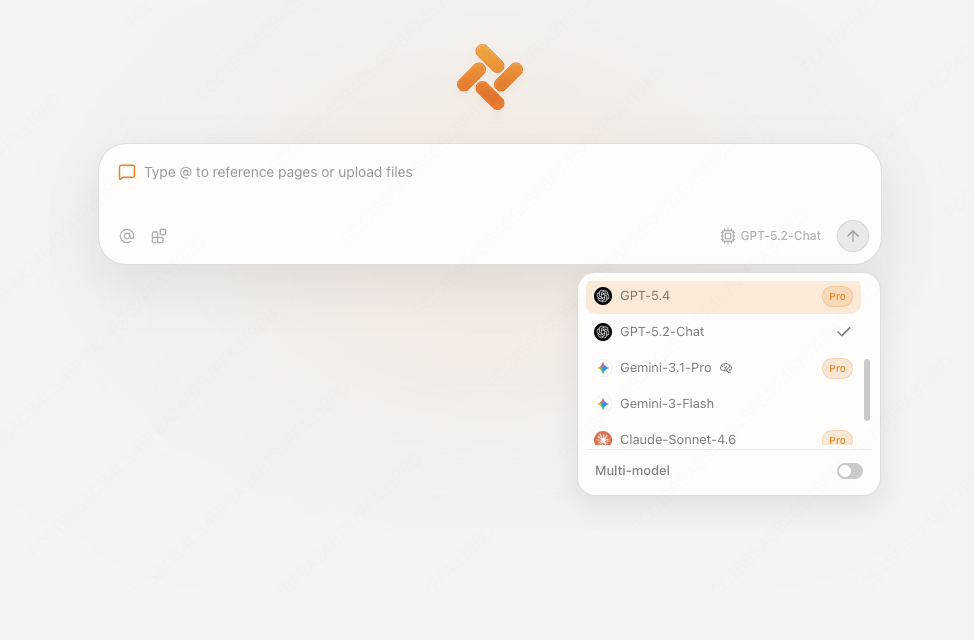
Os limites, ditos sem rodeio: o Tabbit é um cliente, não uma camada de faturamento da OpenAI. A disponibilidade de modelos depende da sua conta e edição, e nada no navegador muda o que a OpenAI cobra — a tabela acima vale onde quer que o Astra rode. O que o navegador muda é o custo de montagem: a página de recursos do GPT-6 Astra (English) e sua coleção de prompts (English) descrevem tarefas reproduzíveis para rodar contra o seletor antes de escrever qualquer código de orquestração — a forma mais barata de descobrir qual nível de esforço sua carga realmente precisa.
 Tabbit Browser
Se o trabalho é automação em nível de navegador em vez de conversa, o panorama de navegadores agênticos, o que é um navegador agêntico e o guia de automação de navegador cobrem esse fluxo; o guia de navegadores com IA é o ponto de partida geral.
Tabela de decisão do preço do GPT-6 Astra
| Sua carga | Motor do custo | Melhor rota inicial | Cuidados |
|---|---|---|---|
| Chat interativo, respostas curtas | Tokens de saída | API com esforço low/medium, ou Plus | A saída a $50/M domina; 5x a entrada |
| Avaliações ou enriquecimento noturnos | Volume | Batch a 50% | Limites de fila por nível; resultados em horas |
| Loops agênticos longos abaixo de 272K | Leituras e gravações de cache | Padrão com prefixos estáveis em cache | Retenção de cache relatada de ~30 minutos |
| Contextos acima de 272K | O salto | Reestruturar para ficar abaixo, ou orçar 20/75 | A solicitação inteira é retarifada, não só o excedente |
| Produção sensível à latência | Fast mode | Fast (2x) sobre o esforço mínimo suficiente | A escolha de esforço move o custo mais que o nível |
| Uso intensivo diário do consumidor | Cota de assinatura | Pro (a partir de 100 $) ou API+Batch | Cota queimada ~4x mais rápido que Sol nos relatos |
Veredito final
O GPT-6 Astra tem preço de ingrediente para trabalho difícil, e fatura como tal. Compre-o quando a tarefa for de longo fôlego, intensiva em ferramentas e cara de supervisionar — e depois compre com cuidado: Batch para tudo que pode esperar, esforço low até um teste de aceitação dizer o contrário, contextos projetados abaixo de 272K e prefixos amigáveis ao cache medidos contra um relógio de 30 minutos. Deixe para Luna ou Terra o volume que não precisa do principal; a escada da família existe justamente para que o flagship seja uma decisão de roteamento, não um padrão.
Se o Astra é seu motor diário na API, faça orçamento por tarefa concluída (com tentativas e taxas de ferramentas) e reveja todo mês a página oficial de preços — a base promocional do Sol carrega data de 21 de novembro e a escada inteira pode se mover. A comparação dedicada de alternativas segue em preparação; até chegar, os recursos do modelo (English), o panorama e os registros da comunidade vinculados acima são a trilha de fontes.
Fontes
Preços da API da OpenAI e página do modelo gpt-6-astra — tabelas, regras de níveis e limites, verificados em 22 de setembro de 2026
Preços do ChatGPT — exibições Free/Go/Plus/Pro, verificadas em 22 de setembro de 2026
Sam Altman, 30 de julho de 2026 — anúncio das quedas de Luna/Terra e do Fast mode do Sol
Página de lançamento do GPT-6 Astra na Artificial Analysis — instantâneo de inteligência, velocidade e custo por tarefa por esforço, 22 de setembro de 2026
OpenRouter GPT-6 Astra — instantâneo de tarifas e latência por provedor, 22 de setembro de 2026
Registros da comunidade com capturas e condições no texto: r/codex 1w6hvo9, r/codex 1wciwc1, r/codex 1w8r103, r/LLMDevs 1w9z8nb, r/ChatGPT 1w9nya5, Ask HN

Perguntas frequentes
Quanto custa o GPT-6 Astra?
A tarifa padrão da API, verificada nas páginas da OpenAI em 22 de setembro de 2026, é de 10 dólares por milhão de tokens de entrada, 1 dólar por milhão de entrada em cache, 12,50 dólares por milhão de gravação em cache e 50 dólares por milhão de saída. Prompts acima de 272K tokens de entrada são faturados às tarifas maiores de contexto longo (20 dólares de entrada, 2 em cache, 25 de gravação, 75 de saída) pela solicitação inteira. Batch e Flex custam 50% do padrão, Fast mode o dobro, e endpoints regionais de residência de dados adicionam 10%.
O GPT-6 Astra tem algum plano gratuito?
Não no nível gratuito da API. A tabela de limites da OpenAI marca o nível Free do gpt-6-astra como não suportado, com acesso pago começando no Tier 1. Do lado do consumidor, o plano gratuito do ChatGPT oferece texto ilimitado com GPT-5.6 Luna, mas sem Astra; o Plus inclui acesso limitado ao Astra, e o Pro é apresentado como movido pelo GPT-6 Astra.
Por que o GPT-6 Astra custa 2,5 vezes mais que o GPT-5.6 Sol?
A OpenAI posiciona o Astra para o trabalho mais difícil de ponta a ponta (raciocínio, código, computer use e pesquisa) e o tarifa em 10/50 dólares contra 4/20 do Sol. Atenção: as tarifas atuais do Sol são preços promocionais disponíveis pelo menos até 21 de novembro de 2026, então a própria linha de base da comparação pode mudar. Quando o Astra termina em menos tentativas, o custo por tarefa converge com o do Sol.
Vale a pena o ChatGPT Pro só pelo GPT-6 Astra?
Depende do formato da sua carga. O Pro aparece a partir de 100 dólares por mês com 5x de uso e raciocínio com Astra, mas medições da comunidade descrevem uma cota semanal equivalente em API caindo de cerca de 2.500 dólares com Sol para cerca de 1.200 com Astra, uma retenção de cache de cerca de 30 minutos e usuários intensivos esgotando cotas rápido. Se suas tarefas são longas e agênticas, calcule bem o orçamento ou use a API com Batch quando a latência permitir.
Qual é a forma mais barata de rodar o GPT-6 Astra?
Combine as alavancas: mande trabalho não urgente por Batch ou Flex a 50% do preço padrão; comece com esforço de raciocínio low ou medium e só suba quando os testes de aceitação falharem; mantenha os prompts abaixo de 272K tokens de entrada para evitar o salto de contexto longo; e guarde em cache prefixos estáveis para que releituras sejam cobradas a 1 dólar em vez de 10 por milhão.
Os preços da API do GPT-6 Astra incluem chamadas de ferramentas?
Não. As tarifas publicadas cobrem apenas entrada e saída de texto. A OpenAI afirma que modelos com ferramentas, como web search e computer use, têm tarifa por chamada, faturada separadamente do preço por token; um agente que busca 40 vezes tem um segundo medidor rodando.