
GPT-6 Astra constitue une prouesse technique indéniable. Lors de son lancement officiel le 3 septembre 2026 par OpenAI, il a ramené le temps d'exécution sur le banc d'essai de bureau OSWorld 2.0 de 75 minutes à 40 minutes — soit une accélération de 47 % — tout en portant le taux de réussite à 72,6 %. Lors d'évaluations indépendantes menées par des développeurs, il a fait preuve d'une ténacité remarquable en menant à bien la génération d'un client API Python sous Codex en 33 minutes à travers 13 cycles d'autocorrection consécutifs, tout en identifiant 3 à 5 fois plus de sources web lors de recherches exploratoires complexes. Si votre contrainte principale réside dans le temps passé à surveiller manuellement de longs flux d'agents autonomes, Astra apporte une valeur opérationnelle indéniable.
Néanmoins, les arguments en faveur d'alternatives reposent sur des calculs d'ingénierie rigoureux. OpenAI a fixé les tarifs standards de l'API d'Astra à 10,00 $ par million de tokens d'entrée et 50,00 $ par million de tokens de sortie, soit exactement 2,5 fois le coût de GPT-5.6 Sol (4,00 $ / 20,00 $). De surcroît, si votre requête dépasse 272 000 tokens d'entrée, une tarification majorée s'applique à l'ensemble de l'appel. Parallèlement, les mesures indépendantes d'Artificial Analysis révèlent que l'indice d'intelligence globale d'Astra n'a progressé que de 0,3 point par rapport à Sol (61,2 contre 60,9), tandis que son score promotionnel de 99,9 % sur ARC-AGI-3 résultait d'adaptateurs propriétaires tombant à 62,7 % sur les environnements publics standards.
Ce décalage éclaire la décision de migration : payer un surcoût de 150 % sur votre facture d'API pour un gain d'intelligence générale de 0,5 % est un choix financier discutable si votre charge de travail ne requiert pas 40 minutes d'entêtement autonome. Pour les pipelines de données volumineux, le code interactif rapide, l'analyse documentaire multimodale et les tâches quotidiennes avec supervision humaine, des alternatives performantes offrent des résultats équivalents ou supérieurs à une fraction du prix. La vue d'ensemble de GPT-6 Astra détaille ses spécifications et notre analyse critique de GPT-6 Astra met en lumière les limites de ses bancs d'essai ; ce guide présente les critères pour choisir votre alternative idéale.
Points clés à retenir
GPT-5.6 Sol est l'alternative de repli la plus directe : Il offre 99,5 % du niveau de raisonnement général d'Astra (60,9 contre 61,2) pour 60 % de moins (4 $ / 20 $ contre 10 $ / 50 $ par million de tokens) avec une latence de premier token bien plus faible.
Claude Fable 5.1 et Sonnet 5 excellent dans l'architecture logicielle : La mise en cache des invites d'Anthropic réduit le coût des entrées récurrentes de 75 %, garantissant une rigueur stylistique supérieure dans le remaniement de code sans les avertissements juridiques pesants d'Astra.
Gemini 3.8 Flash s'impose sur le traitement multimodal à haut débit : À 0,75 $ en entrée et 3,75 $ en sortie, il traite les flux audio, vidéo et les documents PDF volumineux avec plus de 85 % d'économie par rapport à Astra.
DeepSeek V4.1 Flash débloque des coûts dérisoires en heures creuses : La lecture de cache descend à 0,003 $ par million de tokens en période creuse, ce qui en fait le moteur idéal pour les tâches de fond planifiées.
L'agent du navigateur Tabbit simplifie la couche d'exécution : Si votre frustration découle de la gestion de navigateurs sans tête, de l'extraction du DOM et des clés API, exécuter directement des modèles dans Tabbit élimine toute cette complexité d'infrastructure.
Quatre critères pour évaluer les alternatives
Le coût réel par tâche achevée, et non la grille nominale : Un modèle théoriquement bon marché qui génère 4 000 tokens verbeux ou exige trois tentatives manuelles coûte plus cher qu'un modèle efficace. Le coût réel englobe les tokens de raisonnement, l'efficacité du cache, les seuils de dépassement à 272K et le temps d'intervention humaine.
La latence acceptable en interaction directe : Lorsqu'un développeur attend une réponse, le temps jusqu'au premier token (TTFT) et la fluidité de la génération priment sur le débit de pointe en arrière-plan. Un agent autonome peut tourner 40 minutes, mais pas une session de programmation interactive.
L'adéquation avec le contexte long, les outils et le multimodal : Changer de modèle ne doit pas se faire au détriment de l'appel d'outils natif, de l'inspection de fichiers ou d'une fenêtre de contexte d'au moins 1 million de tokens.
Des retours d'expérience concrets plutôt que des classements synthétiques : Nous nous appuyons sur des incidents réels, des limites de débit et des retours de développeurs documentés sur Hacker News et Reddit plutôt que sur des annonces promotionnelles.
Vue d'ensemble des 5 alternatives
| Modèle candidat | Idéal pour | Route officielle | Prix vérifié (22-09-2026) | Contexte / Sortie max. | Contrepartie principale (The main catch) |
|---|---|---|---|---|---|
| GPT-5.6 Sol | Remplacement immédiat économique dans le même écosystème | gpt-5.6-sol | 4,00 $ entrée / 20,00 $ sortie (par 1M) | 1 050 000 / 128 000 | Moins endurant sur les boucles de bureau complexes de plus de 10 étapes |
| Claude Fable 5.1 / Sonnet 5 | Architecture logicielle et remaniement de code précis | claude-fable-5-1 / claude-sonnet-5 | 2,00 $–3,00 $ entrée / 10,00 $–15,00 $ sortie | 1 000 000 / 128 000 | Limites de concurrence strictes par organisation et coût élevé du raisonnement poussé |
| Gemini 3.8 Flash | Extraction multimodale massive et débit ultra-rapide | gemini-3-8-flash | 0,75 $ entrée / 3,75 $ sortie (par 1M) | 1 048 576 / 65 536 | Délai initial (TTFT) plus marqué en mode de réflexion maximale |
| DeepSeek V4.1 Flash | Traitement par lots économique planifié en heures creuses | deepseek-flash | Heures creuses : 0,15 $ entrée / 0,60 $ sortie | 1 000 000 / 384 000 | Majoration tarifaire aux heures de pointe et absence d'agent visuel de bureau |
| Agent Navigateur Tabbit | Automatisation de flux web sans aucun code d'intégration | Environnement de bureau intégré | Sélecteur multimodèle natif | DOM des onglets actifs + Fichiers locaux | Conçu pour la productivité interactive sur poste de travail, pas comme API de serveur |
Remarques tarifaires : Tarifs standards de l'API vérifiés au 22 septembre 2026. Les tokens de réflexion sont facturés comme des tokens de sortie. La mise en cache d'invites réduit le coût d'entrée de 75 % à 90 % selon le fournisseur.
GPT-5.6 Sol
Idéal pour : Les équipes souhaitant basculer depuis Astra sans modifier leur code d'intégration, en conservant l'infrastructure du SDK OpenAI tout en réduisant la facture de 60 %.
Points forts : GPT-5.6 Sol partage exactement la même fenêtre de contexte de 1 050 000 tokens, les mêmes schémas d'outils et les mêmes formats de sortie JSON qu'Astra. Sur l'indice d'Artificial Analysis, Sol affiche un score de 60,9 contre 61,2 pour Astra, ce qui préserve 99,5 % des capacités de raisonnement général. À l'usage, Sol offre un démarrage de réponse bien plus réactif sans les temps d'attente d'Astra en mode de réflexion élevée. Comme l'a souligné l'ingénieur handzhiev sur Hacker News, Sol fait office de « véritable bête de somme » qui s'avère « largement suffisante pour l'immense majorité des tâches », sans imposer de surcoût démesuré.
Points faibles : Sol a nécessité environ 75 minutes lors de la simulation OSWorld 2.0 contre 40 minutes pour Astra. Sur des flux d'agents exigeant plus de dix corrections autonomes successives, il est plus enclin à dévier ou à s'arrêter prématurément. Pour une analyse approfondie de sa gestion de mémoire, consultez notre étude sur les capacités du contexte 1M de GPT-5.6 Sol.
Tarifs indicatifs : 4,00 $ par million de tokens d'entrée, 0,50 $ en lecture de cache et 20,00 $ par million de tokens de sortie, sans pénalité au-delà de 272K.
Verdict : Adoptez GPT-5.6 Sol si votre utilisation actuelle d'Astra concerne des tâches ne nécessitant pas de pilotage graphique complexe ou d'autocorrection sur des dizaines d'étapes. C'est le choix par défaut le plus rationnel pour 80 % des charges de production.
Claude Fable 5.1 et Sonnet 5
Idéal pour : Les développeurs full-stack, les architectes logiciels et les équipes exigeant une rigueur absolue dans la lisibilité du code et le respect des abstractions.
Points forts : Les modèles d'Anthropic brillent par leur discipline stylistique et leur retenue. Alors qu'Astra peut se montrer inutilement bavard, Claude réalise des modifications précises sans casser l'architecture existante. L'ingénieur Skiffssh a fait remarquer sur Hacker News que malgré les progrès d'Astra dans la modélisation 3D, il « continuait de privilégier Claude pour le moment » en raison de son discernement technique. Par ailleurs, la mise en cache d'invites d'Anthropic accorde 75 % de réduction sur les préfixes répétés, ce qui allège considérablement le coût des longues sessions de travail.
Points faibles : Anthropic applique des limites de débit de requêtes strictes par compte d'entreprise. Les modes de réflexion adaptative peuvent faire gonfler rapidement les tokens de sortie facturés, et les filtres de sécurité refuseront fermement toute tâche touchant à l'ingénierie inverse.
Tarifs indicatifs : Tarifs officiels de 2,00 $ à 3,00 $ en entrée et de 10,00 $ à 15,00 $ en sortie par million de tokens, avec une lecture de cache à 0,20 $–0,30 $.
Verdict : Choisissez Claude Fable 5.1 ou Sonnet 5 si votre départ d'Astra est motivé par la qualité du code, la précision de conception ou l'économie offerte par la mise en cache de longs contextes.
Gemini 3.8 Flash
Idéal pour : L'extraction massive de données, le traitement de grands volumes de documents et l'ingestion multimodale d'enregistrements audio, vidéo et de fichiers PDF denses.
Points forts : Gemini 3.8 Flash associe une fenêtre de 1 048 576 tokens à une compréhension native du texte, de l'image, de l'audio et de la vidéo. Son tarif standard de 0,75 $ en entrée et 3,75 $ en sortie est plus de 85 % inférieur à celui d'Astra, et son débit d'émission dépasse très largement les performances des modèles OpenAI. Comme l'illustrent notre analyse des prix de Gemini 3.8 Flash et notre évaluation détaillée de Gemini 3.8 Flash, ce modèle constitue un levier économique incomparable pour le traitement de données volumineuses.
Points faibles : Lorsqu'il est configuré sur un niveau de réflexion élevé, son temps de réponse initial augmente sensiblement. Sur des tâches de logique très complexes multi-fichiers, ses explications peuvent devenir redondantes en l'absence de contraintes de sortie strictes.
Tarifs indicatifs : 0,75 $ par million de tokens d'entrée et 3,75 $ par million en sortie pour les requêtes sous 128K (1,50 $ / 7,50 $ pour les contextes supérieurs).
Verdict : Foncez sur Gemini 3.8 Flash si les coûts d'Astra asphyxient vos pipelines documentaires ou multimédias, et ne gardez Astra que pour les rares tâches nécessitant une exécution itérative en ligne de commande.
DeepSeek V4.1 Flash
Idéal pour : Le traitement par lots économique en arrière-plan, l'enrichissement de données et les architectures capables d'exploiter les plages horaires creuses.
Points forts : DeepSeek V4.1 Flash établit une référence tarifaire imbattable : en heures creuses, le cache descend à 0,003 $ par million de tokens, avec un prix de base de 0,15 $ en entrée et 0,60 $ en sortie. Il prend en charge 1M de contexte avec une limite de sortie élevée de 384K tokens, et gère nativement les modes direct et avec réflexion.
Points faibles : La grille tarifaire varie selon les horaires : en période de pointe en semaine (01:00–04:00 et 06:00–10:00 UTC), les prix doublent à 0,30 $ en entrée et 1,20 $ en sortie. En outre, il ne dispose pas d'agents de vision de bureau pour l'automatisation d'interfaces graphiques type OSWorld.
Tarifs indicatifs : En heures creuses : 0,15 $ entrée / 0,60 $ sortie ; en période de pointe : 0,30 $ entrée / 1,20 $ sortie par million de tokens.
Verdict : Privilégiez DeepSeek V4.1 Flash lorsque le coût par token est la priorité absolue et que vos traitements peuvent être différés en heures creuses. Ne le choisissez pas pour remplacer les fonctions d'automatisation de bureau d'Astra.
Agent Navigateur Tabbit
Idéal pour : Les analystes, professionnels et développeurs souhaitant déléguer des tâches à des agents directement sur leurs applications web et multiples onglets sans développer d'infrastructure API.
Points forts : Bien souvent, la complexité attribuée à GPT-6 Astra ne provient pas des poids du modèle, mais de l'effort considérable requis pour mettre en place l'environnement d'automatisation : configurer Playwright, analyser le DOM et gérer les délais d'attente réseau prend des jours. Le navigateur Tabbit intègre des agents d'IA multimodèles directement au sein de votre espace de navigation. Vous pouvez conduire des recherches approfondies et compiler des données d'onglets multiples grâce à un sélecteur qui attribue chaque requête au moteur le plus adapté.
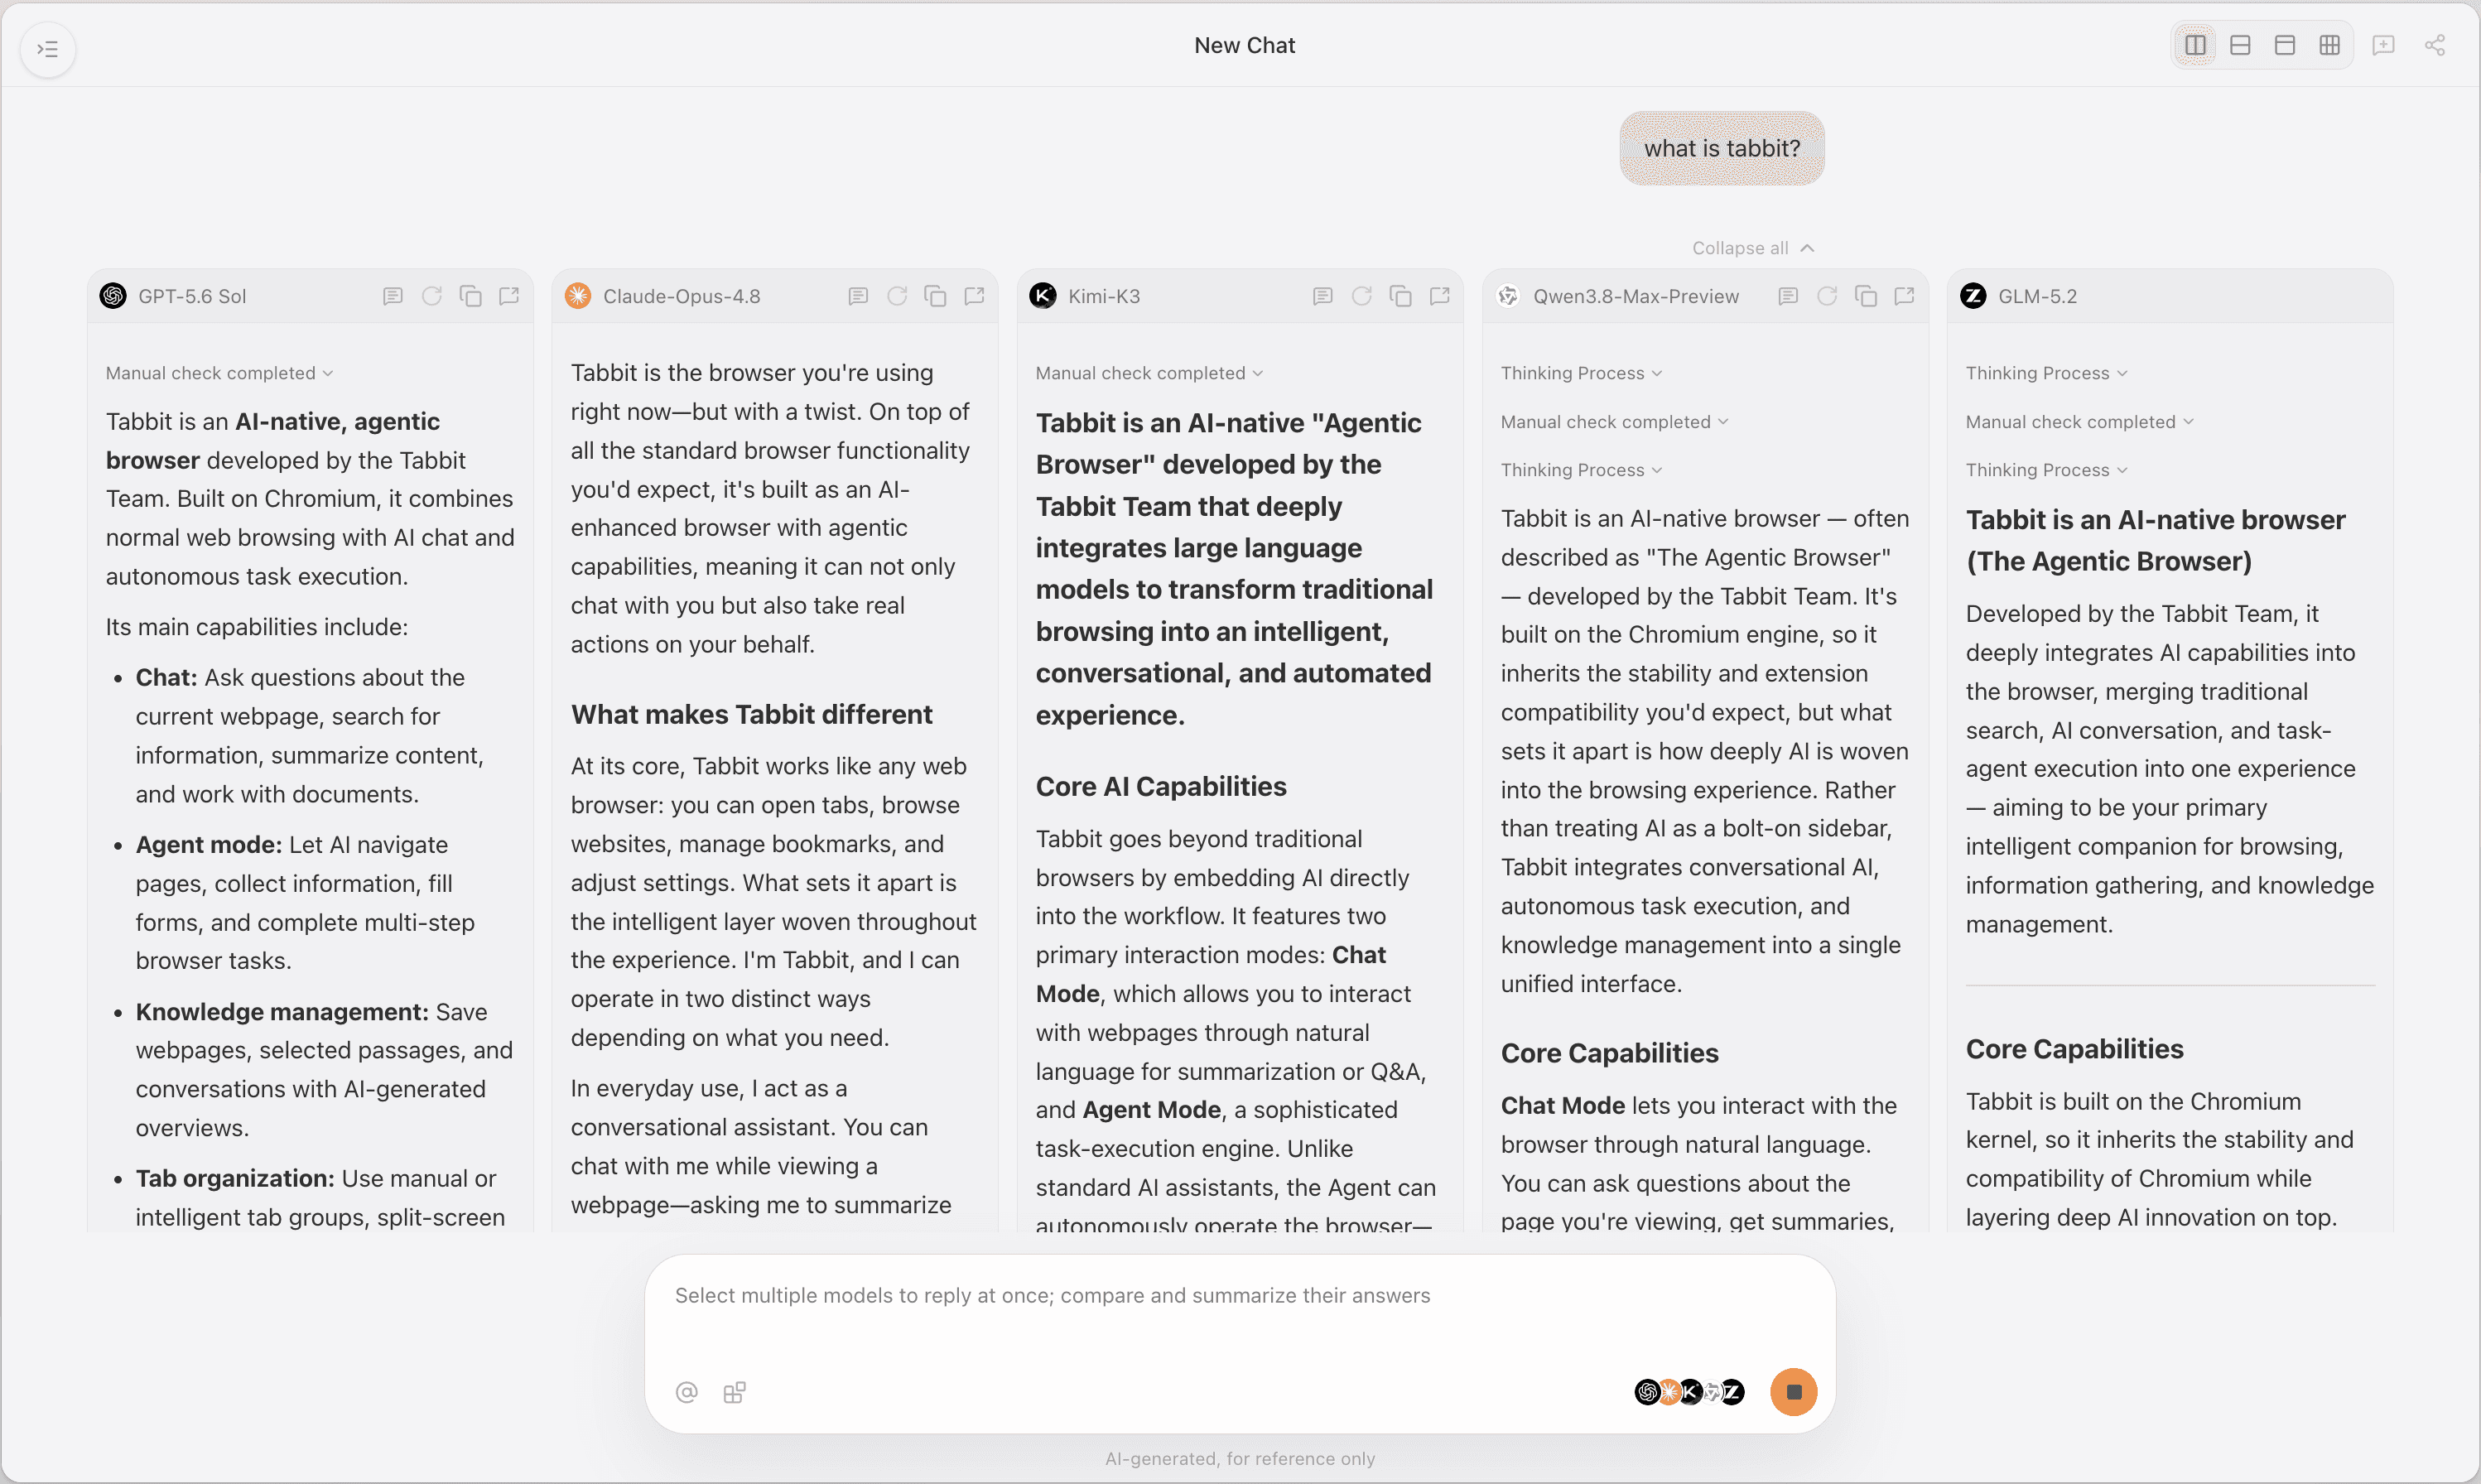
Points faibles : Tabbit est pensé pour la productivité sur ordinateur de bureau et l'automatisation interactive, et non pour servir d'API d'arrière-plan traitant des millions d'appels programmatiques automatisés.
Tarifs indicatifs : Disponible gratuitement au téléchargement sur macOS et Windows, avec une gestion flexible des modèles intégrés.
Verdict : Choisissez le navigateur Tabbit si vous payez l'API onéreuse d'Astra uniquement pour analyser des pages web, synthétiser des documents ou piloter des flux de navigation. Découvrir ce qu'est un navigateur agencé et explorer le paysage des navigateurs d'IA agencés prouve qu'un bon environnement d'exécution surpasse souvent une simple montée en version de modèle. Pour en savoir plus, consultez notre guide complet du navigateur Tabbit AI et notre dossier sur l'automatisation web.
 Tabbit Browser
Choisir selon votre contrainte opérationnelle majeure
Plutôt que de chercher un hypothétique vainqueur universel, identifiez le facteur de blocage principal de votre architecture pour sélectionner l'alternative adéquate :
| Contrainte principale | Modèle à tester en priorité | Critère de succès | Principale contrepartie |
|---|---|---|---|
| Budget API et conservation du SDK | GPT-5.6 Sol | Pipeline fonctionnel avec 60 % d'économie sans changer de code | Taux d'achèvement légèrement inférieur sur les boucles de plus de 10 étapes |
| Rigueur du code et architecture | Claude Fable 5.1 / Sonnet 5 | Moins de retouches manuelles et budget maîtrisé grâce au cache | Nécessite de gérer des limites de concurrence plus serrées |
| Traitement documentaire massif | Gemini 3.8 Flash | Réduction de plus de 85 % du coût de traitement des fichiers PDF et vidéos | Latence initiale perceptible sur les niveaux de réflexion maximale |
| Traitement par lots à coût minimal | DeepSeek V4.1 Flash | Pipelines nocturnes achevés dans les limites tarifaires d'heures creuses | Hausse des prix aux heures de pointe et absence d'outils visuels de bureau |
| Fatigue liée aux scripts et outils | Tabbit Browser Agent | Tâches exécutées directement sur vos onglets actifs sans développement | Conçu pour un usage interactif sur bureau, pas pour une API de serveur |
Protocole pour mener un test comparatif rigoureux
Avant de procéder à une refonte complète de votre infrastructure, réalisez un test comparatif sur des cas réels :
Fixez deux tâches représentatives : Une tâche de raisonnement logiciel délimitée (par exemple, remanier un module complexe de client API) et une tâche d'extraction de données (analyser un rapport financier de 50 pages en PDF avec tableaux).
Standardisez l'environnement : Utilisez rigoureusement les mêmes instructions, définitions d'outils, formats de sortie et règles de réessai sur chaque modèle.
Calculez le coût global réel : Additionnez la consommation des tokens d'entrée, de sortie, de réflexion ainsi que le temps de relecture humaine nécessaire.
Mesurez les temps de réponse : Exécutez chaque tâche au moins cinq fois par modèle pour consigner la dispersion de la latence initiale et du temps total d'exécution.
Évaluez l'autonomie d'exécution : Notez si le travail a été validé dès la première tentative sans correction humaine ou s'il a nécessité des relances.
Conclusion
GPT-6 Astra est un outil spécialisé réservé à des cas d'usage extrêmes. Si votre architecture exige qu'un agent navigue en autonomie pendant 40 minutes sur une interface de bureau ou résolve des calculs géométriques en 3D à travers une dizaine de cycles d'autocorrection, son tarif de 10 $ / 50 $ peut se justifier.
Cependant, pour l'écrasante majorité des développements informatiques et des flux de travail professionnels, Astra impose une surtaxe injustifiée de 2,5x. GPT-5.6 Sol offre des performances intellectuelles équivalentes pour 40 % du prix ; Claude surpasse la concurrence en matière d'élégance architecturale ; Gemini 3.8 Flash domine le traitement multimodal de masse ; et DeepSeek garantit le plancher tarifaire des traitements par lots. Et si votre priorité est d'automatiser des tâches sur le web sans vous encombrer de scripts fragiles, opérer avec des agents au sein du navigateur Tabbit constitue le raccourci le plus efficace vers la productivité.

Questions fréquentes
Quelle est l'alternative la plus proche dans la même gamme que GPT-6 Astra ?
GPT-5.6 Sol est la solution de repli la plus directe au sein du même écosystème. Il partage la même fenêtre de contexte de 1 050 000 tokens et le même protocole d'outils. Sur l'indice d'intelligence indépendant d'Artificial Analysis, il atteint 60,9 points (à peine 0,3 point derrière Astra), tout en réduisant les coûts de 60 % (4 $ / 20 $ contre 10 $ / 50 $ par million de tokens) avec un temps de réponse initial nettement plus rapide.
Pourquoi chercher une alternative à GPT-6 Astra s'il a battu le record d'OSWorld en 40 minutes ?
Le passage de 75 à 40 minutes sur OSWorld 2.0 (un gain de 47 %) reflète une persévérance remarquable dans les boucles de débogage autonome prolongées, et non une latence réduite dans l'usage quotidien. Pour des questions-réponses interactives, de l'assistance au code ou des requêtes courantes, Astra souffre d'un délai initial élevé, d'une inflation de tokens et d'un surcoût de 2,5x injustifié.
Quel modèle alternatif affiche les tarifs d'API officiels les plus bas ?
DeepSeek V4.1 Flash propose les tarifs les plus agressifs du marché, avec des lectures de cache en heures creuses débutant à 0,003 $ et des prix de base de 0,15 $ en entrée et 0,60 $ en sortie par million de tokens. Parmi les acteurs occidentaux majeurs, Gemini 3.8 Flash domine l'économie d'échelle à 0,75 $ / 3,75 $. Cependant, le coût réel dépend du volume de tokens de réflexion générés et des réessais.
Comment le seuil de 272K tokens d'entrée influe-t-il sur la facturation réelle ?
Dans la grille tarifaire d'OpenAI pour Astra, dès qu'une requête dépasse 272 000 tokens d'entrée, l'intégralité de l'appel est basculée sur le palier tarifaire supérieur, et pas seulement les tokens excédentaires. Cela crée une falaise économique brutale où un appel à 280K coûte bien plus cher que deux requêtes à 140K. Sol, Gemini et Claude conservent des tarifications plus prévisibles et linéaires.
Les prix par token d'API sont-ils directement comparables aux abonnements ChatGPT ou Claude Pro ?
Non. L'API fonctionne selon une facturation stricte à l'usage avec des garanties de débit et de concurrence, tandis que les abonnements grand public reposent sur un forfait mensuel (de 20 $ à 200 $) soumis à des quotas dynamiques de messages et des files d'attente. Les automatisations de production doivent impérativement s'évaluer selon les modèles économiques de l'API.
Comment tester et comparer ces modèles alternatifs directement dans le navigateur Tabbit ?
Le navigateur Tabbit intègre un sélecteur multimodèle qui permet de basculer instantanément entre GPT-6 Astra, GPT-5.6 Sol, Claude, Gemini et DeepSeek au sein du même espace de travail. Sans avoir à coder des scripts de scraping ou des connecteurs MCP, vous pouvez exécuter des requêtes en parallèle sur vos onglets actifs et fichiers locaux pour valider l'exécution en conditions réelles.