
GPT-6 Astra es un modelo sumamente capaz. En los resultados de referencia publicados por OpenAI el 3 de septiembre de 2026, redujo el tiempo de ejecución en la simulación de tareas de escritorio OSWorld 2.0 de 75 a 40 minutos —una aceleración del 47 %— aumentando la tasa de éxito al 72,6 %. En pruebas de desarrolladores independientes, demostró una tenacidad notable: completó una implementación de cliente API en Python con Codex de 33 minutos superando 13 ciclos automáticos de corrección de errores sin descarrilar, al tiempo que descubrió de 3 a 5 veces más fuentes web en tareas de investigación profunda. Si tu cuello de botella reside en la necesidad de supervisión humana constante durante flujos de agentes muy prolongados, Astra aporta una solidez genuina.
Sin embargo, las razones para explorar alternativas se sustentan en cálculos de ingeniería elementales. OpenAI fijó las tarifas estándar de la API de Astra en $10,00 por millón de tokens de entrada y $50,00 por millón de tokens de salida: exactamente 2,5 veces el coste de GPT-5.6 Sol ($4,00/$20,00). Además, si una solicitud supera los 272.000 tokens de entrada, se aplica un recargo a toda la llamada. Paralelamente, las evaluaciones independientes de Artificial Analysis indican que el índice general de inteligencia de Astra solo avanzó 0,3 puntos respecto a Sol (61,2 frente a 60,9), mientras que su puntuación promocionada del 99,9 % en ARC-AGI-3 dependía de adaptadores propietarios que cayeron al 62,7 % bajo entornos de prueba públicos estándar.
Esta discrepancia define la decisión de cambio: pagar un 150 % más en la factura de API por un incremento de razonamiento general del 0,5 % resulta económicamente ineficiente si la carga de trabajo no requiere 40 minutos de insistencia autónoma. Para canalizaciones de alto volumen, codificación interactiva ágil, análisis multimodal masivo y flujos de trabajo con supervisión humana en el bucle, existen alternativas que ofrecen resultados iguales o mejores a un coste sustancialmente menor. El análisis general de GPT-6 Astra detalla sus especificaciones técnicas y la evaluación técnica de GPT-6 Astra examina los límites de sus evaluaciones sintéticas; esta guía ofrece el mapa de decisión para elegir la alternativa adecuada.
Conclusiones clave
GPT-5.6 Sol es el reemplazo directo más eficiente: Ofrece el 99,5 % del índice de razonamiento general de Astra (60,9 frente a 61,2) con un descuento del 60 % ($4/$20 frente a $10/$50 por millón de tokens) y un tiempo hasta el primer token significativamente más rápido.
Claude Fable 5.1 y Sonnet 5 dominan la arquitectura de software: La memoria caché de indicaciones de Anthropic reduce los costes de entrada repetida en un 75 %, aportando un criterio estilístico superior en la refactorización de bases de código sin la rigidez de las advertencias legales de Astra.
Gemini 3.8 Flash es el líder en rendimiento multimodal masivo: A $0,75 de entrada y $3,75 de salida, procesa grandes volúmenes de audio, vídeo y documentos PDF con más de un 85 % de ahorro respecto a Astra.
DeepSeek V4.1 Flash optimiza el procesamiento por lotes en horas valle: Los precios de lectura de caché en horas de baja demanda descienden a $0,003 por millón de tokens, situándose como la opción idónea para tareas en segundo plano programadas.
Tabbit Browser Agent resuelve la capa de ejecución: Si la mayor complicación reside en orquestar scripts con navegadores sin cabeza, capturar árboles DOM y gestionar claves de API, ejecutar modelos directamente en Tabbit Browser elimina por completo la sobrecarga de integración.
Cuatro criterios para evaluar estas alternativas
Coste real por tarea finalizada, no tablas de tarifas teóricas: Un modelo con tarifas nominales bajas que genera 4.000 tokens redundantes o exige tres reintentos resulta más caro que uno eficiente. El coste real incluye tokens de razonamiento, tasas de acierto en caché, recargos por umbral de 272K y tiempo de revisión humana.
Latencia tolerable para interacción en tiempo real: Cuando un ingeniero espera una respuesta interactiva, el tiempo hasta el primer token (TTFT) y la estabilidad de la transmisión son prioritarios frente al rendimiento máximo por lotes.
Compatibilidad con contexto amplio, herramientas y multimodalidad: Ninguna alternativa es viable si sacrifica la ejecución nativa de herramientas, la inspección de documentos o una ventana de contexto de al menos 1 millón de tokens.
Evidencia empírica contrastada en entornos reales: Damos prioridad a experiencias documentadas de desarrollo, incidencias reales y limitaciones observadas por la comunidad técnica en Hacker News y Reddit frente a reclamos comerciales.
Cinco alternativas de un vistazo
| Candidato | Ideal para | Vía de acceso | Precio verificado (22-09-2026) | Contexto / Salida máx. | Principal contrapartida (The main catch) |
|---|---|---|---|---|---|
| GPT-5.6 Sol | Reemplazo inmediato de bajo coste de la misma familia | gpt-5.6-sol | $4,00 entrada / $20,00 salida por 1M | 1.050.000 / 128.000 | Menor autonomía en bucles de escritorio de más de 10 pasos |
| Claude Fable 5.1 / Sonnet 5 | Arquitectura de software y refactorización precisa | claude-fable-5-1 / claude-sonnet-5 | $2,00–$3,00 entrada / $10,00–$15,00 salida | 1.000.000 / 128.000 | Límites de concurrencia organizativa estrictos y alto coste de razonamiento adaptativo |
| Gemini 3.8 Flash | Procesamiento multimodal masivo de alto rendimiento | gemini-3-8-flash | $0,75 entrada / $3,75 salida por 1M | 1.048.576 / 65.536 | Mayor tiempo hasta el primer token con esfuerzo de pensamiento alto |
| DeepSeek V4.1 Flash | Procesamiento por lotes programado en horas valle | deepseek-flash | Horas valle: $0,15 entrada / $0,60 salida | 1.000.000 / 384.000 | Recargo en ventanas horarias punta y ausencia de agente visual de escritorio |
| Tabbit Browser Agent | Ejecución de flujos web sin código de enlace | Entorno integrado de escritorio | Selector multimodelo integrado | DOM de pestañas activas + Archivos locales | Herramienta de productividad de escritorio, no un servicio de API sin cabeza |
Notas sobre tarifas: Precios correspondientes a niveles estándar de API verificados el 22 de septiembre de 2026. Los tokens de razonamiento se facturan como tokens de salida. Los aciertos en caché reducen la tarifa de entrada entre un 75 % y un 90 %.
GPT-5.6 Sol
Ideal para: Equipos que buscan una transición sin fricción desde Astra, conservando el SDK y la infraestructura de OpenAI pero reduciendo los costes de API en un 60 %.
Puntos fuertes: GPT-5.6 Sol comparte la misma ventana de contexto de 1.050.000 tokens, esquemas idénticos de llamadas a funciones y respuestas estructuradas en JSON. En el índice de Artificial Analysis, Sol obtuvo 60,9 puntos frente a los 61,2 de Astra, manteniendo prácticamente el mismo nivel de razonamiento general. En la práctica, ofrece un tiempo de respuesta inicial sensiblemente más ágil, evitando las pausas prolongadas de Astra en modos de pensamiento avanzado. Como señaló el desarrollador handzhiev en Hacker News, Sol funciona como un "auténtico caballo de batalla" que resulta "suficiente para la inmensa mayoría de tareas" sin incurrir en costes desmedidos.
Contrapartidas: Sol requirió aproximadamente 75 minutos en la simulación de OSWorld 2.0 frente a los 40 minutos de Astra. En tareas de agentes que exigen más de diez ciclos consecutivos de autocorrección, presenta mayor tendencia a desviarse o detenerse prematuramente. Para un análisis detallado de su gestión de memoria, consulta nuestra guía sobre las capacidades de contexto de 1M en GPT-5.6 Sol.
Precios de referencia: $4,00 por millón de tokens de entrada, $0,50 para aciertos en caché y $20,00 por millón de tokens de salida, sin penalizaciones por umbral de 272K.
Veredicto: Elige GPT-5.6 Sol si tu consumo actual en Astra se destina a tareas que no requieren navegación compleja por interfaces de escritorio ni ciclos iterativos masivos de autocorrección. Es la opción predeterminada más sensata para el 80 % de las cargas de trabajo de producción.
Claude Fable 5.1 y Sonnet 5
Ideal para: Desarrolladores full-stack, arquitectos de sistemas y equipos que priorizan la claridad del código, el rigor en las abstracciones y el seguimiento meticuloso de instrucciones.
Puntos fuertes: La familia de modelos de Anthropic destaca por su disciplina estilística y contención. Frente a la verbosidad ocasional de Astra, Claude ejecuta modificaciones limpias y modulares. El ingeniero Skiffssh indicó en Hacker News que, pese a los avances de Astra en generación geométrica 3D, "seguirá apostando por Claude durante un buen tiempo" debido a su criterio técnico en desarrollo de software. Además, el almacenamiento en caché de Anthropic ofrece un descuento del 75 % en prefijos repetidos, reduciendo enormemente el coste de sesiones largas de desarrollo.
Contrapartidas: Anthropic aplica límites de velocidad y concurrencia organizacional rigurosos. El razonamiento adaptativo profundo puede elevar rápidamente los tokens de salida facturables y sus filtros de seguridad, aunque menos burocráticos que los de Astra, denegarán de forma tajante tareas relacionadas con ingeniería inversa o análisis de vulnerabilidades.
Precios de referencia: Tarifas estándar de $2,00–$3,00 de entrada y $10,00–$15,00 de salida por millón de tokens, con lecturas de caché a $0,20–$0,30.
Veredicto: Elige Claude Fable 5.1 o Sonnet 5 si el motivo para abandonar Astra es la calidad del código, la precisión arquitectónica o el ahorro derivado de la caché en contextos extensos.
Gemini 3.8 Flash
Ideal para: Extracción masiva de datos estructurados, síntesis de grandes volúmenes documentales y flujos de trabajo que procesan horas de audio, vídeo o miles de páginas en PDF.
Puntos fuertes: Gemini 3.8 Flash combina una ventana de 1.048.576 tokens con comprensión multimodal nativa de texto, imágenes, audio y vídeo. Su tarifa de $0,75 de entrada y $3,75 de salida es más de un 85 % inferior a la de Astra, y su velocidad de generación duplica holgadamente la del modelo de OpenAI. Como se explica en nuestro desglose de precios de Gemini 3.8 Flash y en la revisión detallada de Gemini 3.8 Flash, ofrece una ventaja operativa decisiva en el tratamiento de datos no estructurados.
Contrapartidas: En modos de pensamiento elevado, la latencia hasta el primer token aumenta notablemente. En tareas lógicas complejas con múltiples archivos de código, puede divagar si las instrucciones no incluyen restricciones estrictas de salida.
Precios de referencia: $0,75 por millón de tokens de entrada y $3,75 por millón de salida en peticiones de hasta 128K ($1,50 / $7,50 para contextos mayores).
Veredicto: Opta por Gemini 3.8 Flash si los costes de Astra están ahogando tus canalizaciones de ingesta documental o análisis multimedia, reservando Astra únicamente para flujos que precisen ejecución iterativa en terminal.
DeepSeek V4.1 Flash
Ideal para: Procesamiento por lotes de bajo presupuesto, enriquecimiento masivo de datos y arquitecturas que pueden programar ejecuciones en horarios valle.
Puntos fuertes: DeepSeek V4.1 Flash establece una referencia agresiva en costes: en horas valle, los aciertos en caché descienden a $0,003 por millón de tokens, con tarifas base de entrada de $0,15 y salida de $0,60. Cuenta con 1M de contexto, un límite máximo de salida de 384K tokens y soporte tanto para modos directos como de pensamiento deliberado.
Contrapartidas: Aplica tarifas diferenciadas por franjas horarias: en horas punta laborables (01:00–04:00 y 06:00–10:00 UTC), los precios se duplican a $0,30 de entrada y $1,20 de salida. Asimismo, no dispone de agentes visuales de escritorio nativos para automatización de interfaces tipo OSWorld.
Precios de referencia: En horas valle: $0,15 entrada / $0,60 salida; en horas punta: $0,30 entrada / $1,20 salida por millón de tokens.
Veredicto: Elige DeepSeek V4.1 Flash cuando el coste por token sea la métrica crítica y puedas planificar las cargas de trabajo en horas de baja demanda. No es adecuado como sustituto directo para automatización gráfica de escritorio.
Tabbit Browser Agent
Ideal para: Profesionales, analistas y desarrolladores que necesitan ejecutar tareas de agentes directamente en aplicaciones web, paneles SaaS y múltiples pestañas sin programar código de integración.
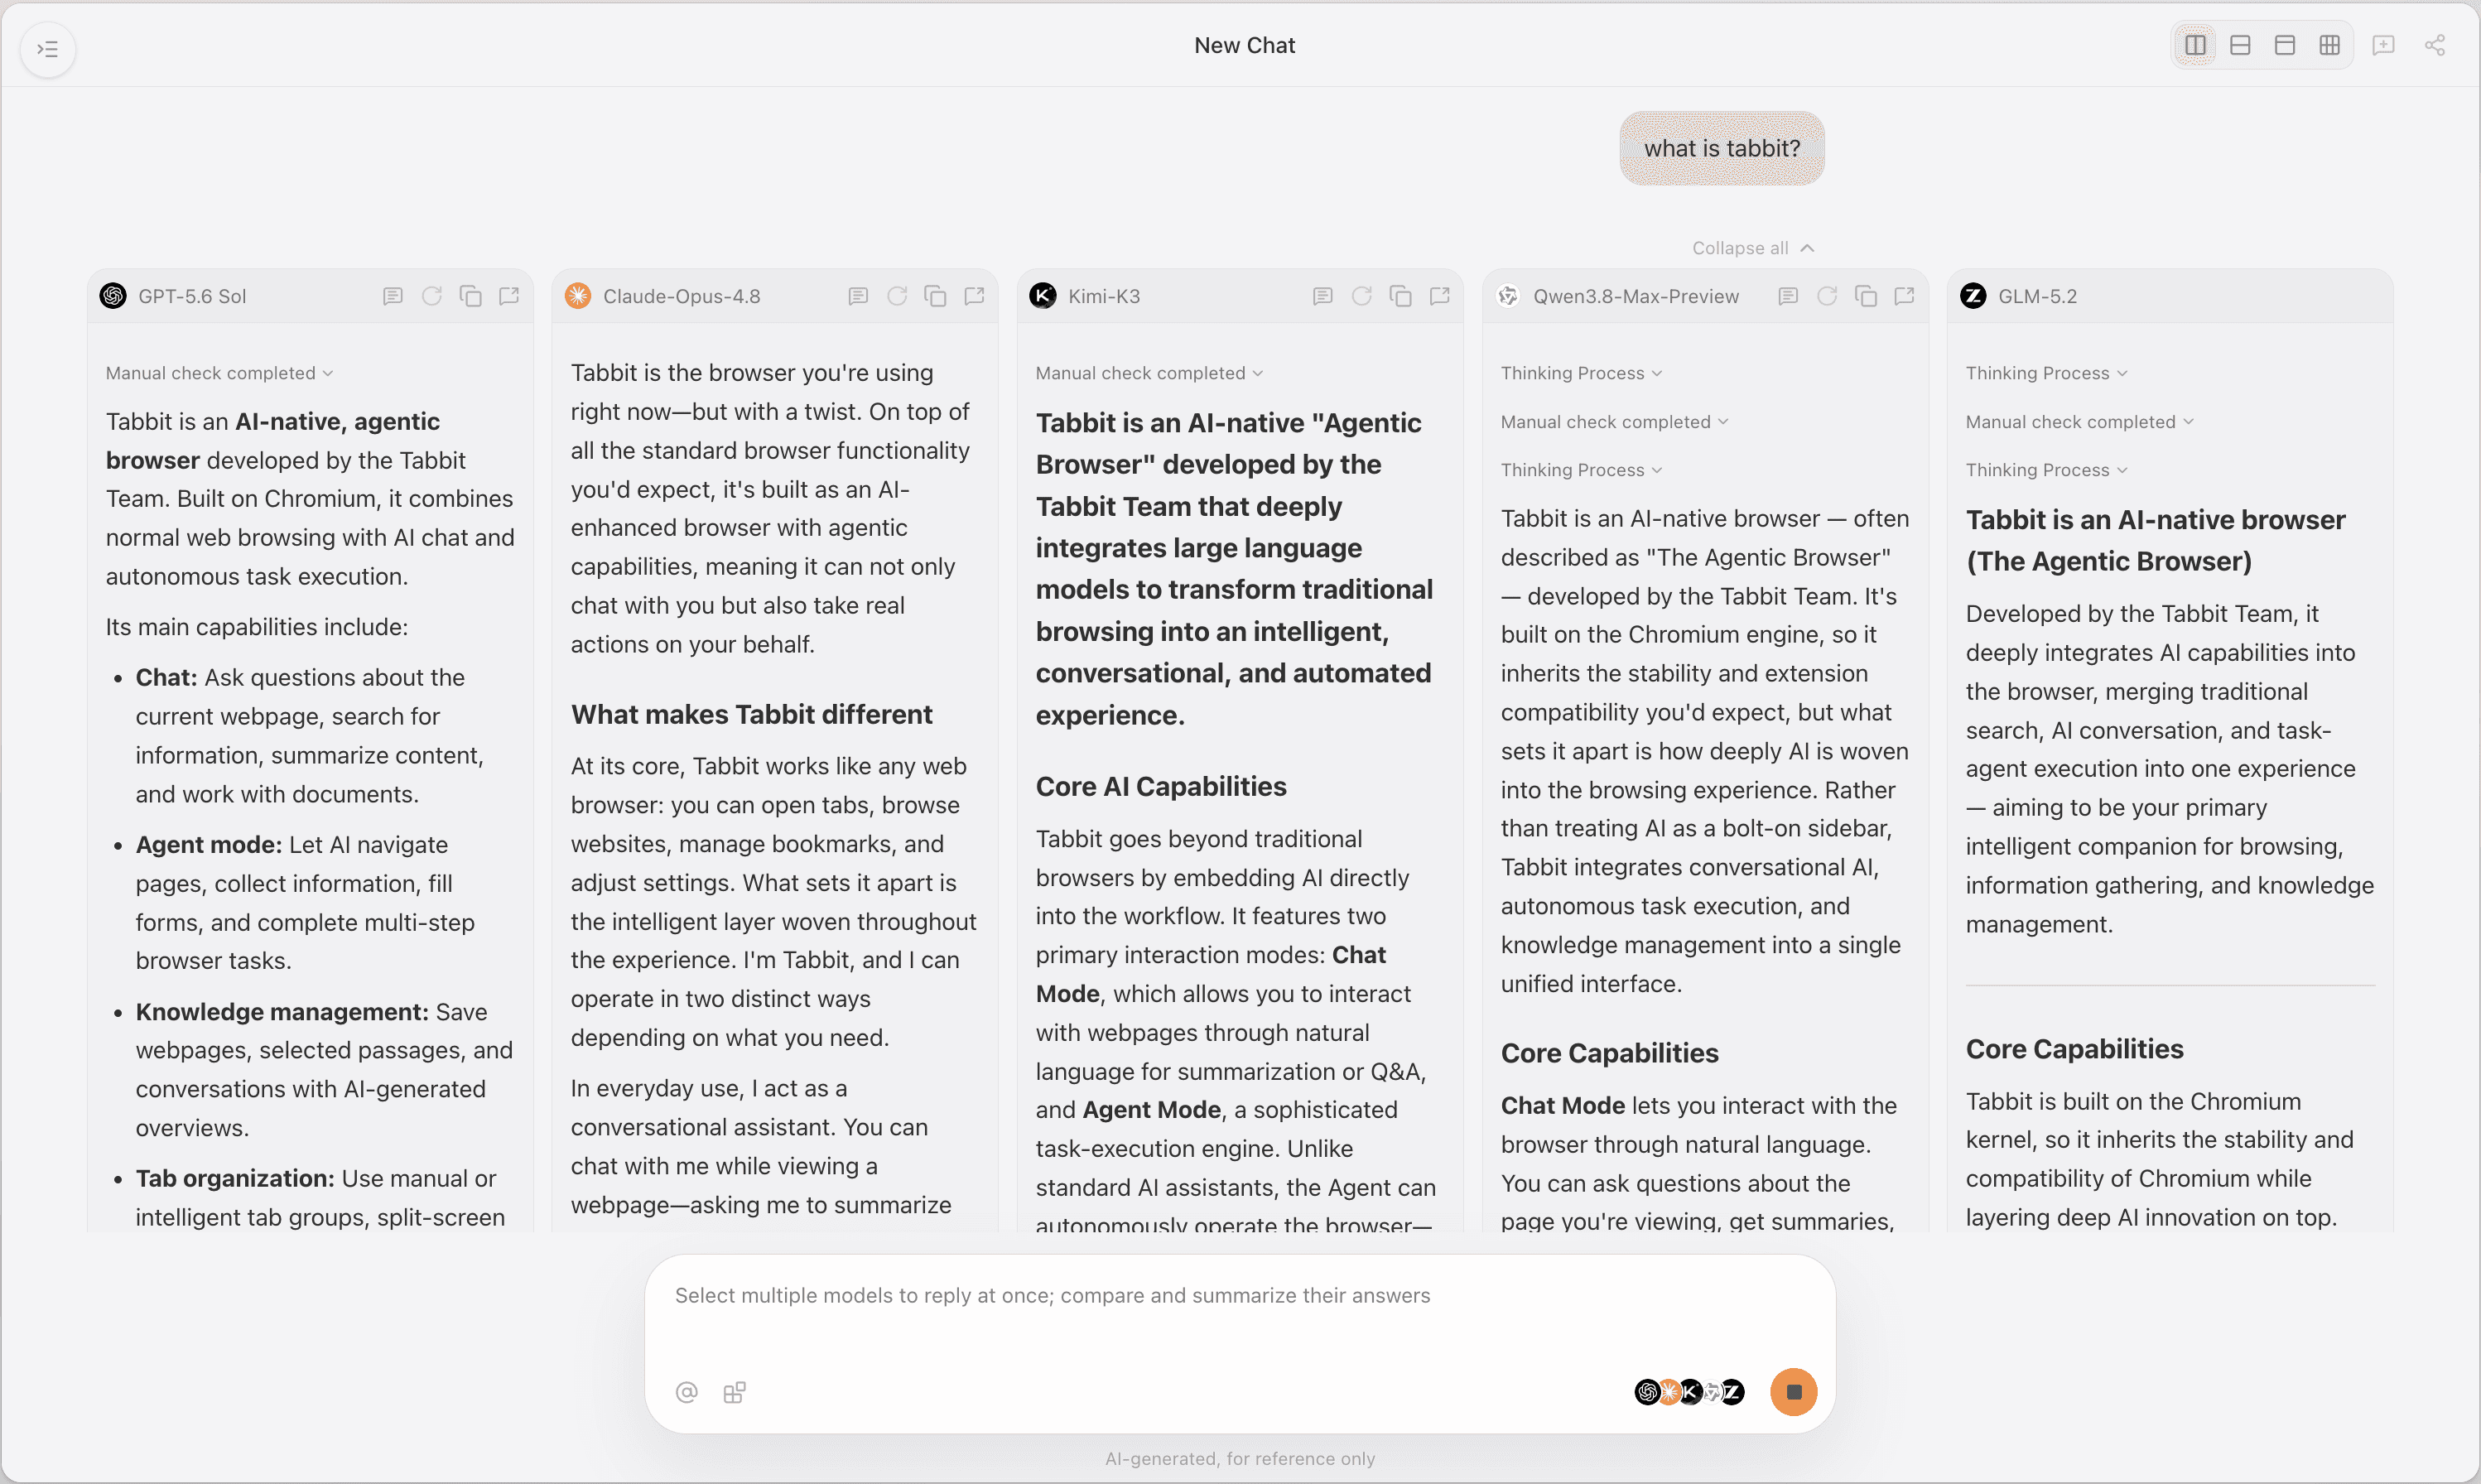
Puntos fuertes: A menudo, las dificultades atribuidas a GPT-6 Astra no provienen del modelo en sí, sino de la complejidad de construir el entorno de ejecución: configurar navegadores sin cabeza, capturar árboles DOM y gestionar tiempos de espera consume jornadas enteras. Tabbit Browser integra agentes multimodelo directamente en el espacio de trabajo del navegador. Es posible realizar investigaciones profundas y consolidar información entre pestañas utilizando un selector integrado que asigna la tarea al motor más adecuado.
Contrapartidas: Tabbit Browser está optimizado para la productividad en el escritorio, la interacción en tiempo real y la automatización del flujo de trabajo personal, no como un punto de enlace de backend para millones de peticiones programáticas.
Precios de referencia: Disponible para descarga y prueba gratuita en macOS y Windows, con flexibilidad para utilizar diversos motores de IA.
Veredicto: Elige Tabbit Browser si recurres a la costosa API de Astra simplemente para analizar sitios web, revisar documentos o gestionar flujos de navegación. Comprender qué es un navegador agéntico y analizar las opciones de navegadores con IA agéntica demuestra que una buena capa de ejecución supera a menudo la mera actualización de modelo. Descubre más en nuestra guía del navegador Tabbit AI y en la sección sobre automatización del navegador.
 Tabbit Browser
Cómo elegir según tu principal limitación técnica
En lugar de buscar un modelo universalmente superior, identifica la restricción que genera fricción en tu flujo y selecciona la alternativa correspondiente:
| Limitación principal | Modelo recomendado para pruebas | Criterio de éxito | Principal contrapartida |
|---|---|---|---|
| Presupuesto de API y compatibilidad | GPT-5.6 Sol | La canalización opera con un 60 % menos de coste sin alterar el código existente | Menor tasa de resolución en bucles autónomos de más de 10 iteraciones |
| Calidad de código y refactorización | Claude Fable 5.1 / Sonnet 5 | Menos correcciones manuales y reducción del coste en sesiones iterativas con caché | Requiere gestionar límites de concurrencia organizativos más estrictos |
| Volumen masivo y multimodalidad | Gemini 3.8 Flash | Reducción superior al 85 % en el coste de procesamiento de PDFs extensos y vídeos | Latencia de inicio perceptible en modos de pensamiento profundo |
| Procesamiento por lotes económico | DeepSeek V4.1 Flash | Procesos nocturnos completados dentro de las tarifas reducidas de horas valle | Fluctuaciones de latencia en horas punta y sin herramientas visuales de escritorio |
| Sobrecarga de scripts y configuración | Tabbit Browser Agent | Ejecución directa entre pestañas sin desarrollar raspadores ni código intermedio | Diseñado para interacción en escritorio, no para APIs de backend a gran escala |
Protocolo de prueba comparativa
Antes de acometer una migración técnica completa, realiza una prueba controlada con tareas reales:
Fija dos tareas representativas: Selecciona un problema de razonamiento acotado (por ejemplo, refactorizar un módulo de cliente API complejo) y una tarea de procesamiento de datos (como estructurar un informe financiero de 50 páginas en PDF).
Estandariza las condiciones: Mantén idénticas las instrucciones del prompt, las especificaciones de herramientas, los esquemas de salida y las reglas de reintento en todos los modelos.
Mide el coste efectivo total: Registra los tokens de entrada, salida y razonamiento consumidos, además del tiempo invertido en supervisión humana.
Registra las curvas de latencia: Anota el tiempo hasta el primer token y el tiempo total de ejecución en al menos cinco iteraciones por modelo para evaluar la dispersión.
Verifica la tasa de autonomía: Comprueba si la tarea se completó sin intervención manual en el primer intento o si necesitó correcciones adicionales.
Veredicto
GPT-6 Astra es una herramienta de ingeniería diseñada para casos de uso específicos y de alta exigencia. Si tu sistema requiere que un agente opere una interfaz gráfica de escritorio sin instrumentar durante 40 minutos o resuelva geometrías complejas en 3D mediante ciclos continuos de depuración, su coste de $10/$50 está justificado.
Sin embargo, para la mayoría de los desarrollos de software y aplicaciones empresariales, Astra impone un sobrecoste innecesario de 2,5x. GPT-5.6 Sol ofrece prácticamente la misma capacidad general a un 40 % del precio; Claude proporciona una calidad técnica superior en el mantenimiento de código; Gemini 3.8 Flash sobresale en flujos multimodales de gran volumen; y DeepSeek fija el suelo de costes en procesamiento por lotes. Por último, si tu objetivo es agilizar tareas y extraer conocimiento en la web sin mantener infraestructuras complejas, operar con agentes dentro de Tabbit Browser es el camino más directo y eficiente.

Preguntas frecuentes
¿Cuál es la alternativa más cercana dentro de la misma familia a GPT-6 Astra?
GPT-5.6 Sol es la alternativa directa más natural. Comparte la misma ventana de contexto de 1.050.000 tokens y el protocolo de llamadas a herramientas. En el índice de inteligencia independiente de Artificial Analysis obtuvo 60,9 puntos (solo 0,3 puntos por debajo de Astra), pero reduce los costes un 60 % ($4/$20 frente a $10/$50 por millón de tokens) con una latencia de respuesta inicial mucho más rápida.
¿Por qué considerar alternativas a GPT-6 Astra si logró el récord de 40 minutos en OSWorld?
Porque la reducción del 47 % del tiempo en OSWorld 2.0 (40 frente a 75 minutos) refleja resistencia autónoma en bucles de depuración prolongados, no una menor latencia en interacciones cotidianas. Para preguntas y respuestas, soporte de programación o chats interactivos, Astra introduce esperas prolongadas en el primer token, inflación de tokens y un recargo de precio de 2,5x que no aporta beneficios perceptibles en tareas comunes.
¿Qué modelo alternativo ofrece el precio de API publicado más bajo?
DeepSeek V4.1 Flash ofrece las tarifas más bajas del mercado, con aciertos de caché en horas valle a partir de $0,003 y precios base de entrada y salida de $0,15 y $0,60 por millón de tokens. Entre los proveedores punteros occidentales, Gemini 3.8 Flash lidera en economía con $0,75/$3,75. Sin embargo, el coste real por tarea depende de la verbosidad y de los tokens de razonamiento generados.
¿Cómo afecta el umbral de 272K tokens de entrada al coste total?
En los precios oficiales de OpenAI para Astra, si una solicitud supera los 272.000 tokens de entrada, toda la llamada se factura a la tarifa superior por tramos, no solo el exceso. Esto genera un salto de coste abrupto: una petición de 280K cuesta considerablemente más que dos llamadas de 140K. Modelos como Sol, Gemini y Claude mantienen estructuras tarifarias más lineales.
¿Se pueden comparar los precios por token de API con las suscripciones mensuales de ChatGPT o Claude Pro?
No. Las tarifas de API se calculan estrictamente por consumo y volumen de tokens con garantías de concurrencia, mientras que las suscripciones de consumo aplican una tarifa plana mensual ($20 a $200) sujeta a límites dinámicos de mensajes, colas y cuotas horarias. Las cargas de trabajo que requieren automatización programática o integración en producción deben presupuestarse según los costes reales de API.
¿Cómo puedo probar y comparar estos modelos alternativos dentro de Tabbit Browser?
Tabbit Browser incluye un selector multimodelo integrado que permite alternar entre GPT-6 Astra, GPT-5.6 Sol, Claude, Gemini y DeepSeek en una única interfaz. En lugar de desarrollar scripts de extracción o código de enlace con MCP, los usuarios pueden ejecutar consultas en paralelo aprovechando las pestañas activas, archivos locales y documentos abiertos.