
GPT-6 Astra 确实是一项令人印象深刻的工程成果。在 OpenAI 于 2026 年 9 月 3 日发布的官方测评中,它在桌面端模拟测试集 OSWorld 2.0 上的执行时间由 GPT-5.6 Sol 的 75 分钟大幅缩短至 40 分钟,速度提升约 47%,并将任务完成率推进至 72.6%。在独立开发者的实测中,它成功跑通了历时 33 分钟、经历 13 轮自动报错与排错重试的 Codex Python 客户端构建,且在长程网络深度调研中发现了 3 至 5 倍的多源信息。如果你的业务瓶颈在于需要人类长时间盯盘监护复杂的长程 Agent 循环,Astra 展现出了无可替代的自愈执行力。
然而,决定寻找替代方案的理由同样来自严肃的工程账本。OpenAI 将 Astra 的标准 API 费率定为每百万输入 Token $10.00、输出 $50.00,整整是 GPT-5.6 Sol($4.00/$20.00)的 2.5 倍。更为苛刻的是,一旦单次请求输入超过 272,000 Token,整笔调用将立即触发高阶溢价。与此同时,来自 Artificial Analysis 的中立质量评估显示,Astra 的智力综合指数仅从 Sol 的 60.9 微升至 61.2(增幅仅 0.3 分),而其 ARC-AGI-3 宣称的 99.9% 惊人成绩完全由专用 Adapter 驱动,在标准公开测试框架下骤降至 62.7%。
这就是核心选型权衡所在:如果你从事的工作不需要模型进行长达 40 分钟的连续自主试错,那么为仅 0.5% 的通用智商增量多支付 150% 的账单,本质上是在为“过剩的顽固性”缴纳昂贵的税费。对于大吞吐批处理、敏捷交互式编码、海量多模态文档解析以及日常办公辅助,完全有更经济、响应更迅速的替代路径。读者可在 GPT-6 Astra 总览 中查验规格参数,在 GPT-6 Astra 深度测评 中审视基准水分,而本文将提供清晰的替代选型路线图。
核心结论
GPT-5.6 Sol 是最稳妥的同门降级选项: 保留了 Astra 99.5% 的通用推理水平(60.9 vs 61.2),成本立省 60%($4/$20 对比 $10/$50),且首 Token 响应明显更敏捷。
Claude Fable 5.1 与 Sonnet 5 执掌复杂代码架构: 依靠最高 75% 的 Prompt 缓存折扣,在长代码重构与逻辑严密性上维持出色的品味,且没有 Astra 频繁弹出的合规说教。
Gemini 3.8 Flash 是高吞吐多模态效率冠军: 输入仅 $0.75 / 输出 $3.75,吞吐单价较 Astra 降低 85% 以上,原生支持长视频、音频和超大 PDF 批处理。
DeepSeek V4.1 Flash 释放极致离峰批处理算力: 离峰缓存命中低至 $0.003 / 基础输入 $0.15,是构建定时后台任务、成本高度敏感型工作流的首选。
Tabbit 浏览器 Agent 彻底解构运行时门槛: 若痛点在于编写爬虫、解析 DOM 树以及配置复杂的无头工具链,直接在 Tabbit 浏览器中调用多模型能省去所有工程胶水代码。
筛选替代模型的四大标准
已完成任务的真实花费,而非单纯的标称价目表: 标价便宜但频繁输出数千字废话、或需要三次人工重试的模型并不划算。综合成本必须计算思考 Token 膨胀系数、上下文缓存利用率、272K 溢价断崖以及工程师介入校正的时间成本。
人在回路交互的可忍受延迟: 当工程师在终端或对话框前等待时,首 Token 生成时间(TTFT)与流式输出的稳定性远比后台峰值吞吐重要。后台异步 Agent 可以容忍 40 分钟,但交互结对编程不行。
上下文、多模态与工具链生态匹配度: 替换模型绝不能以丢失原生工具调用(Tool Calls)、结构化提取或百万 Token 上下文解析为代价。
经真实开发者核验的一手实践证据: 摒弃合成基准天梯榜,优先采信 Hacker News 与 Reddit 工程师在生产踩坑中沉淀的报错、速率限制与可用性实测。
五款替代方案速览
| 候选模型 | 最佳适用场景 | 官方调用路线 | 核验费率(2026-09-22) | 上下文 / 最大输出 | 主要权衡与短板(The main catch) |
|---|---|---|---|---|---|
| GPT-5.6 Sol | 最直接的同门低成本工作马 | gpt-5.6-sol | 输入 $4.00 / 输出 $20.00(每 1M) | 1,050,000 / 128,000 | 在超过 10 步的复杂桌面自动化闭环中顽固度略逊 |
| Claude Fable 5.1 / Sonnet 5 | 复杂系统架构与精细代码重构 | claude-fable-5-1 / claude-sonnet-5 | 输入 $2.00–$3.00 / 输出 $10.00–$15.00 | 1,000,000 / 128,000 | 组织并发速率限制严格,高思考模式单价高昂 |
| Gemini 3.8 Flash | 海量多模态数据抽取与极速吞吐 | gemini-3-8-flash | 输入 $0.75 / 输出 $3.75(每 1M) | 1,048,576 / 65,536 | 最大思考 Effort 下首 Token 延迟存在明显等待 |
| DeepSeek V4.1 Flash | 定时离峰批量推理与极低预算批处理 | deepseek-flash | 离峰输入 $0.15 / 输出 $0.60(每 1M) | 1,000,000 / 384,000 | 工作日高峰期存在阶梯加价,无原生桌面视觉 Agent |
| Tabbit 浏览器 Agent | 无需胶水代码的桌面与网页工作流 | 桌面内置执行环境 | 动态集成多模型选择器 | 活动标签 DOM + 本地文件 | 专注桌面交互与工作流,非无头高并发后台接口 |
计价说明:费率基于 2026 年 9 月 22 日官方标准 API。思考 Token 按输出计费。Prompt Caching 命中可使输入单价降低 75% 至 90%。
GPT-5.6 Sol
最佳适用: 希望以零代码重构成本从 Astra 迁移、继续沿用现有 OpenAI SDK 生态并将账单直降 60% 的工程团队。
核心优势: GPT-5.6 Sol 与 Astra 拥有完全一致的 1,050,000 Token 上下文窗口、相同的 JSON 结构化约束以及一致的函数调用接口。在 Artificial Analysis 质量指数中,Sol 测得 60.9 分,与 Astra 的 61.2 分相比几乎没有通用能力断层。在日常调用中,Sol 的首 Token 响应显著优于 Astra,避免了高思考档位带来的长时间卡顿。Hacker News 工程师 handzhiev 在评估中指出,Sol 是名副其实的“可靠工作马”,“足以应付绝大多数生产任务”,无需为前沿概念支付溢价。
主要短板: Sol 在 OSWorld 2.0 桌面长程任务中的表现为 75 分钟,且在超过 10 轮的连续自愈报错测试中,比 Astra 更容易出现逻辑退化或提前退出。关于其上下文窗口的详细表现,可参考我们针对 GPT-5.6 Sol 100 万 Token 窗口能力 的深度解读。
参考计费: 输入每百万 Token $4.00,缓存命中 $0.50,输出 $20.00。不存在 272K 门槛惩罚性加价。
明确裁决: 如果你的调用场景不涉及长达半小时的复杂桌面 GUI 试错或十余步深度排错,GPT-5.6 Sol 是替代 Astra 最理性的默认选项。
Claude Fable 5.1 与 Sonnet 5
最佳适用: 全栈架构师、系统工程师以及对代码可维护性、重构逻辑及指令精细遵循有极高要求的研发团队。
核心优势: Anthropic 家族在复杂工程编码中展现出更高的逻辑严密性与克制力。与 Astra 偶现的过度冗长不同,Claude 在进行仓库级重构时能准确把握抽象边界。工程师 Skiffssh 在 Hacker News 上分享道,尽管 Astra 在 3D 几何生成上有所突破,但他“依然会在常规代码架构中坚守 Claude”。此外,Anthropic 的 Prompt Caching 可为重复前缀输入提供 75% 的可观减免,大幅削减多轮调试的实际支出。
主要短板: Anthropic 的组织并发速率限制相对苛刻,容易在突发高并发请求时触发限流重试;自适应思考开启后输出 Token 增长迅速,且安全防护策略虽然不像 Astra 那样充满官僚口吻,但在逆向工程等边缘场景下仍会直接拒绝。
参考计费: 标准费率约为输入 $2.00–$3.00、输出 $10.00–$15.00 每百万 Token,缓存命中输入低至 $0.20–$0.30。
明确裁决: 若促使你离开 Astra 的是代码生成的工程品味、逻辑严谨度或长上下文缓存效益,切换至 Claude 是最佳技术决策。
Gemini 3.8 Flash
最佳适用: 海量文档抽取、长音视频理解、大批次爬虫信息结构化等对吞吐速度和单位成本高度敏感的业务。
核心优势: Gemini 3.8 Flash 提供了原生跨模态理解能力与超高并发生成速率,能够直接处理超长视频、录音与图文混排 PDF。其官方输入单价 $0.75 / 输出 $3.75 比 Astra 低出 85% 以上,且长文本生成吞吐远超 OpenAI 旗舰型号。正如我们在 Gemini 3.8 Flash 费率解析 与 Gemini 3.8 Flash 全面评测 中所测算的,它在批量数据流水线中具备压倒性的单位产出效益。
主要短板: 在启用 High 思考模式时,其首 Token 延迟增加;若提示词缺乏极其严格的结构约束,在处理超长复杂推理时论述容易发散。
参考计费: 128K 以内输入 $0.75 / 输出 $3.75(超长窗口输入 $1.50 / 输出 $7.50)。
明确裁决: 如果 Astra 的昂贵账单是由海量文件解析、多模态清洗或日常批量抽取引起的,果断迁移至 Gemini 3.8 Flash。
DeepSeek V4.1 Flash
最佳适用: 成本红线极其严苛的后端批处理、海量数据清洗与能够进行夜间错峰调度的背景任务。
核心优势: DeepSeek V4.1 Flash 确立了极具冲击力的离峰价格标杆:非高峰期缓存命中仅 $0.003,基础输入 $0.15,输出 $0.60。它具备 1M 上下文与 384K 的超大输出上限,兼具思考与非思考模式。在开发者社群中,其透明的计费与性价比备受好评。
主要短板: 工作日高峰时段(UTC 01:00–04:00 及 06:00–10:00)费率翻倍至输入 $0.30 / 输出 $1.20;公网服务在亚太业务高峰偶有排队波动;且不具备像 Astra 那样经过专门针对桌面操作系统优化的原生视觉执行代理。
参考计费: 离峰输入 $0.15 / 输出 $0.60,高峰输入 $0.30 / 输出 $1.20 每百万 Token。
明确裁决: 当任务预算受限且系统具备离峰缓冲能力时,DeepSeek V4.1 Flash 极具性价比;但切勿尝试将其作为桌面级 GUI 自动化的直接替代品。
Tabbit 浏览器 Agent
最佳适用: 需要直接面向网页 SaaS、在线看板、数据多标签页开展调研与协作,却不愿编写任何无头浏览器和 API 胶水代码的用户。
核心优势: 很多时候,使用者对 GPT-6 Astra 的抱怨并不源于模型本身,而是源于维护自动化环境的巨大疲劳。配置 Playwright、处理验证码、截取 DOM 树与调试网络超时会消耗大量开发时间。Tabbit 浏览器 将多模型调度与工作流直接集成在日常浏览器环境中,用户可在阅读页面时直接呼出侧边栏,按需分派任务给最适合的底层模型。
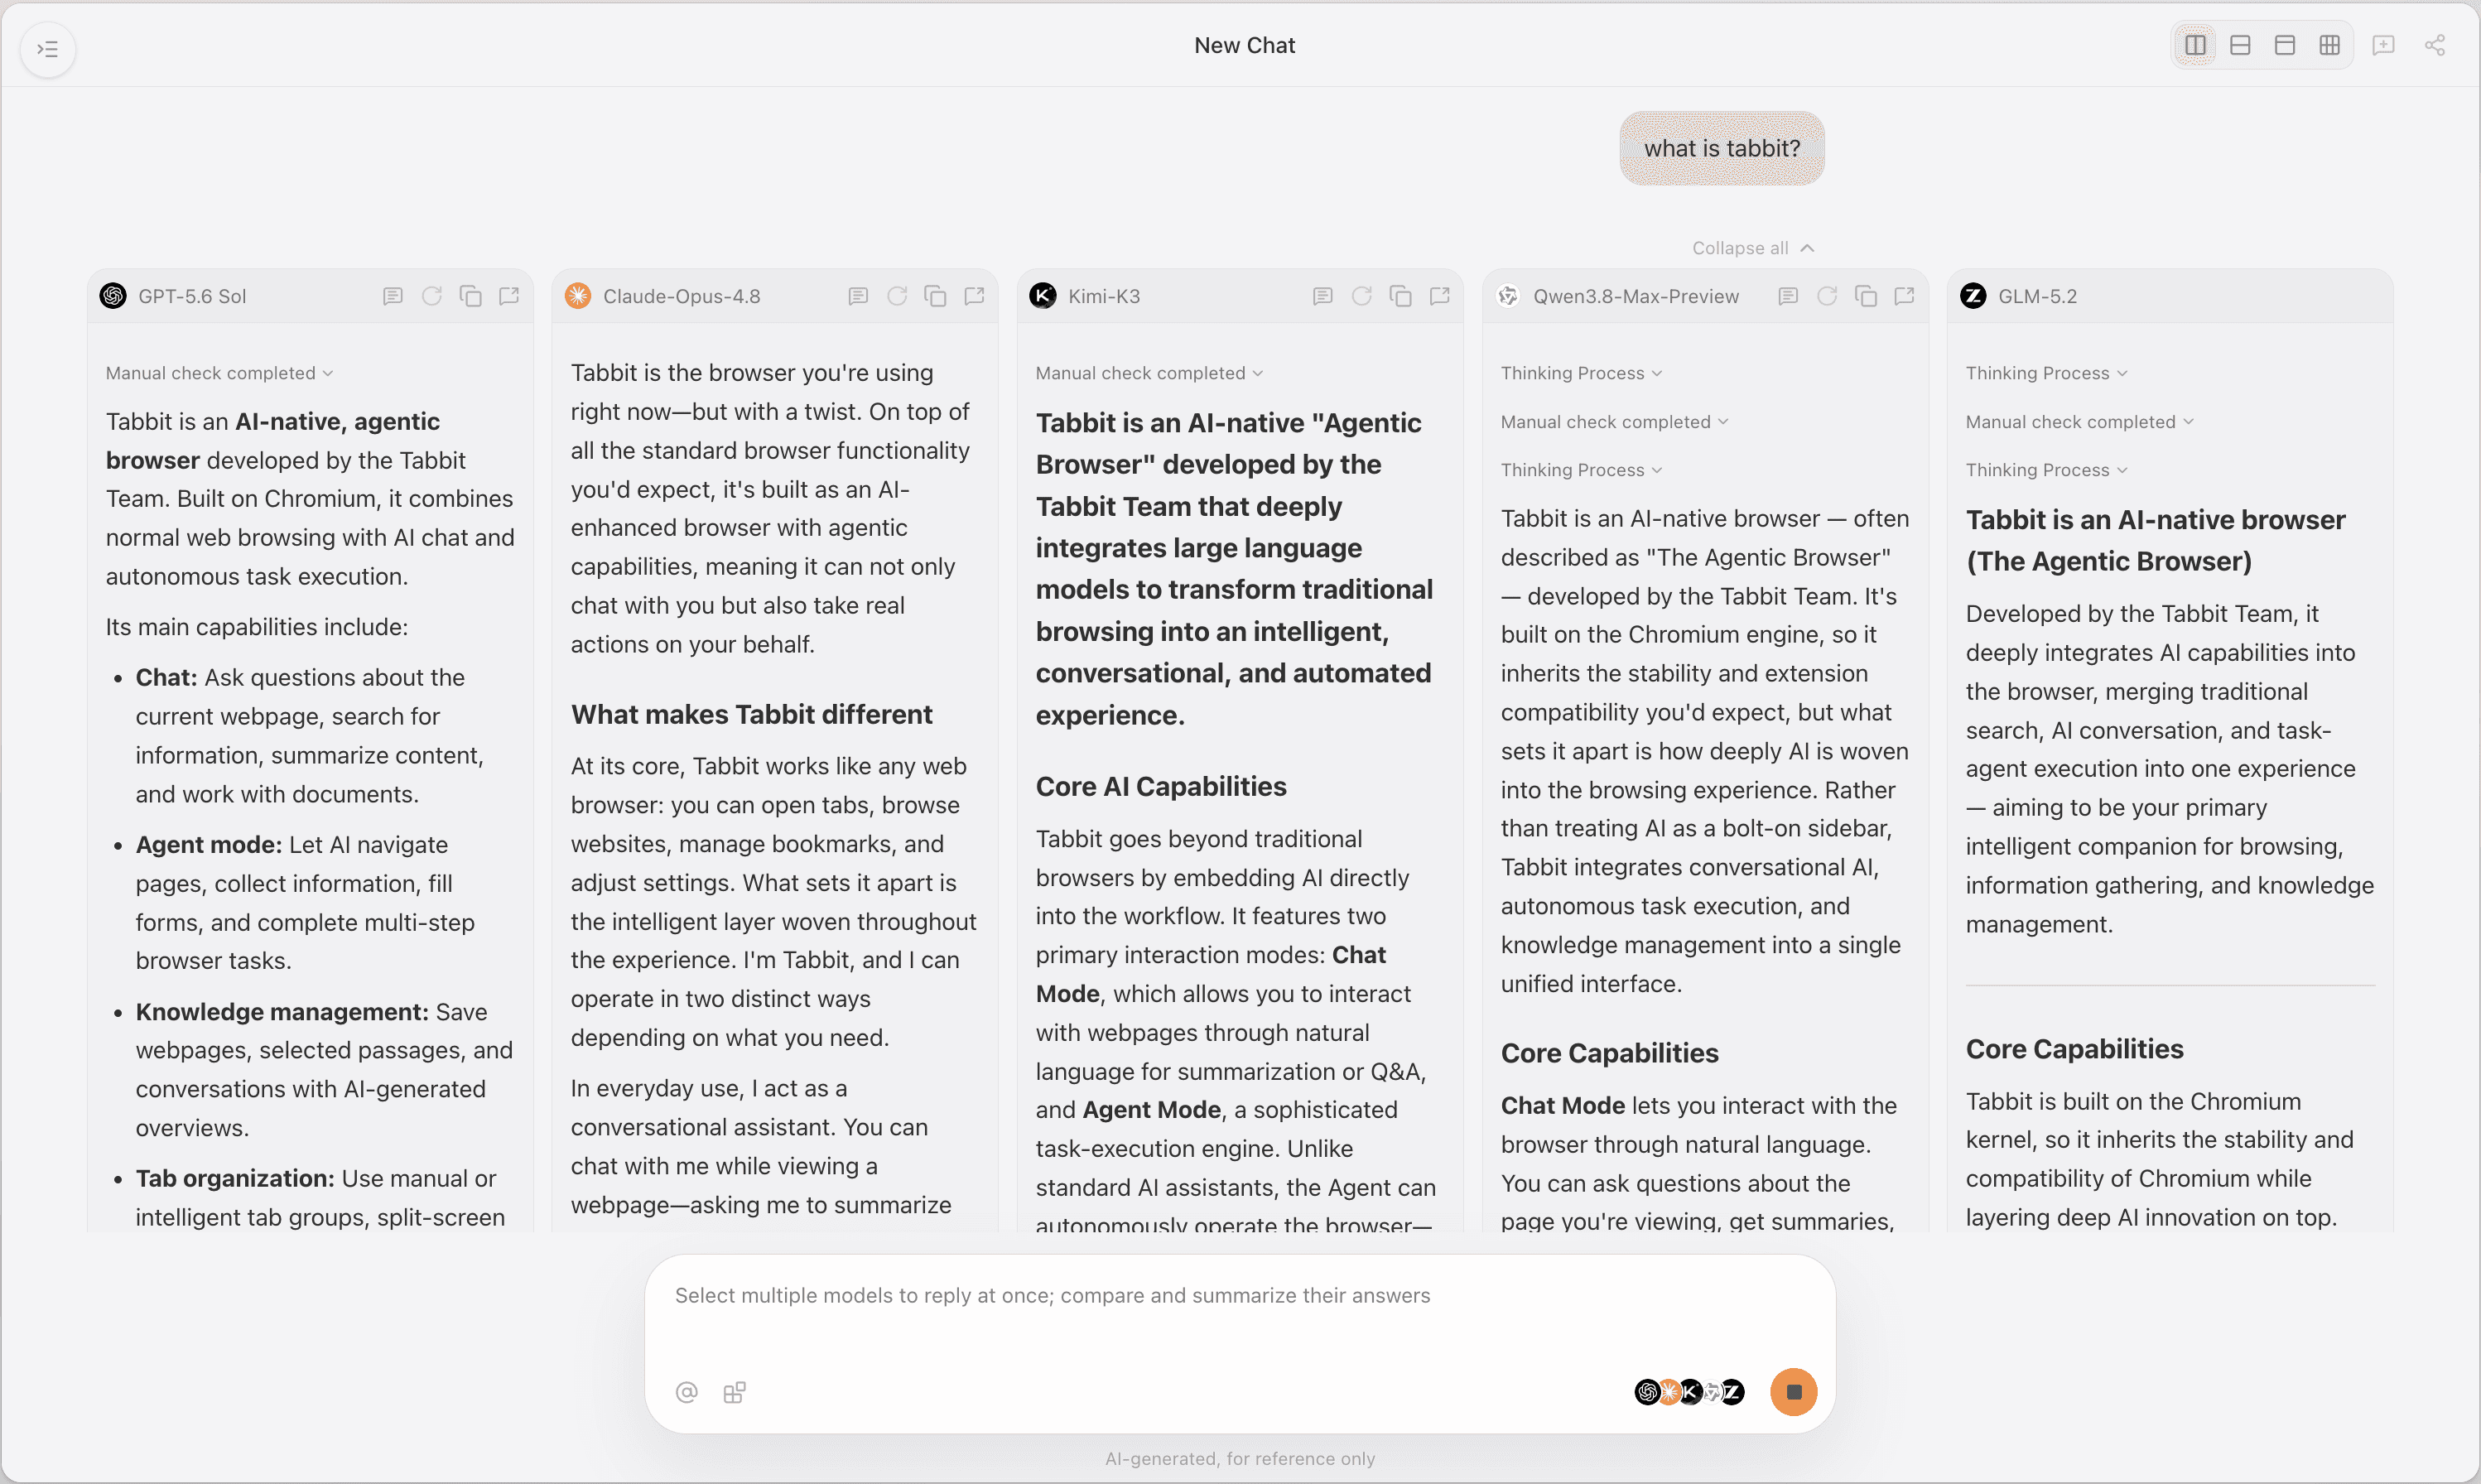
主要短板: Tabbit 专为桌面端沉浸式办公与交互自动化设计,而非用于每秒处理数千次异步 API 请求的后台无头服务器。
参考计费: 提供 macOS 与 Windows 客户端免费下载试用,支持根据工作流灵活选用内置模型。
明确裁决: 如果你调用 Astra 的主要目的是分析网页信息、处理本地文件或完成浏览器内操作,问题不在于模型,而在于运行层。了解 什么是 Agentic 浏览器 并深入探索 Agentic AI 浏览器家族,能为你开辟全然不同的生产力路径。更多内容请参考我们的 Tabbit 浏览器深度指南 与 浏览器自动化技术专栏。
 Tabbit Browser
按任务的核心约束做选型决策
放弃盲目寻找“全能第一”的思维,先明确当前最主要的痛点,再选定最匹配的替代路径:
| 核心约束 | 首选试点模型 | 验证成功的标准 | 核心权衡代价 |
|---|---|---|---|
| API 预算吃紧且沿用 SDK | GPT-5.6 Sol | 任务顺利跑通,Token 花费立省 60%,无需修改接口架构 | 在 10 步以上的长程桌面复杂纠错中完成率略有下降 |
| 代码优雅度与仓库级重构 | Claude Fable 5.1 / Sonnet 5 | 减少人工返工修改,多轮缓存读取使总体支出明显可控 | 需应对更为严格的团队并发速率限制 |
| 多模态解析与超大吞吐量 | Gemini 3.8 Flash | 复杂 PDF/音视频任务完成度一致,单任务成本降低 85%+ | 高思考模式下首 Token 等待时间较为明显 |
| 极低成本错峰批处理 | DeepSeek V4.1 Flash | 离峰定时流水线稳定落地,单任务花费达到最低下限 | 需规避高峰期计费溢价,无原生桌面自动化视控能力 |
| 厌烦编写爬虫与胶水代码 | Tabbit 浏览器 Agent | 直接在打开的网页多标签中跑通复杂提取,免去脚手架搭建 | 适用于桌面交互环境,无法作为纯无头后台接口 |
执行同任务对照试点
在正式大面积迁移前,建议执行小规模严谨对照:
固定两个代表性任务: 选取一个边界明确的代码重构任务(如优化一个复杂模块),以及一个多页长文档结构化解析任务。
统一测试测试约束: 保持提示词意图、外部工具定义、结构化输出规范与重试策略绝对一致。
核算全流程实际成本: 统计输入、输出、思考 Token 消耗与人工纠错时间,避免仅看标价。
记录延迟波动分布: 连续运行至少 5 次,记录首 Token 响应耗时与总执行时长。
计算免监护完成率: 评估任务是否无需人工接管直接达成验收。
结语
GPT-6 Astra 是一款定位极度明确的专用工具。如果你的系统必须依靠它在不受控的操作系统环境中连续探索 40 分钟,或者在三维空间代码里经历十几次自愈试错,那么其 $10/$50 的价格是成立的。
但在绝大多数通用软件开发与企业业务中,Astra 强加了并不必要的 2.5 倍溢价。GPT-5.6 Sol 以 40% 的成本提供了几乎一致的推理基准;Claude 在代码工程美学上更胜一筹;Gemini 3.8 Flash 是多模态吞吐的性价比标杆;DeepSeek 则牢牢锁定了离峰批处理的成本底线。而若你的真正目标是高效率驾驭网络信息,在 Tabbit 浏览器中直接调度多模型,才是摆脱低效脚手架的最快路径。

常见问题
最接近 GPT-6 Astra 的同门替代模型是哪款?
GPT-5.6 Sol 是最直接的同门降级选项。它共享相同的 1,050,000 Token 上下文窗口与工具调用协议,在 Artificial Analysis 独立智力指数中取得 60.9 分(仅比 Astra 低 0.3 分),但单价直降 60%(输入/输出 $4/$20 vs $10/$50),首 Token 响应也更为敏捷。
既然 GPT-6 Astra 创下了 40 分钟 OSWorld 记录,为何还要考虑替代方案?
Astra 在 OSWorld 2.0 任务时间上从 75 分钟降至 40 分钟(缩减 47%),体现的是其在长程自愈循环中的顽固耐力,而非日常交互的低延迟。对于日常问答、代码辅助与即时分析,Astra 存在显著的首 Token 等待、高 Effort 模式下的 Token 暴涨以及 2.5 倍的价格溢价,在多数通用场景下属于性能过剩与成本浪费。
哪款替代模型的标称 API 成本最低?
DeepSeek V4.1 Flash 拥有极具竞争力的公网费率,其离峰缓存命中单价低至每百万 Token $0.003,基础输入与输出分别为 $0.15 和 $0.60。在欧美前沿模型阵营中,Gemini 3.8 Flash 以输入 $0.75 / 输出 $3.75 位居低费率前列。不过,实际任务花费还取决于生成冗长度、思考 Token 消耗和重试频率。
272K 输入 Token 阶梯门槛如何影响实际调用成本?
在 OpenAI 公布的 Astra 费率中,一旦单次请求输入超过 272K Token,整笔请求将统一按更高的阶梯费率计费,而非仅对超出部分溢价。这造成了陡峭的成本断崖,单次 280K 的调用花费显著高于两次 140K 调用。而 Sol、Gemini 与 Claude 等替代模型维持着更为线性的定价或更平缓的缓存计费结构。
API Token 计费能与 ChatGPT 或 Claude Pro 订阅会员直接换算吗?
不能。API 是按使用量精确结算的开发者接口,具备确定性的并发与调用保障;而个人或团队订阅采用固定月费制(20 至 200 美元),但受制于动态消息频次限制、排队配额和路由降级。需要程序化自动化、批量任务或生产系统集成的业务必须依据 API 经济模型做预算评估。
如何在 Tabbit 浏览器中同时测试和对比这些替代模型?
Tabbit 浏览器内置了多模型切换选择器,用户可以在同一个日常工作空间内,按需调用 GPT-6 Astra、GPT-5.6 Sol、Claude、Gemini 或 DeepSeek。无需自行编写爬虫脚本或拼接 MCP 胶水代码,即可让不同模型直接读取活动标签页、解析本地文档并协同完成复杂的跨页面调研。