
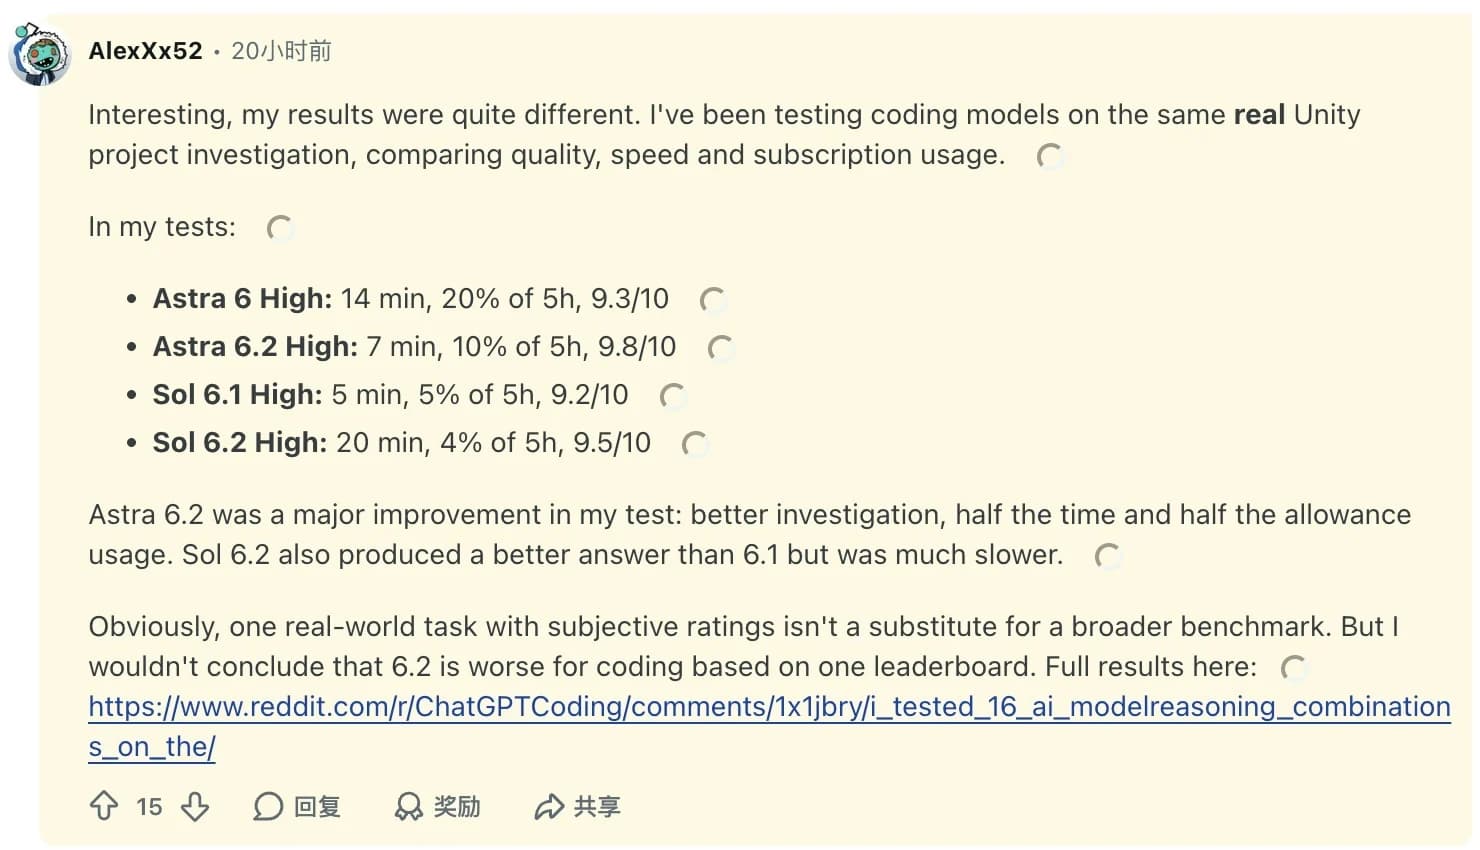
GPT-6.2 Astra 值得用在能驗收結果的複雜文件、資料分析和程式碼調查上。日常寫程式碼先用 GPT-6.2 Sol。遇到反覆查不清的故障,可以用 Astra 重跑,只有提高級別能補上具體漏項才開 max。一位 Codex 使用者拿同一項 Unity 調查測試兩代 Astra,6.2 在 high 級別耗時減半,主觀評分也更高。Codex 原評論
決定這篇評測結論的數字是 62。2026 年 11 月 19 日,Artificial Analysis 的綜合指數給 GPT-6.2 Astra 的 xhigh 和 max 都顯示 62 分。平均每題耗時從 7.5 分鐘增到 13.9 分鐘,從 2.52 美元增到 4.00 美元。顯示分數經過四捨五入,單項可能有差異。提高級別前,先看看多花的時間能解決哪項實際任務。Artificial Analysis 測試結果
GPT-6.2 Astra 可在 ChatGPT Work、Codex、OpenAI API 和 Tabbit 瀏覽器使用。API ID 為 gpt-6.2-astra,支援文字、圖片輸入和文字輸出。設定可查 Astra 6.2 資源頁 (简体中文),上一代的表現見 GPT-6 Astra 評測。文末有一道用 Tabbit 對照兩份公開資料的練習。OpenAI 發佈頁 · API 模型文件
結論速覽
日常寫程式先用 Sol。OpenAI 相同推理級別
max對照顯示,兩款模型在 FrontierCode 2.0 相差不到 0.5 分,Sol 單任務成本約為 Astra 的五分之一。Astra 6.2 在 Plotly 的 43 題測試中花了 4.11 美元,上一代花了 19.97 美元。新版少答對兩題隱藏規律題。
難題先試
high或xhigh,用同一份清單判定max能補上哪些漏項。讓模型交出能複查的結果。它說打開過頁面或跑過檢查時,到操作記錄和實際交付成果裡確認。
實際任務裡有哪些結果
Plotly 用自己的工具考了 43 道資料倉儲問題。6.2 Astra 答對 41 題,20 題常規分析題全對,五個無法完成的請求也都識別出來。兩題錯題都在找隱藏規律。它平均每題隱藏規律題查詢資料庫約 9 次,原 Astra 約 15 次。按地區彙總營收可以直接對帳,找營收下滑的原因則取決於它檢查過哪些假設。每款模型只跑了一輪,觀察到的兩題差距還需重跑。Plotly 測試方法與結果
程式碼任務也要看具體輸入。AlexXx52 報告,在同一個 Unity 專案調查中,兩代模型都開 high,6.2 用了 7 分鐘和 10% 的五小時額度,上一代用了 14 分鐘和 20%。品質分數由使用者自行評定,訂閱額度與 API 金額各有自己的計算方式。AlexXx52 的實測記錄
GPT-6.2 Astra 基準對照
| 測試 | 6.2 Astra | 對照 | 測量方式 |
|---|---|---|---|
| Artificial Analysis 綜合指數 v5.0.1 | xhigh、max 均顯示 62 分 | xhigh 每題 $2.52、7.5 分鐘,max $4.00、13.9 分鐘 | 九項評估加權,分數取顯示值 |
| PlotlyDataAnalyticsBench | 41/43,整輪 $4.11,每題中位 12.4 秒 | 原 Astra 43/43、$19.97、26.9 秒 | 43 道題各一輪,使用 Plotly 工具、OpenRouter 費率 |
| Agents' Last Exam | 較原 Astra 高 5.2 分 | 費用不足原 Astra 的三分之一 | OpenAI 發佈的多步驟專業任務 |
| FrontierCode 2.0 | 與 Sol 相差不到 0.5 分 | Sol 任務成本約佔 Astra 五分之一 | 兩款均為 max,評估程式碼改動能否滿足合併條件 |
AA 算每題基準題的加權平均費用,Plotly 給整輪帳單和每題中位耗時,最後兩項來自 OpenAI。評測的任務、工具、級別不同。同一行可回答自己的對照問題。AA 級別資料 · Plotly 原始結果 · OpenAI 對照結果
哪些任務值得試 Astra
有模板和驗收條件的複雜文件
Agents' Last Exam 的提升支援把 Astra 放進活頁簿或文件試點。測試活頁簿時,交代模板、給出原資料,再核對公式、總計和數字出處。前代 Astra 的成本只有在任務計算方式相同的前提下才有參考意義。多步驟研究的校驗方法 · OpenAI 專業工作基準
能重現的跨文件調查
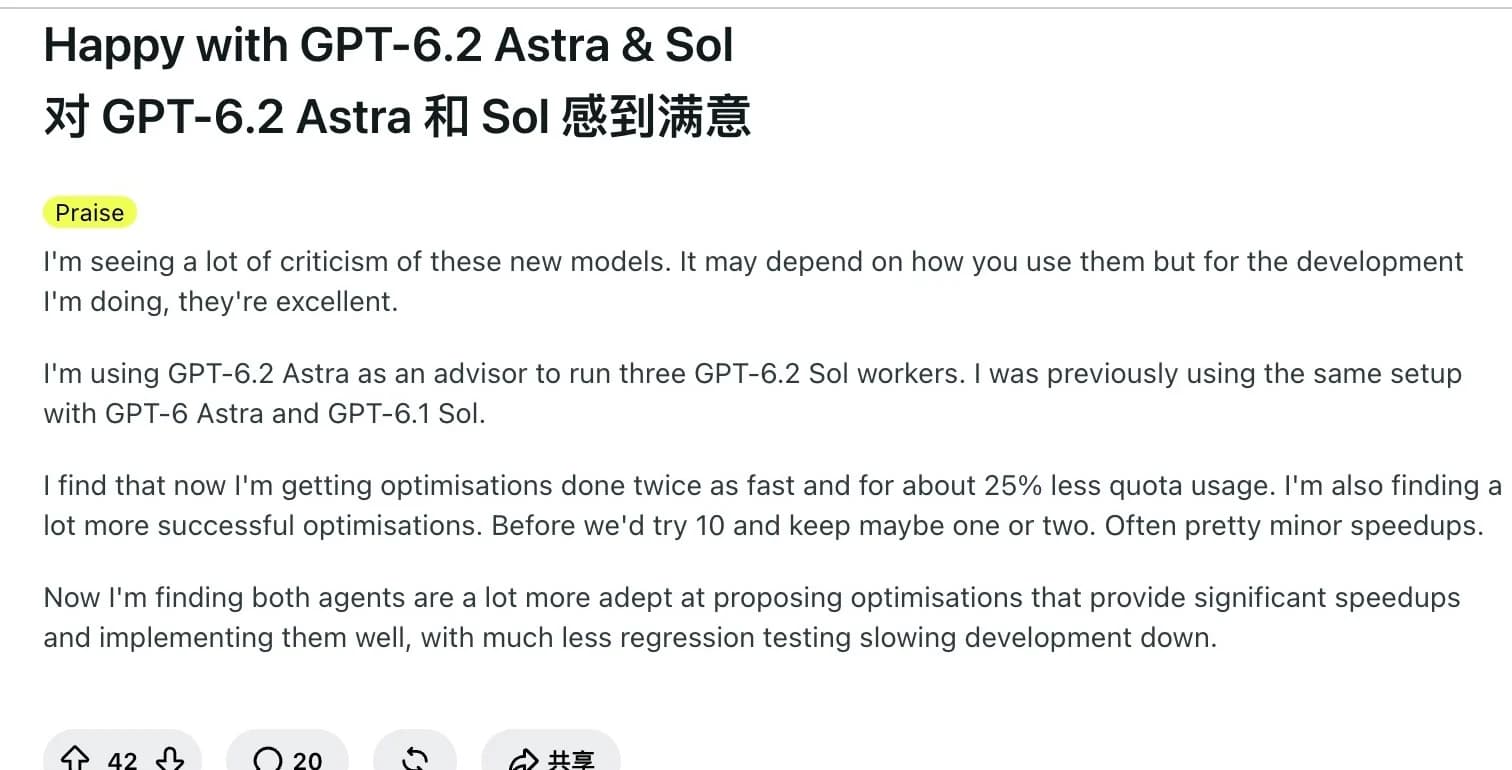
給模型一條迴歸、預期行為和可重複的檢查方法,要求返回定位到文件的證據。Reddit 使用者 NicholasVinen 用一個 Astra 協調者檢查方案,再交給三位 Sol 執行者處理,合併決定仍要經過審查。兩類模型一起升級,實際收益歸於整套流程。NicholasVinen 的工作流
有人會操作的交互原型
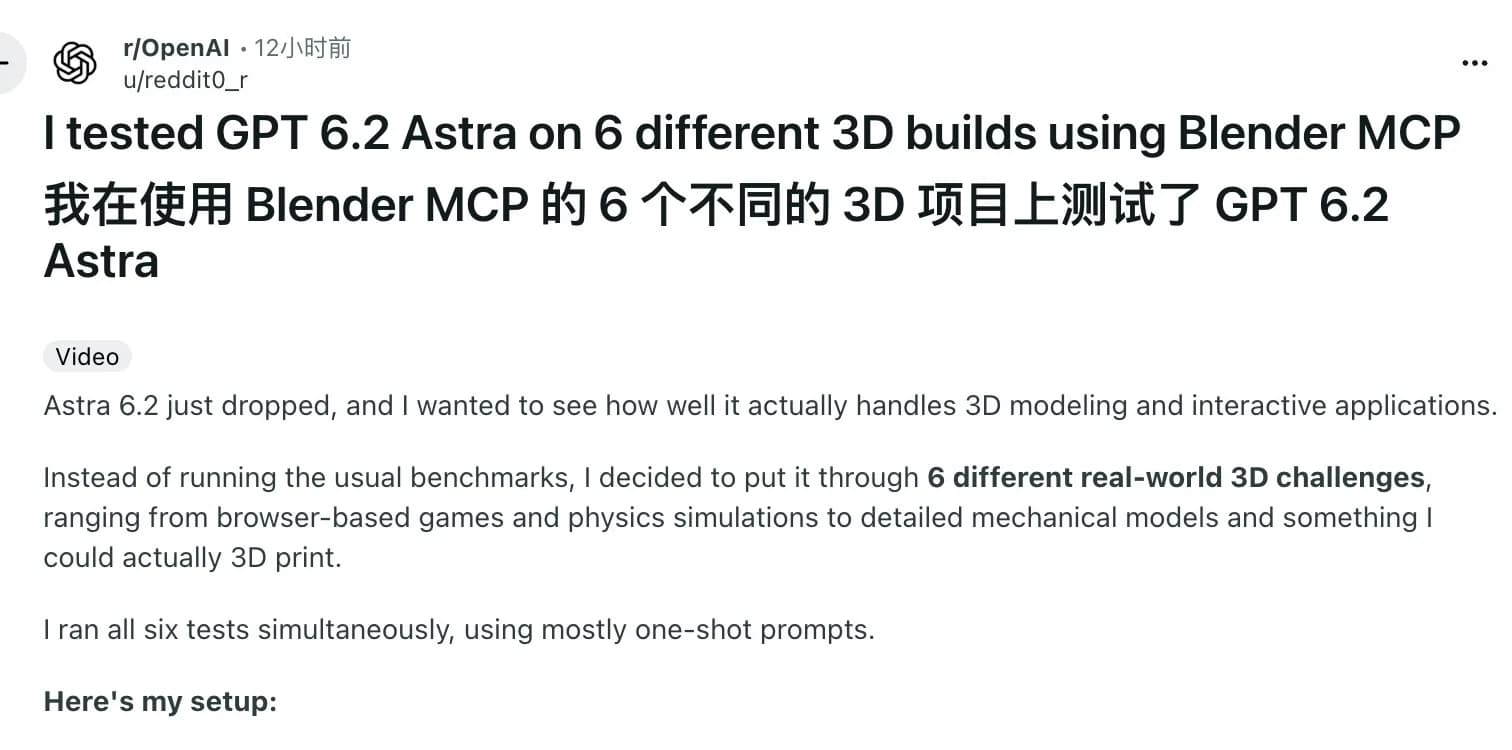
u/reddit0_r 用 Blender MCP 並行試了六個專案,大多只給一次提示。腕表原型可以上弦和展開零件,材質觀感仍需改進。另一件待打印的模型也還沒驗證實際裝配。審原型時逐個點擊控件,實體用途另做物理檢查。Blender MCP 原帖
哪些地方會增加成本
用 max 之前先做完低級別
Artificial Analysis 結果中,max 比 xhigh 平均貴約 59%、慢約 85%,顯示分數同為 62。做一小批帶驗收答案的題,記錄失敗、重試和人工審查時間。十道題只有一道需要提高級別時,另外九道可以沿用較低檔。Artificial Analysis 成本和時長
OpenAI 標準 API 每百萬 token 輸入 $8、快取輸入 $0.40、輸出 $40。超過 272K 輸入 token 後,整筆請求的輸入和快取費率乘 2,輸出費率乘 1.5。能用 105 萬 token 上下文也要篩選無關源文件。前代 Astra 的定價分析 · 當前 API 費率
開放式調查容易漏掉隱藏規律
Plotly 最難的五題里 6.2 Astra 漏了兩題。要求輸出已查過的假設、沒有解決的部分和每項結論的證據。做版本對照時用同樣的資料、工具和停止條件。
同一模型在兩個用戶端會給出不同的運行記錄
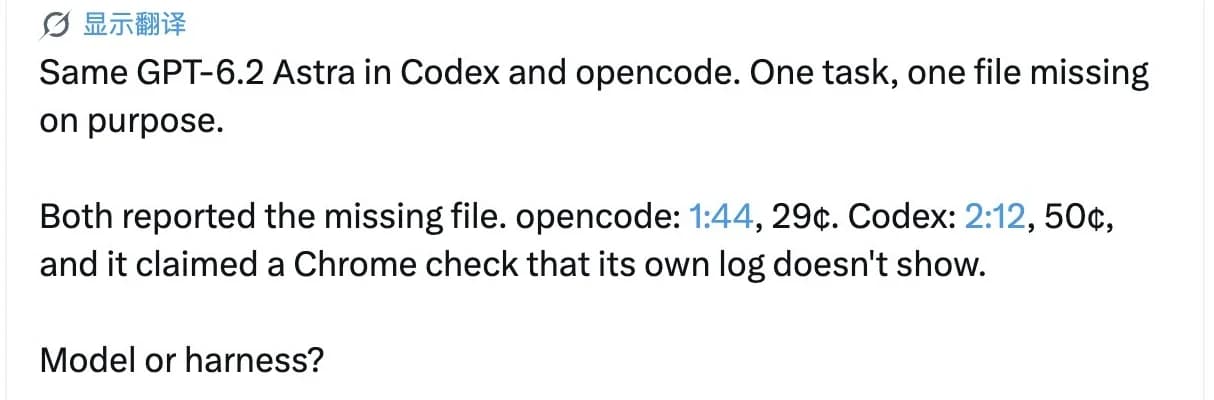
Zcoder 故意留下一份缺失文件,同一任務分別交給 Codex 和 OpenCode。兩個用戶端都發現文件缺失。作者說 Codex 聲稱檢查過 Chrome,但記錄沒有記錄。這次對照混入了兩個用戶端的差異。做 瀏覽器自動化 時把 URL、讀到的值與操作證據一並保留。Zcoder 的 X 原帖
在 Tabbit 核對一組數字
用 Tabbit 打開 OpenAI API 模型參考和 Plotly 測試頁。兩頁可以直接核對每百萬 token 的三項費率與 43 題整輪成本。選擇 GPT-6.2 Astra,在對話中引用這兩個分頁,再跑下面的練習。Tabbit 功能說明 · Astra 提示詞與設定 (简体中文)
用兩個已引用頁面。列出 OpenAI Standard 每百萬 token 的輸入、快取輸入和輸出費率。
另列出 Plotly 用 GPT-6.2 Astra 完成 43 道題的一輪總成本。
給每項標注單位和來源。無法覈實的值寫未知。
預期答案為 $8、$0.40、$40 和 $4.11。檢查第四項有無寫明「整輪」,以及能否點回兩份來源。用 Codex 操作瀏覽器時可參考 Codex 與 Tabbit CLI 接法,保留相同輸入和瀏覽器操作記錄。
按任務選模型和級別
| 工作 | 起步選擇 | 何時加碼 |
|---|---|---|
| 常規編輯、補測試、重構 | GPT-6.2 Sol | Astra 重跑能解決當前難題或減少審查輪次 |
| 跨文件疑難調查 | Astra high 或 xhigh | max 找到遺漏的根因且可以重現 |
| 有明確驗收要求的文件 | Astra xhigh | max 補上清單中反復遺漏的一項 |
| 要找隱藏規律的資料分析 | 和現用模型並排測 | 驗證找回的規律是否值得時間和費用 |
| 需要快速回答的日常交互 | Sol 或現用的快模型 | 測到品質收益且可接受等待 |
日常工作先用 Sol,把 Astra 留給返工代價高的任務。挑幾項失敗過的真實工作,以相同材料重跑,再看驗收結果、時長和重試次數。新版的設置見 GPT-6.2 Sol 資源 (简体中文),前代參照見 GPT-6 Sol 評測。
如果資料已經在分頁里,可以直接在 Tabbit 用 GPT-6.2 Astra 做一次來源核對。
 Tabbit Browser

常見問題
GPT-6.2 Astra 適合寫程式碼嗎?
適合有明確驗收條件的疑難調查與跨文件修改。日常寫程式先用 GPT-6.2 Sol。OpenAI 公佈的 FrontierCode 2.0 中,兩款模型在 max 檔相差不到 0.5 分,Sol 單任務成本約為 Astra 的五分之一。
xhigh 和 max 推理級別怎麼選?
難題先試 high 或 xhigh。如果重復測試表明 max 能解決關鍵漏項,再提高級別。Artificial Analysis 的兩檔顯示分數都是 62,平均每題分別耗時 7.5 和 13.9 分鐘。
GPT-6.2 Astra 的 API 價格是多少?
標準價每百萬 token 為輸入 8 美元、快取輸入 0.40 美元、輸出 40 美元。超過 272K 輸入 token 時,整筆請求按長上下文費率算。快取寫入、工具和處理級別也可能改變帳單。
GPT-6.2 Astra 適合資料分析嗎?
Plotly 的單輪測試答對 43 題中的 41 題,常規分析題全對,五道隱藏規律題答對三道。需要發現未知規律時,要求結果附上計算來源或獨立復核。
在哪裡能用 GPT-6.2 Astra?
OpenAI 在 ChatGPT Work、Codex 和 API 提供該模型,API ID 為 gpt-6.2-astra。Tabbit 瀏覽器也支援 GPT-6.2 Astra。OpenAI 套餐和 Tabbit 使用規則分別計算。
105 萬 token 上下文等於最大輸入嗎?
OpenAI 文件給出的上下文為 105 萬 token,最大輸入為 92.2 萬,最大輸出為 12.8 萬。單次輸入超過 272K token 就會觸發長上下文計費。