
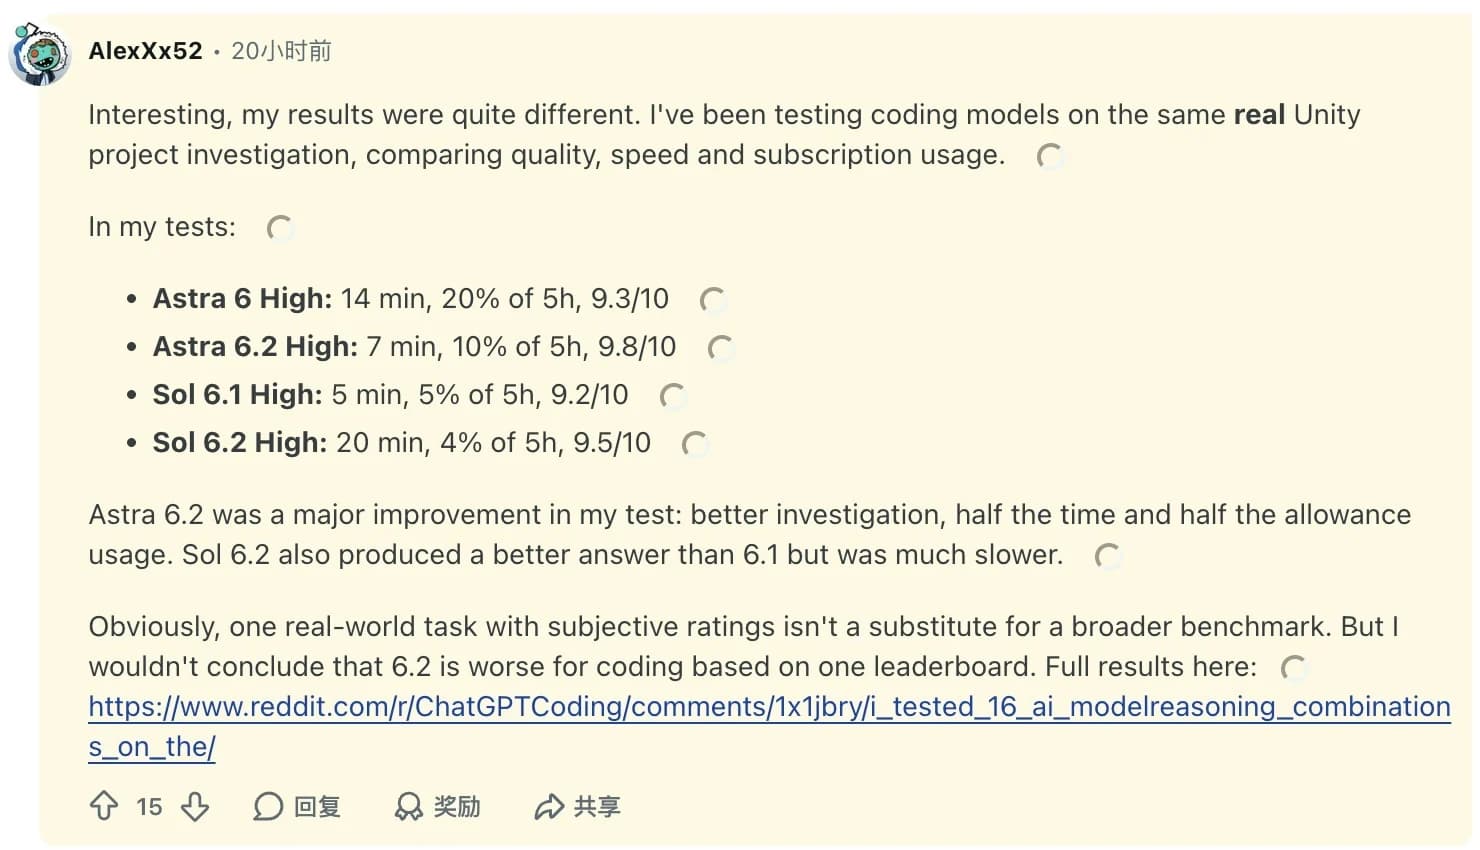
GPT-6.2 Astra 值得用在能验收结果的复杂文档、数据分析和代码调查上。日常写代码先用 GPT-6.2 Sol。遇到反复查不清的故障,可以用 Astra 复跑,只有升档能补上具体漏项才开 max。一位 Codex 用户拿同一项 Unity 调查测试两代 Astra,6.2 在 high 档用时减半,主观评分也更高。Codex 原评论
决定这篇测评结论的数字是 62。2026 年 11 月 19 日,Artificial Analysis 的综合指数给 GPT-6.2 Astra 的 xhigh 和 max 都显示 62 分。平均每题却从 7.5 分钟增到 13.9 分钟,从 2.52 美元增到 4.00 美元。数字经过舍入,单项可能有差异。升档前先看看多花的时间能解决哪项实际任务。Artificial Analysis 测试结果
GPT-6.2 Astra 可在 ChatGPT Work、Codex、OpenAI API 和 Tabbit 浏览器使用。API ID 为 gpt-6.2-astra,支持文本、图片输入和文本输出。配置可查 Astra 6.2 资源页,上一代的表现见 GPT-6 Astra 测评。文末有一道用 Tabbit 对照两份公开资料的练习。OpenAI 发布页 · API 模型文档
结论速览
日常编码先用 Sol。OpenAI 同档
max对照显示,两款模型在 FrontierCode 2.0 相差不到 0.5 分,Sol 单任务成本约为 Astra 的五分之一。Astra 6.2 在 Plotly 的 43 题测试中花了 4.11 美元,上一代花了 19.97 美元。新版少答对两道隐藏规律题。
难题先试
high或xhigh,用同一份清单判定max能补上哪些漏项。让模型交出能复查的结果。它说打开过页面或跑过检查时,到操作日志和实际交付物里确认。
实际任务里发生了什么
Plotly 用自己的工具考了 43 道数据仓库问题。6.2 Astra 答对 41 道,20 道常规分析题全对,五个无法完成的请求也都识别出来。两道错题都在找隐藏规律。它平均每道隐藏规律题查询数据库约 9 次,原 Astra 约 15 次。按地区汇总营收可以直接对账,找营收下滑的原因则取决于它检查过哪些假设。每款模型只跑了一轮,观察到的两题差距还需复跑。Plotly 测试方法与结果
代码任务也要看具体输入。AlexXx52 报告,在同一个 Unity 项目调查中,两代模型都开 high,6.2 用了 7 分钟和 10% 的五小时额度,上一代用了 14 分钟和 20%。质量分数由用户自行评定,订阅额度与 API 金额各有自己的口径。AlexXx52 的实测记录
GPT-6.2 Astra 基准对照
| 测试 | 6.2 Astra | 对照 | 核对口径 |
|---|---|---|---|
| Artificial Analysis 综合指数 v5.0.1 | xhigh、max 均显示 62 分 | xhigh 每题 $2.52、7.5 分钟,max $4.00、13.9 分钟 | 九项评估加权,分数取显示值 |
| PlotlyDataAnalyticsBench | 41/43,整轮 $4.11,每题中位 12.4 秒 | 原 Astra 43/43、$19.97、26.9 秒 | 43 道题各一轮,使用 Plotly 工具、OpenRouter 费率 |
| Agents' Last Exam | 较原 Astra 高 5.2 分 | 费用不足原 Astra 的三分之一 | OpenAI 发布的多步骤专业任务 |
| FrontierCode 2.0 | 与 Sol 相差不到 0.5 分 | Sol 任务成本约占 Astra 五分之一 | 两款均为 max,评估代码改动能否满足合并标准 |
AA 算每道基准题的加权平均费用,Plotly 给整轮账单和每题中位耗时,最后两项来自 OpenAI。评测的任务、工具、档位不同。同一行可回答自己的对照问题。AA 档位数据 · Plotly 原始结果 · OpenAI 对照结果
哪些任务值得试 Astra
有模板和验收条件的复杂文档
Agents' Last Exam 的提升支持把 Astra 放进工作簿或文档试点。测试工作簿时,交代模板、给出原数据,再核对公式、总计和数字出处。前代 Astra 的成本只有在任务口径相同的前提下才有参考意义。多步骤研究的校验方法 · OpenAI 专业工作基准
能复现的跨文件调查
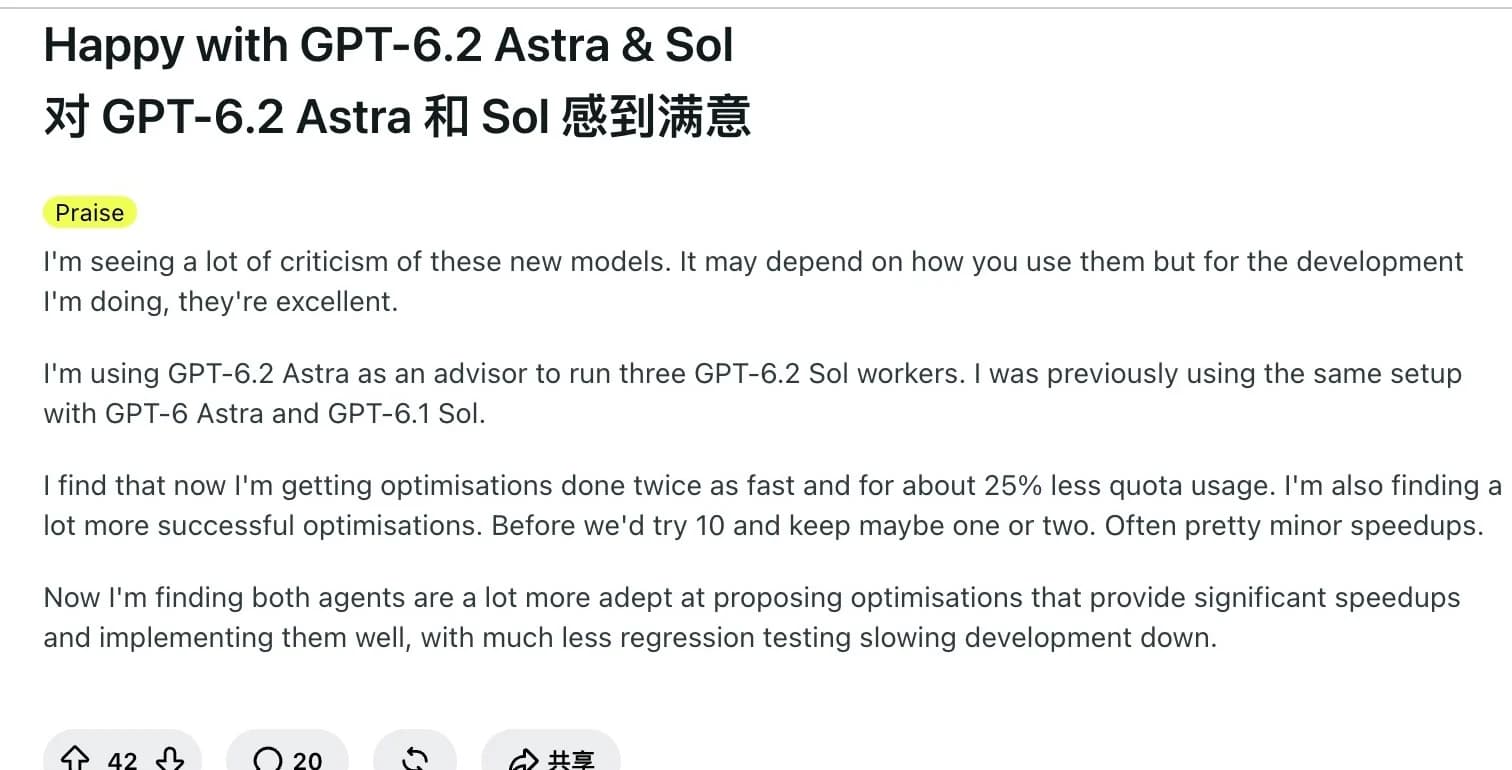
给模型一条回归、预期行为和可重复的检查方法,要求返回定位到文件的证据。Reddit 用户 NicholasVinen 用一位 Astra 协调者检查方案,再交给三位 Sol 执行者处理,合并决定仍要经过审查。两类模型一起升级,实际收益归于整套流程。NicholasVinen 的工作流
有人会操作的交互原型
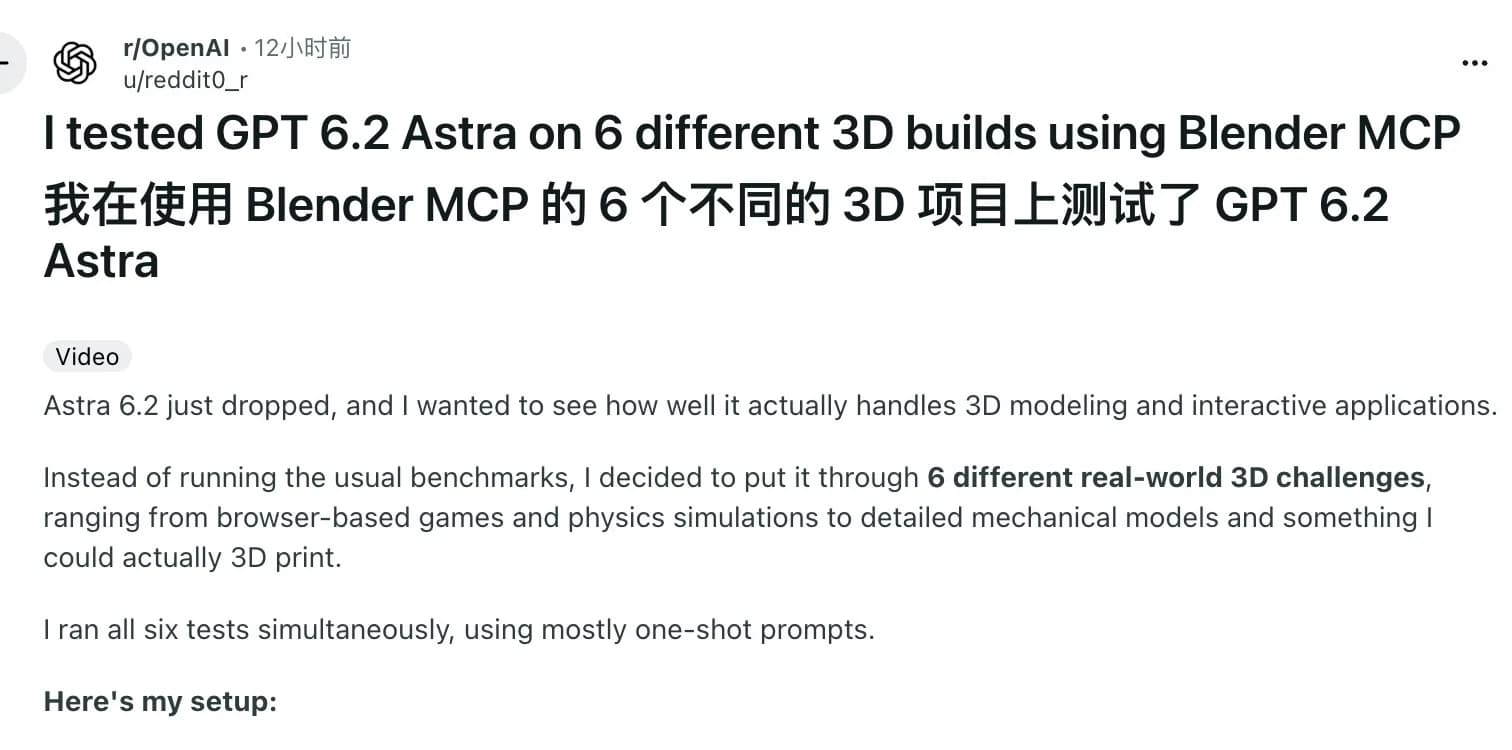
u/reddit0_r 用 Blender MCP 并行试了六个项目,大多只给一次提示。腕表原型可以上弦和展开零件,材质观感仍需改进。另一件待打印的模型也还没验证实际装配。审原型时逐个点击控件,实体用途另做物理检查。Blender MCP 原帖
哪些地方会增加成本
开 max 之前先跑通低档位
Artificial Analysis 结果中,max 比 xhigh 平均贵约 59%、慢约 85%,显示分数同为 62。做一小批带验收答案的题,记录失败、重试和人工审查时间。十道题只有一道需要升档时,另外九道可以沿用较低档。Artificial Analysis 成本和时长
OpenAI 标准 API 每百万 token 输入 $8、缓存输入 $0.40、输出 $40。超过 272K 输入 token 后,整笔请求的输入和缓存费率乘 2,输出费率乘 1.5。能用 105 万 token 上下文也要筛查无关源文件。前代 Astra 的定价分析 · 当前 API 费率
开放式调查容易漏掉隐藏规律
Plotly 最难的五题里 6.2 Astra 漏了两题。要求输出已查过的假设、没有解决的部分和每项结论的证据。做版本对照时用同样的数据、工具和停止条件。
同一模型在两个客户端会给出不同的运行记录
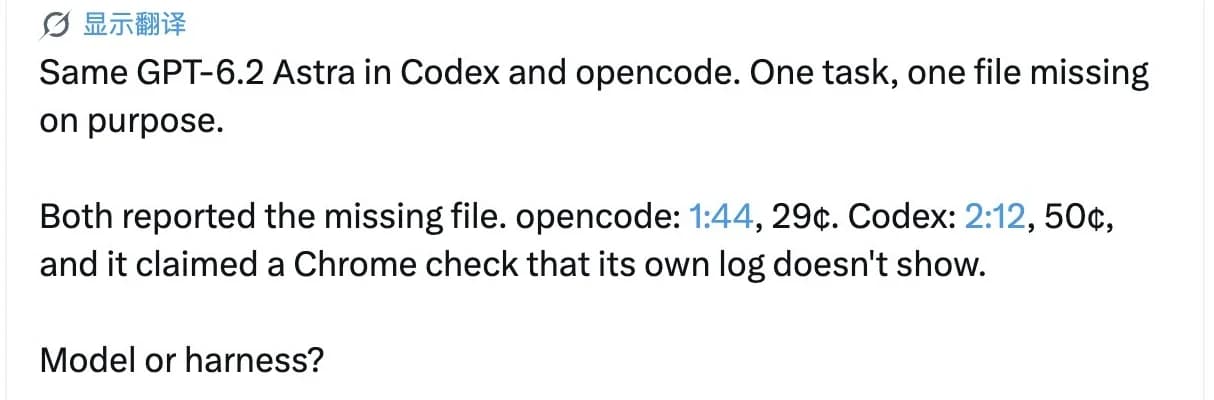
Zcoder 故意留下一份缺失文件,同一任务分别交给 Codex 和 OpenCode。两个客户端都发现文件缺失。作者说 Codex 声称检查过 Chrome,但日志没有记录。这次对照混入了两个客户端的差异。做 浏览器自动化 时把 URL、读到的值与操作证据一并留存。Zcoder 的 X 原帖
在 Tabbit 核对一组数字
用 Tabbit 打开 OpenAI API 模型参考和 Plotly 测试页。两页可以直接核对每百万 token 的三项费率与 43 题整轮成本。选择 GPT-6.2 Astra,在对话中引用这两个标签页,再跑下面的练习。Tabbit 功能说明 · Astra 提示词与配置
用两个已引用页面。列出 OpenAI Standard 每百万 token 的输入、缓存输入和输出费率。
另列出 Plotly 用 GPT-6.2 Astra 完成 43 道题的一轮总成本。
给每项标注单位和来源。无法核实的值写未知。
预期答案为 $8、$0.40、$40 和 $4.11。检查第四项有无写明「整轮」,以及能否点回两份来源。用 Codex 操作浏览器时可参考 Codex 与 Tabbit CLI 接法,保留相同输入和浏览器操作记录。
按任务选模型和档位
| 工作 | 起步选择 | 何时加码 |
|---|---|---|
| 常规编辑、补测试、重构 | GPT-6.2 Sol | Astra 复跑能解决当前难题或减少审查轮次 |
| 跨文件疑难调查 | Astra high 或 xhigh | max 找到遗漏的根因且可以复现 |
| 有明确验收要求的文档 | Astra xhigh | max 补上清单中反复遗漏的一项 |
| 要找隐藏规律的数据分析 | 和现用模型并排测 | 验证找回的规律是否值得时间和费用 |
| 需要快速回答的日常交互 | Sol 或现用的快模型 | 测到质量收益且可接受等待 |
日常工作先用 Sol,把 Astra 留给返工代价高的任务。挑几项失败过的真实工作,以相同材料复跑,再看验收结果、时长和重试次数。新版的设置见 GPT-6.2 Sol 资源,前代参照见 GPT-6 Sol 测评。
如果资料已经在标签页里,可以直接在 Tabbit 用 GPT-6.2 Astra 做一次来源核对。
 Tabbit Browser

常见问题
GPT-6.2 Astra 适合写代码吗?
适合有明确验收条件的疑难调查与跨文件修改。日常编码先用 GPT-6.2 Sol。OpenAI 公布的 FrontierCode 2.0 中,两款模型在 max 档相差不到 0.5 分,Sol 单任务成本约为 Astra 的五分之一。
xhigh 和 max 推理档位怎么选?
难题先试 high 或 xhigh。如果重复测试表明 max 能解决关键漏项,再升档。Artificial Analysis 的两档显示分数都是 62,平均每题分别耗时 7.5 和 13.9 分钟。
GPT-6.2 Astra 的 API 价格是多少?
标准价每百万 token 为输入 8 美元、缓存输入 0.40 美元、输出 40 美元。超过 272K 输入 token 时,整笔请求按长上下文费率算。缓存写入、工具和处理档位也可能改变账单。
GPT-6.2 Astra 适合数据分析吗?
Plotly 的单轮测试答对 43 题中的 41 题,常规分析题全对,五道隐藏规律题答对三道。需要发现未知规律时,要求结果附上计算来源或独立复核。
在哪里能用 GPT-6.2 Astra?
OpenAI 在 ChatGPT Work、Codex 和 API 提供该模型,API ID 为 gpt-6.2-astra。Tabbit 浏览器也支持 GPT-6.2 Astra。OpenAI 套餐和 Tabbit 使用规则分别计算。
105 万 token 上下文等于最大输入吗?
OpenAI 文档给出的上下文为 105 万 token,最大输入为 92.2 万,最大输出为 12.8 万。单次输入超过 272K token 就会触发长上下文计费。