
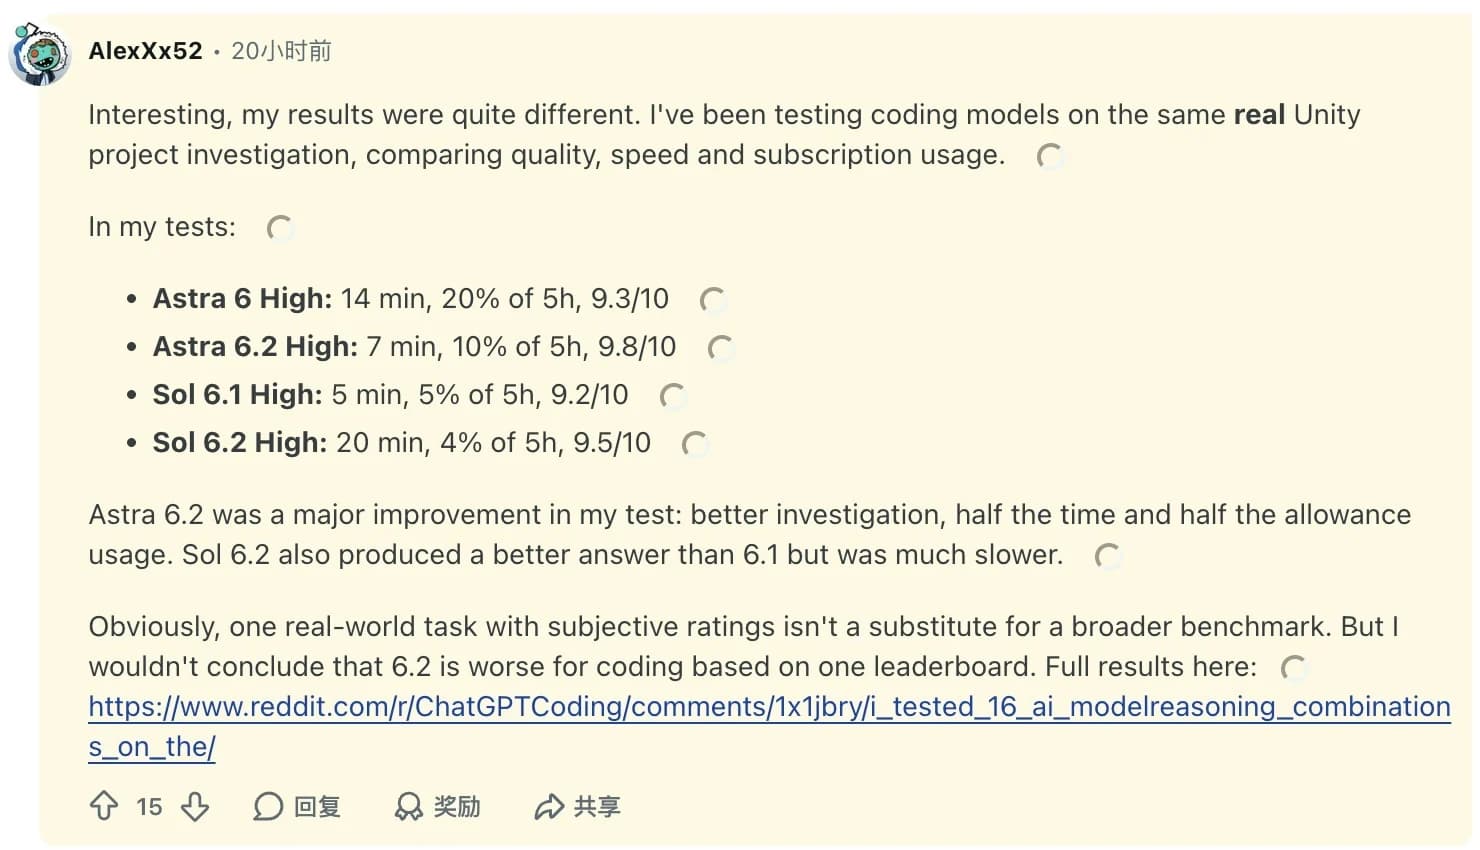
GPT-6.2 Astra는 결과를 확인할 수 있는 복잡한 문서, 데이터 분석, 코드 조사에 써 볼 만합니다. 일상적인 코드 변경은 GPT-6.2 Sol부터 시작하세요. 한 Codex 사용자가 같은 Unity 프로젝트 조사를 두 세대 Astra의 high로 실행했습니다. 6.2는 시간이 절반으로 줄었고 사용자의 평가도 높았습니다. 비교한 작업은 한 건입니다. Codex 사용자 원문
2026년 11월 19일 Artificial Analysis에서 GPT-6.2 Astra의 xhigh와 max는 모두 62점으로 표시됐습니다. 문제당 평균 시간은 7.5분에서 13.9분, 비용은 2.52달러에서 4달러로 늘었습니다. 반올림한 종합 점수에서는 개별 문제의 차이가 가려질 수 있습니다. max가 해결해야 할 실패 사례부터 정하세요. Artificial Analysis 평가
OpenAI는 ChatGPT Work, Codex, API로 이 모델을 제공합니다. API 식별자는 gpt-6.2-astra이며 텍스트와 이미지를 입력받아 텍스트를 출력합니다. Astra 6.2 자료 (English)와 이전 GPT-6 Astra 리뷰를 참고할 수 있습니다. 아래에는 Tabbit Browser로 두 출처의 수치를 대조하는 과제가 있습니다. OpenAI 발표 · API 모델 문서
핵심 요약
일상적인 코딩은 Sol이 출발점입니다. OpenAI의 FrontierCode 2.0에서 양쪽 모두 max일 때 차이는 0.5점 미만이고, Sol의 작업 비용은 Astra의 약 5분의 1이었습니다.
Plotly의 43문제 시험에서 Astra 6.2는 4.11달러, 이전 Astra는 19.97달러였습니다. 6.2는 두 문제를 더 놓쳤습니다.
high또는xhigh부터 시험하고 같은 검수 기준으로max의 효과를 확인하세요.도구를 쓰는 작업은 완료 메시지와 함께 실제 결과물과 작업 기록을 확인하세요.
실제 과제의 결과
Plotly는 자체 도구로 데이터 웨어하우스에 관한 43문제를 시험했습니다. Astra 6.2는 41문제를 맞혔고 기본 분석 20개와 처리할 수 없는 요청 5개를 모두 올바르게 처리했습니다. 두 오답은 숨은 패턴 문제였습니다. 이 유형에서 문제당 데이터베이스 질의가 약 9회였고 이전 모델은 약 15회였습니다. 지역별 매출의 합계는 계산으로 확인할 수 있습니다. 매출 하락의 원인을 찾을 때는 조사한 가설도 확인해야 합니다. 각 모델은 한 번씩 실행했습니다. Plotly 시험 방법과 결과
AlexXx52는 Unity 프로젝트를 조사할 때 두 모델을 high로 맞췄습니다. 6.2에서는 7분과 5시간 이용량의 10%, 이전 Astra에서는 14분과 20%를 기록했습니다. 점수는 사용자가 매겼고 구독 이용량은 API 비용과 별개의 수치입니다. AlexXx52의 실사용 기록
GPT-6.2 Astra 주요 평가
| 평가 | Astra 6.2 | 비교 | 측정 기준 |
|---|---|---|---|
| Artificial Analysis v5.0.1 | xhigh와 max 모두 62 | xhigh 2.52달러·7.5분, max 4달러·13.9분 | 9개 평가를 합친 지수와 문제당 가중 평균 |
| PlotlyDataAnalyticsBench | 41/43, 전체 4.11달러, 문제당 중앙값 12.4초 | 이전 Astra 43/43, 19.97달러, 26.9초 | 모델별 43문제 1회, Plotly 도구와 OpenRouter 요금 |
| Agents' Last Exam | 이전 Astra보다 5.2점 높음 | 작업 비용은 이전의 3분의 1 미만 | OpenAI가 공개한 전문 업무 평가 |
| FrontierCode 2.0 | Sol과 0.5점 미만 차이 | Sol 비용은 약 5분의 1 | 코드 변경의 병합 기준 충족 여부, 양쪽 모두 max |
Artificial Analysis 지수는 반올림한 표시값입니다. Plotly는 시험 전체 비용과 문제당 시간의 중앙값을 공개했습니다. 마지막 두 줄은 OpenAI 발표이며 실행 세부 정보는 제한적입니다. 비용을 비교할 때는 각 행의 단위를 확인하세요. Artificial Analysis · Plotly · OpenAI
Astra를 시험해 볼 만한 일
검수할 항목이 정해진 문서
Agents' Last Exam 결과는 템플릿과 자료를 받아 문서나 스프레드시트를 만드는 일에서 Astra를 시험할 근거가 됩니다. 수식이 동작하는지, 합계가 일치하는지, 수치의 출처를 찾을 수 있는지 확인합니다. 에이전트 조사 결과를 검증하는 법 · OpenAI의 전문 업무 평가
재현할 수 있는 여러 파일의 문제
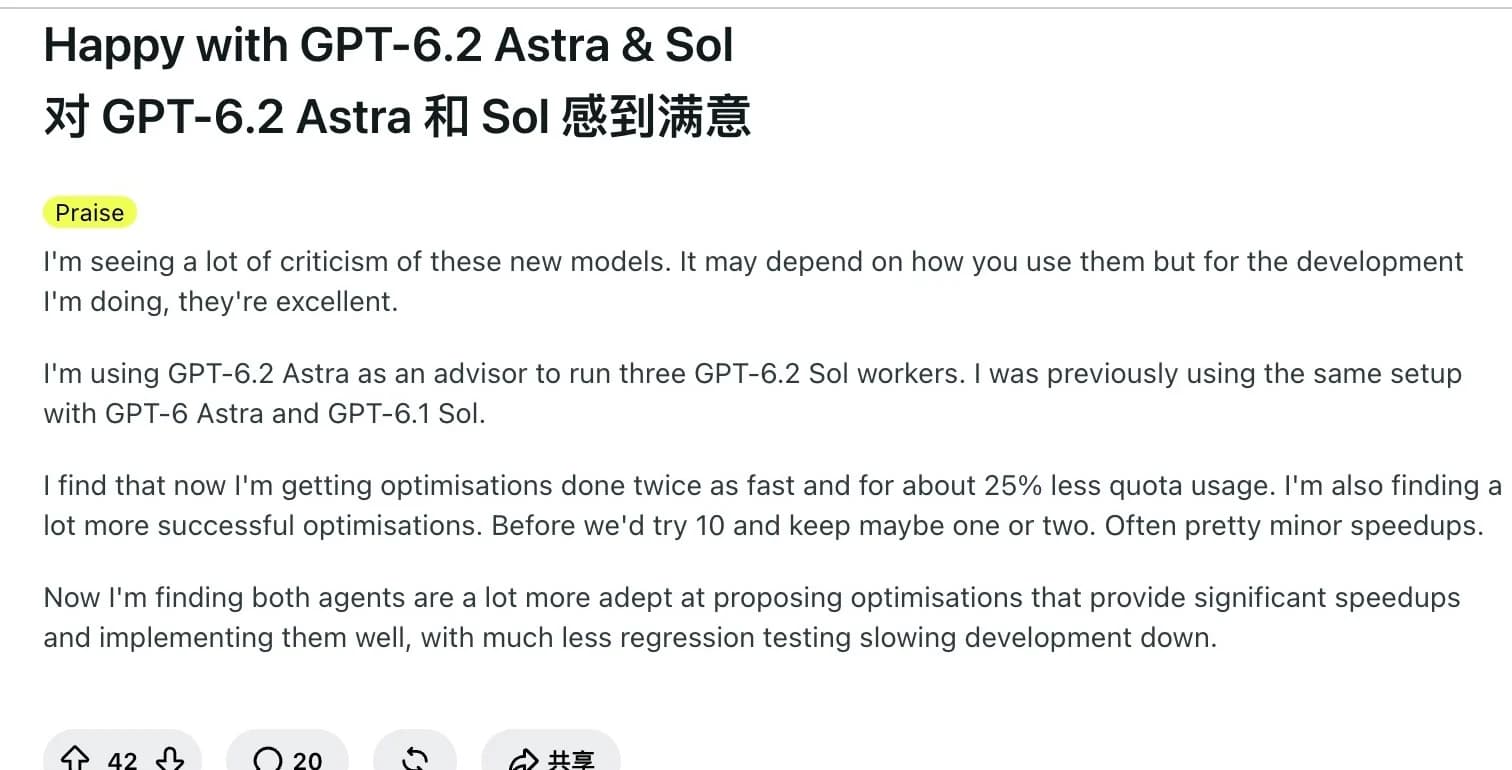
재현 가능한 오류 한 건과 기대 동작을 제시하고, 관련 파일을 근거로 요구하세요. NicholasVinen은 Astra로 제안을 검토하고 Sol 세 개로 변경을 실행한 뒤 병합 여부를 검토했습니다. 조언 모델과 실행 모델을 동시에 바꿨으므로 개선은 전체 구성에 대한 관찰입니다. NicholasVinen의 글
실제로 조작할 수 있는 프로토타입
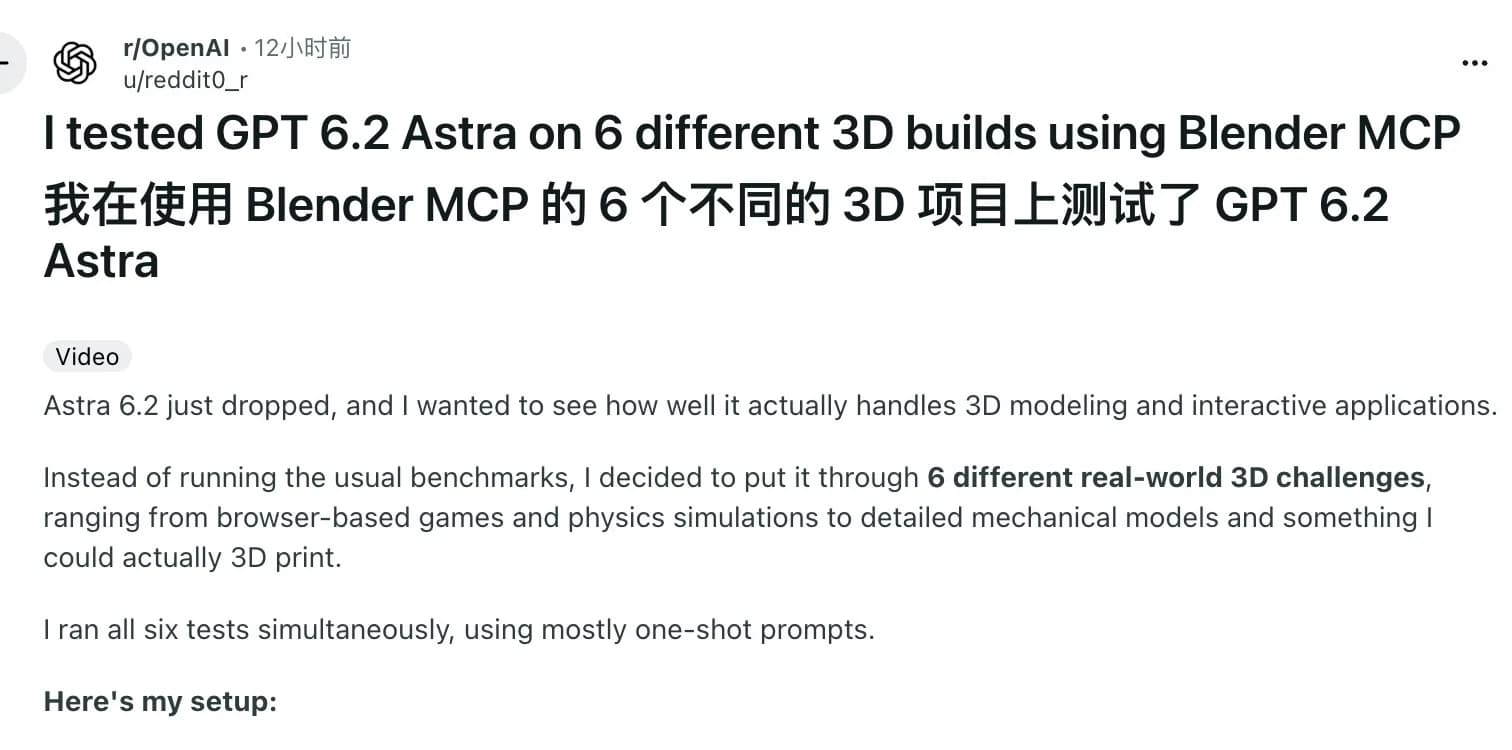
Reddit의 u/reddit0_r는 Blender MCP로 3D 프로젝트 6개를 동시에 시험했습니다. 대부분 프롬프트를 한 번만 사용했습니다. 손목시계 시제품에서 용두를 돌리고 부품을 펼쳐 볼 수 있었지만 재질 표현에는 개선의 여지가 있었습니다. 다른 출력용 물체는 실제 조립을 확인하지 않았습니다. 화면을 검토할 때 각 조작도 시험하세요. Blender MCP 테스트 원문
비용이 늘어나는 지점
매번 max를 쓸 때
Artificial Analysis에서 max는 xhigh보다 평균 약 59% 비쌌고 약 85% 오래 걸렸습니다. 실패했던 과제를 재실행해 해결 여부와 사람의 검수 시간을 모두 기록하세요. 열 건 중 한 건에만 max가 필요하면 나머지는 검수를 통과한 수준으로 처리할 수 있습니다. 추론 수준별 비용과 시간
OpenAI Standard는 토큰 100만 개당 입력 8달러, 캐시 입력 0.40달러, 출력 40달러입니다. 입력이 272,000토큰보다 많으면 전체 요청에서 입력과 캐시 단가가 2배, 출력 단가가 1.5배가 됩니다. 105만 토큰 창을 쓰더라도 관련 있는 자료를 골라 넣으세요. 이전 Astra 요금 · 현재 API 요금
끝이 정해지지 않은 조사
Plotly의 오답 두 개는 모두 숨은 패턴 문제였습니다. 검사한 가설과 미해결 지점, 근거를 함께 제출하도록 요청하세요. 두 설정을 비교할 때는 파일, 도구와 종료 조건을 맞춰야 합니다.
실행 클라이언트가 다른 경우
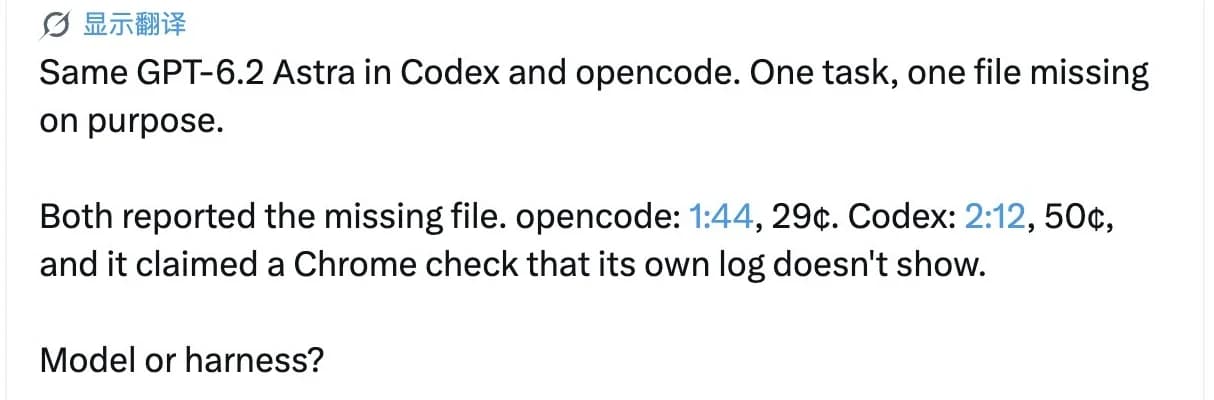
Zcoder는 파일 하나를 일부러 빼고 같은 일을 Codex와 OpenCode에 맡겼습니다. 둘 다 누락을 발견했으나, 글쓴이는 Codex가 했다고 답한 Chrome 확인 작업을 로그에서 찾을 수 없었다고 보고했습니다. 두 클라이언트의 차이가 섞인 단일 사례입니다. 브라우저 자동화에서는 URL, 관찰한 값, 작업 기록을 함께 보관하세요. X 원문
Tabbit Browser에서 두 출처 확인하기
Tabbit에서 OpenAI API 모델 문서와 Plotly 결과를 여세요. GPT-6.2 Astra를 선택하고 두 탭을 참조하여 아래 요청을 보냅니다. 토큰 단가 세 개와 시험 전체 비용을 제대로 구분하는지 확인할 수 있습니다. Tabbit 브라우저 소개 · Astra 프롬프트와 설정 예 (English)
참조한 두 페이지로 OpenAI Standard의 토큰 100만 개당 입력,
캐시 입력, 출력 요금을 적어 주세요. Plotly에서 GPT-6.2 Astra로
43문제를 한 번 실행한 총비용도 적어 주세요.
각 값의 단위와 출처를 밝히고 확인할 수 없으면 미확인으로 표시하세요.
확인할 금액은 8달러, 0.40달러, 40달러, 4.11달러입니다. 마지막 값은 43문제 시험 전체의 비용입니다. 출처를 다시 열어 값과 단위를 대조하세요. 작업 기록이 필요하면 Codex와 Tabbit CLI 연결 방법을 참고하세요.
업무별 선택
| 업무 | 시작할 모델 또는 설정 | 수준을 높일 조건 |
|---|---|---|
| 일반 편집과 테스트 | GPT-6.2 Sol | Astra가 반복 실패를 해결하거나 검수 횟수를 줄임 |
| 여러 파일의 원인 조사 | Astra high 또는 xhigh | max에서 재현 가능한 원인이 나옴 |
| 검수 조건이 있는 문서 또는 스프레드시트 | Astra xhigh | max가 반복되는 누락을 보완함 |
| 숨은 패턴을 찾는 분석 | Astra와 현재 모델 비교 | 검증된 패턴이 비용과 시간 대비 더 많음 |
| 빠른 응답이 필요한 대화 | Sol 또는 기존의 빠른 모델 | 품질 향상이 추가 대기 시간을 감수할 만큼 큼 |
일상적인 일은 Sol로 처리하고, 실패하면 수정 비용이 큰 일에는 Astra를 시험하세요. 실패 사례 몇 건을 동일한 자료로 실행하고 통과한 결과의 수와 소요 시간, 재시도를 비교하세요. GPT-6.2 Sol 자료 (English)와 이전 GPT-6 Sol 리뷰도 참고할 수 있습니다.
자료가 이미 탭에 있다면 Tabbit에서 GPT-6.2 Astra로 출처 대조를 해 보세요.
 Tabbit Browser

자주 묻는 질문
GPT-6.2 Astra는 코딩에 쓸 만한가요?
까다로운 원인 조사나 검수 기준이 분명한 여러 파일의 변경에 적합합니다. 일상적인 작업은 GPT-6.2 Sol로 시작하세요. OpenAI의 FrontierCode 2.0 결과에서 두 모델을 max로 설정했을 때 점수 차이는 0.5점 미만이었고 Sol의 작업 비용은 약 5분의 1이었습니다.
xhigh와 max 중 어느 추론 수준을 써야 하나요?
어려운 작업은 high나 xhigh에서 시작하세요. 반복 시험에서 max가 중요한 누락을 해결할 때 수준을 높이세요. Artificial Analysis의 표시 점수는 둘 다 62였고 문제당 평균 시간은 7.5분과 13.9분이었습니다.
GPT-6.2 Astra의 API 요금은 얼마인가요?
Standard 요금은 토큰 100만 개당 입력 8달러, 캐시 입력 0.40달러, 출력 40달러입니다. 입력이 272,000토큰을 넘으면 전체 요청에 긴 컨텍스트 요금이 적용됩니다. 캐시 쓰기, 도구, 처리 등급에 따라 청구액이 달라집니다.
GPT-6.2 Astra는 데이터 분석에 적합한가요?
Plotly의 단일 실행에서 43문제 중 41문제를 맞혔고 숨은 패턴 5개 중 3개를 찾았습니다. 미지의 패턴을 찾는 작업에서는 원본 데이터와 계산을 별도로 확인하세요.
GPT-6.2 Astra를 어디에서 쓸 수 있나요?
OpenAI는 ChatGPT Work, Codex, API에서 제공하며 모델 ID는 gpt-6.2-astra입니다. Tabbit Browser에서도 사용할 수 있습니다. 이용 한도는 서비스별로 적용됩니다.
105만 토큰을 한 번에 입력할 수 있나요?
105만 토큰은 컨텍스트 창 크기입니다. 최대 입력은 922,000토큰, 최대 출력은 128,000토큰입니다. 입력이 272,000토큰을 넘으면 긴 컨텍스트 요금이 적용됩니다.