
GPT-6.1 Terraとは何か、乗り換える価値はあるか
GPT-6.1 Terraは、画像を使うタスク、提供資料に基づく簡潔な文章作成、範囲を限定したPC操作の自動化で評価する価値があります。一方、GPT-6.1 Solを一律に置き換えるモデルとしては勧めにくいです。トークン単価は低いものの、実際にタスクを終えるまでの費用は推論設定と人による修正量で決まります。
これは2026年10月27日時点の公開情報を確認したレビューです。OpenAIのドキュメント、独立した評価、公開初日のユーザー報告をまとめています。独自のTerraベンチマークを行ったとは主張しません。また、Tabbit BrowserでTerraを選んだ実行も検証していません。記事の最後に、こうした制約を明記した再現可能なブラウザでの確認手順を示します。
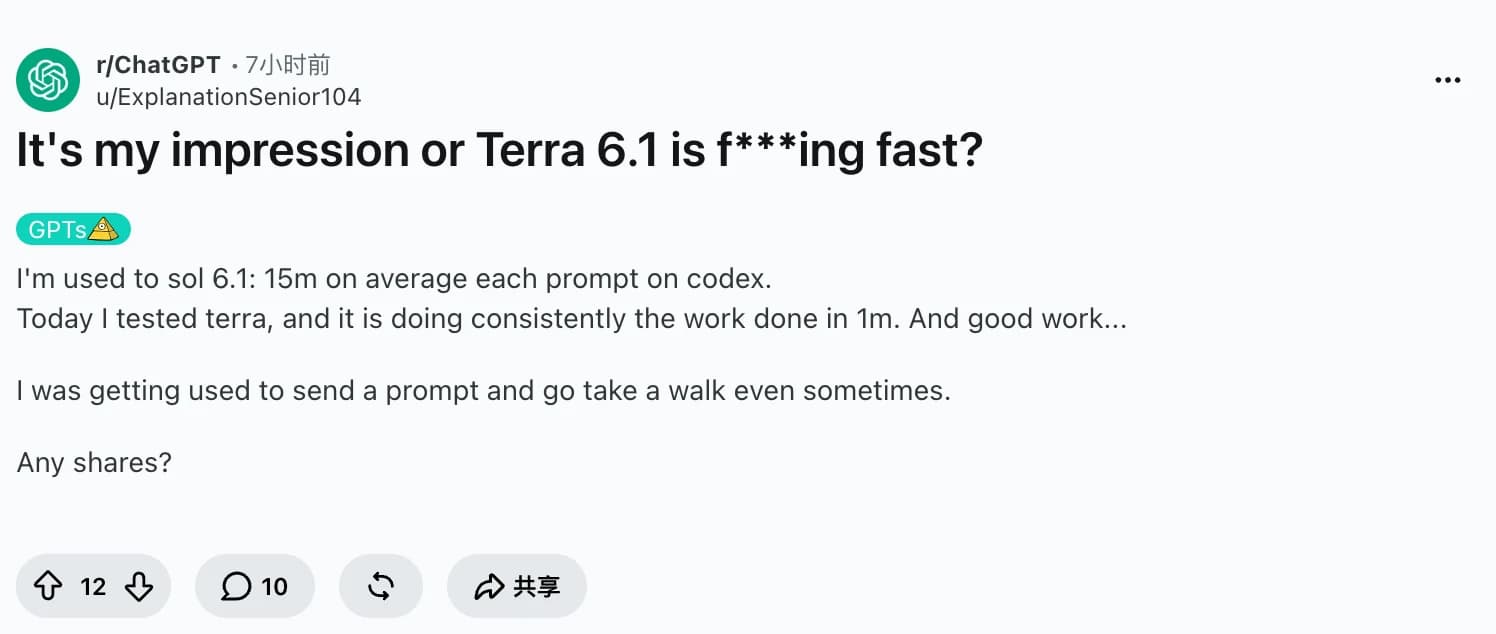
初期のCodexユーザーであるu/ExplanationSenior104は、Solよりはるかに速く完了したと報告しました。一方、別のユーザーは文書タスクが途中で止まることや、利用枠が予想外に速く減ることを指摘しています。評価が分かれているからこそ、公開時の宣伝文句ではなく、完了した作業を比べる必要があります。
OpenAIは10月26日にTerraを公開し、視覚的推論、PC操作、自然な文章作成を主な用途に挙げました。API上のモデルIDはgpt-6.1-terraです。GPT-5.6 Terraの後継ですが、GPT-6 Sol、GPT-6.1 Sol、より小型のGPT-6 Lunaとは区別してください。
要点
標準の短いコンテキストでのAPI料金は、入力100万トークンあたり1ドル、出力100万トークンあたり5ドルで、Solの各料金の半額です。キャッシュ済み入力は100万トークンあたり0.05ドルです。
Artificial AnalysisによるTerraのIntelligence Index最高スコアは48で、GPT-6.1 Solの52を下回ります。料金が低くても、総合的な能力が同等とは限りません。
同じ評価機関は、Terraの設定によってタスク費用に最大7.4倍の幅があると報告しています。推論設定の選択も、モデル選びの一部です。
特定分野の評価と複数のユーザー報告から、一貫性や長い指示への追従に疑問が残ります。確認を行う理由にはなりますが、あらゆるタスクで失敗するという証明ではありません。
ワークフローを切り替える前に、少数の固定タスクで試してください。サブスクリプションの利用枠、API請求、Tabbitのメンバーシップは分けて考えましょう。
注目すべき数字:トークン単価は半額、推論設定で費用に7.4倍の幅
比較のポイントは、Terraが1ドル/5ドル、Solが2ドル/10ドルという差だけではありません。Artificial Analysisの公開ページによれば、IndexのタスクでTerraの最も安い設定と最も高い設定を比べると、平均費用に7.4倍の差があります。料金が低くても、余分なトークンや再試行が増えたり、人の修正が多く必要になったりすれば、節約分は消えてしまいます。
Artificial Analysisの10月26日の評価では、Intelligence Indexの費用対効果の境界にTerraのlowとmediumが位置しています。一方、Coding Agent Indexではlowとxhighがその境界にあります。複数分野をまとめたベンチマークで魅力的な設定が、コーディングにも適切とは限りません。
モデル選びの基準はシンプルです。
合格タスクあたりの費用 = 実行費用と再試行費用の合計 / チェックに合格したタスク数
運用費用 = モデル費用 + 人による確認・修正の費用
これは評価用の式で、Terraについて実測した結果ではありません。人の確認に金額をつけられない場合は、別項目として記録してください。資料に基づく書き換えなら、推論を増やしても役立たないことがあります。難しい修正では、推論が足りないために何度もやり直すことがあります。まずタスクのチェックに通る最も低い設定を使い、Solも妥当な設定で比べましょう。
ベンチマーク表を見る前に確認したい実務データ
DualEntryは、自社の会計分野の101タスク評価でTerraを3回実行しました。報告された精度は78.2%、タスクあたり16.1秒、費用は0.042ドルです。さらに注目すべきなのは、3回すべてで合格したタスクが65.3%にとどまったことです。速く安価でも、確認作業がかなり必要になる場合があります。
これは会計ソフト企業による特定分野の評価で、モデル全般の順位を示すものではありません。公開レポートからは、すべてのモデルを同じ推論強度で比較したかどうか確認できません。秒数や費用からブラウザセッションを予測しないでください。参考になるのは、平均精度と再現性を分けて示している点です。
以下の比較では、評価機関をそろえ、それぞれの対象範囲を示しています。
| 評価または費用の指標 | GPT-6.1 Terra | GPT-6.1 Sol | GPT-6 Luna | 分かること |
|---|---|---|---|---|
| AA Intelligence Index v4.3.2、掲載中の最高設定、概数 | 48 | 52 | 38 | Indexに含まれる10評価で見た幅広い能力 |
| AA Coding Agent Index v2.0、報告値 | 48 | 54 | 31 | コーディングエージェント能力。別の指標 |
| 標準APIの入力/出力、短いコンテキストで100万トークンあたり | $1 / $5 | $2 / $10 | $0.10 / $0.50 | 追加料金を除いたトークン単価 |
| TerraのIndexタスク設定ごとの費用 | 最大7.4倍の差 | モデル間の比較ではない | モデル間の比較ではない | 推論設定の選択で測定費用がどれほど変わるか |
10月27日に確認した情報:AA公開ページ、AA公開時の評価、OpenAIの料金表。
2つのIndexは異なるタスクを使っているため、平均してはいけません。概数のIntelligenceスコアは、各モデルの掲載中の最高設定であり、推論強度をそろえた測定値ではありません。トークン単価はタスク単価ではありません。AAの調査はOpenAIの公開時のグラフとは独立していますが、AA独自のタスク、ツール、採点方法、設定に左右されます。いずれも、あなたの環境での完了率は測定していません。
OpenAIは別途、最大の推論設定でTerminal-Bench 4.0のスコアを50.3%と報告し、GPT-5.6 Terraの公表値21.5%と比較しています。これは前モデルとのベンダー公表の比較であり、ソフトウェア開発全般でTerraがSolに匹敵する証明ではありません。OpenAI自身も、最も複雑なコーディングにはSolかAstraを勧めています。この違いは、別バージョンを扱った以前のGPT-6 Solレビューを読むときにも重要です。
Terraが役立ちそうな場面
元資料がそろっているときの明快な文章作成
Terraを試す理由として有力なのは、提供されたメモを読みやすい説明に整えることです。OpenAIのモデル選択ガイドも、簡潔で資料に基づく文章作成を評価するよう勧めています。「文章作成に最適」と言い切るより、範囲を絞った説明です。
元資料、読者、必要な節を渡し、根拠のない事実を追加しないよう指示してください。条件や但し書きが保たれているか、必要な詳細が含まれているかを確認します。編集者が結果を確認できる製品ドキュメントや社内要約に向いています。長い本や多くのツールから資料を集める調査レポートの信頼性まで示すものではありません。
使い道がはっきりした画像タスク
OpenAIは、図面の解釈、商品画像の照合、アプリ画面上の操作をTerraの用途に挙げています。公開時の評価では、視覚的推論とデスクトップタスクで前モデルより改善したとしています。フォームの入力やスクリーンショットの読み取りに試す理由になります。
ただし、結果を確認できることが前提です。入力した値が資料と一致すること、選んだ商品が画像と合うことを確かめてください。ブラウザ自動化には、ページへのアクセス、ツールの動作、結果の検証も含まれます。モデルのスコアが測るのはワークフローの一部です。
範囲の限られたタスクなら費用を抑えられる可能性
AAの費用対効果の結果は、合格条件が明確な反復タスクで、低い推論設定を試す根拠になります。決まった項目の抽出や、新しい事実を加えずに段落を書き換える作業が例です。価格を抑えたLunaと幅広い能力を持つSolの間に、Terraを試す余地があります。
事実性の改善も注目できます。AAによれば、AA-Omniscienceで答えられない質問に推測で回答する割合は、GPT-5.6 Terraの88%からTerraの38%へ下がり、精度は2ポイント上がりました。この条件付きの推測率は、通常の回答の38%が誤りだという意味でも、残り62%がすべて正しいという意味でもありません。抽出タスクで不明点を明示する根拠にはなります。
節約効果が消える場面
長いタスクでは料金以上の監督が必要かもしれない
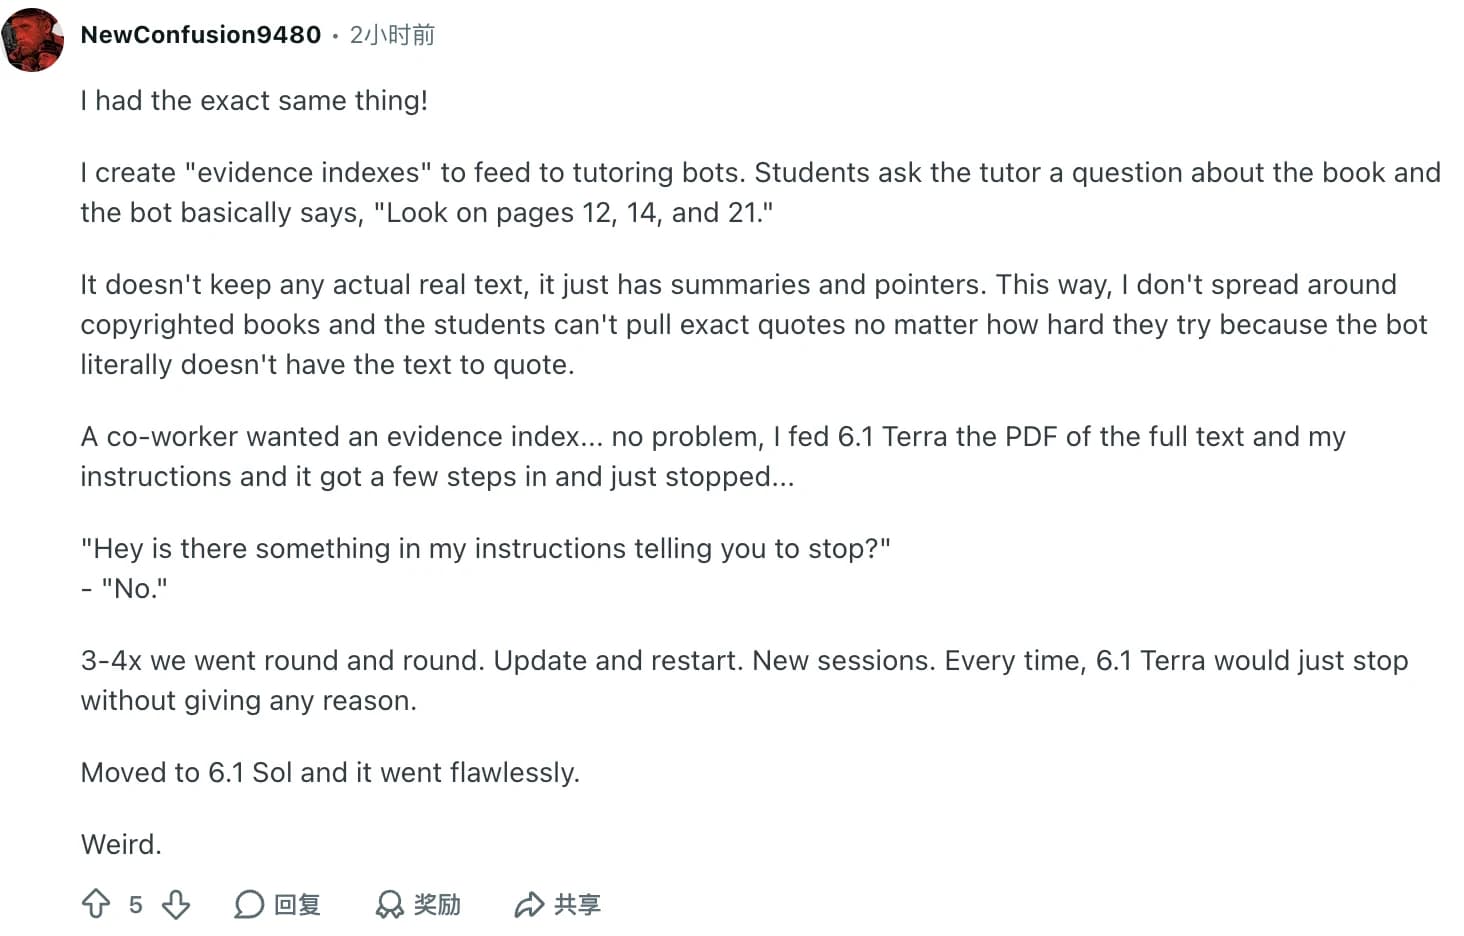
u/NewConfusion9480は、家庭教師向けPDFの証拠索引を作る具体的なタスクを紹介しました。Terraは何度も止まった一方、Solに切り替えると作業が完了したとのことです。元の投稿者u/Hefestion89は、ChatGPT Workで章ごとに文学作品を分析させた際、手順の指示に従わないことがあったと説明しています。
いずれも公開初日の報告で、統制された再現テストはありません。モデルの挙動と、オーケストレーションやセッション状態の影響を切り分けられない報告です。ただ、受け入れテストの観点は示しています。何度も指示し直さずに、エージェントが必要な節をすべて終えたかを確認しましょう。推論強度を上げるだけでは、完了したかどうかの確認にはなりません。
速さと品質が引き換えになることがある
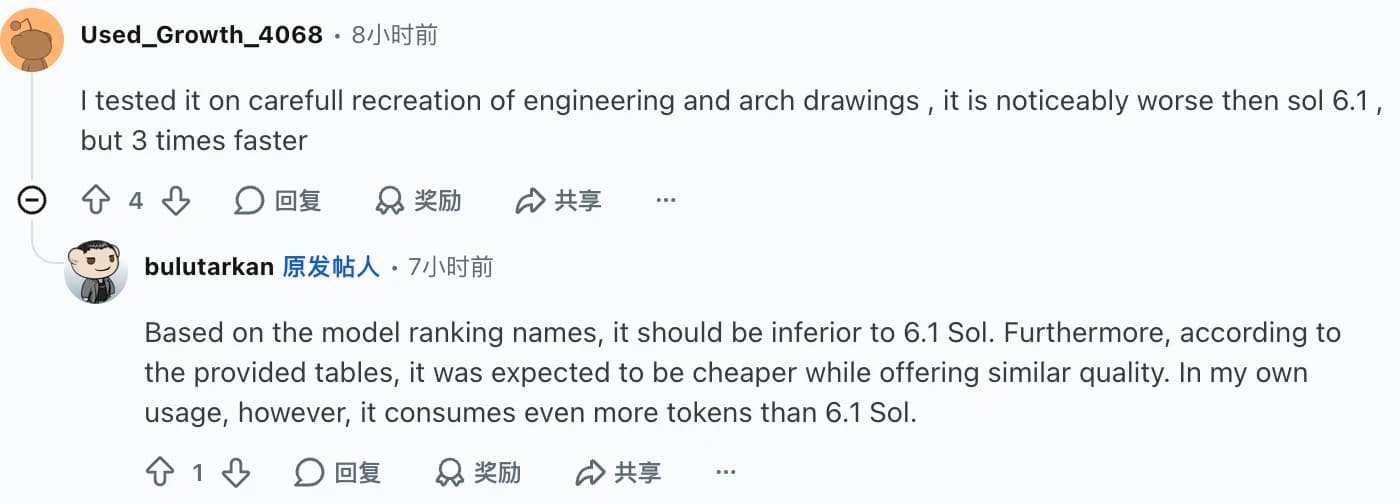
u/Used_Growth_4068による図面再現の報告では、TerraはSolより速いものの、目に見えて品質が低いとされています。共通の入力や採点基準がないため、速度の倍率は個人の感想です。それでも、画像作業が速くなれば細部も保たれる、という思い込みへの反例になります。
DualEntryの再現性の結果は、同じ懸念を特定分野で数値化しています。毎回同じ答えが必要なら、最もよくできた例だけでなく、複数回実行して確かめてください。難しく曖昧な作業では、GPT-6 Astraレビューで扱ったような、より高性能な選択肢とも比べましょう。
APIの割引からサブスクリプションの利用枠は分からない
OpenAIのモデルドキュメントには6段階の推論設定が記載され、既定値はmediumです。入力が272Kトークンを超えるプロンプトでは、リクエスト全体に高い料金が適用されます。キャッシュ書き込みやツールの料金も関係します。コンテキストウィンドウが1,050,000トークンでも、上限まで使ったときに安いという保証にはなりません。
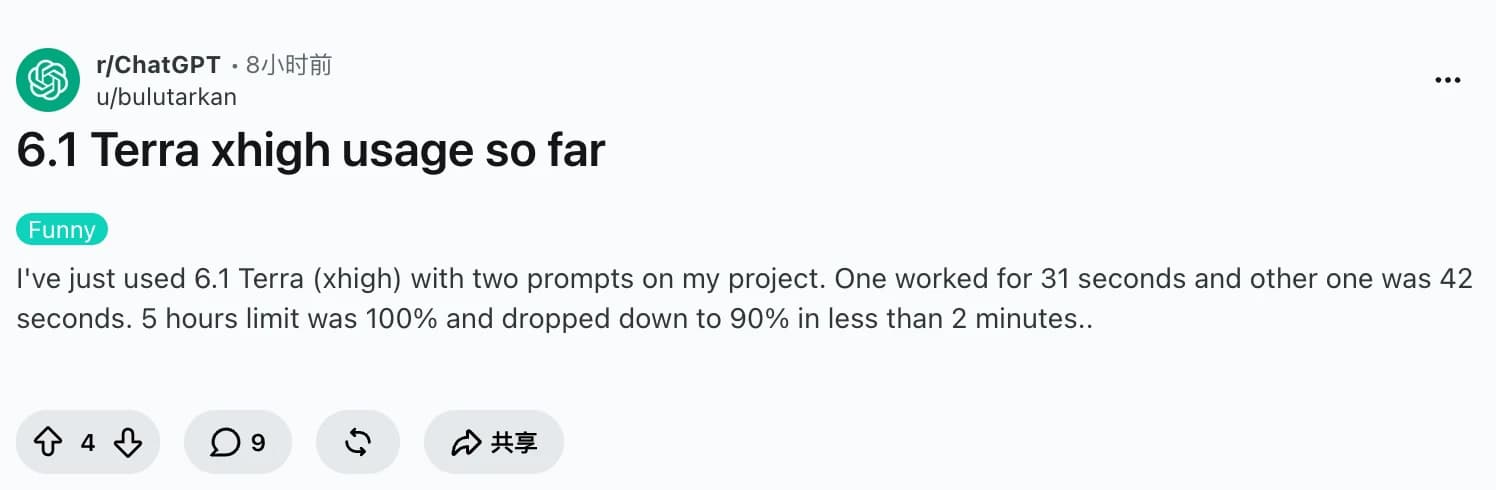
一方、u/bulutarkanは、xhighのプロンプトを2回使った後に利用枠が10ポイント減ったと報告しました。これはAPI請求書でも、管理された利用枠の比較でもありません。アカウント、推論、コンテキスト、製品側の計算方法はそれぞれ異なる場合があります。この報告は自分の利用状況を確認するきっかけとして扱い、トークン数とサブスクリプションの割合を換算する式には使わないでください。
ユーザーの声:速さとタスクの完了
肯定的な報告は待ち時間の短さに注目しています。懸念は出力の忠実さ、作業の完了、利用枠に関するものです。以下の引用は日本語に翻訳していますが、スクリーンショット内の文面は原文のままです。4例は異なる観点を示すもので、代表性のある調査ではありません。
「今日Terraを試したところ、安定して1分で作業を終えてくれました。しかも出来がいい……」
u/ExplanationSenior104、Codexでの作業、10月26日UTC。投稿者自身のセッションを比べており、タスクの組み合わせはそろえていません。
「Sol 6.1より明らかに出来は悪いが、3倍速い」
u/Used_Growth_4068、工学・建築図面の再現、10月26日UTC。引用文は日本語に翻訳しています。速度と品質の評価は投稿者の観察です。
「6.1 Terraは毎回、何の説明もなく止まってしまう。」
u/NewConfusion9480、PDF証拠の索引作成、10月27日UTC。報告ではSolがワークフローを完了しました。Terraが停止した原因は確認されていません。
「5時間の利用枠が100%だったのに、2分もたたずに90%まで下がった……」
u/bulutarkan、xhighでプロジェクト用プロンプトを2回実行、10月26日UTC。これはサブスクリプション利用枠についての観察で、測定されたAPI費用ではありません。
Hacker Newsのwyreは、PC操作、自動化、技術文書作成がTerraの対象ユーザーだと述べています。これは製品の位置づけに関する意見で、別のテスト結果ではありません。ここで重要な区別とは一致しています。安価なモデル1つが大型モデルをすべて置き換えると期待せず、必要な作業に合わせてTerraを評価しましょう。
タスク別の結論
範囲が限られた画像・文章ワークフローでは、Terraを試す価値があります。長く複雑な作業では、比較対象としてSolを残してください。トークン単価が半額でも、確認を終えた成果物が使える場合にだけ節約になります。
| 作業内容 | 最初に試すモデル | 切り替える前に確認すること |
|---|---|---|
| 提供メモを短い説明文に書き換える | Terraをnoneまたはlowで試す | 元資料への忠実さ、必要な節、読者への適合 |
| スクリーンショットを解釈する、フォーム欄を準備する | Terraをlowまたはmediumで試す | 各値と元資料の一致、保存後の結果 |
| 小規模で独立したコードの不具合を直す | TerraとGPT-6.1 Solを比較する | 回帰チェック、再試行の合計、確認時間 |
| 大規模なリポジトリ変更、長時間の自動文書タスク | Solから始め、難しい作業ではAstraも検討 | 最初から最後まで完了するか、すべての制約が保たれるか |
| 単純なスキーマを使う大量分類 | LunaとTerraを比較する | 自分のデータでの合格タスク費用とエラー処理 |
| 不一致による損失が大きい反復作業 | トークン価格だけで選ばない | 再現性と修正費用 |
表の設定は試行を始めるための候補であり、実測した最適値ではありません。AIブラウザガイドとエージェント型ブラウザの概要では、モデルを取り巻く製品側の機能を説明しています。ページ、ファイル、保存結果をまたぐタスクでは、その部分も重要です。
Tabbitでワークフローを試し、結果を確認する
ベンチマークだけでは、モデルに自分のタブへのアクセスを与えたり、保存した記録を検証したりできません。Tabbit Browserはブラウザのコンテキストとタスク用ツールを提供します。公式サイトには、ページ、スクリーンショット、ローカルファイルを参照する機能が記載されています。これらはTerraが想定する種類の作業を評価する場所として使えます。
まず、アカウントのモデル選択欄にGPT-6.1 Terraが実際に表示されるか確認してください。Terraのリソースページ (English)には設定と根拠がまとめられていますが、存在するだけではクライアントで使えると確認できません。この記事ではTerraを選択したTabbitのテストを完了していないため、その環境での成功率、応答時間、トークン請求額、比較結果は提示できません。
最初の確認では、公開されている製品仕様を開き、4項目を尋ねます。製品名、通貨付きの価格、明記された制限、情報源URLです。ページに書かれていない値にはunknownと答えるよう求めてください。2つ目のページでも繰り返し、画面上の原文と出力を照合します。続いて、外部情報を持ち込まずに2ページの内容を比較するタスクを試します。長い文書を扱う場合は、ページを特定した回答を求め、引用を一つずつ確認してください。
実行前に、要求した全項目または引用がそろっていること、裏付けのない追加がないこと、完了報告が正確であることを合格条件にします。入力、選択したモデル名、出力、スクリーンショット、修正内容を保存してください。可能であれば同じタスクをSolでも繰り返します。クライアントでの測定とAPIベンチマークは別に扱い、少数の例から全般的な成功率を推定しないでください。
これらの確認が自分の作業に合うなら、Tabbitをダウンロードして少数のタスクで比べてください。モデルの利用可否とメンバーシップ条件は、現在のクライアントと地域によって異なります。この記事のAPI料金はTabbitの料金ではありません。
 Tabbit Browser

よくある質問
GPT-6.1 TerraはGPT-6.1 Solの代わりに使う価値がありますか?
速度と費用が重要な画像処理、資料に基づく文章作成、範囲を限定した自動化では、Terraを評価する価値があります。複雑なコーディングや長い推論では、Solをより有力な出発点として考えてください。実際に使う推論設定でタスクを完了・確認し、比べましょう。
GPT-6.1 TerraのAPI料金はいくらですか?
2026年10月27日に確認した標準の短いコンテキスト料金は、入力100万トークンあたり1ドル、キャッシュ済み入力100万トークンあたり0.05ドル、出力100万トークンあたり5ドルです。キャッシュ書き込み、ツール、サービス階層、長いコンテキストへの調整で請求額は変わります。API料金はChatGPT、Codex、Tabbitのサブスクリプション利用枠を示すものではありません。
Terraでは常に`max`の推論強度を使うべきですか?
いいえ。Artificial AnalysisはTerraの設定間で、平均タスク費用に最大7.4倍の差があると報告しています。範囲が限定されたタスクでは低い設定から始め、自分の合格基準で明確な改善が確認できた場合だけ推論強度を上げてください。
幻覚率が下がったなら、回答は信頼できますか?
特定の評価で改善したという意味であり、保証ではありません。Artificial Analysisはモデルが答えられない質問への推測を測定しています。一方、OpenAIは異なる社内プロンプトセットで事実誤認を報告しています。どちらの割合も、あなたの文書やアプリでの誤り率ではありません。
GPT-6.1 TerraはChat Completions経由でツールを呼び出せますか?
OpenAIはChat Completionsを対応エンドポイントに挙げていますが、ツール呼び出しにはResponses APIが必要です。モデルはテキストと画像を受け取り、テキストを出力します。モデルを使う製品が独自にツールやファイル処理を追加する場合はあります。
Tabbit BrowserでGPT-6.1 Terraを試せますか?
TabbitでTerraを使ったワークフローを計画する前に、アカウントの現在のモデル選択欄を確認してください。この記事ではTerraを選択したTabbitでの実行を検証しておらず、モデルのリソースページだけではアカウントで利用できることを確認できません。Tabbitのメンバーシップ条件はOpenAI API料金とは別です。