
Claude Opus 5.5 是近期最容易做的 Opus 決定:把你預設的 Opus 工作切過去。Anthropic 於 2026 年 9 月 22 日發布它,定價每百萬輸入 4 美元、輸出 20 美元——比 Opus 5 低 20%——並明確宣稱它在「大多數工作上達到 Claude Fable 5.1 的水準」,運行成本「比 Opus 5 低 40%」。發布次日的獨立證據大體支持這個說法,但有兩個保留:最高努力檔下它的話足夠多,多到能吃掉折扣;細看之下,它相對 Fable 5.1 的能力提升是漸進式的,不是新天花板。
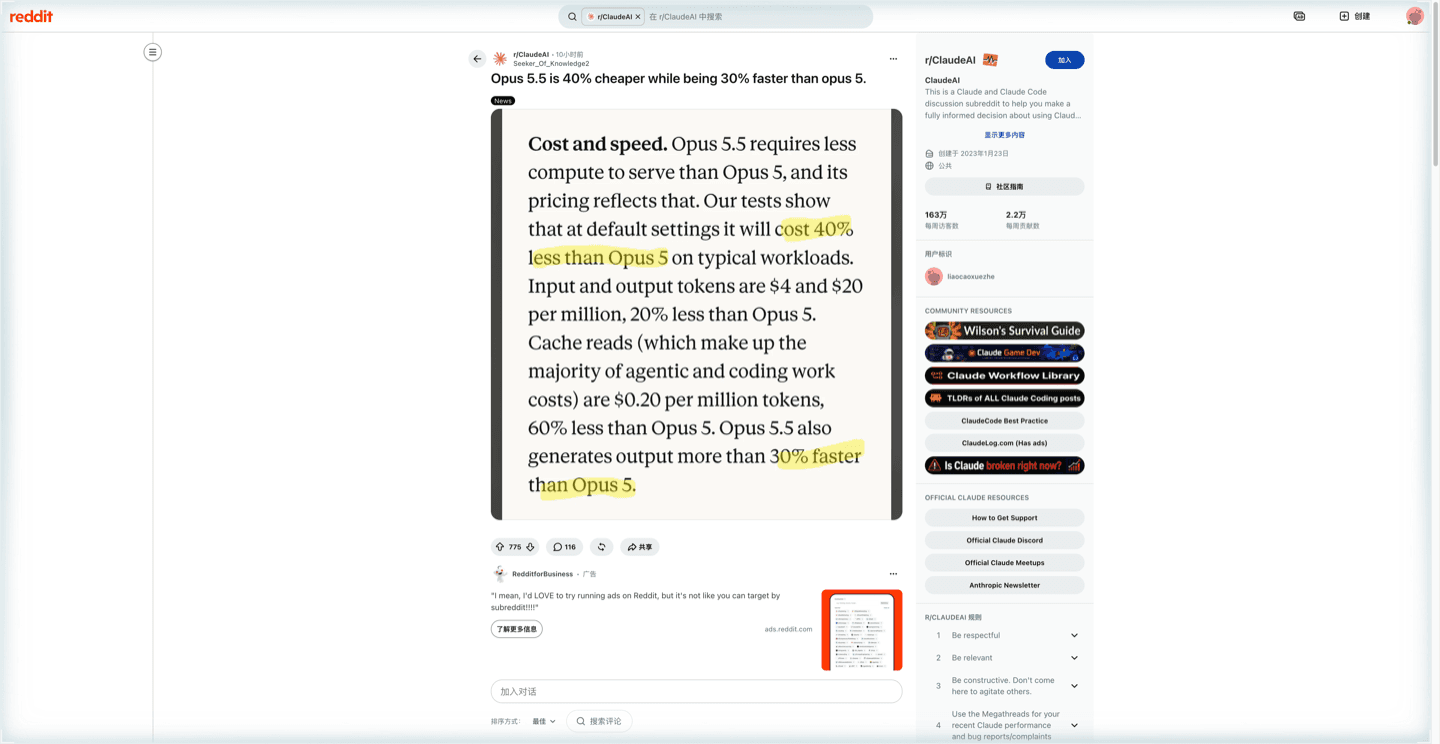
這套定調不是憑空造出來的。發布幾小時內,r/ClaudeAI 投票最高的帖子標題就是「Opus 5.5 is 40% cheaper while being 30% faster than opus 5」——775 個讚,社群把官方數字複述成了購買理由。同帖最高讚留言解釋了反應為什麼這麼激烈:Opus 5「couldn't even communicate properly」,人們「wasting even more time and tokens」跟它搏鬥(u/Front_Raspberry_6488,226 讚;譯:連正常溝通都做不到……浪費了更多時間和 token)。這篇評測負責分類這些感受裡哪些有證據支持。
下文所有事實都在 2026 年 9 月 23 日、發布次日逐一打開核對:Anthropic 發布頁、Artificial Analysis 模型頁和各條 Reddit 原帖。Claude Opus 5.5 模型首頁 (简体中文)承載提示詞與證據庫,它的評測證據卡 (简体中文)是本文背後的一手記錄。目前尚無 Opus 5.5 的定價頁和替代品頁,本文不連結不存在的兄弟頁面。結尾會討論這些發現對瀏覽器級工作流的意義——這類模型越來越多的活,正在那裡發生。
核心結論
關鍵數字是 40%,而且它是工作量口徑,不是牌價。 價格降了 20%(4/20 美元),快取讀取降了 60%(0.20 美元/百萬)。「運行成本低 40%」來自 Anthropic 自家的典型負載測試——SonarSource 在 Java 生成上獨立測得輸出 token 恰好少了 40%,而 Artificial Analysis 在最高努力檔測得每個指數任務 5.98 美元。
一個獨立榜第一,代價是話多。 Artificial Analysis 給 Opus 5.5(最高努力檔)打出 58 分,212 個模型中排第 1;同時冗長程度排第 95:每個指數任務約 11.9 萬輸出 token,對比 GPT-6 Astra 最高檔的約 2.7 萬。
壓垮 Opus 5 的溝通問題看起來修好了。 社群對 Opus 5 最大的抱怨是活幹得不差、對話沒法進行。首日聲音普遍形容 5.5 快、自然、廢話少;SonarSource 測得生成 Java 程式碼的註解占比從 10.5% 降到 3.1%。
程式碼更少,缺陷更密。 SonarSource 的預發布版測試中,程式碼量少 27.5%、問題總數少 42%,通過率持平,但每百萬行缺陷密度從 576 升到 644,並發類缺陷升 44%。審查環節不能省。
METR 的判詞:漸進式,不是跨越。 預部署評估在五項 AI 研發任務上測得相對 Fable 5.1 的小幅提升,判斷類短板(前瞻、回饋循環、研究品味)依然存在。為經濟性和打磨度買 5.5,撞到天花板再升級 Fable。
Claude Opus 5.5 到底是什麼
Claude Opus 5.5 是 Anthropic 新的 Claude 5.5 系列的第一款模型,2026 年 9 月 22 日發布。API 模型 ID 為 claude-opus-5-5;發布頁列出 Anthropic Claude Platform、AWS、Google Cloud 和 Microsoft Azure。文件口徑是 100 萬 token 上下文、最高 12.8 萬 token 輸出、自適應思考,預設努力檔為 medium——這個細節比本文任何一行基準都重要。
| 問題 | 已發布口徑(2026-09-23 核對) | 它不能證明什麼 |
|---|---|---|
| 發布時間與模型 ID | 2026-09-22;claude-opus-5-5 | 每個用戶端都暴露同一構建和努力檔區間 |
| 輸入 / 輸出價格 | 每百萬 token 4 美元 / 20 美元 | 思考和重試之後的單任務完成成本 |
| 快取讀 / 寫 | 每百萬 0.20 / 5 美元(Opus 5:0.50 / 6.25) | 所有負載普降 40% |
| 上下文與輸出 | 輸入 100 萬,輸出最高 12.8 萬 | 每家供應商或方案都給滿視窗 |
| 努力檔 | 自適應思考;預設 medium | 低努力檔還能保住同樣的分數(未按任務公布曲線) |
| 可用性 | Anthropic、AWS、Google Cloud、Azure | 消費端方案;本文未核實 |
| 獨立快照 | Artificial Analysis:58 分,212 個模型第 1(最高檔) | 速度:AA 對該模型的延遲標為 N/A |
Anthropic 還給這次發布加了程序性註腳:這是該公司呼籲「pacing the frontier」(放緩前沿節奏)之後的第一款發布,發布前經過包括 Frontier Design 和 METR 在內的外部評估者測試。在 Anthropic 自家的自動化行為稽核(約 2000 個情境)上,Opus 5.5 是「迄今測試過的表現最強的模型」;一項圍欄邊界評估顯示,越界嘗試比 Opus 5 或 Mythos 5.1 少約 85%。這些安全聲明值得記錄,而且雙向起作用:後文會展示安全護欄的介入如何在能力基準上變成零分。
本文回答的問題不是「它聰不聰明」——廠商發布表和獨立榜第一已經回答了。而是:一款按主力機型定價、按旗艦水準宣傳的模型,值不值得進入你的日常工作流——對比繼續用 Opus 5 的費率、付 Fable 5.1 的價格,或者把機械性工作轉給 GPT-5.6 Sol、MiMo-V2.6-Pro 這類更便宜的模型。
決定這篇評測的那個數字:40%
Anthropic 的定調句,已在發布頁原文核對,值得逐字讀:Opus 5.5「performs at the level of Claude Fable 5.1 on most work and costs 40% less to run than Opus 5」(在大多數工作上達到 Fable 5.1 的水準,運行成本比 Opus 5 低 40%)。一句話裡兩個可檢驗的主張——接近旗艦的能力,主力機的經濟性。
價格部分公開且簡單:輸入 5→4 美元,輸出 25→20 美元,快取讀取 0.50→0.20 美元/百萬。快取讀取對 Agent 工作影響最大,因為一次 40 個工具呼叫的運行會把快取前綴重讀 40 遍;0.20 美元——輸入價的 5%,也就是 Artificial Analysis 標注的 95% 快取折扣——讓長會話在結構上變便宜。這正是 Fable 5.1 發布時快取降價故事的延續,只是這次壓得更低。
40% 部分藏滿了細則,三項獨立測量把它夾在中間:
兌現了: SonarSource 的 Java 生成測試(預發布構建、High 檔)輸出 1296 萬 token,對比 Opus 5 的 2171 萬——字面上的 40% 縮減——而通過率只差不到一個點(87.68% 對 88.6%)。程式碼更少、token 更少、功能結果相同。這是折扣按設計兌現的樣子。
花掉了: Artificial Analysis 用最高努力檔跑智慧指數,測得每任務約 119,000 個輸出 token——對比 Opus 5 最高檔約 7.3 萬、Fable 5.1 最高檔約 7.8 萬、GPT-6 Astra 最高檔約 2.7 萬——加權單任務成本 5.98 美元,冗長程度排 212 個模型中第 95。這是模型被允許全音量思考時,折扣被花掉的樣子。
中間態: Anthropic 內部的併購分析任務 63 分鐘完成,對比 Opus 5 的 93 分鐘,「運行成本低 50%」——廠商自測,正好落在宣稱值上。
調和這三條不是找矛盾,而是找到那個旋鈕:努力檔。預設 medium 有它的道理:40% 的折扣是真的,能不能拿到,基本取決於你的工作流反射性地用哪一檔。 METR 的能力判讀從另一側支持同一結論——相對 Fable 5.1 只是漸進式提升,所以切換的理由是經濟性和打磨度,不是新天花板。如果你的管線因為「最強模型配最高檔」而無腦鎖 max,你已經把自己重新定價回旗艦區。
排行榜之前,真實任務上發生了什麼
首日最有用的證據不是基準行,而是三個有名字、有邊界的建造故事。
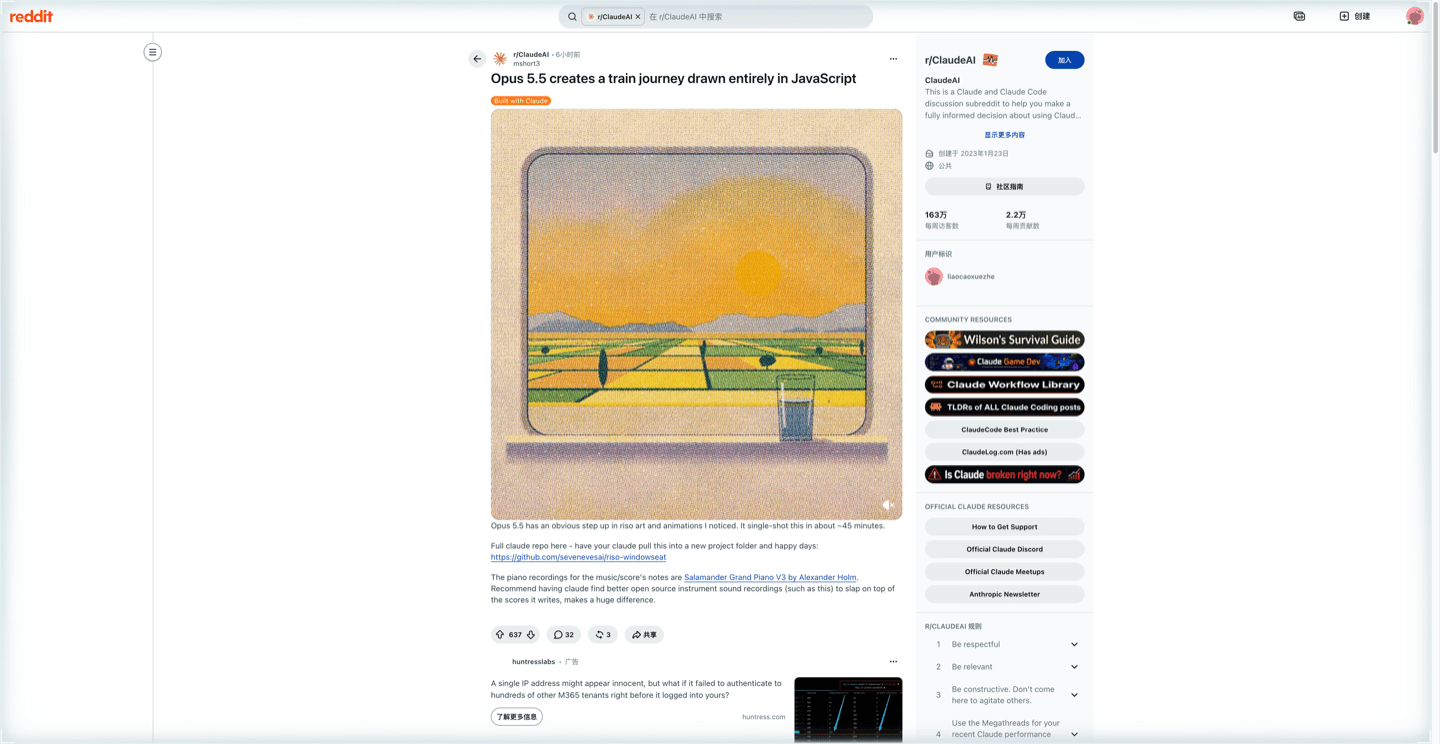
一支 45 分鐘一次成片的電影。 u/mshort3 在一個現成的創意專案裡給 Claude Code 一句話——「Lets make a ~70s riso film of your own choosing, free range」——並報告 Opus 5.5 一次運行約 45 分鐘產出了一支 78 秒的動畫火車旅程(r/ClaudeAI,637 讚)。儲存庫公開,作者把功勞記給專案自帶的技能和文件,而不只是模型。單次運行,沒有中間狀態日誌。
一段提示詞做出一分鐘影片——附成本回執。 u/AzorAhai1TK 要求渲染「an average day at work… with a twist」——一個詭異版的一分鐘職場影片,並報告模型在 Extra-High 檔端到端寫程式加渲染約 45 分鐘,用掉 $20/月方案每週額度的約 4%(r/ClaudeAI)。數字自報,但這個額度數據點正是定價討論需要的:創意型高努力運行不免費,也不算災難。
Claude Code 裡「night and day」的速度——作者自己貼了保留意見。 u/Lazy_Assistance_1137 說以前要查一陣子的 UI bug「in no time」就被定位,稱提升「night and day」——緊接著自己潑冷水:「this could just be the classic day-one honeymoon phase, and in two weeks we'll all be back to posting 'did they nerf it?' threads」(r/ClaudeAI,273 讚;譯:這可能只是經典的發布日蜜月期,兩週後我們又會回去發「他們是不是削弱了它」的帖子)。最高讚回覆只有一個詞的深度:「It's crazy fast. I'm impressed.」(u/capivara_de_pijama,96 讚;譯:快得離譜,我服了。)
三個故事,各 n=1,無日誌,無 token 計數(那 4% 除外)。它們證明的是:發布第一天,這個模型反覆地、公開地、帶著可打開的成品,完成長程、自主、多工具的創意建造。它們不能證明的是:這種完成的頻率。這正是基準該補的位——看看它到底補了多少。
基準資料,以及該信幾分
Anthropic 發布表,按 2026-09-22 發布原樣記錄。不同列可能來自不同營運方和榜單(GPT-6 Astra 與 GPT-5.6 Sol 的數字被 Anthropic 標注為來自 OpenAI 報告),請按行讀,別做欄間算術:
| 領域 / 基準 | Opus 5.5 | Fable 5.1 | Opus 5 | GPT-6 Astra | GPT-5.6 Sol |
|---|---|---|---|---|---|
| Agent 編碼:Terminal-Bench 4.0 | 66.4% | 55.8% | 52.3% | 57.9% | 37.3% |
| Agent 編碼:FrontierCode v1.1 | 54.4% | 50.3% | 48.0% | 53.3% | 47.5% |
| Agent 編碼:CursorBench 4.0 | 57.8% | 51.8% | 46.6% | — | 41.7% |
| 知識工作:GDPval-AA v2.1 | 1846 | 1735 | 1708 | 1542 | 1588 |
| 業務流程:AutomationBench | 40.0% | 31.4% | 26.9% | 41.4% | 28.8% |
| 推理:Humanity's Last Exam(帶工具) | 67.7% | 65.6% | 63.6% | 57.2% | — |
| Agent 科研:Terminal-Bench-Science 0.1 | 58.7% | 52.6% | 29.0% | 64.6% | 22.4% |
| 電腦使用:OSWorld 2.0(partial) | 81.8% | 80.7% | 74.0% | — | — |
| 圖表識別:Chartography(帶工具) | 89.0% | 88.4% | 83.4% | — | — |
然後是潑冷水三連。
誤差範圍是公開的,而且不窄。 Terminal-Bench 4.0 上 Opus 5.5 的標準誤為 ±2.6 個百分點;Terminal-Bench-Science 為每模型 ±3.5–5 個百分點。TB-Science 上 Opus 5 → Opus 5.5(29.0% → 58.7%)的跳躍扛得住任何誤差;同一行上與 GPT-6 Astra(64.6%)的差距也扛得住——方向對 Astra 有利。Anthropic 自己在頁面上提醒:在當前能力水平下,基準分數差異未必能可靠地代表真實世界差距。這句話出自廠商之口,是本季所有發布表裡最誠實的一行。
對比條件並不統一。 Terminal-Bench 各行使用 Claude Code 測試框架;AutomationBench 由 Zapier 運行並報告,未啟用回退模型,安全護欄介入即記失敗;GDPval-AA v2.1 的獨立評分流程在頁面上沒有細說。被護欄介入的任務會記零分——一次策略結果被記成能力失誤。這些都不讓發布表變「錯」,但讓它變成一組條件各異的快照,不是一場控制變數的比賽。
獨立記錄認形狀,不認幅度。 Artificial Analysis 自家指數(v4.3.2,十項評測)給 Opus 5.5 最高檔 58 分、212 個模型第 1,其中六項 outright 領先(Humanity's Last Exam 61.4%、SciCode 66.9%、GDPval-AA 1846、AA-Briefcase 1822——比 Fable 5.1 高 143 Elo),Terminal-Bench 4.0 以 59.6% 與 GPT-6 Astra xhigh 並列。SonarSource 的受控 Java 測試是最鋒利的單個數據點:通過率與 Opus 5 相差不到一個點,同時程式碼量少 27.5%——而單位行數缺陷密度上升,後文展開。METR 的預部署評估歷時 10 個工作日、五項 AI 研發任務,結論是相對 Fable 5.1 的提升為「incremental… rather than a discontinuous leap」(漸進式……而非斷崖式跨越),在前瞻、回饋循環搭建、研究判斷上沒有大的進展。
潑完冷水還站得住的:對 Opus 5 的前後差距真實且巨大(TB-Science 29.0% → 58.7% 不是四捨五入的花招);獨立榜第一有第二來源佐證;成本故事有一項完全獨立的重現(SonarSource 的 token 數)。站不住的:任何「Opus 5.5 完勝 GPT-6 Astra」的說法——Anthropic 自己的表上 Opus 5.5 領先 Terminal-Bench 4.0、Astra 領先 Terminal-Bench-Science;Artificial Analysis 的獨立 TB-4.0 運行裡兩者 59.6% 打平;我們的 GPT-6 Astra 評測另文討論它自己的取捨。
Opus 5.5 真正好的地方
它終於像個同事一樣說話
沒有任何基準行能覆蓋這條優點:Opus 5 是一款編碼很強、卻讓人討厭跟它對話的模型,而首日聲音說 5.5 把對話本身修好了。r/ClaudeAI 錨點帖的高讚留言是對舊痛的清算——「Opus is fantastic, just until you have to talk to it」(u/Neon_Camouflage,61 讚;譯:大部分專案工作上 Opus 很棒,直到你不得不跟它說話)——配上如釋重負:「Heard Opus 5.5 is less verbose」(u/No-Temperature6597;譯:聽說 Opus 5.5 廢話少了)。SonarSource 的分析器給這個行為變化上了數字:生成 Java 的註解占比從 10.5% 降到 3.1%,程式碼異味密度降 21%。受訓哲學家的氛圍檢查(medium 檔、無痕模式)形容它是「a model with polish and panache… It will happily cite back Theophrastus and Austin to you, but can't break the habit of wanting to get its hands dirty」(u/Wickywire;譯:一個打磨光鮮、派頭十足的模型……會愉快地給你引用泰奧弗拉斯托斯和奧斯汀,但改不了想捲起袖子動手做的習慣)。如果你靠寫作和規劃吃飯——不只是編譯——這條升級比任何編碼分數都重要。
Agent 跟進力,配 Opus 的價格
這是官方表的中心地帶,而且立得住:Terminal-Bench 4.0 66.4%、TB-Science 58.7%(都在公布的誤差帶內),測試框架為 Claude Code;CursorBench 4.0 57.8%;OSWorld 2.0 partial 81.8% 覆蓋電腦使用。內部案例在廠商證據裡算異常具體的:季度財報任務上 18 份報告有 16 份通過了一個逐數字逐引用核對的評分器,而 Fable 5.1 和 Opus 5 的嘗試都沒過;虛構併購分析 63 分鐘對 Opus 5 的 93 分鐘,成本約一半。廠商自測,但任務形狀——長程、多檔案、重驗證——正是終端分數測量的東西。對 Agent 研究與深度工作負載來說,4/20 美元配上這個側寫,是本次發布最硬的理由。
Medium 檔的經濟性是安靜的頭條
預設 medium 加 0.20 美元快取讀取,改變的是長會話的單位經濟學,而牌價看不出來。Artificial Analysis 把五個努力檔中的四個放進了智慧-成本帕累托前沿——唯一的例外是沒人該反射性去選的那檔——它的 5.98 美元/任務屬於 max,不屬於 medium。CodeRabbit 的管線測試發現 Standard 配置(較低檔)在 80 個模式集上以更好的可執行精度和更少留言數擊敗了自家 Max 配置,Max 只在 13 個最難的 Signal 案例上拉開差距。三個獨立來源的形狀一致:這個模型的價值函數獎勵刻意的努力檔選擇,懲罰條件反射。 對還在付 Opus 5 或 老 Opus 4.8 費率的團隊,這次切換幾乎是白撿的上行空間。
它咬人的地方
Max 檔燒掉折扣
讓 medium 便宜的那個旋鈕,讓 max 昂貴:AA 指數任務約 119k 輸出 token(GPT-6 Astra max 的 4.4 倍、Fable 5.1 max 的 1.6 倍)、加權單任務 5.98 美元、冗長度第 95/212、整個評測累計 2.6 億 token。CodeRabbit 在生產形狀的工作裡看到同樣的形狀:token 用量比自家基線高 49–60%,Max 在 OSS 集 +57.6%、Signal 集 +60.1%,換來的精度常常不需要。如果你的框架或習慣鎖死 max,請按旗艦預算做規劃;也可以看看 Gemini 3.8 Flash 評測裡一個刻意節儉的對照,以及近期佇列中單任務實測成本最低的 MiMo-V2.6-Pro。
程式碼更少,缺陷更密
SonarSource 的數字值得配上它彆扭的標題:問題總數降 42%,但每百萬行缺陷密度從 576 升到 644;並發/執行緒類——在生產環境而不是審查中暴露的那類——升 44% 成為最大類(295/mLOC)。三個最高嚴重級 BLOCKER 的密度全部下降,這確實讓人安心,但形狀很清楚:5.5 寫的程式碼更緊湊,卻不均勻地更安全。兩個邊界:該測試用的是預發布構建(SonarSource 會在正式版後重跑);CodeRabbit 的平行發現——OSS 集上新找出 11 個模式、漏掉基線能抓的 9 個——從審查側說了同一件事。保留審查環節,把它挪到管線更前面,別刪掉。
對 Fable 只是漸進,且未知仍是未知
METR 的評估是最不客氣的獨立判詞,值得讀兩遍:五項 AI 研發任務全面小勝 Fable 5.1、沒有證據支持完全自動化、判斷形能力(前瞻、預測、回饋循環搭建、研究品味)沒有大的進展。再加上真正未知的東西:沒有可信的延遲數據(Artificial Analysis 對該模型速度標 N/A,所以本文不引用任何首 token 數字);消費端可用性未核實;帶護欄的運行可能整題記零,意味著你測試框架的安全設定是你測得能力的一部分。一款只活了一天的模型,這些都隨身攜帶。沒有一條足以否決;每一條都在說:先做一次有度量的試點,而不是全量翻轉。
社群原聲
首日輿論沿兩條軸分裂,不是一條。
軸一:終於快了——也終於能聊了。 速度帖及其回覆是明確的欣喜;哲學訪談是同一件事的定性版,形容它「polish and panache」外加動手欲。圍繞它重建工作流的用戶概括了這個人群:喜歡 Opus 5 的產出、痛恨跟它的對話。
軸二:信任,但要驗證——Opus 5 的疤痕組織。 錨點帖裡的懷疑是具體的:人們被一款基準好看、溝通糟糕的模型燙過,不接受發布日數字當作結案。一條留言善意地解讀設計意圖——「Fable 5 & Opus 5 were designed & tested together with the intent being that you talk to Fable and it delegates execution to Opus agents」(u/canyonero7;譯:Fable 5 和 Opus 5 是一起設計、一起測試的,意圖就是你跟 Fable 說,它把執行派給 Opus)——這引出了關於 5.5 的真問題:它按執行模型定價,卻被當成對話模型宣傳,一款模型同時勝任兩個角色,恰恰是發布日的狂歡無法證實的。
本文落點:切換決定上跟歡呼者站在一起——經濟性一邊倒,沒必要把新工作留在 Opus 5 上;過程上跟懷疑者站在一起。蜜月期作者說得對,兩週的日誌會比上文任何一張表更有說服力;他也說得對,此刻它確實像一次真實的跨越。
裁決:切換你的 Opus 工作,保留紀律
| 工作負載形狀 | 裁決 | 理由 | 主要保留 |
|---|---|---|---|
| 目前跑在 Opus 5 / 4.8 上的預設編碼 Agent 工作 | 現在就切 | 價格低 20%、快取讀低 60%、溝通修復、TB-Science 29.0% → 58.7% | 鎖定模型 ID;正式版重跑數據落地後再複核 |
| 最難的前沿與長程研究 | 升級到 Fable 5.1 | METR:漸進式;官方定調本身也是「Fable 的水準」 | Fable 的成本與怪癖是另一個決定 |
| 無人值守長運行、批次處理管線 | medium 檔的好候選 | 0.20 美元快取讀 + 預設 medium;AA 帕累托前沿 5 檔佔 4 | 無可信延遲——押 SLA 前自測首響 |
| 互動式聊天產品 | 先測再上 | 延遲未知;高努力檔的冗長度(第 95/212)直接打在體驗和帳單上 | AA 速度標 N/A;本文不引用任何數字 |
| 無審查的 Java 或大規模程式碼生成 | 用,但審查前移 | 通過率持平、輸出更精、BLOCKER 密度全降 | 缺陷密度 576 → 644/mLOC;並發 +44% |
| 成本地板的自動化 | 對比更便宜的模型 | 4/20 美元對 Opus 級便宜,絕對值不便宜 | 機械活 MiMo 0.13 美元/任務或 Gemini 3.8 Flash 可能更合適 |
兩條時效提示。第一,本文所有獨立數字都是首日快照:SonarSource 測的是預發布構建並承諾正式版後重跑;Artificial Analysis 排名逐日變動。第二,家族梯隊還在補位——Sonnet 5 和 Haiku 4.5 在這次發布之下,而 Anthropic 的「Claude 5.5 family」措辭說明還有後續成員。用鎖定而不是習慣來規劃模型路由。
一條實踐路徑:在工作發生的地方跑它
上文所有線索指向同一個形狀:經濟性獎勵長程、多工具、刻意選檔的運行;失敗模式是不加監督的量;而未決問題——延遲、選擇器可用性、數週後的穩定性——都只能靠跑一個有邊界的任務來回答,不是再讀一張表。這是瀏覽器形狀的活:多頁調研、抽取與自動化,由智能體瀏覽器托住會話的頁面與上下文,讓模型在裡面幹活——Tabbit Browser正是圍繞這個循環構建的。
誠實的邊界,與我們其他模型評測一致:本文未核實 Opus 5.5 是否出現在 Tabbit Browser 的即時模型選擇器中,也不聲稱做過任何上手實測。請檢查你帳號的模型選擇器,鎖定模型 ID,給它一個可回退的小任務——一個帶現成測試的多檔案改動,或一份要求引用來源的調研包——並按「每個可接受結果的成本」對比 Opus 5,再決定切換你在乎的東西。
 Tabbit Browser
來源
Anthropic:Introducing Claude Opus 5.5——發布事實、定價、基準表、安全章節(2026-09-23 打開)
Artificial Analysis:Claude Opus 5.5 與發布文章——指數 58(第 1/212)、5.98 美元/任務、冗長度測量
METR:Predeployment evaluation of Claude Opus 5.5——「漸進式超過 Fable」判詞
SonarSource:Evaluating Claude Opus 5.5 on Java code generation——通過率、token 與缺陷密度(預發布構建)
CodeRabbit:Opus 5.5 model review——召回/精度與 token 取捨

常見問題
Claude Opus 5.5 值不值得用?
值得作為預設的 Opus 級模型。它以每百萬輸入 4 美元、輸出 20 美元的價格,瞄準大多數工作上 Fable 5.1 的水準,比 Opus 5 便宜 20%,快取讀取低至 0.20 美元。最難的前沿任務仍建議留給 Fable 5.1,也不要反射性地開最高努力檔——實測顯示那時的輸出量會吃掉折扣。
Claude Opus 5.5 比 Opus 5 便宜嗎?
牌價低 20%:輸入 4 美元對 5 美元,輸出 20 美元對 25 美元,快取讀取從 0.50 美元降到 0.20 美元(每百萬 token)。Anthropic 依自家測試宣稱典型工作負載總成本約降 40%。實際省多少取決於努力檔位和 token 結構,請用代表性任務實測。
Opus 5.5 比 Fable 5.1 強嗎?
Anthropic 自己的說法是:Opus 5.5 在大多數工作上達到 Fable 5.1 的水準,同時運行成本更低。獨立核查各有側重:METR 認為在 AI 研發任務上相對 Fable 5.1 只是漸進式提升,而 Artificial Analysis 給 Opus 5.5 打出 58 分,是其 212 個模型快照的第一名。結論是低價位上的接近持平,不是全面勝出。
Claude Opus 5.5 寫程式行嗎?
發布頁報告 Terminal-Bench 4.0 得分 66.4%(標準誤約 ±2.6 個百分點),CursorBench 4.0 為 57.8%。SonarSource 的 Java 受控測試發現它和 Opus 5 的通過率基本持平(87.68% 對 88.6%),程式碼更少但缺陷密度更高,所以保留程式碼審查環節,不要盲信輸出。
為什麼 Claude Opus 5.5 這麼耗 token?
在最高努力檔,Artificial Analysis 測得每個智慧指數任務約輸出 119,000 個 token,是 GPT-6 Astra 最高檔(約 27,000)的四倍多,冗長程度排 212 個模型中的第 95 位。預設努力檔是 medium,且 SonarSource 在 Java 生成上實測輸出 token 比 Opus 5 少 40%,因此消耗量取決於努力檔位和工作負載。
Claude Opus 5.5 什麼時候發布的,哪裡能用?
Anthropic 於 2026 年 9 月 22 日發布,API 模型 ID 為 claude-opus-5-5,上下文 100 萬 token,最高輸出 12.8 萬 token。發布頁列出 Anthropic Claude Platform、AWS、Google Cloud 和 Microsoft Azure。消費端方案的可用性本輪未核實。
能在 Tabbit Browser 裡用 Claude Opus 5.5 嗎?
本文未能核實 Opus 5.5 是否出現在 Tabbit 的即時模型選擇器裡,請勿據此規劃。先查看你自己帳號的模型選擇器,跑一個可回退的小任務,再把工作流交給它。