
O Claude Opus 5.5 é a decisão Opus mais fácil em bastante tempo: migre para ele seu trabalho Opus padrão. A Anthropic o lançou em 22 de setembro de 2026 a 4 dólares por milhão de tokens de entrada e 20 de saída — 20% abaixo do Opus 5 — e o apresentou performando "at the level of Claude Fable 5.1 on most work" com custo de execução "40% less… than Opus 5". O registro independente do dia seguinte apoia em geral essa apresentação, com duas ressalvas: no esforço máximo o modelo fala o suficiente para comer o desconto; e visto de perto, o ganho de capacidade sobre o Fable 5.1 é incremental, não um teto novo.
Esse enquadramento não é marketing no vácuo. Horas após o lançamento, a thread mais votada do r/ClaudeAI se intitulava "Opus 5.5 is 40% cheaper while being 30% faster than opus 5" — 775 upvotes da comunidade repetindo os números oficiais como argumento de compra. O comentário mais votado da mesma thread explica por que a reação é tão intensa: o Opus 5 "couldn't even communicate properly", e as pessoas terminaram "wasting even more time and tokens" brigando com ele (u/Front_Raspberry_6488, 226 upvotes). Esta análise separa quais desses sentimentos sobrevivem às evidências.
Todos os fatos abaixo foram abertos e verificados em 23 de setembro de 2026, um dia após o lançamento: a página da Anthropic, a página da Artificial Analysis e as threads originais do Reddit. O recurso do modelo Claude Opus 5.5 (English) guarda a biblioteca de prompts e evidências; suas fichas de análise (English) são o registro a nível de fonte por trás deste artigo. Ainda não existem páginas irmãs de preços nem de alternativas do Opus 5.5, então esta análise não linka nenhuma. No final, cubro o que os achados significam para fluxos de trabalho em nível de navegador, onde modelos assim trabalham cada vez mais.
Pontos-chave
O número decisivo é 40%, e é uma afirmação sobre carga de trabalho, não uma etiqueta de preço. Os preços caíram 20% (4/20 dólares) e a leitura de cache caiu 60% (para 0,20 dólar/M). O "40% menos para rodar" vem dos testes da própria Anthropic com cargas típicas — a SonarSource mediu de forma independente literalmente 40% menos tokens de saída na geração Java, enquanto a Artificial Analysis mediu 5,98 dólares por tarefa do índice no esforço máximo.
Primeiro de um ranking independente, a um custo. A Artificial Analysis dá ao Opus 5.5 (esforço máximo) nota 58, nº 1 de 212 modelos, e ao mesmo tempo o coloca em 95º de 212 em verbosidade: cerca de 119 mil tokens de saída por tarefa do índice contra cerca de 27 mil do GPT-6 Astra max.
O problema de comunicação que afundou o Opus 5 parece resolvido. A maior queixa contra o Opus 5 era que o trabalho saía bom e a conversa não. As vozes do primeiro dia descrevem o 5.5 como rápido, natural e menos enrolado, e a SonarSource mediu a proporção de comentários do Java gerado caindo de 10,5% para 3,1%.
Menos código, bugs mais densos. No teste Java da SonarSource (build pré-lançamento): 27,5% menos código e 42% menos problemas com taxa de aprovação estável, mas a densidade de bugs por milhão de linhas subiu de 576 para 644, com bugs de concorrência subindo 44%. A revisão continua obrigatória.
A leitura da METR: incremental, não um salto. A avaliação pré-implantação encontrou ganhos incrementais sobre o Fable 5.1 em cinco tarefas de P&D de IA, com fraquezas de julgamento (previsão, loops de feedback, faro de pesquisa) ainda abertas. Compre o 5.5 pela economia e pelo acabamento; escale para o Fable quando bater no teto dele.
O que o Claude Opus 5.5 realmente é
O Claude Opus 5.5 é o primeiro modelo da nova família Claude 5.5 da Anthropic, lançado em 22 de setembro de 2026. O ID do modelo é claude-opus-5-5; a página de lançamento lista disponibilidade na Anthropic Claude Platform, AWS, Google Cloud e Microsoft Azure. O envelope documentado: contexto de 1 milhão de tokens, até 128 mil de saída, adaptive thinking e medium como esforço padrão — esse último detalhe importa mais do que qualquer linha de benchmark nesta análise.
| Pergunta | Fotografia publicada (verificada em 2026-09-23) | O que não prova |
|---|---|---|
| Lançamento e ID | 2026-09-22; claude-opus-5-5 | Que todo cliente exponha o mesmo build e a mesma faixa de esforço |
| Preço entrada / saída | 4 / 20 dólares por milhão de tokens | Seu custo por tarefa após raciocínio e tentativas |
| Cache leitura / escrita | 0,20 / 5 dólares por milhão (Opus 5: 0,50 / 6,25) | Uma economia universal de 40% em toda carga |
| Contexto e saída | 1 milhão de entrada, até 128 mil de saída | Que todo provedor ou plano exponha a janela completa |
| Esforço | adaptive thinking; medium padrão | Que esforços menores mantenham as mesmas notas (curva não publicada por tarefa) |
| Disponibilidade | Anthropic, AWS, Google Cloud, Azure | Planos de consumo; não verificado aqui |
| Fotografia independente | Artificial Analysis: 58, nº 1/212 (esforço máximo) | Velocidade: a AA marca latência N/A para este modelo |
A Anthropic também emoldura o lançamento proceduralmente: é a primeira entrega desde que a empresa "called for pacing the frontier", testada antes do lançamento por avaliadores externos, incluindo Frontier Design e METR. Na auditoria comportamental automatizada da Anthropic — perto de 2.000 cenários — o Opus 5.5 é "the strongest-performing model we've tested to date", e uma avaliação de fronteira de contenção mostrou cerca de 85% menos tentativas de burla do que o Opus 5 ou o Mythos 5.1. São afirmações de segurança que merecem registro, e cortam nos dois sentidos: uma seção adiante mostra como intervenções de salvaguarda também viram zeros em benchmarks de capacidade.
A pergunta que esta análise responde não é "é inteligente" — a tabela do fabricante e um nº 1 independente já dizem que sim. É se um modelo precificado como cavalo de batalha e vendido como nau capitânea pertence ao seu fluxo diário — versus manter as tarifas do Opus 5, pagar os preços do Fable 5.1, ou mover trabalho mecânico para modelos mais baratos como GPT-5.6 Sol ou MiMo-V2.6-Pro.
O número que decide esta análise: 40%
A frase de apresentação da Anthropic, verificada na página, merece leitura literal: o Opus 5.5 "performs at the level of Claude Fable 5.1 on most work and costs 40% less to run than Opus 5". Duas afirmações verificáveis numa linha — capacidade quase de nau capitânea, economia de cavalo de batalha.
A parte do preço é pública e simples: a entrada caiu de 5 para 4 dólares, a saída de 25 para 20, a leitura de cache de 0,50 para 0,20 dólar por milhão. O cache pesa mais no trabalho agêntico porque uma execução de 40 chamadas de ferramenta relê 40 vezes o prefixo em cache; a 0,20 dólar — 5% do preço de entrada, o desconto de cache de 95% que a Artificial Analysis lista — as sessões longas ficam estruturalmente mais baratas. É a mesma alavanca que fez do corte de cache do Fable 5.1 a história do lançamento dele, agora empurrada mais para baixo.
A parte dos 40% é onde mora a letra miúda, e três medições independentes a cercam:
Recolhida: a execução Java da SonarSource (build pré-lançamento, esforço High) usou 12,96 milhões de tokens de saída contra 21,71 milhões do Opus 5 — uma redução literal de 40% — com taxa de aprovação a menos de um ponto (87,68% contra 88,6%). Menos código, menos tokens, mesmo resultado funcional. É o desconto funcionando como desenhado.
Gasta: a Artificial Analysis rodou o Índice de Inteligência no esforço máximo e mediu cerca de 119.000 tokens de saída por tarefa — contra cerca de 73 mil do Opus 5 max, 78 mil do Fable 5.1 max e 27 mil do GPT-6 Astra max — pousando em 5,98 dólares por tarefa ponderada e um 95º lugar em verbosidade entre 212. É o desconto sendo gasto quando se deixa o modelo pensar em voz alta no volume máximo.
No meio: a análise interna de M&A da Anthropic terminou em 63 minutos contra 93 do Opus 5 com "50% less to run" — teste do fabricante, exatamente na promessa.
A reconciliação não é contradição; é o dial de esforço. Medium é o padrão por um motivo: o desconto de 40% é real, e recolhê-lo depende sobretudo de qual nível de esforço o seu fluxo usa por reflexo. A leitura de capacidade da METR apoia a mesma conclusão pelo outro lado — o modelo é um passo incremental sobre o Fable 5.1, então o motivo para migrar é economia e acabamento, não teto novo. Se o seu pipeline fixa max porque "melhor modelo, esforço máximo", você já se reprecificou de volta ao território capitâneo.
O que aconteceu em trabalho real, antes do ranking
A evidência mais útil do primeiro dia não é uma linha de benchmark. São três histórias de construção, com nomes e limites declarados.
Um filme de 45 minutos numa tacada só. O u/mshort3 deu ao Claude Code uma única frase — "Lets make a ~70s riso film of your own choosing, free range" — dentro de um projeto criativo existente, e relata que o Opus 5.5 produziu uma viagem de trem animada de 78 segundos numa única execução de cerca de 45 minutos (r/ClaudeAI, 637 upvotes). O repositório é público, e o autor credita as skills e a documentação do próprio projeto, não só o modelo. Uma execução; sem registros dos estados intermediários.
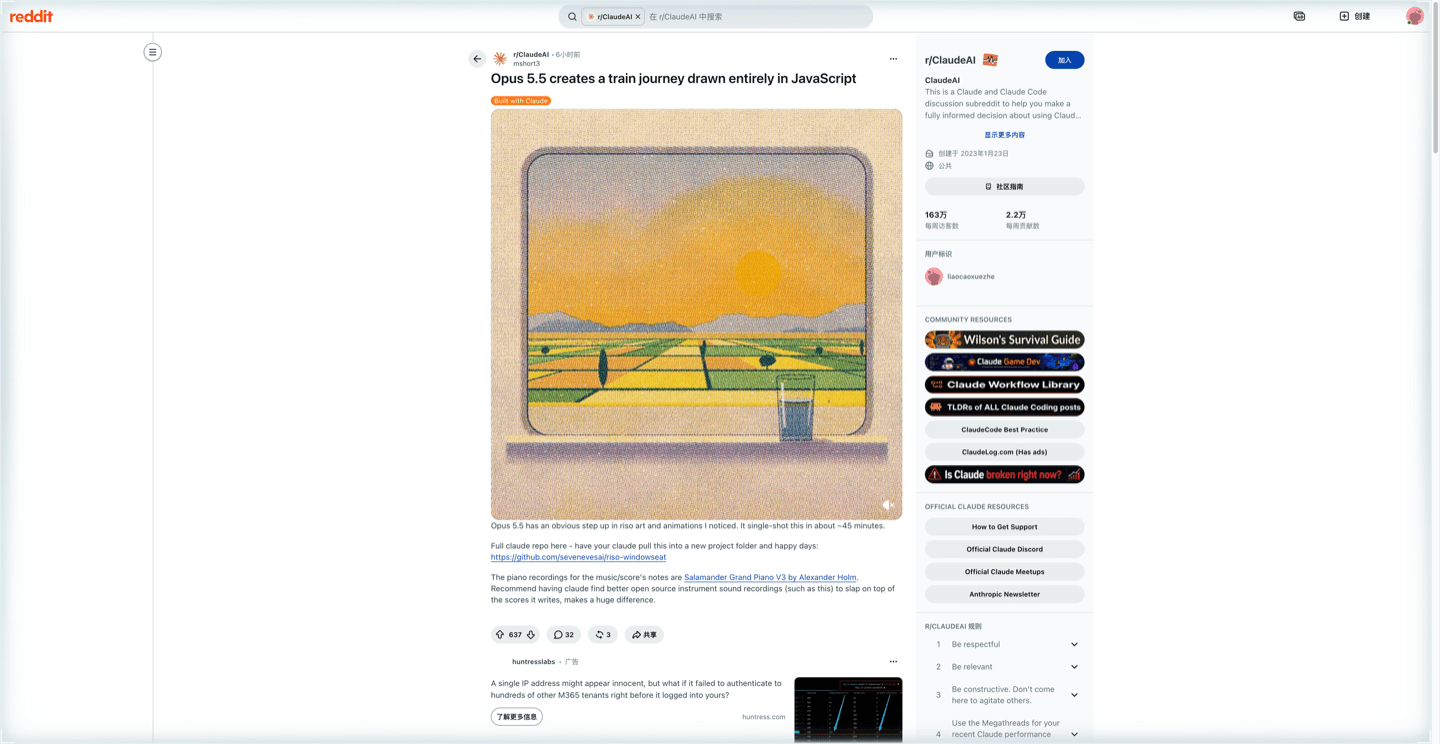
Thread original: r/ClaudeAI 1wnkvys.
Um vídeo de um minuto com um prompt — com recibo de custo. O u/AzorAhai1TK pediu "an average day at work… with a twist" renderizado como um vídeo assustador de um minuto, e relata que o modelo codificou e renderizou de ponta a ponta no esforço Extra-High em cerca de 45 minutos, usando cerca de 4% da cota semanal de um plano de 20 dólares/mês (r/ClaudeAI). Números auto-relatados, mas o dado de cota é exatamente o que um debate de preço precisa: execuções criativas no esforço máximo não são grátis, nem catastróficas.
Velocidade "night and day" no Claude Code — com a ressalva anexada pelo próprio autor. O u/Lazy_Assistance_1137 relata que bugs de interface que "used to take a while to track down" são localizados "in no time", e chama o salto de "night and day" — para em seguida se alertar: "this could just be the classic day-one honeymoon phase, and in two weeks we'll all be back to posting 'did they nerf it?' threads" (r/ClaudeAI, 273 upvotes). A resposta mais votada tem uma palavra de profundidade: "It's crazy fast. I'm impressed." (u/capivara_de_pijama, 96 upvotes).
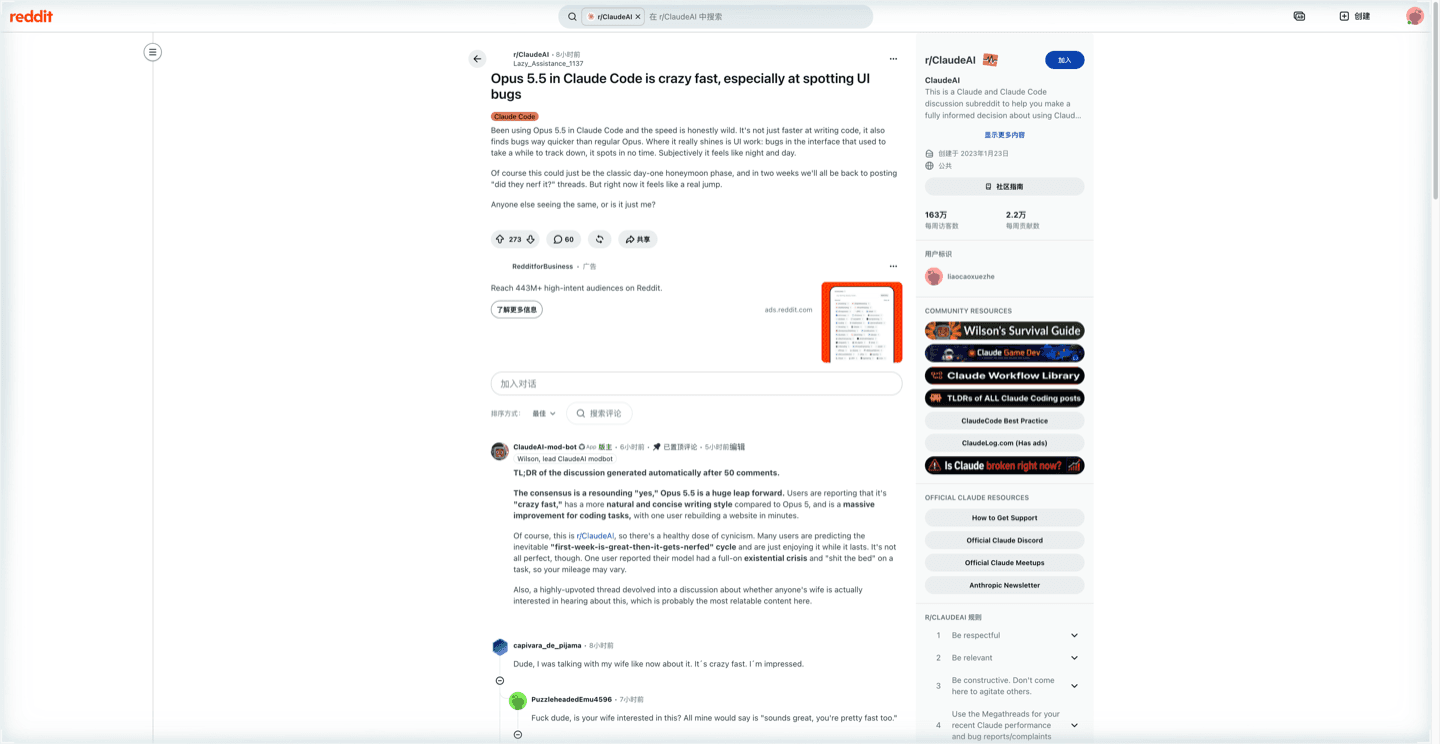
Thread original: r/ClaudeAI 1wnil7n.
Três histórias, n=1 cada, sem registros, sem contagens de tokens (exceto os 4% relatados). O que estabelecem: no primeiro dia, o modelo completa construções criativas longas, autodirigidas e multi-ferramenta, repetidamente, em público, com artefatos que você pode abrir. O que não estabelecem: com que frequência. Essa é a lacuna que benchmarks deveriam preencher — vejamos quanto preenchem de verdade.
Os benchmarks, e quanto confiar neles
Tabela de lançamento da Anthropic, registrada como publicada em 2026-09-22. Colunas diferentes podem vir de operadores e rankings diferentes (as cifras de GPT-6 Astra e GPT-5.6 Sol são identificadas pela Anthropic como vindas de relatórios da OpenAI), então leia linhas, não aritmética entre colunas:
| Domínio / benchmark | Opus 5.5 | Fable 5.1 | Opus 5 | GPT-6 Astra | GPT-5.6 Sol |
|---|---|---|---|---|---|
| Código agêntico: Terminal-Bench 4.0 | 66,4% | 55,8% | 52,3% | 57,9% | 37,3% |
| Código agêntico: FrontierCode v1.1 | 54,4% | 50,3% | 48,0% | 53,3% | 47,5% |
| Código agêntico: CursorBench 4.0 | 57,8% | 51,8% | 46,6% | — | 41,7% |
| Trabalho de conhecimento: GDPval-AA v2.1 | 1846 | 1735 | 1708 | 1542 | 1588 |
| Fluxos de negócio: AutomationBench | 40,0% | 31,4% | 26,9% | 41,4% | 28,8% |
| Raciocínio: Humanity's Last Exam (com ferramentas) | 67,7% | 65,6% | 63,6% | 57,2% | — |
| Ciência agêntica: Terminal-Bench-Science 0.1 | 58,7% | 52,6% | 29,0% | 64,6% | 22,4% |
| Uso de computador: OSWorld 2.0 (parcial) | 81,8% | 80,7% | 74,0% | — | — |
| Reconhecimento de gráficos: Chartography (com ferramentas) | 89,0% | 88,4% | 83,4% | — | — |
Agora a água fria, em três partes.
As margens de erro são publicadas, e são largas. O Terminal-Bench 4.0 carrega erro padrão de ±2,6 pontos para o Opus 5.5; o Terminal-Bench-Science, de ±3,5–5 pontos por modelo. O salto Opus 5 → Opus 5.5 no TB-Science (29,0% → 58,7%) sobrevive a qualquer barra de erro; a distância para o GPT-6 Astra (64,6%) na mesma linha também — em favor do Astra. A própria Anthropic avisa na página que, nos níveis atuais de capacidade, diferenças de pontuação podem não representar com confiabilidade as distâncias do mundo real. Essa frase, dita pelo fabricante, é a linha mais honesta de qualquer tabela de lançamento nesta temporada.
As condições de comparação não são uniformes. As linhas do Terminal-Bench usam o arnês Claude Code; o AutomationBench foi executado e reportado pela Zapier, sem modelos de fallback, então intervenções de segurança contavam como falhas; o processo de pontuação independente do GDPval-AA v2.1 não é detalhado na página. Uma intervenção de salvaguarda pode zerar uma tarefa — um resultado de política registrado como falha de capacidade. Nada disso torna a tabela errada; torna-a um conjunto de fotografias em condições variadas, não uma corrida controlada.
O registro independente concorda na forma, não nas margens. O índice da própria Artificial Analysis (v4.3.2, dez avaliações) dá 58 ao Opus 5.5 max, nº 1 de 212, liderando seis avaliações isoladas (Humanity's Last Exam 61,4%, SciCode 66,9%, GDPval-AA 1846, AA-Briefcase 1822 — 143 Elo acima do Fable 5.1) e empatando com o GPT-6 Astra xhigh no Terminal-Bench 4.0 a 59,6%. O teste Java controlado da SonarSource é o dado mais afiado: taxa de aprovação a um ponto do Opus 5 gerando 27,5% menos código — com densidade de bugs por linha subindo, coberto abaixo. A avaliação pré-implantação da METR, dez dias úteis em cinco tarefas de P&D de IA, conclui que o ganho sobre o Fable 5.1 é "incremental… rather than a discontinuous leap", sem progresso maior em previsão, construção de loops de feedback ou faro de pesquisa.
O que sobrevive ao banho: o salto sobre o Opus 5 é real e grande (TB-Science 29,0% → 58,7% não é truque de arredondamento); o nº 1 independente tem segunda fonte; a história de custo tem uma replicação totalmente independente (as contagens de tokens da SonarSource). O que não sobrevive: qualquer alegação de que o Opus 5.5 "bate com folga" o GPT-6 Astra — na tabela da Anthropic, o Opus 5.5 lidera o Terminal-Bench 4.0 e o Astra lidera o Terminal-Bench-Science; no TB-4.0 independente da Artificial Analysis, os dois empatam em 59,6%; nossa análise do GPT-6 Astra cobre os trade-offs dele.
Onde o Opus 5.5 é genuinamente bom
Ele finalmente conversa como um colega
A força que nenhuma linha captura: o Opus 5 era um modelo de código forte que as pessoas odiavam conversar, e as vozes do dia um dizem que o 5.5 conserta a conversa em si. Os comentários de topo da thread-âncora são a autópsia dessa dor — "Opus is fantastic, just until you have to talk to it" (u/Neon_Camouflage, 61 upvotes) — pareados com alívio: "Heard Opus 5.5 is less verbose" (u/No-Temperature6597). O analisador da SonarSource põe número na mudança de comportamento: a proporção de comentários do Java gerado caiu de 10,5% para 3,1% das linhas, com densidade de code smells 21% abaixo. E o teste de vibe do filósofo formado (esforço medium, anônimo) o descreve como "a model with polish and panache… It will happily cite back Theophrastus and Austin to you, but can't break the habit of wanting to get its hands dirty" (u/Wickywire). Se você escreve ou planeja para viver — não só compila — essa é a melhoria que importa mais do que qualquer nota de código.
Perseverança agêntica, a preço Opus
Aqui está o centro de gravidade da tabela oficial, e ele se sustenta: 66,4% no Terminal-Bench 4.0 e 58,7% no TB-Science (ambos dentro das bandas de erro publicadas) com o arnês Claude Code; 57,8% no CursorBench 4.0; OSWorld 2.0 a 81,8% parcial para uso de computador. Os exemplos internos são incomumente concretos para evidência de fabricante: numa tarefa de resultados trimestrais, 16 de 18 relatórios passaram por um avaliador que checava cada cifra e citação e reprovou as tentativas do Fable 5.1 e do Opus 5; numa análise de M&A fictícia, 63 minutos contra 93 do Opus 5, pela metade do custo. Teste do fabricante, mas exatamente o formato de trabalho — longo, multi-arquivo, pesado em verificação — que as cifras de terminal medem. Para cargas de pesquisa agêntica e trabalho profundo, esse perfil a 4/20 dólares é o argumento mais forte do lançamento.
A economia do esforço medium é a manchete silenciosa
O medium padrão somado à leitura de cache a 0,20 dólar muda a economia unitária das sessões longas de um jeito que os preços de capa não mostram. A Artificial Analysis colocou quatro dos cinco níveis de esforço na fronteira de Pareto inteligência-custo — a exceção é o nível que ninguém deveria escolher por reflexo — e os 5,98 dólares por tarefa pertencem ao max, não ao medium. O teste de pipeline da CodeRabbit achou que a configuração Standard (esforço menor) venceu a própria configuração Max no conjunto de 80 padrões, com melhor precisão acionável e menos comentários, com o Max à frente só nos 13 casos Signal mais difíceis. O padrão nas três fontes independentes é consistente: a função de valor deste modelo recompensa seleção deliberada de esforço e pune o reflexo. Para times pagando tarifas do Opus 5 — ou do Opus 4.8 legado — a migração é quase tudo lucro.
Onde ele morde
O esforço máximo queima o desconto
O mesmo dial que barateia o medium encarece o max: cerca de 119 mil tokens de saída por tarefa do índice da AA (4,4× o GPT-6 Astra max, 1,6× o Fable 5.1 max), 5,98 dólares por tarefa ponderada, verbosidade 95ª/212, 260 milhões de tokens acumulados na avaliação inteira. A CodeRabbit viu a mesma forma em trabalho com cara de produção: uso de tokens +49–60% contra a própria linha de base, com o Max somando 57,6% (conjunto OSS) a 60,1% (Signal) por precisão que muitas vezes não era necessária. Se o seu arnês ou hábito fixa max, orce dinheiro de nau capitânea e veja também a análise do Gemini 3.8 Flash como contraste deliberadamente frugal — e o MiMo-V2.6-Pro pelo menor custo medido por tarefa da safra recente.
Menos código, bugs mais densos
Os números da SonarSource merecem a moldura desconfortável: o total de problemas caiu 42%, mas a densidade de bugs por milhão de linhas subiu de 576 para 644, e os bugs de concorrência — a classe que aparece em produção, não em revisão — subiram 44% e viraram a maior categoria (295/mLOC). As três densidades de severidade BLOCKER caíram, o que tranquiliza de verdade, mas a forma é clara: o 5.5 escreve código mais enxuto que não é uniformemente mais seguro. Dois limites: a execução usou build pré-lançamento (a SonarSource repetirá na disponibilidade geral), e o achado paralelo da CodeRabbit — 11 padrões novos achados, 9 padrões da linha de base perdidos no conjunto OSS — diz a mesma coisa pelo lado da revisão. Mantenha a revisão; mova-a para mais cedo no pipeline, não a apague.
Incremental sobre o Fable, e o desconhecido que continua desconhecido
A avaliação da METR é a leitura independente menos lisonjeira, e merece duas passadas: ganhos sobre o Fable 5.1 nas cinco tarefas de P&D de IA, nenhuma evidência de automação completa, e nenhum progresso maior nas capacidades com cara de julgamento — previsão, predição, construir loops de feedback, faro de pesquisa. Some o genuinamente desconhecido: não existe latência verificada (a Artificial Analysis lista a velocidade como N/A para este modelo, então esta análise não cita nenhum tempo até o primeiro token); a disponibilidade em planos de consumo não foi verificada; e execuções sob salvaguardas podem zerar tarefas, o que significa que as configurações de segurança do seu arnês fazem parte da sua capacidade medida. Um modelo com um dia de vida chega com tudo isso pendurado. Nada disso desqualifica; tudo defende um piloto medido em vez de uma virada de frota inteira.
O que as pessoas realmente disseram
A conversa do dia um se parte em dois eixos, não um.
Eixo um: finalmente rápido — e finalmente dá para conversar. A thread de velocidade e suas respostas são deleite inequívoco; a entrevista filosófica é a versão qualitativa da mesma coisa, descrevendo acabamento e vontade de sujar as mãos. Quem reconstrói fluxos em volta resume a base: gente que gostava do resultado do Opus 5 e odiava a conversa.
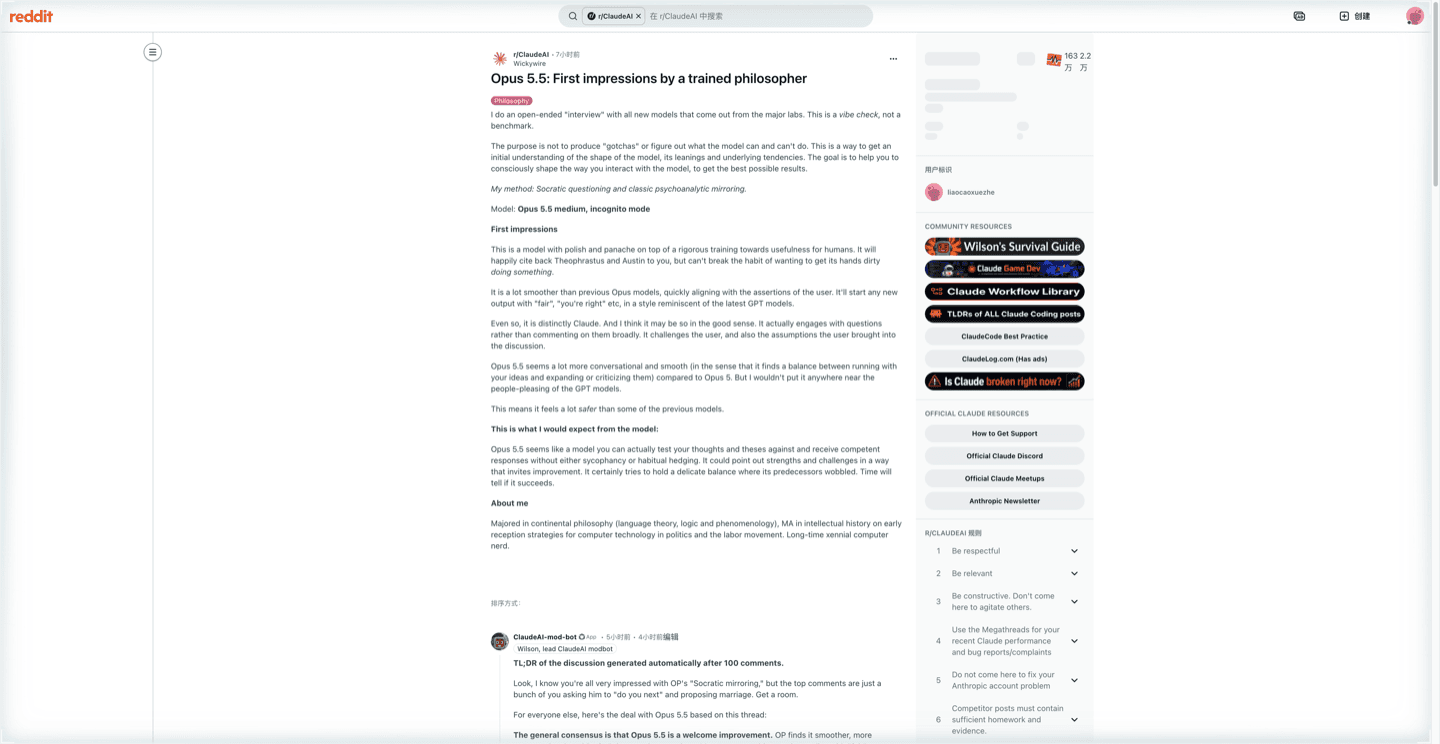
Thread original: r/ClaudeAI 1wnkgie.
Eixo dois: confiar, mas verificar — o tecido cicatricial do Opus 5. O ceticismo da thread-âncora é específico: as pessoas foram queimadas por um modelo que benchmarkava bem e comunicava mal, e não aceitam números do dia de lançamento como encerramento. Um comentarista lê a intenção de design com caridade — "Fable 5 & Opus 5 were designed & tested together with the intent being that you talk to Fable and it delegates execution to Opus agents" (u/canyonero7) — o que levanta a pergunta real sobre o 5.5: precificado como modelo de execução, vendido como modelo de conversa, e os dois papéis num modelo só é exatamente o que a euforia do dia um não consegue confirmar.
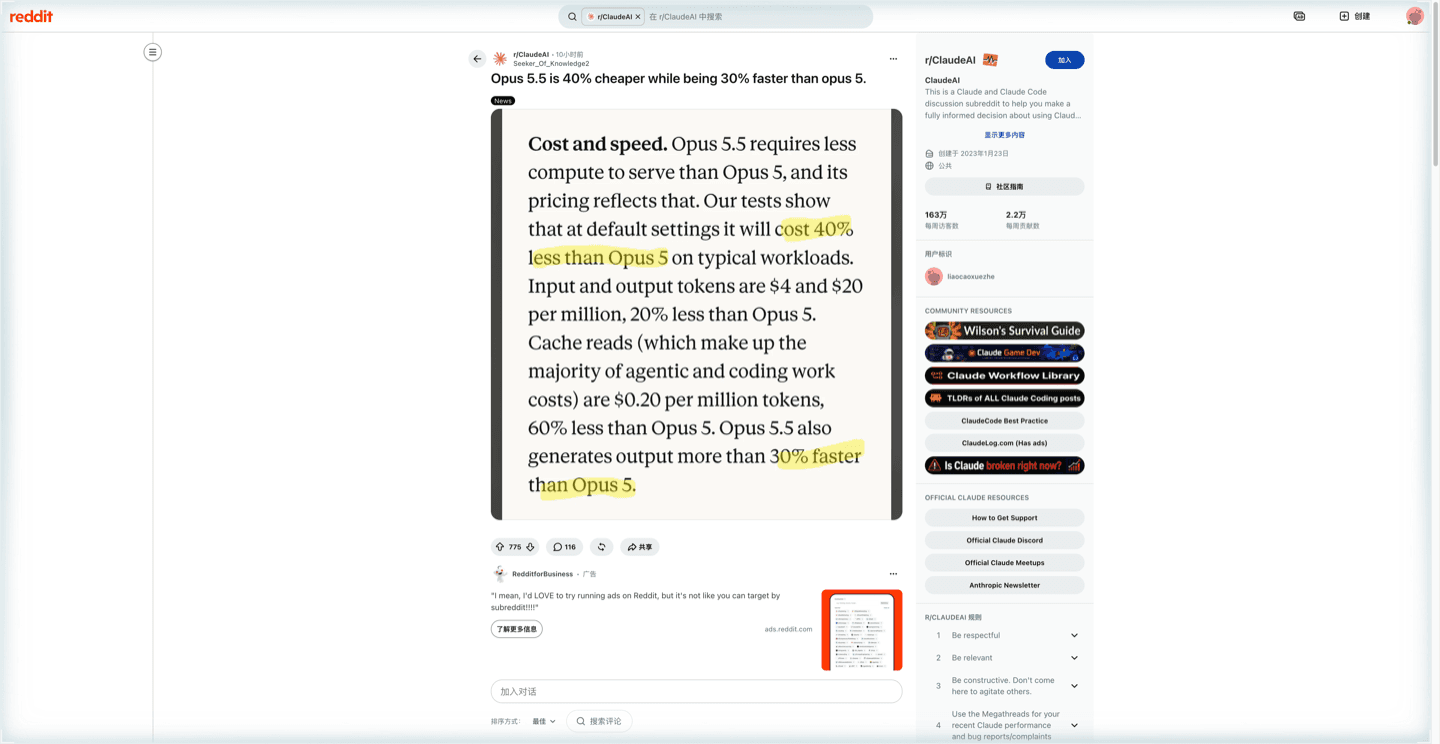
Thread original: r/ClaudeAI 1wnf7sb.
Onde esta análise pousa: com os entusiasmados na decisão de migrar — a economia é unilateral demais para deixar trabalho novo no Opus 5 — e com os cépticos no processo. O autor da lua de mel está certo em que duas semanas de logs dirão mais do que qualquer tabela acima; e está certo em que, agora, parece um salto real.
O veredito: migre seu trabalho Opus, mantenha a disciplina
| Formato da carga | Veredito | Por quê | Ressalva principal |
|---|---|---|---|
| Trabalho padrão de código agêntico hoje no Opus 5 ou 4.8 | Migrar agora | Preços 20% menores, cache 60% mais barato, conversa consertada, TB-Science 29,0% → 58,7% | Fixe o ID do modelo; recubra medições quando as re-execuções GA chegarem |
| Fronteira mais difícil e pesquisa de longo prazo | Escalar para o Fable 5.1 | METR: incremental; o próprio pitch oficial é "nível Fable na maior parte do trabalho" | Os custos e manhas do Fable são outra decisão |
| Execuções longas sem supervisão, pipelines em lote | Bom candidato no medium | Leitura de cache a 0,20 dólar + medium padrão; fronteira de Pareto da AA em 4 de 5 níveis | Sem latência verificada — meça o primeiro token antes de apostar SLAs |
| Produtos de chat interativos | Meça antes | Latência desconhecida; a verbosidade no esforço alto (95ª/212) bate direto na experiência e na fatura | AA marca velocidade N/A; nenhuma cifra citada aqui |
| Java ou geração massiva de código sem revisão | Use, com a revisão antecipada | Taxa estável, saída mais enxuta, densidades BLOCKER caindo | Densidade de bugs 576 → 644/mLOC; concorrência +44% |
| Automação com piso de custo | Compare modelos mais baratos | 4/20 dólares é barato para a classe Opus, não em termos absolutos | MiMo a 0,13 dólar/tarefa ou Gemini 3.8 Flash podem servir melhor no mecânico |
Duas notas sensíveis ao tempo. Primeira: todos os números independentes deste artigo são fotografias do dia um — a SonarSource testou um build pré-lançamento e repetirá na disponibilidade geral; os rankings da Artificial Analysis se movem diariamente. Segunda: a escada da família continua se preenchendo — Sonnet 5 e Haiku 4.5 estão abaixo deste lançamento, e a expressão "Claude 5.5 family" da Anthropic anuncia mais membros. Planeje o roteamento de modelos com um alfinete, não com um hábito.
Um caminho prático: rode-o onde o trabalho acontece
Tudo acima aponta para um padrão: a economia recompensa execuções longas, multi-ferramenta, com esforço deliberado; o modo de falha é volume sem supervisão; e as perguntas abertas — latência, disponibilidade no seletor, estabilidade após semanas — só se respondem rodando uma tarefa delimitada, não lendo mais uma tabela. É um trabalho com cara de navegador: pesquisa multi-página, extração e automação onde um navegador agêntico segura as páginas e o contexto da sessão enquanto o modelo trabalha, com o Tabbit Browser construído exatamente em volta desse ciclo.
A fronteira honesta, como nas nossas outras análises de modelos: esta análise não verificou se o Opus 5.5 aparece no seletor de modelos do Tabbit Browser, e nenhuma execução prática é reivindicada. Confira o seletor da sua conta, fixe o ID do modelo, dê a ele uma tarefa reversível — uma mudança multi-arquivo com um teste existente, ou um pacote de pesquisa com citações obrigatórias — e registre o custo por resultado aceito contra o Opus 5 antes de migrar qualquer coisa que importe.
 Tabbit Browser
Fontes
Anthropic: Introducing Claude Opus 5.5 — fatos de lançamento, preços, tabela de benchmarks, seção de segurança (aberta em 2026-09-23)
Artificial Analysis: Claude Opus 5.5 e artigo de lançamento — índice 58 (nº 1/212), 5,98 dólares/tarefa, medições de verbosidade
METR: Predeployment evaluation of Claude Opus 5.5 — leitura "incremental sobre o Fable"
SonarSource: Evaluating Claude Opus 5.5 on Java code generation — taxa de aprovação, tokens e densidade de bugs (build pré-lançamento)
CodeRabbit: Opus 5.5 model review — trade-offs de recall/precisão e tokens
Threads do Reddit: 1wnf7sb, 1wnil7n, 1wnkgie, 1wnkvys, 1wnh4fn

Perguntas frequentes
Vale a pena usar o Claude Opus 5.5?
Sim como seu modelo padrão da classe Opus. Ele mira nível Fable 5.1 na maior parte do trabalho a 4 dólares por milhão de tokens de entrada e 20 de saída, 20% abaixo do Opus 5, com leitura de cache a 0,20 dólares. Guarde o Fable 5.1 para as tarefas de fronteira mais difíceis e evite ligar o esforço máximo por reflexo: a verbosidade medida nesse nível pode consumir a economia.
O Claude Opus 5.5 é mais barato que o Opus 5?
Os preços de tabela caem 20% na entrada (4 dólares contra 5) e na saída (20 contra 25), e a leitura de cache cai de 0,50 para 0,20 dólares por milhão de tokens. A Anthropic afirma cerca de 40% menos custo total em cargas típicas com base em testes próprios. A economia real depende do nível de esforço e da mistura de tokens, então meça uma tarefa representativa.
O Opus 5.5 é melhor que o Fable 5.1?
A própria Anthropic diz que o Opus 5.5 performa no nível do Fable 5.1 na maior parte do trabalho, custando menos para rodar. As verificações independentes matizam: a METR considera o ganho em P&D de IA incremental sobre o Fable 5.1, enquanto a Artificial Analysis dá ao Opus 5.5 nota 58, o primeiro de sua fotografia de 212 modelos. Leia como quase-paridade por custo menor, não vitória clara.
O Claude Opus 5.5 é bom para programar?
A página de lançamento reporta 66,4% no Terminal-Bench 4.0 com erro padrão de cerca de 2,6 pontos e 57,8% no CursorBench 4.0. O teste Java da SonarSource encontrou taxa de aprovação parecida com a do Opus 5 (87,68% contra 88,6%) com menos código mas densidade de bugs maior, então mantenha a revisão de código em vez de confiar às cegas.
Por que o Claude Opus 5.5 usa tantos tokens?
No esforço máximo, a Artificial Analysis mediu cerca de 119.000 tokens de saída por tarefa do Índice de Inteligência, mais de quatro vezes os ~27.000 do GPT-6 Astra, colocando o Opus 5.5 em 95º entre 212 em verbosidade. O esforço padrão é medium, e a SonarSource mediu 40% menos tokens de saída que o Opus 5 na geração Java, então o consumo depende do esforço e da carga.
Quando o Claude Opus 5.5 foi lançado e onde está disponível?
A Anthropic lançou em 22 de setembro de 2026, com ID de modelo claude-opus-5-5, contexto de 1 milhão de tokens e até 128 mil de saída. A página de lançamento lista Anthropic Claude Platform, AWS, Google Cloud e Microsoft Azure. A disponibilidade em planos de consumo não foi verificada nesta análise.
Posso usar o Claude Opus 5.5 no Tabbit Browser?
Esta análise não verificou se o Opus 5.5 aparece no seletor de modelos do Tabbit, então não planeje com base nisso. Confira o seletor da sua conta e rode uma tarefa reversível antes de entregar um fluxo de trabalho a ele.