
Claude Opus 5.5 est la décision Opus la plus facile depuis longtemps : basculez votre travail Opus par défaut dessus. Anthropic l'a publié le 22 septembre 2026 à 4 USD par million de tokens d'entrée et 20 en sortie — 20 % sous Opus 5 — en le présentant comme performant « at the level of Claude Fable 5.1 on most work » pour un coût d'exécution « 40% less… than Opus 5 ». Le registre indépendant du lendemain soutient dans l'ensemble cette présentation, avec deux réserves : à l'effort maximal, le modèle parle assez pour manger la remise ; et de près, le gain de capacité sur Fable 5.1 est incrémental, pas un nouveau plafond.
Ce cadrage n'est pas du marketing dans le vide. Quelques heures après la sortie, le fil le plus voté de r/ClaudeAI s'intitulait « Opus 5.5 is 40% cheaper while being 30% faster than opus 5 » — 775 upvotes de la communauté réénonçant les chiffres officiels en argument d'achat. Le commentaire le mieux voté du même fil explique l'intensité de la réaction : Opus 5 « couldn't even communicate properly », et les gens ont fini par « wasting even more time and tokens » à se battre avec lui (u/Front_Raspberry_6488, 226 upvotes). Ce test trie ce que ces sentiments survivent à l'épreuve des preuves.
Tous les faits ci-dessous ont été ouverts et vérifiés le 23 septembre 2026, au lendemain de la sortie : la page Anthropic, la page Artificial Analysis et les fils Reddit d'origine. La ressource modèle Claude Opus 5.5 (English) porte la bibliothèque de prompts et de preuves ; ses fiches de test (English) sont le registre au niveau source derrière cet article. Il n'existe pas encore de page pricing ni d'alternatives pour Opus 5.5, donc ce test n'en lie aucune. À la fin, je couvre ce que ces résultats signifient pour les flux au niveau navigateur, là où ce type de modèles travaille de plus en plus.
L'essentiel
Le chiffre clé est 40 %, et c'est une affirmation de charge de travail, pas une étiquette de prix. Les prix ont baissé de 20 % (4/20 USD) et les lectures de cache de 60 % (à 0,20 USD/M). Le « 40 % de moins à l'exécution » vient des tests d'Anthropic sur des charges typiques — SonarSource a indépendamment mesuré littéralement 40 % de tokens de sortie en moins en génération Java, tandis qu'Artificial Analysis a mesuré 5,98 USD par tâche d'index à l'effort maximal.
Premier d'un classement indépendant, à un coût. Artificial Analysis note Opus 5.5 (effort max) à 58, no 1 sur 212 modèles, tout en le classant no 95 sur 212 en verbosité : environ 119k tokens de sortie par tâche d'index contre environ 27k pour GPT-6 Astra max.
Le problème de communication qui a coulé Opus 5 semble réparé. La plainte majeure contre Opus 5 : le travail était bon, la conversation impossible. Les voix du premier jour décrivent 5.5 comme rapide, naturel et moins bavard, et SonarSource a mesuré la part de commentaires du Java généré passant de 10,5 % à 3,1 %.
Moins de code, des bugs plus denses. Sur le test Java de SonarSource (build pré-sortie) : 27,5 % de code en moins et 42 % d'anomalies en moins à taux de réussite égal, mais la densité de bugs par million de lignes monte de 576 à 644, dont les bugs de concurrence en hausse de 44 %. La revue de code reste obligatoire.
Le verdict de METR : incrémental, pas un saut. L'évaluation pré-déploiement trouve des gains incrémentaux sur Fable 5.1 sur cinq tâches de R&D d'IA, avec des faiblesses de jugement (anticipation, boucles de retour, goût de recherche) toujours ouvertes. Achetez 5.5 pour l'économie et la finition ; passez à Fable quand vous butez sur son plafond.
Ce qu'est réellement Claude Opus 5.5
Claude Opus 5.5 est le premier modèle de la nouvelle famille Claude 5.5 d'Anthropic, publié le 22 septembre 2026. L'identifiant d'API est claude-opus-5-5 ; la page de lancement liste Anthropic Claude Platform, AWS, Google Cloud et Microsoft Azure. L'enveloppe documentée : contexte de 1M de tokens, jusqu'à 128K en sortie, adaptive thinking, et medium comme effort par défaut — ce dernier détail compte plus que n'importe quelle ligne de benchmark dans ce test.
| Question | Instantané publié (vérifié 2026-09-23) | Ce que ça ne prouve pas |
|---|---|---|
| Sortie et identifiant | 2026-09-22 ; claude-opus-5-5 | Que chaque client expose le même build et la même plage d'efforts |
| Prix entrée / sortie | 4 / 20 USD par million de tokens | Votre coût par tâche après raisonnement et retries |
| Cache lecture / écriture | 0,20 / 5 USD par million (Opus 5 : 0,50 / 6,25) | Une baisse universelle de 40 % sur toute charge |
| Contexte et sortie | 1M en entrée, jusqu'à 128K en sortie | Que chaque fournisseur ou offre expose la fenêtre complète |
| Effort | adaptive thinking ; medium par défaut | Que des efforts plus bas gardent les mêmes scores (courbe non publiée par tâche) |
| Disponibilité | Anthropic, AWS, Google Cloud, Azure | Offres grand public ; non vérifié ici |
| Instantané indépendant | Artificial Analysis : 58, no 1/212 (effort max) | Vitesse : AA marque la latence N/A pour ce modèle |
Anthropic ajoute une note procédurale à la sortie : c'est la première parution depuis que la société a « called for pacing the frontier », testée avant publication par des évaluateurs externes dont Frontier Design et METR. Sur l'audit comportemental automatisé d'Anthropic — près de 2 000 scénarios — Opus 5.5 est « the strongest-performing model we've tested to date », et une évaluation de frontière de confinement montre environ 85 % de tentatives de contournement en moins qu'Opus 5 ou Mythos 5.1. Ce sont des affirmations de sécurité à consigner, et à double tranchant : une section ultérieure montre comment les interventions de garde-fous se transforment aussi en zéros sur des benchmarks de capacité.
La question de ce test n'est pas « est-il intelligent » — un tableau fournisseur et un no 1 indépendant y répondent déjà. C'est de savoir si un modèle tarifé comme un cheval de trait et présenté comme un vaisseau amiral a sa place dans votre flux quotidien — face au maintien des tarifs Opus 5, au paiement du prix de Fable 5.1, ou au déplacement du travail mécanique vers des modèles moins chers comme GPT-5.6 Sol ou MiMo-V2.6-Pro.
Le chiffre qui décide de ce test : 40 %
La phrase de présentation d'Anthropic, vérifiée sur la page, mérite une lecture littérale : Opus 5.5 « performs at the level of Claude Fable 5.1 on most work and costs 40% less to run than Opus 5 ». Deux affirmations vérifiables en une ligne — capacité quasi amirale, économie de cheval de trait.
La partie prix est publique et simple : l'entrée passe de 5 à 4 USD, la sortie de 25 à 20, les lectures de cache de 0,50 à 0,20 USD par million. Le cache pèse le plus sur le travail agentique, car une exécution de 40 appels d'outils relit 40 fois son préfixe mis en cache ; à 0,20 USD — 5 % du prix d'entrée, la remise de cache de 95 % que liste Artificial Analysis — les longues sessions deviennent structurellement moins chères. C'est le même levier qui a fait de la baisse de cache de Fable 5.1 l'histoire de sa sortie, poussé encore plus bas.
La partie 40 % est celle des petites lignes, et trois mesures indépendantes l'encadrent :
Encaissée : la génération Java de SonarSource (build pré-sortie, effort High) a utilisé 12,96M de tokens de sortie contre 21,71M pour Opus 5 — une réduction littérale de 40 % — pour un taux de réussite à moins d'un point (87,68 % contre 88,6 %). Moins de code, moins de tokens, même résultat fonctionnel. Voilà la remise quand elle fonctionne.
Dépensée : Artificial Analysis a exécuté l'index d'intelligence à l'effort maximal et mesuré environ 119 000 tokens de sortie par tâche — contre environ 73k pour Opus 5 max, 78k pour Fable 5.1 max et 27k pour GPT-6 Astra max — aboutissant à 5,98 USD par tâche pondérée et un rang de verbosité no 95 sur 212. Voilà la remise quand on laisse le modèle penser à voix haute au volume maximal.
Entre les deux : l'analyse M&A interne d'Anthropic s'est terminée en 63 minutes contre 93 pour Opus 5 à « 50% less to run » — testé par le fournisseur, pile sur la promesse.
La réconciliation n'est pas une contradiction ; c'est le cadran d'effort. Medium est la valeur par défaut pour une raison : la remise de 40 % est réelle, et l'encaisser dépend surtout du niveau d'effort que votre flux utilise par réflexe. La lecture de capacité de METR soutient la même conclusion par l'autre bout — le modèle est un pas incrémental sur Fable 5.1, donc la raison de basculer est économique et de finition, pas un nouveau plafond. Si votre pipeline verrouille max parce que « meilleur modèle, effort maximal », vous vous êtes re-tarifés en territoire amiral.
Ce qui s'est passé en vrai, avant le classement
La preuve la plus utile du premier jour n'est pas une ligne de benchmark. Ce sont trois histoires de fabrication, nominatives, limites comprises.
Un film en une prise de 45 minutes. u/mshort3 a donné à Claude Code une seule phrase — « Lets make a ~70s riso film of your own choosing, free range » — dans un projet créatif existant, et rapporte qu'Opus 5.5 a produit un voyage en train animé de 78 secondes en une exécution d'environ 45 minutes (r/ClaudeAI, 637 upvotes). Le dépôt est public, et l'auteur crédite les skills et la documentation du projet, pas seulement le modèle. Une exécution ; pas de journal des états intermédiaires.
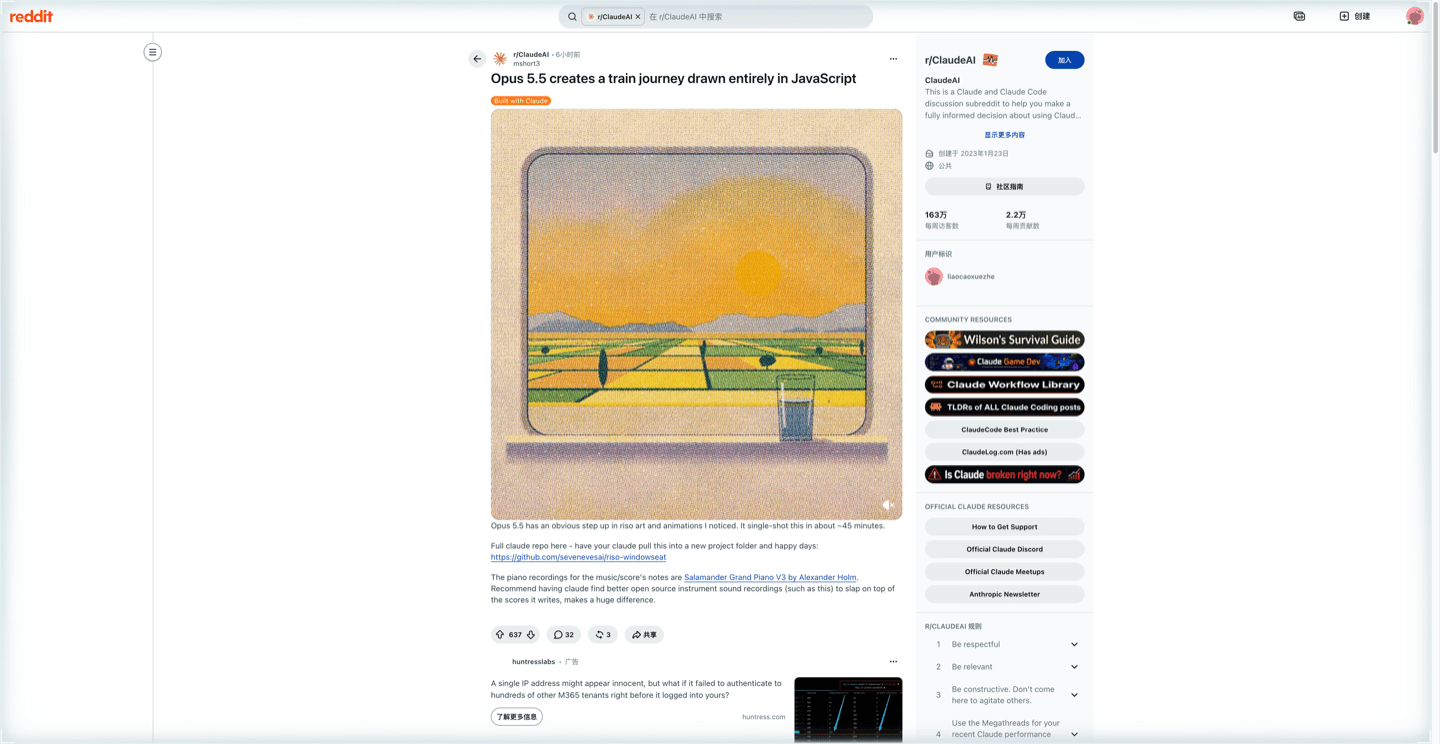
Fil d'origine : r/ClaudeAI 1wnkvys.
Une vidéo d'une minute en un prompt — avec reçu de coût. u/AzorAhai1TK a demandé « an average day at work… with a twist » rendu en vidéo inquiétante d'une minute, et rapporte que le modèle l'a codée et rendue de bout en bout à l'effort Extra-High en environ 45 minutes, consommant environ 4 % de l'allocation hebdomadaire d'une offre à 20 USD/mois (r/ClaudeAI). Chiffres auto-déclarés, mais ce point d'allocation est exactement ce qu'un débat tarifaire réclame : les exécutions créatives à effort maximal ne sont ni gratuites ni catastrophiques.
Une vitesse « night and day » dans Claude Code — avec la réserve apportée par son propre auteur. u/Lazy_Assistance_1137 rapporte que des bugs d'interface qui « used to take a while to track down » sont repérés « in no time », et qualifie le bond de « night and day » — avant d'alerter aussitôt : « this could just be the classic day-one honeymoon phase, and in two weeks we'll all be back to posting 'did they nerf it?' threads » (r/ClaudeAI, 273 upvotes). La réponse la mieux votée a un mot de profondeur : « It's crazy fast. I'm impressed. » (u/capivara_de_pijama, 96 upvotes).
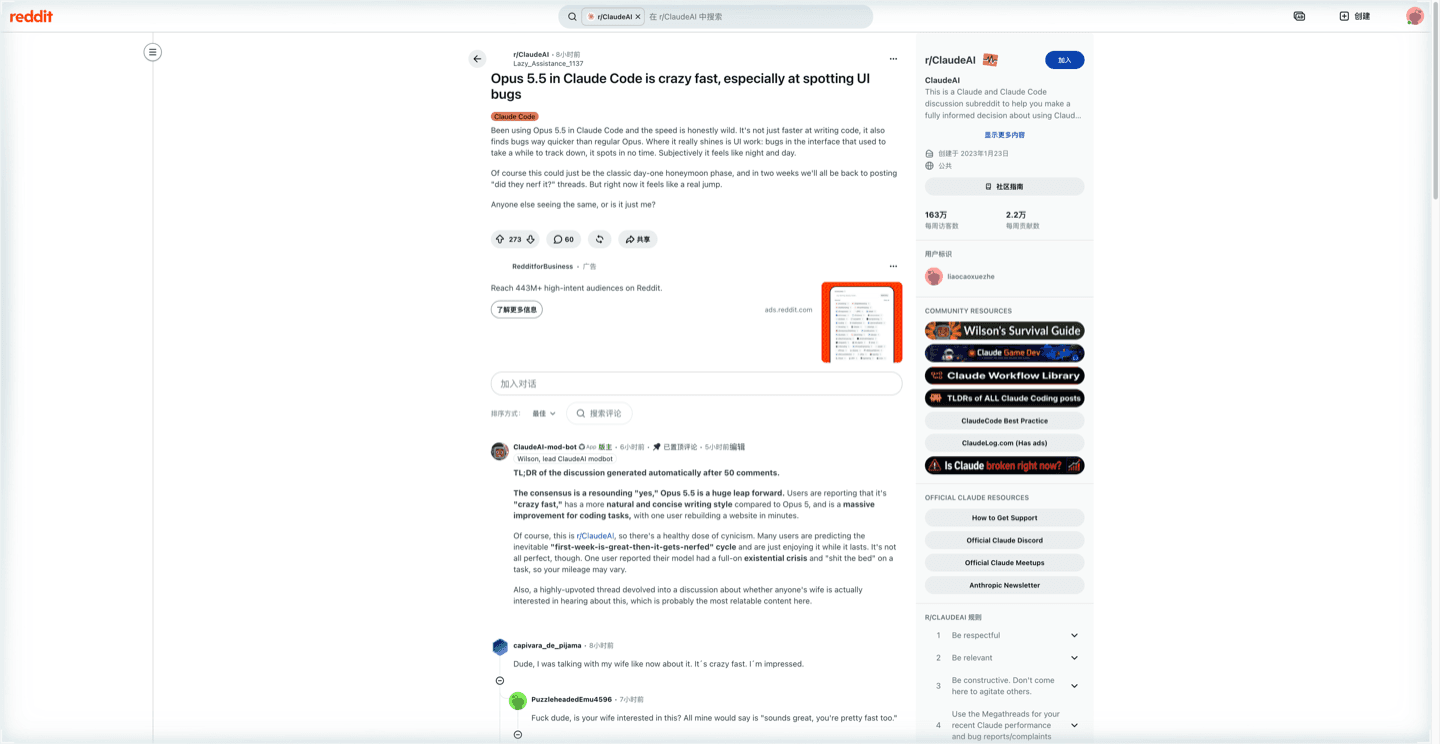
Fil d'origine : r/ClaudeAI 1wnil7n.
Trois histoires, n=1 chacune, sans journaux, sans comptages de tokens (hors les 4 % déclarés). Ce qu'elles établissent : le premier jour, le modèle complète des constructions créatives longues, autonomes et multi-outils, à plusieurs reprises, en public, avec des artefacts ouvrables. Ce qu'elles n'établissent pas : la fréquence. C'est exactement le vide que les benchmarks sont censés combler — voyons combien ils combler.
Les benchmarks, et combien leur faire confiance
Tableau de lancement d'Anthropic, enregistré tel que publié le 2026-09-22. Des colonnes différentes peuvent venir d'opérateurs et de classements différents (les chiffres de GPT-6 Astra et GPT-5.6 Sol sont identifiés par Anthropic comme issus de rapports OpenAI) : lisez en lignes, pas en arithmétique inter-colonnes :
| Domaine / benchmark | Opus 5.5 | Fable 5.1 | Opus 5 | GPT-6 Astra | GPT-5.6 Sol |
|---|---|---|---|---|---|
| Code agentique : Terminal-Bench 4.0 | 66,4 % | 55,8 % | 52,3 % | 57,9 % | 37,3 % |
| Code agentique : FrontierCode v1.1 | 54,4 % | 50,3 % | 48,0 % | 53,3 % | 47,5 % |
| Code agentique : CursorBench 4.0 | 57,8 % | 51,8 % | 46,6 % | — | 41,7 % |
| Travail de connaissance : GDPval-AA v2.1 | 1846 | 1735 | 1708 | 1542 | 1588 |
| Flux métier : AutomationBench | 40,0 % | 31,4 % | 26,9 % | 41,4 % | 28,8 % |
| Raisonnement : Humanity's Last Exam (avec outils) | 67,7 % | 65,6 % | 63,6 % | 57,2 % | — |
| Science agentique : Terminal-Bench-Science 0.1 | 58,7 % | 52,6 % | 29,0 % | 64,6 % | 22,4 % |
| Usage ordinateur : OSWorld 2.0 (partiel) | 81,8 % | 80,7 % | 74,0 % | — | — |
| Reconnaissance de graphiques : Chartography (avec outils) | 89,0 % | 88,4 % | 83,4 % | — | — |
Maintenant l'eau froide, en trois morceaux.
Les marges d'erreur sont publiées, et elles sont larges. Terminal-Bench 4.0 porte une erreur type de ±2,6 points pour Opus 5.5 ; Terminal-Bench-Science, de ±3,5–5 points par modèle. Le bond Opus 5 → Opus 5.5 sur TB-Science (29,0 % → 58,7 %) survit à toute barre d'erreur ; l'écart avec GPT-6 Astra (64,6 %) sur la même ligne aussi — en faveur d'Astra. Anthropic elle-même prévient sur la page qu'aux niveaux de capacité actuels, les écarts de scores peuvent ne pas représenter fidèlement les écarts réels. Cette phrase, venue du fournisseur, est la ligne la plus honnête de tous les tableaux de lancement de la saison.
Les conditions de comparaison ne sont pas uniformes. Les lignes Terminal-Bench utilisent le harnais Claude Code ; AutomationBench a été exécuté et rapporté par Zapier, sans modèles de repli, donc les interventions de sécurité comptaient comme échecs ; le processus de notation indépendant de GDPval-AA v2.1 n'est pas détaillé sur la page. Une intervention de garde-fou peut mettre une tâche à zéro — un résultat de politique enregistré comme échec de capacité. Rien de cela ne rend le tableau faux ; cela en fait un ensemble d'instantanés aux conditions variées, pas une course contrôlée.
Le registre indépendant tombe d'accord sur la forme, pas sur les marges. L'indice propre d'Artificial Analysis (v4.3.2, dix évaluations) donne 58 à Opus 5.5 max, no 1 sur 212, en tête nette sur six évaluations (Humanity's Last Exam 61,4 %, SciCode 66,9 %, GDPval-AA 1846, AA-Briefcase 1822 — 143 Elo au-dessus de Fable 5.1) et à égalité avec GPT-6 Astra xhigh sur Terminal-Bench 4.0 à 59,6 %. Le test Java contrôlé de SonarSource est le point le plus tranchant : taux de réussite à un point d'Opus 5 en générant 27,5 % de code en moins — avec la densité de bugs à la hausse, couverte plus bas. L'évaluation pré-déploiement de METR, dix jours ouvrés sur cinq tâches de R&D d'IA, conclut que le gain sur Fable 5.1 est « incremental… rather than a discontinuous leap », sans progrès majeur sur l'anticipation, la construction de boucles de retour ou le jugement de recherche.
Ce qui survit à la douche : l'écart avant/après sur Opus 5 est réel et massif (TB-Science 29,0 % → 58,7 % n'est pas un tour d'arrondi) ; le no 1 indépendant a une seconde source ; l'histoire de coût a une réplication totalement indépendante (les comptages de tokens de SonarSource). Ce qui ne survit pas : toute affirmation qu'Opus 5.5 « bat nettement » GPT-6 Astra — sur le tableau d'Anthropic, Opus 5.5 mène Terminal-Bench 4.0 et Astra mène Terminal-Bench-Science ; sur le TB-4.0 indépendant d'Artificial Analysis, les deux sont à égalité à 59,6 % ; notre test de GPT-6 Astra couvre ses propres arbitrages.
Là où Opus 5.5 est réellement bon
Il parle enfin comme un collègue
La force qu'aucune ligne de benchmark ne capture : Opus 5 était un modèle de code solide dont les gens détestaient la conversation, et les voix du premier jour disent que 5.5 répare la conversation elle-même. Les commentaires en tête du fil ancre sont l'autopsie de cette douleur — « Opus is fantastic, just until you have to talk to it » (u/Neon_Camouflage, 61 upvotes) — jumelée au soulagement : « Heard Opus 5.5 is less verbose » (u/No-Temperature6597). L'analyseur de SonarSource met un chiffre sur le changement de comportement : la part de commentaires du Java généré tombe de 10,5 % à 3,1 % des lignes, densité de code smells en baisse de 21 %. Et le check de vibes du philosophe formé (effort medium, incognito) le décrit comme « a model with polish and panache… It will happily cite back Theophrastus and Austin to you, but can't break the habit of wanting to get its hands dirty » (u/Wickywire). Si vous écrivez ou planifiez pour vivre — pas seulement compiler — c'est la mise à jour qui compte plus que n'importe quel score de code.
La persévérance agentique, au prix Opus
C'est le centre de gravité du tableau officiel, et il tient : 66,4 % Terminal-Bench 4.0 et 58,7 % TB-Science (tous deux dans leurs bandes d'erreur publiées) avec le harnais Claude Code ; 57,8 % CursorBench 4.0 ; OSWorld 2.0 à 81,8 % partiel pour l'usage ordinateur. Les exemples internes sont inhabituellement concrets pour de la preuve fournisseur : sur une tâche de résultats trimestriels, 16 rapports sur 18 ont passé un correcteur vérifiant chaque chiffre et citation, qui a recalé les tentatives de Fable 5.1 et d'Opus 5 ; sur une analyse M&A fictive, 63 minutes contre 93 pour Opus 5 à moitié coût. Auto-testé, mais exactement la forme de travail — long, multi-fichiers, lourd en vérification — que mesurent les chiffres terminaux. Pour les charges de recherche agentique et de travail profond, ce profil à 4/20 USD est l'argument le plus solide de la sortie.
L'économie de l'effort medium est le titre silencieux
Le medium par défaut plus les lectures de cache à 0,20 USD changent l'économie unitaire des longues sessions d'une façon que les prix en tête d'affiche ne montrent pas. Artificial Analysis a placé quatre des cinq niveaux d'effort sur la frontière de Pareto intelligence-coût — l'exception étant le niveau que personne ne devrait choisir par réflexe — et ses 5,98 USD par tâche appartiennent à max, pas à medium. Le test de pipeline de CodeRabbit a trouvé que la configuration Standard (effort moindre) battait sa propre configuration Max sur l'ensemble de 80 motifs avec une meilleure précision actionnable et moins de commentaires, Max ne creusant l'écart que sur les 13 cas Signal les plus durs. Le motif à travers les trois sources indépendantes est cohérent : la fonction de valeur de ce modèle récompense la sélection délibérée de l'effort et punit le réflexe. Pour les équipes payant encore les tarifs Opus 5 — ou ceux de l'Opus 4.8 héritée — la bascule est presque du gain gratuit.
Là où ça mord
L'effort max brûle la remise
Le même cadran qui rend medium bon marché rend max cher : environ 119k tokens de sortie par tâche d'indice AA (4,4× GPT-6 Astra max, 1,6× Fable 5.1 max), 5,98 USD par tâche pondérée, verbosité no 95/212, 260M de tokens cumulés sur l'évaluation. CodeRabbit a vu la même forme sur du travail à profil de production : usage de tokens +49–60 % contre sa ligne de base, Max ajoutant 57,6 % (ensemble OSS) à 60,1 % (Signal) pour une précision souvent inutile. Si votre harnais ou votre habitude verrouille max, budgétez de l'argent de vaisseau amiral et voyez aussi le test de Gemini 3.8 Flash pour une alternative volontairement frugale — et MiMo-V2.6-Pro pour le coût mesuré par tâche le plus bas de la cohorte récente.
Moins de code, des bugs plus denses
Les chiffres de SonarSource méritent leur cadrage inconfortable : le total d'anomalies baisse de 42 %, mais la densité de bugs par million de lignes monte de 576 à 644, et les bugs de concurrence — la classe qui surgit en production, pas en revue — grimpent de 44 % pour devenir la première catégorie (295/mLOC). Les trois densités de sévérité BLOCKER baissent, ce qui rassure réellement, mais la forme est claire : 5.5 écrit du code plus serré qui n'est pas uniformément plus sûr. Deux limites : l'exécution a utilisé un build pré-sortie (SonarSource refera le test en disponibilité générale), et le constat parallèle de CodeRabbit — 11 nouveaux motifs trouvés, 9 motifs de la ligne de base manqués sur l'ensemble OSS — dit la même chose côté revue. Gardez la revue ; avancez-la dans le pipeline, ne la supprimez pas.
Incrémental sur Fable, et l'inconnu qui reste inconnu
L'évaluation de METR est la lecture indépendante la moins flatteuse, et elle mérite deux passes : des gains sur Fable 5.1 sur les cinq tâches de R&D d'IA, aucune preuve d'automatisation complète, et pas de progrès majeur sur les capacités en forme de jugement — anticipation, prédiction, construction de boucles de retour, goût de recherche. Ajoutez le vraiment inconnu : aucune latence vérifiée n'existe (Artificial Analysis liste la vitesse N/A pour ce modèle, donc ce test ne cite aucun temps jusqu'au premier token), la disponibilité grand public n'est pas vérifiée, et les exécutions sous garde-fous peuvent mettre des tâches à zéro, ce qui signifie que les réglages de sécurité de votre harnais font partie de votre capacité mesurée. Un modèle âgé d'un jour arrive avec tout cela attaché. Rien n'est disqualifiant ; tout plaide pour un pilote mesuré plutôt qu'un basculement de flotte.
Ce que les gens ont réellement dit
La conversation du premier jour se fendille sur deux axes, pas un.
Axe un : enfin rapide — et enfin bavard dans le bon sens. Le fil vitesse et ses réponses sont une joie sans ambiguïté ; l'entretien philosophique en est la version qualitative, décrivant polish et l'envie de se salir les mains. Celui qui reconstruit ses flux autour résume l'électorat : des gens qui aimaient le rendu d'Opus 5 et détestaient la conversation.
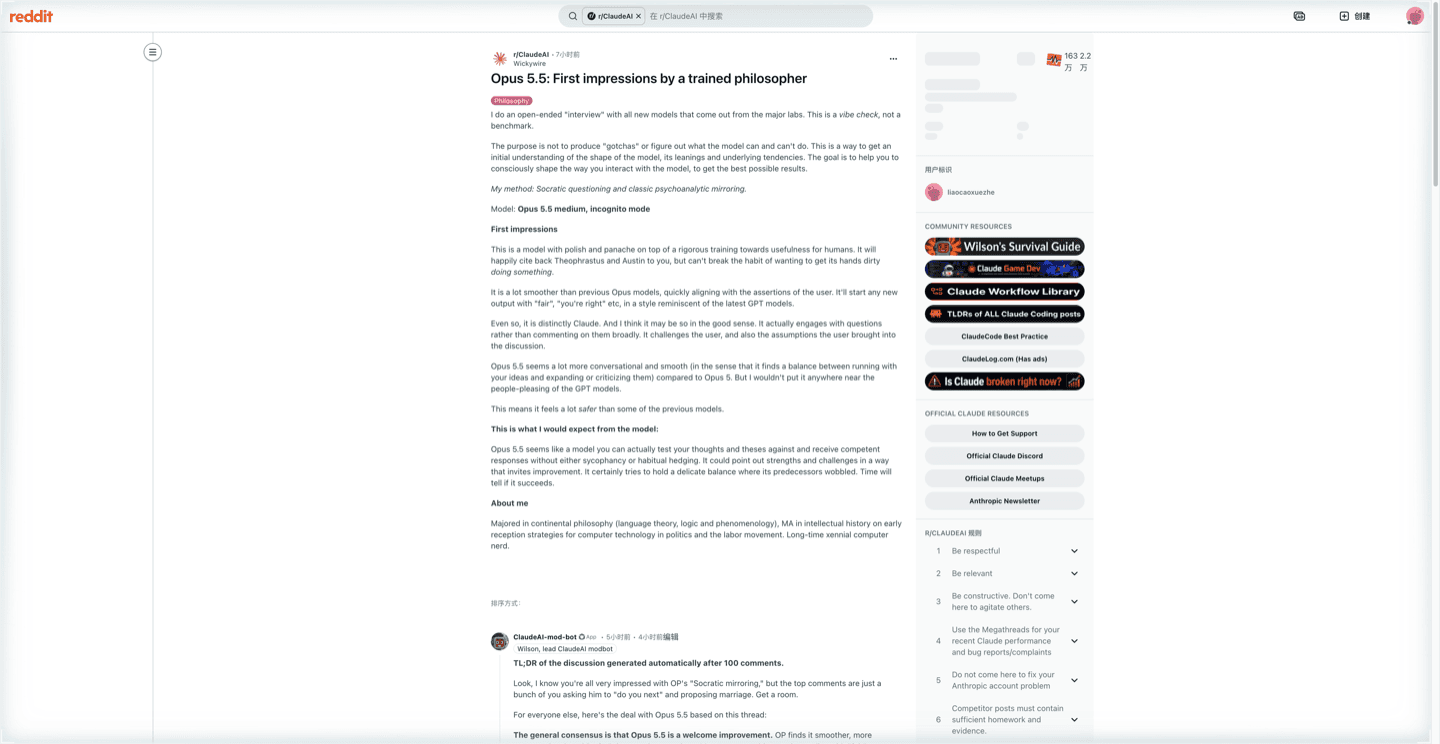
Fil d'origine : r/ClaudeAI 1wnkgie.
Axe deux : faire confiance, mais vérifier — le tissu cicatriciel d'Opus 5. Le scepticisme du fil ancre est précis : des gens ont été brûlés par un modèle qui benchmarkait bien et communiquait mal, et ils n'acceptent pas les chiffres du jour de sortie comme un règlement. Un commentateur lit l'intention de conception avec bienveillance — « Fable 5 & Opus 5 were designed & tested together with the intent being that you talk to Fable and it delegates execution to Opus agents » (u/canyonero7) — ce qui pose la vraie question pour 5.5 : tarifé comme modèle d'exécution, vendu comme modèle de conversation, et les deux rôles dans un seul modèle est précisément ce que l'euphorie du premier jour ne peut pas confirmer.
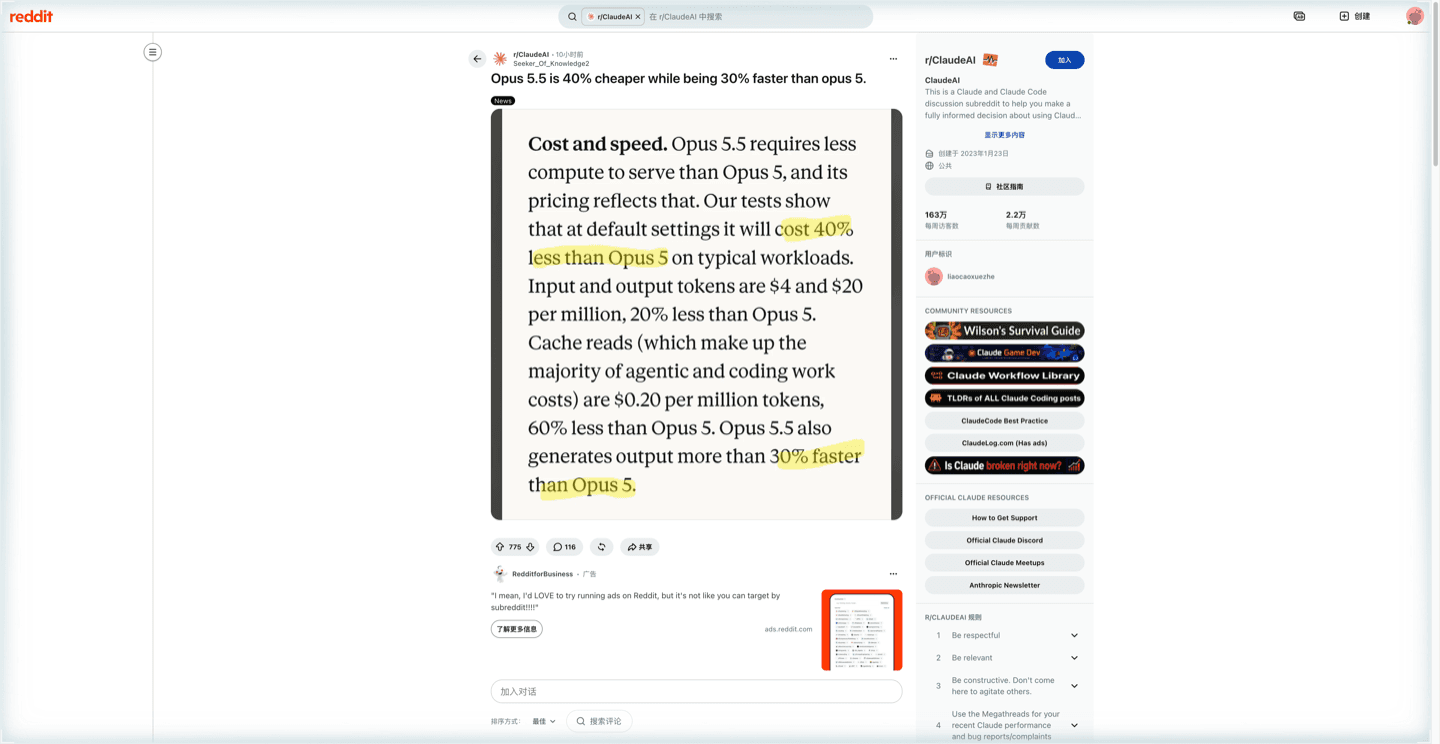
Fil d'origine : r/ClaudeAI 1wnf7sb.
Où ce test atterrit : avec les enthousiastes sur la décision de bascule — l'économie est trop déséquilibrée pour laisser du travail neuf sur Opus 5 — et avec les sceptiques sur la méthode. L'auteur de la lune de miel a raison : deux semaines de journaux en diront plus que n'importe quel tableau ci-dessus ; et il a raison aussi : pour l'instant, ça ressemble à un vrai bond.
Le verdict : basculez votre travail Opus, gardez la discipline
| Forme de charge | Verdict | Pourquoi | Réserve principale |
|---|---|---|---|
| Travail de code agentique par défaut encore sur Opus 5 ou 4.8 | Basculer maintenant | Prix -20 %, cache -60 %, conversation réparée, TB-Science 29,0 % → 58,7 % | Épinglez l'ID du modèle ; remesurez après les ré-exécutions GA |
| Frontière la plus dure, recherche long horizon | Monter sur Fable 5.1 | METR : incrémental ; le pitch officiel lui-même est « niveau Fable sur la plupart du travail » | Les coûts et manies de Fable sont une autre décision |
| Exécutions longues sans supervision, pipelines par lots | Bon candidat en medium | Lectures de cache à 0,20 USD + medium par défaut ; frontière de Pareto AA sur 4 niveaux sur 5 | Pas de latence vérifiée — mesurez le premier token avant de parier des SLA |
| Produits de chat interactifs | Mesurer d'abord | Latence inconnue ; la verbosité à effort élevé (no 95/212) frappe directement l'expérience et la facture | AA marque la vitesse N/A ; aucun chiffre cité ici |
| Java ou génération massive de code sans revue | Oui, avec la revue avancée | Taux égal, sortie plus sobre, densités BLOCKER en baisse | Densité de bugs 576 → 644/mLOC ; concurrence +44 % |
| Automatisation à plancher de coût | Comparer des modèles moins chers | 4/20 USD, c'est bon marché pour la classe Opus, pas en absolu | MiMo à 0,13 USD/tâche ou Gemini 3.8 Flash peuvent mieux coller au mécanique |
Deux notes sensibles au temps. D'abord, tous les chiffres indépendants de cet article sont des instantanés du premier jour : SonarSource a testé un build pré-sortie et refera en disponibilité générale ; les classements d'Artificial Analysis bougent chaque jour. Ensuite, l'échelle de famille continue de se remplir — Sonnet 5 et Haiku 4.5 sont sous cette sortie, et la formule « Claude 5.5 family » d'Anthropic annonce d'autres membres. Planifiez le routage des modèles avec une épingle, pas une habitude.
Une voie pratique : exécutez-le là où le travail se passe
Tout ce qui précède pointe un motif : l'économie récompense les exécutions longues, multi-outils, à effort délibéré ; le mode de défaillance est le volume sans supervision ; et les questions ouvertes — latence, disponibilité dans le sélecteur, stabilité à quelques semaines — ne se répondent qu'en exécutant une tâche bornée, pas en lisant une table de plus. C'est un travail en forme de navigateur : recherche multi-pages, extraction et automatisation où un navigateur agentique tient les pages et le contexte de la session pendant que le modèle travaille, avec Tabbit Browser construit exactement autour de cette boucle.
La limite honnête, comme dans nos autres tests de modèles : ce test n'a pas vérifié si Opus 5.5 apparaît dans le sélecteur de modèles de Tabbit Browser, et aucune exécution pratique n'est revendiquée. Vérifiez le sélecteur de votre compte, épinglez l'ID du modèle, donnez-lui une tâche réversible — une modification multi-fichiers avec un test existant, ou un paquet de recherche avec citations obligatoires — et consignez le coût par résultat accepté contre Opus 5 avant de basculer quoi que ce soit d'important.
 Tabbit Browser
Sources
Anthropic : Introducing Claude Opus 5.5 — faits de sortie, tarifs, tableau de benchmarks, section sécurité (ouvert le 2026-09-23)
Artificial Analysis : Claude Opus 5.5 et article de lancement — indice 58 (no 1/212), 5,98 USD/tâche, mesures de verbosité
METR : Predeployment evaluation of Claude Opus 5.5 — lecture « incrémental sur Fable »
SonarSource : Evaluating Claude Opus 5.5 on Java code generation — taux de réussite, tokens et densité de bugs (build pré-sortie)
CodeRabbit : Opus 5.5 model review — arbitrages rappel/précision et tokens

Questions fréquentes
Claude Opus 5.5 vaut-il le coup ?
Oui comme modèle Opus par défaut. Il vise un niveau Fable 5.1 sur la plupart des travaux à 4 USD par million de tokens d'entrée et 20 en sortie, soit 20 % de moins qu'Opus 5, avec des lectures de cache à 0,20 USD. Gardez Fable 5.1 pour les tâches frontière les plus dures et évitez le réflexe de l'effort maximal : la verbosité mesurée à ce niveau peut absorber l'économie.
Claude Opus 5.5 est-il moins cher qu'Opus 5 ?
Les tarifs affichés baissent de 20 % à l'entrée (4 USD contre 5) et en sortie (20 contre 25), et les lectures de cache passent de 0,50 à 0,20 USD par million de tokens. Anthropic revendique environ 40 % de coût total en moins sur des charges typiques, d'après ses propres tests. L'économie réelle dépend du niveau d'effort et du mélange de tokens : mesurez une tâche représentative.
Opus 5.5 est-il meilleur que Fable 5.1 ?
Anthropic dit qu'Opus 5.5 performe au niveau de Fable 5.1 sur la plupart des travaux pour un coût d'exécution inférieur. Les vérifications indépendantes nuancent : METR juge le gain en R&D d'IA incrémental par rapport à Fable 5.1, tandis qu'Artificial Analysis note Opus 5.5 à 58, premier de son instantané de 212 modèles. Lisez cela comme une quasi-parité à moindre coût, pas une victoire nette.
Claude Opus 5.5 est-il bon pour coder ?
La page de lancement rapporte 66,4 % sur Terminal-Bench 4.0 avec une erreur type d'environ 2,6 points et 57,8 % sur CursorBench 4.0. Le test Java de SonarSource trouve un taux de réussite proche d'Opus 5 (87,68 % contre 88,6 %) avec moins de code mais une densité de bugs plus élevée : gardez une passe de revue plutôt que de faire confiance aveuglément.
Pourquoi Claude Opus 5.5 consomme-t-il autant de tokens ?
À l'effort maximal, Artificial Analysis a mesuré environ 119 000 tokens de sortie par tâche d'index d'intelligence, plus de quatre fois les ~27 000 de GPT-6 Astra, plaçant Opus 5.5 au 95e rang sur 212 en verbosité. L'effort par défaut est medium, et SonarSource a mesuré 40 % de tokens de sortie en moins qu'Opus 5 en génération Java : la consommation dépend de l'effort et de la charge.
Quand Claude Opus 5.5 est-il sorti, et où est-il disponible ?
Anthropic l'a publié le 22 septembre 2026, avec l'identifiant d'API claude-opus-5-5, un contexte de 1M de tokens et jusqu'à 128K en sortie. La page de lancement liste Anthropic Claude Platform, AWS, Google Cloud et Microsoft Azure. La disponibilité sur les offres grand public n'a pas été vérifiée pour ce test.
Peut-on utiliser Claude Opus 5.5 dans Tabbit Browser ?
Ce test n'a pas vérifié si Opus 5.5 apparaît dans le sélecteur de modèles de Tabbit, ne planifiez donc pas autour. Vérifiez le sélecteur de votre compte et lancez une tâche réversible avant de lui confier un flux de travail.