
Claude Opus 5.5 は久々に悩まない Opus の決断です。デフォルトの Opus 仕事を移行させていい。Anthropic は 2026 年 9 月 22 日にリリースし、価格は 100 万トークンあたり入力 4 ドル・出力 20 ドル——Opus 5 より 20% 安い——「大半の仕事で Claude Fable 5.1 と同等の水準」で「運用コストは Opus 5 より 40% 低い」と売り出しました。リリース翌日の独立系記録はこの売り文句をほぼ支持しますが、留保が 2 つ。最高努力レベルではモデルが割引を食い潰すほどよく喋ること、そして詳しく見ると Fable 5.1 対比の能力向上は漸進的で、新たな天井ではないこと。
この構図は空想のマーケティングではありません。リリースから数時間で、r/ClaudeAI の最高得票スレッドのタイトルは「Opus 5.5 is 40% cheaper while being 30% faster than opus 5」——775 件の賛同。コミュニティが公式数字を購買理由として復唱した形です。同スレッドの最多コメントが反応の激しさを説明します。Opus 5 は「couldn't even communicate properly」で、人々は「wasting even more time and tokens」と格闘していた(u/Front_Raspberry_6488、226 賛同。訳:まともにコミュニケーションすら取れなかった……余計な時間とトークンを無駄にした)。本レビューは、これらの感想のどこに証拠が残るかを仕分けます。
以下の事実はすべて 2026 年 9 月 23 日、リリース翌日に開いて照合しました。Anthropic の発表ページ、Artificial Analysis のモデルページ、各 Reddit 元スレッド。Claude Opus 5.5 モデルページ (English)にプロンプトと証拠ライブラリがあり、レビュー証拠カード (English)が本記事の一次記録です。Opus 5.5 の価格ページ・代替品ページはまだ存在しないため、本稿は存在しない兄弟ページへリンクしません。最後に、これらの知見がブラウザレベルのワークフローで何を意味するか——この種のモデルの仕事場がますますそこに移っている——を扱います。
要点
鍵となる数字は 40%。そしてこれはワークロードの主張で、定価ではない。 価格は 20% 下がり(4/20 ドル)、キャッシュ読み取りは 60% 下がった(0.20 ドル/M)。「運用コスト 40% 減」は Anthropic 自身の典型的ワークロードテストに基づく——SonarSource は Java 生成で文字どおり 40% 少ない出力トークンを独立測定し、Artificial Analysis は最高努力レベルでタスクあたり 5.98 ドルを測定した。
独立ランキング 1 位、ただし代償付き。 Artificial Analysis は Opus 5.5(最高努力レベル)に 58 点、212 モデル中 1 位。同時に冗長さは 95 位:知能指数タスクあたり約 11.9 万出力トークンは、GPT-6 Astra 最高レベルの約 2.7 万の 4 倍超。
Opus 5 を沈めたコミュニケーション問題は解決された模様。 Opus 5 への最大の不満は「仕事はできるが会話ができない」。初日の声は 5.5 を速い・自然・無駄話が少ないと描写し、SonarSource は生成 Java のコメント比率が 10.5% から 3.1% に低下したと測定した。
コードは少なく、バグは密。 SonarSource のリリース前ビルド検証では、コード量 27.5% 減・問題総数 42% 減・合格率横ばいだが、100 万行あたりのバグ密度は 576 から 644 へ上昇、並行処理系は 44% 増。レビューは必須のまま。
METR の判定:漸進的であって躍進ではない。 事前評価は 5 つの AI 研究開発タスクで Fable 5.1 対比の小幅な向上を確認し、先見性・フィードバックループ・研究の目利きという判断系の弱点は残ると結論。5.5 は経済性と洗練のために買い、天井に当たったら Fable に上げる。
Claude Opus 5.5 とは何か
Claude Opus 5.5 は Anthropic の新ファミリー Claude 5.5 の最初のモデルで、2026 年 9 月 22 日リリース。API モデル ID は claude-opus-5-5。発表ページは Anthropic Claude Platform、AWS、Google Cloud、Microsoft Azure を掲載。ドキュメント上のスペックはコンテキスト 100 万トークン、最大 12.8 万トークン出力、adaptive thinking、そしてデフォルトの努力レベルが medium——この最後の詳細が、本レビューのどのベンチマーク行よりも重要です。
| 項目 | 公表値(2026-09-23 照合) | 証明できないこと |
|---|---|---|
| リリースとモデル ID | 2026-09-22;claude-opus-5-5 | 全クライアントが同一ビルドと努力レベル範囲を露出 |
| 入力 / 出力価格 | 100 万トークンあたり 4 / 20 ドル | 思考とリトライ後の 1 タスク完了コスト |
| キャッシュ読み / 書き | 100 万あたり 0.20 / 5 ドル(Opus 5:0.50 / 6.25) | 全ワークロードで一律 40% 減 |
| コンテキストと出力 | 入力 100 万、出力最大 12.8 万 | 全プロバイダー・プランが全幅を提供 |
| 努力レベル | adaptive thinking、デフォルト medium | 低努力レベルで同スコアを維持(タスク別曲線は未公表) |
| 可用性 | Anthropic、AWS、Google Cloud、Azure | コンシューマープラン。本稿では未検証 |
| 独立スナップショット | Artificial Analysis:58 点、212 モデル中 1 位(最高レベル) | 速度:AA は本モデルの遅延を N/A 表記 |
Anthropic は手続き上の脚注も付けています。同社が「pacing the frontier」(フロンティアの速度調整)を呼びかけて以降の初リリースであり、Frontier Design と METR を含む外部評価者による事前テストを経たこと。Anthropic 自身の自動化行動監査(約 2,000 シナリオ)で Opus 5.5 は「現在までにテストした中で最良の成績」であり、ある封じ込め境界評価では Opus 5 や Mythos 5.1 比で境界回避の試みが約 85% 少なかった。これらは記録に値する安全面の主張で、両刃でもあります。後述のように、セーフガードの介入は能力ベンチマーク上のゼロ点にもなります。
本レビューが答える問いは「賢いか」ではありません。ベンダーの表と独立 1 位が既にイエスと言っています。聞くべきは、作業馬の値段で旗艦並みと喧伝されるモデルが日常ワークフローに居場所を持つか——Opus 5 の料率を維持するのと、Fable 5.1 の価格を払うのと、機械的作業を GPT-5.6 Sol や MiMo-V2.6-Pro といった安価なモデルへ移すのと、どれが得かです。
このレビューを決めるひとつの数字:40%
Anthropic の売り文句は、発表ページで原文照合済みです。Opus 5.5 は「performs at the level of Claude Fable 5.1 on most work and costs 40% less to run than Opus 5」(大半の仕事で Fable 5.1 と同等の水準で、運用コストは Opus 5 より 40% 低い)。一行に検証可能な主張が 2 つ——旗艦に近い能力と、作業馬の経済性。
価格の部分は公開され単純です。入力は 5→4 ドル、出力は 25→20 ドル、キャッシュ読み取りは 100 万あたり 0.50→0.20 ドル。キャッシュ読み取りがエージェント作業で最も効くのは、40 回のツール呼び出しでキャッシュ済みプレフィックスを 40 回読み直すため。0.20 ドル——入力価格の 5%、Artificial Analysis の言う 95% キャッシュ割引——により長時間セッションは構造的に安くなります。Fable 5.1 のリリースを飾ったキャッシュ値下げと同じレバーを、さらに押し下げた形です。
40% の部分には細則が詰まっており、3 つの独立測定が挟み込みます。
回収された: SonarSource の Java 生成(リリース前ビルド、High レベル)は出力 1,296 万トークンで、Opus 5 の 2,171 万に対し文字どおり 40% 減。合格率は 1 ポイント未満差(87.68% 対 88.6%)。コードもトークンも少なく機能結果は同じ。割引が設計どおり効いた姿です。
使われた: Artificial Analysis が知能指数を最高努力レベルで実行すると、タスクあたり約 119,000 出力トークン——Opus 5 最高レベルの約 7.3 万、Fable 5.1 最高レベルの約 7.8 万、GPT-6 Astra 最高レベルの約 2.7 万に対して——加重タスクコスト 5.98 ドル、冗長さ 212 モデル中 95 位。モデルが最大音量で考えさせるままにしたとき、割引が費える姿です。
中間: Anthropic 内部の M&A 分析タスクは 63 分で完了(Opus 5 は 93 分)し「運用コスト 50% 減」——ベンダー自計で、主張値どおり。
この 3 つを調整するのは矛盾ではなく、努力ダイヤルです。デフォルトが medium なのには理由があります。40% の割引は本物で、回収できるかはほぼ、ワークフローが反射的にどのレベルを使うかで決まる。 METR の能力判定が裏から同じ結論を支えます——Fable 5.1 対比は漸進的で、乗り換えの理由は経済性と洗練、新しい天井ではない。「最良モデルに最高努力レベル」という理由で max を固定するパイプラインは、すでに自分を旗艦価格帯に再設定しています。
リーダーボードの前に、実仕事で起きたこと
初日で最も有用な証拠はベンチマーク行ではなく、名前と限界の明記された 3 つの制作譚です。
45 分 1 回のショートフィルム。 u/mshort3 は既存のクリエイティブプロジェクト内で Claude Code に一言——「Lets make a ~70s riso film of your own choosing, free range」——を渡し、Opus 5.5 が約 45 分の 1 回実行で 78 秒のアニメーション列車の旅を生成したと報告(r/ClaudeAI、637 賛同)。リポジトリは公開で、著者は功績をモデルだけではなくプロジェクト自体のスキルとドキュメントに帰しています。1 回実行、中間状態のログなし。
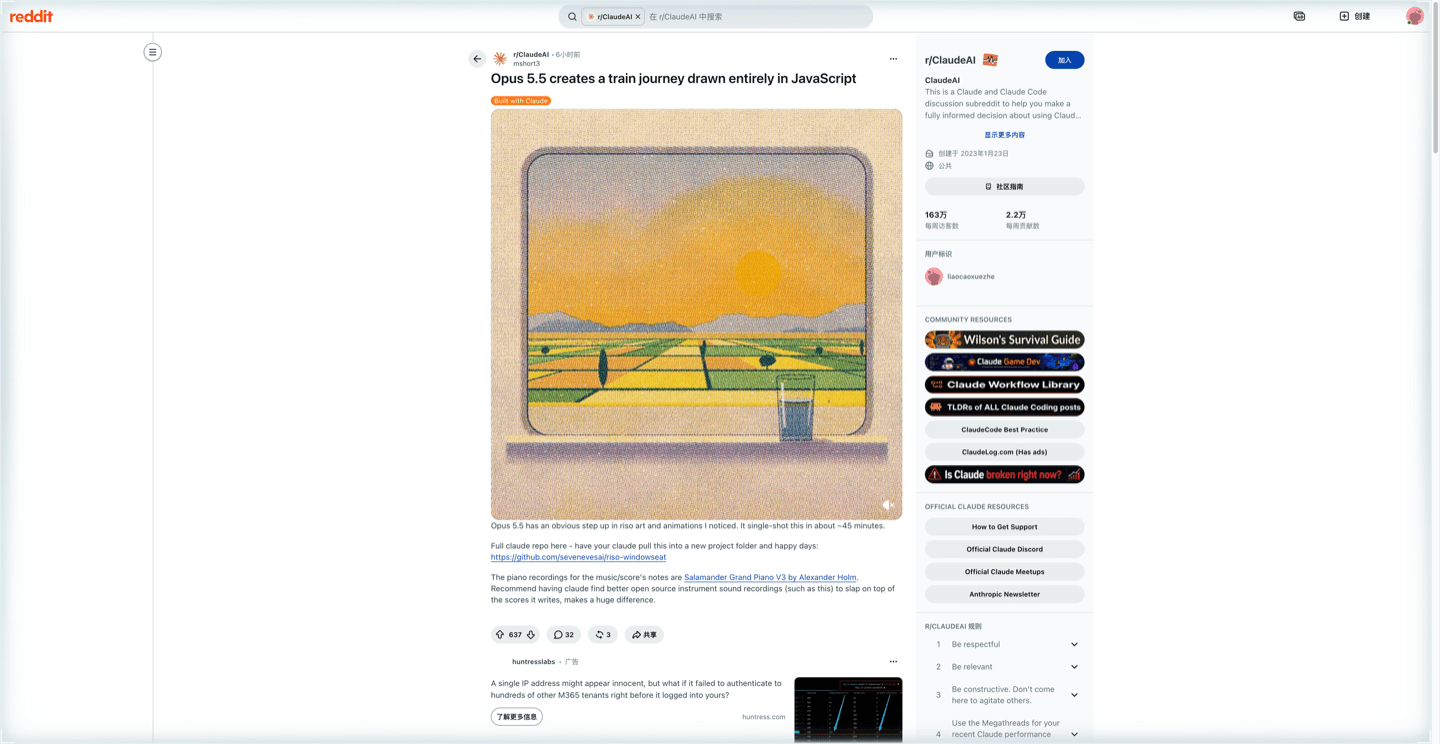
元スレッド:r/ClaudeAI 1wnkvys。
1 プロンプトで 1 分動画——コストの領収書付き。 u/AzorAhai1TK は「an average at work… with a twist」の不気味な 1 分動画を依頼し、モデルが Extra-High レベルでコーディングからレンダリングまで約 45 分、月 20 ドルプランの週次枠の約 4% を消費したと報告(r/ClaudeAI)。自己申告の数字ですが、この枠消費のデータこそ価格議論に必要なものです。クリエイティブな高努力レベル実行は無料でも致命的でもない。
Claude Code で「night and day」の速度——注意書きは著者自身が添付。 u/Lazy_Assistance_1137 は「used to take a while to track down」UI バグが「in no time」で見つかり、向上を「night and day」と評した——直後に「this could just be the classic day-one honeymoon phase, and in two weeks we'll all be back to posting 'did they nerf it?' threads」と冷水も(r/ClaudeAI、273 賛同。訳:これは単なる初日の新婚気分かもしれず、2 週間後には「 nerf された?」スレッドに戻っている)。最多リプライは一言深:「It's crazy fast. I'm impressed.」(u/capivara_de_pijama、96 賛同。訳:ぶっ飛ぶほど速い。感動した。)
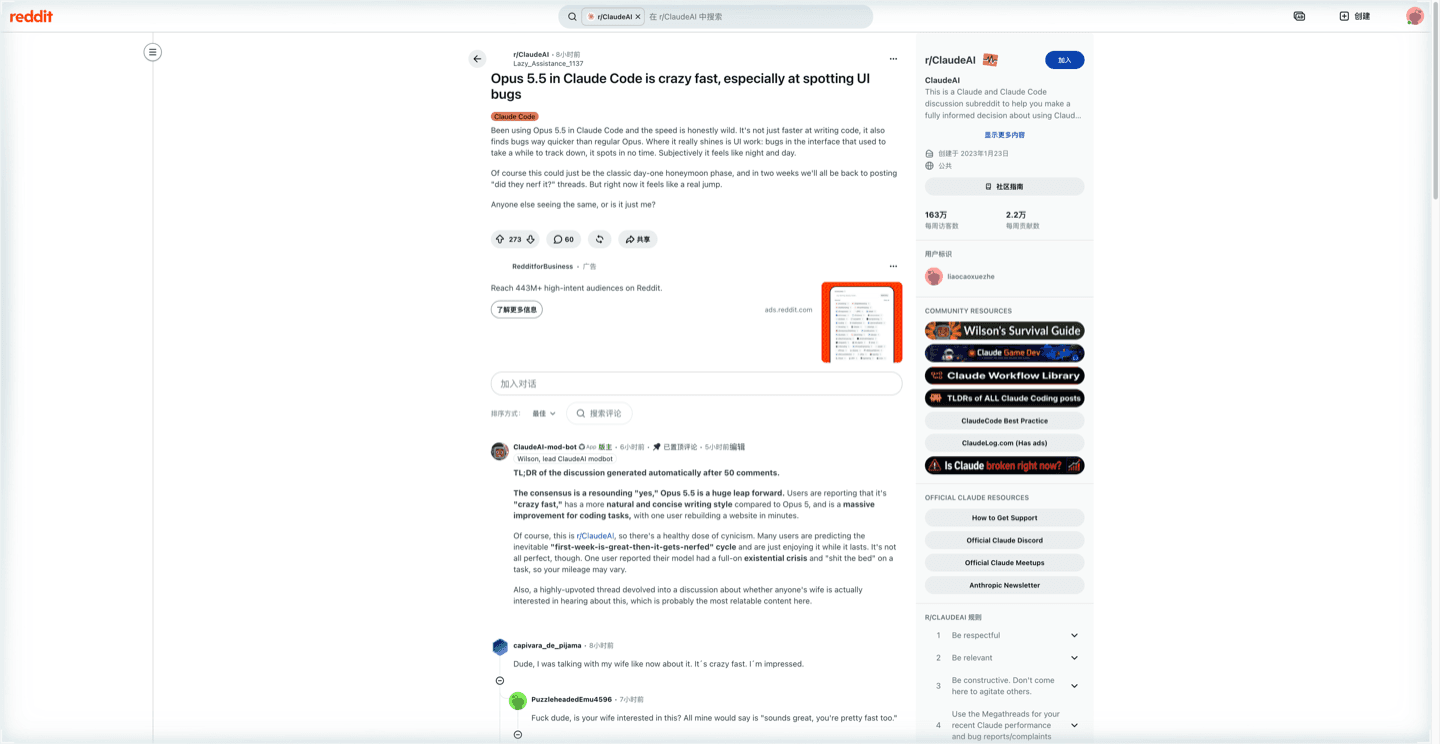
元スレッド:r/ClaudeAI 1wnil7n。
3 話、各 n=1、ログなし、トークン計数なし(例の 4% を除く)。証明できるのは、リリース初日にこのモデルが長く自律的なマルチツールの制作を、繰り返し、公開で、開ける成果物つきで完遂したこと。証明できないのは、その頻度。ベンチマークが埋めるべきはまさにその隙間です——実際にどれだけ埋まるか見ましょう。
ベンチマークと、信じてよい程度
Anthropic の発表表を 2026-09-22 公表どおりに記録します。列ごとに演者とリーダーボードが異なり得ます(GPT-6 Astra と GPT-5.6 Sol の数値は OpenAI 報告由来と Anthropic が明記)。列間の算術ではなく行で読んでください:
| 領域 / ベンチマーク | Opus 5.5 | Fable 5.1 | Opus 5 | GPT-6 Astra | GPT-5.6 Sol |
|---|---|---|---|---|---|
| エージェントコーディング:Terminal-Bench 4.0 | 66.4% | 55.8% | 52.3% | 57.9% | 37.3% |
| エージェントコーディング:FrontierCode v1.1 | 54.4% | 50.3% | 48.0% | 53.3% | 47.5% |
| エージェントコーディング:CursorBench 4.0 | 57.8% | 51.8% | 46.6% | — | 41.7% |
| 知識労働:GDPval-AA v2.1 | 1846 | 1735 | 1708 | 1542 | 1588 |
| ビジネスワークフロー:AutomationBench | 40.0% | 31.4% | 26.9% | 41.4% | 28.8% |
| 推論:Humanity's Last Exam(ツールあり) | 67.7% | 65.6% | 63.6% | 57.2% | — |
| エージェント科学研究:Terminal-Bench-Science 0.1 | 58.7% | 52.6% | 29.0% | 64.6% | 22.4% |
| コンピューター操作:OSWorld 2.0(partial) | 81.8% | 80.7% | 74.0% | — | — |
| 図表認識:Chartography(ツールあり) | 89.0% | 88.4% | 83.4% | — | — |
続いて冷水三連。
誤差範囲は公表済みで、しかも広い。 Terminal-Bench 4.0 の Opus 5.5 標準誤差は ±2.6 ポイント、Terminal-Bench-Science はモデルごとに ±3.5〜5 ポイント。TB-Science の Opus 5 → Opus 5.5(29.0% → 58.7%)の跳躍はどの誤差帯にも生き残り、同行の GPT-6 Astra(64.6%)との差も生き残ります——Astra 有利の方向で。Anthropic 自身がページ上で「現在の能力水準では、ベンチマークスコア差が実世界の差を確実に代表するとは限らない」と注意を書いています。ベンダー自身のこの一文が、今季のどの発表表よりも誠実です。
比較条件は揃っていない。 Terminal-Bench 行は Claude Code ハーネスを使用。AutomationBench は Zapier が実行・報告し、フォールバックモデルなし——セーフガード介入は失敗計上。GDPval-AA v2.1 の独立採点プロセスはページに詳細なし。ガード介入タスクはゼロ点になり得て、ポリシー結果が能力ミスとして記録されます。表を「誤り」にはしませんが、条件の異なるスナップショット群であって、統制された競争ではありません。
独立記録は形で一致し、幅度ではしない。 Artificial Analysis の指数(v4.3.2、10 評価)は Opus 5.5 最高レベルに 58 点、212 モデル中 1 位。6 評価で単独首位(Humanity's Last Exam 61.4%、SciCode 66.9%、GDPval-AA 1846、AA-Briefcase 1822——Fable 5.1 比 +143 Elo)。Terminal-Bench 4.0 は 59.6% で GPT-6 Astra xhigh と同率。SonarSource の統制 Java 検証は最も鋭い一撃です。合格率は Opus 5 と 1 ポイント未満差でコード 27.5% 減——ただし行あたりバグ密度は上昇、後述。METR の事前評価(営業日 10 日、AI 研究開発 5 タスク)は Fable 5.1 対比の向上を「incremental… rather than a discontinuous leap」、先見性・フィードバックループ構築・研究判断への大きな進展なしと結論します。
冷水の後も立っているもの:Opus 5 との前後差は大きく本物(TB-Science 29.0% → 58.7% は丸め誤差ではない)。独立 1 位には第二ソースがある。コストの話には完全に独立した再現が 1 件ある(SonarSource のトークン計数)。立っていないもの:「Opus 5.5 が GPT-6 Astra に圧勝する」類の主張。Anthropic 自身の表では Opus 5.5 が Terminal-Bench 4.0 を取り、Astra が Terminal-Bench-Science を取る。Artificial Analysis の独立 TB-4.0 では両者 59.6% 同率。GPT-6 Astra レビューで同モデルのトレードオフは別途扱います。
Opus 5.5 が本当に優れているところ
ついに同僚のように話す
どのベンチマーク行も捉えられない強みです。Opus 5 はコードは強いが会話が嫌われるモデルで、初日の声は 5.5 が会話そのものを直したと言います。アンカースレッドの上位コメントは古傷の検死——「Opus is fantastic, just until you have to talk to it」(u/Neon_Camouflage、61 賛同。訳:たいていの作業では Opus は素晴らしい、話しかけるまでは)——と安堵のセット。「Heard Opus 5.5 is less verbose」(u/No-Temperature6597。訳:Opus 5.5 は無駄話が減ったと聞く)。SonarSource の解析器は行動変化に数字を付けました。生成 Java のコメント比率は行の 10.5% から 3.1% へ、コードスメル密度は 21% 減。訓練された哲学者の雰囲気チェック(medium レベル・シークレットモード)は「a model with polish and panache… It will happily cite back Theophrastus and Austin to you, but can't break the habit of wanting to get its hands dirty」と描写します(u/Wickywire。訳:磨きとかっこよさを備えたモデル……テオフラストスやオースティンを喜んで引用するが、手を汚したがる癖は直らない)。書くこと・計画することで飯を食う人——コンパイルだけではない人——にとって、これはどのコーディングスコアより重要な改善です。
エージェントの完遂力、Opus の値段で
公式表の重心はここで、しかも持ちこたえます。Terminal-Bench 4.0 66.4%、TB-Science 58.7%(いずれも公表誤差帯内)、ハーネスは Claude Code。CursorBench 4.0 57.8%、OSWorld 2.0 partial 81.8% が操作系をカバー。内部事例はベンダー証拠にしては具体性が際立ちます。四半期決算タスクでは 18 報告中 16 が、数字と引用を一つずつ検証する採点器を通過し、Fable 5.1 と Opus 5 の試行は両方落ちた。架空の M&A 分析は 63 分(Opus 5 は 93 分)、コスト約半分。ベンダー自計ながら、まさに長く・マルチファイル・検証の重いという、ターミナル数値が測る仕事の形です。エージェント研究と深い作業にとって、4/20 ドルでこの側面は今回のリリースで最も硬い理由です。
medium レベルの経済性は静かな見出し
デフォルト medium と 0.20 ドルのキャッシュ読み取りは、長いセッションの単位経済を変えますが、表紙価格からは見えません。Artificial Analysis は 5 つ努力レベルのうち 4 つを知能対コストのパレートフロンティアに置きました——例外は誰も反射的に選ぶべきでないレベル——で、5.98 ドル/タスクは max に属し medium には属しません。CodeRabbit のパイプライン検証では、Standard 構成(低努力レベル)が 80 パターン集合で自社 Max 構成を、より良い実行可能精度とより少ないコメント数で下回りました。Max が差をつけたのは最難関の Signal 13 件だけ。3 つの独立ソースの形は一貫します。このモデルの価値関数は意図的な努力レベル選択に報い、反射を罰する。 Opus 5 や旧 Opus 4.8 の料率を払い続けるチームにとって、移行はほぼ無条件のプラスです。
噛むところ
max レベルは割引を焼く
medium を安くするダイヤルは、max を高くする。AA 指数タスクあたり約 119k 出力トークン(GPT-6 Astra max の 4.4 倍、Fable 5.1 max の 1.6 倍)、加重 1 タスク 5.98 ドル、冗長さ 95/212 位、評価全体で累計 2.6 億トークン。CodeRabbit は本番形状の仕事で同じ形を見ました。トークン使用量は自社基準比 +49〜60%、Max は OSS 集合 +57.6%、Signal 集合 +60.1% を、しばしば不要な精度のために加算。ハーネスや習慣が max 固定なら旗艦級の予算を組み、意図的に倹約的な対抗馬として Gemini 3.8 Flash レビューも、直近の群れで最安の実測タスクコストとして MiMo-V2.6-Proも参照してください。
コードは少なく、バグは密
SonarSource の数字には居心地の悪い枠付けが要ります。問題総数は 42% 減だが、100 万行あたりバグ密度は 576 → 644。並行処理系——レビューではなく本番で顔を出す階層——は 44% 増で最大カテゴリ(295/mLOC)。最重度 BLOCKER 3 種の密度はすべて低下し、これは本当に安心材料です。ただし形は明瞭。5.5 のコードはコンパクトであっても一様に安全ではない。限界が 2 つ。テストはリリース前ビルドで(SonarSource は一般提供後に再実行予定)、CodeRabbit の並行発見——OSS 集合で新規 11 パターン発見・基準の 9 パターン取り逃し——がレビュー側から同じことを言っています。レビューは残し、パイプラインの前へ移動させる。削除はしない。
Fable 対比は漸進、そして未知は未知のまま
METR の評価は最も甘くない独立の判定で、2 回読む価値があります。AI 研究開発 5 タスクすべてで Fable 5.1 を小幅に上回るが、完全自動化の証拠はなく、判断系の能力——先見、予測、フィードバックループ構築、研究の目利き——に大きな進展はない。真に未知の事項も加算してください。検証済みのレイテンシは存在しない(Artificial Analysis は本モデルの速度を N/A 表記。よって本稿は初回トークン時間を一切引用しない)。コンシューマー可用性は未検証。ガード付き実行はタスクをゼロ点にでき、あなたのハーネスの安全設定は測定される能力の一部です。生まれて 1 日のモデルはこれら全部を抱えて出荷されます。失格になるものは一つもない。すべてが「一斉展開ではなく計測された試験導入」を指しています。
人々は実際に何と言ったか
初日の会話は 1 本ではなく 2 軸で割れます。
軸 1:ついに速い——そして、ついに会話できる。 速度スレッドとそのリプライは曖昧さのない喜びで、哲学インタビューは同じことの定性版です。磨きと手を汚したがる気性を描写し、周りでワークフローを再構築するユーザーは支持層を要約します。Opus 5 の成果は好きだが会話は嫌いだった人々。
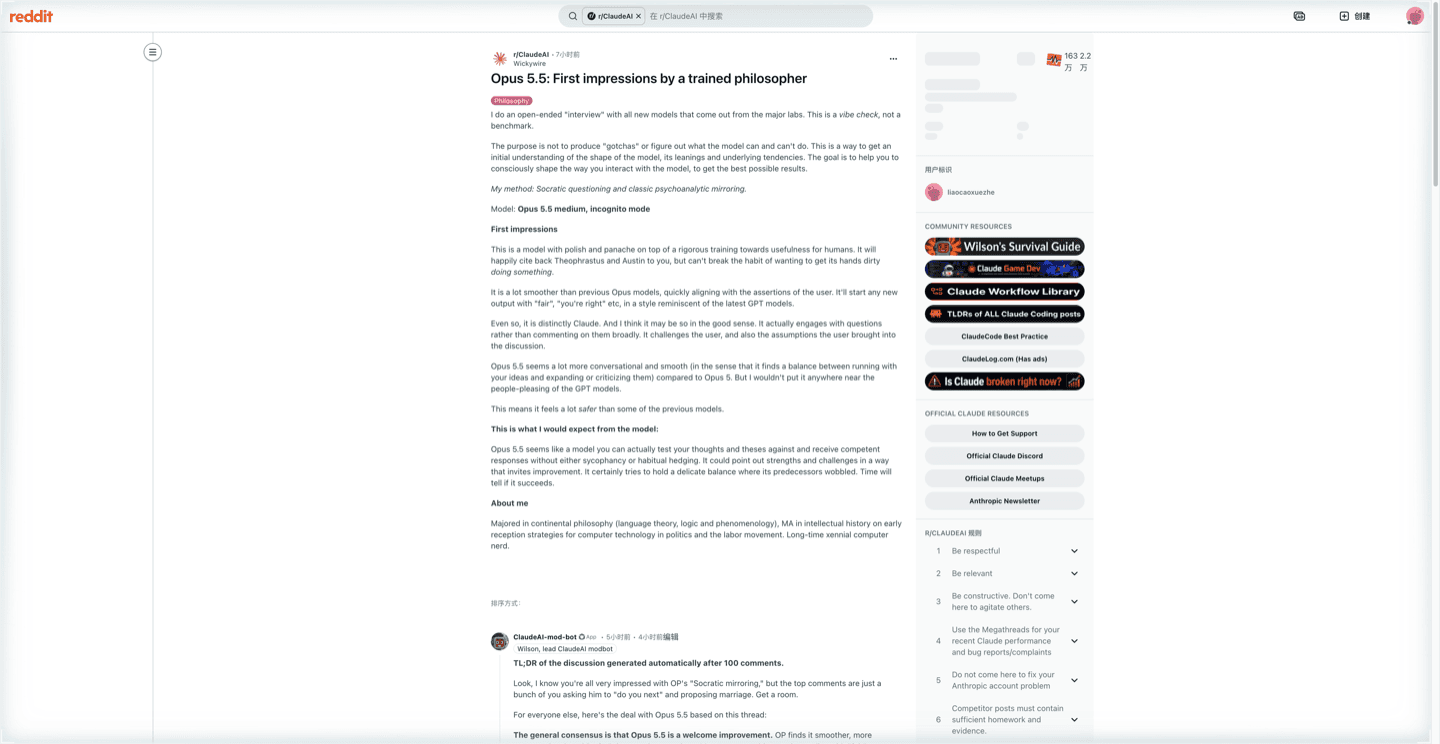
元スレッド:r/ClaudeAI 1wnkgie。
軸 2:信用するが検証する——Opus 5 の瘢痕組織。 アンカースレッドの懐疑は具体的です。人々はベンチマークが良くて会話が悪いモデルに火傷しており、初日の数字を決着として受け入れない。あるコメントは設計意図を好意的に読む——「Fable 5 & Opus 5 were designed & tested together with the intent being that you talk to Fable and it delegates execution to Opus agents」(u/canyonero7。訳:Fable 5 と Opus 5 は一緒に設計・テストされ、あなたは Fable と話し、Fable が実行を Opus に委譲する意図だった)——これは 5.5 をめぐる本当の問いを立てます。実行モデルの値段で、会話モデルとして宣伝される。1 つのモデルが両方の役を務めることは、まさに初日の熱狂には証明できないのです。
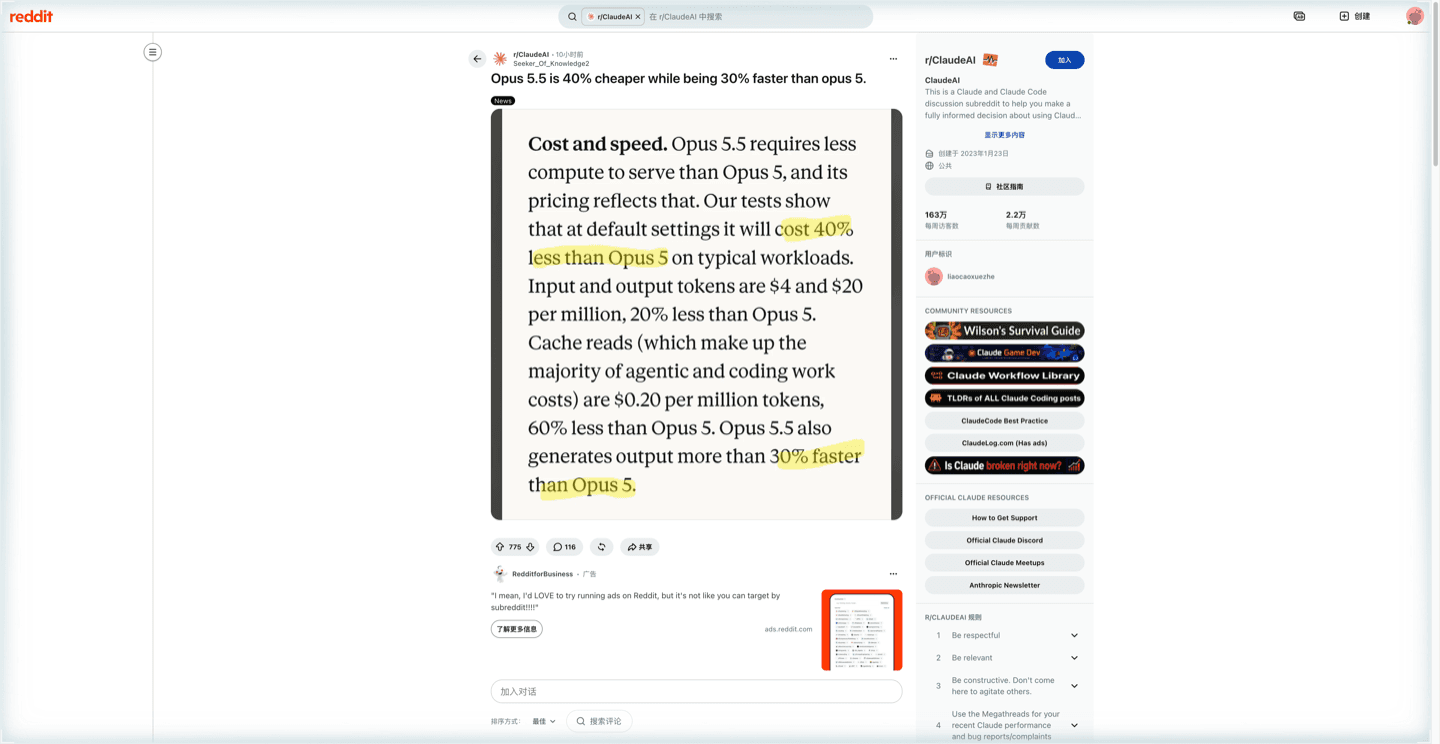
元スレッド:r/ClaudeAI 1wnf7sb。
本レビューの着地:移行判断では熱狂側に——経済性が片倒しで、新しい仕事を Opus 5 に残す理由はない。プロセスでは懐疑側に。新婚期間の著者は、2 週間のログが上のどの表より語るという点で正しく、今この瞬間が本物の跳躍に感じられるという点でも正しい。
判定:Opus の仕事は移し、規律は残す
| ワークロードの形 | 判定 | 理由 | 主な留保 |
|---|---|---|---|
| 現在 Opus 5 / 4.8 で回す既定のコーディング作業 | 今すぐ移行 | 価格 20% 減、キャッシュ 60% 減、会話修復、TB-Science 29.0% → 58.7% | モデル ID を固定。GA 再実行後に再計測 |
| 最難関のフロンティア・長期研究 | Fable 5.1 へ格上げ | METR:漸進的。公式の売り自体が「大半の仕事で Fable 水準」 | Fable のコストと癖は別の判断 |
| 無人監視の長期実行・バッチパイプライン | medium レベルで良候補 | キャッシュ読み 0.20 ドル+デフォルト medium。AA パレート 5 レベル中 4 つ | 検証済みレイテンシなし——SLA の前に初回トークンを自測 |
| 対話型チャット製品 | 先に計測 | レイテンシ未知。高努力レベルの冗長さ(95/212 位)は UX と請求に直撃 | AA 速度は N/A。本稿は数字を引用しない |
| レビューなしの Java・大規模コード生成 | 使うが、レビュー前倒し | 合格率横ばい、出力はコンパクト、BLOCKER 密度は低下 | バグ密度 576 → 644/mLOC、並行処理 +44% |
| コスト床のある自動化 | より安いモデルと比較 | 4/20 ドルは Opus 級では安いが絶対値では安くない | 機械作業なら MiMo 0.13 ドル/タスクや Gemini 3.8 Flash が適合の可能性 |
時効の注記が 2 つ。第一に、本稿の独立数値はすべて初日のスナップショットです。SonarSource はリリース前ビルドで一般提供後に再実行を約束し、Artificial Analysis の順位は日替わりです。第二に、ファミリーの梯子はまだ埋まり途中——Sonnet 5 と Haiku 4.5 は本リリースの下にあり、Anthropic の「Claude 5.5 family」という語は追加メンバーを示唆します。モデルルーティングは習慣ではなくピン留めで計画してください。
実践の道:仕事が起きる場所で走らせる
以上が指し示す形は一つ。経済性は長く・マルチツール・意図的なレベル選択の実行に報い、失敗モードは無監視の量であり、未決の問い——レイテンシ、セレクター可用性、数週間後の安定性——は表をもう 1 枚読むのではなく、境界のあるタスクを 1 件走らせることでしか答えない。これはブラウザ形状の仕事です。複数ページの調査・抽出・自動化をエージェント的ブラウザがセッションのページと文脈を保持し、その中でモデルが働く。Tabbit Browser はまさにこのループの周りに構築されています。
他のモデルレビューと同じ正直な境界です。本稿は Opus 5.5 が Tabbit Browser のライブモデルセレクターに表示されるかを検証しておらず、一切の体験実行を主張しません。自分のアカウントのセレクターを確認し、モデル ID を固定し、差し戻し可能な小さなタスク——既存テスト付きのマルチファイル変更か、引用必須の調査パッケージ——を 1 件与え、「受け入れ可能な結果あたりのコスト」を Opus 5 と比較してから、大事なものを切り替えてください。
 Tabbit Browser
出典
Anthropic: Introducing Claude Opus 5.5——リリース事実、価格、ベンチマーク表、安全性セクション(2026-09-23 開覧)
Artificial Analysis: Claude Opus 5.5 およびリリース記事——指数 58(1/212 位)、5.98 ドル/タスク、冗長さ測定
METR: Predeployment evaluation of Claude Opus 5.5——「Fable 対比漸進的」の判定
SonarSource: Evaluating Claude Opus 5.5 on Java code generation——合格率、トークン、バグ密度(リリース前ビルド)
CodeRabbit: Opus 5.5 model review——再現率・精度とトークンのトレードオフ

よくある質問
Claude Opus 5.5 は使う価値がある?
デフォルトの Opus クラスとしてはイエス。入力 100 万トークンあたり 4 ドル、出力 20 ドルで、大半の仕事で Fable 5.1 と同等的水準を狙い、Opus 5 より 20% 安く、キャッシュ読み取りは 0.20 ドルまで下がります。最難関のフロンティア業務は Fable 5.1 に残し、反射的な最高努力レベルも避けるべき——そこでの出力量は割引を食い潰します。
Claude Opus 5.5 は Opus 5 より安い?
定価は入力で 20% 安く(4 ドル対 5 ドル)、出力も 20 ドル対 25 ドル、キャッシュ読み取りは 100 万トークンあたり 0.50 ドルから 0.20 ドルへ。Anthropic は自社テストに基づき典型的ワークロードで総コスト約 40% 減と主張しています。実際の節約額は努力レベルとトークン構成次第なので、代表タスクで実測してください。
Opus 5.5 は Fable 5.1 より上?
Anthropic 自身の説明は「大半の仕事で Fable 5.1 と同等の水準に達し、運用コストはより低い」。第三者検証はまちまちです。METR は AI 研究開発タスクでの向上を Fable 5.1 対比の漸進的改善と評し、Artificial Analysis は 58 点で 212 モデル中 1 位としています。安価なほぼ互角と読むのが正確で、明確な勝利ではありません。
Claude Opus 5.5 はコーディングに向く?
発表ページは Terminal-Bench 4.0 で 66.4%(標準誤差 ±2.6 ポイント)、CursorBench 4.0 で 57.8% を報告しています。SonarSource の Java 検証では Opus 5 とほぼ同じ合格率(87.68% 対 88.6%)でコードは少ないもののバグ密度は高く、ブラインド信頼ではなくレビューを残してください。
Claude Opus 5.5 はなぜトークンをこんなに使うの?
最高努力レベルでは、Artificial Analysis が知能指数タスク 1 件あたり約 119,000 出力トークンを測定。GPT-6 Astra 最高レベル(約 27,000)の 4 倍超で、冗長さは 212 モデル中 95 位。デフォルトの努力レベルは medium で、SonarSource は Java 生成で Opus 5 比 40% 少ない出力トークンを測定しており、消費量は努力レベルとワークロード次第です。
Claude Opus 5.5 のリリース日と利用可能な環境は?
Anthropic は 2026 年 9 月 22 日にリリース。API モデル ID は claude-opus-5-5、コンテキスト 100 万トークン、最大 12.8 万トークン出力。発表ページは Anthropic Claude Platform、AWS、Google Cloud、Microsoft Azure を掲載しています。コンシューマープランでの利用可否は本レビューでは未検証です。
Tabbit Browser で Claude Opus 5.5 を使える?
本レビューは Opus 5.5 が Tabbit のモデルセレクターに表示されるかを検証できていないため、これを前提に計画しないでください。自分のアカウントのセレクターを確認し、差し戻し可能な小さなタスクを 1 件走らせてから判断してください。