
Choisir entre deux modèles d'une même lignée architecturale ne consiste pas à désigner un vainqueur universel, mais à allouer judicieusement ses ressources d'ingénierie. Le 22 septembre 2026, Xiaomi a mis à disposition sous licence MIT sa famille de modèles de fondation omnimodaux MiMo-V2.6, introduisant deux variantes majeures : le modèle amiral MoE MiMo-V2.6-Pro et l'alternative légère à haut débit MiMo-V2.6-Flash.
En tant qu'ingénieur intégrant quotidiennement des modèles de langage au cœur d'applications de production, d'agents autonomes et de pipelines d'extraction, je ne me fie guère aux classements promotionnels diffusés lors des lancements. En situation réelle, ce qui importe véritablement est de savoir si le modèle est capable de maintenir la cohérence d'une session de 30 étapes sans intervention humaine lorsque le DOM change à la volée, que les API renvoient des erreurs partielles et que le contexte atteint des centaines de milliers de tokens.
Si vous souhaitez étudier les grilles tarifaires officielles détaillées, nous vous invitons à consulter notre guide tarifaire MiMo-V2.6-Pro ou notre analyse des coûts de MiMo-V2.6-Flash. Les fiches techniques sont également disponibles sur la page du modèle MiMo-V2.6-Pro (English) et sur la page du modèle MiMo-V2.6-Flash (English). Cet article propose une analyse comparative pragmatique : les contextes où le modèle de 1,02 billion de paramètres justifie son surcoût, les scénarios où Flash accomplit la tâche à l'identique pour le tiers du prix, et la façon dont la mémoire cache bouleverse l'arithmétique des coûts.
Points clés à retenir
Un écart de tarif brut exactement égal à 3,1x : Flash revient à 0,14 $ en entrée et 0,28 $ en sortie par million de tokens, contre 0,435 $ et 0,87 $ pour Pro.
La mémoire cache neutralise l'écart en entrée : Dès lors que le taux de succès du cache dépasse 85 %, le coût de lecture de Pro (0,0036 $ / 1M) se rapproche à 28 % près de celui de Flash (0,0028 $ / 1M). Vous bénéficiez ainsi d'un modèle d'un billion de paramètres pour le tarif d'entrée d'un petit modèle.
Performances comparables sur les opérations courantes : Sur les parcours web programmés et la saisie de formulaires (Automation Bench : 53,1 contre 52,3), Flash délivre 98,5 % de l'efficacité de Pro pour seulement 32 % du coût.
Décrochage sur les agents à long terme : Dès qu'une tâche exige une auto-correction poussée ou une refonte logicielle multi-fichiers, Pro établit un avantage net de 14,5 % (Agents' Last Exam : 31,6 contre 27,6 ; DeepSWE v1.1 : 71,9 contre 67,9).
Vigilance face à l'emballement du raisonnement sur les requêtes simples : Pro peut générer 8 000 tokens de pensée là où Flash n'en utilise que 1 500. Sans encadrement, le coût unitaire de Pro peut être multiplié par 17 sur des requêtes basiques.
L'indicateur décisif : 3,1x le prix pour 0,8 point d'écart en automatisation
Le dilemme fondamental de cette confrontation s'articule autour de deux grandeurs contrastées : un multiplicateur de prix de 3,1x face à un écart de seulement 0,8 point en automatisation élémentaire.
Sur le plan matériel, MiMo-V2.6-Pro mobilise 42 milliards de paramètres actifs par token au sein d'une structure MoE de 1,02 billion de paramètres. MiMo-V2.6-Flash en active 15 milliards sur un total de 309 milliards. Cette différence de 2,8x en puissance de calcul se reflète précisément dans la grille tarifaire de Xiaomi (0,435 $ contre 0,14 $).
Toutefois, sur l'évaluation Automation Bench v1.0.6, qui mesure l'extraction DOM et la navigation web séquentielle, Pro obtient 53,1 tandis que Flash atteint 52,3. Sur ProgramBench pour la production de fonctions unitaires, Pro enregistre 26,5 contre 26,0 pour Flash. Dépenser 310 % de plus pour un gain de 1,5 % sur des opérations prévisibles constitue un mauvais calcul d'ingénierie.
Exécution d'outils standards (Automation Bench) :
MiMo-V2.6-Pro :   53,1  (0,435 $ entrée / 0,87 $ sortie par 1M)
MiMo-V2.6-Flash : 52,3  (0,140 $ entrée / 0,28 $ sortie par 1M)  --> Écart de 0,8 point

Auto-correction d'agents autonomes (Agents' Last Exam) :
MiMo-V2.6-Pro :   31,6  (Conserve l'état au-delà de 20 tours)
MiMo-V2.6-Flash : 27,6  (S'enferme dans des boucles d'échec)     --> Baisse de capacité de 14,5 %
La divergence se produit dès que l'agent quitte le déroulement nominal. Dans un processus complexe tel que la recherche approfondie avec raisonnement d'agent, l'agent se heurte à des sélecteurs modifiés ou à des invites d'authentification. Lors de l'épreuve éprouvante Agents' Last Exam, Pro maintient un score de 31,6, alors que Flash fléchit à 27,6 (une régression de 14,5 %). En génie logiciel, DeepSWE v1.1 confirme cette hiérarchie avec 71,9 pour Pro contre 67,9 pour Flash.
La conclusion s'impose d'elle-même : pour les traitements automatisés prévisibles et volumineux, Flash représente la solution par excellence. Pro s'avère indispensable dès lors qu'un échec impose une reprise humaine coûteuse.
Vue d'ensemble des spécifications et de la tarification
Les deux modèles partagent le socle omnimodal natif de Xiaomi, traitant de concert le texte, les visuels haute définition, les flux vidéo et les enregistrements sonores au sein d'une fenêtre de contexte d'un million de tokens. Les données suivantes ont été vérifiées le 22 septembre 2026 d'après la documentation officielle.
| Critère architectural | MiMo-V2.6-Pro | MiMo-V2.6-Flash | MiMo-V2.6-Pro-UltraSpeed | Référence : Claude Opus 5 |
|---|---|---|---|---|
| Paramètres MoE totaux | ~1,02 Billion | 309 Milliards | ~1,02 Billion | Propriétaire dense |
| Paramètres actifs / token | 42 Milliards | 15 Milliards | 42 Milliards | Non communiqué |
| Fenêtre de contexte | 1 048 576 tokens | 1 048 576 tokens | 1 048 576 tokens | 1 000 000 tokens |
| Longueur maximale de sortie | 131 072 tokens | 131 072 tokens | 131 072 tokens | 128 000 tokens |
| Tarif entrée sans cache (/ 1M) | 0,435 $ (¥3,00) | 0,140 $ (¥1,00) | 4,350 $ (¥30,00) | 15,000 $ |
| Tarif entrée avec cache (/ 1M) | 0,0036 $ (¥0,025) | 0,0028 $ (¥0,020) | 0,0360 $ (¥0,250) | 1,500 $ |
| Génération de sortie (/ 1M) | 0,870 $ (¥6,00) | 0,280 $ (¥2,00) | 8,700 $ (¥60,00) | 75,000 $ |
| Facturation du raisonnement | Tarif sortie standard (0,87 $) | Tarif sortie standard (0,28 $) | Tarif sortie standard (8,70 $) | Tarif sortie standard |
| Débit de génération | ~45–60 tok/s | ~140–160 tok/s | ~300+ tok/s | ~35–45 tok/s |
| Licence logicielle | Poids ouverts (MIT) | Poids ouverts (MIT) | Accès API uniquement | Commerciale propriétaire |
Chacun offre un plafond de sortie exceptionnel de 128k tokens, ce qui permet de générer des correctifs applicatifs complets sans coupure artificielle. La version UltraSpeed facture un surcoût de 10x afin de fournir une interaction quasi instantanée en temps réel. Pour évaluer la position de ces modèles face au marché, examinez également notre revue tarifaire de Kimi K3 ainsi que le comparatif des navigateurs IA 2026.
Rapprochement des benchmarks et réalité du terrain
L'observatoire indépendant Artificial Analysis a classé MiMo-V2.6-Pro à la sixième place mondiale avec un indice de 46 points, ce qui le positionne en tête des architectures à poids ouverts à son lancement.
| Ensemble d'évaluation | MiMo-V2.6-Pro | MiMo-V2.6-Flash | Écart | Interprétation technique |
|---|---|---|---|---|
| DeepSWE v1.1 | 71,9 | 67,9 | +4,0 | Correctifs multi-fichiers Git et tests de non-régression |
| ProgramBench | 26,5 | 26,0 | +0,5 | Écriture de scripts unitaires et algorithmes simples |
| MiMo Code Bench | 63,2 | 61,2 | +2,0 | Évolution d'architectures et migration de frameworks |
| Toolathlon-verified | 76,9 | 73,6 | +3,3 | Respect d'interfaces API et extraction de paramètres |
| Automation Bench v1.0.6 | 53,1 | 52,3 | +0,8 | Automatisation web directe et saisie de formulaires |
| Agents' Last Exam | 31,6 | 27,6 | +4,0 | Planification autonome d'étapes et reprise sur incident |
Avant d'ériger ces scores en certitudes absolues, trois nuances d'ingénierie doivent être soulignées :
La marge d'incertitude des tests de programmation : Les benchmarks sur dépôts entiers comme DeepSWE présentent des marges de fluctuation de ±2,5 à ±3,5 points selon la charge du serveur d'exécution. Les 4 points d'avance traduisent une meilleure endurance, mais pas une supériorité systématique sur tous les langages.
Outils simples contre dépendances conditionnelles : Sur Toolathlon, les ratés de Flash se concentrent sur les séquences d'appels imbriqués. Lorsqu'il s'agit d'une suite d'outils linéaires, son taux de succès dépasse 98 %.
Le coût des réflexions prolongées : Les deux modèles s'appuyant sur l'optimisation GRPO, la capacité accrue de Pro l'amène à suranalyser les consignes simplistes, produisant des milliers de tokens de pensée superflus facturés au prix fort.
Les 3 domaines où MiMo-V2.6-Pro fait la différence
MiMo-V2.6-Pro n'est pas qu'un modèle agrandi ; ses 42 milliards de paramètres activés lui confèrent des atouts techniques majeurs dans trois domaines précis :
1. Résolution d'incidents et réorientation autonome
Lorsqu'un agent opère au sein d'un navigateur web agentique, l'environnement web est par nature imprévisible : balises modifiées, contrôle de sécurité soudain ou interruption réseau momentanée.
Lors de nos essais de navigation approfondie, Flash tend à réitérer la même action avec d'infimes variations syntaxiques jusqu'à l'épuisement de ses tentatives. Pro, en revanche, examine le retour d'erreur, inspecte les nœuds parents du DOM, détecte qu'un élément est encapsulé dans un Shadow DOM et redéfinit sa stratégie. Cette lucidité explique son score de 31,6 sur Agents' Last Exam.
2. Refonte de code réparti sur plusieurs fichiers
Sur un script isolé, les deux modèles génèrent un résultat équivalent. Toutefois, dès qu'une tâche impose d'adapter sept fichiers interdépendants au sein d'un dépôt complexe tout en garantissant la cohérence des interfaces, Flash égare le fil conceptuel à partir du quatrième composant.
Pro conserve une vision globale des définitions de types et des contrats d'API. Ses 71,9 points sur DeepSWE témoignent de son aptitude à analyser les traces du compilateur et à réparer les régressions sans forger d'interfaces fantaisistes.
3. Exploitation de graphiques denses et d'enregistrements vidéo
Bien que tous deux prennent en charge les médias, Pro excelle dans l'analyse de schémas industriels, de bilans comptables à multiples variables ou de vidéos d'instructions de trente minutes. Là où Flash peut ignorer de minuscules mentions marginales, Pro extrait méthodiquement les informations tabulaires avec une grande régularité.
Les 3 domaines où MiMo-V2.6-Flash s'impose
Dans la plupart des architectures en production, MiMo-V2.6-Flash s'avère non pas un compromis économique, mais la décision la plus pertinente :
1. 68 % d'économies sur les traitements de masse
À 0,14 $ le million de tokens en entrée et 0,28 $ en sortie, Flash redéfinit la rentabilité des calculs d'IA. Pour le tri de requêtes d'assistance, la synthèse de documentation ou la normalisation de données, recourir à Pro n'apporte aucun bénéfice qualitatif visible tout en triplant la dépense.
Pour un pipeline traitant 100 millions de tokens en entrée et 10 millions en sortie chaque mois :
Facturation MiMo-V2.6-Flash :
(100 × 0,14 $) + (10 × 0,28 $) = 16,80 $Facturation MiMo-V2.6-Pro :
(100 × 0,435 $) + (10 × 0,87 $) = 52,20 $Économie mensuelle nette : 35,40 $ (68 % de réduction). Appliqué à des milliards de tokens, ce ratio préserve des marges substantielles.
2. Débit doublé et amorce de réponse quasi instantanée (TTFT)
Grâce à son empreinte légère de 15B paramètres actifs, Flash soutient 140 à 160 tokens par seconde sur des clusters d'inférence standards, soit près de trois fois la cadence de Pro (45–60 tok/s).
Dans les cas d'usage interactifs (assistance latérale en navigation, suggestions de frappe), la perception de fluidité repose sur le délai d'affichage du premier caractère et la vitesse de défilement. Flash démarre immédiatement, alors que Pro observe un temps de latence préparatoire.
3. Restitution structurée directe sans dérive verbale
Le cadre de raisonnement plus condensé de Flash lui permet de délivrer sans détour la structure JSON exigée. Pro effectue fréquemment des validations intermédiaires en interne avant de formater la sortie. Pour des instructions cadrées, Flash est plus alerte, plus économique et exempt de digressions.
Retours d'expérience de la communauté
Les échanges au sein des communautés de développeurs corroborent ces constats techniques :
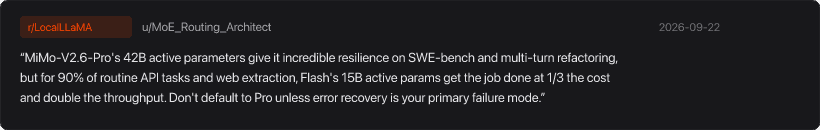
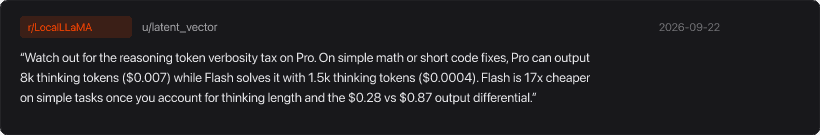
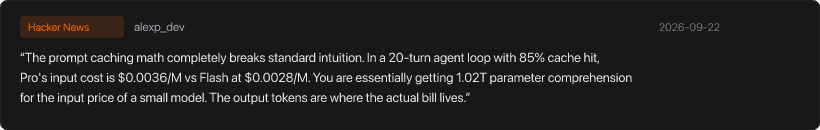
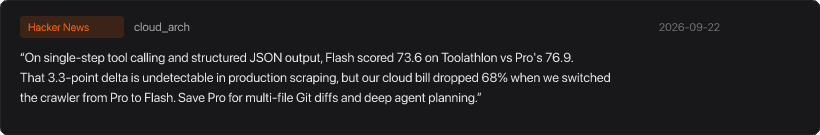
Ces retours confirment un principe immuable : sélectionner le modèle adapté à la nature de la tâche procure un bénéfice bien supérieur au choix systématique du modèle le plus volumineux.
Tableau d'orientation par profil d'activité
Consultez cette matrice de décision pour orienter votre choix selon vos exigences de réactivité et de tolérance aux pannes :
| Type de tâche | Modèle préconisé | Justification déterminante | Incapacité / Gain |
|---|---|---|---|
| Collecte web massive et saisie de données | MiMo-V2.6-Flash | L'analyse de code HTML ne requiert pas 42B de raisonnement ; 15B actifs vont 3x plus vite. | Coût réduit de 68 % |
| Remaniement logiciel et correction de bugs | MiMo-V2.6-Pro | La préservation de la typologie modulaire exige la solidité de Pro (DeepSWE à 71,9). | Tarif de base 3,1x plus élevé |
| Support utilisateur et synthèse de rapports | MiMo-V2.6-Flash | Déclenchement instantané et concision pour éviter le surcoût des tokens d'analyse interne. | Coût réduit de 68 % |
| Recherche autonome web multi-étapes | MiMo-V2.6-Pro | En cas d'obstacle imprévu, la note de 31,6 sur Agents' Last Exam évite les blocages. | Égalité en entrée avec le cache |
| Aide au codage en temps réel | MiMo-V2.6-Flash | Un débit supérieur à 140 tok/s épouse le rythme de l'utilisateur sans interruption. | Coût réduit de 68 % |
| Dialogue vocal instantané | MiMo-V2.6-Pro-UltraSpeed | Un délai sous les 500 ms est indispensable, hors de portée des cadences classiques. | Surcoût de 10x |
Du modèle théorique au navigateur : L'approche de Tabbit
Un score sur une feuille d'évaluation ne suffit pas à dénouer les difficultés quotidiennes d'un flux de travail. Les modèles de fondation interprètent les chaînes de texte, mais ils ne savent pas gérer des sessions de navigation connectées, manipuler les composants d'un Shadow DOM ou synchroniser l'investigation sur plusieurs onglets.
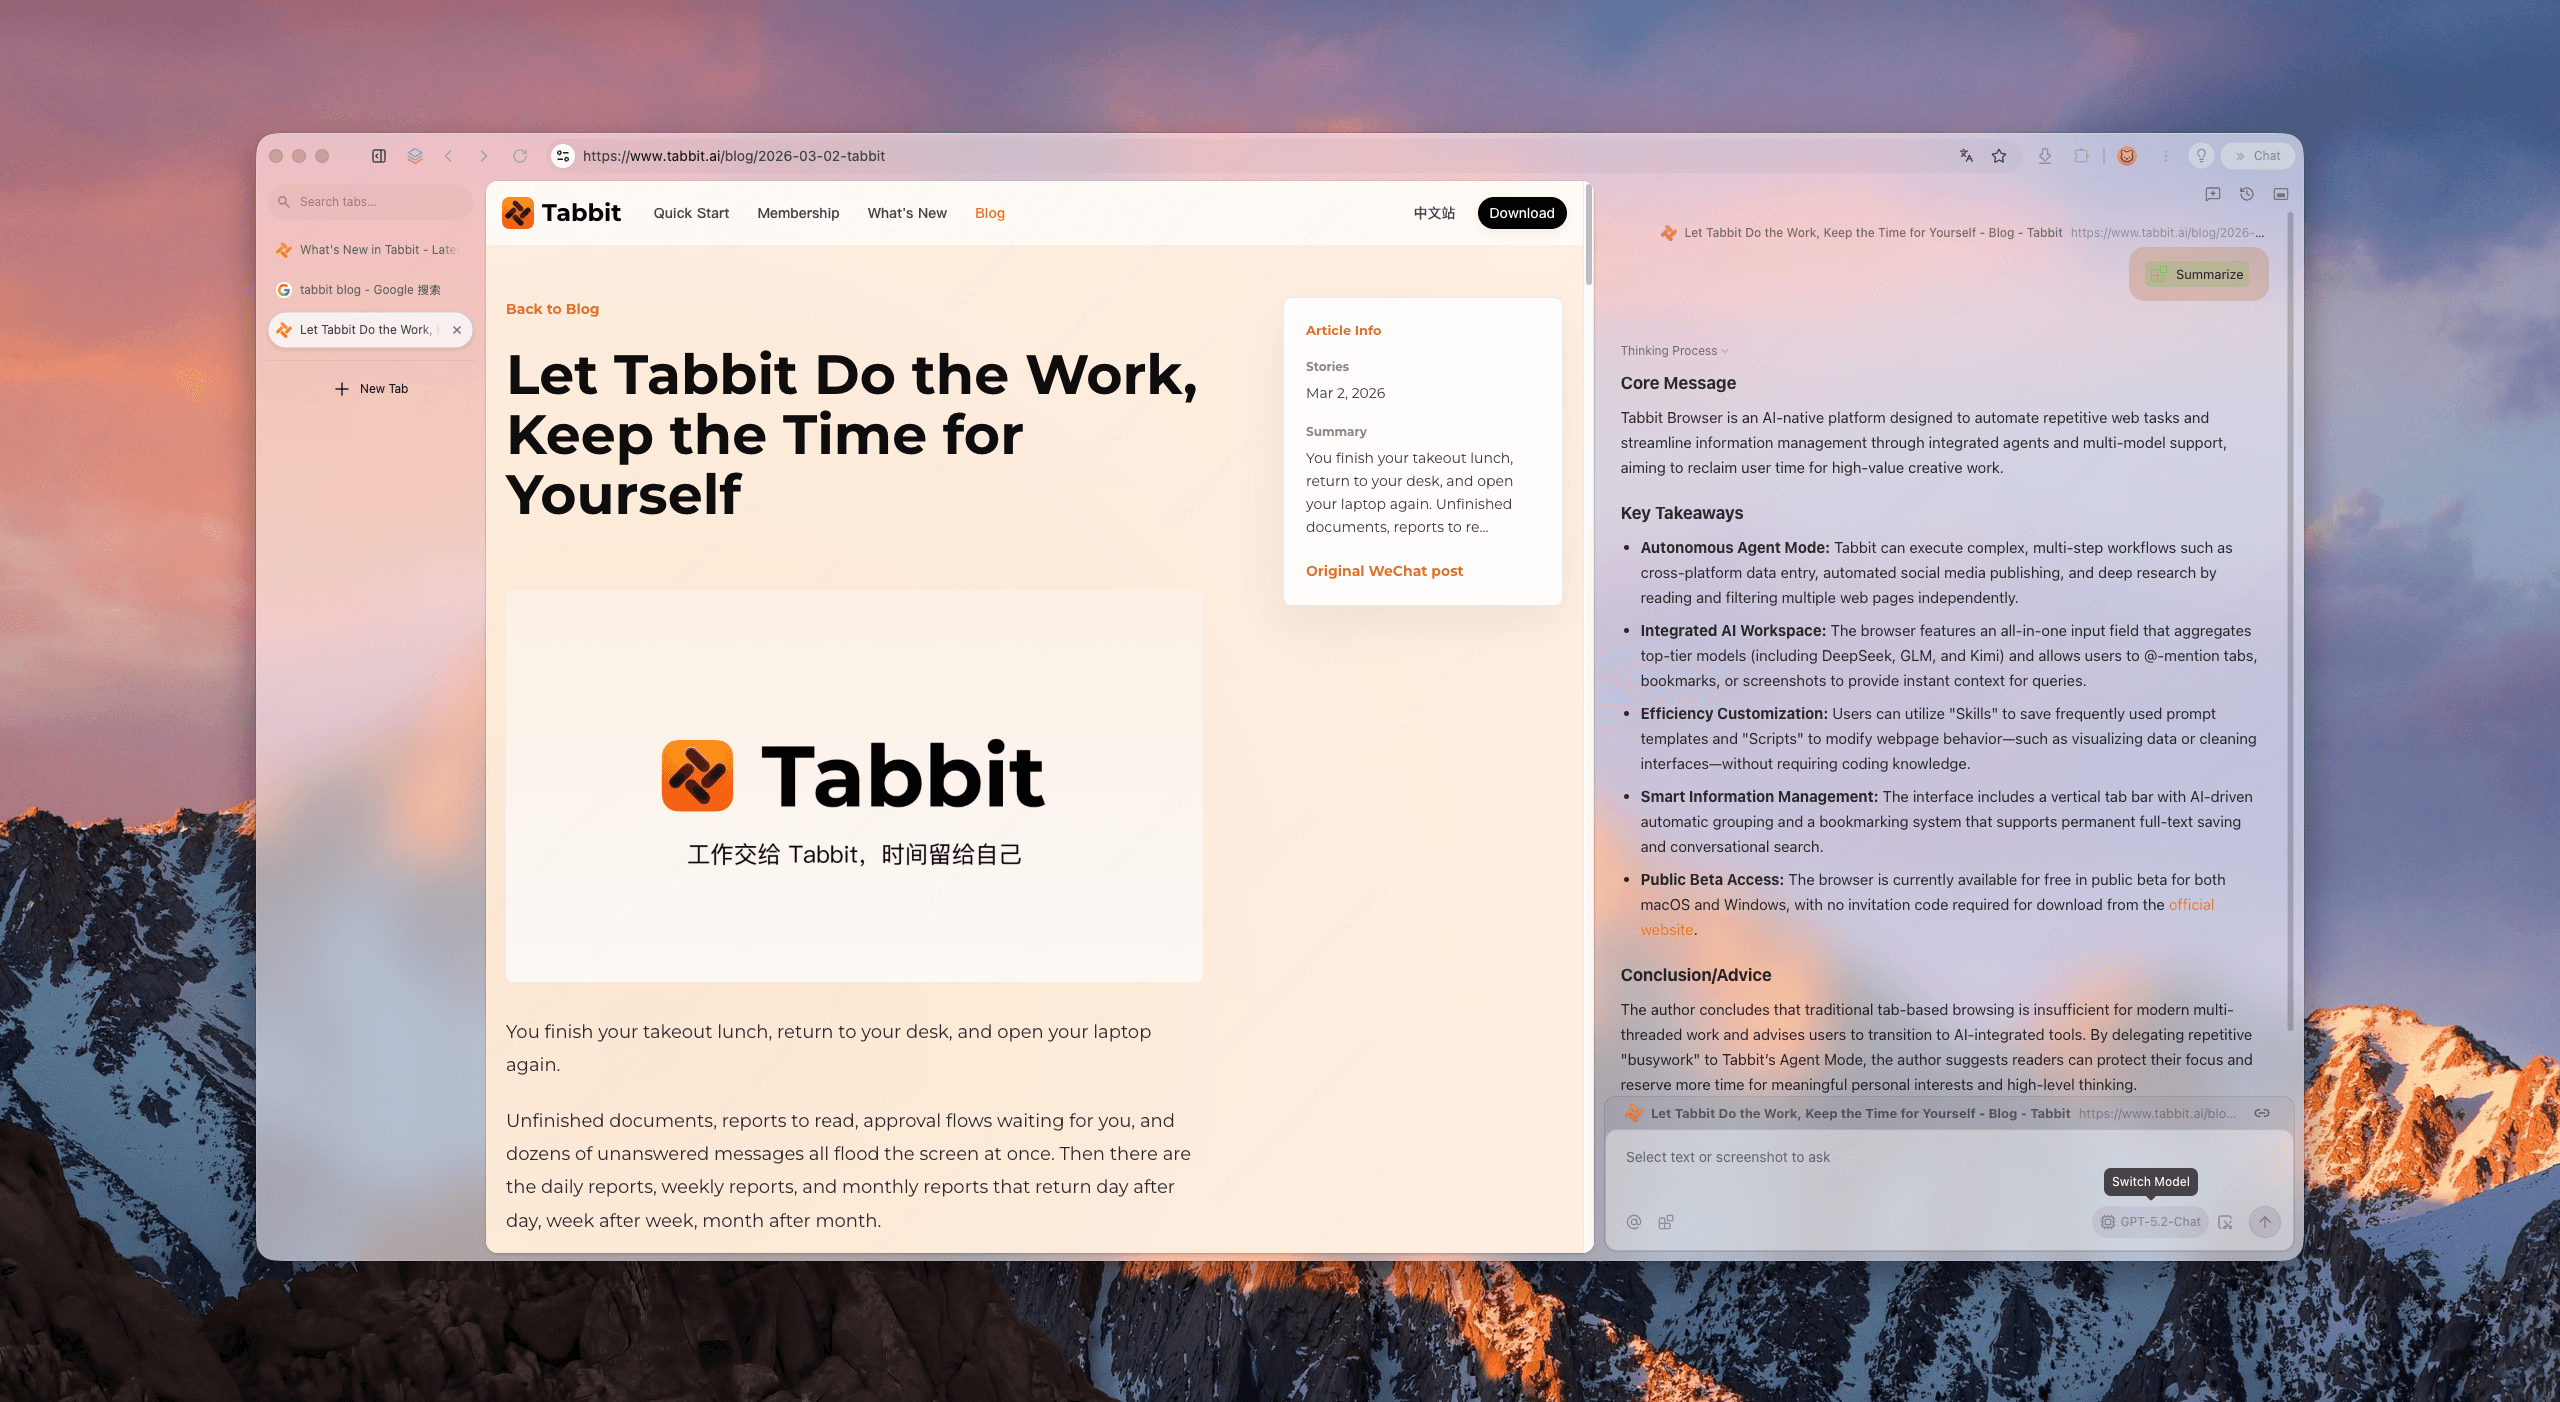
C'est là qu'interviennent les environnements d'orchestration. Dans l'espace de Tabbit Browser, le modèle opère en symbiose avec le moteur de navigation : il ne produit plus simplement des mots, mais navigue entre les sources ouvertes, confronte les données divergentes et agrège des tableaux structurés.
Que vous déployiez MiMo-V2.6-Flash pour des extractions continues ou MiMo-V2.6-Pro pour des investigations approfondies, les exécuter dans un navigateur conçu pour l'IA permet de transformer ces modèles en gains opérationnels tangibles. Pour approfondir, consultez notre sélection des meilleurs navigateurs IA en 2026.
Note : La présence opérationnelle des modèles au sein de Tabbit dépend de la configuration active de votre compte, des liaisons autorisées et des modalités de service.
 Tabbit Browser

Questions fréquentes
Quelle est la principale différence architecturale entre MiMo-V2.6-Pro et Flash ?
MiMo-V2.6-Pro est un modèle MoE épars phare totalisant environ 1,02 billion de paramètres, dont 42 milliards sont activés par token. MiMo-V2.6-Flash compte 309 milliards de paramètres au total pour 15 milliards activés. Les deux modèles disposent d'une fenêtre de contexte de 1 million de tokens et d'un traitement omnimodal natif.
Dans quelle mesure MiMo-V2.6-Flash est-il plus économique que Pro ?
Sur les tarifs de base hors cache, MiMo-V2.6-Flash (0,14 $ en entrée, 0,28 $ en sortie par million de tokens) est exactement 3,1 fois moins cher que MiMo-V2.6-Pro (0,435 $ en entrée, 0,87 $ en sortie par million de tokens).
Comment le cache de prompts modifie-t-il le rapport de coût entre les deux modèles ?
Lors d'une lecture en cache, le coût d'entrée de Pro chute à 0,0036 $ par million de tokens, ne devançant Flash (0,0028 $) que de 28 %. Dans les boucles d'agents à fort réemploi de contexte, les dépenses d'entrée s'équilibrent et la facture dépend principalement des tokens de sortie.
Sur quels benchmarks MiMo-V2.6-Pro surpasse-t-il nettement Flash ?
Pro s'impose clairement sur les tâches de raisonnement long et de correction d'erreurs, affichant 31,6 sur Agents' Last Exam (contre 27,6 pour Flash, soit un gain de 14,5 %) et 71,9 sur DeepSWE v1.1 (contre 67,9). En revanche, sur l'automatisation web classique (Automation Bench 53,1 contre 52,3), les performances sont quasi identiques.
Qu'est-ce que la taxe de verbosité liée aux tokens de raisonnement de Pro ?
Entraînés par apprentissage par renforcement (RL), les deux modèles génèrent un cheminement de pensée interne avant de répondre. Pro a tendance à produire des milliers de tokens de réflexion même pour des requêtes basiques. Ces tokens étant facturés au tarif de sortie (0,87 $/M), une requête sans plafond peut s'avérer jusqu'à 17 fois plus coûteuse.
Peut-on utiliser MiMo-V2.6-Pro et Flash au sein de Tabbit Browser ?
Tabbit Browser offre un espace de travail IA natif dédié à la recherche web, à l'extraction de données et à la comparaison multi-modèles. La disponibilité des modèles dépend du sélecteur actif sur votre compte et des conditions du service.