
同一のモデルファミリー内での選定は、どちらが優れているかを決める単純な優劣競争ではなく、エンジニアリングリソースの適切な配分作業です。2026 年 9 月 22 日、Xiaomi は MIT ライセンスのもとでオムニモーダル基盤モデルファミリー MiMo-V2.6 をオープンソース化し、2 つの主要ティアを発表しました。フラッグシップ MoE である MiMo-V2.6-Pro と、高効率な MiMo-V2.6-Flash です。
日々モデルを本番ソフトウェアや自律型エージェントに組み込んでいるエンジニアとして、私はベンダー発表のマーケティング数値をそのまま鵜呑みにすることはありません。実運用において真に重要なのは、DOM が動的に書き換わり、API が散発的なエラーを返し、コンテキストが何十万トークンにも膨らんだ 30 ターンのセッションで、モデルが破綻せずに自律稼働し続けられるかどうかです。
公式の料金体系や計算式については、すでに公開済みの MiMo-V2.6-Pro 料金ガイド や MiMo-V2.6-Flash 料金解説 をご参照ください。また、ハードウェア仕様は MiMo-V2.6-Pro モデル詳細 (English) および MiMo-V2.6-Flash モデル詳細 (English) で確認できます。本記事は、直接的な技術対決として、1.02 兆パラメータのフラッグシップがその価格差を証明する領域、Flash が 3 分の 1 のコストで完全な代替となる領域、そしてキャッシュ機能がコスト常識を覆す理由を解説します。
主要な結論
未キャッシュ料金は正確に 3.1 倍の差:Flash は入力 $0.14、出力 $0.28 / 100 万トークンであるのに対し、Pro は入力 $0.435、出力 $0.87 です。
キャッシュヒットが入力費用の差を無効化:85% 以上のプロンプトキャッシュヒット率では、Pro の読み取りコストは $0.0036 / 1M となり、Flash の $0.0028 とわずか 28% の差に縮まります。小型モデルの入力コストで 1 兆パラメータモデルを実行できます。
一般的な自動化タスクでは同等:Web 画面遷移やフォーム抽出(Automation Bench: 53.1 対 52.3)において、Flash は Pro の 98.5% の性能をわずか 32% のコストで達成します。
長期間エージェントでの決定的な性能差:予期せぬエラーの自己修復やリポジトリ規模のコード改修において、Pro は 14.5% の明確な優位性を確立します(Agents' Last Exam: 31.6 対 27.6、DeepSWE v1.1: 71.9 対 67.9)。
単純なタスクでの過剰思考に注意:Pro は簡単な質問でも 8,000 トークンの思考を行う場合があり、出力課金によって Flash の 17 倍の費用がかかるリスクがあります。
決断を分ける指標:3.1 倍の価格差 対 0.8 ポイントの自動化差
この比較の核心は、相反する 2 つの数字にあります。3.1 倍の価格差 と、わずか 0.8 ポイントの自動化性能差 です。
アーキテクチャ上、MiMo-V2.6-Pro は 1.02 兆パラメータの MoE ネットワークから トークンあたり 420 億のアクティブパラメータ を動員します。MiMo-V2.6-Flash は 3090 億パラメータから 150 億パラメータ を活性化します。これは 2.8 倍のアクティブ計算量の差であり、Xiaomi の公式レートカード($0.435 対 $0.14)にも反映されています。
しかし、複数ステップの Web 操作や DOM 抽出を測定する Automation Bench v1.0.6 では、Pro のスコアが 53.1、Flash が 52.3 です。ProgramBench の単一関数コード生成でも、Pro が 26.5、Flash が 26.0 となっています。日常的な Web スクレイピングや定型的な処理において、1.5% 未満の微細な差のために 310% の追加料金を払うのは非効率的です。
一般的なツール呼び出し(Automation Bench):
MiMo-V2.6-Pro:   53.1  (入力 $0.435 / 出力 $0.87 / 100万トークン)
MiMo-V2.6-Flash: 52.3  (入力 $0.140 / 出力 $0.28 / 100万トークン)  --> わずか 0.8 ポイント差

長期間エージェントの自己修復(Agents' Last Exam):
MiMo-V2.6-Pro:   31.6  (20 ターン以上の相互作用後も文脈を維持)
MiMo-V2.6-Flash: 27.6 (同じ誤りを繰り返すループに陥る) --> 性能が 14.5% 低下明確な性能乖離が現れるのは、自律型エージェントが定型パターンから外れた瞬間です。自律型推論とディープリサーチ のような高度なワークフローでは、Web セレクターの変更や動的認証に遭遇します。過酷な Agents' Last Exam ベンチマークにおいて、Pro は 31.6 を維持しますが、Flash は 27.6 へと 14.5% 落ち込みます。ソフトウェア開発テストの DeepSWE v1.1 でも、Pro の 71.9 に対して Flash は 67.9 に留まります。
指針は明確です。定型的で大量処理が必要なパイプラインには Flash を選び、人間の介入なしに失敗から復旧する必要があるタスクには Pro が必須の保険となります。
仕様、アーキテクチャ、価格一覧
両モデルとも、100 万トークンの単一コンテキスト内で、テキスト、高解像度画像、ビデオストリーム、音声をネイティブに処理する Xiaomi のオムニモーダル基盤を共有しています。以下の仕様は 2026 年 9 月 22 日に公式資料に基づき確認されたものです。
| アーキテクチャ項目 | MiMo-V2.6-Pro | MiMo-V2.6-Flash | MiMo-V2.6-Pro-UltraSpeed | 参考:Claude Opus 5 |
|---|---|---|---|---|
| MoE 総パラメータ数 | 約 1.02 兆 | 3090 億 | 約 1.02 兆 | 独自高密度設計 |
| アクティブパラメータ / トークン | 420 億 | 150 億 | 420 億 | 非公開 |
| コンテキストウィンドウ | 1,048,576 トークン | 1,048,576 トークン | 1,048,576 トークン | 1,000,000 トークン |
| 最大出力長 | 131,072 トークン | 131,072 トークン | 131,072 トークン | 128,000 トークン |
| 未キャッシュ入力料金(/ 1M) | $0.435(¥3.00) | $0.140(¥1.00) | $4.350(¥30.00) | $15.000 |
| キャッシュ読み取り料金(/ 1M) | $0.0036(¥0.025) | $0.0028(¥0.020) | $0.0360(¥0.250) | $1.500 |
| 出力生成料金(/ 1M) | $0.870(¥6.00) | $0.280(¥2.00) | $8.700(¥60.00) | $75.000 |
| 推論トークン課金 | 通常出力枠($0.87) | 通常出力枠($0.28) | 通常出力枠($8.70) | 通常出力枠 |
| スループット速度 | 約 45–60 tok/s | 約 140–160 tok/s | 約 300+ tok/s | 約 35–45 tok/s |
| ライセンス | オープンウェイト(MIT) | オープンウェイト(MIT) | API 提供のみ | 商用プロプライエタリ |
両モデルとも 128k という膨大な最大出力制限を備えており、巨大なコードベースの修正パッチも途切れずに生成できます。UltraSpeed バリアントは 10 倍の料金でリアルタイム応答を提供します。他社モデルとの比較については、Kimi K3 料金レビュー や 2026 年最新 AI ブラウザ比較 もご覧ください。
ベンチマーク検証と実務的解釈
Artificial Analysis の最新インデックスにおいて、MiMo-V2.6-Pro は総合知能スコア 46 で世界第 6 位にランクインし、オープンウェイトモデルとしてトップに立ちました。
| ベンチマーク名 | MiMo-V2.6-Pro | MiMo-V2.6-Flash | 差分 | 実務上の意義 |
|---|---|---|---|---|
| DeepSWE v1.1 | 71.9 | 67.9 | +4.0 | 複数ファイル Git パッチ適用、回帰テスト通過率 |
| ProgramBench | 26.5 | 26.0 | +0.5 | 単一アルゴリズム関数の実装 |
| MiMo Code Bench | 63.2 | 61.2 | +2.0 | フレームワーク移行や複雑なアーキテクチャ設計 |
| Toolathlon-verified | 76.9 | 73.6 | +3.3 | 複雑なスキーマ遵守と引数抽出 |
| Automation Bench v1.0.6 | 53.1 | 52.3 | +0.8 | 定型的な Web 自動化、フォーム入力 |
| Agents' Last Exam | 31.6 | 27.6 | +4.0 | 動的環境での長期間計画、例外からの自己修復 |
これらの数値を実務に適用する際は、以下の 3 点を客観的に評価する必要があります。
ソフトウェア工学テストの誤差範囲:DeepSWE のようなリポジトリ全体のテストには通常 ±2.5〜±3.5 ポイントの誤差が伴います。4.0 ポイントの差は確かな能力差を示していますが、すべてのコードベースで圧倒的な違いを生むわけではありません。
階層型ツールの有無:Toolathlon において、Flash の失点は主に多重ネストされた条件付きツール呼び出しで発生しています。単純な単層のツール呼び出しでは、Flash の精度は 98% を超えます。
推論思考の肥大化:強化学習(GRPO)の影響で、Pro の 42B アクティブパラメータは単純な質問に対しても深く考えすぎる傾向があります。出力トークン課金制では、この思考トレースが予想外のコスト増を招きます。
MiMo-V2.6-Pro が真に勝る 3 つの場面
MiMo-V2.6-Pro は単にパラメータを増やしただけではなく、以下の 3 つの場面で明確な構造的優位性を発揮します。
1. 長期間の自己修復と複雑なエージェント障害対応
AI ネイティブな自律型ブラウザ 内でエージェントを自律動作させる際、DOM 変更や二要素認証、予期せぬ API エラーが日常的に発生します。
複数ターンの収集テストにおいて、Flash は初期セレクターが失敗すると同じ誤りを繰り返すループに陥りがちです。対照的に、Pro は大きな容量を活かしてエラー内容を分析し、DOM ツリーを再探索して Shadow DOM 内に対象が隠れていることを見抜き、別のアプローチへ柔軟に軌道修正します。これが Agents' Last Exam で 31.6 を叩き出す原動力です。
2. 複数ファイルにまたがるコードリファクタリング
単一のスクリプト作成では両者の差はわずかです。しかし、モノレポ全体で 7 つの関連ファイルを変更し、型定義の一貫性を保つタスクでは、Flash は 4 つ目以降のファイルで文脈を見失い始めます。
Pro はプロンプト全体でシンボルテーブルとアーキテクチャの契約を確実に保持します。DeepSWE で 71.9 を記録した能力は、コンパイラエラーを正確に読み取り、実在しない架空の関数を捏造することなくモジュール間を修正できる強みによるものです。
3. 高密度なビジュアルおよび長尺ビデオの理解
両モデルともマルチモーダル入力をサポートしていますが、複雑な回路図や多軸グラフ、30 分に及ぶ製品デモ動画など、情報密度が極めて高いコンテンツの解析では Pro が際立ちます。Flash では見落としがちな小さな注記も、Pro は正確に表形式データとして抽出します。
MiMo-V2.6-Flash が真に勝る 3 つの場面
実世界の多くの本番運用環境では、MiMo-V2.6-Flash は妥協策ではなく、最も合理的で優れた選択肢となります。
1. 大量処理パイプラインにおける 68% のコスト削減
入力 $0.14、出力 $0.28 / 1M トークンという価格設定は、圧倒的な経済的優位性を提供します。サポートチケットの分類、文書要約、構造化データの抽出などにおいて、Pro を使用しても品質差は現れず、単に請求額が 3 倍に跳ね上がるだけです。
月間 1 億入力トークン、1,000 万出力トークンのワークロードの場合:
MiMo-V2.6-Flash の費用:
(100 × $0.14) + (10 × $0.28) = $16.80MiMo-V2.6-Pro の費用:
(100 × $0.435) + (10 × $0.87) = $52.20月間削減額:$35.40(68% のコスト削減)。これが数十億トークン規模になれば、年間数千ドル規模の利益差となります。
2. スループットの倍増と低遅延(高速な TTFT)
15B の軽量アクティブパラメータにより、Flash は一般的な推論環境で 毎秒 140〜160 トークン を出力し、Pro(45〜60 tok/s)の約 3 倍の速度を誇ります。
ブラウザのサイドバー要約やリアルタイム対話など、人間が待機する画面では、最初のトークンが出るまでの時間(TTFT)とストリーミング速度が体感品質を決定します。Flash は即座に応答を開始し、ユーザーの思考を妨げません。
3. 過剰思考のない簡潔で整った構造化出力
Flash の思考プロセスはよりコンパクトに設計されているため、求められた JSON 形式をダイレクトに返します。Pro が内部で長々と推論検証を行うのに対し、Flash は即座に出力するため、出力トークン課金を大幅に抑えられます。
コミュニティ開発者の実際の声
開発者コミュニティでの議論からも、これらの特徴が実証されています。
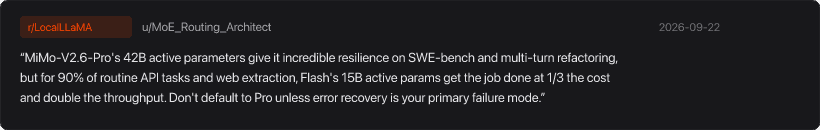
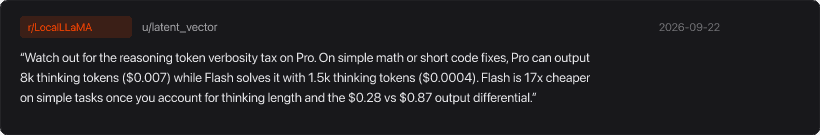
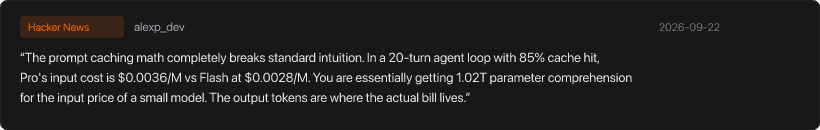
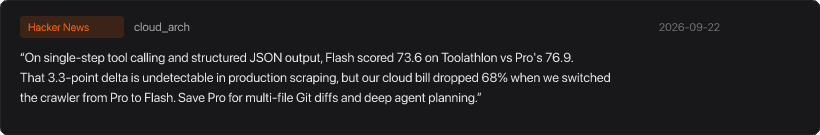
これらの声が示す結論は一つです。常に最大パラメータのモデルを選ぶのではなく、タスクの性質に応じてモデルを切り替えることが最も効果的です。
ワークロード別選定マトリクス
業務要件、遅延の許容度、および失敗時のリカバリ難易度に応じて、以下の選定表を参考にしてください。
| ワークロード分類 | 推奨モデル | 主な選定理由 | コストへの影響 |
|---|---|---|---|
| 大規模な Web スクレイピングと抽出 | MiMo-V2.6-Flash | DOM 構造解析に 42B の複雑推論は不要。15B が 3 倍速く低コスト。 | 68% の費用削減 |
| 複数ファイルのコード修正・リファクタリング | MiMo-V2.6-Pro | 依存関係の整合性維持に Pro の DeepSWE 性能(71.9 対 67.9)が必須。 | 3.1 倍の基本料金 |
| カスタマーサポート分類とドキュメント要約 | MiMo-V2.6-Flash | 優れた初回応答速度と簡潔な回答により、無駄な思考課金を回避。 | 68% の費用削減 |
| 自律的なマルチステップ Web リサーチ | MiMo-V2.6-Pro | 予期せぬ画面変化時に、Agents' Last Exam 31.6 の自律復旧力が不可欠。 | キャッシュ活用で入力費は同等 |
| リアルタイムのコード補全・インライン入力 | MiMo-V2.6-Flash | 人間の思考速度に合わせた 140+ tok/s の即時スループットが最適。 | 68% の費用削減 |
| 超低遅延のリアルタイム音声対話 | MiMo-V2.6-Pro-UltraSpeed | 500ms 未満の応答が求められ、通常速度のモデルでは対応困難な場合。 | 10 倍の料金プレミアム |
単体のモデルからブラウザ自動化へ:Tabbit による統合
技術仕様書のスコアだけでは、日常の業務課題は解決しません。素の言語モデルはテキストやトークンを理解しますが、認証されたセッション情報の管理や、複雑な Shadow DOM の操作、複数タブを跨いだ情報比較を自律的に行うことはできません。
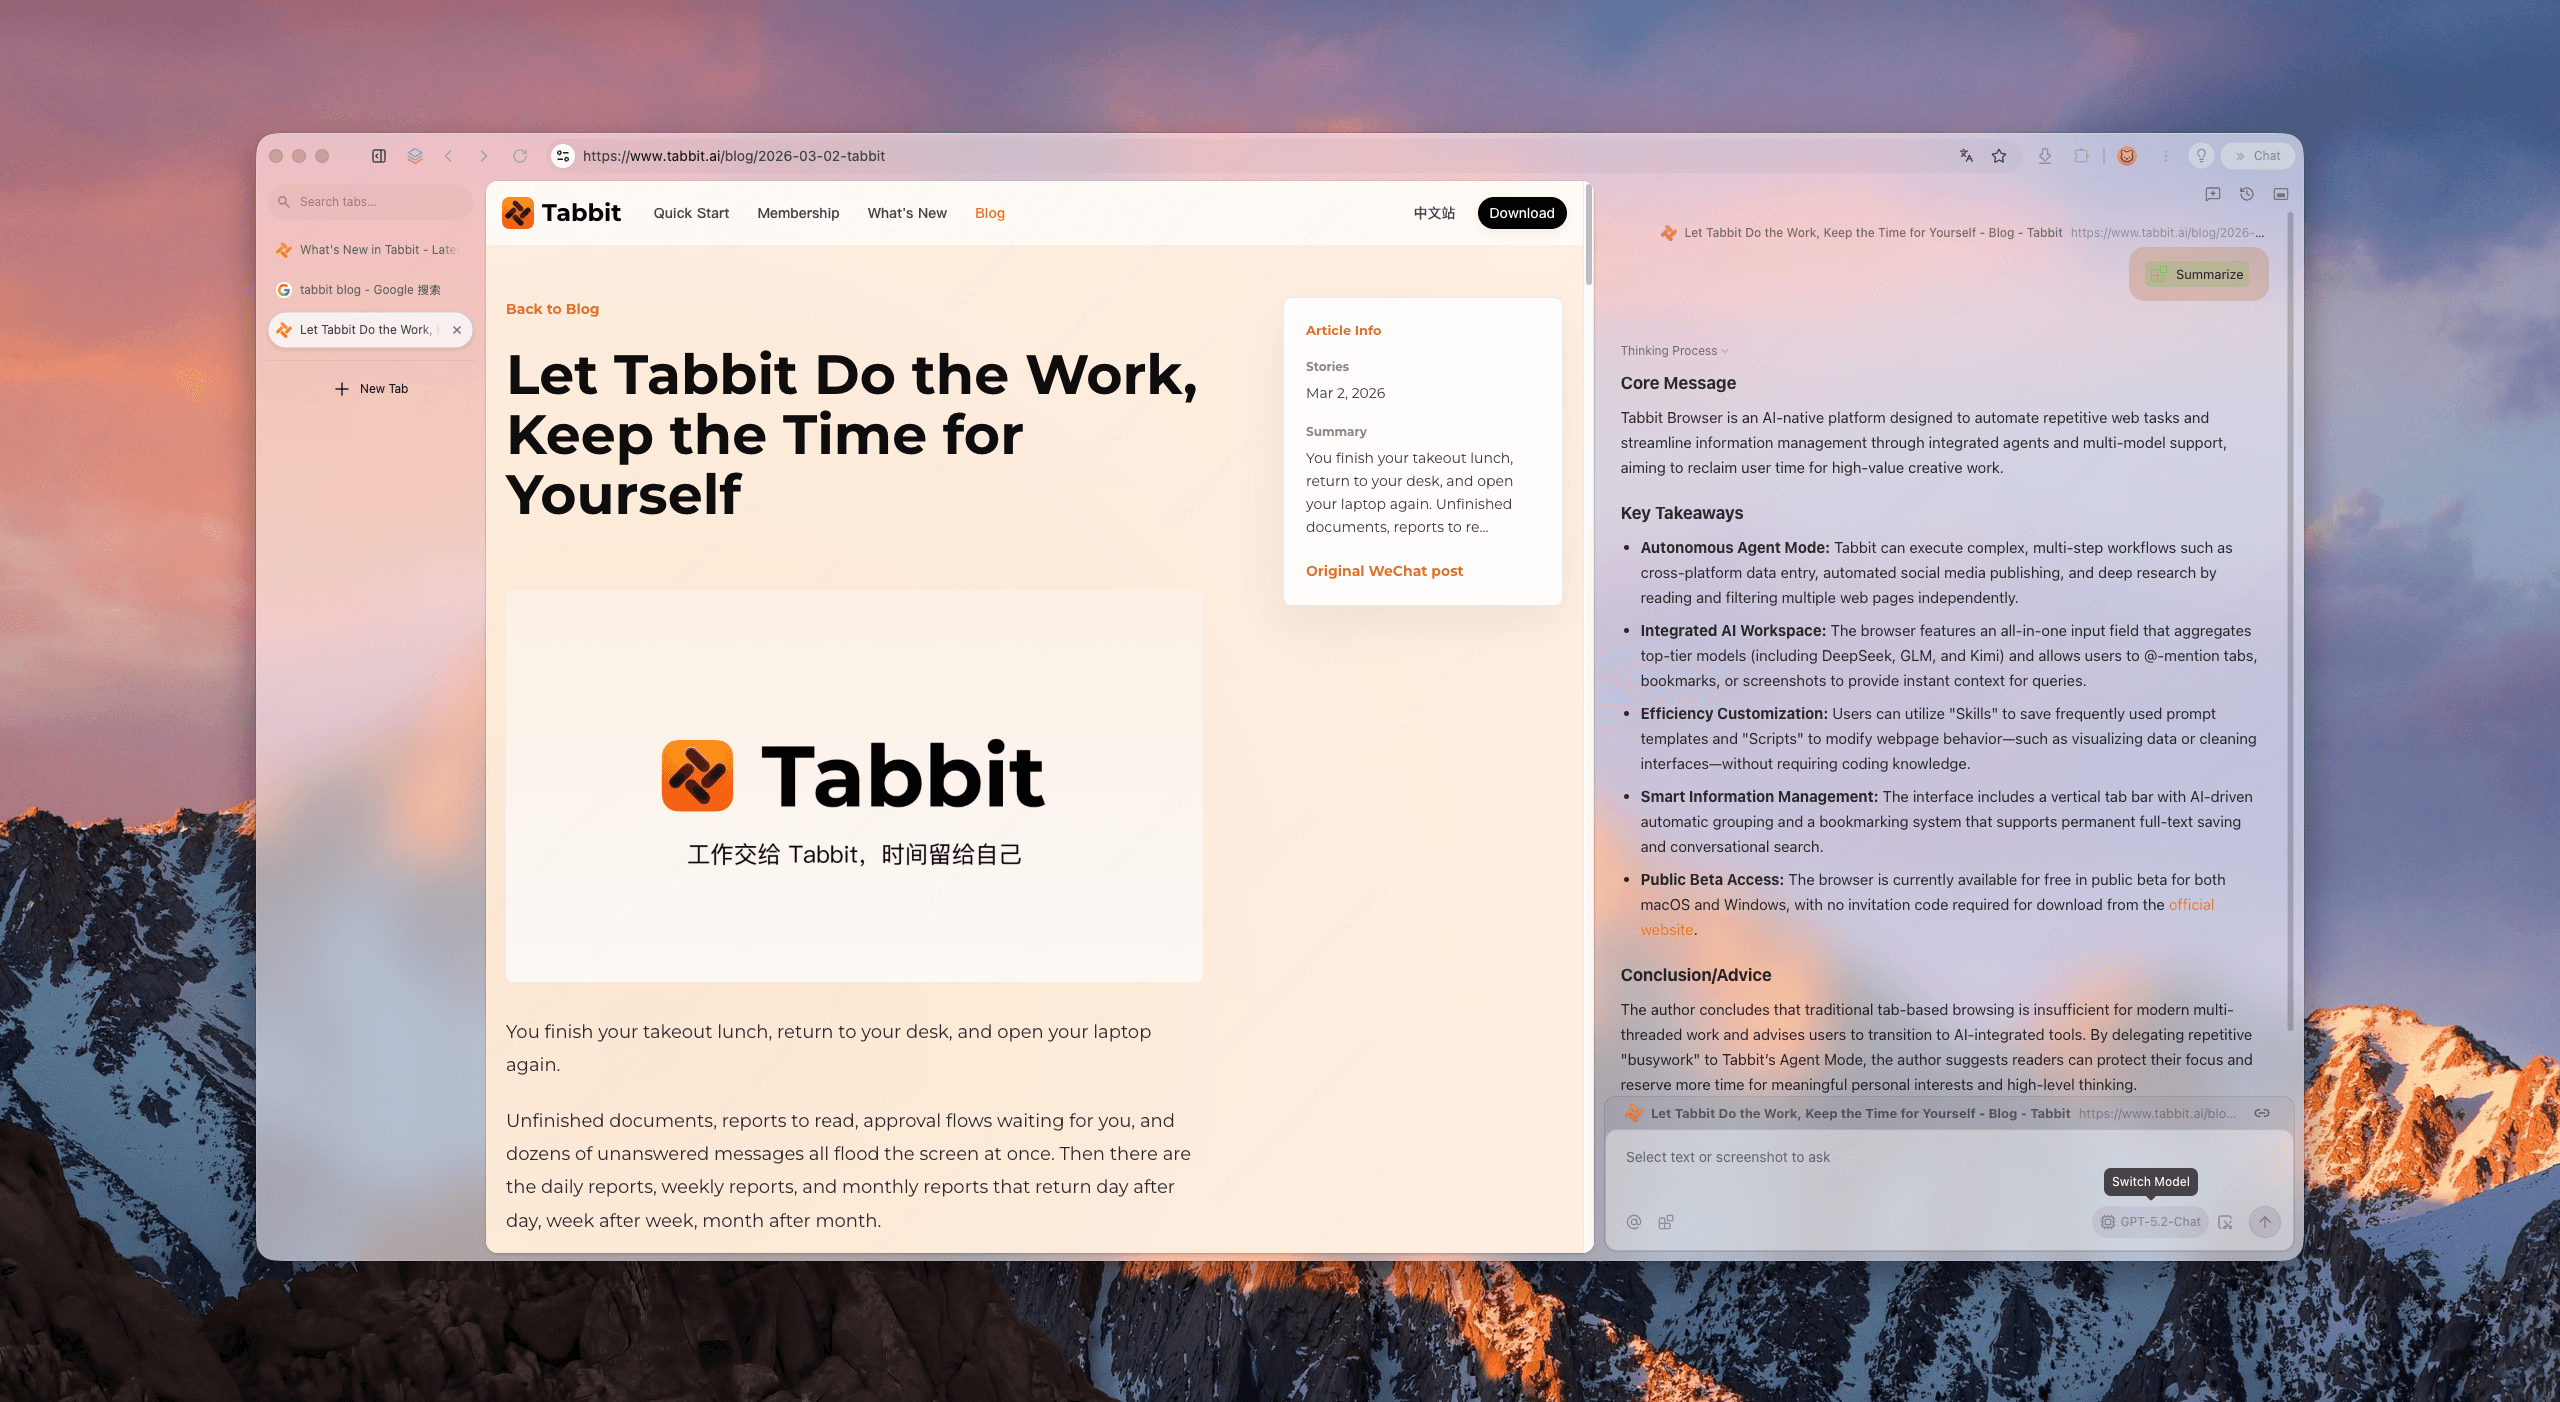
それこそがエージェント環境が存在する理由です。Tabbit ブラウザ の作業領域では、モデルと実行環境が緊密に連携します。モデルは単に回答を返すだけでなく、開いているタブ間を行き来して矛盾点を調査し、Web アプリケーションから正確なデータを収集します。
MiMo-V2.6-Flash を使って軽量なデータ収集を行う場合でも、MiMo-V2.6-Pro を活用して複雑な調査を進める場合でも、AI ネイティブなブラウザで動かして初めて真の生産性が発揮されます。詳細は 2026 年のおすすめ AI ブラウザまとめ もご覧ください。
※ ご利用のアカウントのモデルセレクターや契約内容により、Tabbit 内での特定モデルの提供状況は異なります。
 Tabbit Browser

よくある質問
MiMo-V2.6-Pro と Flash の主なアーキテクチャの違いは何ですか?
MiMo-V2.6-Pro は総パラメータ約 1.02 兆、トークンあたり 420 億パラメータを活性化するフラッグシップ MoE モデルです。MiMo-V2.6-Flash は総パラメータ 3090 億、トークンあたり 150 億パラメータを活性化する軽量・高効率版です。両モデルとも 100 万トークンのコンテキストウィンドウとネイティブなオムニモーダル入力を備えています。
MiMo-V2.6-Flash は Pro と比べてどのくらい安価ですか?
未キャッシュの基本料金において、Flash(入力 $0.14、出力 $0.28 / 100 万トークン)は Pro(入力 $0.435、出力 $0.87 / 100 万トークン)と比べて正確に 3.1 倍安価です。日本円換算でも同様の明確なコスト削減効果があります。
プロンプトキャッシュは両者のコスト比較にどう影響しますか?
プロンプトキャッシュにヒットした場合、Pro の入力コストは $0.0036 / 100 万トークンに低下し、Flash の $0.0028 との差はわずか 28% に縮まります。高ヒット率のエージェントループでは入力費用の差がほぼ消滅し、請求額の差は主に出力および推論トークン数によって決まります。
MiMo-V2.6-Pro が明確に優れているベンチマークは何ですか?
Pro は長期間の推論と自己修復を伴うタスクで大きくリードします。Agents' Last Exam で 14.5% のアドバンテージ(31.6 対 27.6)を示し、DeepSWE v1.1 でも 4.0 ポイント上回っています(71.9 対 67.9)。一方で日常的なブラウザ自動化(Automation Bench 53.1 対 52.3)ではほぼ同等のスコアです。
MiMo-V2.6-Pro の推論トークン膨張税とは何ですか?
両モデルは大規模な強化学習(RL)でトレーニングされており、回答前に内部思考トレースを生成します。Pro は単純なタスクでも数千トークンの思考を生成する傾向があり、思考トークンも出力料金($0.87/M)で課金されるため、簡単なクエリでは Flash の十数倍のコストになることがあります。
Tabbit ブラウザで両方のモデルを利用できますか?
Tabbit ブラウザは、マルチモデル検証、Web 調査、および自動化エージェントを統合した AI ネイティブな作業環境を提供します。特定モデルの利用可否は、アカウントの現在のモデルセレクターおよびサービス利用規約に依存します。