
Gemini 4 Argon は継続的なコーディングや知識作業に向く可能性がありますが、公開情報だけでは「常に最良」とは言えません。Google は特定のエンジニアリング作業の社内結果を公開しています。一方、独立評価は推論設定とベンチマークによって変わります。利用者にとっての問題は、API料金やサブスクリプションの上限に見合う品質かどうかです。Google の事例では、Python Agent Development Kit の長時間セッション準備時間が 40% 減り、コールドインポート時間が21%短縮したとされています。本レビューの判断軸はこの数値です。Google が特定のコードベースで報告した結果であり、すべてのプロジェクトに当てはまる予測ではありません。
要点
Argon は複雑なコーディング、調査、複数ステップの作業を想定しています。Gemini API のモデルカードは、入力と出力を合わせて100万トークンのコンテキストを記載しています。
Google の ADK 事例では、長時間セッションのメモリ準備が40%短縮し、コールドインポートが21%高速化しました。独立した再現は示されていません。
Artificial Analysis の Index v5.0.1 では Argon High が50、Carbon High が60です。9つの評価をまとめた値で、すべての業務フローを表すものではありません。
Reddit には能力、利用枠、作業の追従性について異なる体験談があります。管理されたテストではありません。
深い推論が必要で、出力を確認できる場合に小さく試してください。順位だけで決めないでください。
Gemini 4 Argon レビュー概要
| 根拠 | 公開されている内容 | 示していないこと |
|---|---|---|
| Google の ADK 事例 | 長時間セッションの準備時間40%減、コールドインポート21%高速化 | 別のコードでも同じ改善が出ること |
| Artificial Analysis Index v5.0.1 | Argon High は50、9つの評価を統合 | 永続的な順位や同条件の比較 |
| Gemini 4 Argon モデルカード | API の入力・出力合計コンテキスト100万トークン | すべての製品で同じ上限や利用枠があること |
| Reddit の体験談 | 品質や利用枠の評価が分かれる | 公式の利用条件や成功率 |
得意分野として示されていること
Google は Argon を複雑なコーディング、金融、法律、サイバーセキュリティ、科学向けと説明しています。10月の ADK Python 事例では、リポジトリのルールと短い目標を渡して最適化を行いました。Google によれば、長時間セッションのメモリ準備時間が40%短縮し、コールドインポートが21%速くなりました。記事にはコード変更へのリンクがあり、例を確認できます。
ただし、この結果は Google が選んだプロジェクトのものです。記事にランダム化比較の説明はなく、改善は特定のコード経路に関するものです。自分のコードが40%速くなる保証ではありません。モデルカードは、幻覚、タイムアウト、高い推論設定でのトークン消費増加にも触れています。
ベンチマークが示す範囲
Artificial Analysis の比較ページでは、Index v5.0.1 で Argon High が50、Carbon High が60です。9評価を統合した指数で、ページは定期更新されます。比較時には版と日付を記録してください。恒久的な順位ではありません。出力単価が同じでも、入力、キャッシュ、推論、回答トークン量が異なればタスク費用は変わります。
Reddit の利用者は、Codex、Claude Code、Antigravity、OpenCode を使った小規模なリバースエンジニアリング比較も公開しました。Argon Medium の3タスク平均を56.33と報告していますが、各モデルの実行環境は異なります。評価方法を考える材料にはなりますが、条件の揃ったモデル対決ではありません。
結論:自分のタスクで試す
複雑なコーディング、分析、調査で、出力をレビューでき、停止条件も明確なら Argon は限定的に試す価値があります。簡単な質問、確認者のいない高リスク作業、利用枠に強く縛られる運用には向かない場合があります。代表的なタスクを一つ選び、プロンプトと出力を保存し、元ファイルと照合してから使用量を確認してください。1回の実行から一般的な成功率を推測しないでください。
コーディング調査にブラウザーを使う場合は、別のワークフローを扱う Gemini 4 Carbon のブラウザーガイドと Gemini CLI の browser MCP ガイドを参照してください。
MammothResult8482 は Gemini アプリで “consumes a lot of tokens” と述べ、Lost-Willow386 は1つのプロンプトが “way too much quota for a single prompt” を使うことがあると投稿しました。異なる利用者の体験談であり、利用枠の測定ではありません。
関連記事
Reddit 原文のスクリーンショット
元の投稿をブラウザーで開いた画面です。個人の経験であり、製品の保証ではありません。
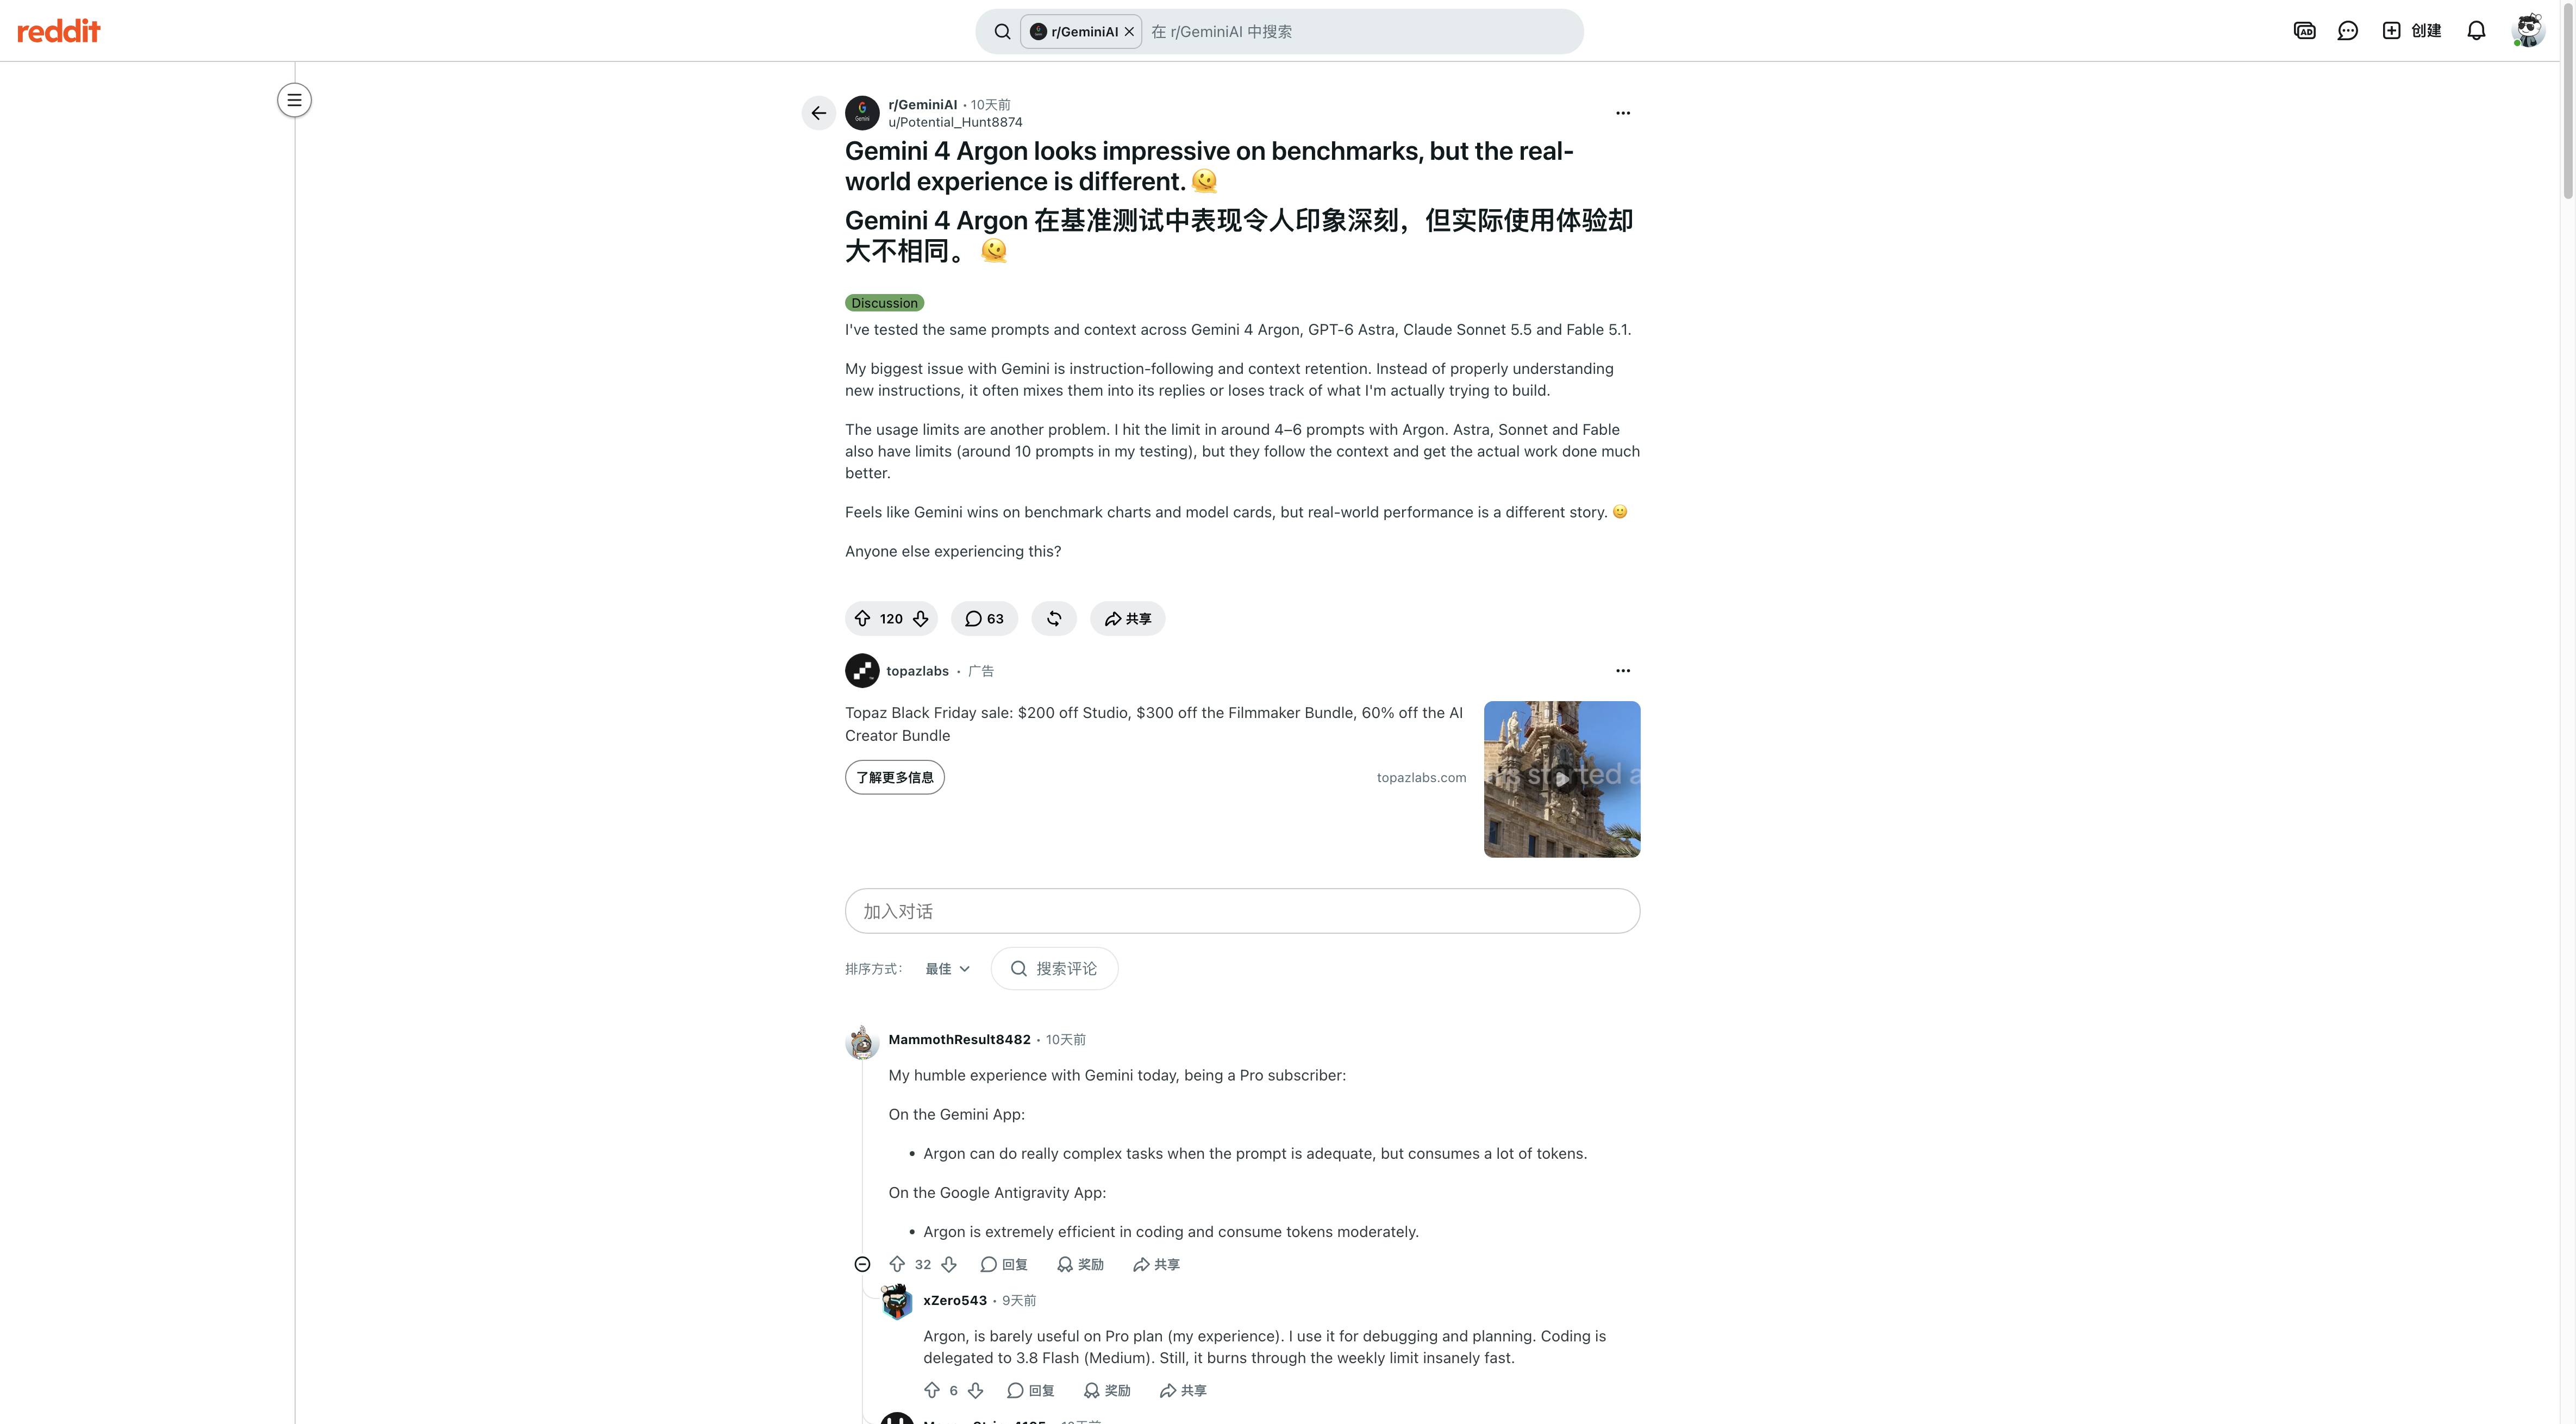
MammothResult8482 による Gemini App と Antigravity の比較。採集時は約10日前の投稿。 Reddit の元のスレッド
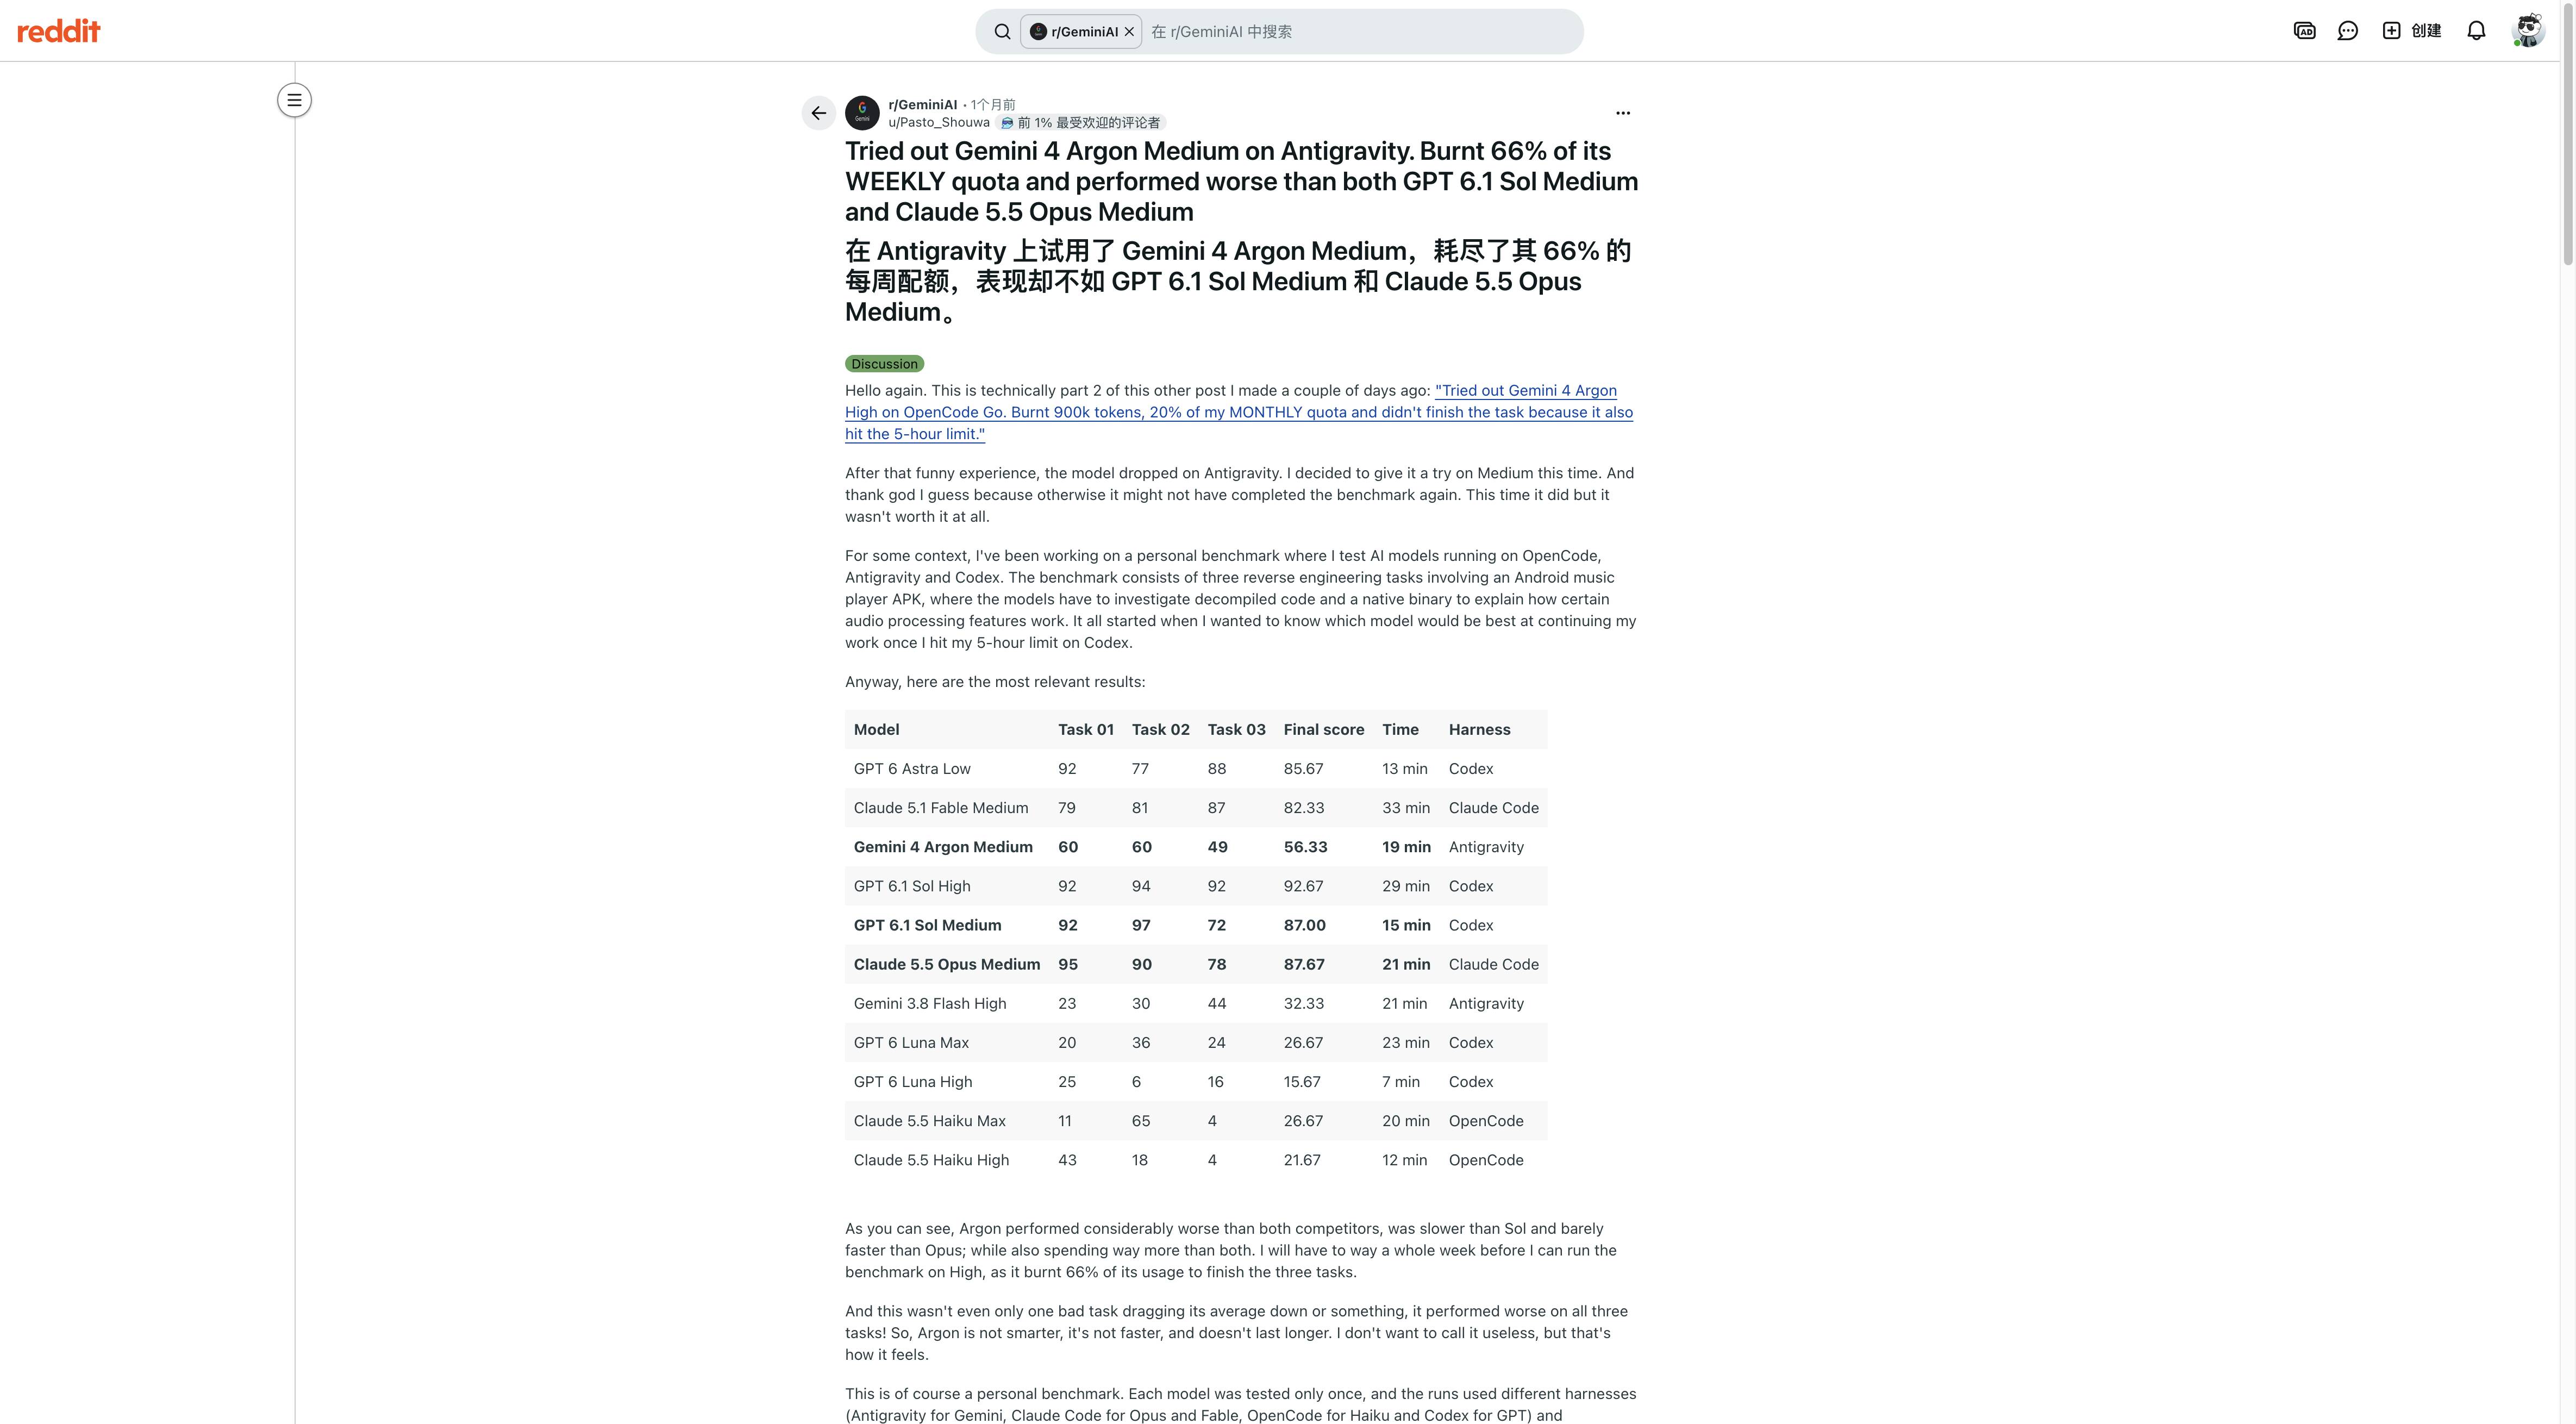
Pasto_Shouwa が3タスクの個人評価と異なる実行環境を報告。 Reddit の元のスレッド
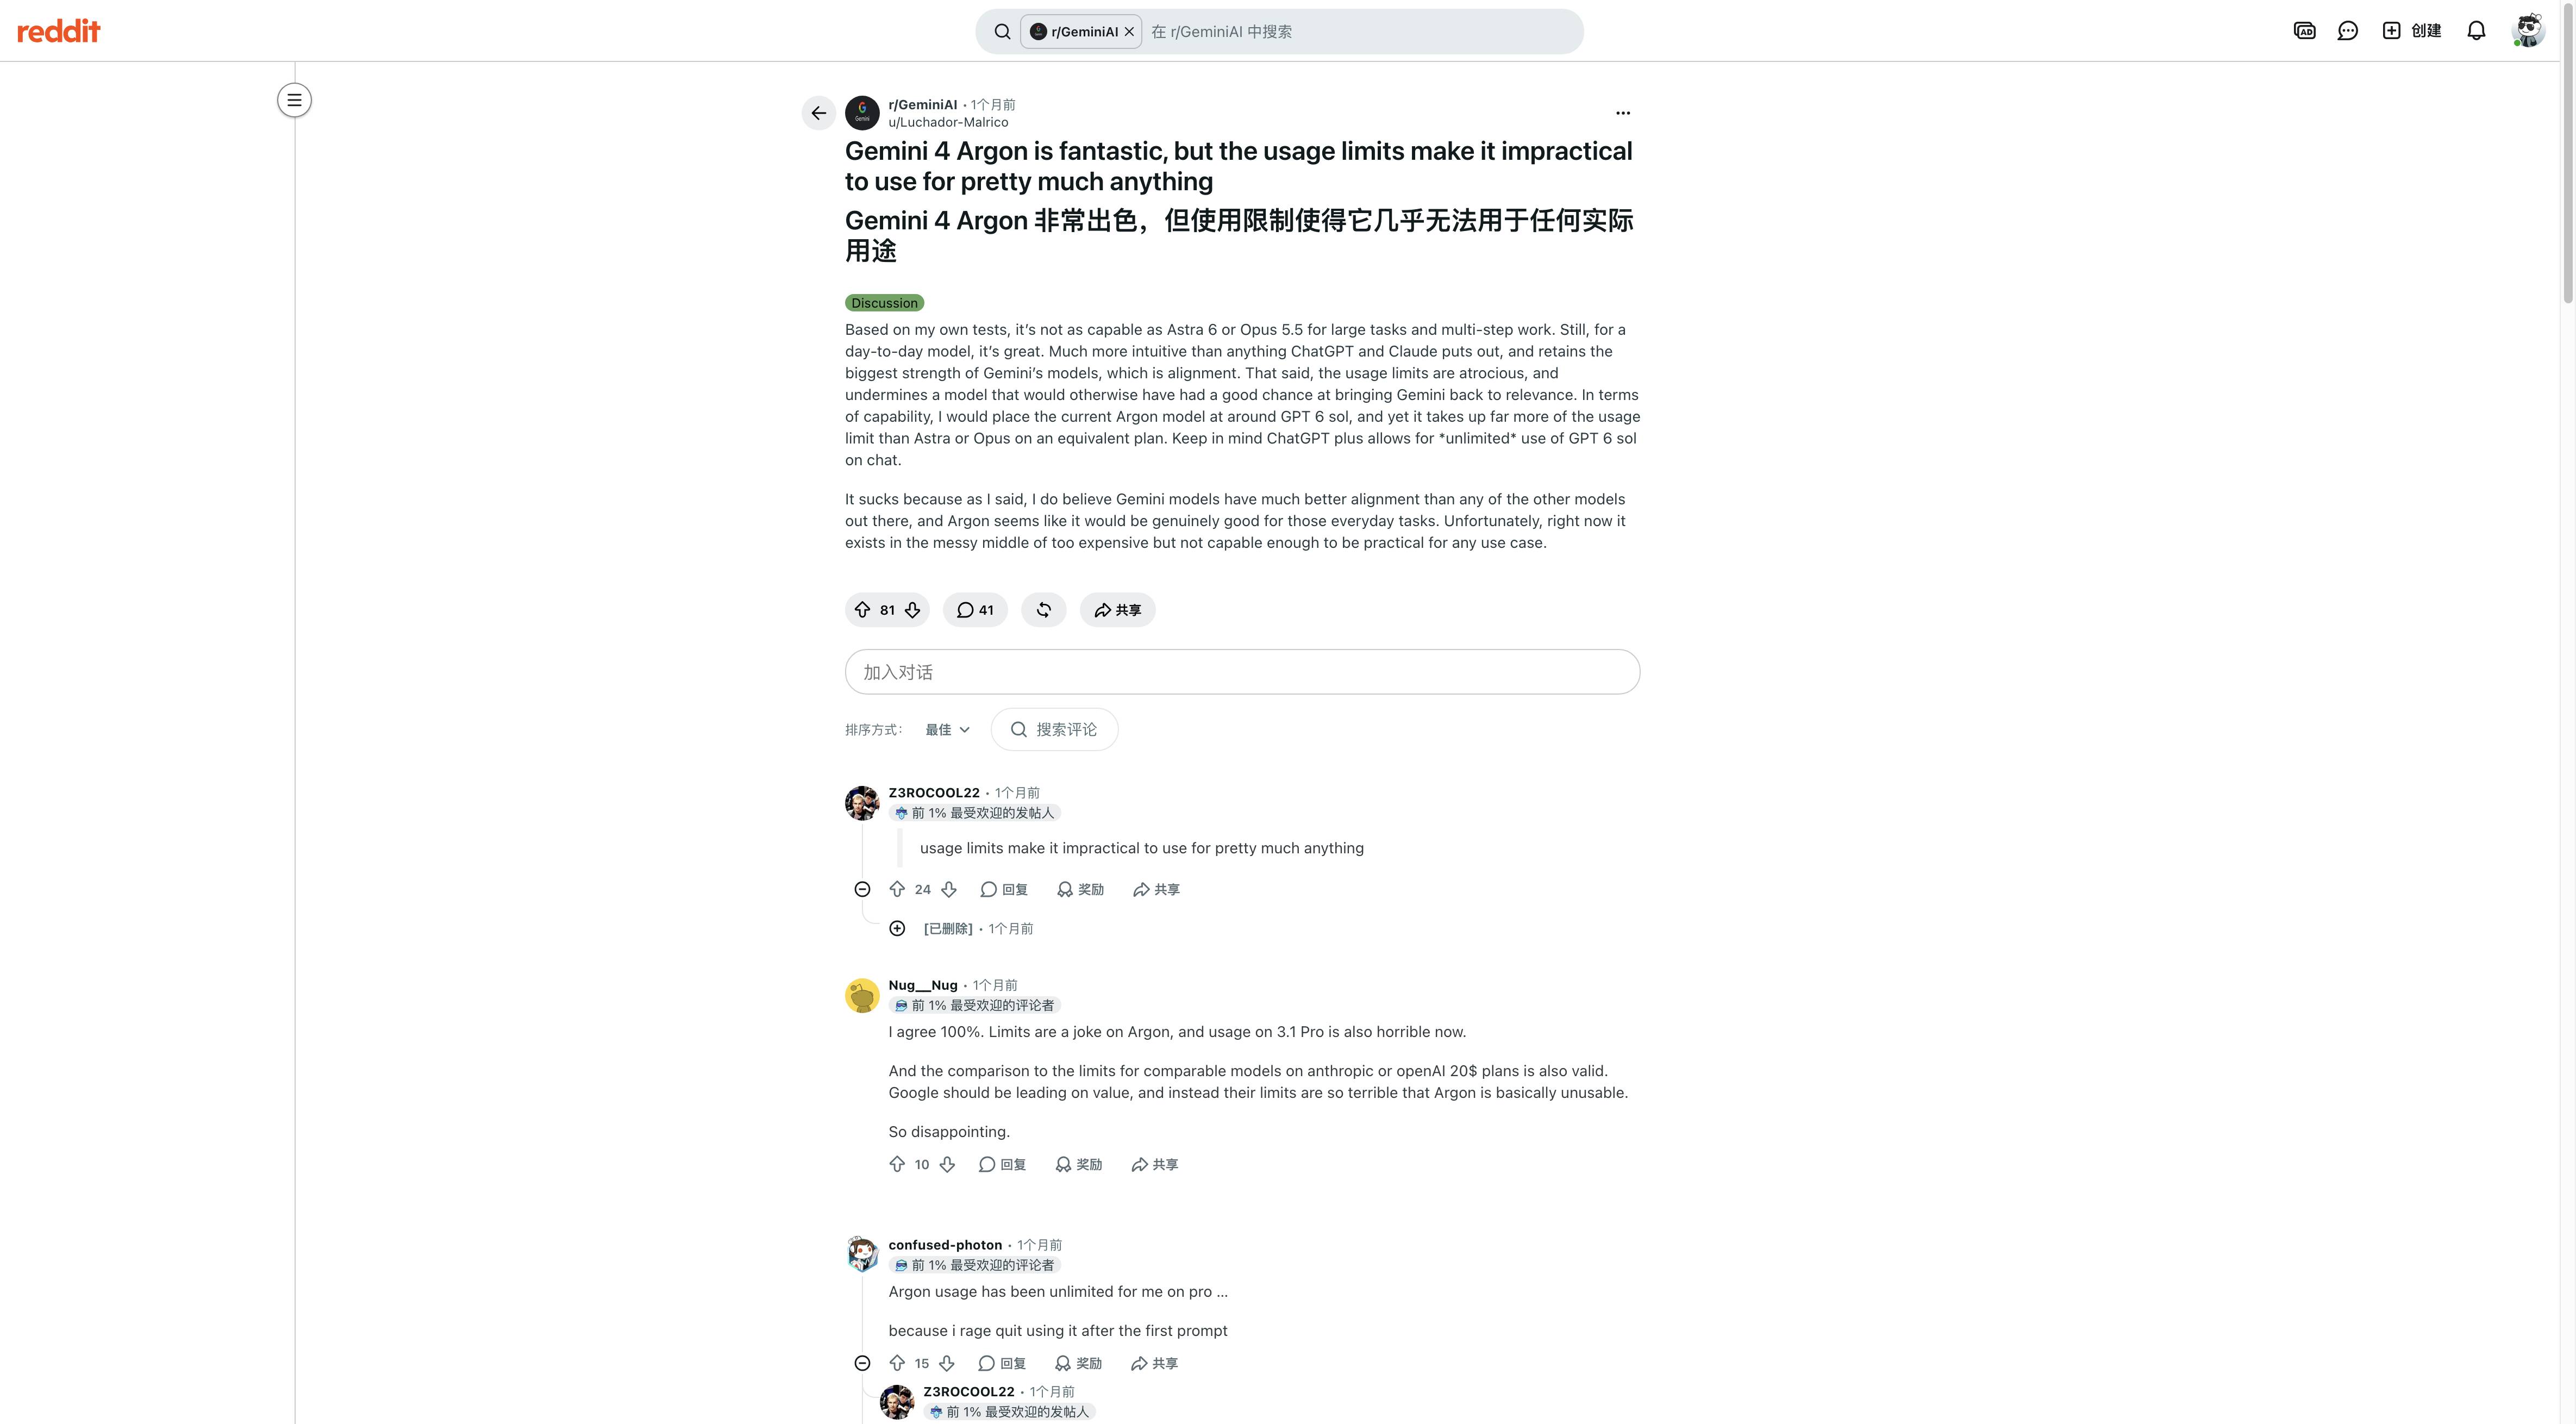
Reddit の利用者が Argon の利用枠について投稿。プラン依存の体験談です。 Reddit の元のスレッド
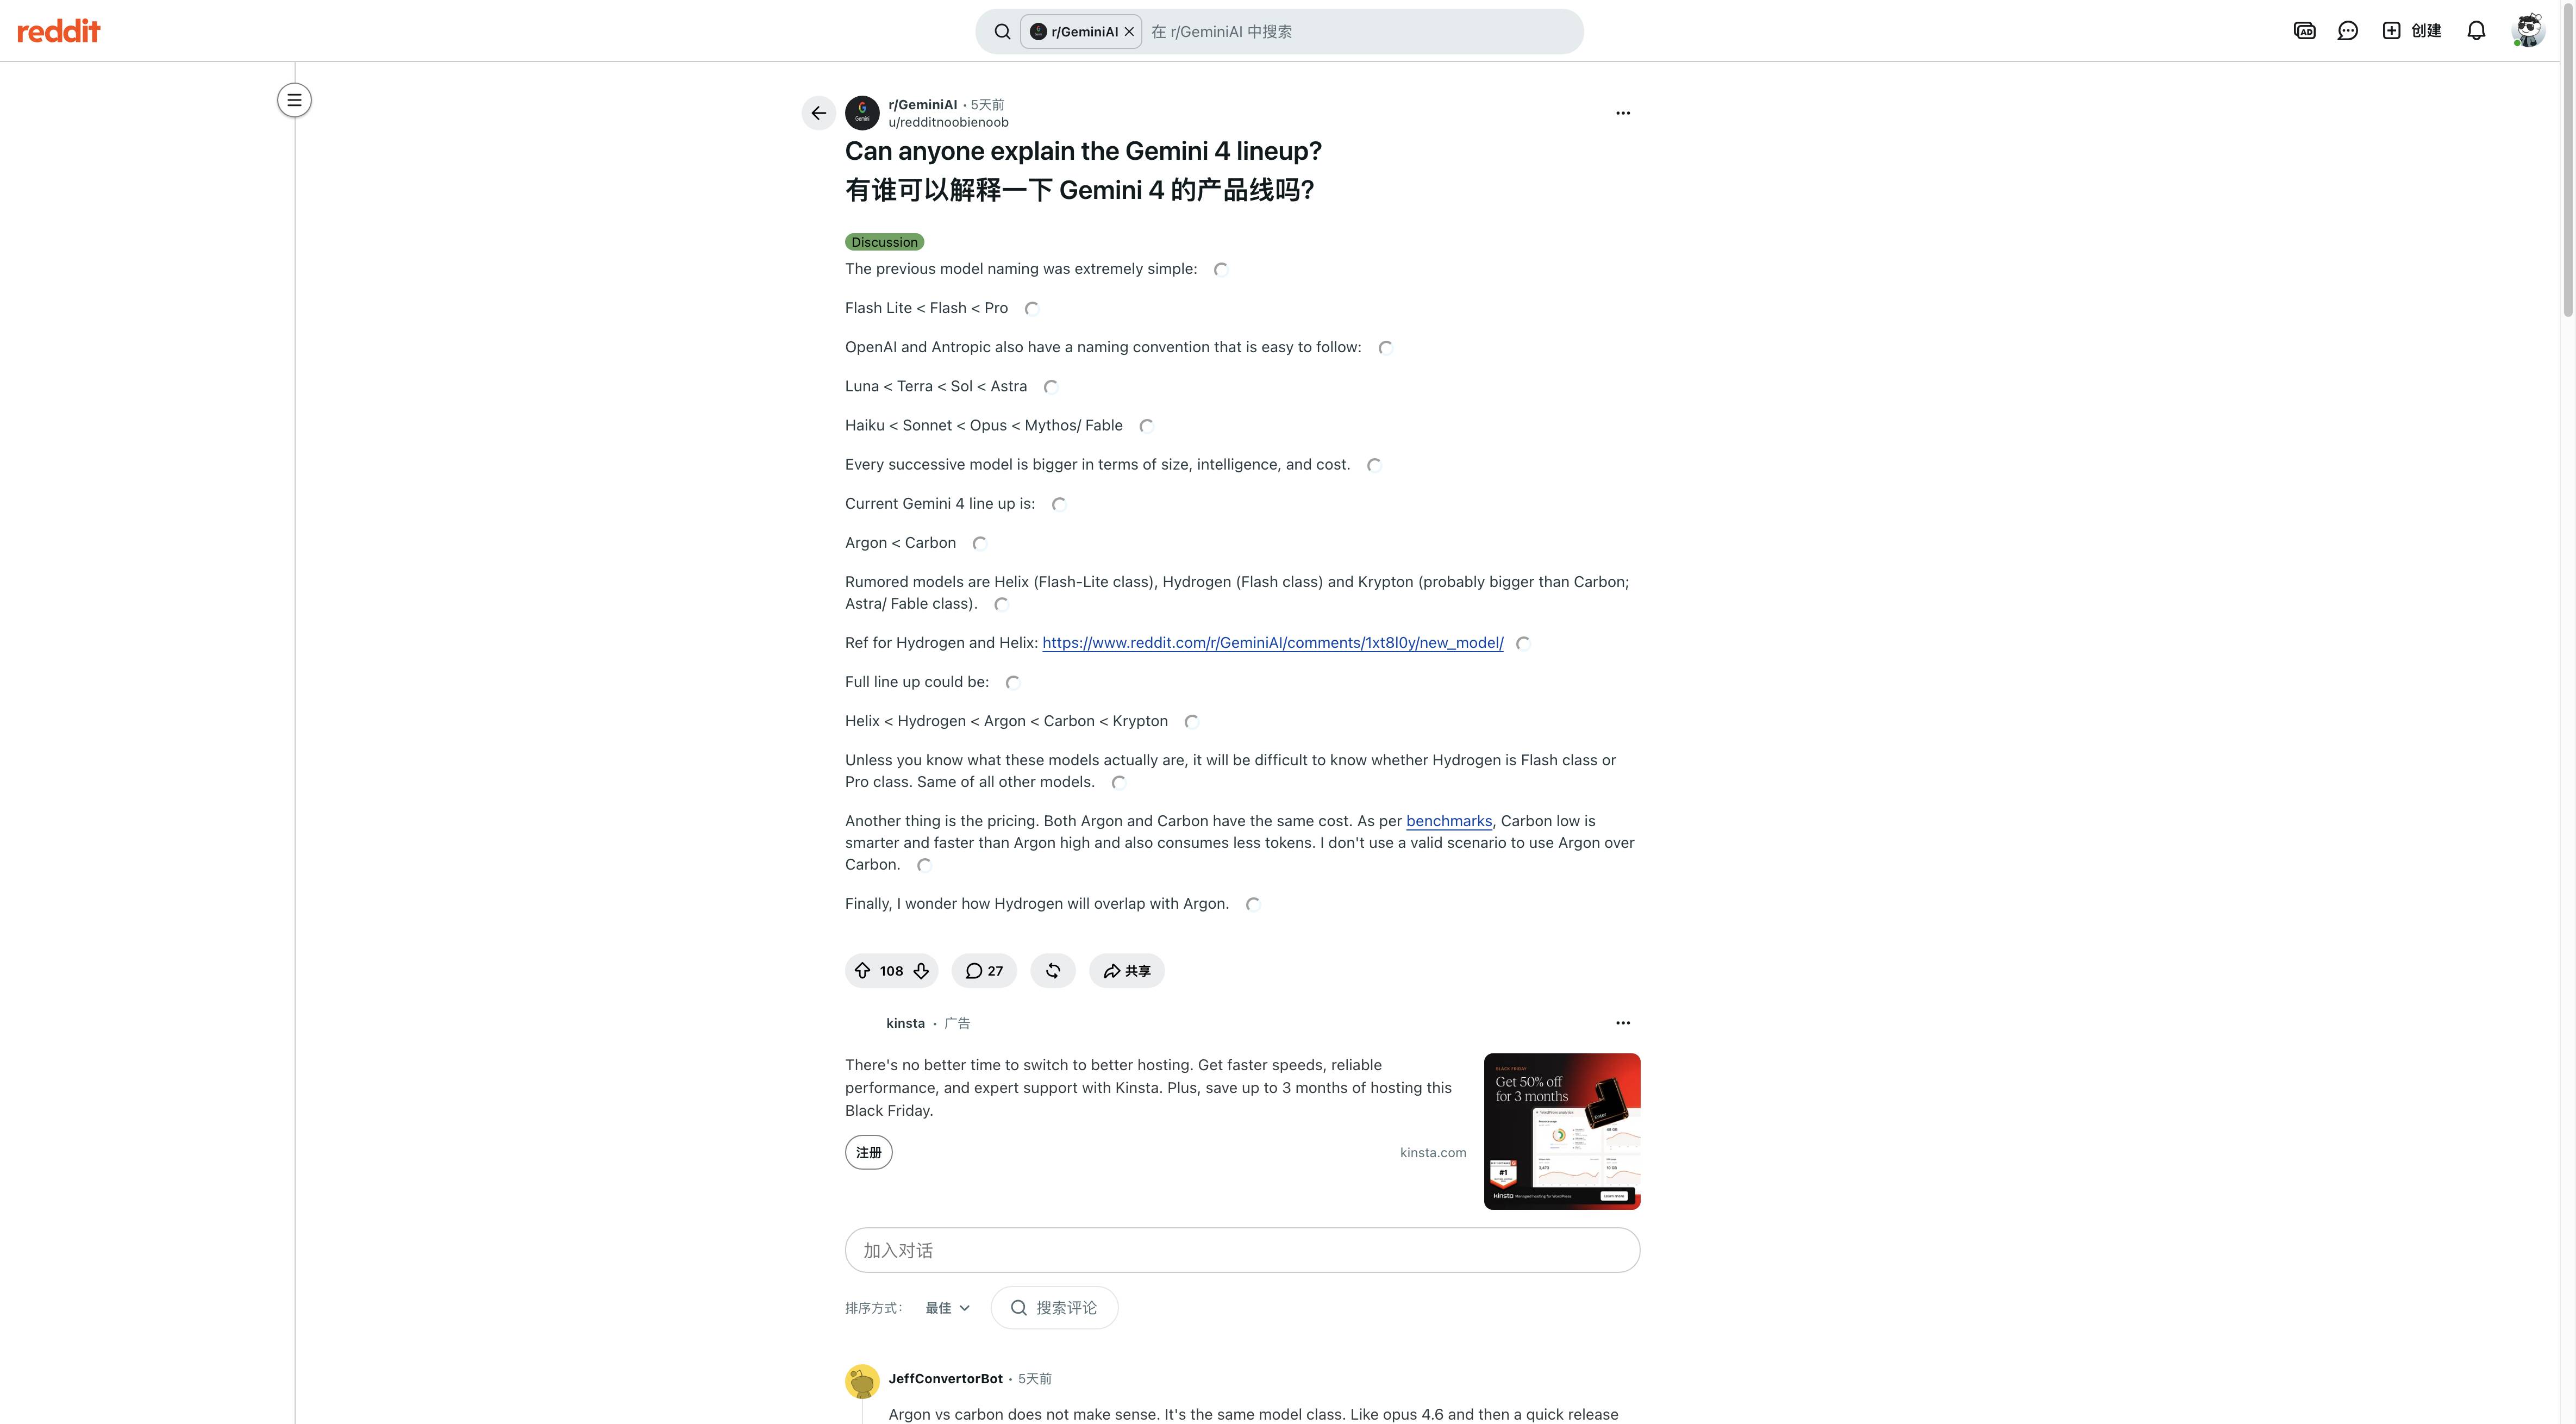
Argon と Carbon の名称の意味を問う Gemini ラインアップの議論。 Reddit の元のスレッド

よくある質問
Gemini 4 Argon は優れたモデルですか?
複雑で結果を確認できるコーディングや知識作業の候補です。公開評価は個別の作業に限られるため、標準採用前に自分のタスクで試してください。
Gemini 4 Argon のコンテキスト長は?
Google は Gemini API で入力と出力を合わせ最大100万トークンと説明しています。製品ごとに別の上限がある場合があります。
Argon は Gemini 4 Carbon より常に優れていますか?
いいえ。Artificial Analysis Index v5.0.1 は Argon High を50、Carbon High を60としています。費用と遅延も設定によって異なります。
Argon の利用枠を使い切るという声があるのはなぜ?
Reddit には Gemini、Antigravity、APIで異なる体験が投稿されています。個人の報告であり、公式上限ではありません。
自分の作業で Argon をどう評価すればよいですか?
代表的なタスクを選び、モデル間でプロンプト、ツール、成功基準をそろえます。完了率、再試行、所要時間、トークン費用を記録してください。
Argon のベンチマークは独立検証済みですか?
Artificial Analysis Index v5.0.1 などの独立評価があります。Google の事例はベンダー報告で、どちらも個々の作業結果を保証しません。