
Gemini 4 Argon peut convenir au codage soutenu et au travail documentaire, mais les preuves publiques ne permettent pas de le déclarer « meilleur » dans tous les cas. Google publie des gains internes sur des tâches précises ; les résultats indépendants varient selon le niveau de raisonnement et le benchmark. Pour l’utilisateur, la question est de savoir si la qualité compense le coût API ou la limite d’abonnement. Google indique que, sur Python Agent Development Kit, Argon a réduit de 40 % la préparation en mémoire des sessions longues et de 21 % le temps d’import à froid. C’est le repère de cette analyse : un résultat Google sur une base de code, pas une prévision universelle.
À retenir
Argon vise le codage complexe, la recherche et les tâches en plusieurs étapes. La fiche Gemini API décrit un contexte combiné entrée-sortie de 1 million de jetons.
Le cas ADK de Google annonce 40 % de temps de préparation en moins et 21 % d’import à froid en moins ; aucune réplication indépendante n’est donnée sur la page.
Artificial Analysis affiche 50 pour Argon High et 60 pour Carbon High dans l’Index v5.0.1, qui agrège neuf évaluations.
Reddit contient des avis opposés sur le codage, les quotas et la continuité. Ce sont des témoignages, pas des tests contrôlés.
Argon mérite un essai si le raisonnement supplémentaire aide et si vous pouvez vérifier le résultat. Ne choisissez pas sur le classement seul.
Gemini 4 Argon : résumé de l’avis
| Éléments | Ce qui est publié | Ce que cela ne prouve pas |
|---|---|---|
| Cas d’ingénierie ADK de Google | Préparation des sessions longues réduite de 40 %, import à froid accéléré de 21 % | Le même gain sur un autre projet |
| Artificial Analysis Index v5.0.1 | Argon High : 50 ; neuf évaluations agrégées | Un classement permanent ou des conditions identiques |
| Fiche Gemini 4 Argon | Contexte API combiné de 1 M de jetons | Le même contexte et quota dans chaque interface |
| Retours Reddit | Avis variés sur la qualité et la consommation | Une règle officielle ou un taux de réussite général |
Ce qu’Argon semble bien faire
Google destine Argon au codage complexe, à la finance, au droit, à la cybersécurité et aux sciences. Son cas d’octobre décrit une optimisation de Python ADK : l’équipe fournit les règles du dépôt et un objectif court. Google rapporte 40 % de temps de préparation en mémoire en moins lors de longues sessions et 21 % d’amélioration sur les imports à froid. Le billet renvoie aux modifications du code, ce qui rend l’exemple vérifiable.
La portée reste limitée. Google a choisi ce projet, sans décrire de comparaison randomisée ; le résultat concerne un chemin de code précis. Il montre qu’Argon a aidé sur cette tâche, pas qu’il accélérera votre dépôt de 40 %. La fiche du modèle mentionne aussi les hallucinations, les délais d’attente et une consommation accrue aux niveaux de raisonnement élevés.
Ce que les benchmarks mesurent
La comparaison d’Artificial Analysis affiche actuellement Argon High à 50 et Carbon High à 60 dans l’Index v5.0.1, qui combine neuf évaluations. La page est mise à jour régulièrement : notez la version et la date. Ce n’est pas un classement définitif. Même à prix de sortie égal, le coût par tâche change selon les volumes d’entrée, de cache, de raisonnement et de réponse.
Un utilisateur Reddit a publié une petite comparaison de rétro-ingénierie avec Codex, Claude Code, Antigravity et OpenCode. Il rapporte 56,33 pour Argon Medium sur trois tâches, mais les environnements diffèrent. C’est un rappel utile sur la méthode, pas une comparaison contrôlée : outils, prompts, abonnements et notation ne sont pas équivalents.
Verdict : testez votre propre tâche
Argon mérite un essai limité pour une tâche complexe de code, d’analyse ou de recherche si vous pouvez contrôler la sortie et fixer une condition d’arrêt. Il est moins évident pour une question simple, une tâche risquée sans relecture ou un flux contraint par un quota grand public. Choisissez un cas représentatif, conservez prompt et résultat, vérifiez les fichiers source puis consultez le compteur d’usage. Une seule exécution ne donne pas un taux général de réussite.
Pour la recherche de code dans un navigateur, consultez le guide Gemini 4 Carbon dans le navigateur et le guide Gemini CLI avec browser MCP, qui couvrent d’autres workflows.
MammothResult8482 a décrit Gemini comme “consumes a lot of tokens” ; Lost-Willow386 indique qu’un prompt peut utiliser “way too much quota for a single prompt”. Ce sont deux témoignages, pas une mesure de quota.
À lire aussi
Captures Reddit
Captures navigateur des discussions d’origine. Ce sont des expériences individuelles, pas des garanties produit.
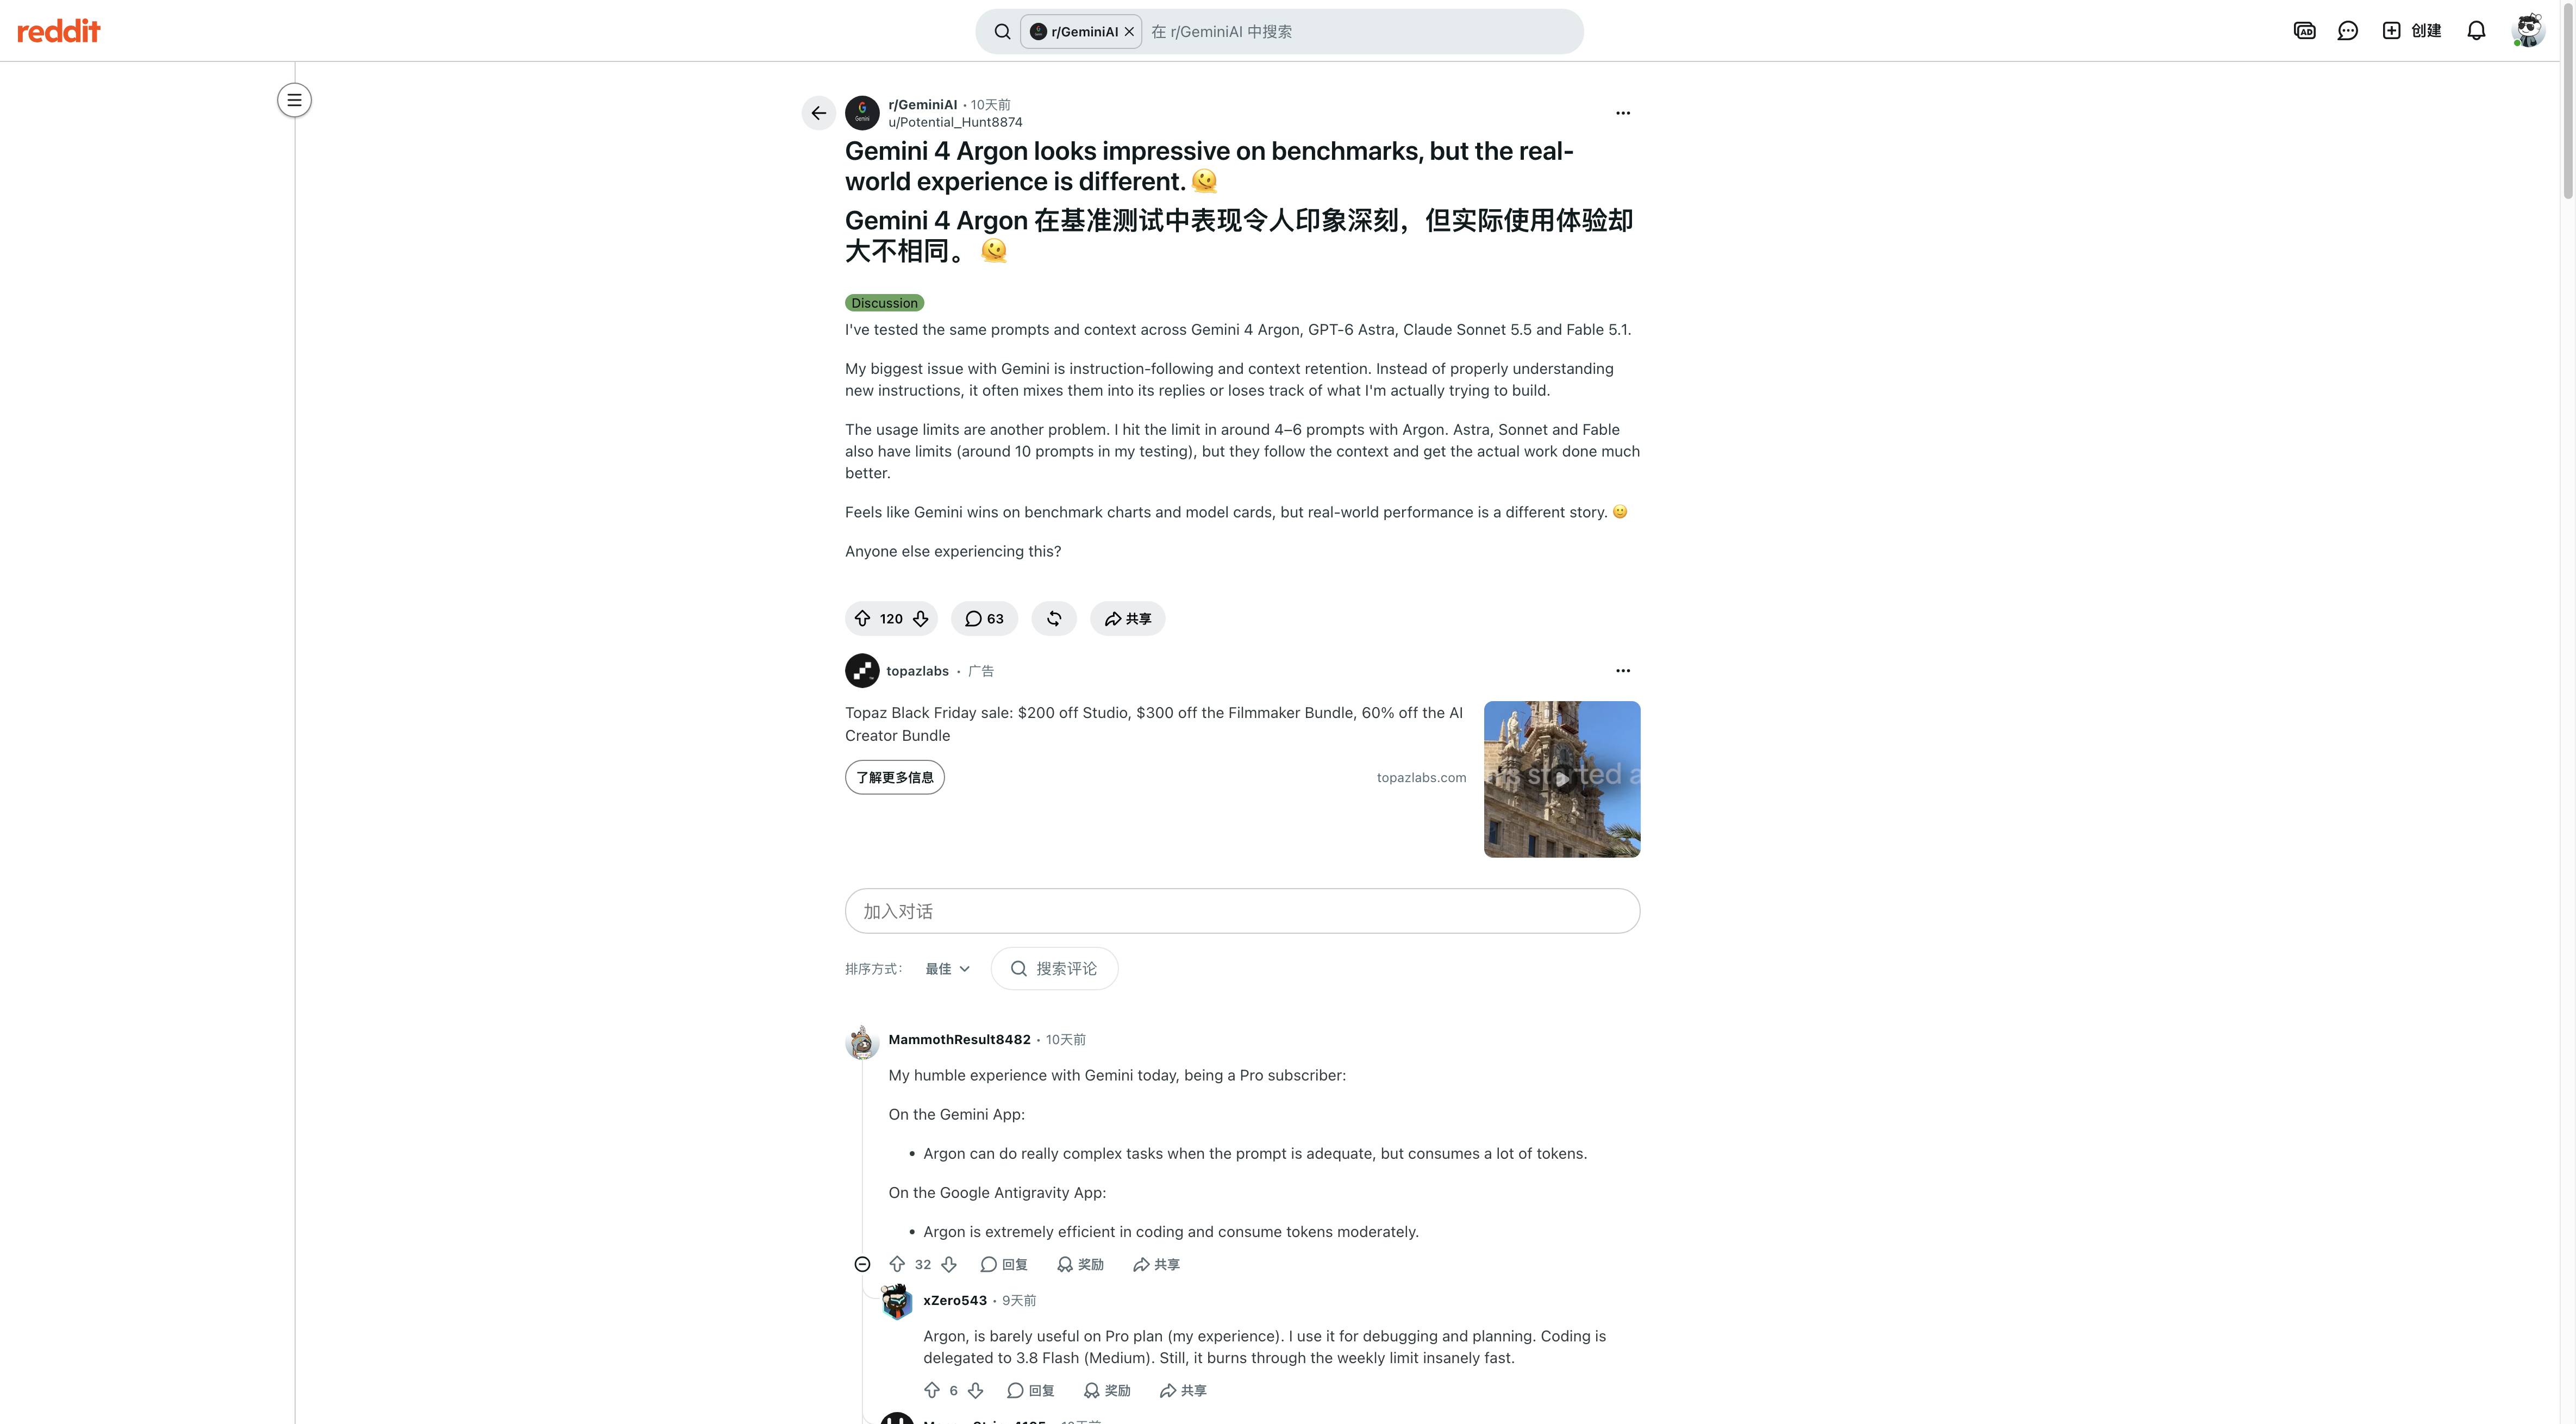
MammothResult8482 compare Gemini et Antigravity ; environ 10 jours avant la collecte. Fil Reddit d’origine
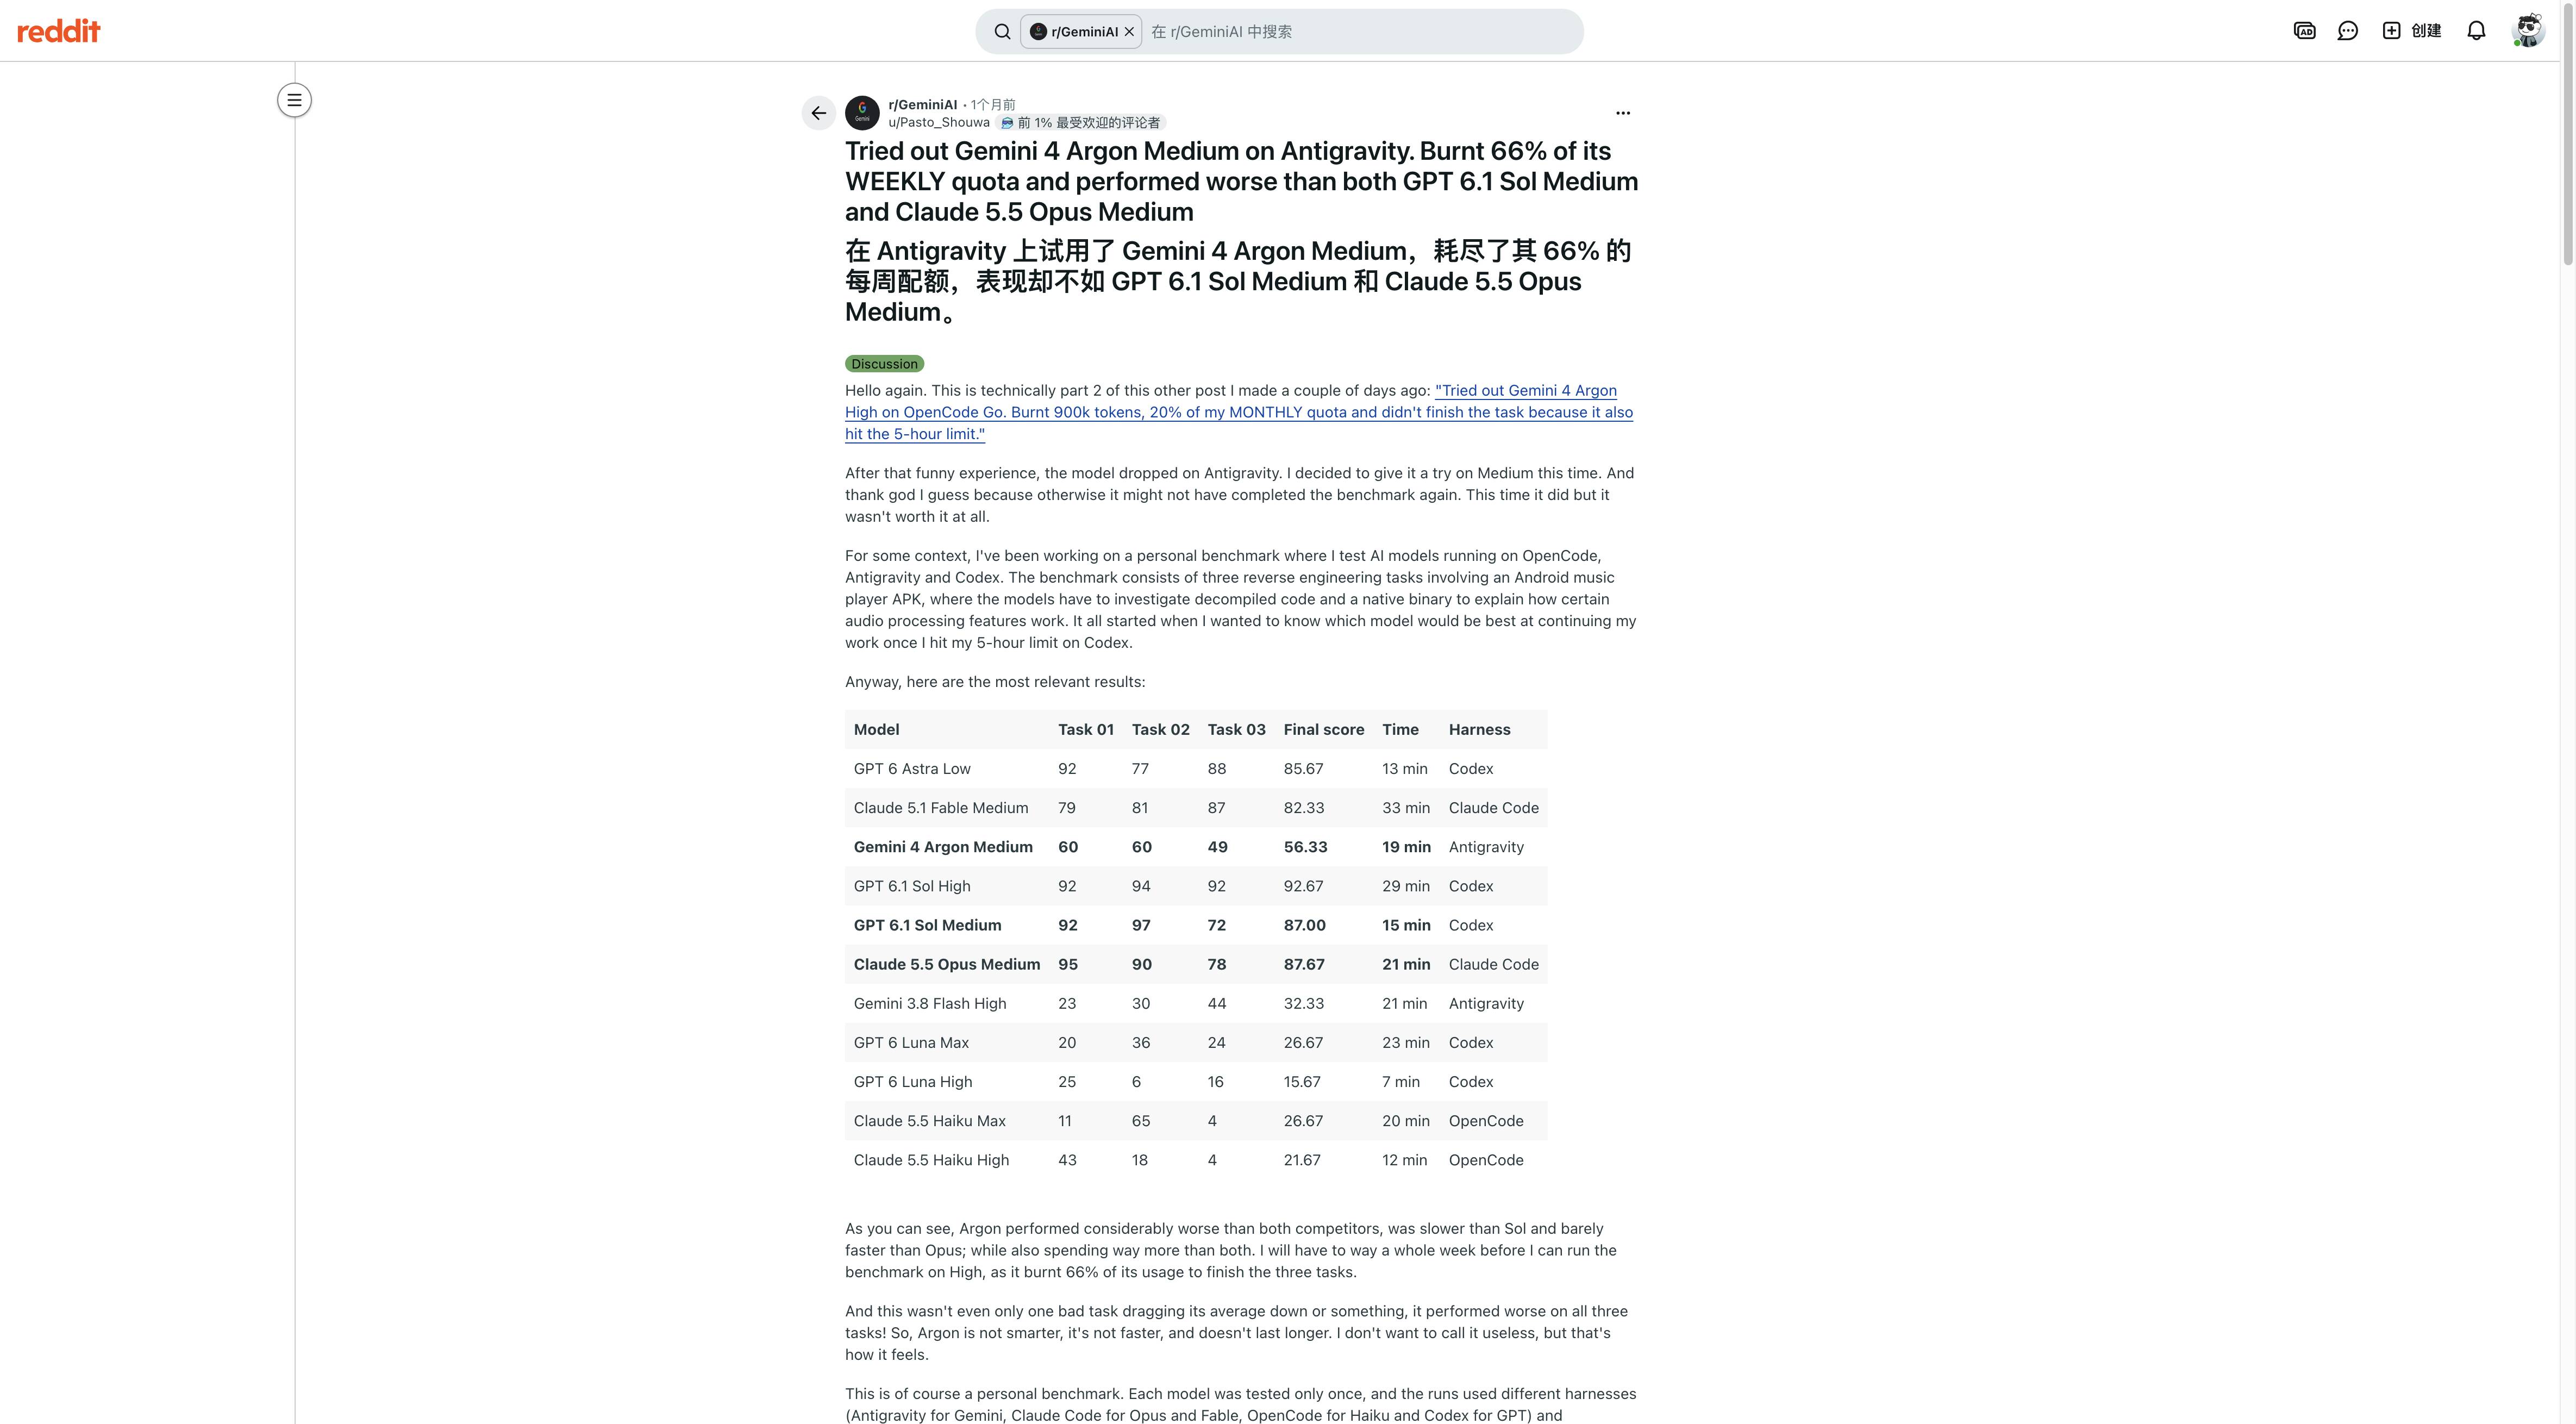
Pasto_Shouwa décrit un test personnel de trois tâches et des environnements différents. Fil Reddit d’origine
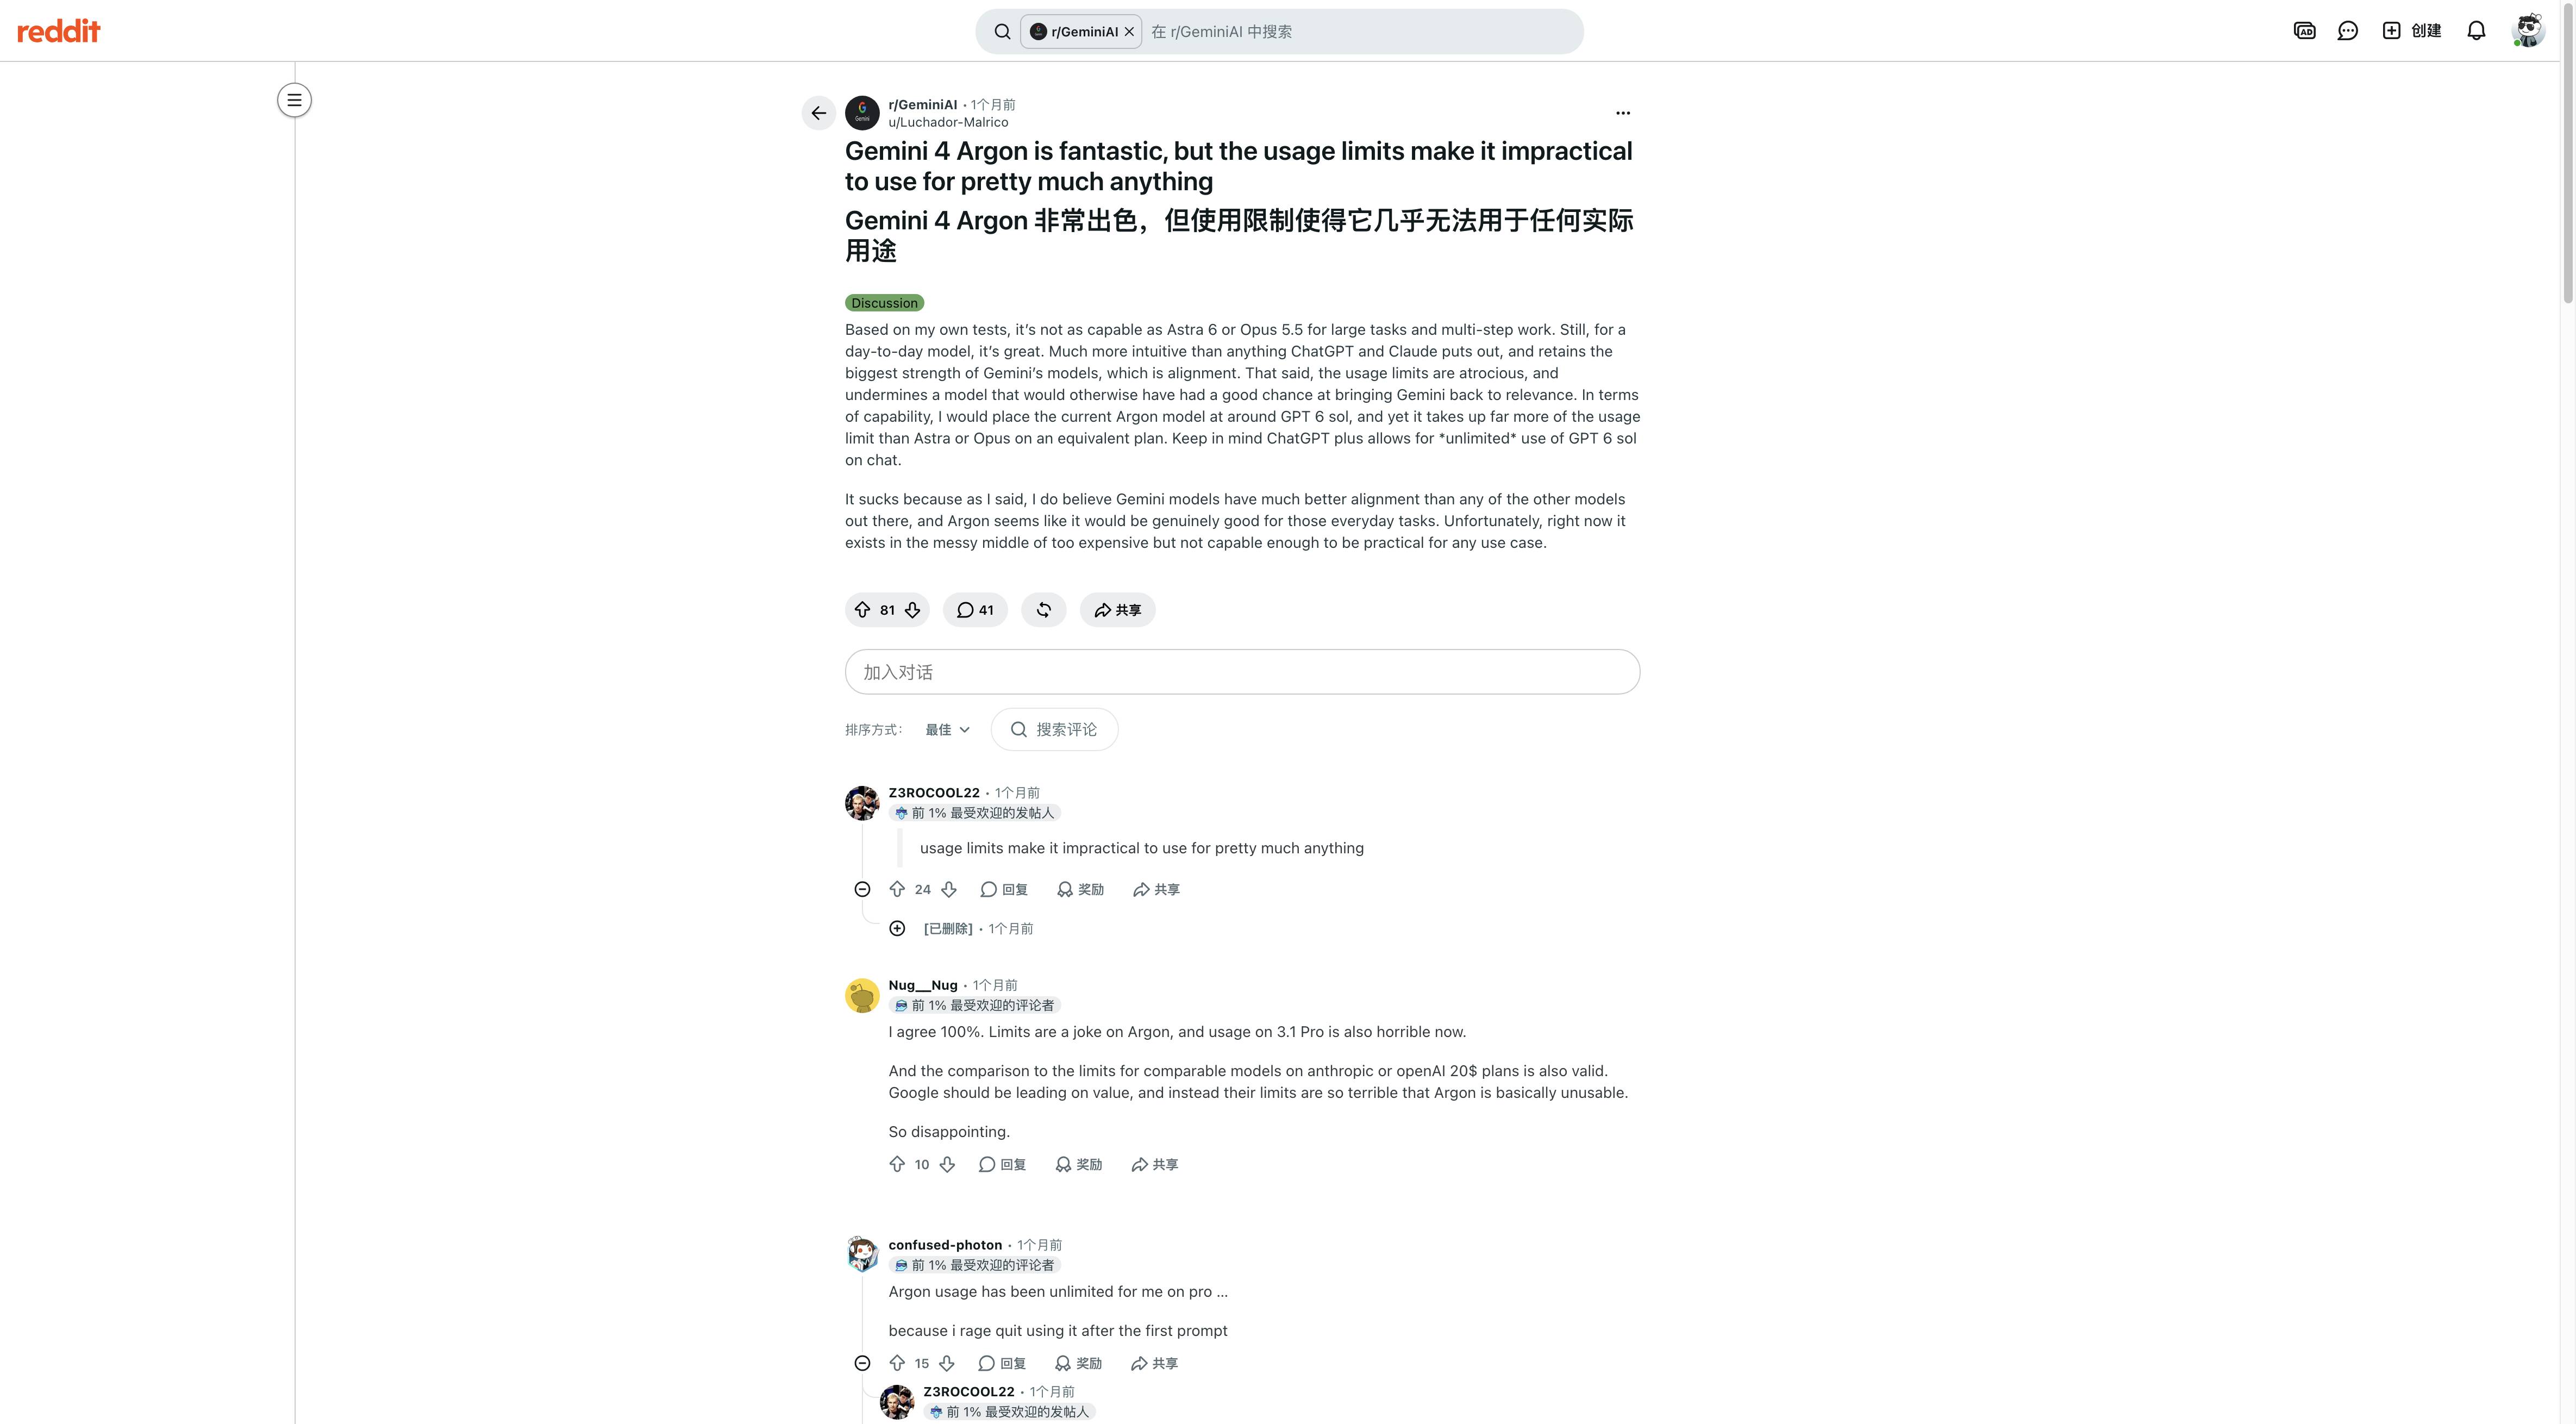
Des abonnés Reddit évoquent des limites différentes ; témoignages selon le forfait. Fil Reddit d’origine
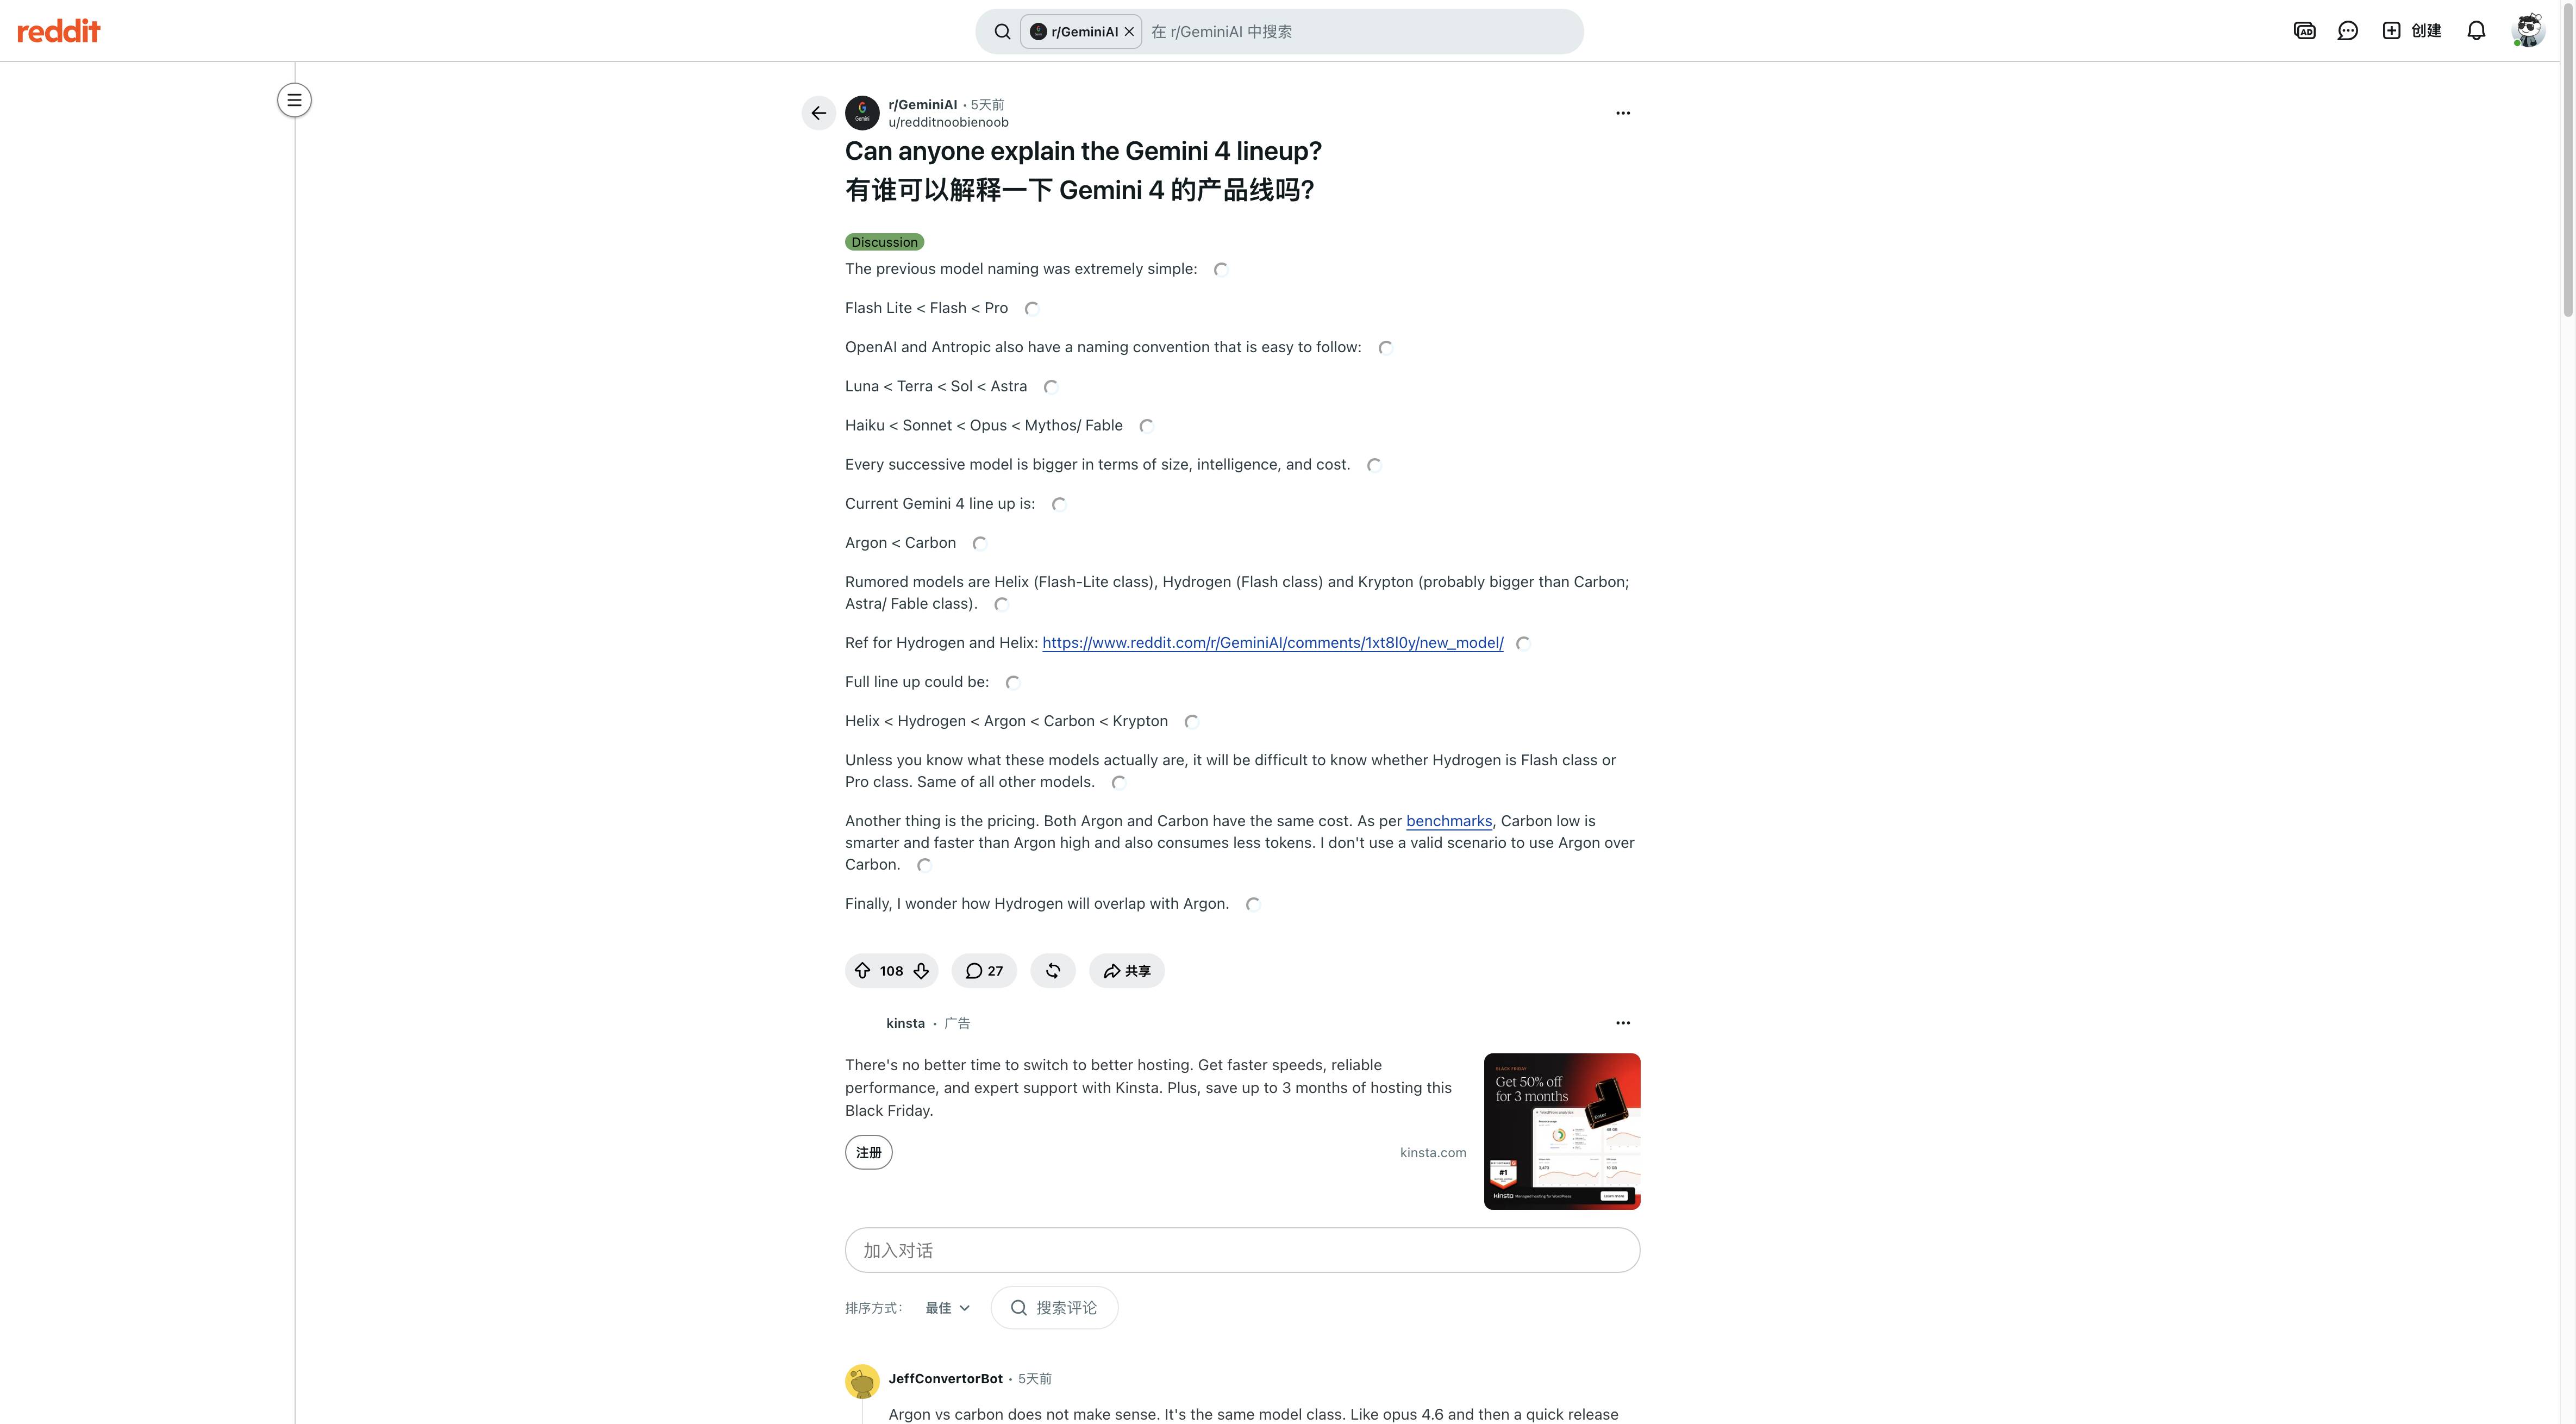
Discussion sur la gamme Gemini et le sens des noms Argon et Carbon. Fil Reddit d’origine

Questions fréquentes
Gemini 4 Argon est-il performant ?
C’est un candidat pour les tâches complexes de code et de connaissance que vous pouvez vérifier. Les preuves publiques sont propres à chaque tâche ; testez-le avant d’en faire votre modèle par défaut.
Quelle est la fenêtre de contexte de Gemini 4 Argon ?
Google indique jusqu’à 1 million de jetons combinés en entrée et sortie pour Gemini API. Les interfaces peuvent appliquer d’autres limites.
Argon dépasse-t-il toujours Gemini 4 Carbon ?
Non. Artificial Analysis Index v5.0.1 affiche 50 pour Argon High et 60 pour Carbon High ; coût et latence changent aussi selon le réglage.
Pourquoi certains disent-ils qu’Argon consomme beaucoup de quota ?
Les témoignages Reddit varient entre Gemini, Antigravity et API. Ils restent anecdotiques et ne définissent pas les limites officielles.
Comment évaluer Argon pour mon travail ?
Choisissez une tâche représentative avec le même prompt, les mêmes outils et critères de réussite pour chaque modèle ; notez la réussite, les reprises, le temps et le coût en jetons.
Les benchmarks d’Argon sont-ils vérifiés indépendamment ?
Des évaluations indépendantes comme Artificial Analysis Index v5.0.1 existent. Les exemples d’ingénierie Google sont des rapports fournisseur ; aucun ne prédit chaque workflow.