
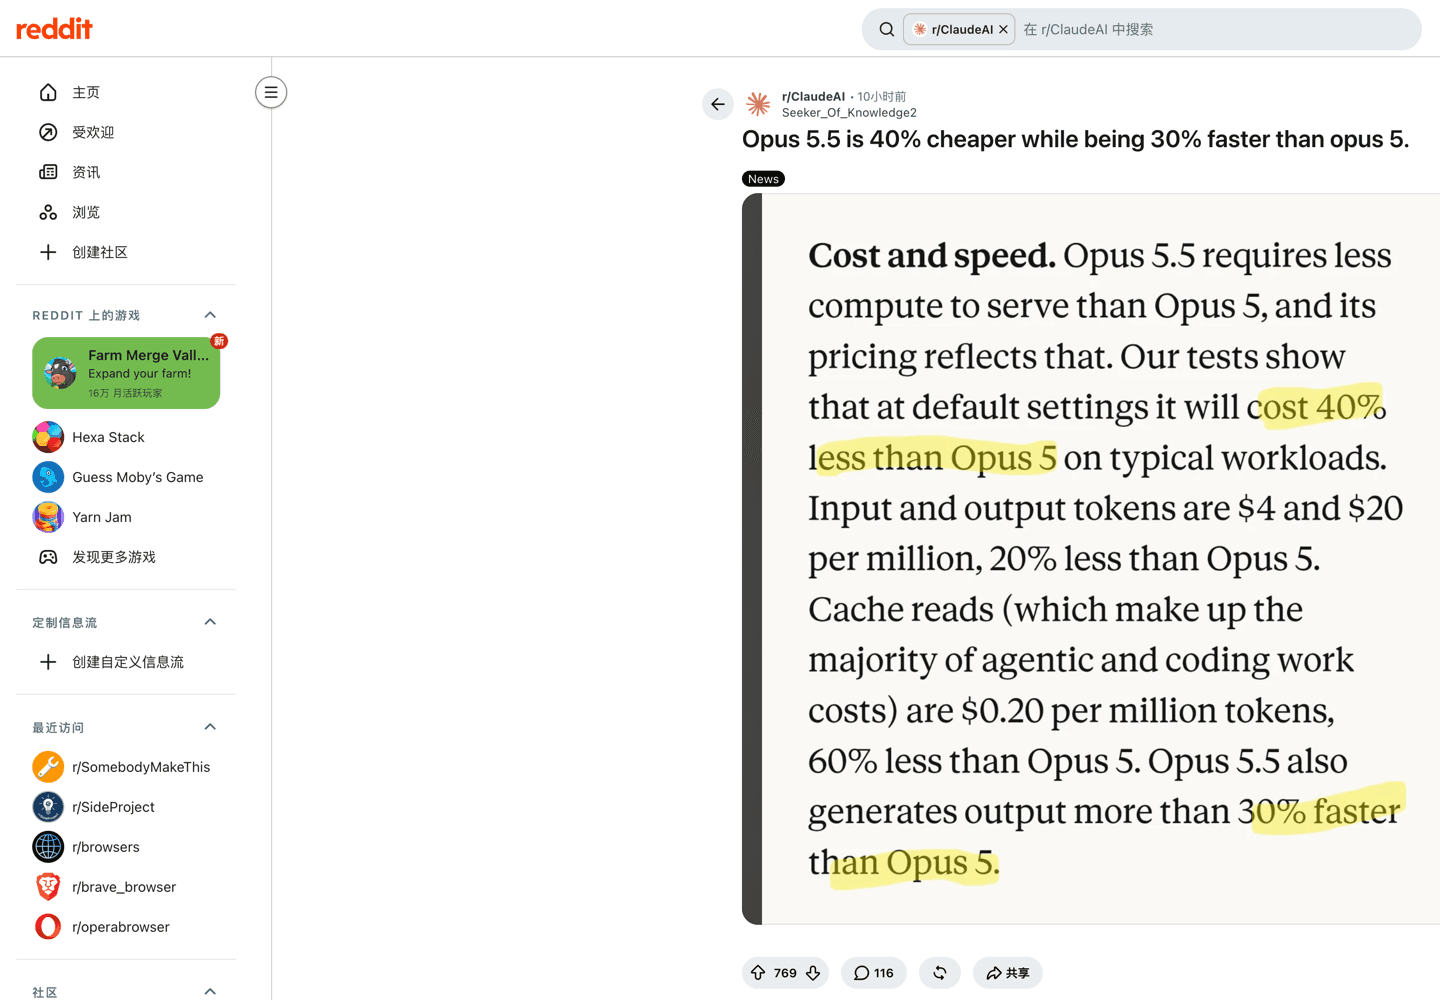
O Claude Opus 5.5 custa $4 por milhão de tokens de entrada e $20 por milhão de tokens de saída na API da Anthropic, com leituras de cache a $0,20 por milhão — todas as taxas conferidas na própria documentação de preços da Anthropic em 23 de setembro de 2026, um dia após o lançamento. Desta vez a tabela de preços é a notícia: as cinco linhas de cobrança caíram em relação ao Opus 5, a primeira geração de Opus que fica mais barata que a antecessora. Cinco gerações de Opus — da 4.5 à 5 — cotavam $5/$25, e a mais nova de repente é a mais barata. A estimativa da Anthropic: "nas configurações padrão, custará 40% menos que o Opus 5 em cargas de trabalho típicas".
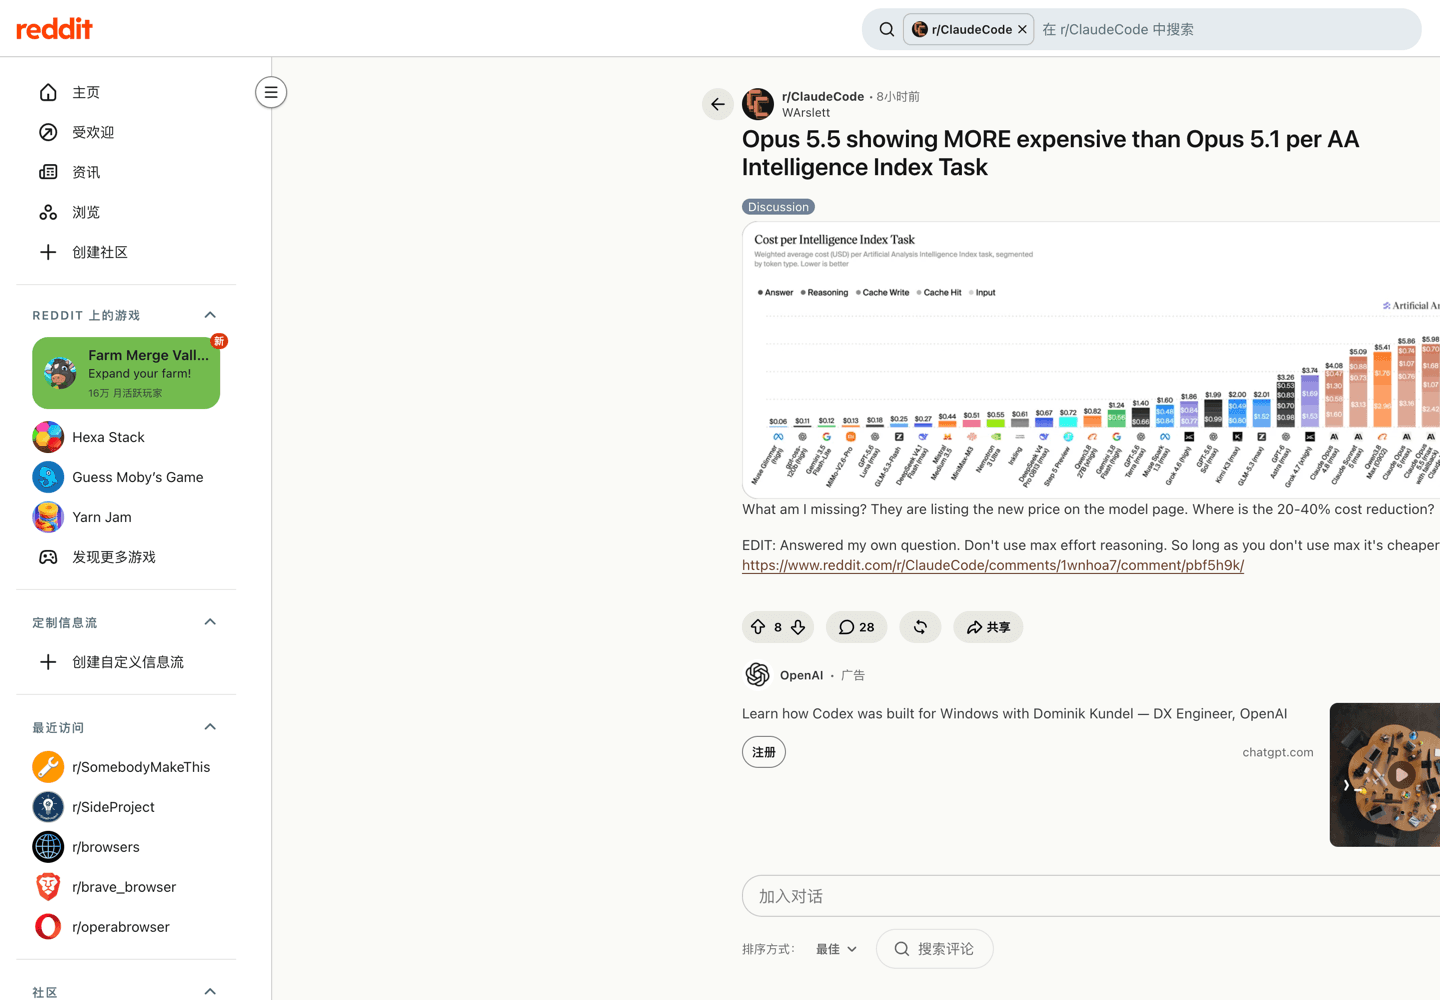
As duas metades dessa frase são verdadeiras, e a distância entre elas é a razão de este artigo existir. Na tabela oficial, uma linha fez a maior parte do trabalho — leituras de cache caíram 60%, para os mesmos $0,20 que o Sonnet 5 cobra. Fora da tabela, um desenvolvedor do r/ClaudeCode abriu o Artificial Analysis no dia do lançamento e viu o Opus 5.5 "aparecendo MAIS caro que o Opus 5.1 por tarefa do AA Intelligence Index", e então respondeu à própria pergunta: "Não use raciocínio no esforço máximo. Contanto que você não use max, é mais barato" (r/ClaudeCode). Esta página é o lado do dinheiro da história do Opus 5.5 — a visão geral da família e o status legado do Opus 4.8 cobrem o pano de fundo de capacidades; mais adiante no guia, o Tabbit Browser aparece como um lugar prático para rodar essas comparações quando o orçamento estiver claro. Primeiro, os números.
Key takeaways
A tabela: $4 de entrada, $0,20 de leitura de cache (0,05x — uma taxa que só o Opus 5.5 tem), $5/$8 de escrita de cache (5m/1h), $20 de saída por milhão de tokens. Batch corta tudo para $2/$10; o modo Fast dobra tudo para $8/$40; inferência US-only adiciona 1,1x a cada linha.
Um número fez a maior parte do corte. Leituras de cache caíram 60% ($0,50 → $0,20) — a linha que a própria Anthropic diz "compôr a maioria dos custos de trabalho agêntico e de código". A leitura de cache do Opus 5.5 agora empata a do Sonnet 5, com o dobro de modelo.
Esforço é a maior alavanca controlável. O Artificial Analysis mede $0,55 por tarefa no esforço low e $5,98 no max — uma oscilação de 11x por 16 pontos de inteligência. O padrão é medium, e o modelo pensa mais por turno que o Opus 5 no mesmo ajuste.
Sem penhasco de contexto longo. Toda a janela de 1M de tokens é cobrada a taxas padrão, e um header beta de Batch permite 300K tokens de saída. Mas o tokenizador mais novo produz ~30% mais tokens para o mesmo texto que modelos pré-4.7.
Assinaturas ganharam uma atualização paralela. O Opus 5.5 conta como alocação padrão no Pro/Max (o Fable queima créditos de uso a 50% dos limites semanais), limites de cinco horas foram aumentados nos planos pagos, e resets de limite agora podem ser guardados para depois.
Preços do Claude Opus 5.5 num relance
A tabela padrão completa, renderizada da documentação de preços da Anthropic em 23 de setembro de 2026:
| Modelo | Entrada / 1M | Escrita 5m / 1M | Escrita 1h / 1M | Leitura cache / 1M | Saída / 1M |
|---|---|---|---|---|---|
| Claude Opus 5.5 | $4,00 | $5,00 | $8,00 | $0,20 | $20,00 |
| Claude Fable 5.1 | $10,00 | $12,50 | $20,00 | $0,25 | $50,00 |
| Claude Opus 5 | $5,00 | $6,25 | $10,00 | $0,50 | $25,00 |
| Claude Sonnet 5 | $2,00 | $2,50 | $4,00 | $0,20 | $10,00 |
| Claude Haiku 4.5 | $1,00 | $1,25 | $2,00 | $0,10 | $5,00 |
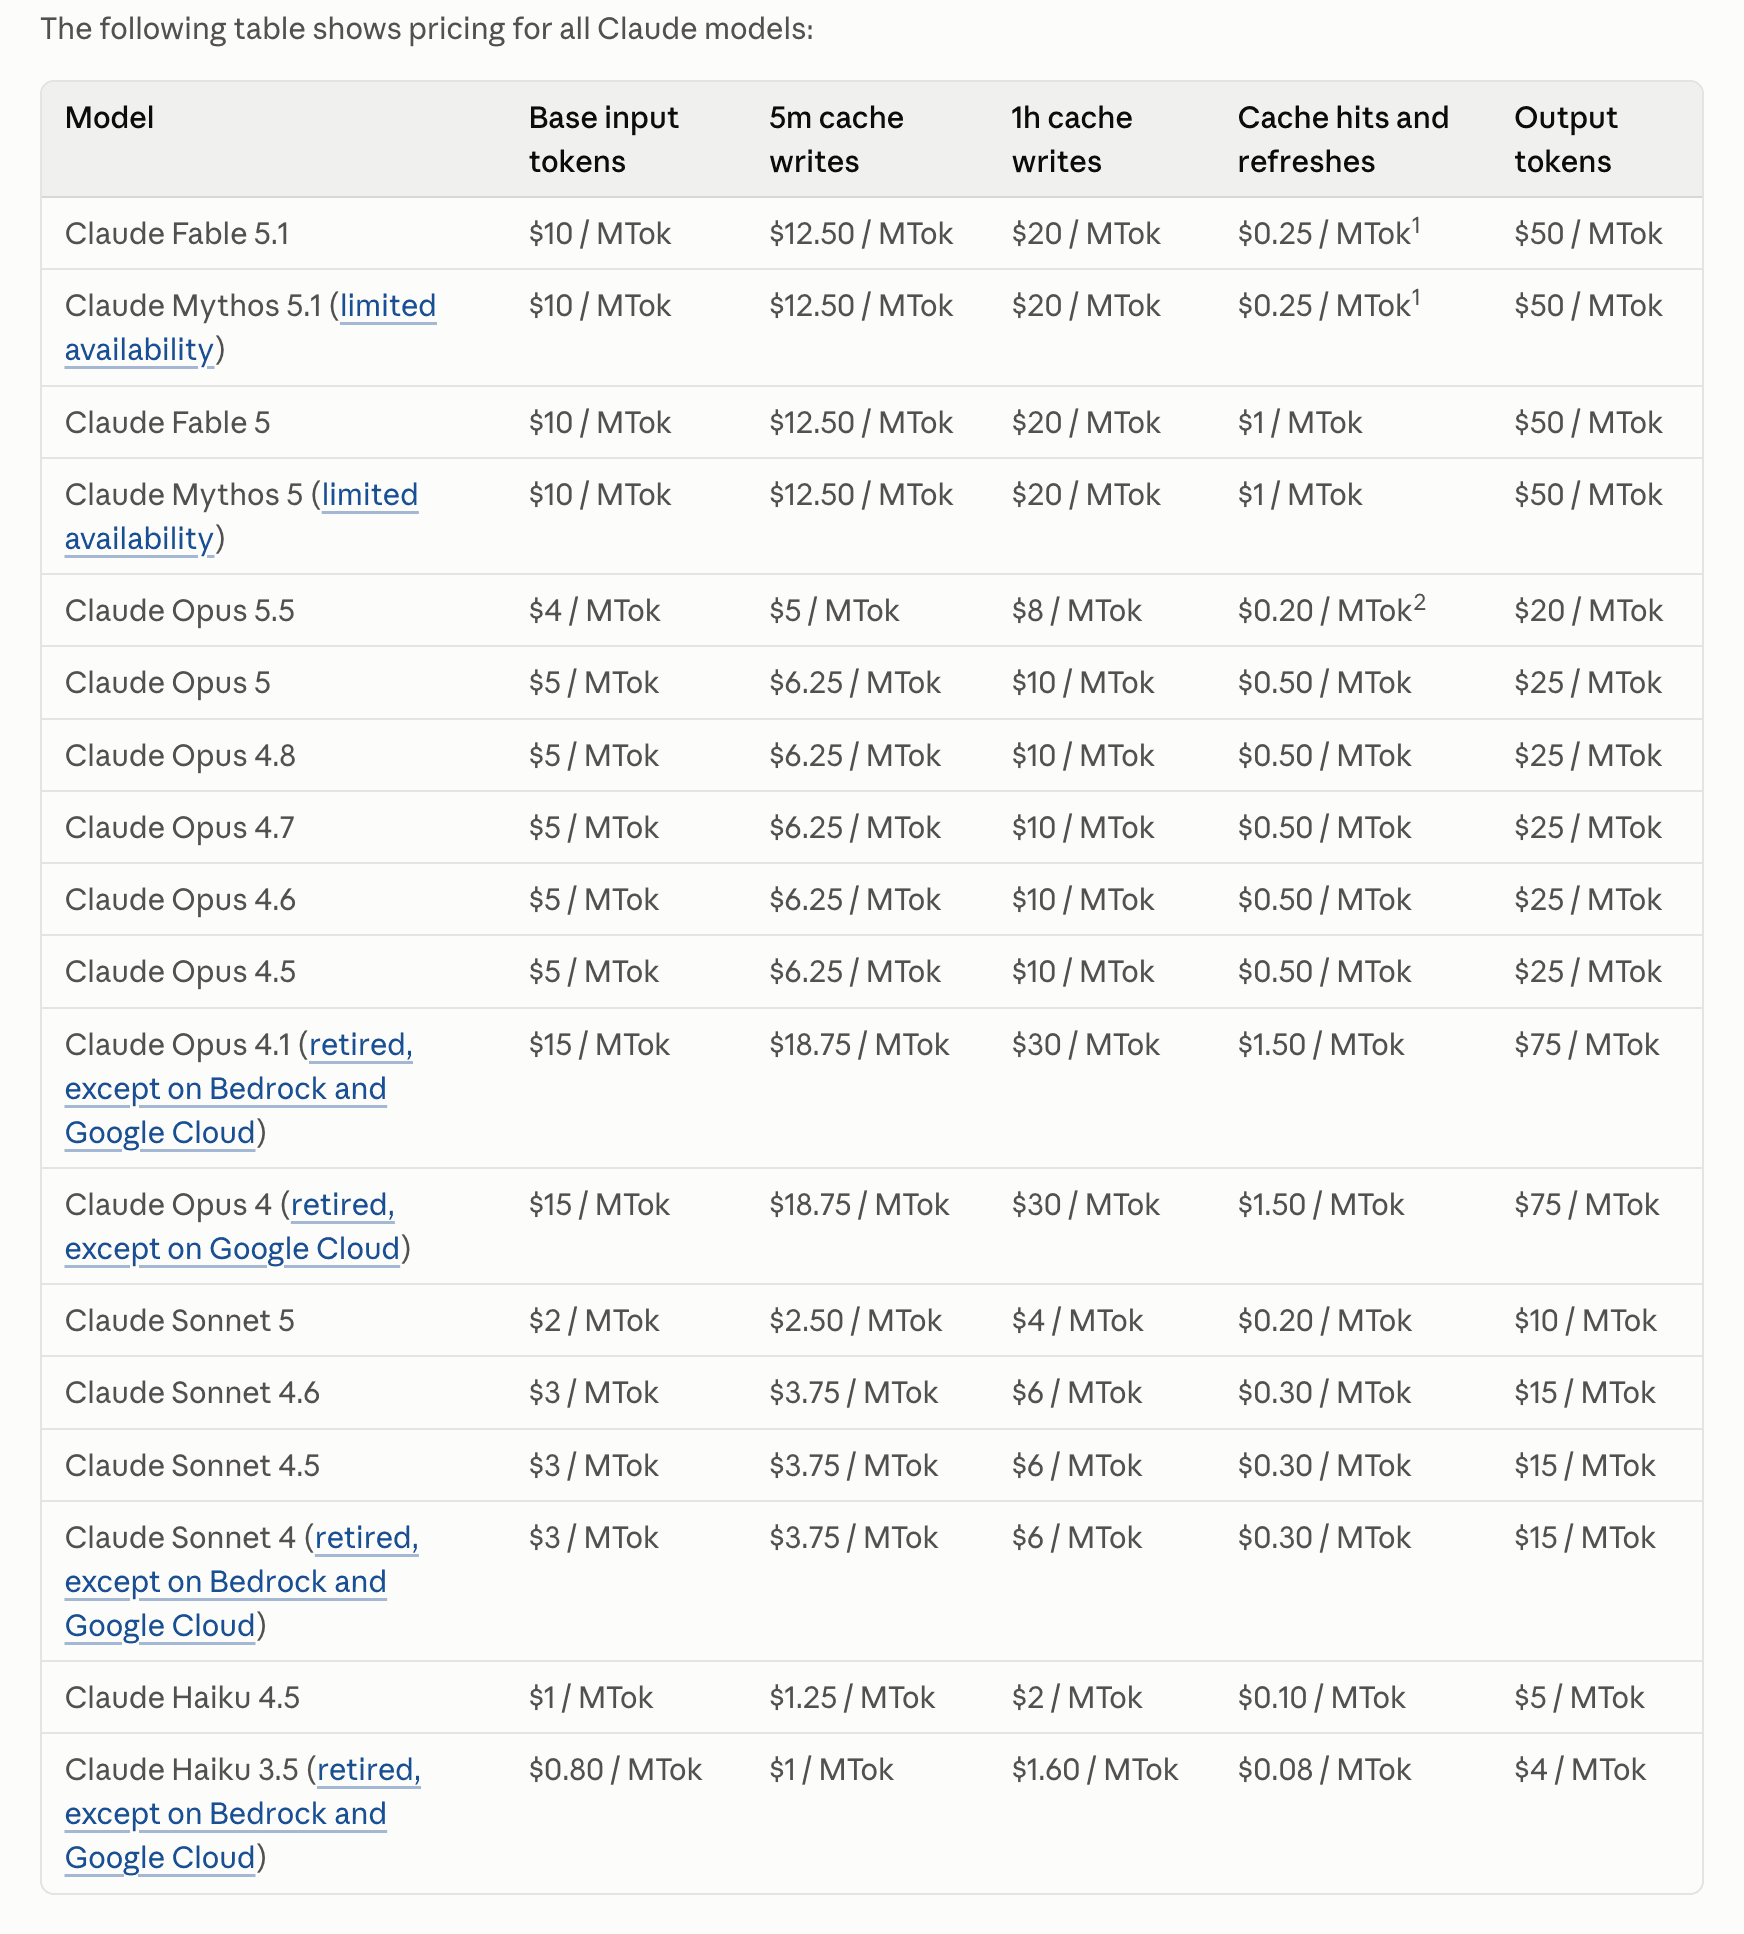
Três coisas nesta tabela merecem atenção, e nenhuma é o $4 do título:
Leituras de cache agora têm multiplicador próprio. Leituras de todos os outros modelos padrão custam 0,1x a entrada base; Fable 5.1 e Mythos 5.1 pagam 0,025x; o Opus 5.5 fica entre os dois em 0,05x, segundo a nota de rodapé da Anthropic. O resultado: $0,20 — idêntico à leitura de cache do Sonnet 5.
A saída ainda é 5x a entrada. O raciocínio adaptativo não pode ser desligado neste modelo, e tokens de pensamento são saída faturável. Um prompt modesto com uma longa cadeia de raciocínio é uma conta de saída vestida de entrada.
O tokenizador mudou debaixo de você há duas gerações. Modelos Claude 4.7 e posteriores produzem aproximadamente 30% mais tokens para o mesmo texto, segundo a própria nota da Anthropic. Comparar preço por token com taxas da era Opus 4.6 superestima em um terço o custo do modelo antigo.
Vale fixar também: toda a janela de 1M de tokens é cobrada a taxas padrão — não existe faixa de contexto longo. Diferente do penhasco de 272K do GPT-6 Astra, onde cruzar um limar reprecifica a requisição inteira, no Opus 5.5 "uma requisição de 900k tokens é cobrada à mesma taxa por token que uma de 9k", nas palavras da Anthropic.
O número que mudou: leituras de cache caíram 60%
Cinco linhas de cobrança se moveram entre o Opus 5 e o Opus 5.5, mas o corte que importa para trabalho agêntico é a linha de leitura: $0,50 → $0,20 por milhão, um corte de 60% e um novo multiplicador de 0,05x.
A mecânica: quando uma requisição repete um prefixo já processado — prompt de sistema, contexto de repositório, histórico de conversa, definições de ferramentas — a API lê esse prefixo do cache em vez de reprocessá-lo. Escritas custam 1,25x a entrada base para uma entrada de 5 minutos ($5/M aqui), 2x para uma de 1 hora ($8/M). Leituras custam 0,05x da base — $0,20/M — só neste modelo. O cache se paga após uma relectura de 5 minutos ou duas de 1 hora, os multiplicadores se acumulam com Batch e residência de dados, e o prompt mínimo cacheável é de 512 tokens.
Por que isso domina contas de agentes: um agente que faz 40 chamadas de ferramenta sobre um contexto de 200.000 tokens relê esse prefixo 40 vezes. Sob as leituras de $0,50/M do Opus 5, essas relecturas custam $4,00; sob os $0,20/M do Opus 5.5, custam $1,60 — antes de gerar um único token novo. A própria página de lançamento da Anthropic aponta exatamente para esta linha: leituras de cache "compõem a maioria dos custos de trabalho agêntico e de código", e o corte de 60% é a maior fatia individual dos 40% oficiais.
O lado de assinatura da mesma história, do campo:
"Usage drains so slowly with opus 5.5. Have multiple threads going on xhigh and max and the usage bar is hardly budging", lê-se numa resposta; outro usuário relata duas tarefas substanciais sem a alocação semanal se mover. São experiências de plano auto-relatadas, não benchmarks — mas apontam na mesma direção da matemática da API: a linha de leitura é onde vivem os orçamentos agênticos.
A armadilha, como sempre: economias de cache exigem um prefixo estável. Se seu contexto muda a cada turno — saídas dinâmicas de ferramentas, documentos rotativos — você paga a penalidade de escrita de 1,25x–2x repetidamente em vez de surfar as leituras de 0,05x. E os blocos de pensamento estão amarrados ao modelo e à conversa no Opus 5.5; editar o prefixo os invalida, que é a história da próxima seção em miniatura.
O que "40% mais barato" realmente significa
A afirmação de lançamento da Anthropic tem três condições precisas, e analisá-las é a diferença entre um orçamento e um desejo. "Nossos testes mostram que, nas configurações padrão, custará 40% menos que o Opus 5 em cargas de trabalho típicas."
Condição um: a linha de base é o Opus 5, não concorrentes nem Fable. A afirmação soma dois efeitos — o corte de tabela de ~20% mais menos tokens por tarefa ("custa menos por token que o Opus 5 e usa menos tokens por tarefa, o que liquida em uma queda de 40% nos custos"). Os próprios exemplos da Anthropic caem na mesma faixa e acima: uma reescrita do HAProxy de C para Rust terminou em 9,5 horas contra 12 do Fable 5.1 por 51% menos de custo; uma auditoria de codebase de 200.000 linhas levou menos de 3 horas onde o Opus 5 levou mais de 20 e usou 2,5x os tokens. Testadores citados relataram cortes de custo de 40–50% (Spotify), metade dos tokens (Kiro), um terço (Box) e "o primeiro modelo que colocaríamos no medium por padrão" (Factory). Um comentarista do HN resumiu a linha de tendência: "lançar um modelo com ~3-6x a razão desempenho/custo do seu lançamento de apenas 3 semanas atrás" (Hacker News).
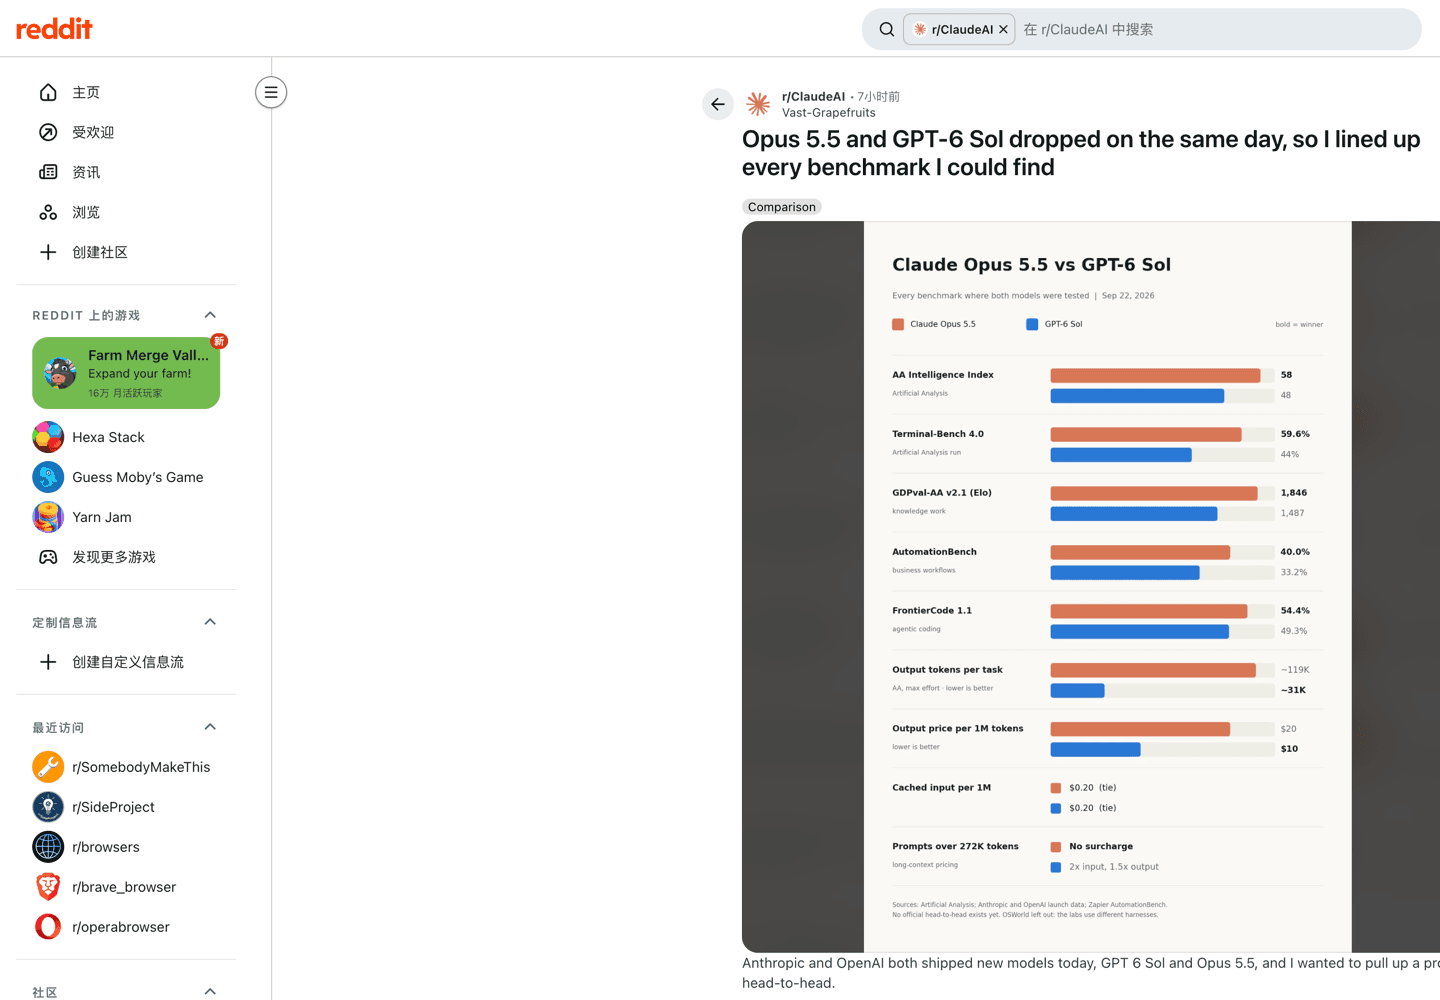
Condição dois: "configurações padrão" significa esforço medium. No esforço max a matemática inverte — o modelo "tende a pensar mais por turno que o Claude Opus 5, sobretudo em xhigh e max", segundo as notas oficiais de comportamento, e raciocínio faturável é onde orçamentos morrem. A thread de comparação do r/ClaudeAI quantificou o formato: "No esforço max, o AA mediu o Opus 5.5 em cerca de 119K tokens de saída por tarefa, enquanto o [GPT-6] Sol usou cerca de 31K e custou $1,06 por tarefa para o índice inteiro":
Condição três: "cargas de trabalho típicas" significa que as suas talvez não sejam. A comunidade carrega cicatrizes aqui, e elas têm preço. O comentário mais votado (226 pontos) na thread da notícia:
"quando lançaram o Opus 5, viviam proclamando o quão avançado o modelo era… as pessoas descobriram que o Opus 5 nem se comunicava direito… os vai-e-vens levaram muita gente a duvidar de si, desperdiçando ainda mais tempo e tokens." Céticos da mesma rede leem os gráficos do AA ao contrário — "opus 5.5 venceu a astra… mas usou 4,5x os tokens para a mesma tarefa" — enquanto defensores leem "mesmo desempenho, opus 5.5 medium vs Astra max, 2,5x mais barato". Ambos leem o mesmo lançamento. A qual sua conta se assemelha depende de qual token a domina — e é isso que a próxima seção mede. Para o lado de capacidades dessa troca, veja o review do Fable 5.1 e nosso guia de raciocínio agêntico.
A alavanca de esforço: de $0,55 a $5,98 por tarefa
Nada na tabela diz que este dial move o custo mais do que qualquer linha de preço. O Artificial Analysis acompanha o Opus 5.5 como cinco entradas separadas; instantâneo de 23 de setembro de 2026:
| Esforço | Intelligence Index | Custo por tarefa II | Velocidade de saída |
|---|---|---|---|
| low | 42 | $0,55 | 83 t/s |
| medium (padrão) | 51 | $1,34 | 76 t/s |
| high | 54 | $1,82 | 90 t/s |
| xhigh | 56 | $3,46 | 76 t/s |
| max | 58 | $5,98 | — |
Leia as colunas das pontas juntas: o esforço max custa 10,9x o low por tarefa, por 16 pontos de inteligência medida. O medium — o padrão — entrega o mesmo índice de inteligência do Opus 5 no esforço max ($1,34 contra o preço do nível max do Opus 5). "max custa quase o dobro do xhigh e é um ponto fora da curva dos outros níveis. Se usar medium ou high, você deve ver economia real", como resumiu a resposta mais votada da thread no r/ClaudeCode. Um desenvolvedor lá já reconstruiu um fluxo ao redor da escada: "Opus 5.5 High é absurdo de bom. Parece fable 5.1 medium, mas bem mais barato… mudei meu fluxo para usar Opus 5.5 high na maior parte."
Duas ressalvas antes de girar o dial. Primeira, migração: o padrão saiu de high (Opus 5) para medium, e no mesmo ajuste o modelo novo pensa mais por turno — os docs da Anthropic mandam refazer seu sweep de esforço em vez de carregar um ajuste, e deixar espaço em max_tokens para o pensamento. Segunda, esforço maior não compra qualidade de forma confiável. A avaliação do CodeRabbit no dia do lançamento encontrou que "esforço de raciocínio mais alto não entregou de forma consistente uma melhor taxa de conclusão" — e mais comentários para o desenvolvedor avaliar já é, por si, um custo:
As citações de clientes na página de lançamento vão na mesma direção — a Rogo bateu o Opus 5 no high "no seu ajuste de esforço mais baixo… com cerca de 60% menos tokens de saída"; a Walleye Capital "resolveu em grande parte" a suíte deles no ajuste mais baixo. Quando as evidências do próprio fornecedor apontam repetidamente para os ajustes baratos, tome isso como resposta padrão e guarde o max para as tarefas que comprovadamente precisam dele.
As linhas de cobrança fora do título
Cinco linhas decidem a maioria das contas reais, e só a primeira aparece na cobertura de lançamento.
Modo Fast: 2x em cada linha, por até 2,5x de velocidade. O Fast (prévia de pesquisa, só na API Claude) cobra $8 de entrada / $40 de saída — o dobro da tabela padrão, linhas de cache incluídas ($0,40 de leitura). Acumula com cache e residência de dados, não combina com Batch, e entrega saída "até 2,5x" mais rápida; a tabela de provedores do OpenRouter mede 143 tok/s no Fast contra 71–83 no padrão. Vale notar: o Fast Opus 5.5 a $40/M de saída ainda fica abaixo dos $50 padrão do Fable 5.1.
Batch: a alavanca de 50%. Requisições assíncronas de Batch são cobradas a $2/$10 — o maior desconto da tabela, acumulável com cache de prompt na janela de contexto inteira, com um header beta permitindo até 300K tokens de saída. Sessões de agente gerenciado não se qualificam; são stateful e interativas.
Inferência US-only: 1,1x em tudo. Definir inference_geo: "us" multiplica cada categoria — entrada, saída, escritas e leituras de cache — por 1,1x. Os mesmos 10% aparecem como preço de endpoint regional nas nuvens parceiras: o OpenRouter lista rotas regionais Bedrock/Azure/Vertex a $4,40/$22,00/$0,22. Regiões por conformidade pagam um prêmio silencioso por linha; o roteamento global é o padrão e o caminho mais barato.
Sobrecargas de ferramentas são contas de tokens. O prompt de sistema de uso de ferramentas adiciona 286 tokens por requisição (contra 675 do Opus 4.7); declarar o conjunto de ferramentas de navegador adiciona cerca de 6.600 tokens de entrada, computer use cerca de 4.500. Busca web no lado servidor cobra $10 por 1.000 buscas além dos tokens; execução de código é gratuita junto a search/fetch, com 1.550 horas de contêiner grátis por mês antes de $0,05/hora. Um "agente" é uma estrutura de preços, não um chat — orce a linha de ferramentas explicitamente. Para a ponta econômica dessa comparação, veja a decomposição de preços do Kimi K3.
Runtime de Managed Agents: $0,08 por hora de sessão, medido só enquanto executa, todas as linhas de tokens a taxas do modelo. Batch não se aplica a sessões.
A escada da família: Opus 5.5 vs Fable 5.1 vs Opus 5 vs Sonnet 5
| Linha (por 1M de tokens) | Opus 5.5 | Fable 5.1 | Opus 5 | Sonnet 5 |
|---|---|---|---|---|
| Entrada | $4,00 | $10,00 | $5,00 | $2,00 |
| Leitura de cache | $0,20 (0,05x) | $0,25 (0,025x) | $0,50 (0,1x) | $0,20 (0,1x) |
| Saída | $20,00 | $50,00 | $25,00 | $10,00 |
| Batch entrada / saída | $2,00 / $10,00 | $5,00 / $25,00 | $2,50 / $12,50 | $1,00 / $5,00 |
| AA Intelligence Index (max) | 58 | 53 | 51 | 38 |
| Custo AA por tarefa II (max) | $5,98 | $7,63¹ | — | — |
¹ Cifra do Fable 5.1 do instantâneo de 22 de setembro do AA, via nossa decomposição de preços do Fable; as duas páginas do AA mudam diariamente.
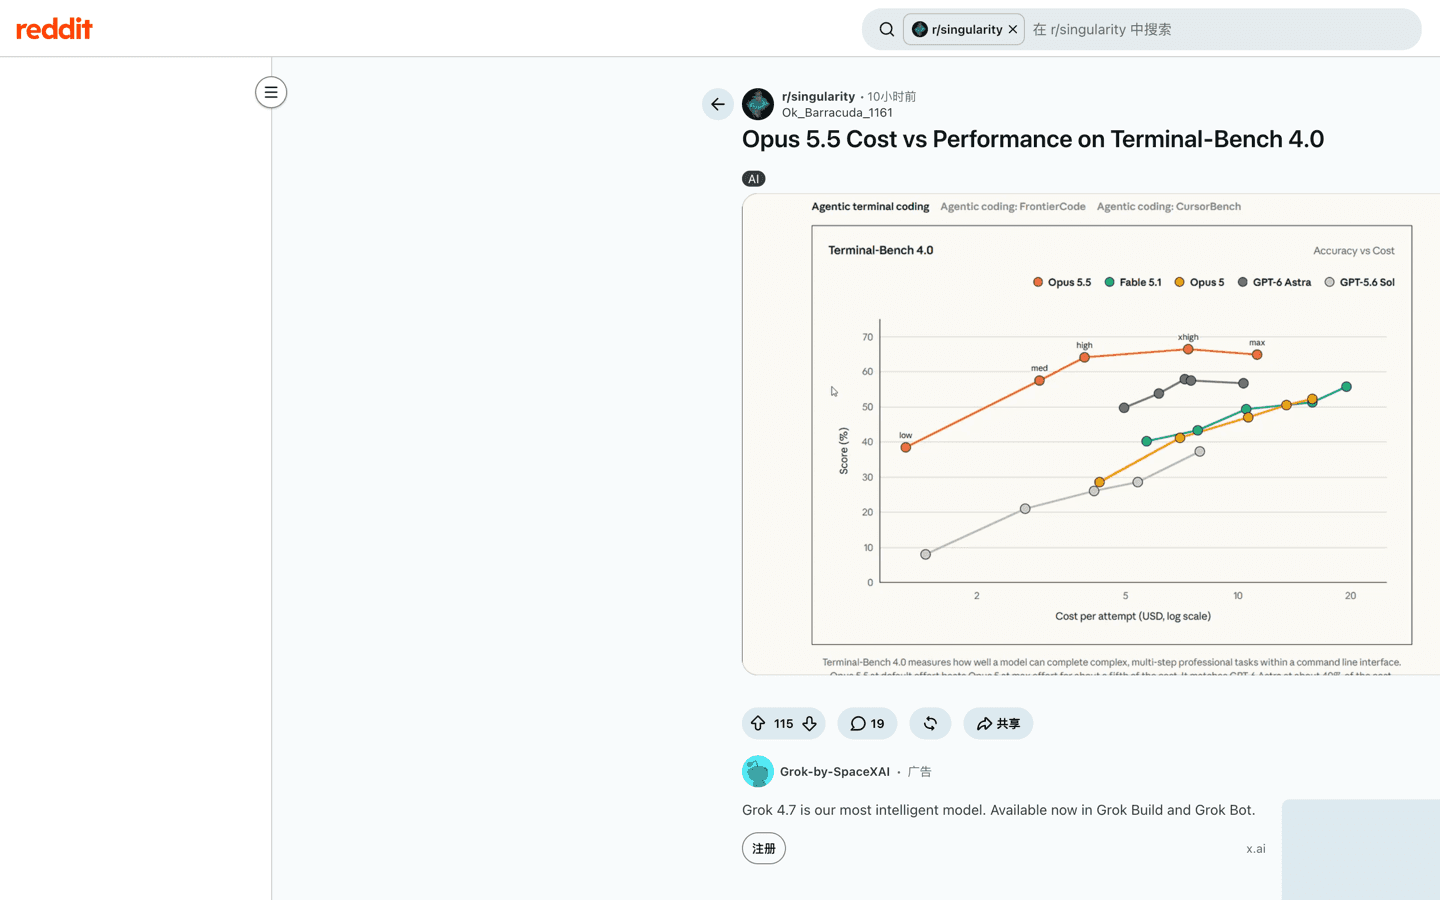
A linha contraintuitiva é a última: no índice do Artificial Analysis, o modelo mais barato agora também é o mais forte. O Opus 5.5 no esforço max pontua 58 contra 53 do Fable 5.1, a $5,98 versus $7,63 por tarefa — enquanto o posicionamento da própria Anthropic ainda reserva o Fable para "trabalho ambicioso, de longa duração e assíncrono" e descreve a distância Opus-Fable como "mais estreita do que essas pontuações sugerem". Leia assim: as pontuações exageram a distância, mas a distância de preço é real e invertida. Loops com contexto cacheado ficam ainda mais próximos — o Fable mantém o desconto de leitura mais profundo (0,025x), mas suas leituras partem de uma base de $10: $0,25/M. Os $0,20 do Opus 5.5 vencem em termos absolutos.
As duas leituras comunitárias do mesmo gráfico do AA, lado a lado:
"same tokens … same performance opus 5.5 med vs Astra max — 2.5x cheaper" contra "opus 5.5 venceu a astra… mas usou 4,5x os tokens para a mesma tarefa". Ambos descrevem o mesmo formato: o Opus 5.5 vence em custo por tarefa concluída e perde em tokens por tarefa. Se suas cargas são sensíveis ao formato de tokens — orçamentos rígidos por token, roteadores terceiros, tetos de throughput — meça antes de migrar; se são sensíveis à tarefa, a escada favorece o Opus 5.5 em praticamente todos os degraus.
Abaixo dos degraus flagship, o Sonnet 5 mantém a cadeira econômica a $2/$10 com leitura de $0,20 — o mesmo preço de leitura do Opus 5.5 agora — e o Haiku 4.5 segura $1/$5. A nova lógica da escada: a coluna de leitura de cache comprimiu-se ao ponto de o modelo inteligente e o modelo barato cobrarem o mesmo pela linha que os agentes mais martelam.
Pelo que você não paga
Os documentos traçam limites que lembram política de reembolso, e em escala agêntica eles importam:
Blocos de pensamento descartados não são cobrados. Quando uma requisição carrega um bloco que o modelo não consegue ler, a API o descarta antes da inferência: "a requisição tem sucesso, e blocos descartados não são cobrados". Para um modelo cujos blocos estão amarrados à conversa, essa é a linha de degradação graciosa.
Reroteamentos de salvaguarda são concluídos em outros modelos. Requisições sinalizadas por cibersegurança são concluídas pelo Opus 4.8, segundo a nota de benchmarks da página de lançamento; o repasse é transparente (recusas devolvem
stop_reason: "refusal"com a área de política, e o fallback do lado servidor tenta de novo num modelo recomendado). A Anthropic não detalha a cobrança do reroteamento para o Opus 5.5 como fez com o Fable — até documentação, assumir a taxa do modelo que conclui é o prudente.Buscas na web falhadas não são cobradas. As bem-sucedidas cobram $10 por 1.000; as erradas, nada. Web fetch não adiciona encargo além dos tokens em que o conteúdo baixado se converte.
Execução de código é gratuita junto a search ou fetch, e toda organização recebe 1.550 horas de contêiner grátis por mês antes de a taxa de $0,05/hora começar.
Disponibilidade em planos: API, nuvens e planos de consumo
A tabela da API é apenas uma de três economias. Verificado em claude.com/pricing e na documentação em 23 de setembro de 2026:
| Superfície | Preço (valor verificado) | Acesso ao Opus 5.5 |
|---|---|---|
| API Anthropic | Taxas por token acima | Sim — claude-opus-5-5 |
| Plano Free | $0 | Não (só Sonnet/Haiku) |
| Pro | $17/mês anual ($200 adiantados) ou $20 mensal | Sim — alocação padrão |
| Max 5x / 20x | A partir de $100/mês | Sim — alocação padrão |
| Team | Assentos Standard acima do Pro; Premium = 5x Standard | Sim |
| Enterprise | $20/assento/mês anual + uso a taxas de API | Sim, com controles de gasto |
| Nuvens | AWS Bedrock, Google Cloud, Microsoft Foundry, Claude Platform on AWS | Sim; endpoints regionais +10%, Foundry mede em CCUs |
A linha de assinatura que merece destaque: na comparação de planos, o Opus consome alocação de uso padrão no Pro e Max — o asterisco de "créditos de uso, 50% dos limites semanais" carregado pelo Fable. Uma hora de Fable custa contra sua alocação o que duas horas de um modelo padrão; uma de Opus 5.5, não. A Anthropic empilhou mais duas mudanças no lançamento: limites de cinco horas aumentados no Pro, Max, Team e Enterprise por assento, e um reset de limite que "agora você pode guardar e usar quando escolher".
A comunidade está dividida sobre o que isso significa na prática, as duas direções visíveis nas mesmas threads da semana de lançamento:
"I am using Fable 5.1 rn, and this is 5x cheaper for same intelligence? I am never going to hit my weekly limits at this rate" — contra — "esses cortes não necessariamente se traduzem em assinaturas… usam custos de API como material de marketing." O aumento de limites está documentado; quão generoso se mostra é um ver-para-ver que só suas próprias janelas de cinco horas podem responder. Mecanicamente: o uso reseta em janelas de sessão rotativas de cinco horas com limites semanais adicionais nos planos pagos; web, desktop, mobile e Claude Code bebem de um mesmo pool; e créditos de uso em planos pagos deixam você continuar a taxas padrão de API além dos limites.
Dois orçamentos calculados, com todas as premissas à vista
Taxas padrão, sem retries, sem ferramentas, sem impostos. Aritmética, não previsões.
Uma pergunta curta com um pensamento longo. 10.000 tokens de entrada, 2.000 de saída:
(10.000 × $4 + 2.000 × $20) / 1.000.000 = $0,08Um loop de agente a frio num repositório grande. 300.000 tokens de entrada (taxa padrão — sem faixa de contexto longo), 8.000 de saída:
(300.000 × $4 + 8.000 × $20) / 1.000.000 = $1,36A versão a quente do mesmo loop. Mesmo contexto de 300.000 tokens, 90% em cache, uma escrita de 1 hora por sessão, 8.000 de saída por passagem:
por passagem: (270.000 × $0,20 + 30.000 × $4 + 8.000 × $20) / 1.000.000 = $0,334
única: 300.000 × $8 / 1.000.000 = $2,40 de escrita por sessão
A passagem a quente cai a um quarto do custo a frio, e a escrita de $2,40 se amortiza em cada passagem que a reutiliza — uma escrita de 5 minutos ($1,50) se paga após uma relectura, a de uma hora após duas. O prefixo que muda devolve o mesmo loop ao frio de $1,36 a cada passagem. O recurso do modelo (English) e sua coleção de prompts (English) acompanham tarefas repetíveis para medir sua própria taxa de acerto.
Cálculo local
Estime o custo de tokens da API Claude Opus 5.5
Usa as tarifas oficiais em USD verificadas em 23/09/2026. Os valores ficam neste navegador.
As leituras de cache são cobradas a 0,20 USD por milhão de tokens — a tarifa 0,05x do Opus 5.5. A estimativa exclui novas tentativas, sobrecustos de ferramentas, redirecionamentos de salvaguarda e margens de provedores. O modo Fast dobra cada linha e não combina com Batch. Ver tarifas atuais
A calculadora roda inteiramente nesta página — nada é enviado a lugar nenhum. Ela precifica ambas as durações de escrita de cache e os modos Padrão, Batch, US-only e Fast, e valida entradas localmente. O que deliberadamente não modela: retries, fan-out de subagentes, sobrecargas de ferramentas e reroteamentos de salvaguarda — isso vai na sua margem. Reconfira a tabela oficial antes de comprometer um orçamento; estes são os números de 23 de setembro de 2026.
Uma opção prática: rode a comparação no Tabbit
Depois do orçamento vem a parte chata: rodar trabalho em formato Opus precisa de um lugar onde páginas, arquivos e chamadas de modelo morem juntos, e onde "testar Opus 5.5 no medium, recuar para Sonnet" seja uma seleção e não um projeto de orquestração. É a lacuna que o Tabbit Browser ocupa — um navegador de IA agêntico cujo seletor de modelos, abas vivas e arquivos locais dividem uma mesma superfície.
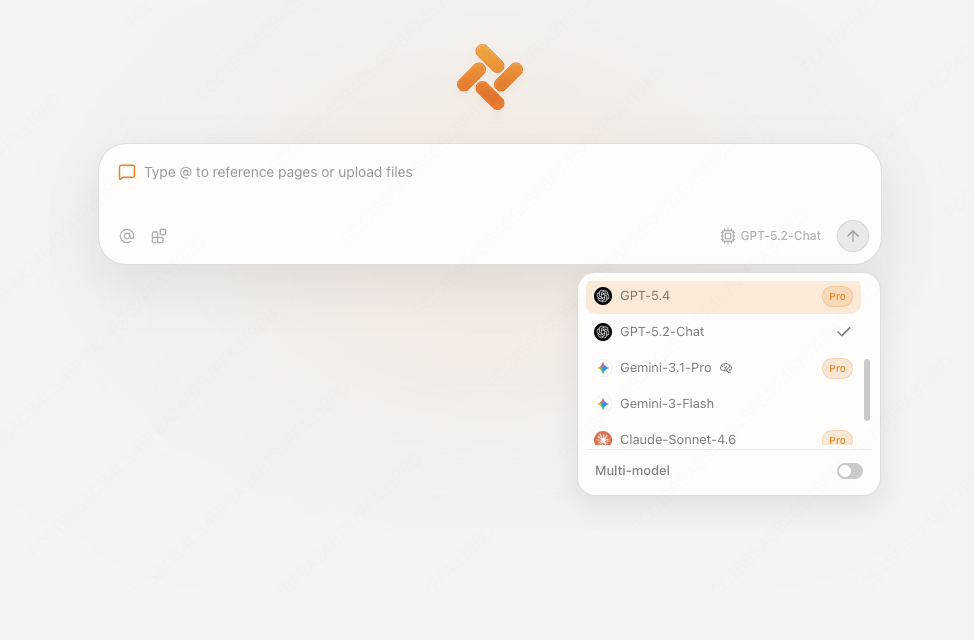
Os limites, ditos sem rodeios: o Tabbit é um cliente, não uma camada de cobrança da Anthropic. A disponibilidade de modelos depende da sua conta e edição, e nada no navegador muda o que a Anthropic cobra — a tabela acima vale onde quer que o Opus 5.5 rode. Este artigo não rodou uma tarefa de Opus 5.5 dentro do Tabbit, portanto nenhuma alegação de disponibilidade ou desempenho é feita aqui. O que o navegador muda é o custo de montagem: medir sua própria taxa de acerto de cache e seu limiar de esforço em trabalho real — os dois números que esta página inteira diz decidirem sua conta — antes de escrever qualquer orquestração sai mais barato num espaço de trabalho construído exatamente para isso. O guia de hábitos de trabalho do Tabbit cobre o método.
 Tabbit Browser
Tabela de decisão de preços do Claude Opus 5.5
| Sua carga de trabalho | Diretor de custo | Melhor ponto de partida | Cuidado com |
|---|---|---|---|
| Loops longos de agente, contexto estável de repositório/documentos | Leituras de cache | Nível padrão, prefixos estáveis, escritas 1h | Editar o prefixo invalida blocos de pensamento amarrados; churn vira leituras em escritas de 1,25–2x |
| Chat curto, edições rápidas | Tokens de saída | Esforço menor — ou Sonnet 5 | O pensamento não desliga; medium padrão costuma bastar |
| Avaliações noturnas, refactors em lote | Volume | API Batch a $2/$10, beta de 300K de saída | Sessões interativas e de agente gerenciado não se qualificam |
| Trabalho interativo limitado por latência | Velocidade de saída | Modo Fast a 2x ($8/$40), com cache | Fast não combina com Batch; dobra cada linha |
| Processamento nos EUA por conformidade | Cada linha | US-only a 1,1x, ou endpoints regionais de nuvem (+10%) | O prêmio também se aplica a leituras de cache |
| Orçamentos sensíveis ao formato de tokens (roteadores, tetos) | Tokens por tarefa | Meça antes de migrar | Opus 5.5 vence em custo-por-tarefa, perde em tokens-por-tarefa contra rivais |
| Uso diário por assinatura | Janelas de 5 horas | Pro/Max — Opus como alocação padrão, limites aumentados | Fable nos mesmos planos queima créditos a 50% dos limites semanais |
Veredito final
O Claude Opus 5.5 é o primeiro Opus que saiu mais barato que o antecessor, e o corte é real em cada linha — 20% na entrada e saída, 60% nas leituras de cache que dominam contas agênticas, agora ao preço do Sonnet 5. Compre-o para código agêntico de longo alcance e trabalho de conhecimento no esforço medium, com prefixos estáveis e Batch carregando tudo o que pode esperar; no índice do AA ele já superou o Fable 5.1 custando menos por tarefa, o que reordena a escada da família. As duas contas que ele não conserta: pensamento no esforço max (uma alavanca de 11x que a tabela jamais mostra) e orçamentos sensíveis ao formato de tokens, onde ainda gasta mais tokens por tarefa que rivais mais enxutos. Em assinatura, é o flagship amigo da alocação — uso padrão, limites aumentados — mas verifique sua própria queima de cinco horas antes de comprometer uma equipe. Reconfire a página oficial de preços mensalmente: a padronização do Sonnet 5 e este lançamento mostram que a escada anda rápido. A história de capacidades vive na visão geral do Fable 5.1 e no review; os registros comunitários linkados acima carregam a evidência de cargas de trabalho; e a comparação de preços entre famílias mostra o que a mesma tabela custa em outro lugar.
Sources
Documentação de preços da Anthropic — tabela, nota de 0,05x no cache, modo Fast, Batch, residência, preços de ferramentas; verificado em 23 de setembro de 2026
Página do modelo Claude Opus 5.5 e novidades — especificações, esforço padrão, mudanças que quebram, "pensa mais por turno", cobrança de blocos descartados; verificado em 23 de setembro de 2026
Página de lançamento da Anthropic — alegação dos 40% e condições, exemplo HAProxy, citações de custo de clientes, aumento de limites, reroteamentos; verificado em 23 de setembro de 2026
claude.com/pricing — comparação Free/Pro/Max e regras de alocação Opus vs Fable; verificado em 23 de setembro de 2026
Página de lançamento do Artificial Analysis — inteligência por esforço, velocidade, instantâneo de custo por tarefa; verificado em 23 de setembro de 2026
OpenRouter Opus 5.5 — taxas de provedores, endpoints regionais, throughput do Fast; verificado em 23 de setembro de 2026
Registros comunitários com capturas e condições inline: pergunta de max no r/ClaudeCode, comparação com Sol no r/ClaudeAI, thread de lançamento no r/ClaudeAI, divisão de assinatura no r/singularity, leituras de gráficos no X, vídeo de avaliação do CodeRabbit, thread de lançamento no HN

Perguntas frequentes
Quanto custa o Claude Opus 5.5?
Na API da Anthropic, o Claude Opus 5.5 custa $4 por milhão de tokens de entrada e $20 por milhão de tokens de saída, verificado na documentação de preços da Anthropic em 23 de setembro de 2026. Escritas de cache de prompt custam $5 por milhão (5 minutos) ou $8 por milhão (1 hora), e leituras de cache custam $0,20 por milhão — uma taxa de 0,05x exclusiva deste modelo. A API Batch corta tudo pela metade, para $2/$10, e o modo Fast dobra tudo, para $8/$40.
O Claude Opus 5.5 é mais barato que o Opus 5?
Todas as linhas da tabela caíram: entrada e saída estão 20% abaixo dos $5/$25 do Opus 5, escritas de cache caíram de $6,25/$10 para $5/$8, e leituras de cache despencaram 60%, de $0,50 para $0,20. A Anthropic estima que cargas de trabalho típicas, nas configurações padrão, custem cerca de 40% menos no total. A exceção é o esforço: no nível max o modelo pensa mais por turno, e medições independentes por tarefa vão de $0,55 no low a $5,98 no max — uma amplitude de 11x que nenhum preço de tabela mostra.
O Claude Opus 5.5 está disponível no plano gratuito?
Não. A comparação de planos da Anthropic marca o Opus como indisponível no Free, que oferece apenas os modelos Sonnet e Haiku. O Opus 5.5 está incluído nas alocações padrão de Pro, Max, Team e Enterprise — notadamente como uso padrão, e não no regime de créditos de uso que o Fable 5.1 tem no Pro e Max. No lançamento, a Anthropic também aumentou os limites de uso de cinco horas no Pro, Max, Team e Enterprise por assento, e adicionou um reset de limite que você pode guardar para usar quando quiser.
Qual é a forma mais barata de rodar o Claude Opus 5.5?
Use as alavancas em ordem: mantenha prefixos de prompt estáveis para que releituras sejam cobradas a $0,20 em vez de $4 por milhão; rode no menor esforço que passe seu controle de qualidade (o medium padrão costuma bastar); mande trabalho não urgente pela API Batch a $2/$10; e pule inferência US-only e modo Fast, a menos que conformidade ou latência exijam. Ao migrar, refaça seu sweep de esforço: no mesmo ajuste, o Opus 5.5 tende a pensar mais por turno que o Opus 5.
O Claude Opus 5.5 cobra a mais por contexto longo?
Não. Toda a janela de contexto de 1M de tokens é cobrada a taxas padrão por token, sem faixa de contexto longo, e os descontos de cache e Batch se aplicam à janela inteira. Na API Batch, um header beta eleva a saída máxima para 300K tokens. Note que os modelos Claude 4.7 e posteriores usam um tokenizador mais novo que produz cerca de 30% mais tokens para o mesmo texto.
Reroteamentos de salvaguarda ou chamadas de ferramenta falhas são cobrados a preços do Opus 5.5?
Requisições reroteadas por salvaguardas são concluídas por outros modelos — a Anthropic diz que trabalho sinalizado por cibersegurança é tratado pelo Opus 4.8 — e o repasse é informado de forma transparente em vez de cobrado em silêncio. Buscas na web falhadas não são cobradas, o web fetch não adiciona encargos além dos tokens do conteúdo baixado, e blocos de pensamento que o modelo não consegue ler são descartados antes da inferência sem custo. Execução de código é gratuita junto a busca ou fetch, com 1.550 horas de contêiner grátis por mês no caso contrário.