
O MiniMax M3.1 Flash merece ser testado para análise de dados supervisionada e tarefas com uso de ferramentas. Seus preços baixos de API e os bons resultados publicados fazem dele um candidato plausível. Isso não prova que ele concluirá sua tarefa de programação mais rapidamente nem que exigirá menos revisão. Esta análise distingue declarações do fornecedor, testes independentes e relatos da comunidade. Não afirma apresentar um benchmark de desempenho realizado pelo autor.
A tensão relevante é específica. No teste de modelos lançados da Plotly, o resultado passou de 38/43 respostas corretas para o Space Bunny Alpha a 41/43 para o M3.1 Flash, enquanto o tempo mediano por pergunta subiu de 36 segundos para 3 minutos. É essa troca, e não uma classificação de lançamento, que determina a recomendação abaixo. O Tabbit Browser aparece como um espaço para organizar um fluxo de trabalho no navegador, com uma verificação explícita de disponibilidade antes de qualquer teste específico do modelo.
O que o MiniMax M3.1 Flash realmente é
A MiniMax lançou a versão geral em 19 de outubro de 2026. O identificador da API é MiniMax-M3.1-Flash. A documentação do modelo o descreve como um modelo multimodal de programação com janela de contexto de 1.000.000 de tokens. Ao comparar resultados, é preciso distinguir a versão lançada, a Preview de setembro e as builds anônimas do Space Bunny. Nossa visão geral do MiniMax M3 aborda o integrante anterior da família.
De acordo com o guia de chamadas, o modo de raciocínio é obrigatório. Há cinco níveis de esforço: low, medium, high, xhigh e max. Se o campo for omitido, o padrão é max. Solicitações que desativam o raciocínio ou usam none retornam erro 400. Use o campo de esforço adequado ao seu protocolo; uma interface de cliente familiar não garante que as mesmas configurações cheguem ao servidor.
Principais conclusões
Avalie o tempo decorrido e o custo total por tarefa aceita, além da velocidade de processamento de tokens.
O resultado de 41/43 da Plotly justifica um teste supervisionado de análise, com uma compensação significativa no tempo de espera.
Preços baixos por token não eliminam o custo de raciocínio, novas tentativas e verificação.
Elogios à Preview e reclamações sobre o Space Bunny precisam ser identificados pela versão.
Confirme o modelo exato na sua conta antes de seguir um fluxo do Tabbit específico para ele.
O número decisivo é 3 minutos, apesar da geração rápida
Em seu relatório analítico de 20 de outubro, a Plotly informa uma mediana de 3 minutos por pergunta para a versão lançada, contra 36 segundos para o Space Bunny Alpha. A pontuação melhorou em três respostas em uma prova de 43 perguntas. Esperar cinco vezes mais pode ser aceitável para análises em segundo plano; é uma penalidade considerável para um assistente interativo.
O relatório atribui a duração maior ao aumento de chamadas ao modelo e à geração de mais texto. As chamadas por pergunta passaram de 15 para 45, enquanto a saída cresceu de cerca de 8.500 para 32.000 tokens. O custo da prova completa, recalculado pelas tarifas públicas da MiniMax, subiu de US$ 0,82 para US$ 4,09. Esses são os resultados de um avaliador em seu agente de análise, não uma garantia geral de latência nem uma comparação com o MiniMax M3.
Por isso, uma taxa alta de tokens por segundo não basta para decidir esta análise. Uma estimativa simples é:
Tempo da tarefa = geração do modelo + execução de ferramentas + espera + novas tentativas
Custo da tarefa = todas as entradas + entradas em cache + todas as saídas faturáveis + ferramentas
Custo por tarefa aceita = gasto total / saídas que passam nas suas verificações
Mantenha o denominador visível. Uma execução barata que falha ainda consome tempo e dinheiro. O guia de navegadores agênticos explica por que a escolha do modelo e a execução no navegador são partes distintas do fluxo de trabalho.
M3.1 Flash em resumo
| Item | Informação verificada | Consequência para a decisão |
|---|---|---|
| Modelo | MiniMax-M3.1-Flash, versão geral | Registre o identificador exato |
| Contexto | 1.000.000 de tokens | Capacidade não comprova precisão de recuperação |
| Raciocínio | Sempre ativo; cinco níveis de esforço; max como padrão | Defina o nível de esforço explicitamente |
| Tarifas de API por milhão de tokens | US$ 0,15 de entrada; US$ 0,60 de saída; US$ 0,015 de entrada em cache | Contabilize o raciocínio e as falhas de cache |
| Análise da Plotly | 41/43 corretas; mediana de 3 minutos por pergunta | Vale testar em análises em segundo plano |
| Pesos abertos | A publicação de lançamento diz que serão disponibilizados depois | Verifique os arquivos e a licença antes de implantar |
As especificações vêm do guia de chamadas e dos preços oficiais, consultados em 21 de outubro. A publicação de lançamento diz que os pesos serão lançados posteriormente. O anúncio de uma publicação futura não significa que já exista um checkpoint para baixar.
Evidências práticas antes da tabela de benchmarks
A prova da Plotly usa um data warehouse sintético de energia eólica e um gabarito privado. O modelo lançado encontrou os cinco padrões ocultos, mas errou duas perguntas no total. Uma falha foi particularmente instrutiva: a explicação dizia que havia dividido por sete uma soma de sete dias, mas a consulta SQL não incluía essa divisão. Uma narrativa convincente não torna o cálculo correto.
Esta é uma evidência prática útil porque identifica tanto um resultado quanto uma falha concreta. Ainda assim, trata-se de um teste analítico de curto prazo. Ele não comprova o desempenho em um repositório grande, em um processo de negócios sem supervisão ou no seu próprio banco de dados. Execute novamente a consulta relevante e inspecione o resultado, em vez de aceitar a descrição do modelo sobre o que fez.
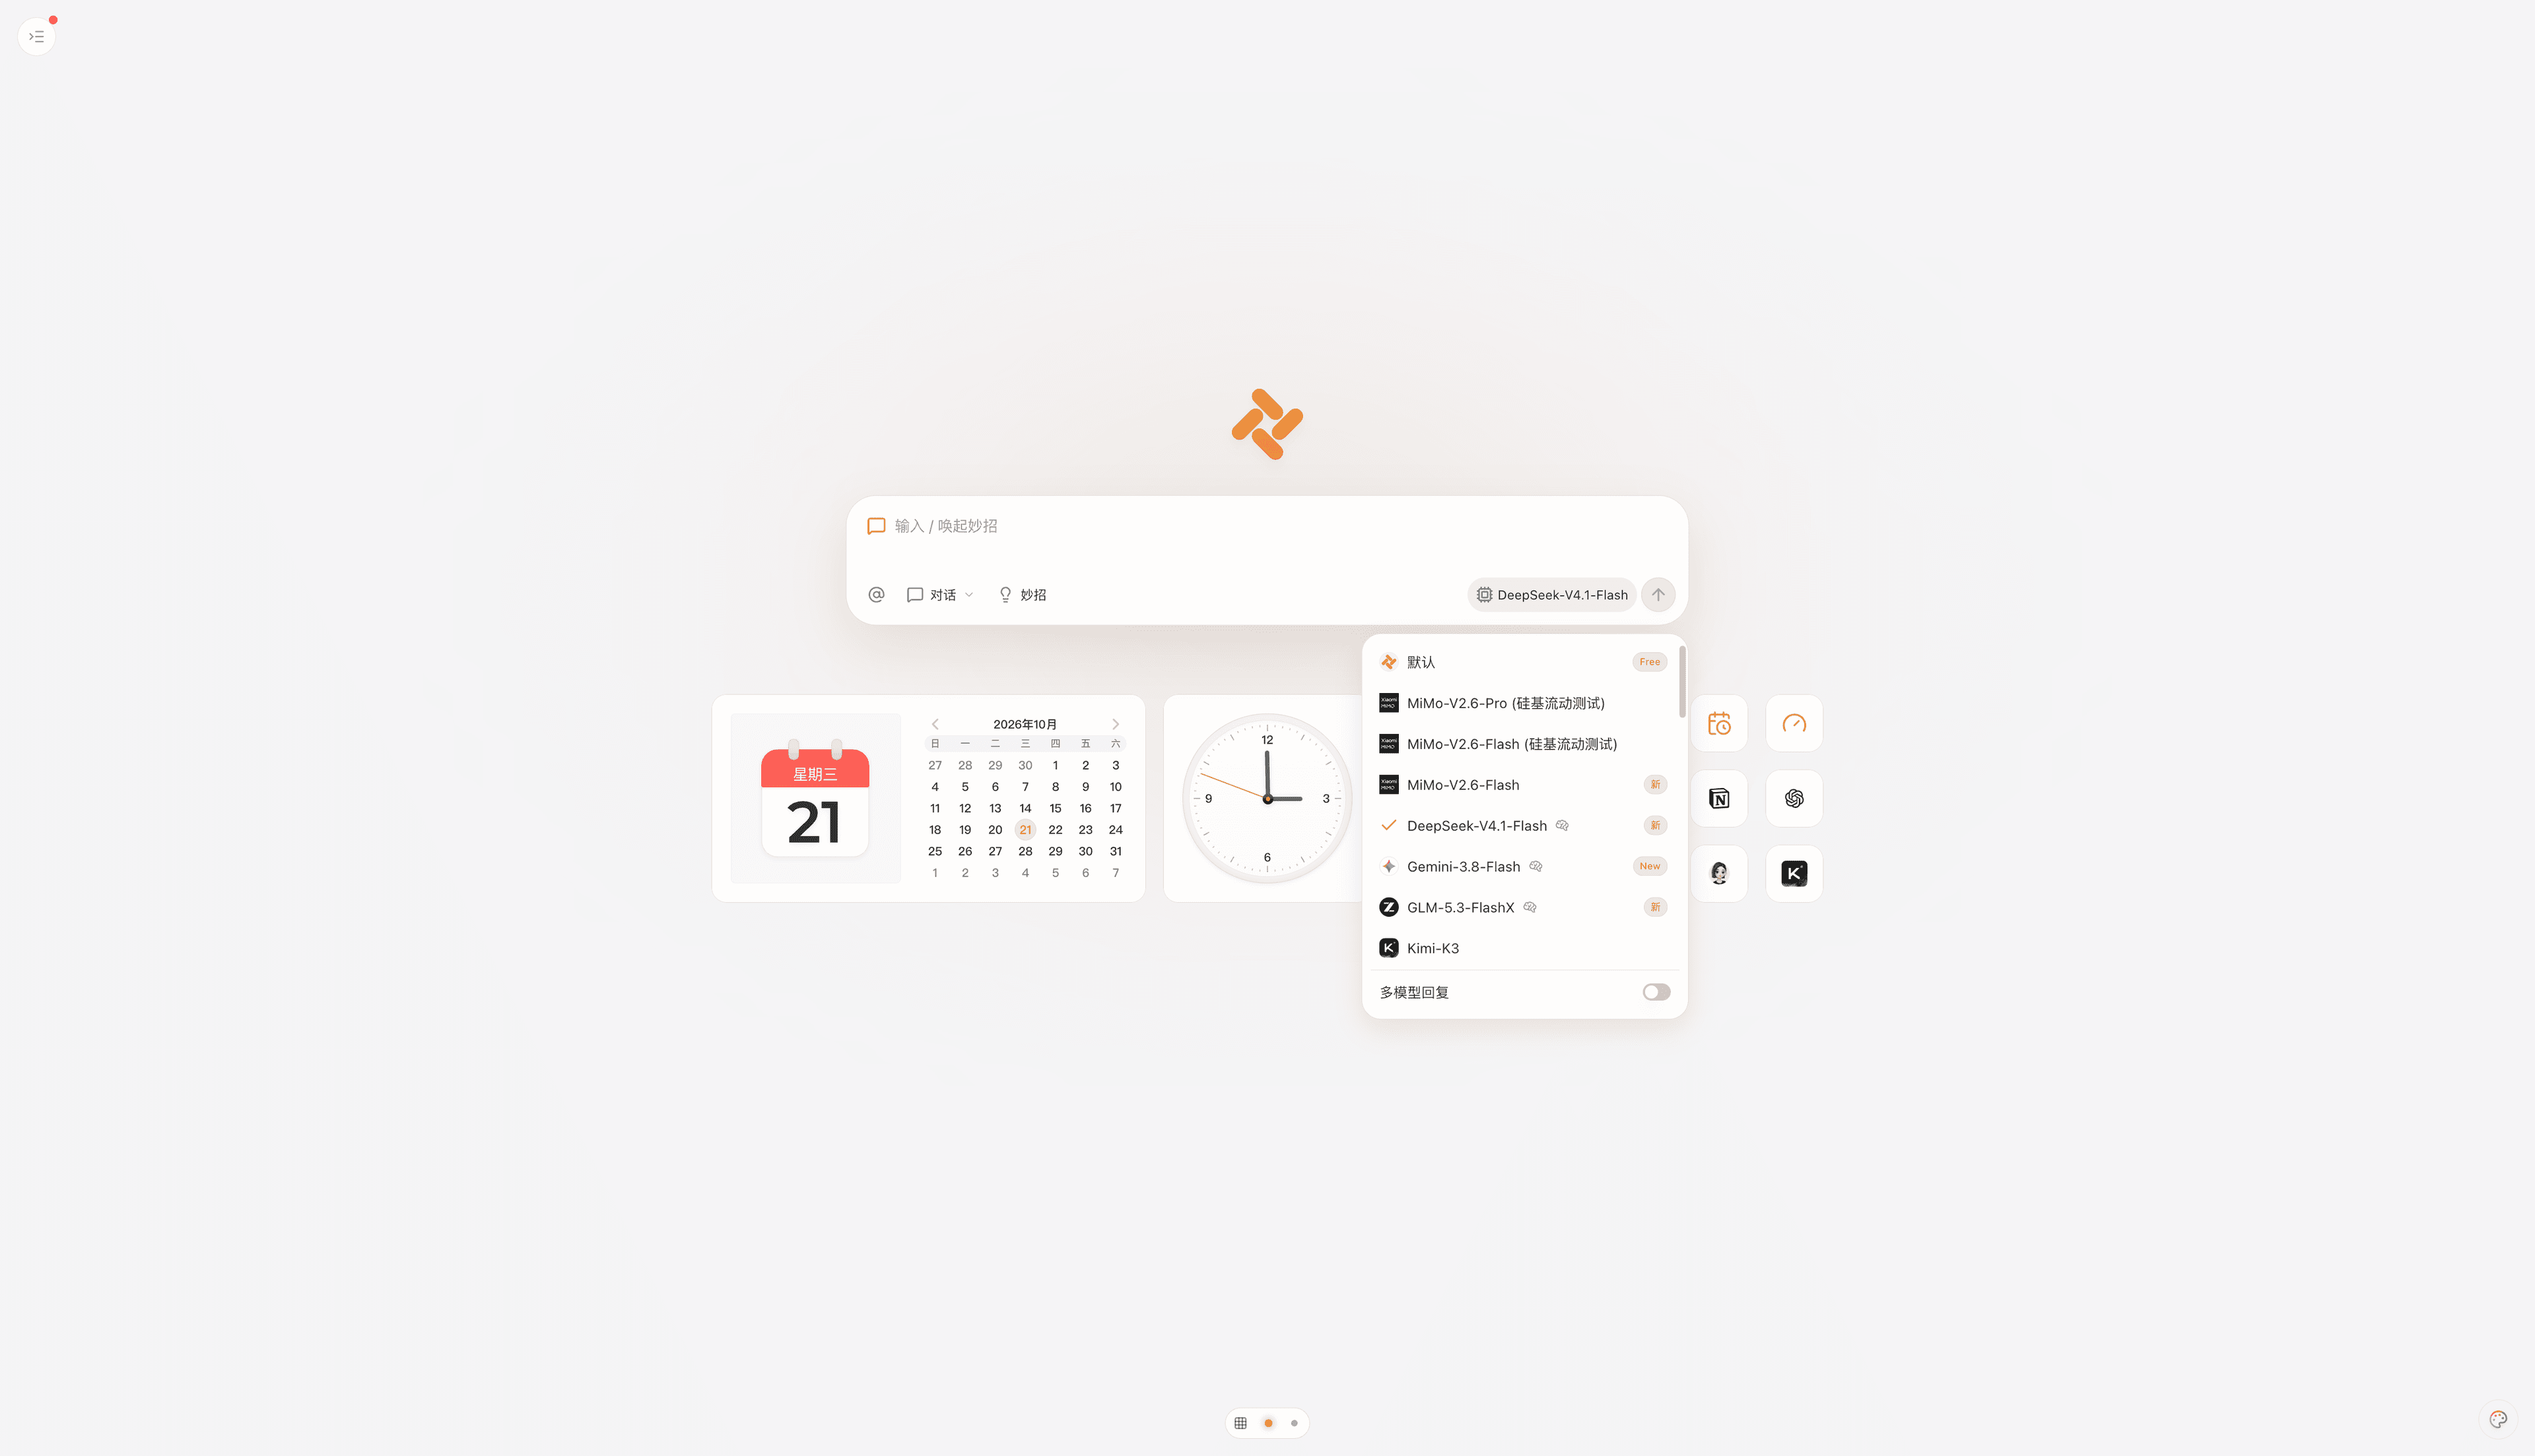
A verificação local do Tabbit para este artigo foi mais limitada. Em 21 de outubro, o seletor de chat da conta de teste disponível mostrava MiniMax-M3 e Friday-MiniMax-M3, mas não o M3.1 Flash. Nenhuma tarefa com o M3.1 Flash foi enviada. A captura de tela registra essa verificação de acesso, não um benchmark malsucedido do modelo. Ela não comprova a disponibilidade em outras contas ou regiões.
Benchmarks do fornecedor e quanto confiar neles
| Benchmark | Resultado do M3.1 Flash informado pela MiniMax | O que pode ajudar a avaliar |
|---|---|---|
| DeepSWE v1.1 | 73,7% | Engenharia de software com testes |
| OSWorld V2 | 61,7 | Operação de computador em diferentes aplicativos |
| Agents' Last Exam | 29,6 | Tarefas profissionais com valor econômico |
| BankerToolBench | 76,2 | Uso de ferramentas financeiras em várias etapas |
| CyberGym | 82% no texto de lançamento | Descoberta e validação de vulnerabilidades |
São resultados informados pelo fornecedor no artigo de lançamento, não testes reproduzidos aqui. O texto arredonda o CyberGym para 82%; diferenças de precisão exibida não constituem evidências independentes. A tabela não oferece um pacote completo de reprodução, intervalos de incerteza ou uma comparação controlada entre todos os clientes e níveis de esforço. Esses resultados justificam um teste, não uma decisão geral de substituição.
Para uma comparação independente em análise de dados, a Plotly informa 41/43 para M3.1 Flash, Claude Opus 5.5, Gemini 4 Argon e GPT-6 Sol, contra 38/43 para GLM 5.3 Flash e Qwen 3.8 27B. Um empate em 43 perguntas não comprova equivalência geral. Para outras famílias candidatas, comece pela visão geral do DeepSeek V4.1 Flash e pelo contexto do GLM Flash, depois verifique os endpoints atuais e execute o mesmo conjunto de tarefas.
Três pontos fortes que vale testar
Análise em segundo plano com cálculos verificáveis
O resultado da Plotly nos padrões ocultos é um motivo para testar a versão lançada em análises que podem ser executadas enquanto você faz outras coisas. A saída útil é uma consulta inspecionável e uma tabela de resultados. Um analista que consegue validar o cálculo pode aceitar uma espera maior para obter uma cobertura melhor. Quem precisa de uma resposta imediata pode tomar outra decisão com base nas mesmas evidências.
Tarifas baixas para contexto de ferramentas repetido
Com as tarifas publicadas, uma execução hipotética com 200.000 tokens de entrada fora do cache e 20.000 tokens de saída faturáveis custa US$ 0,042 antes de ferramentas e outras cobranças. Isso é um cálculo, não o preço medido de uma tarefa. Se a mesma execução gerar 100.000 tokens de saída, o custo dos tokens passa a US$ 0,09. A profundidade do raciocínio e as novas tentativas podem alterar a cobrança mesmo quando a resposta visível é curta.
A entrada em cache tem preço separado. Confirme os acertos reais de cache nos registros de uso, em vez de aplicar a tarifa de cache a todo prompt repetido. A afirmação da MiniMax de que o custo geral de tarefas agênticas cai 70% é diferente de um desconto universal em toda carga de trabalho ou assinatura.
Esforço ajustável em uma integração existente
O guia de chamadas documenta formatos de solicitação compatíveis com Anthropic e OpenAI. Isso oferece aos desenvolvedores um caminho prático de avaliação sem reconstruir o aplicativo ao redor. Comece verificando se o cliente envia corretamente output_config.effort ou reasoning_effort e mantém os resultados das ferramentas entre as interações. Depois compare uma configuração de esforço mais baixa com max, usando os mesmos critérios de aceitação. Menor esforço é uma hipótese a testar, não uma promessa de qualidade equivalente.
Três limitações que alteram a recomendação
Não é possível desligar o raciocínio
Mesmo uma solicitação que precise apenas de uma extração curta usa um modelo com raciocínio adaptativo. Um nível de esforço mais baixo pode reduzir o raciocínio, mas não equivale a um modo sem raciocínio. Registre o resultado final, o uso total, o tempo decorrido e as chamadas às ferramentas. A velocidade dos tokens pode esconder uma interação longa demais. A análise do Gemini 3.8 Flash oferece outra estrutura de comparação baseada em fluxo de trabalho, não uma classificação direta do desempenho deste modelo.
Explicações corretas podem acompanhar trabalho errado
A divisão ausente no SQL da Plotly é mais útil do que uma afirmação sem fontes de que o modelo não é confiável. Confira diretamente as fórmulas e o código gerados. Para extração, verifique uma amostra fixa em relação ao texto de origem. Para código, exija um teste que falhe antes da correção e passe depois dela. A revisão humana continua fazendo parte do custo de uma tarefa aceita.
Diferenças de versão e acesso complicam relatos iniciais
Assinantes da Preview, usuários de endpoints gratuitos anônimos e usuários da API da versão geral podem ter visto builds e ferramentas diferentes. A disponibilidade dos pesos também precisa ser verificada à parte. Não deduza uma licença de implantação com base em uma listagem de API. Da mesma forma, a página de um modelo em um site não prova que uma conta específica do Tabbit possa selecioná-lo hoje.
Relatos da comunidade: evidências úteis, com limites de versão
Experiência positiva com a Preview e defesa dos benchmarks
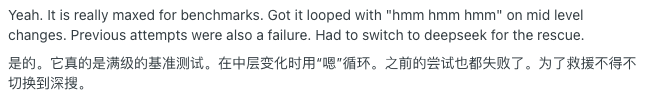
Sovairon, em 19 de outubro, disse que sua experiência com a assinatura da MiniMax favorecia o Flash em relação ao GLM Flash. Em uma resposta posterior, identificou explicitamente o MiniMax 3.1 Flash Preview. A carga de trabalho e o método de pontuação não foram divulgados. Isso sustenta uma preferência subjetiva pela Preview, não uma vitória medida da versão geral.
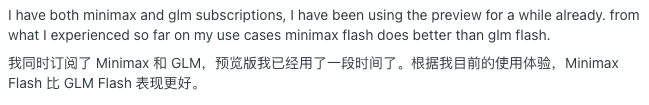
ApprehensiveDelay238, em 19 de outubro, defendeu os benchmarks como medidas imperfeitas, mas úteis, do desempenho de agentes. É um argumento metodológico, não o relato de uma tarefa concluída. Serve como contraponto a descartar todos os resultados publicados após uma sessão decepcionante.
Ciclos de raciocínio e uma preferência oposta
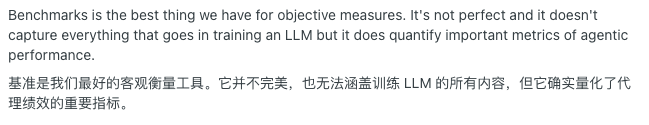
Pepek91, em 20 de outubro, relatou raciocínio repetitivo durante alterações de complexidade média e disse que mudou para o DeepSeek. O endpoint exato, a configuração de esforço e o repositório não foram informados. Trate a publicação como um modo de falha a incluir no seu teste, não como uma estimativa da taxa de falhas.
RepulsiveRaisin7, em 19 de outubro, preferiu o GLM Flash e questionou a narrativa dos benchmarks. O comentário não veio acompanhado de um registro de tarefa. Ele diverge da preferência de Sovairon, exatamente o motivo pelo qual não se pode somar esses relatos para contar vencedores.
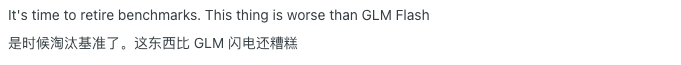
A conclusão prática é testar a ocorrência de ciclos, distinguir as versões e manter os benchmarks como uma das fontes de evidência. Nenhuma dessas publicações estabelece sua futura taxa de sucesso.
O veredito depende da carga de trabalho
| Sua carga de trabalho | Recomendação | Verificação de aceitação |
|---|---|---|
| Análise em segundo plano com revisão | Inclua o M3.1 Flash na lista de candidatos | Execute novamente o SQL e valide unidades e agregações |
| Extração interativa ou respostas rápidas | Compare os níveis de esforço antes de mudar | Meça o tempo decorrido e os resultados corretos |
| Alterações difíceis em repositórios | Mantenha seu modelo atual como controle | Use os mesmos problemas, testes e permissões de ferramentas |
| Ações externas sem supervisão | Não aprove com base apenas nestes resultados | Verifique primeiro a recuperação e os limites das ações |
| Auto-hospedagem necessária hoje | Confirme os pesos e a licença disponíveis | O acesso à API não atende a esse requisito |
| Pesquisa no navegador pelo Tabbit | Confira o seletor antes do teste | Uma opção M3 não é o M3.1 Flash |
Em uma tarefa supervisionada em segundo plano, o ganho de precisão pode justificar a espera. Para interações rápidas, a mediana informada de três minutos é motivo para medir com cuidado antes de migrar. Não há evidências aqui que justifiquem substituir todos os modelos de programação ou remover a revisão humana.
Leve o fluxo de trabalho para o Tabbit depois de verificar o acesso
O Tabbit pode organizar as páginas de origem e a conversa usadas para avaliar uma tarefa no navegador. Sua explicação do produto e as práticas recomendadas de uso descrevem esse fluxo. Isso não comprova que o Tabbit exponha os controles de esforço da API da MiniMax ou inclua o modelo em todos os planos.
A conta de teste observada não oferecia o M3.1 Flash, então este artigo não pode apresentar um resultado do modelo dentro do Tabbit. Use a página de recursos do M3.1 Flash (English) para consultar informações de configuração com fontes e, em seguida, confirme o nome exibido exato no seu próprio seletor. Se ele não aparecer, use um cliente MiniMax oficialmente compatível para testar o modelo. Não substitua pelo M3 e identifique a saída como M3.1 Flash.
Uma tarefa de teste útil é abrir o artigo de lançamento e o guia de chamadas, extrair os preços e os níveis de esforço padrão para uma tabela com links às fontes e distinguir fatos confirmados de incógnitas. Confira cada célula na página original. Registre a região da conta, a versão do cliente, o modelo exibido, os indicadores de ferramentas, o prompt e uma captura de tela. Este é um teste proposto, não um experimento realizado para esta análise.
Comece com uma tarefa controlada e use seu modelo atual como referência. O botão abaixo baixa o Tabbit para o fluxo de trabalho no navegador; ele não garante acesso ao M3.1 Flash nem uso gratuito da API.
 Tabbit Browser

Perguntas frequentes
O que é o MiniMax M3.1 Flash?
É o modelo de programação e agentes lançado pela MiniMax em 19 de outubro de 2026. O identificador da API é MiniMax-M3.1-Flash, com contexto de 1.000.000 de tokens na documentação.
É possível desativar o raciocínio?
Não. O guia oferece cinco níveis de esforço e usa max quando o campo é omitido. Desativar o raciocínio ou enviar none retorna erro 400.
Quanto custa a API?
Em 21 de outubro, as tarifas por milhão de tokens são US$ 0,15 de entrada, US$ 0,60 de saída e US$ 0,015 de entrada em cache. O custo real depende do consumo, raciocínio, cache, ferramentas e novas tentativas.
Ele é mais rápido e preciso que o Space Bunny?
No teste analítico da Plotly, os acertos passaram de 38/43 para 41/43. O tempo mediano por questão subiu de 36 segundos para 3 minutos, portanto o teste não demonstra tarefas mais rápidas.
Os pesos já estão disponíveis para hospedagem própria?
O anúncio informa que os pesos serão publicados depois. Verifique os arquivos e a licença antes de implantar; estar na API não comprova que os pesos podem ser baixados.
Posso selecionar M3.1 Flash no Tabbit?
Depende da conta, região e lista atual de modelos. A conta de teste consultada não o oferecia, por isso não apresentamos um resultado de desempenho dentro do Tabbit.