
根据 2026 年 10 月 21 日查看的官方费率表,MiniMax M3.1 Flash 每百万新输入 token 收费 0.15 美元,缓存输入 0.015 美元,输出 0.60 美元。这些费率用于 API 用量。M Plan 订阅、服务商的免费上线优惠,以及 Tabbit Browser 访问权限,是不同的购买选择。
预算时最该关注的是 缓存输入每百万 0.015 美元。它比 Flash 新输入费率低 90%,也比 M3 标准缓存读取费率低 75%。如果智能体反复读取相同上下文,成本结构可能因此改变。但这不代表每个已完成任务都便宜 90%。一则开发者讨论指出了实际情况:缓存读取更便宜,同时也可能生成更多输出 token。后文会说明,如何先在 Tabbit 检查模型权限,再决定是否把它当作执行选项。
费率一览
下表均为每百万 token 的美元价格,来源是同一份 MiniMax 价格页。M3 对比使用 Standard 档,不含 Priority 或经销商折扣路线。
| 计费项 | M3.1 Flash | M3 Standard,输入不超过 512K | 相比该 M3 档位的变化 |
|---|---|---|---|
| 新输入 | $0.15 | $0.30 | 低 50% |
| 缓存输入 | $0.015 | $0.06 | 低 75% |
| 输出 | $0.60 | $1.20 | 低 50% |
| 输入超过 512K | Flash 费率不变 | 输入 $0.60 / 缓存 $0.12 / 输出 $2.40 | Flash 低 75% / 87.5% / 75% |
Flash 的输入和输出费率是 M3 短输入档的一半,缓存输入费率还要低。M3 的输入超过 512K 时,会切换到另一整档费率,而不是只把超出的部分按更高价格计费。应核对每次请求的输入 token 数;会话累计输入不是判断门槛的方式。
token 数不等于字符数。MiniMax 给出的估算是每 1,000 token 约对应 750 个英文单词,实际消耗会随场景变化。我们没有找到经核实的 Flash tokenizer 变化比例,所以示例会明确标注实测或假设 token 数,不会编造文本到 token 的换算修正。
主要结论
Flash 缓存命中价是新输入的十分之一;输出量保持可控时,高命中率才最有价值。
厂商所说的任务成本降低 70% 是工作负载层面的主张,与输入和输出费率降低 50% 不是同一指标。
直连 API 默认 effort 为
max。调低等级仍会启用思考。服务端网页搜索每次请求另收 $0.01,不含模型 token 费用。
OpenRouter 的免费上线期有明确结束时间。生产预算应按付费价格计算。
改变智能体预算的一个数字:$0.015
MiniMax 缓存文档称,输入至少 512 token 的请求会自动进行前缀缓存。匹配顺序是工具、系统提示词、用户消息。把稳定指令和可重复引用的内容放前面,把会变化的任务细节放后面。上下文窗口很大本身并不会产生缓存命中。
假设智能体读取一个 100,000-token 前缀,共调用 40 次。若第一次全是新输入,之后 39 次全部命中缓存,这部分输入费用为 $0.015 + 39 × $0.0015 = $0.0735。没有缓存命中时,同样的 400 万输入 token 要花 $0.60。这是命中率极高的说明性情境,不是已观察到的缓存保证。历史内容增长、前缀变化都会提高成本。
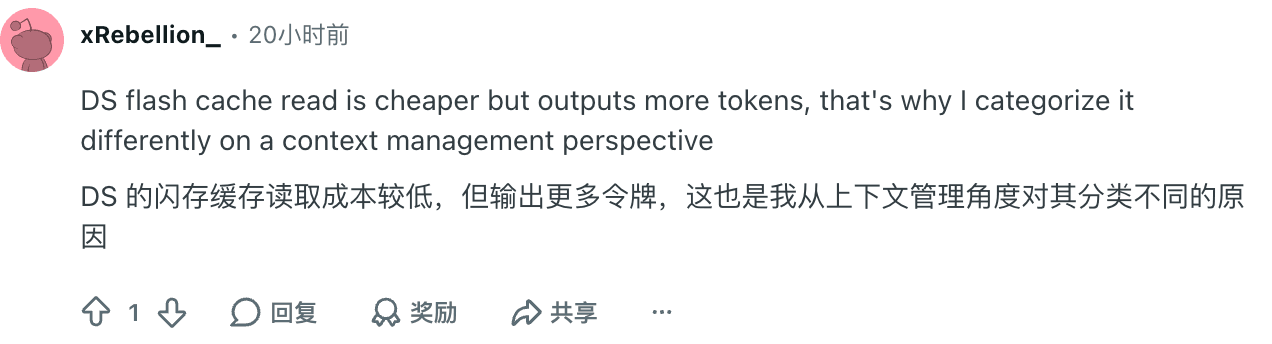
查看原评论。它对采购的提醒很实用:不要只按缓存价格选模型,应先比较同一任务产生的总 token 数。
在自己的表格里核算时,有一个细节可以避免重复计费。Anthropic 兼容响应中的 usage.input_tokens 表示新输入;应把 usage.cache_read_input_tokens 单独按缓存费率计费。OpenAI 兼容响应中的 usage.prompt_tokens 已包含缓存输入;应用新输入费率前,应减去 usage.prompt_tokens_details.cached_tokens。官方缓存指南说明了这两种口径。
70% 节省的说法实际表示什么
10 月 19 日上线公告称,智能体任务用量成本比上一代低 70%。这是厂商汇总后的任务成本主张。费率表独立显示,相比 M3 短输入档,新输入和输出费率低 50%,缓存读取低 75%。两组数字衡量的是不同内容。
要在自己的工作中复现 70% 节省,应固定任务、成功标准、执行框架和重试策略,并记录新输入、缓存输入、计费输出、工具请求和成功完成次数。每次尝试更便宜的任务,如果要多试几次才能验收,单个合格结果仍可能更贵。本文没有进行七天生产对比,也不会把厂商比例说成 Tabbit 实测节省。
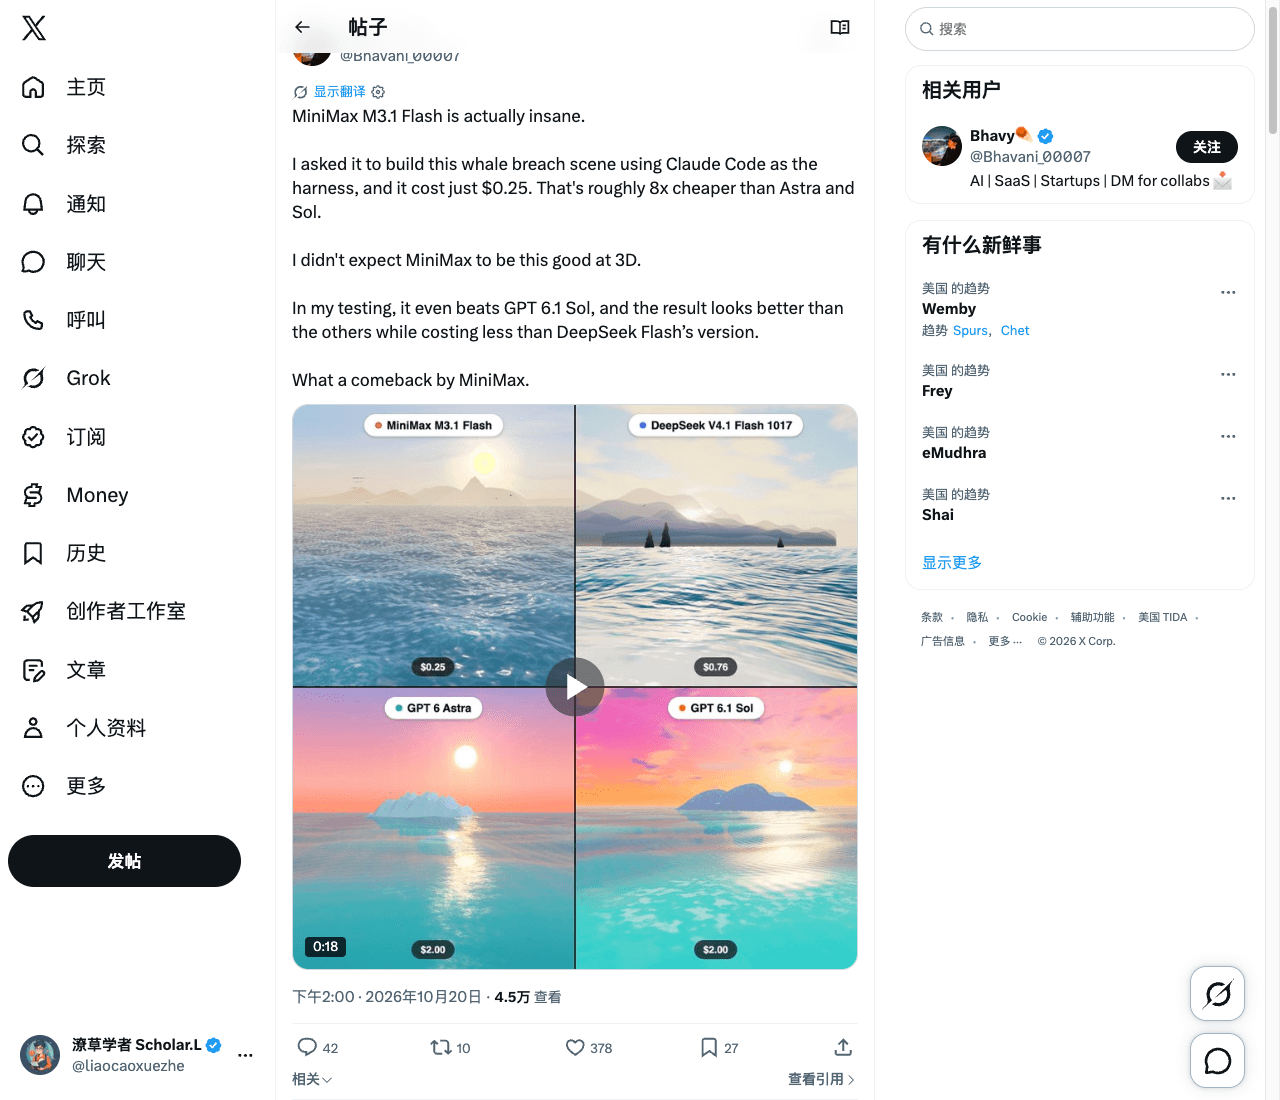
一个正面案例来自 X 用户 Bhavy:他称用 Claude Code 制作鲸鱼动画花了 0.25 美元。这是具体的任务报告,但帖子没有给出完整 token 账单、固定 effort 设置或重复试验。它能证明用户报告过这种成本,不足以预测你的应用费用。
token 表以外的计费项
官方价格页列出服务端 web_search 每次请求收费 $0.01。搜索一万次会在 token 费用之外增加 $100。MCP 的 API-vlm 项目也是每次请求 $0.01。客户端自己的外部工具可能使用不同服务和价格,因此不要把这些费用套用到每次本地函数调用。
上线说明称 Flash 使用统一费率。我们没有在直连 API 费率表中核实 Flash 批处理折扣、地区附加费、Priority 倍数或促销到期时间。预算可按公开费率计算;费率表没有列出某项,不代表每家服务商都采用相同条款。税费、汇率转换、外部执行和重试成本不在计算器范围内。
Venice 自己的页面列出的价格是输入 $0.19、缓存输入 $0.02、输出 $0.75。OpenRouter 模型公告则称临时免费期于 2026 年 10 月 22 日 12:00 UTC 结束,即新加坡时间 20:00。公告表示之后会下架 :free 变体,并要求集成方切换到 minimax/minimax-m3.1-flash。这是有日期的服务商公告,不是永久免费档。
同系列模型和 effort 档位
| 模型或计费档 | 每百万新输入 / 缓存输入 / 输出 | 适用情况 | 主要预算条件 |
|---|---|---|---|
| M3.1 Flash | $0.15 / $0.015 / $0.60 | 试用日常编码和重复工具循环 | 控制生成输出,并确认缓存命中 |
| M3 Standard,输入不超过 512K | $0.30 / $0.06 / $1.20 | 比较期间继续使用已测试的 M3 工作流 | 迁移前比较验收通过的结果 |
| M3 Standard,输入超过 512K | $0.60 / $0.12 / $2.40 | 某次 M3 请求需要更长输入档 | 只对该请求采用此计费档 |
这是对两款现有模型、三种计费配置的比较。上线公告说 Pro 之后才会推出;它不是可供计算器虚构价格的第三款模型。M3 概览介绍旧模型的访问背景,其历史订阅金额不能代替今天的费率表。比较方法可参考单独的 DeepSeek 定价指南和 Gemini Flash 定价指南,采购前请重新核对它们的官方价格。
容易忽略的一点是,缓存优化会让输出成为主要费用。在 90% 输入命中缓存时,Flash 的有效输入费率为每百万 0.0285 美元,输出仍是每百万 $0.60。按这种输入组合计算,一个输出 token 的价格约为一个输入 token 的 21 倍。
MiniMax 调用指南支持 low、medium、high、xhigh 和 max effort,默认使用 max。文档称较高 effort 会增加输出 token 和延迟,并且思考模式无法关闭。可以先在常规步骤测试较低等级,对需要质量保障的难任务保留较高等级。推理 token 已计入用量总数时,只按一次计费,不要再次叠加。
免费项目与未核实的减免
文档说明自动缓存无需额外设置,公开 Flash 费率表列出新输入、缓存读取和输出价格。我们没有在该表中找到单独的 Flash 缓存存储费或写入附加费。这只是公开表格的覆盖范围,不是对未列出服务的合同承诺。
我们没有核实拒答、中断或未成功的文本任务是否普遍退款。价格页中“失败任务不扣费”的规则针对视频,不能移用到这个文本模型。需要修正的回答仍可能已经消耗计费 token。不要把思考、缓存输入或智能体重试标成免费。
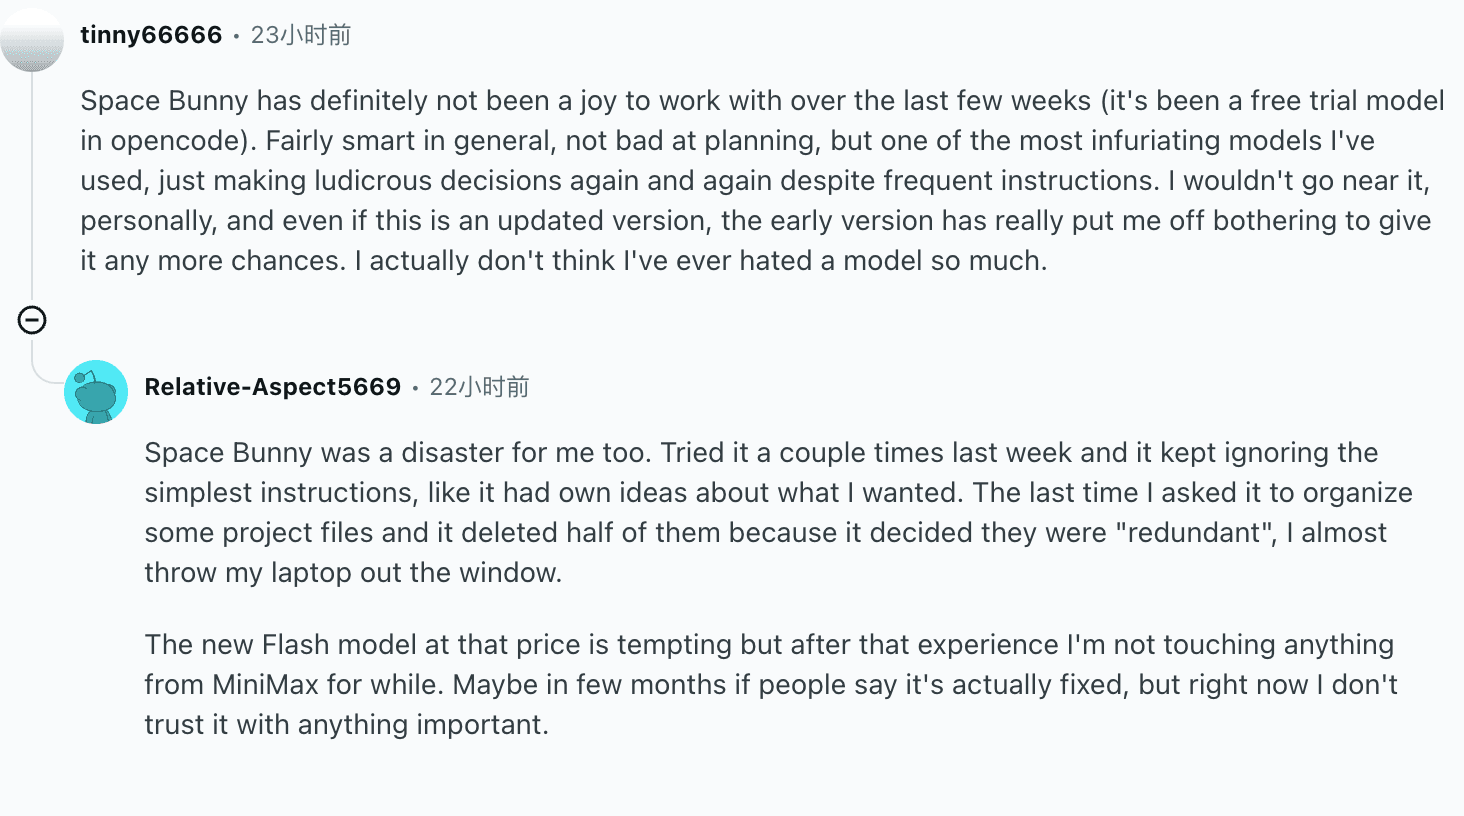
Reddit 用户 tinny66666称,在 OpenCode 里使用 Space Bunny 时多次做出糟糕决策。讨论对象是较早的匿名预览版,不是已发布 Flash 的受控测试。它仍说明了预算中应预留重试空间,并设置验收标准。
M Plan 是另一种购买方式
当前 M Plan 页面显示,Go、Explore 和 Build 均包含 M3.1 Flash;Explore 的用量是 Go 的 3 倍,Build 是 7.5 倍。查看时页面显示的年付价格分别是每年 $220、$550 和 $1,320。这些是年费总额,不是月费。购买前请核对实时账单切换项和结账页,不要把套餐宣传的用量换算成假定的 API token 价格。
套餐对比表还显示,Free 客户端档可以有限使用 Flash,但不提供供编码工具使用的 API Key。M Plan 包含 MiniMax Code。常见问题称 Subscription Key 会使用套餐额度,再使用可用的信用包;pay-as-you-go API Key 则扣账户余额。用量窗口耗尽后如何计费,取决于这一区别。
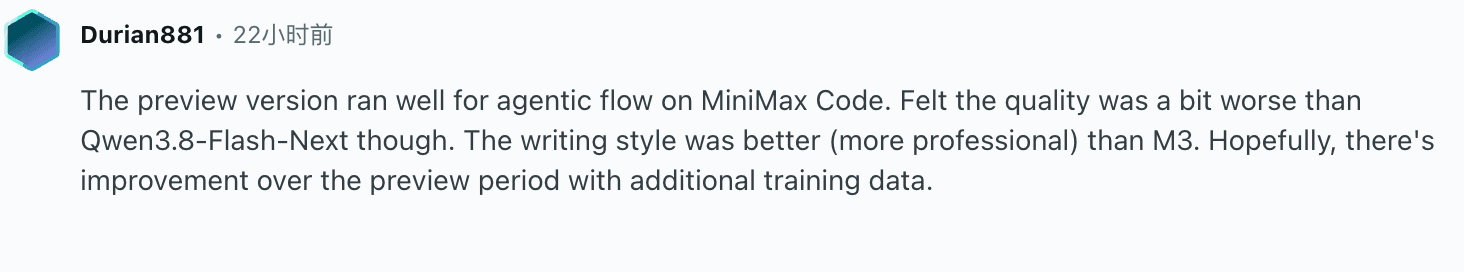
Durian881 的评论称,预览版在 MiniMax Code 中的智能体流程表现不错,但他更喜欢另一个模型的质量。理解这条评价时,应保留它的版本和客户端背景;它不能证明每种 M Plan 工作流都能落在额度内。
两组可复算的预算
以下是使用 10 月 21 日费率计算的示例,不是已执行的工作负载。输入是一个任务所有调用的输入总量,输出是这些调用产生的全部计费输出。真实的多调用 M3 任务必须逐请求选择费率档。
成本 = (新输入 × 0.15 + 缓存输入 × 0.015 + 输出 × 0.60) / 1,000,000
每月 token 成本 = 单任务成本 × 每月任务数
每个验收结果成本 = 所有 token 与工具费用 / 验收通过的结果数| 假设的工作负载 | 每个任务总输入 | 缓存占比 | 每个任务输出 | 每月任务数 | Flash 每月 token 费用 |
|---|---|---|---|---|---|
| 页面信息提取 | 20,000 | 20% | 1,000 | 10,000 | $30.60 |
| 重复上下文智能体 | 200,000 | 90% | 10,000 | 1,000 | $11.70 |
信息提取任务的计算为 (16,000 × 0.15 + 4,000 × 0.015 + 1,000 × 0.60) / 1,000,000 = $0.00306,即每页 $0.00306。处理一万页的 token 费为 $30.60。没有命中缓存时,费用会变为 $36.00,因此此工作负载节省的是 15%,不是 90%。每页进行一次服务端网页搜索还会增加 $100。
智能体任务的计算为 (20,000 × 0.15 + 180,000 × 0.015 + 10,000 × 0.60) / 1,000,000 = $0.0117,即每个任务 $0.0117。一千个任务共 $11.70;没有缓存命中时为 $36.00。保持 token 数不变,短输入 M3 的费用为 $28.80。如果 Flash 输出翻倍到 20,000 token,每月账单会上升到 $17.70。因此 effort 和重试都应纳入预算。
本地月度成本计算器
输入相同用量,即可比较 Flash 与两个 M3 Standard 档位。较长输入档是敏感性情境,并不表示会话累计 token 数会触发单请求门槛。计算器采用输入总量和缓存占比,不会重复计算缓存输入。它不会把输入值或估算发送到分析系统。
估算每月 token 成本
美元费率核对于 2026 年 10 月 21 日。M3 两行均为对比情景,每次请求应选择适用费率。不含工具、重试、税费及服务商费用。输入值留在浏览器内,埋点只记录字段发生变化。
核对官方费率用 Tabbit 检查浏览器工作流
算好 API 预算后,下一步是决定任务在哪里运行。对于浏览器智能体,客户端负责提供页面上下文、工具权限和工作流。可以阅读 Tabbit 简介和实用指南,了解这一层;选择客户端时也可看浏览器对比。
我们在 10 月 21 日检查 Tabbit 测试环境的模型选择器,看到 MiniMax-M3 和 Friday-MiniMax-M3,但没有 M3.1 Flash。因此我们没有改用替代模型发送任务,再把它称为 Flash 测试。本文没有 Tabbit Flash 对话记录、工具轨迹或实测费用。公开的 M3.1 Flash 资源页是研究索引;其提示词指南和评测来源可用于准备,不是账户已获权限的证明。
当你的账户出现准确的模型名称后,可以做一次可逆检查:打开官方费率表,要求列出三个 token 价格、单位和来源网址,再与页面逐项比对。记录模型名称、客户端版本、工具标记、提示词和结果。一次正确回答只能验证该样本。Tabbit 额度仍与上文直连 API 价格分开计算。
结论:购买套餐前,先计算验收通过的任务成本
如果你的工作流会重复使用上下文,而且能控制输出量,可以按付费费率先试用 M3.1 Flash。记录缓存命中和验收结果,在质量允许时调低 effort,并设定重试预算。比较结果证明任务确有改善之前,保留可用的 M3 路线。
如果 M Plan 所含客户端和用量条款适合你的工作,可以选套餐;若需要按 token 记账,则选按量付费。如果工作主要发生在网页中,可以下载 Tabbit,先检查账户的模型选择器,再规划 Flash 工作流。下载不保证能使用 M3.1 Flash,也不会把本文的 API 估算变成 Tabbit 报价。
 Tabbit Browser

常见问题
MiniMax M3.1 Flash 的价格是多少?
截至 2026 年 10 月 21 日,MiniMax 标价为每百万未缓存输入 token 0.15 美元、缓存输入 token 0.015 美元、输出 token 0.60 美元。这是按量计费的美元 API 价格。订阅和其他服务商有各自的条款。
缓存优惠 90% 是否意味着整张账单便宜 90%?
不是。优惠只适用于从缓存读取的输入 token。新输入、输出、工具调用和重试仍会产生费用。
OpenRouter 上的 M3.1 Flash 免费吗?
OpenRouter 的上线公告称,免费期于 2026 年 10 月 22 日 12:00 UTC 结束。公告还说届时会下架 :free 变体,并建议集成方改用 minimax/minimax-m3.1-flash,按 MiniMax 标价计费。
关闭思考模式能降低费用吗?
MiniMax 当前文档称 M3.1 Flash 无法关闭思考模式。支持的 effort 等级为 low、medium、high、xhigh 和 max,默认是 max。降低等级可能减少输出量并缩短延迟。
M Plan 额度用完后会自动扣 API 余额吗?
MiniMax 表示,Subscription Key 会先使用 M Plan 额度,再使用可用的信用包,不会扣按量付费账户余额。Pay-as-you-go API Key 则使用该余额,因此要确认客户端正在使用哪种密钥。
我能在 Tabbit Browser 里使用 M3.1 Flash 吗?
能否使用取决于账户、地区和实时模型选择器。我们在 2026 年 10 月 21 日检查 Tabbit 测试环境时看到了 M3,但没有 M3.1 Flash,因此本文不声称已在 Tabbit 完成 M3.1 Flash 实测。