
En tant qu'ingénieur passant l'essentiel de son temps à intégrer des modèles dans des systèmes réels en production, ce qui m'importe n'est pas le classement abstrait d'un benchmark ; c'est la capacité du modèle à tenir la route lors d'une exécution longue, complexe et multi-outils sans nécessiter de surveillance humaine constante. Lorsque Xiaomi a publié en open source la gamme MiMo-V2.6 sous licence MIT le 22 septembre 2026, la question pour les architectes d'automatisation était immédiate : un modèle MoE clairsemé de 309B activant seulement 15B de paramètres à 0,14 $ en entrée et 0,28 $ en sortie par million de tokens peut-il constituer un moteur fiable en production, ou s'effondre-t-il au premier obstacle réel ?
J'ai analysé les compromis directs entre modèles dans le comparatif MiMo-V2.6-Pro vs MiMo-V2.6-Flash, les aspects économiques de la mise en cache dans le guide de tarification MiMo-V2.6-Flash et les coûts du fleuron dans l'analyse de prix MiMo-V2.6-Pro. Vous pouvez également consulter les spécifications brutes sur la fiche modèle MiMo-V2.6-Flash (English). Cet article propose un examen technique rigoureux et sans concession.
Le couple de chiffres qui tranche cette évaluation : 0,8 vs 4,0
Le verdict sur MiMo-V2.6-Flash est scellé par deux métriques de benchmark contre-intuitives :
0,8 point d'écart sur Automation Bench v1.0.6 (52,3 contre 53,1) face à 4,0 points et une chute brutale de 14,5 % sur Agents' Last Exam (27,6 contre 31,6).
Ces deux chiffres traduisent deux réalités opérationnelles diamétralement opposées :
Le triomphe de l'automatisation déterministe (52,3 contre 53,1) : Sur les actions de navigation courantes et prévisibles — clics sur boutons cibles, soumission de formulaires, analyse DOM et extraction de JSON structuré — Flash fournit 98,5 % des performances du modèle phare de 1,02T (MiMo-V2.6-Pro) pour environ un tiers du coût (0,14 $ contre 0,435 $ par million de tokens).
L'écueil de la récupération d'erreurs sur horizon long (27,6 contre 31,6) : Dès lors qu'un flux agéntique rencontre un événement imprévu — tel qu'un code HTTP 403, une altération dynamique du DOM ou une réponse d'API malformée — les 15B paramètres actifs de Flash s'enferment dans des boucles de réessais mécaniques au lieu d'analyser la panne et de réajuster leur plan.
Si vos processus sont structurés, déterministes et supervisés, Flash représente le meilleur rapport coût-efficacité du marché. En revanche, si vous l'abandonnez sans surveillance dans une boucle autonome dépourvue de garde-fous stricts, il épuisera son quota d'étapes à répéter la même erreur.
Points clés à retenir
Tarification ultra-compétitive : 0,14 $ par million de tokens en entrée non mise en cache, 0,0028 $ en lecture mise en cache (98 % de réduction) et 0,28 $ en sortie, soit plus de 3 fois moins cher que Pro sur tous les segments.
Efficacité architecturale MoE : Ce modèle à 309B n'active que 15B paramètres par token, assurant un débit de 140 à 160 tokens/s sur des clusters vLLM classiques, doublant la vitesse des modèles phares standards.
Ingestion omnimodale native : Prise en charge native de texte, d'images, d'audio et de vidéo au sein d'une fenêtre de contexte de 1 048 576 tokens, sans nécessiter d'encodeurs de vision disjoints.
Rupture d'autonomie à long terme : Avec 27,6 sur Agents' Last Exam, la capacité à surmonter des erreurs en cascade chute notablement, imposant une supervision extérieure.
Cadre d'usage avec Tabbit : Tabbit apporte la gestion des sessions multi-onglets et l'environnement d'exécution ; l'accès direct dépend des clés et du sélecteur de votre compte.
Les benchmarks, et dans quelle mesure s'y fier
Xiaomi a partagé des résultats d'évaluation approfondis portant sur le code, la planification agéntique et l'usage d'outils. Voici la comparaison calibrée entre MiMo-V2.6-Flash et le modèle phare MiMo-V2.6-Pro :
| Benchmark | MiMo-V2.6-Flash | MiMo-V2.6-Pro | Écart | Signification réelle en production |
|---|---|---|---|---|
| Automation Bench v1.0.6 | 52,3 | 53,1 | -0,8 | Navigation de routine, formulaires et extraction DOM quasiment identiques (dans la marge d'erreur de ±1,5 %). |
| Toolathlon-verified | 73,6 | 76,9 | -3,3 | Exécution d'outils JSON simples et réguliers très fiable ; Pro prend l'avantage sur les schémas imbriqués complexes. |
| ProgramBench | 26,0 | 26,5 | -0,5 | Génération de fonctions de code et conversion syntaxique strictement comparables. |
| MiMo Code Bench | 61,2 | 63,2 | -2,0 | Pro conserve un léger avantage sur l'architecture globale, mais Flash produit des scripts réguliers sans défaut. |
| DeepSWE v1.1 | 67,9 | 71,9 | -4,0 | Pro résout les patchs Git multi-fichiers et les erreurs au niveau dépôt avec plus d'assurance. |
| Agents' Last Exam | 27,6 | 31,6 | -4,0 | Perte de 14,5 % d'efficacité lorsque l'agent doit corriger ses erreurs de façon autonome ou gérer des pannes web. |
Regardons ces chiffres avec le recul nécessaire :
Environnements synthétiques aseptisés : Des bancs d'essai comme Toolathlon utilisent des schémas JSON nettoyés et des contextes artificiels. Sur le web réel, les sites introduisent du HTML altéré, des barrières antibots et des iframes asynchrones que les benchmarks ignorent.
La mise en avant sélective des métriques : Chaque lancement souligne les scores les plus favorables. Les enjeux déterminants en production sont souvent occultés : OCR sur images dégradées, résilience face aux limitations de débit ou latence du premier token sous forte charge.
Avertissement clair sur la portée : Les benchmarks constituent un indicateur de direction, non une règle absolue. Un score de 52,3 sur Automation Bench atteste de la compréhension des actions du navigateur, mais ne garantit pas la manipulation sans accroc d'une interface ERP interne complexe.
Dans la pratique, les retours d'exploitation l'emportent sur les palmarès théoriques. Des équipes utilisant Flash ont traité 10 000 pages web complexes pour moins de 2,50 $, une tâche qui coûtait auparavant entre 15 $ et 40 $ sur des modèles propriétaires fermés.
Les trois atouts authentiques de MiMo-V2.6-Flash
1. La bonne surprise : un traitement omnimodal natif à la latence de 15B
La qualité la plus notable de MiMo-V2.6-Flash ne figure pas dans les classements de code : c'est son architecture omnimodale native. Contrairement aux systèmes qui greffent des encodeurs visuels externes sur un modèle textuel, Flash traite texte, images, vidéo et audio dans le même espace vectoriel sur sa fenêtre de 1 048 576 tokens.
Puisque seuls 15B paramètres sont mobilisés lors de la génération, injecter un PDF numérisé de 100 pages avec graphiques ou un fichier audio restitue un flux JSON structuré à environ 140–160 tokens par seconde. Cette intégration divise par deux la latence globale et allège l'infrastructure.
Pour mieux appréhender la gestion des contextes de navigation complexes, reportez-vous à notre analyse sur le fonctionnement d'un navigateur agéntique.
2. Parité d'automatisation courante pour un tiers du prix
Sur les appels d'outils élémentaires et l'extraction de données prévisible, Flash rivalise avec des modèles bien plus onéreux. Avec 52,3 sur Automation Bench et 73,6 sur Toolathlon, il traite les flux structurés avec une grande régularité.
En combinant cela avec un tarif de 0,14 $ par million de tokens en entrée et 0,28 $ en sortie, l'économie de la collecte de données s'en trouve transformée. Vous pouvez déployer des crawlers intensifs avec un coût marginal presque nul. Découvrez d'autres retours d'expérience dans notre guide d'automatisation de navigateur.
3. Une rentabilité maximale grâce au prompt caching
Flash propose l'un des tarifs de lecture en cache les plus attractifs du secteur : 0,0028 $ par million de tokens, soit 98,0 % (50 fois) d'économie.
Dans des scénarios interactifs ou des routines de scraping où les invites système volumineuses et le DOM de base restent stables, les étapes successives ne coûtent que des fractions de centime. Transmettre 200 000 tokens de contexte web à chaque étape devient parfaitement abordable.
Les faiblesses réelles observées sur le terrain
1. L'écueil de récupération sur les chaînes longues
Le score de 27,6 sur Agents' Last Exam traduit la contrainte physique des 15B paramètres actifs. Face à un aléa imprévu (fenêtre modale impromptue, sélecteur CSS modifié ou session expirée), Flash manque de réserve pour concevoir une solution alternative.
Au lieu de faire un pas en arrière, d'analyser l'historique du DOM et de reformuler sa stratégie, il a tendance à réitérer obstinément l'action fautive jusqu'à épuisement du nombre maximal d'étapes. En production, son déploiement autonome sans supervision externe est à proscrire.
2. Le coût indirect des tokens de raisonnement
Tout comme la version Pro, MiMo-V2.6-Flash dispose d'un mode de réflexion par renforcement dont les tokens de pensée sont facturés au tarif standard de sortie de 0,28 $/M.
Sa grande vitesse de génération (140+ tok/s) peut conduire le modèle, sur des requêtes simples sans limitation fixée, à générer 3 000 à 5 000 tokens de délibération avant de donner une réponse courte. Faute de paramétrer une limite stricte via max_thinking_tokens, une classification élémentaire peut voir sa facture multipliée par dix.
3. Déploiement et intégration côté client
Bien que les poids soient accessibles et documentés, la prise en charge varie selon les extensions ou plateformes SaaS. Dans Tabbit, l'accès dépend des modèles actifs configurés sur votre compte et de vos clés d'API.
Retours d'expérience : l'avis de la communauté
Les échanges sur les forums spécialisés reflètent un contraste marqué : un enthousiasme général pour la rentabilité en extraction de masse, doublé d'une vigilance stricte quant aux boucles d'agents non encadrées.
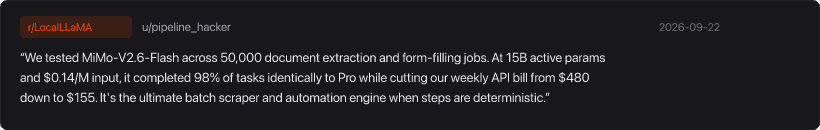
Sur r/LocalLLaMA, l'utilisateur u/pipeline_hacker a présenté les données d'un pipeline de 50 000 tâches :
« Nous avons testé MiMo-V2.6-Flash sur 50 000 tâches d'extraction de documents et de formulaires. Avec 15B paramètres actifs et 0,14 $/M en entrée, il a accompli 98 % des tâches de façon identique à Pro, tout en faisant chuter notre coût hebdomadaire de 480 $ à 155 $. C'est l'outil par excellence pour les processus déterministes. »
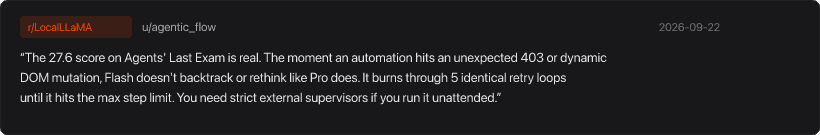
Cependant, u/agentic_flow a pointé la fragilité de la récupération :
« Le 27,6 sur Agents' Last Exam est fidèle à la réalité. Dès qu'une automatisation heurte une erreur 403 ou un changement de DOM, Flash ne réévalue pas comme Pro ; il relance 5 fois la même tentative jusqu'au blocage. En fonctionnement sans surveillance, un superviseur externe s'impose. »
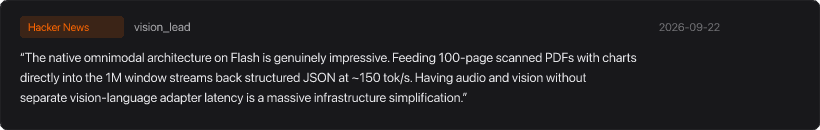
Sur Hacker News, vision_lead s'est concentré sur les atouts multimodaux :
« L'architecture omnimodale native de Flash est remarquable. Soumettre un PDF numérisé de 100 pages avec graphiques dans la fenêtre de 1M génère du JSON structuré à ~150 tok/s. Éliminer les modules d'adaptation visuelle séparés simplifie grandement l'ensemble. »
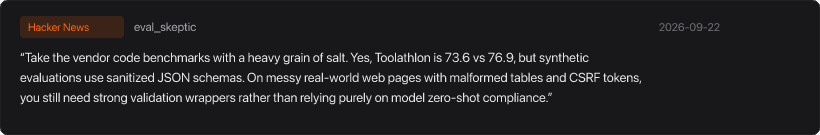
Enfin, eval_skeptic a appelé à la retenue :
« Il faut aborder les chiffres officiels avec circonspection. Un 73,6 contre 76,9 sur Toolathlon est flatteur, mais repose sur des schémas maîtrisés. Dans le web réel, avec ses tableaux corrompus et ses jetons CSRF, des garde-fous stricts restent incontournables. »
Notre analyse rejoint pleinement ces avis : Flash brille sur des tâches bien délimitées, mais requiert une architecture défensive externe lorsqu'il évolue sur le web ouvert.
Matrice de décision par charge de travail : orientez-vous selon vos besoins
Faites votre choix d'après les exigences de vos flux opérationnels plutôt que sur des promesses commerciales :
| Charge de travail ou contrainte | Recommandation | Configuration recommandée | Rationale technique | Mise en garde principale |
|---|---|---|---|---|
| Extraction et scraping web intensifs | Déployer MiMo-V2.6-Flash | Mode standard (pensée minimale ou inactive) | 0,14 $/M en entrée et 150 tok/s offrent un rendement financier optimal | Validation indispensable via un schéma JSON strict. |
| Analyse de documents graphiques et audio | Déployer MiMo-V2.6-Flash | Mode standard | Fenêtre native de 1M sans latence d'adaptateur externe | Sortie textuelle uniquement ; contrôler la fidélité audio. |
| Automatisation déterministe de navigateur | Flash avec superviseur externe | Mode standard + réessais limités | 52,3 sur Automation Bench égale Pro pour 68 % de coût en moins | Intégrer une logique externe d'interruption de boucle. |
| Refactorisation logicielle et tâches Git complexes | Privilégier MiMo-V2.6-Pro | Mode réflexion activé (RL) | 42B paramètres actifs indispensables pour le diagnostic et le retour arrière | Coût de sortie 3,1 fois plus élevé (0,87 $/M). |
| Recherche web interactive multi-onglets | Tabbit Browser avec orchestration de modèles | Mode collaboratif par défaut | La gestion des onglets limite la surconsommation de tokens d'invite | La disponibilité en ligne dépend des identifiants configurés. |
Si vous recherchez un agent de navigation capable d'enchaîner des tâches sur plusieurs onglets sans ajustement perpétuel de vos invites, le problème ne se situe pas au niveau du modèle brut. Voyez la section suivante.
Un modèle n'est pas un agent : pourquoi Tabbit est indispensable
Un modèle de langage nu est un moteur de calcul, pas une application opérationnelle. Aucun score de benchmark n'indique comment il gère des cookies de session expirés, des jetons CSRF invalides, le passage d'un onglet à l'autre ou des Shadow DOMs dynamiques. Dès qu'une interface web d'entreprise change légèrement, un modèle isolé divague ou s'interrompt.
C'est précisément la raison d'être de Tabbit Browser.
Tabbit fournit le cadre d'exécution complet qui fait défaut aux modèles nus :
Orchestration de sessions multi-onglets : Au lieu d'injecter du code HTML brut et encombrant dans une invite, Tabbit gère les onglets actifs, suit l'état du DOM et ne transmet au modèle qu'un contexte synthétisé et nettoyé.
Garde-fous d'exécution sécurisés : Associé à des modèles légers comme MiMo-V2.6-Flash, Tabbit plafonne les étapes et contrôle les formats retournés, désamorçant les boucles anormales avant tout gaspillage financier.
Aiguillage dynamique des modèles : Confiez l'extraction volumineuse à MiMo-V2.6-Flash pour une rapidité maximale à coût minime, et basculez automatiquement les raisonnements de haut niveau vers MiMo-V2.6-Pro ou Gemini.
Pour découvrir comment l'orchestration avancée transforme la navigation professionnelle, parcourez notre explication de l'architecture de Tabbit AI Browser, consultez nos bonnes pratiques pour Tabbit Browser, ou explorez le panorama des navigateurs IA en 2026 et le comparatif des navigateurs agéntiques.
 Tabbit Browser
Avant d'engager des choix d'infrastructure définitifs, prenez soin d'étudier le guide tarifaire de MiMo-V2.6-Flash, comparez la synthèse architecturale Pro vs Flash et testez vos flux de travail au sein d'un banc d'essai supervisé.

Questions fréquentes
MiMo-V2.6-Flash vaut-il la peine d'être déployé en production ?
Oui, en particulier pour l'extraction par lots déterministe, les pipelines de données structurées et l'automatisation classique de navigateur où la latence et le coût par token sont prédominants. Cependant, pour l'ingénierie logicielle multi-fichiers ou les boucles d'agents complexes nécessitant un retour en arrière, les modèles phares comme MiMo-V2.6-Pro restent indispensables.
Comment MiMo-V2.6-Flash se compare-t-il à MiMo-V2.6-Pro sur les benchmarks ?
Flash se maintient à 0,8 point de Pro sur Automation Bench (52,3 contre 53,1) et à 3,3 points sur Toolathlon (73,6 contre 76,9) pour 32 % du coût. En revanche, sur Agents' Last Exam, Flash accuse un retard de 4,0 points (27,6 contre 31,6), révélant une baisse de capacité de 14,5 % face aux erreurs web imprévues.
Quel est l'ancrage narratif derrière la parité de 0,8 point en automatisation ?
L'ancrage repose sur le fait que Flash atteint 98,5 % du score d'automatisation de routine de Pro (52,3 contre 53,1) pour un tiers du coût d'entrée (0,14 $ contre 0,435 $/M), mais subit une rupture nette lors de mutations dynamiques du DOM ou d'erreurs 403, réitérant en boucle au lieu de réévaluer la situation.
Pourquoi MiMo-V2.6-Flash éprouve-t-il des difficultés dans la récupération d'erreurs à long terme ?
En n'activant que 15B de ses 309B paramètres totaux MoE, Flash offre une vitesse de génération linéaire remarquable mais manque de la capacité de représentation nécessaire pour diagnostiquer des défaillances en cascade ou élaborer de nouvelles stratégies de résolution.
Comment la mise en cache des invites (prompt caching) réduit-elle les coûts de Flash ?
La lecture des accès mis en cache est facturée 0,0028 $ par million de tokens, soit une réduction de 98 % (50 fois moins cher) par rapport au tarif non mis en cache de 0,14 $. Cela permet de réutiliser des contextes étendus et des schémas d'outils à un coût minime.
MiMo-V2.6-Flash est-il disponible dans Tabbit Browser ?
La disponibilité dans Tabbit Browser dépend du sélecteur de modèles actif de chaque compte et des identifiants connectés. Bien que les poids et l'API soient publics, Tabbit fait office de couche d'orchestration multi-onglets et ne garantit pas un accès préconfiguré universel.