
任務又長、又依賴工具、而且你願意為更長的 token 帳單付錢時,Grok 4.7 值得拿來試點。日常短任務仍應預設 Grok 4.6。API 標價沒有變。
xAI 在 2026 年 9 月 21 日發布 Grok 4.7,並寫它與 Grok 4.6 同價、同速。9 月 22 日打開的兩張模型卡,在費率和 50 萬上下文上是一致的。它們沒有證明做完一個任務的花費也一樣。Artificial Analysis 以 xhigh 評測 Grok 4.7,智能指數每題大約 8.1 萬輸出 token,Grok 4.6 在 high 檔大約 3.6 萬。決定要不要換模型的是這個數字,不是單價。(xAI 發布頁,Grok 4.7 模型卡,Grok 4.6 模型卡,Artificial Analysis)
Cursor 裡馬上出現了同一組張力。9 月 21 日,u/Dynamix86 寫道:同一個 Ultra 帳號、extra high、關閉 Fast,同一項未公開的任務上,Grok 4.7 消耗方案百分比的速度大約是 Grok 4.6 的 2.5 倍,多數工作會改回 4.6。
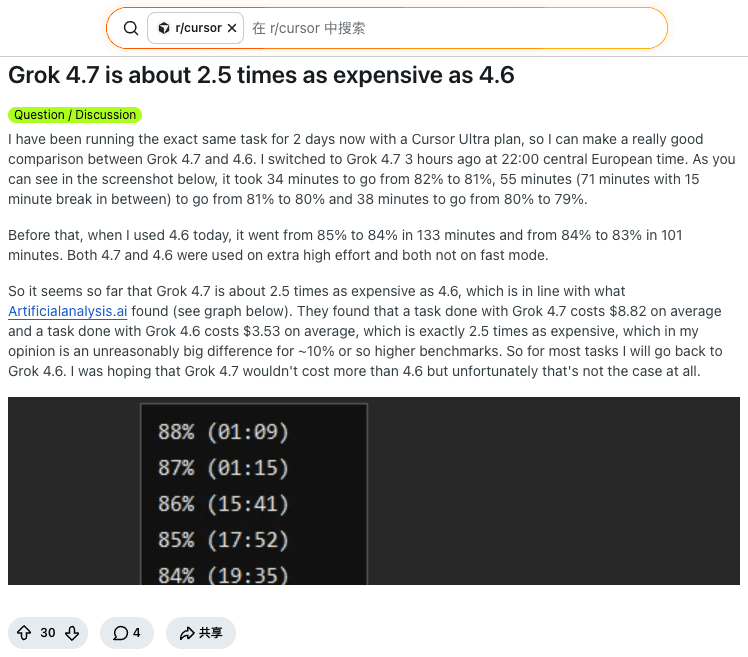
這是一個帳號、一項任務。它不能證明 API 帳單,也不能證明回答品質。它說明「同價」不是該先問的問題。Grok 4.6 總覽 談的是上一代本身。本頁只處理兩者怎麼選。規格入口在 Grok 4.7 模型頁 (简体中文) 和 Grok 4.6 模型頁 (简体中文)。
要點
兩張 API 卡在 20 萬上下文以內都是每百萬 token $2 / 快取 $0.50 / 輸出 $6,超過 20 萬是 $4 / $1 / $12。上下文視窗都是 50 萬。
Grok 4.7 xhigh 每道智能指數題約 8.1 萬輸出 token,Grok 4.6 high 約 3.6 萬,Grok 4.6 xhigh 約 3.8 萬。按輸出 $6 計算,僅輸出大約 $0.49 對 $0.22–$0.23。
智能指數 +2,而且是 xhigh 對 high(46 對 44)。編碼代理指數 +9,兩邊都是 xhigh,且都在 Grok Build 裡(56 對 47)。
xAI 發布表每一列都高於 Grok 4.6,但欄位標題是 Grok 4.7 xHigh 和 Grok 4.6 High。表上 DeepSWE 把 4.7 標成 high effort。這些差距不是同檔實驗。
短而重複的工作留在 Grok 4.6。只有當長編碼或長文件在 4.6 上經常失敗、失敗成本蓋過額外 token 時,再試點 Grok 4.7。
本文沒有 Tabbit 同題執行。模型頁不是實測勝負。
決定這篇對比的數字:同為 $2/$6,輸出大約 8.1 萬對 3.6 萬 token
發布標題寫 Grok 4.7「比同類模型快一倍、價格一半」,正文又寫它與 Grok 4.6 同價同速。前一句沒有點名比較對象,也沒有速度單位。後一句才是費率卡能支持的說法。
變的是新模型花掉多少 token。Artificial Analysis 寫 Grok 4.7 xhigh 每道智能指數題大約 8.1 萬輸出 token,Grok 4.6 high 大約 3.6 萬,他們稱為多 125%。同一篇文章後文又寫,8.1 萬是 Grok 4.6 xhigh 約 3.8 萬的兩倍多。兩個對照都要留著。3.6 萬不是同檔對比。3.8 萬才是。
每道智能指數題的輸出 token(Artificial Analysis,2026-09-21)
Grok 4.7 xhigh     約 8.1 萬
Grok 4.6 high      約 3.6 萬    (token 多 125%,檔位更高)
Grok 4.6 xhigh     約 3.8 萬    (同檔,token 超過 2 倍)

按共享的每百萬輸出 $6,只算輸出
8.1 萬 × $6 / 100 萬  ≈  $0.49
3.6 萬 × $6 / 100 萬  ≈  $0.22
3.8 萬 × $6 / 100 萬  ≈  $0.23
這不是發票。它沒算輸入、快取命中、工具呼叫、重試,也沒算按方案百分比而不是 API 美元計費的客戶端。它也沒說明這些 token 買到了什麼分數。
智能指數從 Grok 4.6 high 的 44 分到 Grok 4.7 xhigh 的 46 分。代理式知識工作之外,Artificial Analysis 認為 Grok 4.7 大體對齊 Grok 4.6 high:Terminal-Bench 4.0 高 4.5 個百分點,GDP.pdf 高 3.0 個百分點,AA-LCR 低 3.7 個百分點,AutomationBench-AA 低 1.1 個百分點。這四項的絕對分沒有印在正文裡。
移動更大的是編碼代理指數,而且檔位對齊。Grok 4.7 xhigh 加 Grok Build 為 56,Grok 4.6 xhigh 加 Grok Build 為 47。該 harness 內 DeepSWE v1.1 從 65% 到 73%,Terminal-Bench 4.0 從 18% 到 33%,SWE-Atlas-QnA 從 58% 到 63%。這些終端數字不是發布表上的 38.0% 和 20.3%,也不是統一 harness 裡的 +4.5 個百分點。三組 Terminal-Bench 可以同時為真,只要 harness 和檔位不同。
額外 token 能少一次返工時,用 Grok 4.7。如果跨檔位的 +2 分指數不值得大約兩倍輸出,留在 Grok 4.6。
規格和價格一覽
2026 年 9 月 22 日核對兩張模型卡。「更高上下文」指請求超過 20 萬 token。Cursor 文件用的是 25.6 萬這條邊界,不在本表裡。
| 維度 | Grok 4.7 | Grok 4.6 | 怎麼用這一列 |
|---|---|---|---|
| API 模型 ID | grok-4.7 | grok-4.6 | 固定 ID。對比時不要用 latest 別名。 |
| 上下文視窗 | 500,000 | 500,000 | 客戶端可以暴露得更短。Cursor 的 Grok 4.7 頁寫標準 256K、長上下文 500K。 |
| 模態 | 文字和影像輸入,文字輸出 | 文字和影像輸入,文字輸出 | 影像大小限制在共享文件裡,不是挑選 ID 的理由。 |
| 輸入 / 快取 / 輸出,不超過 20 萬 | 每百萬 $2 / $0.50 / $6 | 每百萬 $2 / $0.50 / $6 | 標價相同。 |
| 輸入 / 快取 / 輸出,超過 20 萬 | 每百萬 $4 / $1 / $12 | 每百萬 $4 / $1 / $12 | 長上下文倍率也相同。 |
| 知識截止 | 模型索引寫 May 2026 | 本次打開的模型卡沒有重述 | 不要把舊文的截止日期抄過來。 |
| Fast | 發布頁:輸出速度兩倍、價格兩倍,沒有基準列 | 本次打開的卡片沒有寫 | 不要把兩個 Fast 開關當成同一產品。 |
xAI 發布表也給兩欄 Grok 印了輸入 $2、輸出 $6,旁邊是 GPT-5.6 Sol 的 $4 / $20 和 Fable 5.1 的 $10 / $50。那是標價對照,不是做完任務的對照。Fable 5.1 在 xAI 自己的好幾列上仍然領先;取捨寫在 Fable 5.1 測評,不是「Grok 已經換掉它」。
同一天打開的 Cursor Grok 4.7 文件會跳到 cursor.com/cn/docs/models/grok-4-7。頁上把 Grok 4.7 放進與 Grok 4.6、Grok 4.5、Composer 2.5 共享的用量池。按需價格與短上下文 API 卡一致:輸入 $2、快取 $0.50、輸出 $6。Fast 為 $4 / $1 / $12,且 Pro 及以上預設 Fast。輸入超過 256K 時,標準按 2 倍、Fast 按標準費率的 3 倍計,直到 500K。Cursor 的百分比和 API 的美元是兩把尺。先把兩邊的檔位和 Fast 固定,再比較。
基準,以及該信多少
下面兩張表。第一張是 xAI 發布表,檔位按頁面原文。第二張是 Artificial Analysis:能對齊檔位的分開放,不能對齊的標明。
| xAI 發布表,2026-09-21 | Grok 4.7 | Grok 4.6 | GPT-5.6 Sol | Fable 5.1 |
|---|---|---|---|---|
| 欄位檔位 | xHigh;DeepSWE 標為 high effort | High | Max | Max |
| 標價,每百萬輸入 / 輸出 | $2 / $6 | $2 / $6 | $4 / $20 | $10 / $50 |
| CursorBench 4.0 | 46.3% | 40.4% | 41.7% | 51.8% |
| DeepSWE v1.1 | 71.0% | 65.2% | 72.7% | 70.0% |
| EEBench | 64.0% | 53.0% | 39.4% | 56.4% |
| AA Briefcase v1.1 | 1,657 | 1,546 | 1,487 | 1,678 |
| Terminal-Bench 4.0 | 38.0% | 20.3% | 37.3% | 57.9% |
| Harvey Legal Agent Benchmark | 19.6% | 15.8% | 2.5% | 6.7% |
| HealthBench Professional | 56.7% | 48.5% | 60.5% | 62.1% |
這張表上 Grok 4.7 每一列都高於 Grok 4.6。它沒有在 CursorBench、AA Briefcase、Terminal-Bench、HealthBench Professional 上超過 Fable 5.1。對 GPT-5.6 Sol,七個分數列裡它贏五行,DeepSWE 和 HealthBench 落後。頁面沒有樣本量、harness 和信賴區間。圖說把這些基準寫成廠商結果。
同一頁的 CursorBench 散點圖沒有 Grok 4.6。Grok 4.7 的檔位階梯很陡:Extra High 46.3%,約每任務 $6.01、70,141 輸出 token;High 43.9%,$4.69;Medium 41.6%,$3.49;Low 33.1%,$1.58。不寫檔位的「Grok 4.7」不是一個分數。
| Artificial Analysis,文章日期 2026-09-21 | Grok 4.7 | Grok 4.6 | 檔位 | 可以怎麼說 |
|---|---|---|---|---|
| Intelligence Index v4.3 | 46 | 44 | xhigh 對 high | +2,不是同檔 |
| 每道智能題輸出 token | 約 8.1 萬 | high 約 3.6 萬;xhigh 約 3.8 萬 | 混合 | 帳單比指數動得大 |
| Coding Agent Index,Grok Build | 56 | 47 | xhigh 對 xhigh | 一方編碼代理 +9 |
| DeepSWE v1.1,Grok Build | 73% | 65% | xhigh 對 xhigh | 不是發布表的 71.0 / 65.2 |
| Terminal-Bench 4.0,Grok Build | 33% | 18% | xhigh 對 xhigh | 不是 xAI 的 38.0 / 20.3 |
| SWE-Atlas-QnA,Grok Build | 63% | 58% | xhigh 對 xhigh | 升幅小於終端題 |
| AA-Briefcase Elo | 1,657 | high 為 1,546 | xhigh 對 high | 分析品質升,展示品質降 |
| GDPval-AA Elo | 1,695 | high 為 1,605 | xhigh 對 high | 知識工作有提升;xAI 圖上 Fable 5.1 為 1,735 |
| 幻覺率,AA-Omniscience | 29% | high 為 34% | xhigh 對 high | 準確率仍是 47% 對 48% |
關心 Grok Build 時讀編碼代理那一塊。關心統一 harness 時讀智能指數那一塊。不要合成一句「Grok 好了 10%」。Hacker News 上有人直接問:為什麼拿 4.7 xhigh 比 4.6 high?該串回覆對 4.6 何時有 xhigh 並不一致。Artificial Analysis 的編碼指數確實有 Grok 4.6 xhigh,所以至少有一套目前評測使用這個標籤。發布表仍然沒用它。
Grok 4.7 真正拉開差距的地方
編碼代理裡的長任務
最乾淨的提升是檔位對齊的那一組。Grok Build 上編碼代理指數高 9 分,三個分項都上升。終端任務升得最多,該 harness 裡從 18% 到 33%。如果你的失敗模式是多小時儲存庫任務中途停住,這一列值得試點。它沒有說 Grok Build 會勝過 Claude Code 或 Codex。Artificial Analysis 把 Grok 4.7 加 Grok Build 排在原生 harness 的第四,後面是第一名到第三名:Claude Fable 5.1、GPT-6 Astra、Claude Opus 5。
xAI 自己的 Terminal-Bench 4.0 從 20.3% 到 38.0%,方向一致,但檔位不對齊。把它當作廠商側證,不要當成 18 到 33 的另一次獨立測量。
文件和分析,展示品質要單獨看
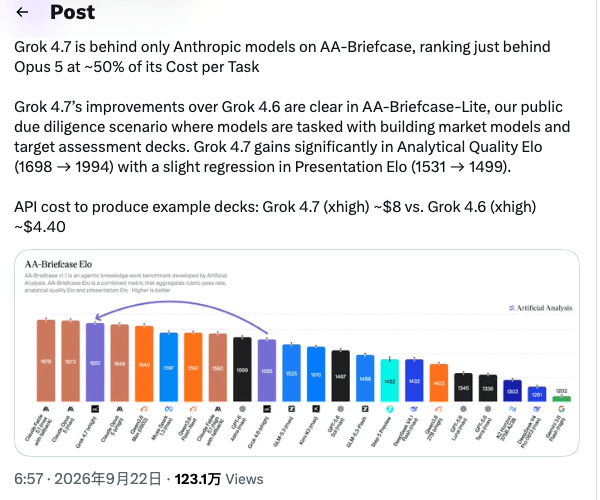
AA-Briefcase 上 Grok 4.7 為 1,657 Elo,比 Grok 4.6 high 高 111,在 Artificial Analysis 的寫法裡緊跟 Claude Opus 5 和 Claude Fable 5.1。分析品質 1,994 對 1,690。展示品質 1,499 對 1,519。分析更好,簡報略差。
公開的 AA-Briefcase-Lite 盡職調查場景把這個分裂寫得更明確:分析 Elo 從 1,698 到 1,994,展示 Elo 從 1,531 到 1,499。示例簡報的 API 成本,Grok 4.7 xhigh 約 $8,Grok 4.6 xhigh 約 $4.40。這是同檔,大約 1.8 倍成本,換來更強的分析和更弱的展示。它是一個場景,不是全部辦公室基準。GDPval-AA 在 high 對 xhigh 的對照裡從 1,605 到 1,695;xAI 的 GDPval 圖上 Fable 5.1 max 為 1,735。
幻覺率更低,準確率沒有更高
AA-Omniscience 幻覺率是 Grok 4.7 xhigh 的 29%,Grok 4.6 high 的 34%。準確率是 47% 對 48%。指數從 30 到 32。如果你要的是更少的自信錯答,這是變化。如果你要的是更多答對,這組數字沒有顯示。檔位仍然不同。
Grok 4.6 仍然該當預設的地方
短任務:多出來的思考本身就是成本
同價買大約兩倍輸出,只有在這些 token 能少一次返工時才划算。有界抽取、小補丁、狀態 JSON,Grok 4.6 更短的軌跡才是優點。看過智能指數 token 圖的 Hacker News 讀者把這稱為 token 效率退步。這則留言沒有新測量,它是把同一張 Artificial Analysis 圖讀成成本問題,而不是能力升級。

Artificial Analysis 點名相對 Grok 4.6 high 退步的 AA-LCR 和 AutomationBench-AA,沒有理由離開 4.6。絕對分沒公布,所以降幅只按已發表的 3.7 和 1.1 個百分點理解。
Cursor 方案:如果 Fast 和檔位沒固定
$2/$6 的標價描述不了 Cursor Ultra 的百分比。Dynamix86 的計時是單人日誌:Grok 4.7 每掉 1 個百分點用了 34、55、38 分鐘,當天更早的 Grok 4.6 是 133 和 101 分鐘,兩邊都是 extra high 且關閉 Fast。作者還把一張 Artificial Analysis 圖讀成編碼代理每任務 $8.82 對 $3.53。這兩個美元數是作者的讀圖。為本頁打開的 Artificial Analysis 文章正文沒有這兩句,所以它們只屬於那篇貼文。
同一帖的一則回覆更直接:就算先不談基準,這個發布的成本也明顯太高。
Cursor 文件還寫 Pro 及以上預設 Fast,token 費率加倍。如果個人測試一邊開了 Fast、另一邊沒有,兩倍價格是設定,不是換模型。Reddit 這則日誌寫了 Fast 關閉。隨意對比常常不會這麼做。
你已經接受 Grok 4.6 的那些工作
Grok 4.6 的測評筆記 (简体中文)已經描述過這個價位上的 50 萬上下文代理模型。Grok 4.7 沒有在 API 卡上增加新的上下文檔位,也沒有降價。如果 4.6 已經做完,而且你沒有卡在長終端任務或長文件上,升級是可選的。HealthBench Professional 在 xAI 自己的表上仍落後於 GPT-5.6 Sol 和 Fable 5.1(56.7 對 60.5 和 62.1),臨床推理也不是這次切換的理由。
人們實際怎麼說
早期留言分成帳單陣營和手感陣營。兩邊都只有幾小時。兩邊都沒有公布提示詞、儲存庫或評分。
帳單。 Dynamix86 大約 2.5 倍的方案用量,加上 truecakesnake 的「成本明顯太高」,和 token 圖放在一起。Hacker News 的 notduckrabbit 指向同一個效率差。合在一起的意思是:不要在發布當天遷移高流量路線。
手感。 同一天下午的另一些 r/cursor 留言喜歡這個模型,而且沒提價格。
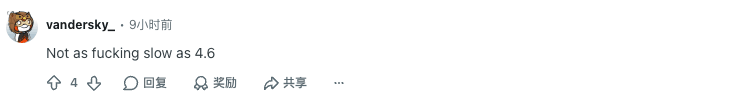
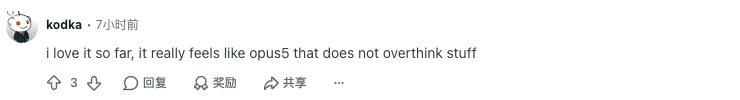
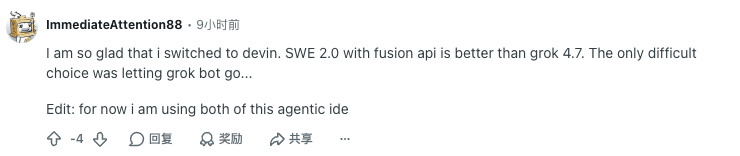
「更快」和「沒那麼過度思考」可以在一次聊天裡成立,同時在吐出 8.1 萬 token 的 xhigh 編碼代理裡不成立。「沒有 4.6 那麼慢」沒有配 token 數。Artificial Analysis 在長提示上測到大約每秒 188 token,每道智能指數題大約 7.1 分鐘解碼時間,不含首 token 和額外開銷。第一印象很快,和一條很長的代理軌跡,可以同時存在。
2026 年 9 月 22 日在 YouTube 搜尋「Grok 4.7 vs Grok 4.6」,出來的是發布解說,其中還有發布前猜測參數量的影片。xAI 發布頁只寫「新的、更大的基座」,沒有參數量。這裡不引用影片旁白。
怎麼選
沒有總冠軍。按工作形狀選,並把推理檔位寫進決定裡。
| 工作負載 | 選擇 | 原因 | 要盯住什麼 |
|---|---|---|---|
| 短抽取、分類或小補丁 | Grok 4.6 | 指數提升小,輸出軌跡短得多 | 不要為一句回答付 xhigh |
| Cursor 用量池上的重複工作 | 任務沒失敗就留 Grok 4.6 | 一份 Ultra 日誌在 extra high、關閉 Fast 時大約 2.5 倍用量 | 先固定 Fast 和檔位,再怪模型 |
| Grok Build 或同類代理裡的多小時編碼 | 試點 Grok 4.7 xhigh | 同檔編碼指數 56 對 47 | 比做完的任務,不只比指數 |
| 市場模型、備忘錄、目標評估簡報 | 試點 Grok 4.7,然後改簡報 | 分析 Elo 上升,展示 Elo 下滑;示例簡報約 $8 對 $4.40 | 簡報留一輪人工 |
| 超過 20 萬的長上下文 API | 價格上兩者一樣 | 兩張卡超過 20 萬都加倍 | Cursor 的 256K 邊界是另一把尺 |
| 你需要 Fable 那種 CursorBench 或 Terminal-Bench | 不是這一對 | Fable 5.1 Max 在 xAI 表上是 51.8% 和 57.9% | 用 Fable 的價卡,不用 Grok 的 |
實用測試是一道你已經知道怎麼打分的任務:同檔、關閉 Fast、同一 harness。記下是否做完、人工修改、輸出 token,以及 API 美元或方案百分比。一次做對不是成功率。
遷移整條路線之前,先在 Tabbit 裡跑同一道題
基準列不會告訴你模型在你的分頁、文件和沒做完的調研裡是什麼樣。Tabbit Browser 是做這次檢查的工作台:模型可以挨著你正在讀的頁面,而不是待在一個看不見這些頁面的聊天視窗裡。代理瀏覽器指南和代理推理指南把模型分數和做完的多步流程分開。AI 瀏覽器對比和 Tabbit 瀏覽器指南談的是模型外面的產品。如果 Tabbit 不是你要的客戶端,2026 AI 瀏覽器盤點是更大的集合。
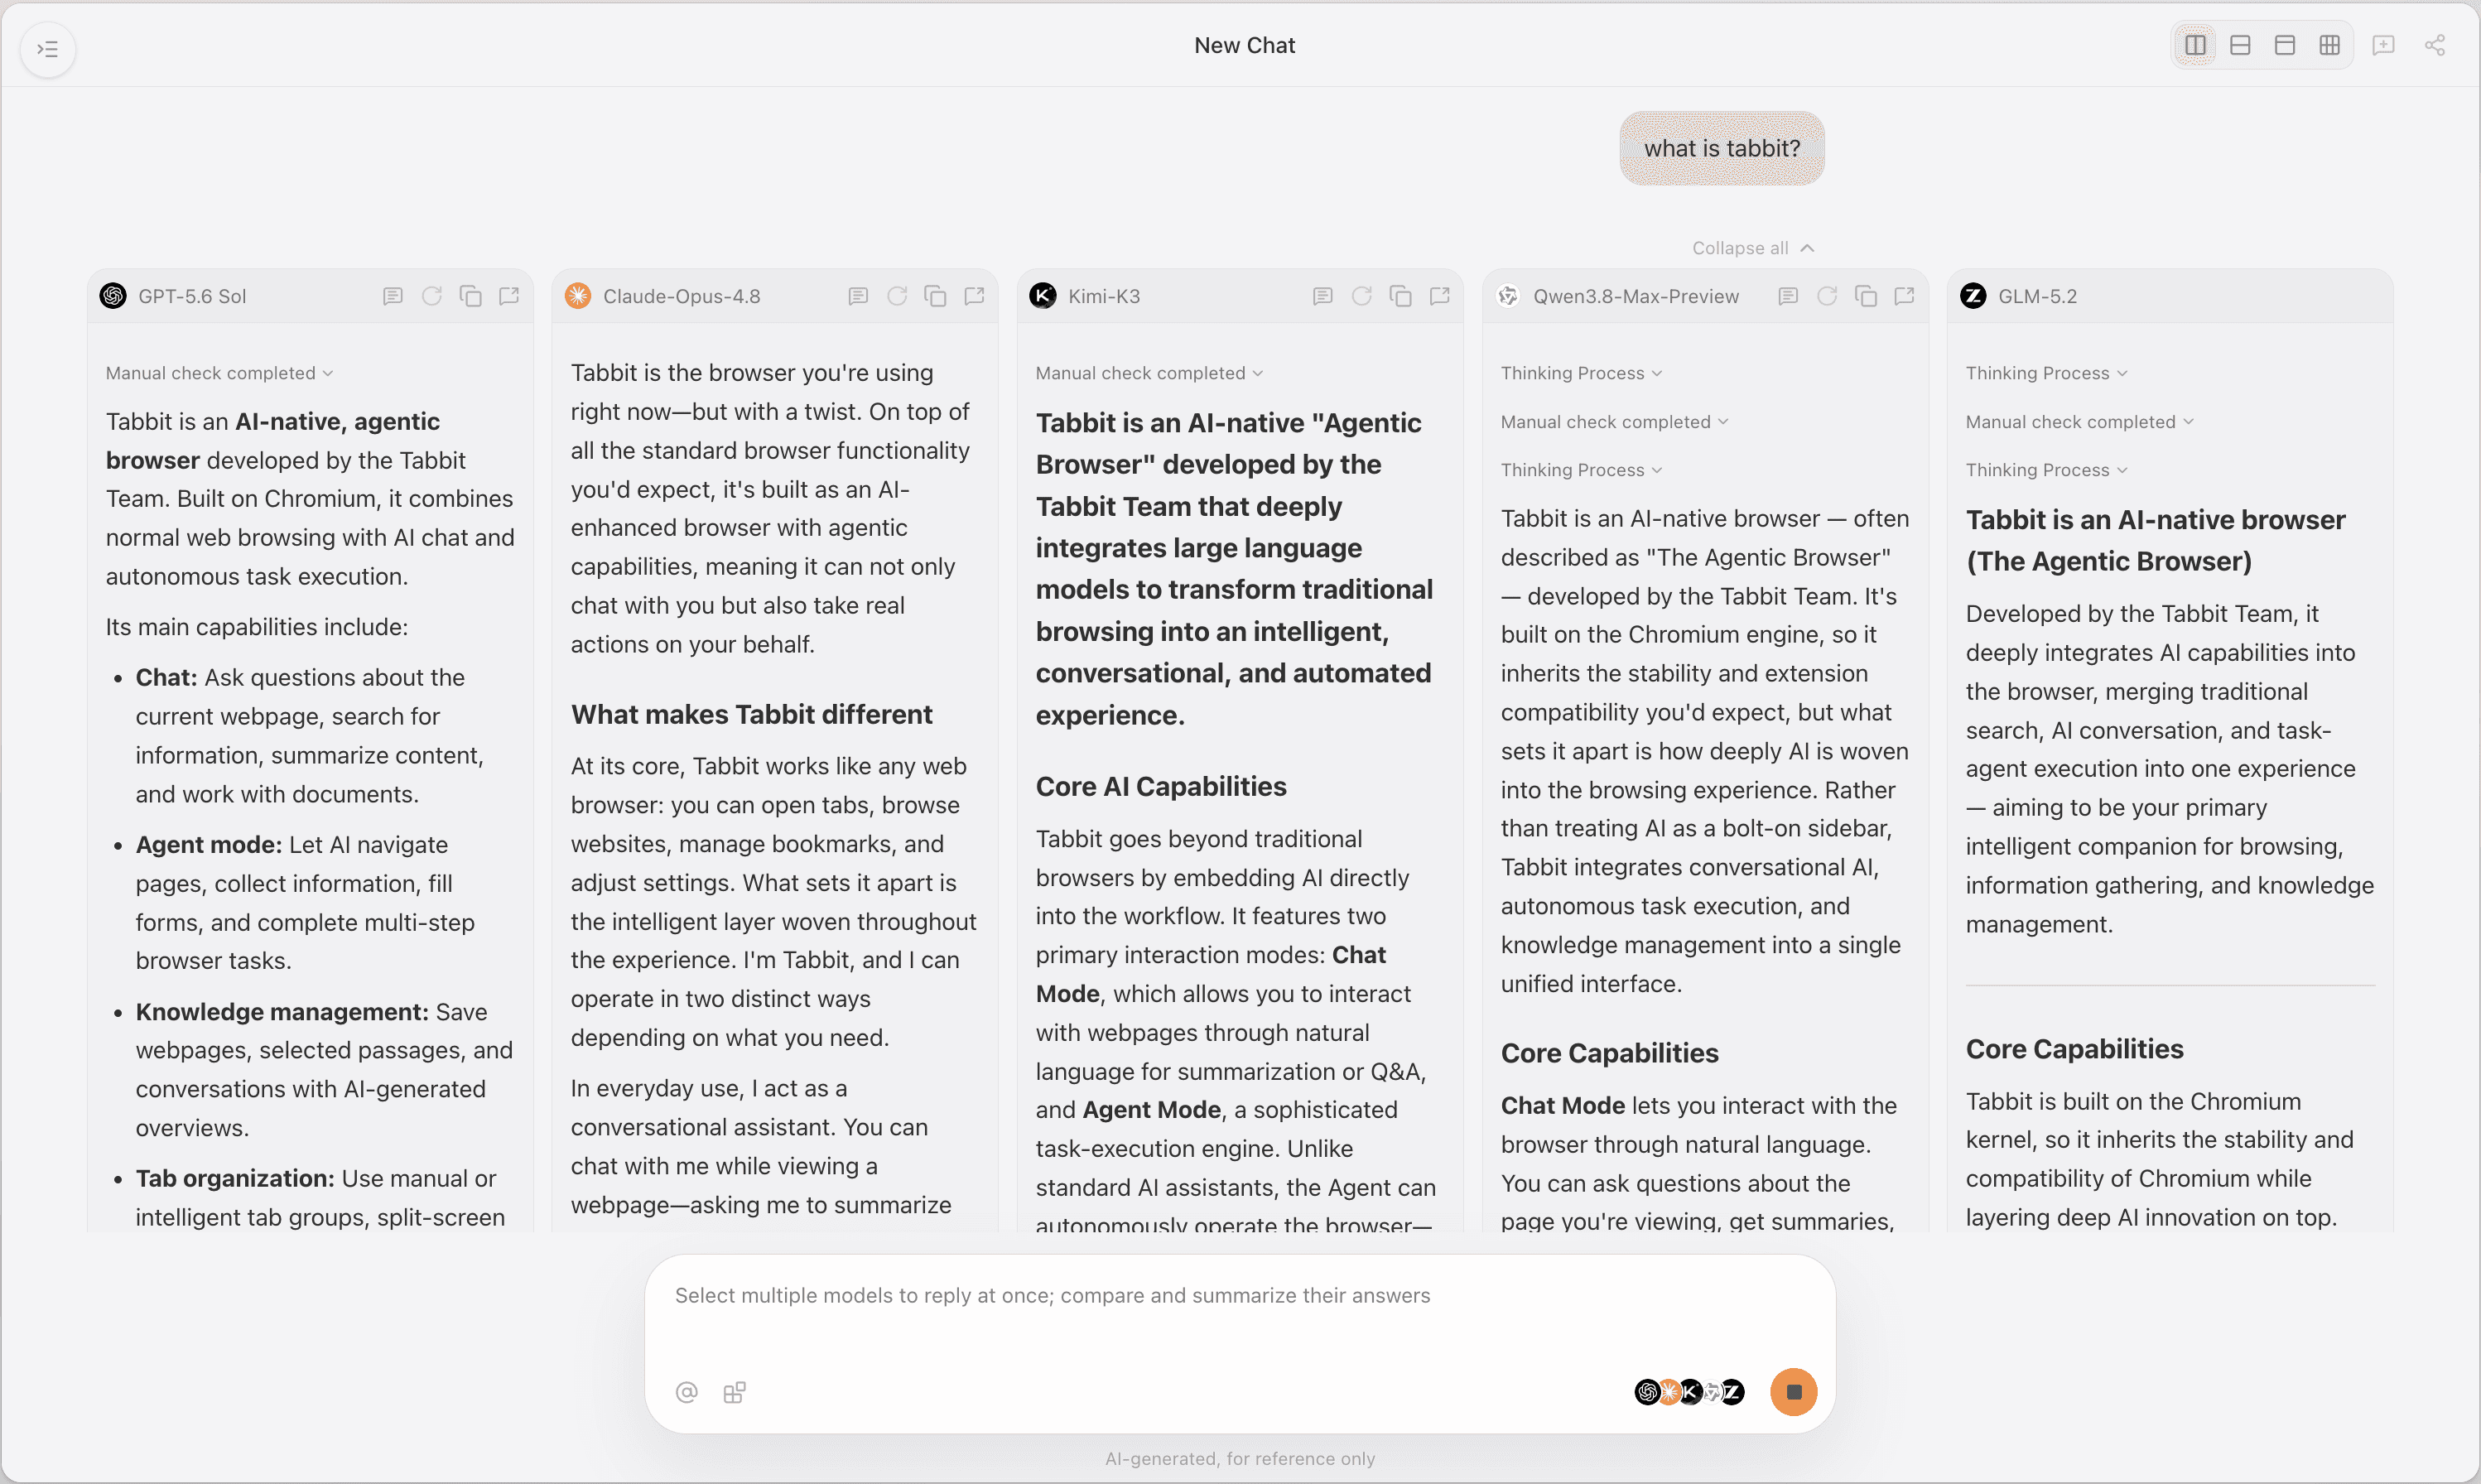
兩個 Grok ID 都已在 Tabbit 註冊。選擇器裡有沒有 Grok 4.7 或 Grok 4.6,取決於帳號和目前清單。本文沒有 Tabbit 紀錄、token 日誌或勝者。如果兩個 ID 都在,就拿一道你知道怎麼打分的任務,檔位和工具保持一致;如果變化只是軌跡更長,就留在 Grok 4.6。Tabbit 實踐指南談的是瀏覽器裡的工作方式,不是說每個帳號都預裝了某一個 Grok。
API 標價、Cursor 用量池和 Tabbit 的使用權限是三筆不同的帳。不要加在一起。
 Tabbit Browser

常見問題
Grok 4.7 比 Grok 4.6 更好嗎?
要看任務和推理檔位。Artificial Analysis 的 Coding Agent Index 上,Grok 4.7 xhigh 配 Grok Build 是 56 分,Grok 4.6 xhigh 是 47 分。智能指數只從 Grok 4.6 high 的 44 分到 Grok 4.7 xhigh 的 46 分,而且有些非代理任務是退步的。沒有總冠軍。
Grok 4.7 和 Grok 4.6 價格一樣嗎?
2026 年 9 月 22 日打開的 xAI 模型卡上,兩者在 20 萬上下文以內都是輸入 $2、快取輸入 $0.50、輸出 $6,超過 20 萬則是 $4、$1、$12。Cursor 另有用量池和 Fast 檔。標價相同不等於做完一個任務的花費相同。
單價沒變,為什麼 Grok 4.7 可能更貴?
Artificial Analysis 測得 Grok 4.7 xhigh 每道智能指數題約 8.1 萬輸出 token,Grok 4.6 high 約 3.6 萬,Grok 4.6 xhigh 約 3.8 萬。按每百萬輸出 $6 計算,僅輸出大約是 $0.49 對 $0.22 或 $0.23,還沒算輸入、快取、工具和重試。
哪些 Grok 4.7 的基準提升是同一推理檔位?
編碼代理指數是 xhigh 對 xhigh:56 對 47。Grok Build 裡 DeepSWE 73% 對 65%,Terminal-Bench 4.0 33% 對 18%,SWE-Atlas-QnA 63% 對 58%。xAI 發布表是 Grok 4.7 xHigh 對 Grok 4.6 High,而且表上的 DeepSWE 把 4.7 標成 high effort。不要把這些列當成同檔實驗。
在 Cursor 裡要從 Grok 4.6 換成 Grok 4.7 嗎?
長編碼或長文件可以試點,但要接受用量掉得更快。一位 Cursor Ultra 使用者在 extra high、關閉 Fast 的條件下,估計方案用量大約是 2.5 倍,並準備把多數任務改回 4.6。也有人覺得 4.7 更快、沒那麼過度思考。比較前先固定檔位和 Fast。
能在 Tabbit 瀏覽器裡對比 Grok 4.7 和 Grok 4.6 嗎?
兩個模型都有 Tabbit 模型頁。選擇器裡是否出現,取決於帳號和目前的模型清單。本文沒有同題實測,所以選擇器裡有這個名字,不能當成某個工作流程已經分出勝負。