
O Grok 4.7 é o modelo para testar quando a tarefa é longa, usa muitas ferramentas e justifica uma fatura de tokens maior. O Grok 4.6 continua sendo o padrão quando o trabalho é rotineiro e você quer o rastro mais curto. A tarifa de tabela da API não mudou.
A xAI publicou o Grok 4.7 em 21 de setembro de 2026 e disse que ele é servido pelo mesmo preço e pela mesma velocidade do Grok 4.6. As fichas abertas em 22 de setembro concordam na tarifa e na janela de 500K. Elas não mostram que uma tarefa concluída custa o mesmo. A Artificial Analysis, avaliando o Grok 4.7 em xhigh, contou cerca de 81.000 tokens de saída por tarefa do Intelligence Index, contra cerca de 36.000 do Grok 4.6 em high. Esse é o número que decide a troca. (lançamento da xAI, ficha do Grok 4.7, ficha do Grok 4.6, Artificial Analysis)
A mesma tensão apareceu logo no Cursor. Em 21 de setembro, u/Dynamix86 escreveu que uma conta Ultra, em extra high e com Fast desligado, queimava a porcentagem do plano cerca de 2,5 vezes mais rápido no Grok 4.7 do que no Grok 4.6 na mesma tarefa sem nome, e que a maior parte do trabalho voltaria ao 4.6.
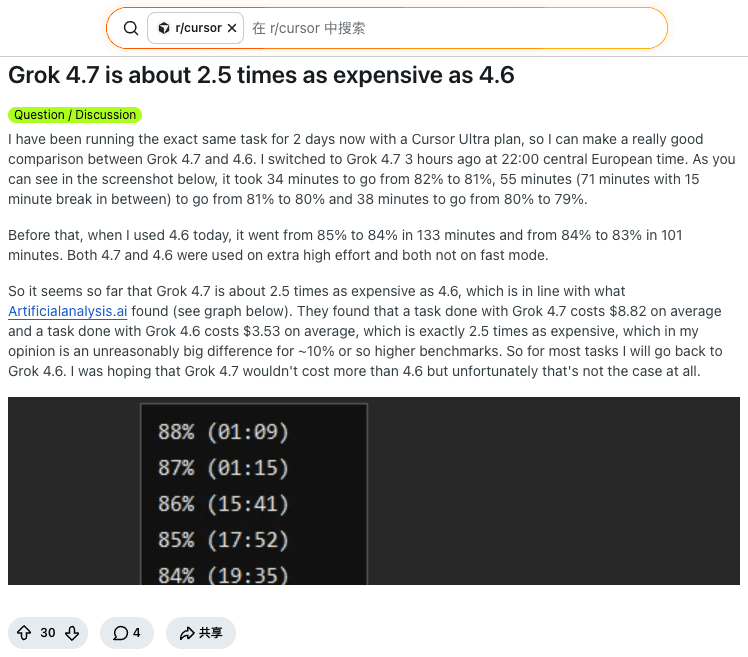
Esse post é uma conta e uma tarefa. Não prova faturas de API nem a qualidade da resposta. Mostra por que “o mesmo preço” é a primeira pergunta errada. A visão geral do Grok 4.6 cobre o modelo anterior por si só. Esta página trata só da escolha entre os dois. As especificações também estão na página do Grok 4.7 (English) e na página do Grok 4.6 (English).
Pontos principais
As duas fichas de API listam US$ 2 / US$ 0,50 em cache / US$ 6 por milhão de tokens abaixo de 200K de contexto, e US$ 4 / US$ 1 / US$ 12 acima de 200K. A janela de 500K coincide.
O Grok 4.7 xhigh usou cerca de 81 mil tokens de saída por tarefa de inteligência da Artificial Analysis, contra cerca de 36 mil do Grok 4.6 high e cerca de 38 mil do Grok 4.6 xhigh. Só a saída, a US$ 6, fica em cerca de US$ 0,49 contra US$ 0,22–US$ 0,23.
O movimento do Intelligence Index é +2, e compara xhigh com high (46 contra 44). O do Coding Agent Index é +9 em xhigh alinhado dentro do Grok Build (56 contra 47).
A tabela de lançamento da xAI melhora em cada linha listada, mas as colunas são Grok 4.7 xHigh e Grok 4.6 High. O DeepSWE nessa tabela marca high effort para o 4.7. Essas diferenças não são um experimento do mesmo degrau.
Deixe o Grok 4.6 para o trabalho curto e repetido. Teste o Grok 4.7 quando uma execução longa de código ou uma tarefa carregada de documentos falhar no 4.6 com frequência suficiente para pagar os tokens extras.
Nenhuma execução da mesma tarefa no Tabbit foi feita para este artigo. Uma página de modelo não é uma vitória medida.
O número que decide: mesma tarifa de US$ 2/US$ 6, cerca de 81 mil contra 36 mil tokens de saída
A manchete do lançamento diz que o Grok 4.7 é “duas vezes mais rápido, pela metade do preço de modelos comparáveis”, e o corpo diz que ele é servido pelo mesmo preço e pela mesma velocidade do Grok 4.6. A primeira frase não nomeia os modelos comparáveis nem a unidade de velocidade. A segunda é a que as fichas de tarifa sustentam.
O que mudou é quantos tokens o modelo novo gasta. A Artificial Analysis escreveu que o Grok 4.7 xhigh usa aproximadamente 81 mil tokens de saída por tarefa do Intelligence Index, contra 36 mil do Grok 4.6 high, o que eles chamam de 125% a mais. Mais adiante no mesmo artigo, 81 mil é mais do que o dobro dos 38 mil usados pelo Grok 4.6 xhigh. As duas comparações importam. O número de 36 mil não é um par do mesmo esforço. O de 38 mil é.
Tokens de saída por tarefa do Intelligence Index (Artificial Analysis, 21 set. 2026)
Grok 4.7 xhigh     ~81k
Grok 4.6 high      ~36k     (+125% de tokens, rótulo de esforço mais alto)
Grok 4.6 xhigh     ~38k     (mais de 2× tokens, mesmo rótulo de esforço)

Cobrança só de saída na tarifa compartilhada de US$ 6 / 1M
81k × US$ 6 / 1M  ≈  US$ 0,49
36k × US$ 6 / 1M  ≈  US$ 0,22
38k × US$ 6 / 1M  ≈  US$ 0,23
Essa conta não é uma fatura. Ignora tokens de entrada, acertos de cache, chamadas de ferramentas, novas tentativas e qualquer cliente que cobre uma porcentagem do plano em vez da API. Também ignora a pontuação que esses tokens compraram.
No Intelligence Index a pontuação foi de 44 no Grok 4.6 high para 46 no Grok 4.7 xhigh. Fora do trabalho de conhecimento agêntico, a Artificial Analysis disse que o Grok 4.7 acompanhava em linhas gerais o Grok 4.6 high, com Terminal-Bench 4.0 +4,5 pontos e GDP.pdf +3,0 pontos, e com quedas em AA-LCR (−3,7 pontos) e AutomationBench-AA (−1,1 ponto). As pontuações absolutas dessas quatro linhas não foram impressas no texto.
O movimento maior é o índice de agente de código, e ele é uma comparação do mesmo esforço. O Grok 4.7 xhigh com Grok Build marcou 56, contra 47 do Grok 4.6 xhigh com Grok Build. Dentro desse harness, DeepSWE v1.1 foi de 65% para 73%, Terminal-Bench 4.0 de 18% para 33% e SWE-Atlas-QnA de 58% para 63%. Esses números de terminal não são os 38,0% e 20,3% da tabela de lançamento da xAI, nem o delta de +4,5 pontos do harness unificado. Três leituras de Terminal-Bench podem ser reais se o harness e o esforço diferirem.
Use o Grok 4.7 quando os tokens extras compram uma execução longa que você refaria. Fique no Grok 4.6 quando um índice +2, medido entre rótulos de esforço diferentes, não valer cerca do dobro da saída.
Especificações e preço de relance
Conferido em 22 de setembro de 2026 nas duas fichas. “Higher context” nessas fichas significa um pedido acima de 200K tokens. A documentação do Cursor usa um limite de 256K e não é esta tabela.
| Dimensão | Grok 4.7 | Grok 4.6 | Como usar a linha |
|---|---|---|---|
| ID do modelo na API | grok-4.7 | grok-4.6 | Fixe o ID. Não use um alias “latest” para comparar. |
| Janela de contexto | 500.000 | 500.000 | Um cliente pode expor menos. A página do Grok 4.7 no Cursor descreve 256K padrão e 500K de contexto longo. |
| Modalidades | Texto e imagem na entrada, texto na saída | Texto e imagem na entrada, texto na saída | Os limites de tamanho de imagem estão na documentação compartilhada, não são motivo para escolher um ID. |
| Entrada / cache / saída, até 200K | US$ 2 / US$ 0,50 / US$ 6 por 1M | US$ 2 / US$ 0,50 / US$ 6 por 1M | Mesma tarifa de tabela. |
| Entrada / cache / saída, acima de 200K | US$ 4 / US$ 1 / US$ 12 por 1M | US$ 4 / US$ 1 / US$ 12 por 1M | O multiplicador de contexto longo também coincide. |
| Corte de conhecimento | Maio de 2026, no índice de modelos | Não repetido na ficha aberta nesta data | Não copie um corte mais antigo. |
| Opção Fast | Post de lançamento: uma variante rápida com o dobro da velocidade de saída e o dobro do preço, sem linha de benchmark | Não consta na ficha aberta nesta data | Não suponha que os dois interruptores Fast sejam o mesmo produto. |
A tabela de lançamento da xAI também imprime US$ 2 de entrada e US$ 6 de saída para as duas colunas Grok, ao lado do GPT-5.6 Sol a US$ 4 / US$ 20 e do Fable 5.1 a US$ 10 / US$ 50. Essa tabela compara tarifas de tabela. Não compara tarefas concluídas. O Fable 5.1 ainda lidera várias linhas da própria xAI; a análise do Fable 5.1 é o lugar dessas trocas, não uma afirmação de que o Grok o substituiu.
A documentação do Grok 4.7 no Cursor, aberta no mesmo dia e servida em chinês em cursor.com/cn/docs/models/grok-4-7, coloca o Grok 4.7 num pool de uso com Grok 4.6, Grok 4.5 e Composer 2.5. As tarifas sob demanda mostradas coincidem com a ficha de API de contexto curto: US$ 2 de entrada, US$ 0,50 em cache, US$ 6 de saída. O Fast aparece a US$ 4 / US$ 1 / US$ 12, e a página diz que Fast é a velocidade padrão no Pro e acima. A entrada acima de 256K é cobrada a 2× no padrão e a 3× a tarifa padrão no Fast, até 500K. Uma porcentagem do Cursor e um dólar de API são medidores diferentes. Compare-os só depois de fixar esforço e Fast dos dois lados.
Benchmarks, e quanto confiar neles
Duas tabelas. A primeira é a de lançamento da xAI, com os rótulos de esforço que a página imprimiu. A segunda é a Artificial Analysis onde os rótulos coincidem, mais as pontuações de índice que não coincidem.
| Tabela de lançamento da xAI, 21 de setembro de 2026 | Grok 4.7 | Grok 4.6 | GPT-5.6 Sol | Fable 5.1 |
|---|---|---|---|---|
| Rótulo de esforço da coluna | xHigh; DeepSWE marcado high effort | High | Max | Max |
| Tarifa de tabela, entrada / saída por 1M | US$ 2 / US$ 6 | US$ 2 / US$ 6 | US$ 4 / US$ 20 | US$ 10 / US$ 50 |
| CursorBench 4.0 | 46,3% | 40,4% | 41,7% | 51,8% |
| DeepSWE v1.1 | 71,0% | 65,2% | 72,7% | 70,0% |
| EEBench | 64,0% | 53,0% | 39,4% | 56,4% |
| AA Briefcase v1.1 | 1.657 | 1.546 | 1.487 | 1.678 |
| Terminal-Bench 4.0 | 38,0% | 20,3% | 37,3% | 57,9% |
| Harvey Legal Agent Benchmark | 19,6% | 15,8% | 2,5% | 6,7% |
| HealthBench Professional | 56,7% | 48,5% | 60,5% | 62,1% |
O Grok 4.7 está à frente do Grok 4.6 em cada linha dessa tabela. Não está à frente do Fable 5.1 em CursorBench, AA Briefcase, Terminal-Bench nem HealthBench Professional. Está à frente do GPT-5.6 Sol em cinco das sete linhas de pontuação e atrás em DeepSWE e HealthBench. Tamanho da amostra, harness e intervalos de confiança não estão na página. A legenda do gráfico diz que os benchmarks são resultados direcionais do fornecedor.
O gráfico de dispersão do CursorBench na mesma página não inclui o Grok 4.6. Para o Grok 4.7 mostra uma escada de esforço íngreme: Extra High 46,3% a cerca de US$ 6,01 e 70.141 tokens de saída por tarefa; High 43,9% a US$ 4,69; Medium 41,6% a US$ 3,49; Low 33,1% a US$ 1,58. “Grok 4.7” sem rótulo de esforço não é uma pontuação só.
| Artificial Analysis, artigo de 21 de setembro de 2026 | Grok 4.7 | Grok 4.6 | Par de esforço | O que dá para dizer |
|---|---|---|---|---|
| Intelligence Index v4.3 | 46 | 44 | xhigh vs high | +2 pontos, não um resultado do mesmo degrau |
| Tokens de saída por tarefa de inteligência | ~81k | ~36k high; ~38k xhigh | misto | A fatura se move mais que o índice |
| Coding Agent Index, Grok Build | 56 | 47 | xhigh vs xhigh | +9 no agente de código do fornecedor |
| DeepSWE v1.1, Grok Build | 73% | 65% | xhigh vs xhigh | Não é o par 71,0 / 65,2 da tabela de lançamento |
| Terminal-Bench 4.0, Grok Build | 33% | 18% | xhigh vs xhigh | Não é o par 38,0 / 20,3 da xAI |
| SWE-Atlas-QnA, Grok Build | 63% | 58% | xhigh vs xhigh | Mais estreito que o salto de terminal |
| Elo do AA-Briefcase | 1.657 | 1.546 em high | xhigh vs high | Qualidade analítica sobe, apresentação desce |
| Elo do GDPval-AA | 1.695 | 1.605 em high | xhigh vs high | Ganho em trabalho de conhecimento; o Fable 5.1 fica em 1.735 no gráfico da xAI |
| Taxa de alucinação, AA-Omniscience | 29% | 34% em high | xhigh vs high | A precisão ficou em 47% contra 48% |
Leia o bloco do agente de código se o Grok Build importa. Leia o bloco de inteligência se um harness compartilhado importa. Não faça a média numa frase de “o Grok é 10% melhor”. Um comentário no Hacker News fez a pergunta óbvia: por que comparar 4.7 xhigh com 4.6 high? As respostas da thread não concordam sobre quando o xhigh chegou ao 4.6. A Artificial Analysis publica uma pontuação de agente de código do Grok 4.6 xhigh, então o rótulo existe em pelo menos uma avaliação atual. A tabela de lançamento ainda não o usa.
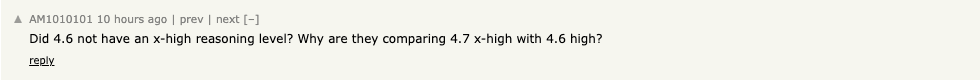
Onde o Grok 4.7 realmente se adianta
Execuções longas de código dentro de um agente
O ganho mais limpo é o de esforço alinhado. No Grok Build, o índice de agente de código subiu 9 pontos, e cada componente subiu. O trabalho de terminal se moveu mais, de 18% para 33% nesse harness. Se o seu modo de falha é uma tarefa de repositório de várias horas que trava, esta é a linha que justifica um teste. Ela não diz que o Grok Build vai vencer o Claude Code ou o Codex. A Artificial Analysis colocou o Grok 4.7 mais Grok Build em quarto entre harness nativos, atrás de Claude Fable 5.1, GPT-6 Astra e Claude Opus 5.
O salto da própria xAI no Terminal-Bench 4.0, de 20,3% para 38,0%, aponta na mesma direção e usa rótulos de esforço não alinhados. Trate-o como evidência de apoio do fornecedor, não como uma segunda medição independente do resultado de 18 para 33.
Documentos e análise, com uma ressalva de apresentação
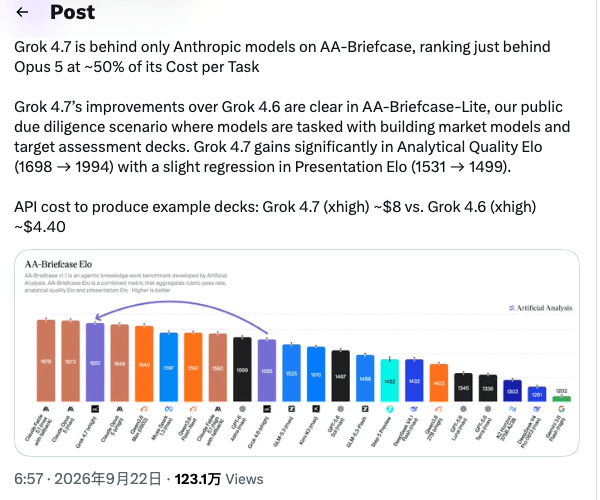
No AA-Briefcase, o Grok 4.7 marcou 1.657 Elo, 111 acima do Grok 4.6 high, logo atrás de Claude Opus 5 e Claude Fable 5.1 no texto da Artificial Analysis. A qualidade analítica foi 1.994 Elo contra 1.690. A qualidade de apresentação foi 1.499 contra 1.519. O modelo melhorou na análise e piorou um pouco na apresentação.
A Artificial Analysis descreveu a mesma divisão com mais nitidez no cenário público de due diligence do AA-Briefcase-Lite: Elo analítico de 1.698 para 1.994, Elo de apresentação de 1.531 para 1.499. As apresentações de exemplo custaram cerca de US$ 8 para o Grok 4.7 xhigh e cerca de US$ 4,40 para o Grok 4.6 xhigh. Esse par é do mesmo esforço e cerca de 1,8 vez o custo de API em troca de uma análise mais forte e uma apresentação mais fraca. É um cenário, não um benchmark universal de escritório. O GDPval-AA foi de 1.605 para 1.695 Elo no par high contra xhigh, e o gráfico GDPval da xAI coloca o Fable 5.1 max em 1.735.
Uma taxa de alucinação mais baixa, não uma precisão mais alta
A taxa de alucinação do AA-Omniscience foi de 29% para o Grok 4.7 xhigh e de 34% para o Grok 4.6 high. A precisão foi de 47% contra 48%. O índice foi de 30 para 32. Se você precisa de menos respostas erradas ditas com segurança, isso é uma mudança real. Se precisa de mais respostas corretas, esse par não mostra isso. Os rótulos de esforço ainda diferem.
Onde o Grok 4.6 continua sendo o melhor padrão
Trabalho curto, em que o pensamento extra é o produto
Pagar a mesma tarifa por cerca do dobro da saída só é uma boa troca quando essa saída evita uma nova tentativa. Para uma extração limitada, um patch curto ou um JSON de status, o rastro mais curto do Grok 4.6 é o recurso. Leitores do Hacker News olhando o gráfico de tokens de inteligência chamaram a mudança de regressão de eficiência de tokens. Esse comentário não acrescenta uma medição nova. É o mesmo gráfico da Artificial Analysis, lido como problema de custo e não como aumento de capacidade.

Nas tarefas que a Artificial Analysis apontou como regressões frente ao Grok 4.6 high, AA-LCR e AutomationBench-AA, não há motivo para sair do 4.6. Pontuações absolutas não foram publicadas, então o tamanho dessas quedas é só o delta publicado: 3,7 e 1,1 pontos.
Planos do Cursor, se Fast e esforço não estão fixos
Uma tarifa de tabela de US$ 2/US$ 6 não descreve uma porcentagem do Cursor Ultra. Os tempos do Dynamix86 são um registro de um único usuário: intervalos do Grok 4.7 de 34, 55 e 38 minutos por ponto percentual, contra 133 e 101 minutos do Grok 4.6 mais cedo no mesmo dia, os dois em extra high com Fast desligado. O autor também leu um gráfico da Artificial Analysis como US$ 8,82 contra US$ 3,53 por tarefa de agente de código. Esses valores em dólar foram a leitura do autor de um gráfico. Não foram impressos como uma frase no artigo da Artificial Analysis aberto para esta página, então ficam atribuídos ao post.
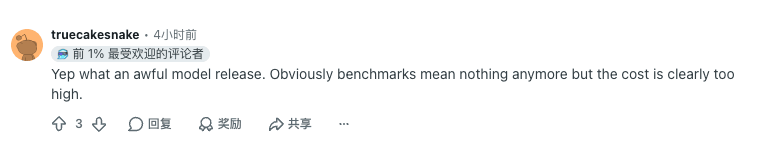
Uma resposta na mesma thread foi mais direta: o lançamento parecia fraco porque o custo estava claramente alto demais, mesmo deixando os benchmarks de lado.
A documentação do Cursor também diz que Fast é o padrão no Pro e acima, ao dobro das tarifas de token. Se um lado de um teste pessoal está em Fast e o outro não, o preço 2× é um ajuste, não uma troca de modelo. O registro do Reddit diz que Fast estava desligado. Muitas comparações casuais não vão estar.
Qualquer trabalho que você já aceita do Grok 4.6
As notas de análise (English) do Grok 4.6 já descrevem um modelo agente de 500K nesta tarifa. O Grok 4.7 não acrescenta um novo degrau de contexto na ficha de API, e não corta a tarifa de tabela. Se o 4.6 já termina o trabalho e você não está travado em terminais longos ou documentos longos, a atualização é opcional. O HealthBench Professional ainda fica atrás do GPT-5.6 Sol e do Fable 5.1 na própria tabela da xAI (56,7 contra 60,5 e 62,1), então uma troca por raciocínio clínico também não é a história.
O que as pessoas de fato disseram
Os comentários iniciais se dividem num campo do custo e num campo da sensação. Os dois têm horas de vida. Nenhum publicou um prompt, um repositório ou uma pontuação.
A fatura. A estimativa de 2,5× de uso do plano do Dynamix86 e o “o custo está claramente alto demais” do truecakesnake ficam ao lado do gráfico de tokens. Outro comentarista do Hacker News, notduckrabbit, apontou a mesma lacuna de eficiência. Juntos, eles dizem: não migre uma rota de alto volume no dia do lançamento.
A sensação. Outros comentários do r/cursor, publicados na mesma tarde, gostaram do modelo e não mencionaram preço.
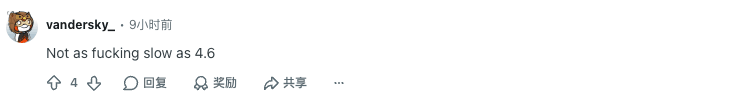
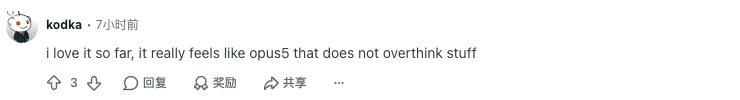
Os comentários de velocidade e de “não pensa demais” podem ser verdadeiros numa sessão de chat e falsos para um agente de código xhigh que emite 81 mil tokens. “Não tão lento quanto o 4.6” não veio com uma contagem de tokens. A Artificial Analysis mediu cerca de 188 tokens por segundo em prompts longos e cerca de 7,1 minutos de decodificação por tarefa de inteligência, sem o tempo até o primeiro token e sem a sobrecarga. Uma primeira impressão rápida e um rastro longo de agente são compatíveis.
A busca no YouTube por “Grok 4.7 vs Grok 4.6” em 22 de setembro devolveu explicações do lançamento, inclusive vídeos anteriores que adivinham contagens de parâmetros. Essas contagens não estão na página de lançamento da xAI, que só diz “um modelo base novo e maior”. Nenhum comentário de vídeo é usado aqui.
O veredito
Não há vencedor geral. Escolha pela forma do trabalho e mantenha o rótulo de esforço dentro da decisão.
| Carga | Escolha | Por quê | O que observar |
|---|---|---|---|
| Extração curta, classificação ou um patch pequeno | Grok 4.6 | O ganho do índice é pequeno e o rastro de saída é bem mais curto | Não pague xhigh por uma resposta de uma linha |
| Trabalho repetido do Cursor num pool de uso | Grok 4.6, a menos que uma tarefa esteja falhando | Um registro Ultra mostrou cerca de 2,5× de uso do plano em extra high com Fast desligado | Fixe Fast e esforço antes de culpar o modelo |
| Código de várias horas no Grok Build ou num agente parecido | Testar o Grok 4.7 xhigh | Coding Agent Index 56 contra 47 em xhigh alinhado | Compare tarefas concluídas, não só o índice |
| Modelos de mercado, memorandos e apresentações-alvo | Testar o Grok 4.7 e depois editar a apresentação | O Elo analítico subiu; o Elo de apresentação caiu; os exemplos custaram cerca de US$ 8 contra US$ 4,40 | Reserve uma passagem humana nos slides |
| Chamadas de API de contexto longo acima de 200K | Qualquer um, no preço | As duas fichas dobram as tarifas depois de 200K | O limite de 256K do Cursor é outro medidor |
| Você precisa de CursorBench ou Terminal-Bench no nível do Fable | Não este par | O Fable 5.1 Max está em 51,8% e 57,9% na tabela da xAI | Precifique essa escolha na ficha do Fable, não na do Grok |
Um teste prático é uma tarefa que você já sabe como avaliar: mesmo esforço, Fast desligado, mesmo harness. Registre se concluiu, as edições humanas, os tokens de saída e os dólares de API ou a porcentagem do plano. Um acerto não é uma taxa.
Rode a mesma tarefa no Tabbit antes de migrar uma rota
Uma linha de benchmark não diz como cada modelo se comporta nas suas abas, documentos e pesquisa pela metade. O Tabbit Browser é o espaço de trabalho dessa verificação: o modelo pode ficar ao lado das páginas que você já está lendo, em vez de um chat separado que nunca as vê. O guia do navegador agêntico e o guia de raciocínio agêntico separam uma pontuação de modelo de um fluxo de vários passos já concluído. A comparação de navegadores de IA e o guia do Tabbit Browser cobrem o produto em volta do modelo. O panorama de navegadores de IA de 2026 é o conjunto mais amplo se o Tabbit não for o cliente que você quer.
Os dois IDs do Grok estão registrados no Tabbit. Se o Grok 4.7 ou o Grok 4.6 aparece no seletor depende da conta e da lista atual. Este artigo não inclui uma transcrição do Tabbit, um registro de tokens nem um vencedor. Se os dois IDs estiverem disponíveis, rode uma tarefa que você já sabe avaliar, mantenha esforço e ferramentas iguais, e fique no Grok 4.6 se a única mudança for um rastro mais longo. O guia de práticas do Tabbit trata do fluxo no navegador, não de uma afirmação de que alguma compilação do Grok vem pré-instalada em cada conta.
A tarifa de tabela da API, um pool do Cursor e o acesso no Tabbit são três faturas diferentes. Não as some.
 Tabbit Browser

Perguntas frequentes
O Grok 4.7 é melhor que o Grok 4.6?
Depende da tarefa e do nível de esforço. No Coding Agent Index da Artificial Analysis, o Grok 4.7 xhigh com Grok Build marcou 56 contra 47 do Grok 4.6 xhigh. O Intelligence Index só foi de 44 no Grok 4.6 high para 46 no Grok 4.7 xhigh, e algumas tarefas não agênticas pioraram. Não há um vencedor único.
Grok 4.7 e Grok 4.6 custam o mesmo?
Nas fichas da xAI abertas em 22 de setembro de 2026, os dois listam US$ 2 por milhão de tokens de entrada, US$ 0,50 de entrada em cache e US$ 6 de saída abaixo de 200K de contexto, e US$ 4, US$ 1 e US$ 12 acima de 200K. O Cursor documenta um pool de uso separado e um nível Fast. A tarifa de tabela igual não significa que uma tarefa concluída custe o mesmo.
Por que o Grok 4.7 pode custar mais se o preço do token não mudou?
A Artificial Analysis mediu cerca de 81.000 tokens de saída por tarefa do Intelligence Index para o Grok 4.7 xhigh, contra cerca de 36.000 do Grok 4.6 high e cerca de 38.000 do Grok 4.6 xhigh. A US$ 6 por milhão de tokens de saída, só essa saída fica em cerca de US$ 0,49 contra US$ 0,22 ou US$ 0,23, antes de entrada, cache, ferramentas ou novas tentativas.
Quais ganhos de benchmark do Grok 4.7 estão no mesmo nível de esforço?
A comparação do Coding Agent Index é xhigh contra xhigh: 56 contra 47, com DeepSWE 73% contra 65%, Terminal-Bench 4.0 33% contra 18% e SWE-Atlas-QnA 63% contra 58% dentro do Grok Build. A tabela de lançamento da xAI compara Grok 4.7 xHigh com Grok 4.6 High, e o DeepSWE nessa tabela marca high effort para o Grok 4.7. Não trate essas linhas como um teste do mesmo degrau.
Devo trocar o Grok 4.6 pelo Grok 4.7 no Cursor?
Teste uma tarefa longa de código ou de documentos se aceitar uma queda maior do plano. Um usuário do Cursor Ultra, em extra high e com Fast desligado, estimou cerca de 2,5 vezes o uso do plano e pretendia devolver a maior parte do trabalho ao 4.6. Outros comentários iniciais disseram que o 4.7 parecia mais rápido ou menos propenso a pensar demais. Fixe o esforço e o Fast antes de comparar.
Posso comparar Grok 4.7 e Grok 4.6 no Tabbit Browser?
Os dois modelos têm páginas no Tabbit. Se aparecem no seletor depende da conta e da lista ao vivo. Este artigo não inclui uma execução da mesma tarefa no Tabbit, então uma entrada no seletor não prova que um modelo vença um fluxo de trabalho.