
タスクが長く、ツールが多く、長いトークン請求を払う価値があるとき、試すモデルはGrok 4.7です。日常の短い作業はGrok 4.6のままにしてください。APIの表示単価は変わっていません。
xAIは2026年9月21日にGrok 4.7を公開し、Grok 4.6と同じ価格と速度で提供すると書きました。9月22日に開いた2枚のモデルカードは、料金と500Kコンテキストでは一致しています。終わったタスクの費用まで同じだとは示していません。Artificial AnalysisはGrok 4.7をxhighで評価し、Intelligence Indexの1タスクあたり出力約81,000トークン、Grok 4.6のhighでは約36,000トークンと数えました。切り替えるかどうかを決めるのはこの数字です。(xAIの発表、Grok 4.7のモデルカード、Grok 4.6のモデルカード、Artificial Analysis)
同じ緊張はCursorですぐに出ました。9月21日、u/Dynamix86は、1つのUltraアカウント、extra high、Fastオフで、名前のない同一タスクについて、Grok 4.7がGrok 4.6の約2.5倍の速さでプラン割合を消費し、大半の作業は4.6へ戻すと書きました。
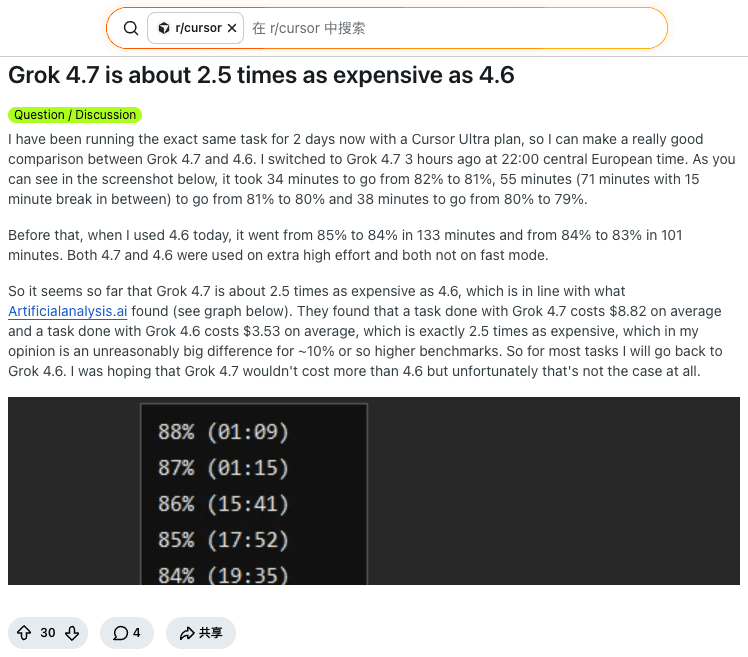
これは1アカウント、1タスクです。APIの請求書も回答品質も証明しません。「同じ価格」が最初の問いとして外れている理由にはなります。Grok 4.6の概要は前のモデル自体の話です。このページは二者の選び方だけを扱います。仕様はGrok 4.7のモデルページ (English)とGrok 4.6のモデルページ (English)にもあります。
要点
2枚のAPIカードは、20万コンテキスト未満で100万トークンあたり2ドル / キャッシュ0.50ドル / 出力6ドル、20万超で4ドル / 1ドル / 12ドルです。500Kの窓は一致します。
Grok 4.7 xhighは知能タスクあたり出力約8.1万トークン、Grok 4.6 highは約3.6万、Grok 4.6 xhighは約3.8万です。出力6ドルだけの計算では約0.49ドル対0.22–0.23ドルです。
Intelligence Indexの動きは+2で、xhigh対highです(46対44)。Coding Agent Indexの動きはGrok Build内の揃ったxhighで+9です(56対47)。
xAIの発表表は掲載行のすべてで上ですが、列はGrok 4.7 xHighとGrok 4.6 Highです。その表のDeepSWEは4.7をhigh effortと記しています。差は同じ段の実験ではありません。
短く繰り返す作業はGrok 4.6のままです。長いコーディングや文書中心のタスクが4.6で十分に失敗し、追加トークンを払う価値があるときだけGrok 4.7を試します。
この記事のために、同一タスクのTabbit実行は完了していません。モデルページは測定された勝ちではありません。
この比較を決める数字:同じ2ドル/6ドルで、出力は約8.1万対3.6万トークン
発表の見出しは、Grok 4.7が「比較対象モデルの2倍速く、半額」だと書き、本文はGrok 4.6と同じ価格と速度で提供すると書きます。前の文は比較対象も速度の単位も名指ししません。料金カードが支えるのは後の文です。
変わったのは、新しいモデルが使うトークン数です。Artificial Analysisは、Grok 4.7 xhighがIntelligence Indexの1タスクあたり出力約81kトークン、Grok 4.6 highが36kで、125%多いと書きました。同じ記事の後段では、81kはGrok 4.6 xhighの38kの2倍超だとも書きます。両方残します。36kは同じ強度の組ではありません。38kの方が同じ強度です。
Intelligence Index 1タスクあたりの出力トークン(Artificial Analysis、2026-09-21)
Grok 4.7 xhigh     約81k
Grok 4.6 high      約36k     (トークン+125%、強度ラベルは高い)
Grok 4.6 xhigh     約38k     (同じ強度ラベルでトークンは2倍超)

共通の出力6ドル / 100万での出力分だけ
81k × $6 / 1M  ≈  $0.49
36k × $6 / 1M  ≈  $0.22
38k × $6 / 1M  ≈  $0.23
この計算は請求書ではありません。入力トークン、キャッシュヒット、ツール呼び出し、再試行、APIではなくプラン割合で課金するクライアントを無視しています。そのトークンが買ったスコアも無視しています。
Intelligence IndexはGrok 4.6 highの44からGrok 4.7 xhighの46へ動きました。エージェント型の知識作業の外では、Artificial AnalysisはGrok 4.7がGrok 4.6 highとおおむね揃い、Terminal-Bench 4.0が4.5ポイント、GDP.pdfが3.0ポイント上がり、AA-LCRが3.7ポイント、AutomationBench-AAが1.1ポイント下がったと書きました。この4行の絶対点は本文に印刷されていません。
より大きい動きはコーディングエージェント指数で、こちらは同じ強度です。Grok 4.7 xhighとGrok Buildは56、Grok 4.6 xhighとGrok Buildは47です。そのハーネス内でDeepSWE v1.1は65%から73%、Terminal-Bench 4.0は18%から33%、SWE-Atlas-QnAは58%から63%です。これらの端末数値はxAI発表表の38.0%と20.3%ではなく、統一ハーネスの+4.5ポイントでもありません。ハーネスと強度が違えば、3つのTerminal-Benchは同時に成立し得ます。
追加トークンが、やり直すはずだった長い実行を買うならGrok 4.7です。強度ラベルをまたいだ指数+2が、およそ2倍の出力に見合わないならGrok 4.6のままです。
仕様と価格の一覧
2026年9月22日に2枚のモデルカードで確認しました。カード上の「より高いコンテキスト」は、リクエストが20万トークンを超える意味です。Cursorの文書は256Kの境界を使い、この表には入りません。
| 項目 | Grok 4.7 | Grok 4.6 | 行の使い方 |
|---|---|---|---|
| APIモデルID | grok-4.7 | grok-4.6 | IDを固定する。比較にlatest別名は使わない。 |
| コンテキスト窓 | 500,000 | 500,000 | クライアントはより短く出せる。CursorのGrok 4.7ページは標準256K、長コンテキスト500Kと書く。 |
| モダリティ | テキストと画像を入力、テキストを出力 | テキストと画像を入力、テキストを出力 | 画像サイズ制限は共有ドキュメント側で、IDを選ぶ理由ではない。 |
| 入力 / キャッシュ / 出力、20万以下 | 100万あたり $2 / $0.50 / $6 | 100万あたり $2 / $0.50 / $6 | 表示単価は同じ。 |
| 入力 / キャッシュ / 出力、20万超 | 100万あたり $4 / $1 / $12 | 100万あたり $4 / $1 / $12 | 長コンテキストの倍率も一致する。 |
| 知識カットオフ | モデル索引に May 2026 | この日開いたカードには再掲なし | 古い記事の日付を引き継がない。 |
| Fast | 発表文:出力速度2倍、価格2倍の高速版。ベンチマーク行はない | この日開いたカードには記載なし | 2つのFastスイッチを同じ製品と思わない。 |
xAIの発表表も、両Grok列に入力2ドル、出力6ドルを印刷し、横にGPT-5.6 Solの4ドル / 20ドル、Fable 5.1の10ドル / 50ドルを置きます。それは表示価格の比較です。終わったタスクの比較ではありません。Fable 5.1はxAI自身の複数行でまだ先行します。そのトレードオフはFable 5.1のレビューの話で、Grokが置き換えたという主張ではありません。
同じ日に開いたCursorのGrok 4.7文書は、中国語の cursor.com/cn/docs/models/grok-4-7 へ飛びました。ページはGrok 4.7を、Grok 4.6、Grok 4.5、Composer 2.5と共有する利用枠に入れます。オンデマンド料金は短いコンテキストのAPIカードと一致し、入力2ドル、キャッシュ0.50ドル、出力6ドルです。Fastは4ドル / 1ドル / 12ドルで、Pro以上ではFastが既定速度だとページは書きます。256Kを超える入力は、標準が2倍、Fastは標準料金の3倍で、上限500Kです。CursorのパーセントとAPIのドルは別のメーターです。両方で強度とFastを固定してから比べます。
ベンチマークと、どこまで信じるか
表は2つです。1つ目はxAIの発表表で、ページが実際に印刷した強度ラベル付きです。2つ目はArtificial Analysisで、強度が揃うものと、揃わない指数です。
| xAI発表表、2026年9月21日 | Grok 4.7 | Grok 4.6 | GPT-5.6 Sol | Fable 5.1 |
|---|---|---|---|---|
| 列の強度ラベル | xHigh。DeepSWEはhigh effort | High | Max | Max |
| 表示価格、100万あたり入力 / 出力 | $2 / $6 | $2 / $6 | $4 / $20 | $10 / $50 |
| CursorBench 4.0 | 46.3% | 40.4% | 41.7% | 51.8% |
| DeepSWE v1.1 | 71.0% | 65.2% | 72.7% | 70.0% |
| EEBench | 64.0% | 53.0% | 39.4% | 56.4% |
| AA Briefcase v1.1 | 1,657 | 1,546 | 1,487 | 1,678 |
| Terminal-Bench 4.0 | 38.0% | 20.3% | 37.3% | 57.9% |
| Harvey Legal Agent Benchmark | 19.6% | 15.8% | 2.5% | 6.7% |
| HealthBench Professional | 56.7% | 48.5% | 60.5% | 62.1% |
その表では、Grok 4.7がすべての行でGrok 4.6の上です。CursorBench、AA Briefcase、Terminal-Bench、HealthBench ProfessionalではFable 5.1の上ではありません。GPT-5.6 Solに対しては7つのスコア行のうち5つで上、DeepSWEとHealthBenchでは下です。サンプル数、ハーネス、信頼区間はページにありません。図の注釈は、ベンチマークを方向性のあるベンダー結果だと書いています。
同じページのCursorBench散布図にGrok 4.6はありません。Grok 4.7は急な強度の階段です。Extra Highは46.3%、1タスク約6.01ドル、出力70,141トークン。Highは43.9%、4.69ドル。Mediumは41.6%、3.49ドル。Lowは33.1%、1.58ドルです。強度ラベルのない「Grok 4.7」は1つのスコアではありません。
| Artificial Analysis、記事日付2026年9月21日 | Grok 4.7 | Grok 4.6 | 強度の組 | 言ってよいこと |
|---|---|---|---|---|
| Intelligence Index v4.3 | 46 | 44 | xhigh対high | +2点。同じ段の結果ではない |
| 知能タスクあたり出力トークン | 約81k | high約36k、xhigh約38k | 混合 | 請求の動きは指数より大きい |
| Coding Agent Index、Grok Build | 56 | 47 | xhigh対xhigh | ベンダーのコーディングエージェントで+9 |
| DeepSWE v1.1、Grok Build | 73% | 65% | xhigh対xhigh | 発表表の71.0 / 65.2ではない |
| Terminal-Bench 4.0、Grok Build | 33% | 18% | xhigh対xhigh | xAIの38.0 / 20.3ではない |
| SWE-Atlas-QnA、Grok Build | 63% | 58% | xhigh対xhigh | 端末の跳ねより小さい |
| AA-Briefcase Elo | 1,657 | highで1,546 | xhigh対high | 分析品質は上がり、発表品質は下がる |
| GDPval-AA Elo | 1,695 | highで1,605 | xhigh対high | 知識作業は向上。xAIの図ではFable 5.1が1,735 |
| 幻覚率、AA-Omniscience | 29% | highで34% | xhigh対high | 正答率は47%対48%のまま |
Grok Buildを見るならコーディングエージェントの塊を読みます。共通ハーネスを見るなら知能指数の塊を読みます。「Grokは10%良い」に平均しないでください。Hacker Newsでは、なぜ4.7 xhighを4.6 highと比べるのか、という問いが出ました。そのスレッドの返信は、4.6にxhighがいつ来たかで一致しません。Artificial AnalysisはGrok 4.6 xhighのコーディングエージェント点数を出しているので、少なくとも1つの現行評価にそのラベルはあります。発表表はまだそれを使いません。
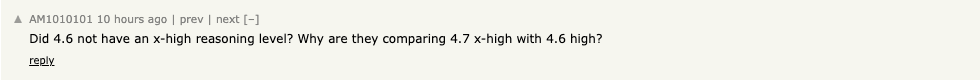
Grok 4.7が実際に離す場所
コーディングエージェントの中の長い実行
いちばんきれいな向上は、強度が揃ったものです。Grok Buildではコーディングエージェント指数が9点上がり、各要素も上がりました。端末作業の動きが最大で、そのハーネスでは18%から33%です。失敗の形が、何時間もかかるリポジトリ作業の途中停止なら、この行がパイロットの理由になります。Grok BuildがClaude CodeやCodexに勝つとは書いていません。Artificial Analysisは、Grok 4.7とGrok Buildをネイティブハーネスの4位とし、上位はClaude Fable 5.1、GPT-6 Astra、Claude Opus 5です。
xAI自身のTerminal-Bench 4.0の20.3%から38.0%も同じ方向ですが、強度ラベルは揃っていません。18から33の独立した二度目の測定ではなく、ベンダー側の補強証拠として扱います。
文書と分析。発表品質は別に見る
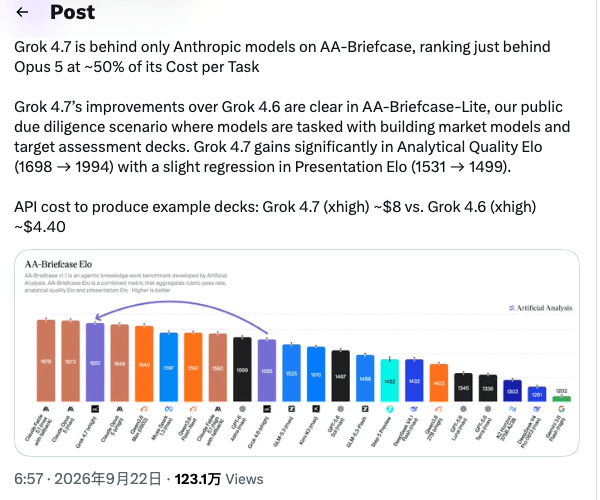
AA-BriefcaseでGrok 4.7は1,657 Elo、Grok 4.6 highより111上で、Artificial Analysisの記述ではClaude Opus 5とClaude Fable 5.1の直後です。分析品質は1,994 Elo対1,690。発表品質は1,499対1,519です。分析は良くなり、デッキは少し悪くなりました。
公開のAA-Briefcase-Liteのデューデリジェンス場面では、この分裂がよりはっきりします。分析Eloは1,698から1,994、発表Eloは1,531から1,499です。例のデッキのAPI費用は、Grok 4.7 xhighが約8ドル、Grok 4.6 xhighが約4.40ドルです。同じ強度で、API費用は約1.8倍、分析は強く、発表は弱い、という組です。1つの場面であり、オフィス作業全体のベンチマークではありません。GDPval-AAはhigh対xhighで1,605から1,695 Eloへ動き、xAIのGDPval図はFable 5.1 maxを1,735に置きます。
幻覚率は下がり、正答率は上がっていない
AA-Omniscienceの幻覚率はGrok 4.7 xhighが29%、Grok 4.6 highが34%です。正答率は47%対48%です。指数は30から32へ動きました。自信のある誤答を減らしたいなら、これは実在する変化です。正答を増やしたいなら、この組はそれを示しません。強度ラベルはまだ違います。
Grok 4.6を既定のままにする場所
短い作業。余分な思考そのものが費用になる
同じ単価で約2倍の出力を買う交換は、その出力が再試行を防ぐときだけ得です。範囲の決まった抽出、短いパッチ、状態のJSONでは、Grok 4.6の短い軌跡が機能です。知能トークンの図を見たHacker Newsの読者は、これをトークン効率の後退と呼びました。そのコメントは新しい測定を足しません。同じArtificial Analysisの図を、能力向上ではなく費用の問題として読んだものです。

Artificial AnalysisがGrok 4.6 highに対する後退として名指ししたAA-LCRとAutomationBench-AAでは、4.6を離れる理由がありません。絶対点は未公表なので、下落幅は公表された差分だけです。3.7ポイントと1.1ポイントです。
Cursorのプラン。Fastと強度を固定していないとき
2ドル/6ドルの表示単価は、Cursor Ultraのパーセントを説明しません。Dynamix86の時間は単一利用者のログです。Grok 4.7は1パーセントポイントあたり34分、55分、38分。同じ日の早い時間のGrok 4.6は133分と101分。どちらもextra highでFastオフです。著者はArtificial Analysisの図を、コーディングエージェント1タスクあたり8.82ドル対3.53ドルとも読みました。そのドル額は著者の図の読みです。このページのために開いたArtificial Analysisの記事本文にはその文がないので、投稿に帰属したままにします。
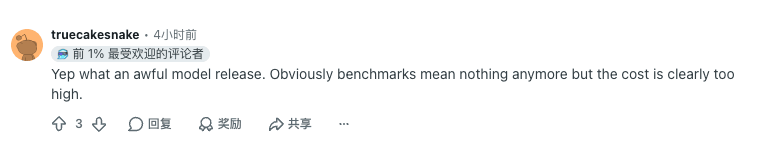
同じスレッドの返信はもっと直接でした。ベンチマークを脇に置いても、費用が明らかに高すぎるので、このリリースは良く見えない、という内容です。
Cursorの文書も、Pro以上ではFastが既定で、トークン料金は2倍だと書きます。個人テストの片側だけがFastなら、2倍の価格は設定であり、モデル変更ではありません。RedditのログはFastオフと書いています。気軽な比較の多くはそうしません。
すでにGrok 4.6で受け入れている作業
Grok 4.6のレビューノート (English)は、この単価の500Kエージェントモデルをすでに説明しています。Grok 4.7はAPIカードに新しいコンテキスト段を足さず、表示価格も下げていません。4.6がすでに仕事を終え、長い端末作業や長い文書で止まっていないなら、更新は任意です。HealthBench ProfessionalはxAI自身の表でGPT-5.6 SolとFable 5.1の後です(56.7対60.5と62.1)。臨床推論のための切り替えも、この話ではありません。
人が実際に言ったこと
初期コメントは費用派と感触派に分かれます。どちらも数時間の話です。どちらもプロンプト、リポジトリ、スコアを公開していません。
請求。 Dynamix86の約2.5倍のプラン使用量と、truecakesnakeの「費用が明らかに高すぎる」は、トークン図の隣に置きます。別のHacker Newsコメント、notduckrabbitは同じ効率差を指しました。まとめると、公開当日に高流量のルートを移さない、ということです。
感触。 同じ午後の別のr/cursorコメントはモデルを好み、価格には触れていません。
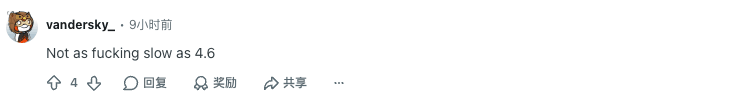
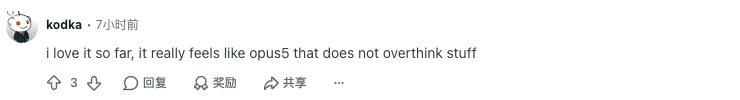
「速い」「考えすぎない」はチャットでは正しく、81kトークンを出すxhighのコーディングエージェントでは同時に誤りになり得ます。「4.6ほど遅くない」にはトークン数が付いていません。Artificial Analysisは長いプロンプトで毎秒約188トークン、知能タスクあたりデコード約7.1分と測りました。最初のトークンまでの時間とオーバーヘッドは除きます。速い第一印象と長いエージェント軌跡は両立します。
2026年9月22日にYouTubeで「Grok 4.7 vs Grok 4.6」を検索すると、発表解説が出て、パラメータ数を推測する公開前の動画も含みました。xAIの発表ページは「新しく、より大きいベースモデル」とだけ書き、パラメータ数はありません。動画の発言は使いません。
どう選ぶか
総合優勝はありません。作業の形で選び、決定の中に強度ラベルを残します。
| 作業 | 選ぶもの | 理由 | 見るもの |
|---|---|---|---|
| 短い抽出、分類、小さいパッチ | Grok 4.6 | 指数の向上は小さく、出力軌跡はずっと短い | 一行の答えにxhighを払わない |
| 利用枠の上の繰り返しCursor作業 | 失敗していなければGrok 4.6 | Ultraの1ログがextra high、Fastオフでプラン使用量約2.5倍 | モデルを責める前にFastと強度を固定する |
| Grok Buildや類似エージェントの数時間コーディング | Grok 4.7 xhighを試す | 揃ったxhighでCoding Agent Index 56対47 | 指数だけでなく、終わったタスクを比べる |
| 市場モデル、メモ、対象デッキ | Grok 4.7を試し、その後デッキを直す | 分析Eloは上がり、発表Eloは下がり、例は約8ドル対4.40ドル | スライドに人の確認を1回入れる |
| 20万超の長コンテキストAPI | 価格ではどちらでも同じ | 両カードとも20万超で料金が2倍 | Cursorの256K境界は別のメーター |
| Fable級のCursorBenchやTerminal-Benchが必要 | この対ではない | xAIの表でFable 5.1 Maxは51.8%と57.9% | その選択はGrokではなくFableの料金カードで見る |
実用テストは、採点方法が分かっている1タスクです。同じ強度、Fastオフ、同じハーネス。完了したか、人の修正、出力トークン、APIのドルまたはプラン割合を記録します。1回の成功は成功率ではありません。
ルートを移す前に、同じタスクをTabbitで走らせる
ベンチマークの1行は、自分のタブ、文書、途中の調査でモデルがどう振る舞うかを教えません。Tabbit Browserはその確認の作業場です。モデルは、読んでいるページの横に置けます。ページを見ない別チャットに置く必要はありません。エージェントブラウザのガイドとエージェント推論のガイドは、モデル点数と、終わった複数ステップの流れを分けます。AIブラウザ比較とTabbitブラウザのガイドは、モデルの外側の製品です。Tabbitが欲しいクライアントでないなら、2026年のAIブラウザまとめがより広い集合です。
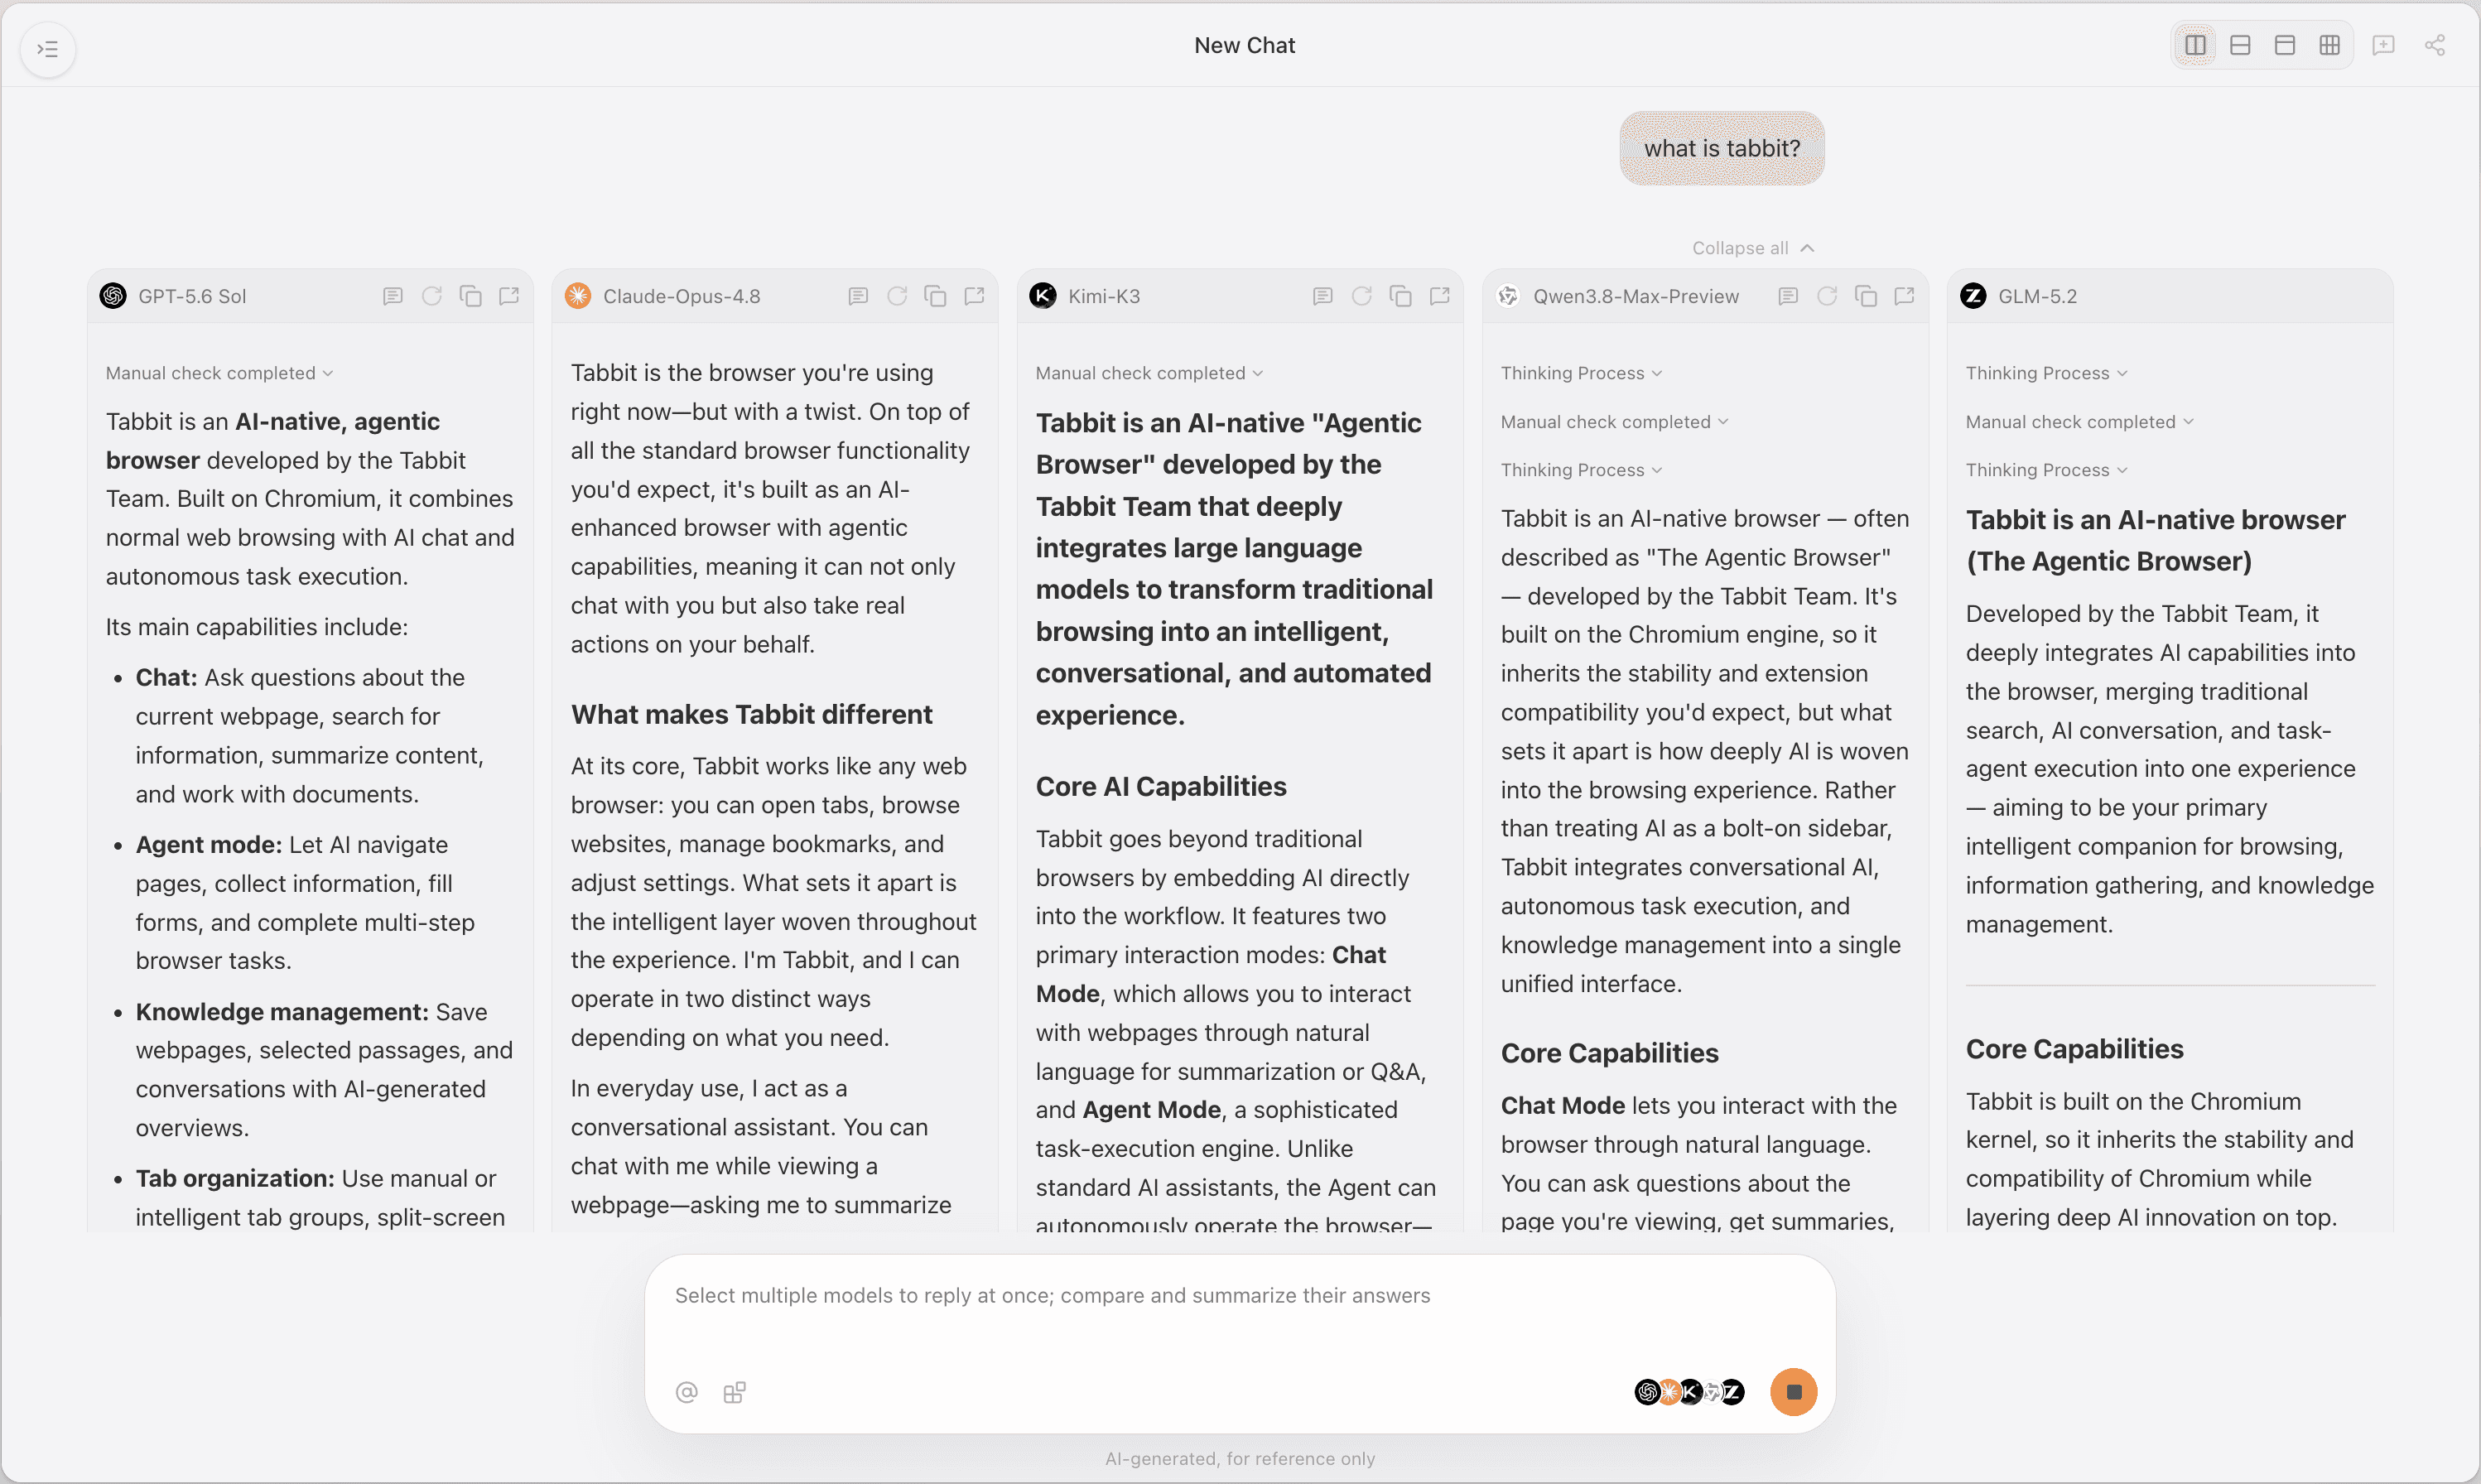
両方のGrok IDはTabbitに登録されています。セレクタにGrok 4.7やGrok 4.6が出るかは、アカウントと現在の一覧によります。この記事にTabbitの記録、トークンログ、勝者はありません。両方のIDがあるなら、採点方法が分かっている1タスクを、強度とツールを揃えて走らせ、変化が軌跡の長さだけならGrok 4.6を残します。Tabbitの実践ガイドはブラウザでの働き方であり、すべてのアカウントに特定のGrokがあらかじめ入っているという主張ではありません。
APIの表示価格、Cursorの利用枠、Tabbitの利用可否は、3つの別の請求です。足し合わせないでください。
 Tabbit Browser

よくある質問
Grok 4.7はGrok 4.6より優れていますか?
タスクと推論強度によります。Artificial AnalysisのCoding Agent Indexでは、Grok 4.7 xhighとGrok Buildが56、Grok 4.6 xhighが47です。Intelligence IndexはGrok 4.6 highの44からGrok 4.7 xhighの46への動きで、エージェント以外の一部タスクは後退しています。総合優勝はありません。
Grok 4.7とGrok 4.6の価格は同じですか?
2026年9月22日に開いたxAIのモデルカードでは、どちらも20万コンテキスト以下で入力100万トークン2ドル、キャッシュ入力0.50ドル、出力6ドル、20万超で4ドル、1ドル、12ドルです。Cursorは別の利用枠とFastを記載しています。表示単価が同じでも、終わったタスクの費用が同じとは限りません。
トークン単価が変わらないのに、なぜGrok 4.7の方が高くなり得ますか?
Artificial Analysisは、Intelligence Indexの1タスクあたり出力トークンをGrok 4.7 xhighで約81,000、Grok 4.6 highで約36,000、Grok 4.6 xhighで約38,000と測りました。出力100万トークン6ドルなら、出力だけでも約0.49ドル対0.22ドルまたは0.23ドルです。入力、キャッシュ、ツール、再試行は含みません。
どのGrok 4.7のベンチマーク向上が同じ推論強度ですか?
Coding Agent Indexはxhigh対xhighで56対47です。Grok Build内のDeepSWEは73%対65%、Terminal-Bench 4.0は33%対18%、SWE-Atlas-QnAは63%対58%です。xAIの発表表はGrok 4.7 xHigh対Grok 4.6 Highで、その表のDeepSWEは4.7をhigh effortと記しています。それらの行を同じ段の実験として扱わないでください。
CursorでGrok 4.6からGrok 4.7へ切り替えるべきですか?
長いコーディングや文書なら、利用枠の減りが速くなることを受け入れられる場合に試します。Cursor Ultraの利用者がextra high、Fastオフで、プラン使用量が約2.5倍と見積もり、大半の作業を4.6へ戻すと書きました。4.7の方が速い、考えすぎない、という初期感想もあります。比べる前に強度とFastを固定してください。
Tabbit BrowserでGrok 4.7とGrok 4.6を比べられますか?
どちらもTabbitのモデルページがあります。セレクタに出るかはアカウントと現在の一覧によります。この記事に同一タスクのTabbit実行は含まれないので、名前があること自体は、あるワークフローで勝った証拠ではありません。