
日常编码和知识工作优先试 Gemini 4 Argon;当任务格外困难、周期长,并能从深入推理与反复验证中受益时,再考虑 Gemini 4 Carbon。这是 Google 自己给出的产品定位。Artificial Analysis Index v5.0.1 中,Carbon High 得分 60,Argon High 得分 50;同一组数据里,Carbon 单任务成本也更高($5.48 对 $4.97),耗时更长(32.1 对 29.3 分钟)。这些是基准集的汇总结果,不保证适用于你的工作。核心数字是 High 档的 10 分差距:在这套评测里,Carbon 的额外推理带来更高分数,也消耗更多时间与费用。
要点
Google 将 Argon 定位为大多数软件工程和知识工作的选择;Carbon 面向挑战模型极限的任务,使用更多思考 Token。
Artificial Analysis Index v5.0.1 High:Carbon 60、Argon 50。每项任务成本分别 $5.48、$4.97;平均用时分别 32.1、29.3 分钟。
独立数据汇总特定基准,不代表每种任务质量相同。两者模型卡都列出 100 万输入与输出合并上下文。
Google 宣布两者 API 优惠期价格相同,但总任务成本会随 Token 用量变化;按具体产品核对价格与权限。
Reddit 用户对命名和额度体验有困惑,但帖子不能证明能力或当前接入规则。
Argon 与 Carbon 速览
| 决策项 | Gemini 4 Argon | Gemini 4 Carbon | 选择含义 |
|---|---|---|---|
| Google 的定位 | 大多数编码与知识工作 | 高难、长周期编码、调试和开放式研究 | 除非任务需要更深推理,否则先试 Argon |
| Artificial Analysis Index v5.0.1,High | 50 | 60 | Carbon 在该综合指数高 10 分 |
| 每项指数任务成本(High) | $4.97 | $5.48 | 该基准中 Carbon 成本更高,尽管输出单价相同 |
| 每项指数任务平均时间(High) | 29.3 分钟 | 32.1 分钟 | 该基准中 Carbon 用时更长 |
| API 优惠价 | 11 月 30 日前输入 $2/M、输出 $10/M | Google 公布相同优惠价 | 跨越价格日期或更换 API 界面时要复核 |
| 上下文窗口 | 输入与输出合计 100 万 | 输入与输出合计 100 万 | 不是输入 100 万再加输出 100 万 |
来源:Google Carbon 发布说明与 Artificial Analysis 发布对比,核对日期 2026-11-16。Artificial Analysis 会更新评测;页面注明 Index v5.0.1,且模型推理设置不同。将成本或时间用于采购预算前,应先阅读其方法说明。
按工作负载选择
| 任务形态 | 优先试 | 原因 | 扩大使用前核对 |
|---|---|---|---|
| 常规代码修改、代码库问答或业务分析 | Argon | Google 称其适用于大多数编码和知识工作 | 用代表性任务检查正确性并记录用量 |
| 牵涉多个组件的难题调试 | Carbon | Google 将其定位为复杂调试与持续验证 | 更多思考 Token 会增加成本和延迟 |
| 开放式研究或高难科学推理 | 试 Carbon | 产品面向深入探索假设 | 检查引用和中间假设 |
| 延迟或 API 预算严格的任务 | Argon 或更轻量的模型 | 该基准中 Carbon High 更慢、单任务更贵 | 确认价格、推理档和当前权限 |
基准不是一张全局赢家榜。当前 Artificial Analysis Index v5.0.1 显示 Carbon High 为 60,Argon High 为 50,但 Carbon 的平均任务时间和成本也更高。该指数综合九项测试,并使用模型专属配置。另一组 Medium 数据显示 Carbon 58 分、$4.68/任务,Argon 48 分、$4.31/任务。不要把 High 与 Medium 当成同一设置,也不要把单任务成本当成 API 费率。
模型卡提供了另一条边界:Carbon 基于 Argon,但 Google 表示它会使用更多思考 Token 和更长的验证循环。这种关系不代表 Carbon 在所有任务上都更好。Carbon 模型卡也提到偶发缓慢、超时,以及高推理档位更高的 Token 用量。两份模型卡都列出最高 100 万 Token 的合并上下文,但 API 或产品界面仍可能有自己的规则。
用户反馈能说明什么
在 r/GeminiAI 的产品线讨论中,JeffConvertorBot 认为 Argon 与 Carbon 的命名区别“说不通”;另一位用户也说模型档位不清晰。这条讨论反映了命名困惑,但不能说明模型架构。Google 官方文档给出了更明确的说法:Carbon 基于 Argon,面向更长、更难的任务。
另一条帖子中,一位用户说 Argon 在 Antigravity 编码时有效,但在 Gemini App 会消耗不少 Token。还有用户公开了跨多个编码工具的三任务逆向工程结果,并明确指出不同模型使用了不同工具,因此不是受控对比。这些帖子适合确定要测什么:任务收尾、额度和界面;它们不能替代官方权限说明或一致的基准协议。
结论:按任务难度分流,再实测
普通编码和知识工作先试 Argon。任务周期长、调试复杂或开放式推理确有价值且能承担额外时间与 Token 时,再用 Carbon。如果任务常规、短或预算严格,公开证据没有证明 Carbon 的成本溢价总是值得。正式采用前,使用相同输入、工具、推理档、套餐和成功标准测两者。
若你还需要 Carbon 浏览器工作流,可参阅 Gemini 4 Carbon 浏览器指南;Gemini CLI 研究流程见 browser MCP 指南。
在产品线讨论中,JeffConvertorBot 写道:“Argon vs carbon does not make sense.” 这反映了命名困惑;Carbon 基于 Argon 的关系应以 Google 当前模型卡为准,而不是评论者的猜测。
延伸阅读
Reddit 原帖截图
以下为浏览器打开的原始讨论截图。帖子反映个人体验,不代表产品承诺。
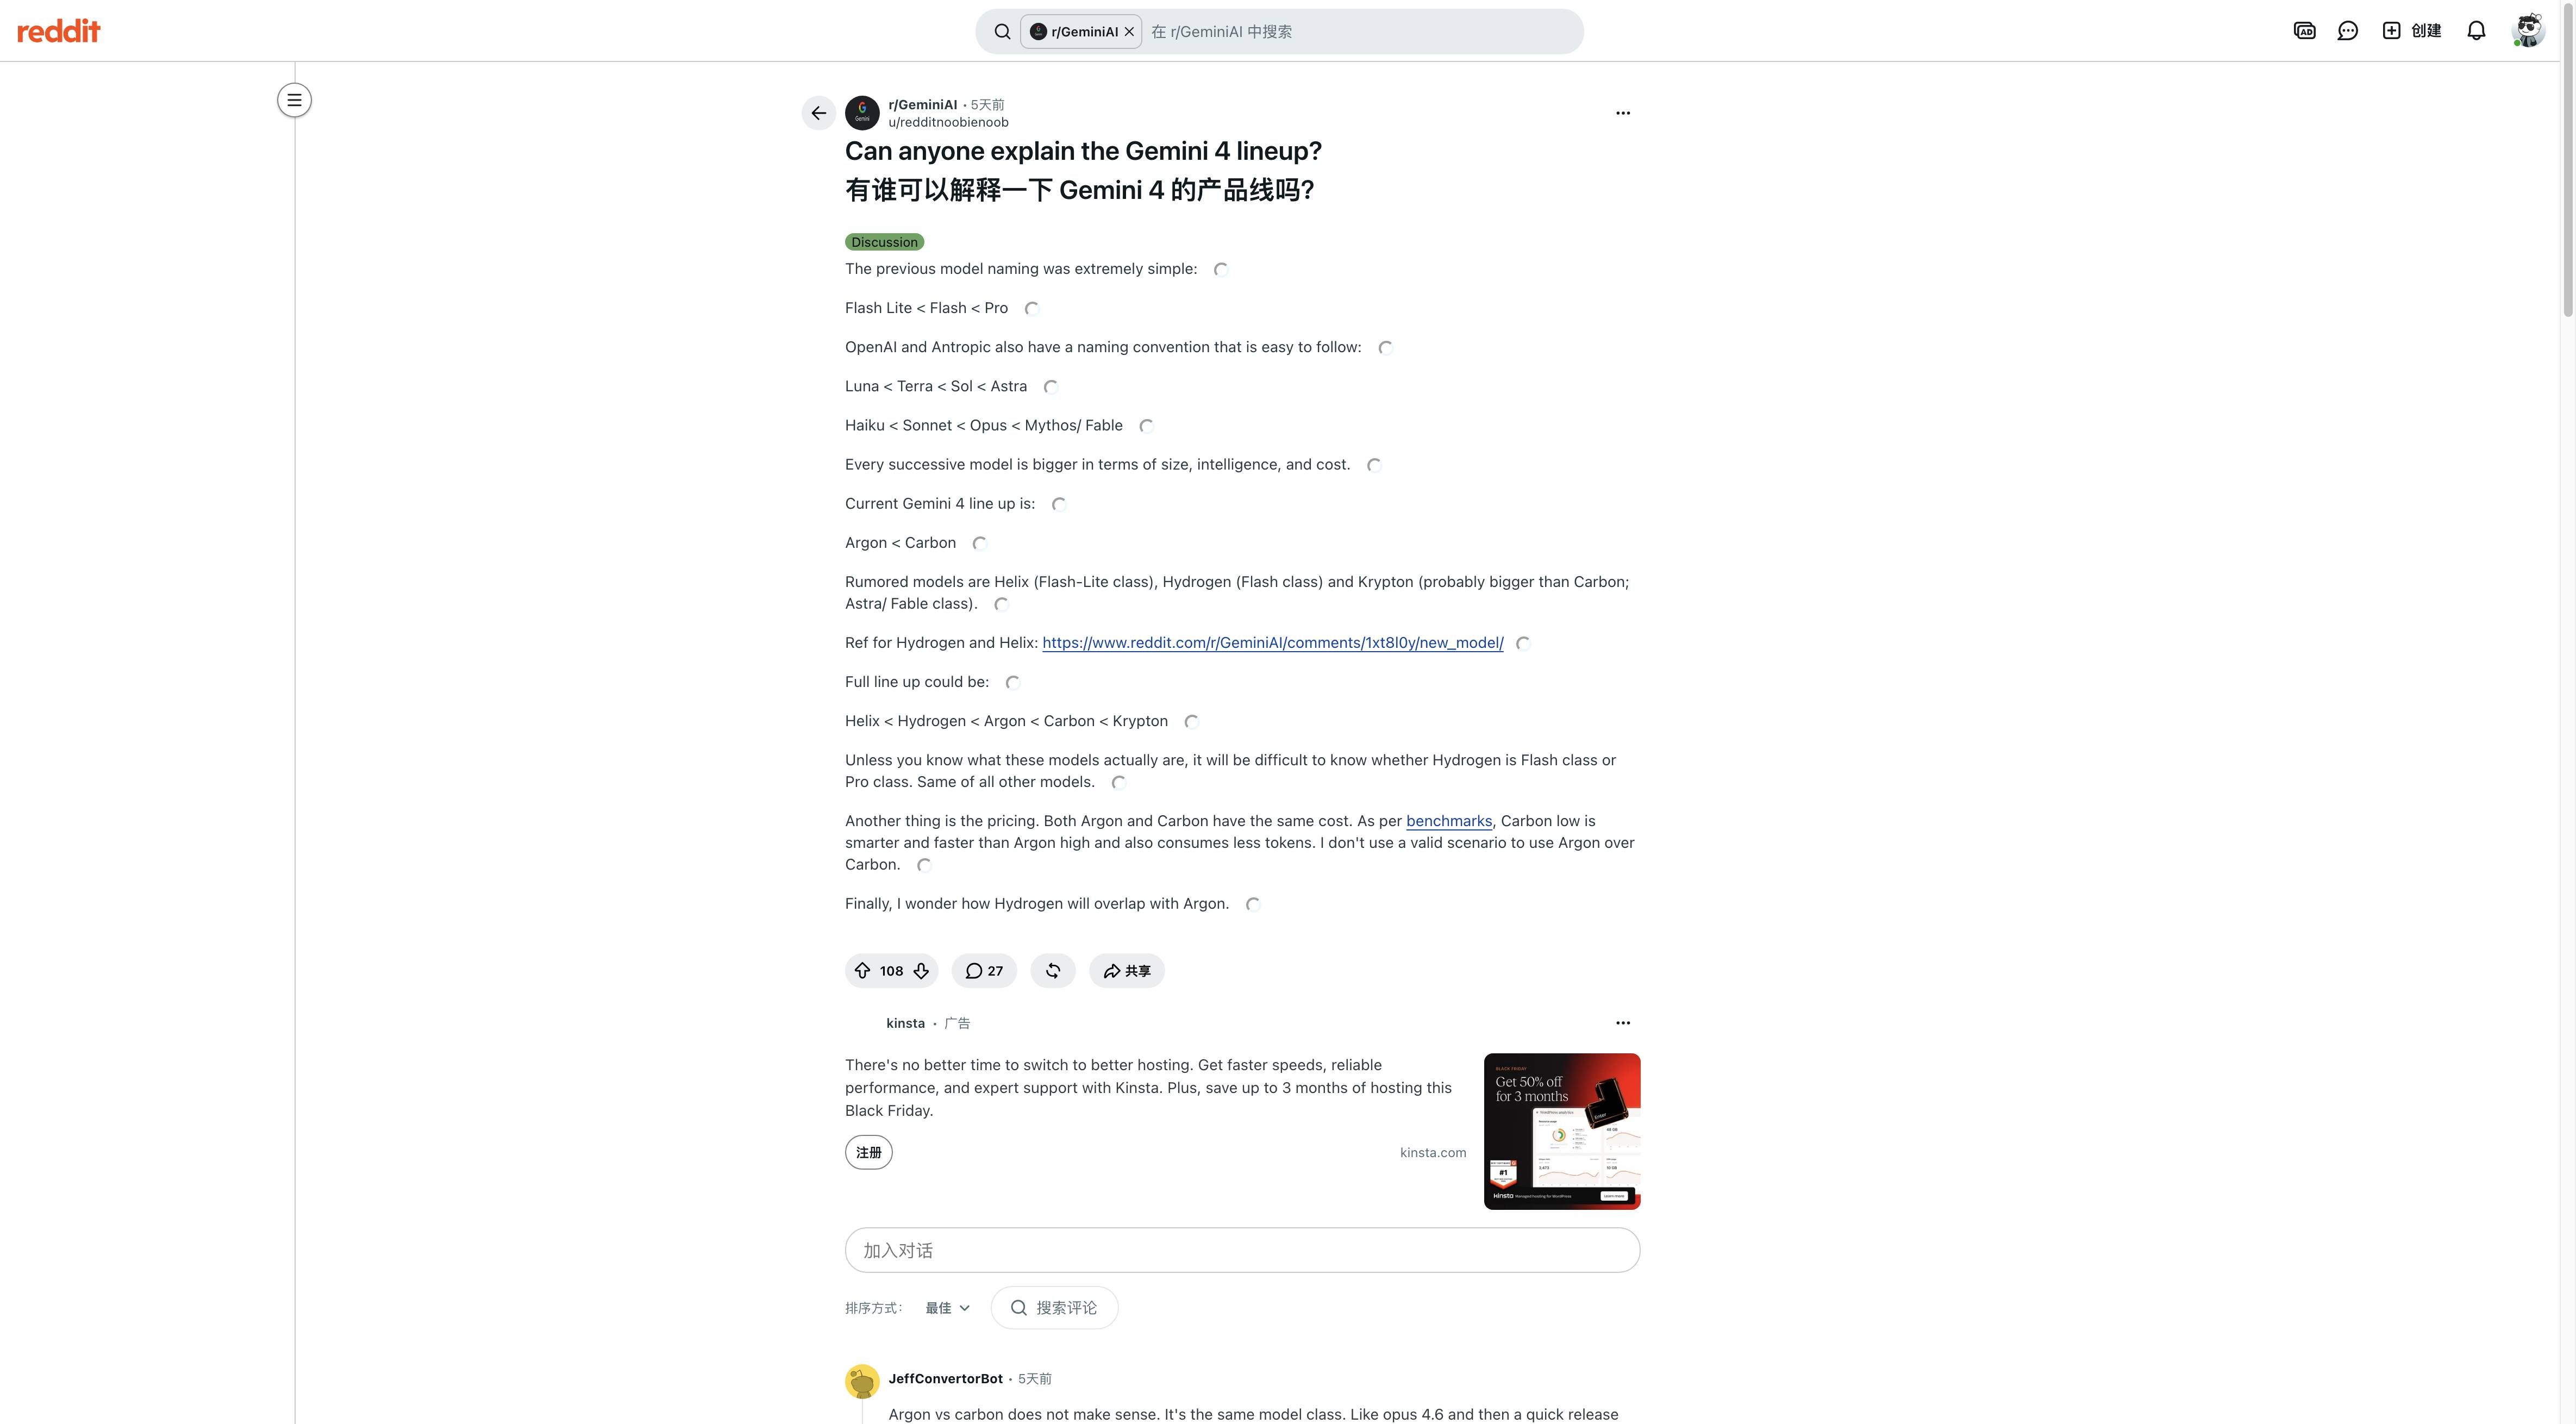
Gemini 产品线讨论中,用户询问 Argon 与 Carbon 名称代表什么。 Reddit 原帖
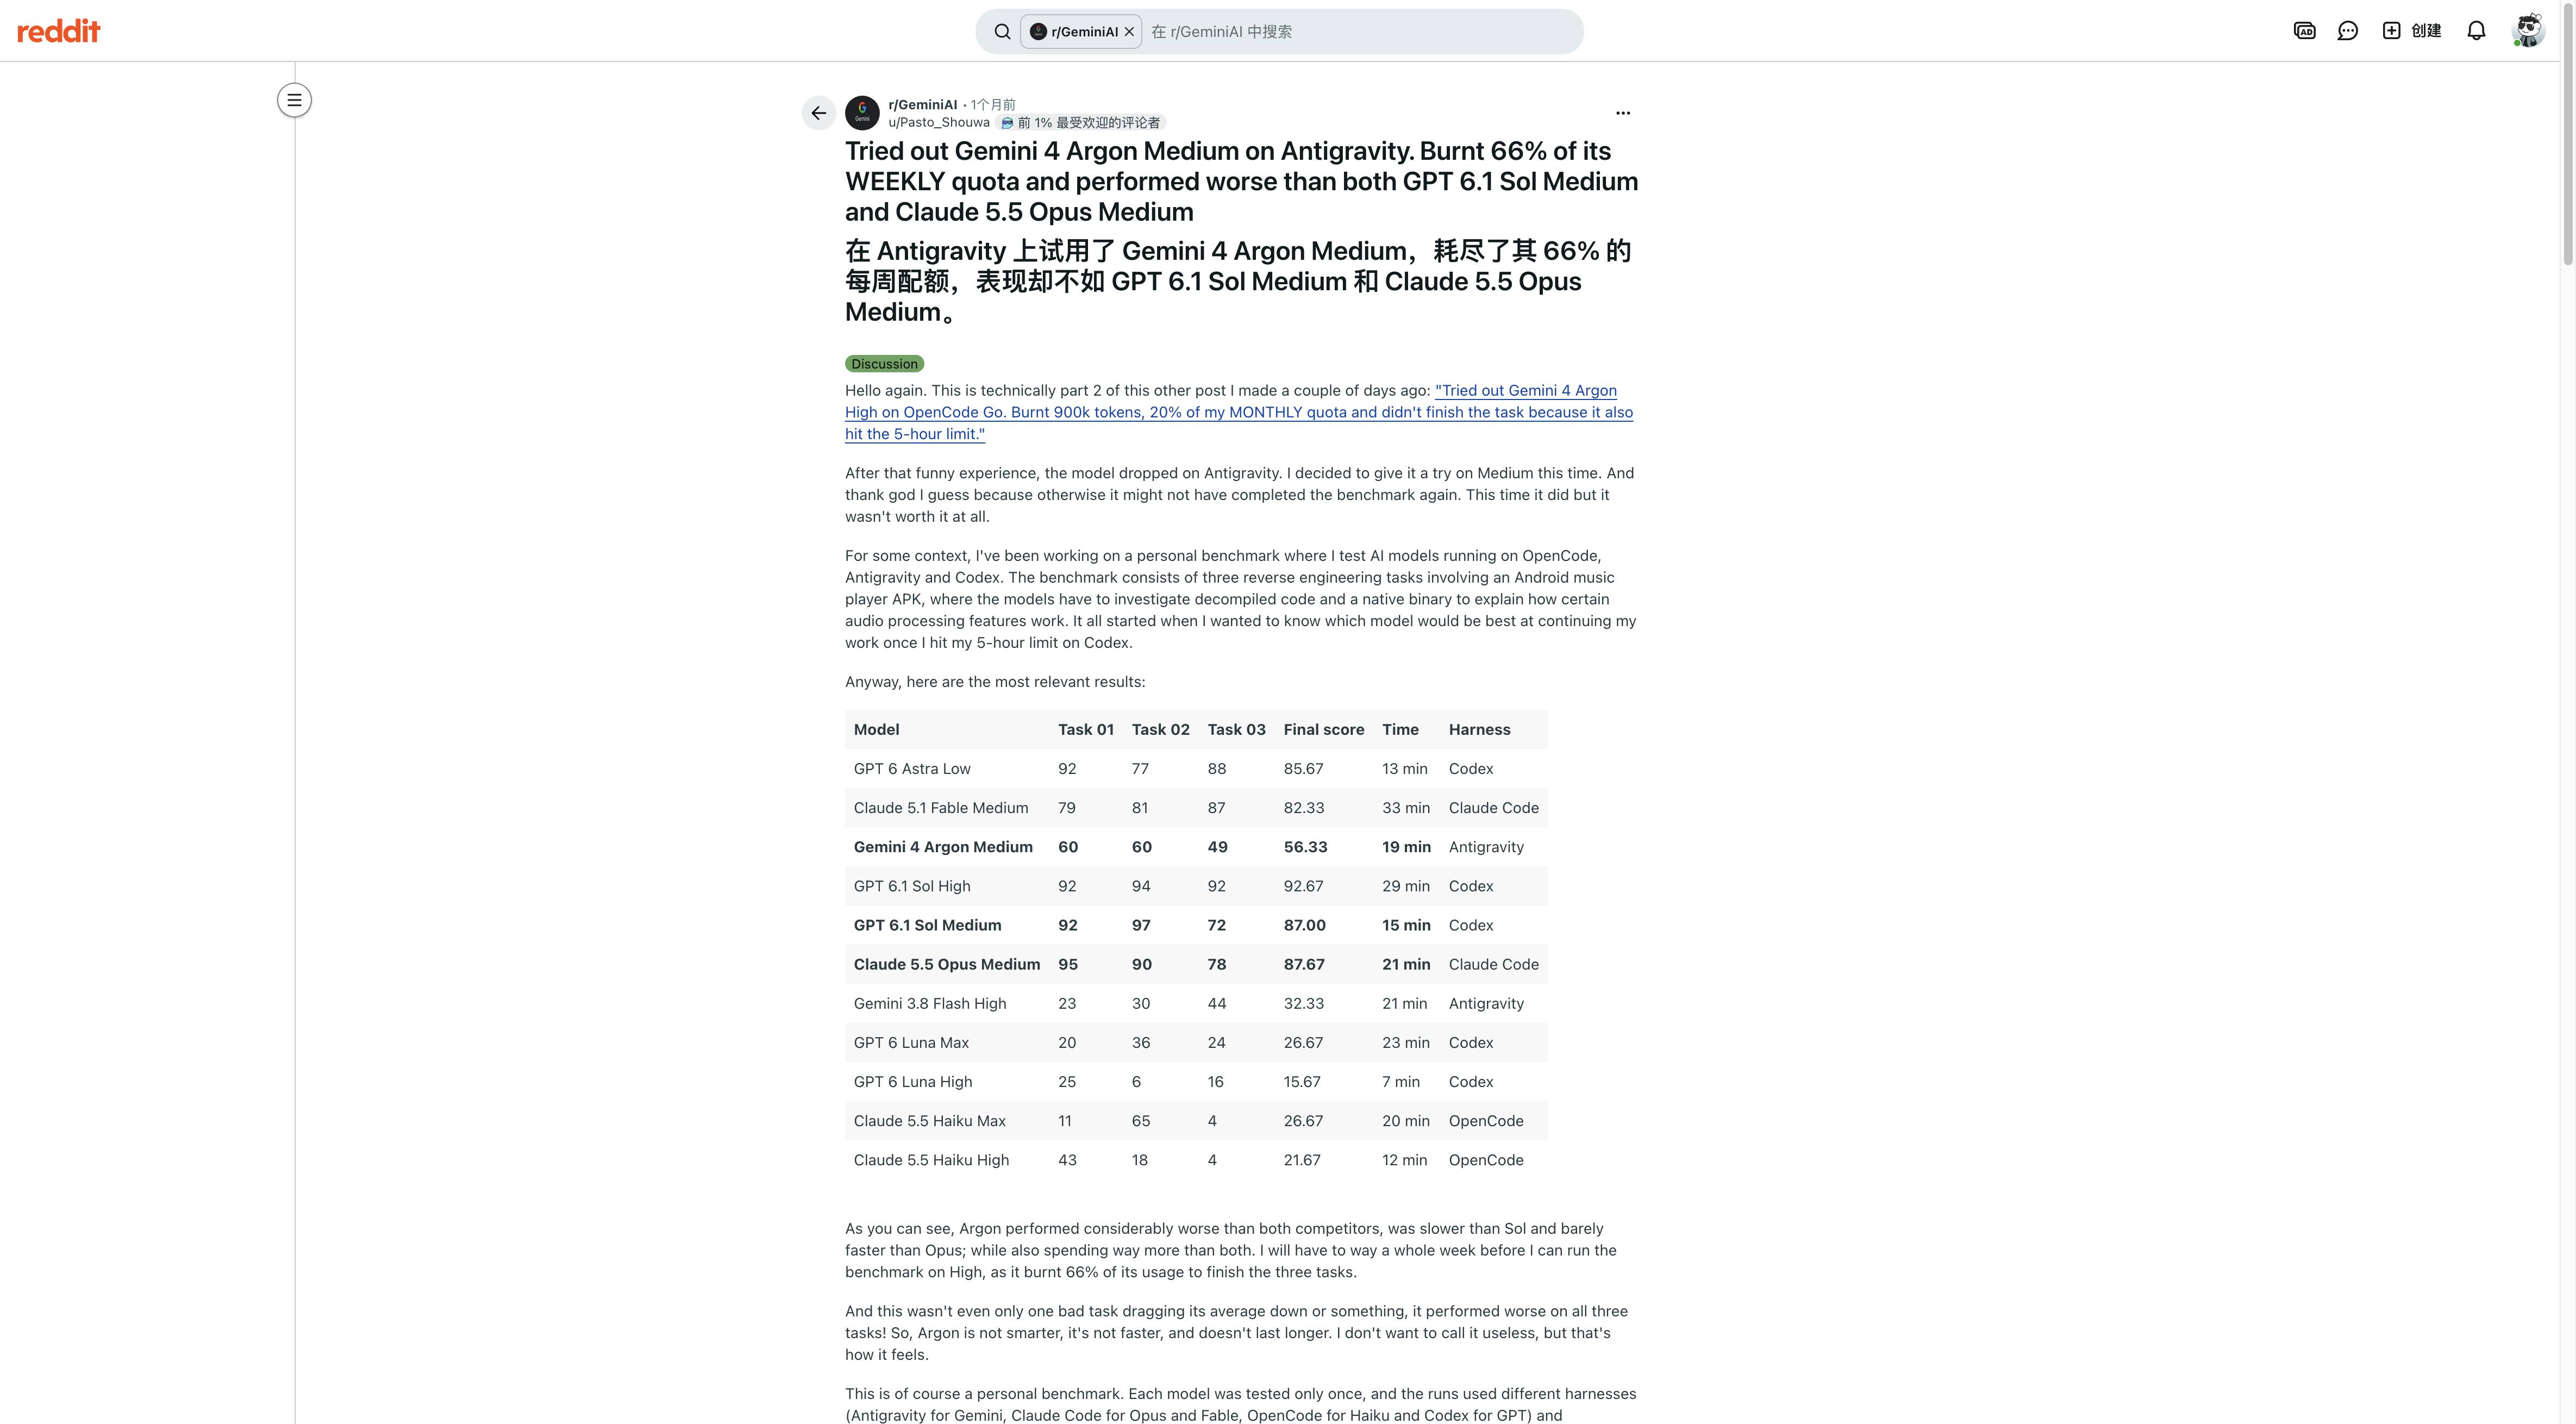
Pasto_Shouwa 分享三项个人基准任务,并说明各模型使用了不同工具链。 Reddit 原帖
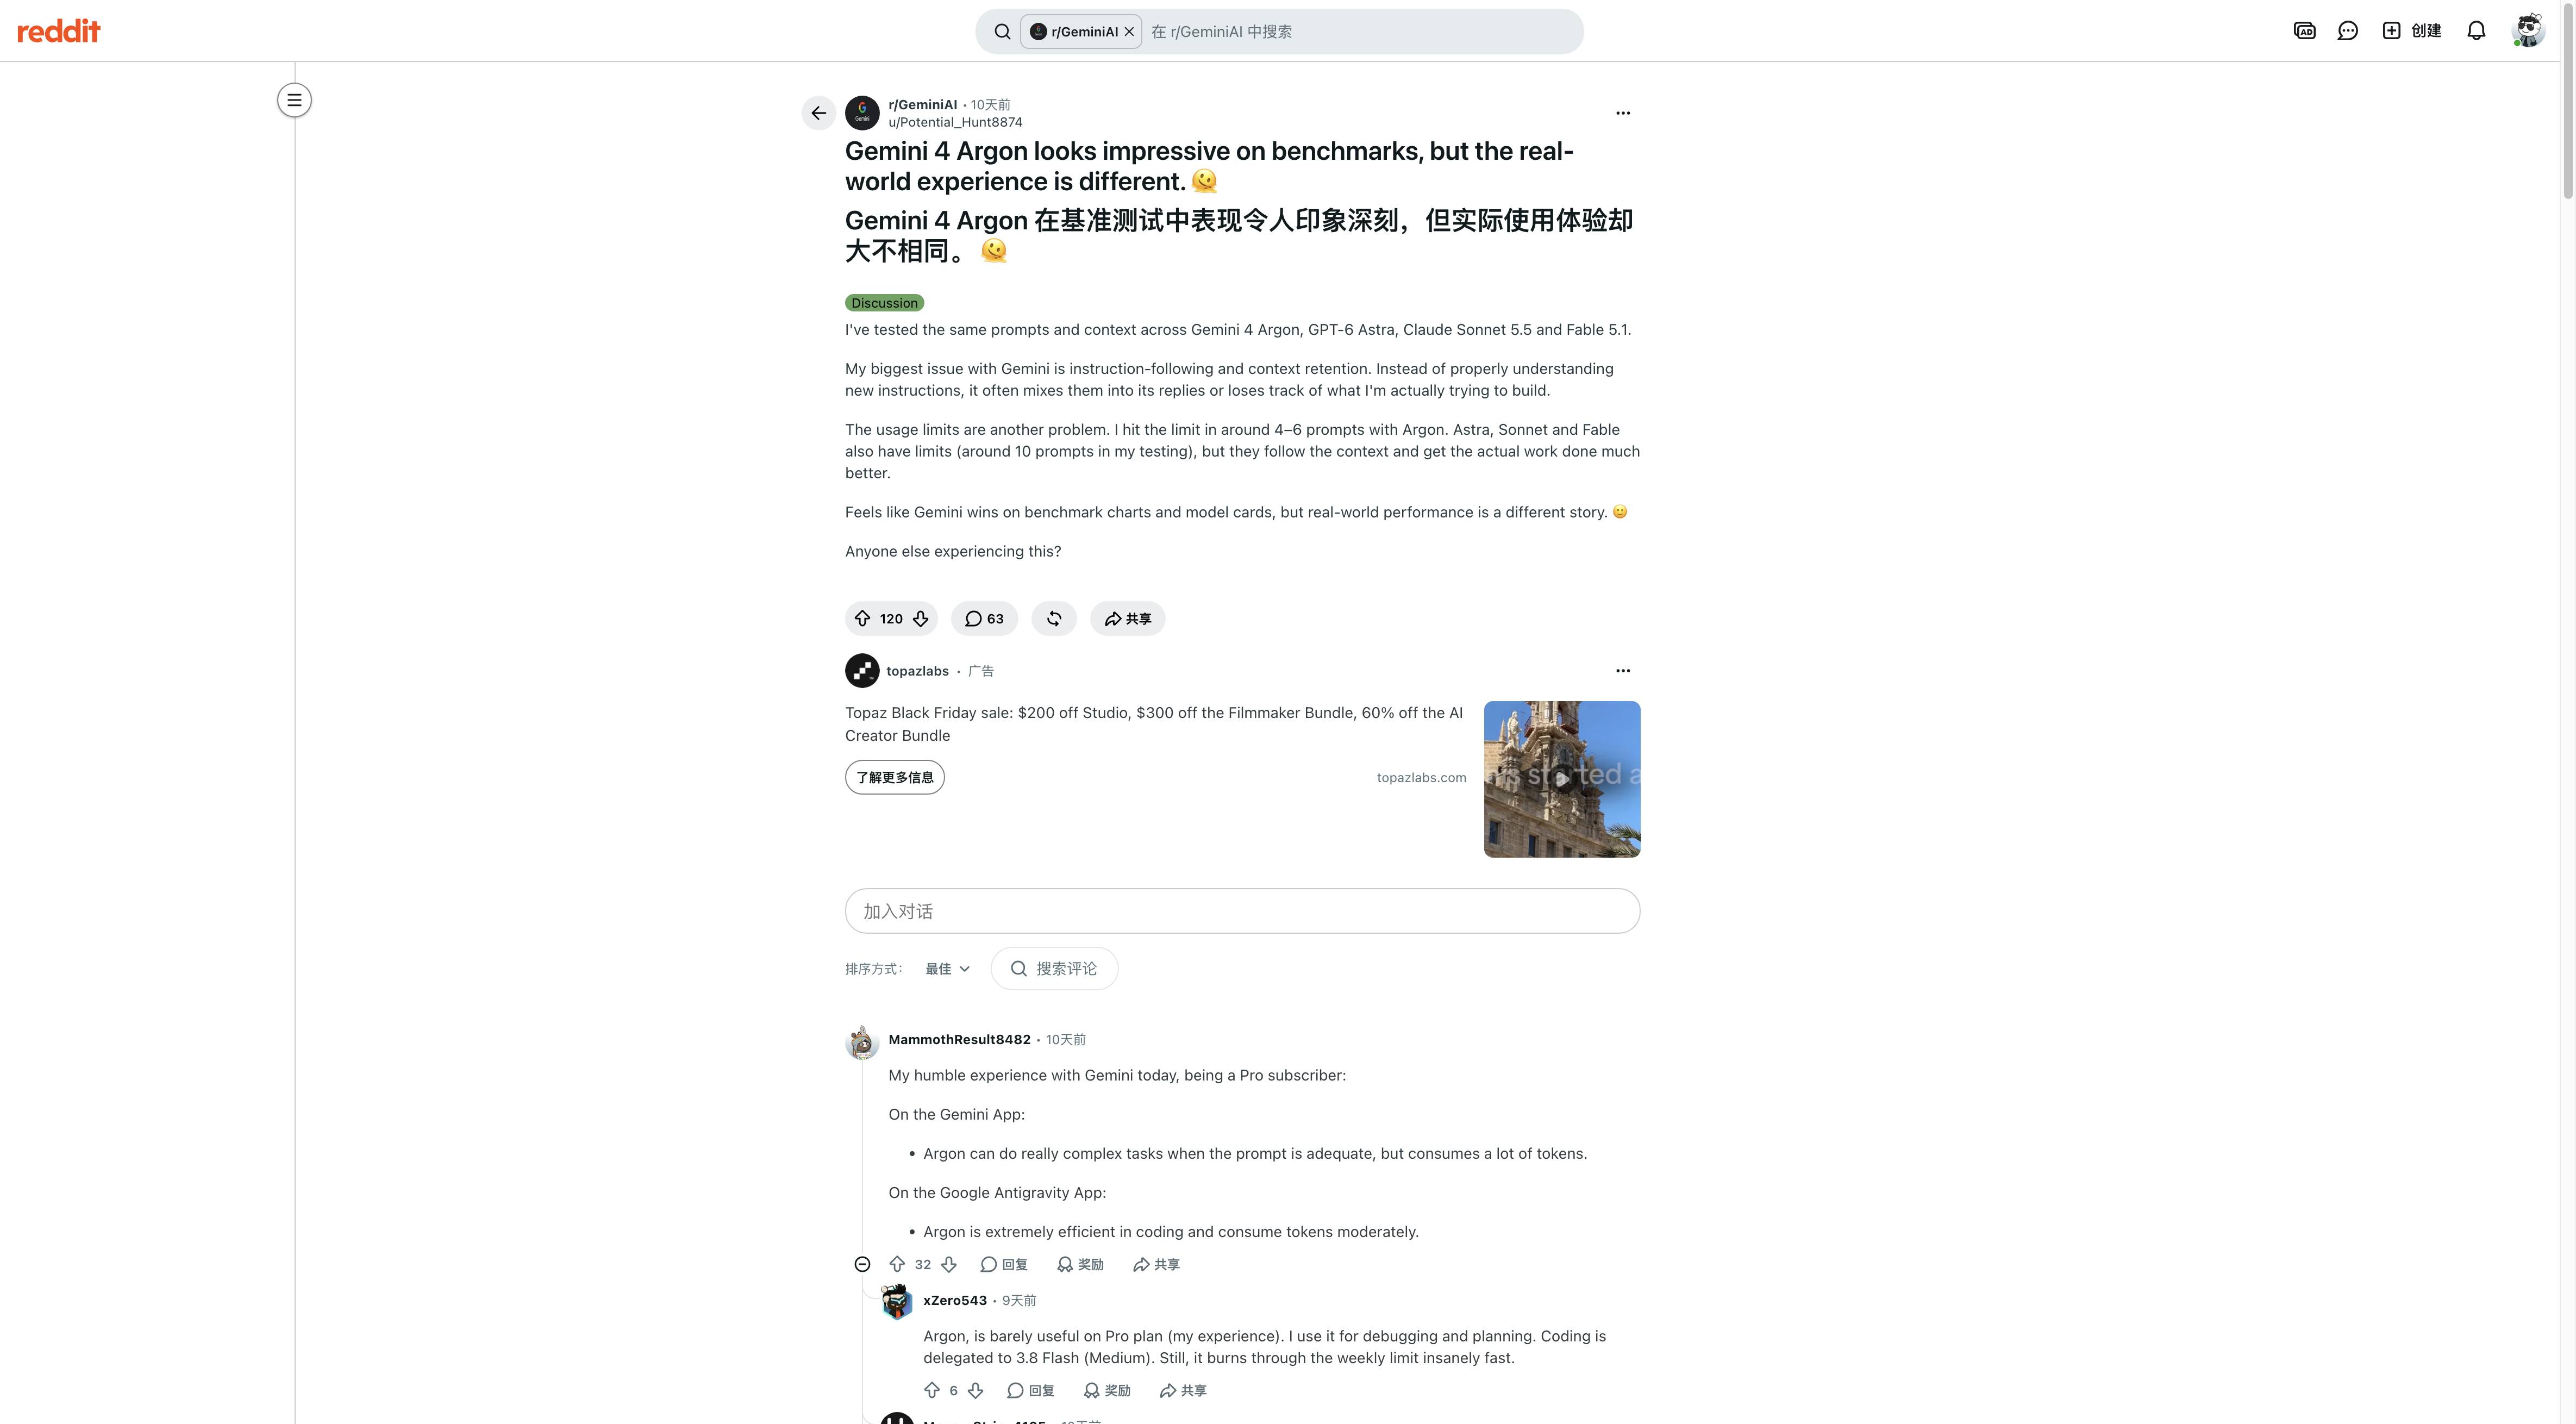
MammothResult8482 对比 Gemini App 与 Antigravity 的用量体验;采集时页面显示约 10 天前发布。 Reddit 原帖
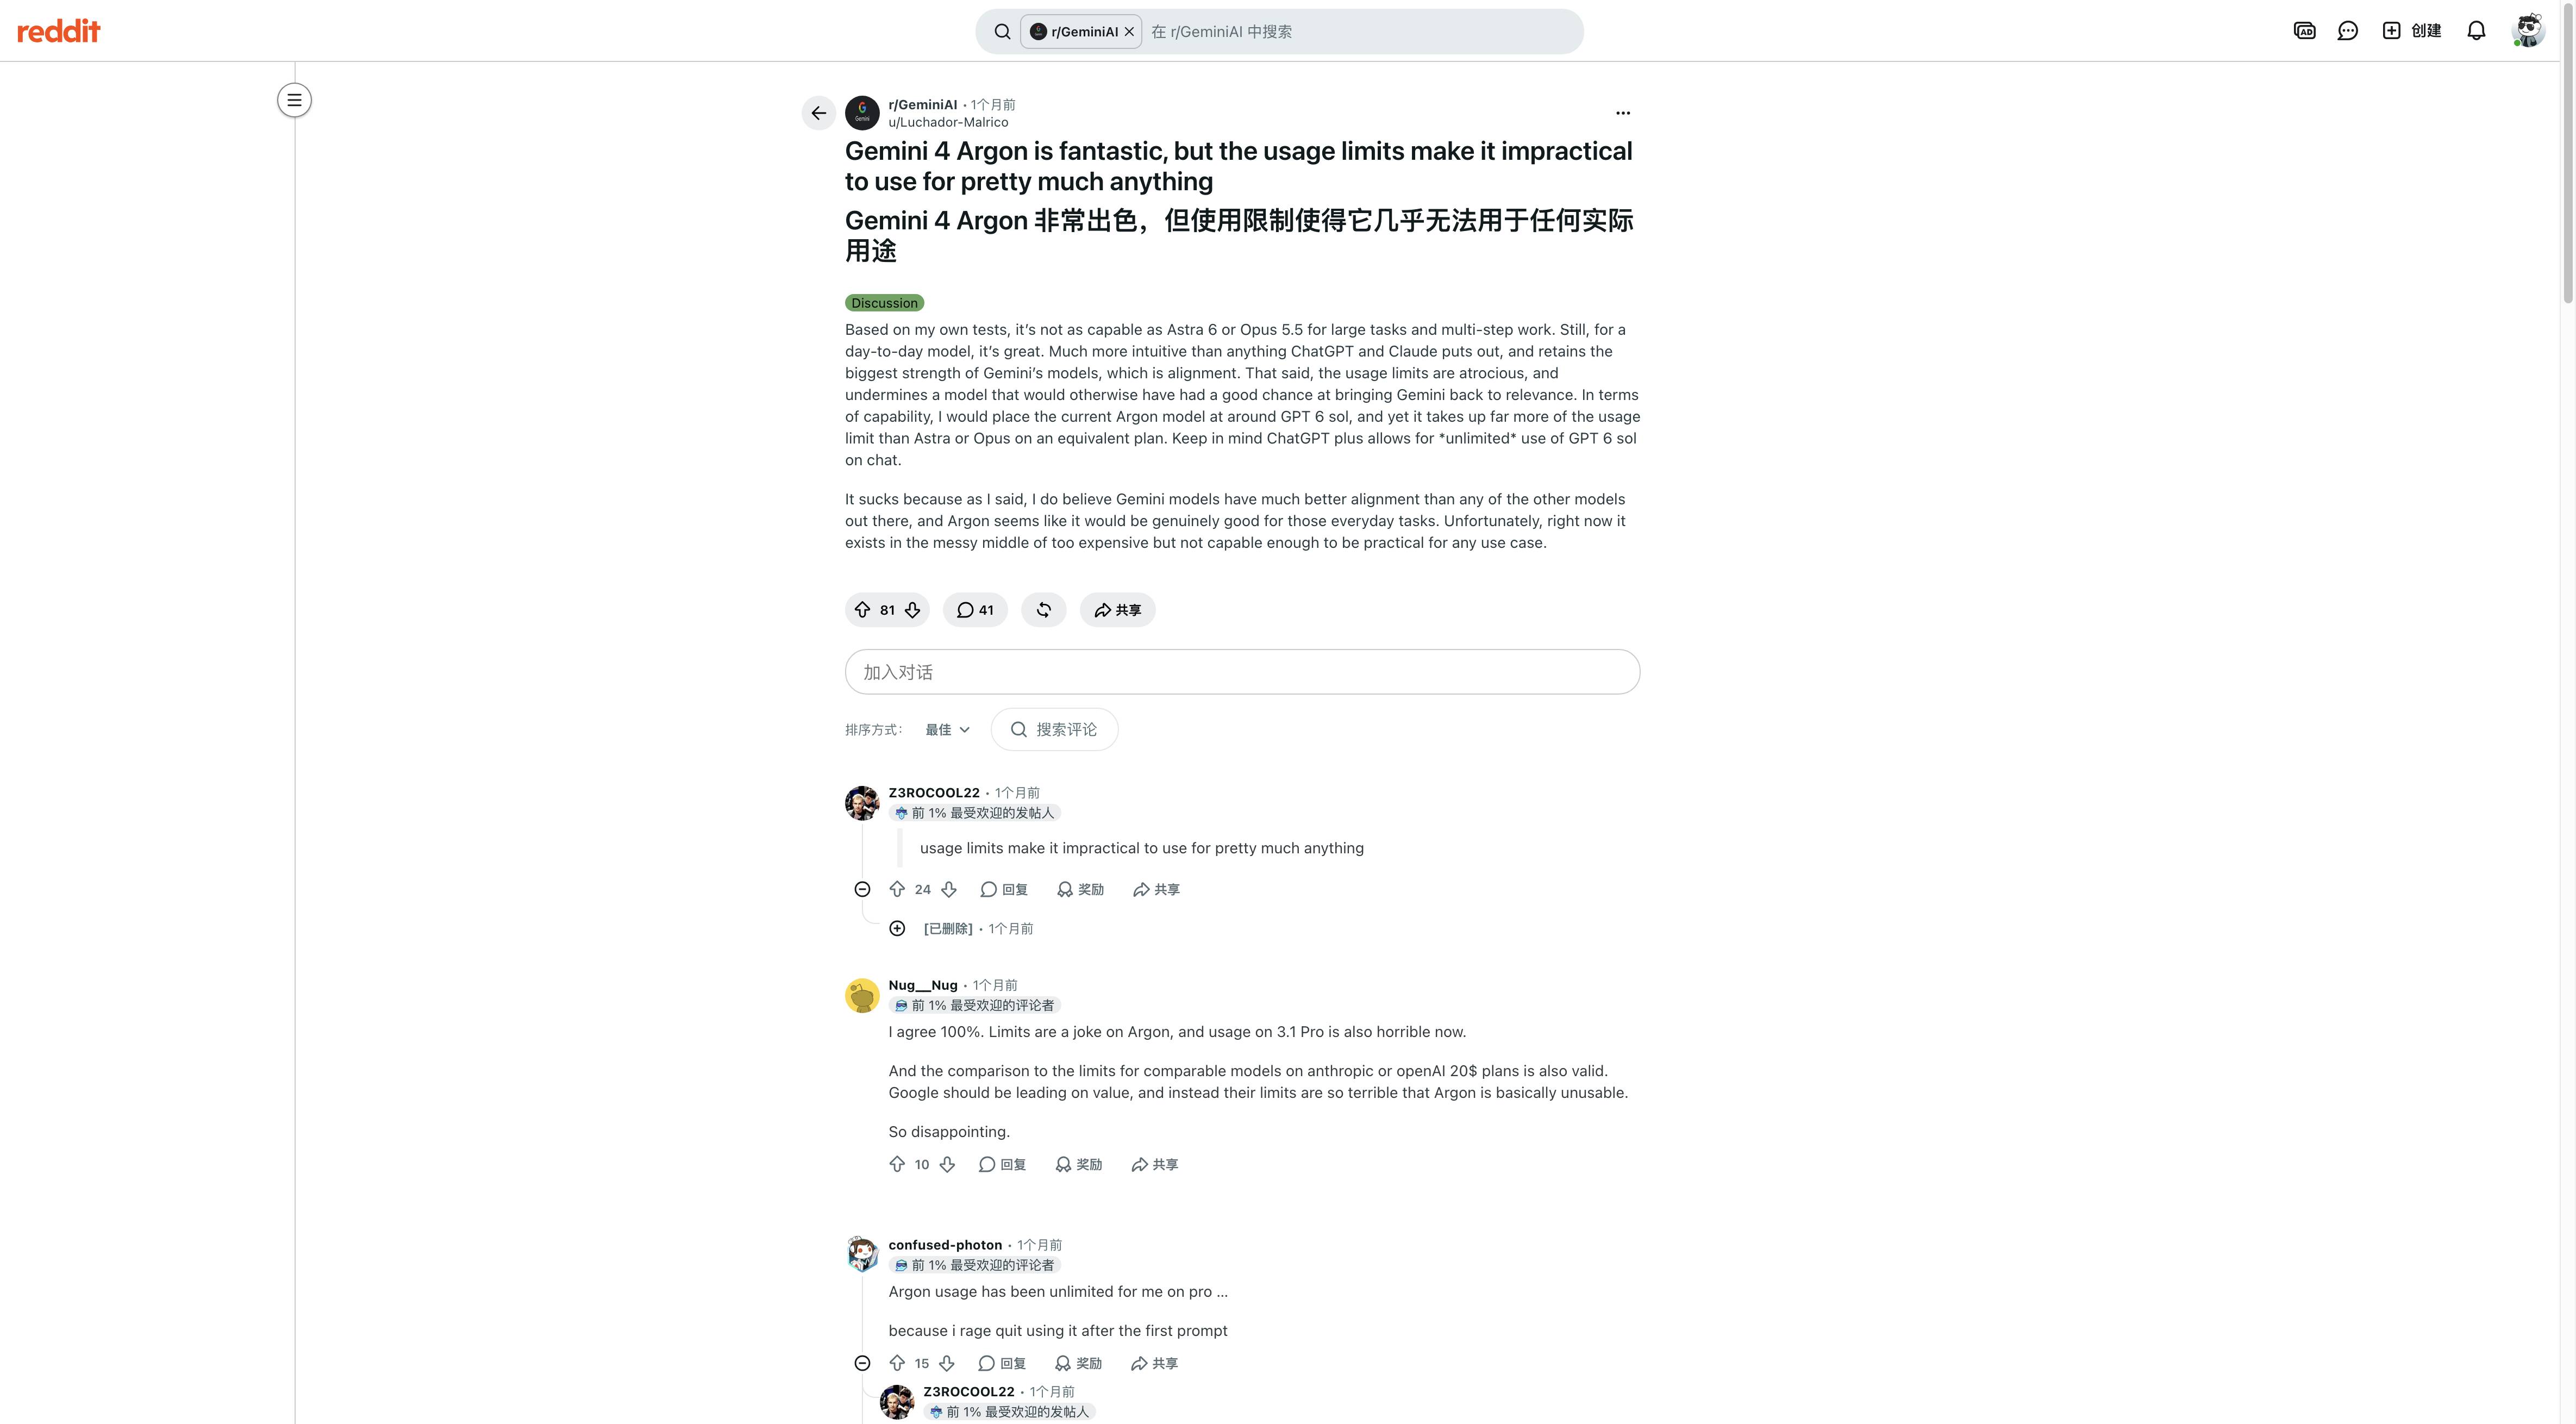
Reddit 订阅用户讨论 Argon 用量限制;属于个人体验,且受套餐影响。 Reddit 原帖

常见问题
Gemini 4 Argon 与 Carbon 最大区别是什么?
Google 将 Argon 定位于大多数软件工程和知识工作;Carbon 面向更困难、周期更长的任务,并使用更多思考 Token。
Gemini 4 Carbon 一定比 Argon 能力强吗?
Artificial Analysis Index v5.0.1 High 中 Carbon 得分 60,Argon 为 50。这是综合基准结果,不保证每项任务都如此。
Carbon 比 Argon 贵吗?
Google 宣布两者 API 优惠价相同。Artificial Analysis 的基准中 Carbon 平均任务成本更高,因为 Token 用量不同。
哪个模型更快?
在 Artificial Analysis Index v5.0.1 High 设置下,Argon 平均任务时间为 29.3 分钟,Carbon 为 32.1 分钟。该结论仅适用于这套评测。
Argon 与 Carbon 上下文窗口相同吗?
两份模型卡都为所述 API 用法列出最高 100 万 Token 的输入与输出合并窗口。
怎样公平比较 Argon 和 Carbon?
固定提示词、工具和成功标准,再比较完成情况、重试次数、耗时与 Token 费用。基准排名无法预测每项具体任务。