
Claude Fable 5.1 在 Anthropic API 上的價格是每百萬輸入 token 10 美元、每百萬輸出 token 50 美元,快取讀取每百萬 0.25 美元——所有費率均於 2026 年 9 月 22 日在 Anthropic 官方定價文件核對。這就是費率卡,而且它平淡得近乎無聊:五個 token 線項裡有四個和 Fable 5 完全相同。帳單卻是另一回事。同一張費率卡上,Artificial Analysis 實測同一個基準任務低推理檔 2.37 美元、max 檔 7.63 美元——一個價格數字都沒動,成本就擺動了 3.2 倍;另有獨立測量顯示 Fable 5.1 的單任務成本比 Fable 5 高 18%,儘管發布宣傳寫著「最多便宜 45%」。
這兩句話都是真的,它們之間的落差正是本文存在的原因。r/LLMDevs 的一位開發者把真實問題說得最準:GPT-6 Astra 和 Fable 5.1「標價相同,實際成本不同」——因為決定帳單的是你的流量形狀,不是標價(r/LLMDevs)。本文是我們 Claude Fable 5.1 總覽與評測的「錢的那一半」;後文會介紹 Tabbit Browser 作為預算清楚後實際執行比較的一個選擇。先看數字。
關鍵結論
費率卡: 每百萬 token 輸入 10 美元、快取讀 0.25 美元(0.025x——全家族唯一特例)、快取寫 12.50/20 美元(5 分鐘/1 小時)、輸出 50 美元。Batch 全線五折;僅美國推理每條線項 1.1 倍。
只有一項動了,其餘都是帳單形狀。 快取讀比 Fable 5 的 1.00 美元下降 75%。Anthropic 估計典型負載省約 25%、agentic 負載最多省約 45%;獨立實測落在 15–30%,還有一個記錄完整的社群建置實測比 Fable 5 貴 2.4 倍。
推理檔是最大的可控槓桿。 AA 的階梯顯示低檔到 max 檔每任務成本 2.37 → 7.63 美元,智慧分只從 47 漲到 53。Fable 在 Claude Code 預設 High 檔,其他介面預設 Medium——先確認你付的是哪一檔的錢。
沒有長上下文斷崖。 完整 100 萬 token 視窗按標準價計費——不像部分競品會對長提示重新定價——但新分詞器對同樣文字多產生約 30% token。
訂閱是另一套經濟系統。 Fable 不在免費版;Pro/Max 按「每週限額 50% 的 usage credits」計量,疊加 5 小時滾動視窗。Enterprise 為每席位 20 美元/月加 API 費率用量。
Claude Fable 5.1 費率速覽
完整標準費率卡,來自 Anthropic 定價文件(2026 年 9 月 22 日核對)。Mythos 5.1——同一套權重、受限存取計畫——標價完全相同但一般買不到;譜系關係見總覽頁。
| 模型 | 輸入 / 百萬 | 5m 快取寫 / 百萬 | 1h 快取寫 / 百萬 | 快取讀 / 百萬 | 輸出 / 百萬 |
|---|---|---|---|---|---|
| Claude Fable 5.1 | $10.00 | $12.50 | $20.00 | $0.25 | $50.00 |
| Claude Fable 5 | $10.00 | $12.50 | $20.00 | $1.00 | $50.00 |
| Claude Opus 5 | $5.00 | $6.25 | $10.00 | $0.50 | $25.00 |
| Claude Sonnet 5 | $2.00 | $2.50 | $4.00 | $0.20 | $10.00 |
| Claude Haiku 4.5 | $1.00 | $1.25 | $2.00 | $0.10 | $5.00 |
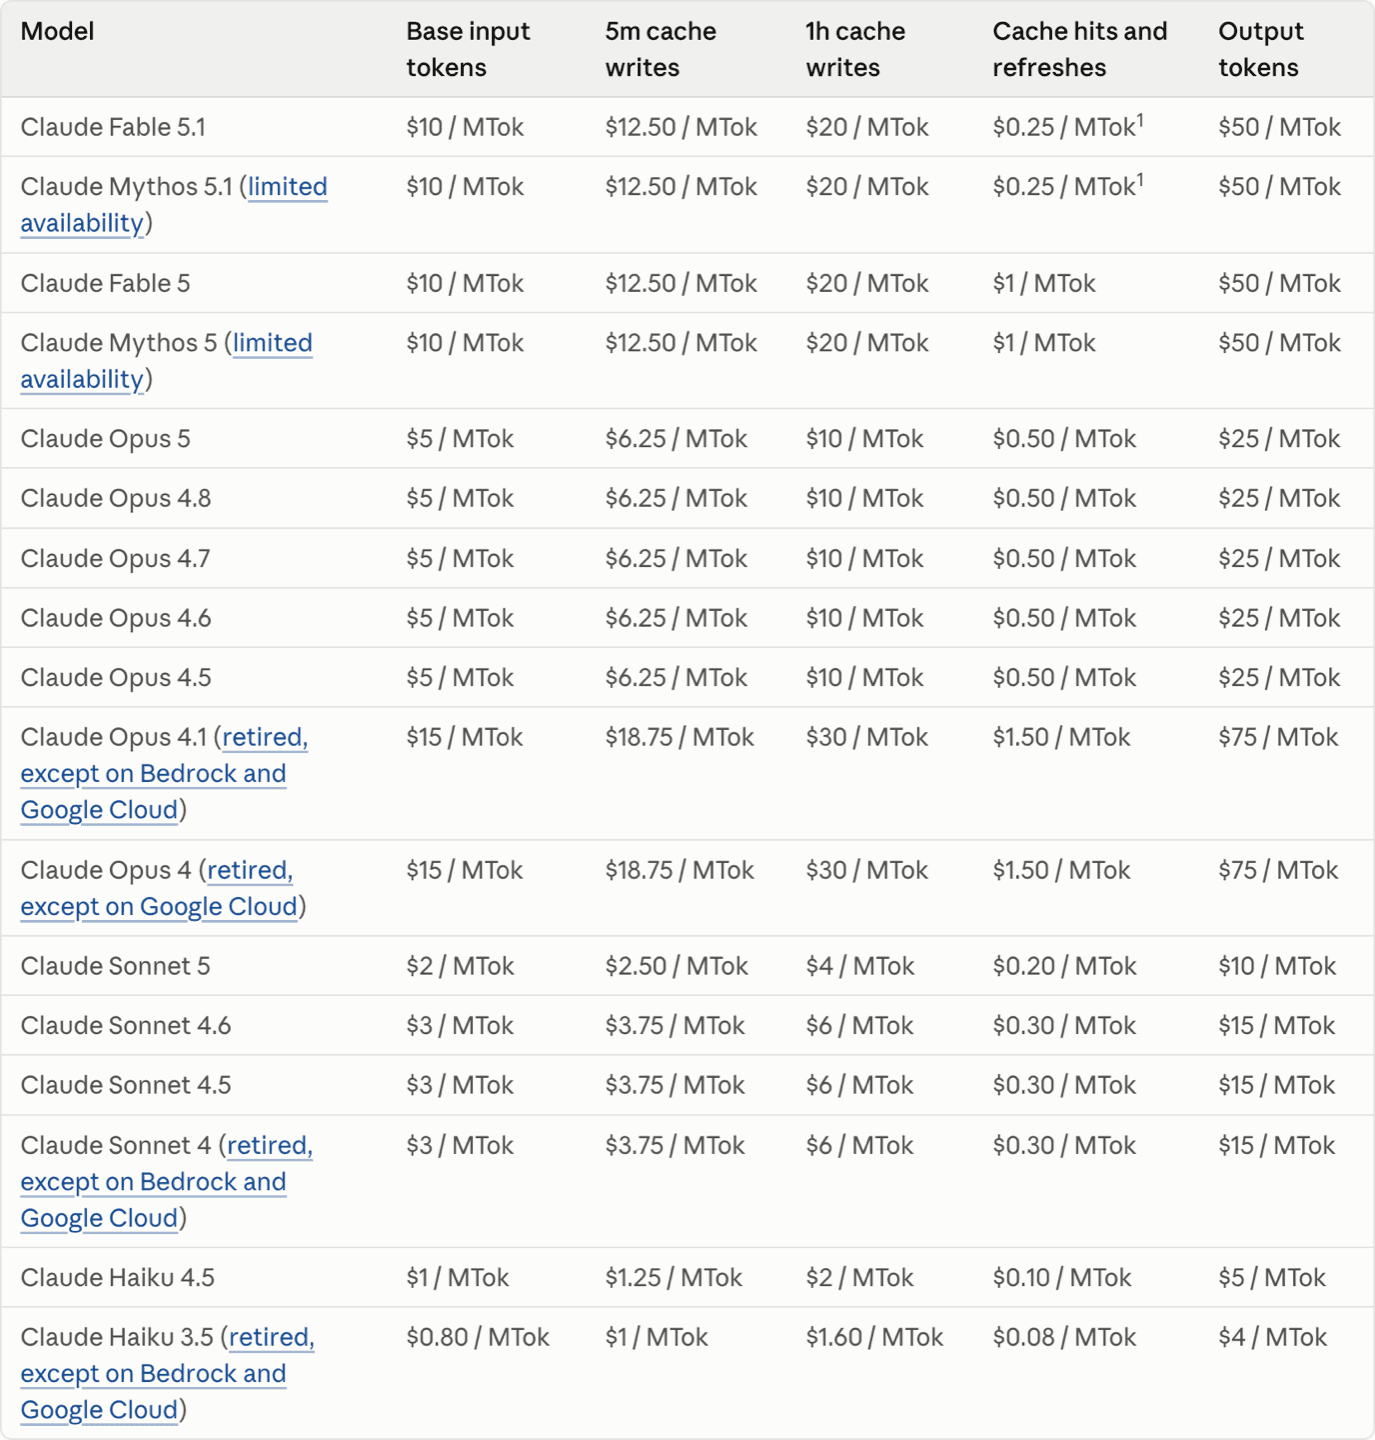
這張表裡真正決定帳單的是三件事,沒有一件是 headline 的 10 美元:
輸出是輸入的 5 倍價。 Fable 是自適應推理模型,它用可計費的輸出 token 思考。一個短提示加一條長推理鏈,本質上是一張穿著輸入外衣的輸出帳單。
快取寫入比輸入還貴。 5 分鐘條目 12.50 美元是基準價的 1.25 倍,1 小時條目 20 美元是 2 倍。5 分鐘檔讀一次、1 小時檔讀兩次就回本——前提是前綴真的被重複使用。
分詞器在你腳下換了。 按 Anthropic 官方腳註,Claude 4.7 及之後模型使用的新分詞器對同樣文字多產生約 30% token。拿 token 單價直接對比 Sonnet 4.6 時代模型而不做這項校正,會把舊模型成本高估三分之一。
還有一點值得釘死:完整 100 萬 token 上下文按標準價計費——用 Anthropic 的話說,「一個 90 萬 token 請求和一個 9 千 token 請求的單價相同」。與 GPT-6 Astra 的 27.2 萬斷崖(越過閾值後整個請求重新定價)不同,Fable 完全沒有長上下文档位。
唯一變化的數字:快取讀下降 75%
提示快取是 Fable 5 到 5.1 之間唯一移動的線項,值得從機制上理解它——因為 agent 迴圈就活在這一行上。
當一個請求重複此前已處理過的提示前綴——系統提示、倉庫上下文、對話歷史、工具定義——API 可以從快取讀取該前綴而不必重新處理。寫入按基礎輸入價的 1.25 倍(5 分鐘條目)或 2 倍(1 小時條目)收費;讀取通常按 0.1 倍收費。Fable 5.1(和 Mythos 5.1)是全家族例外:讀取按 0.025 倍計價——每百萬 0.25 美元,Anthropic 的腳註明確標註了這一點。這些乘數可與 Batch 折扣、資料駐留定價疊加。
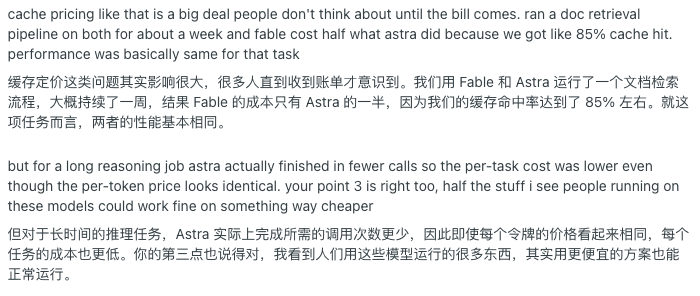
為什麼它主導 agent 帳單:一個在 20 萬 token 上下文上做 40 次工具呼叫的 agent,會把這段前綴重讀 40 次。按 Fable 5 的 1.00 美元讀取價,這些重讀花費 8.00 美元;按 Fable 5.1 的 0.25 美元,只花 2.00 美元——這還發生在一個新 token 生成之前。社群數據指向同一方向。一位在 Fable 5.1 與競品(1.00 美元讀取價)上各跑了一週文件檢索管線的開發者報告:85% 快取命中率下,總成本約為對方一半:
在 r/ClaudeCode,一位把「Fable 5 規劃 + Opus 5 寫碼」組合換成 Fable 5.1 直接寫碼(Medium 檔)的 Django 開發者算出:每請求省約 37%,每輸出 token 省約 52%——用他自己的話說,「原因幾乎完全是快取定價」:
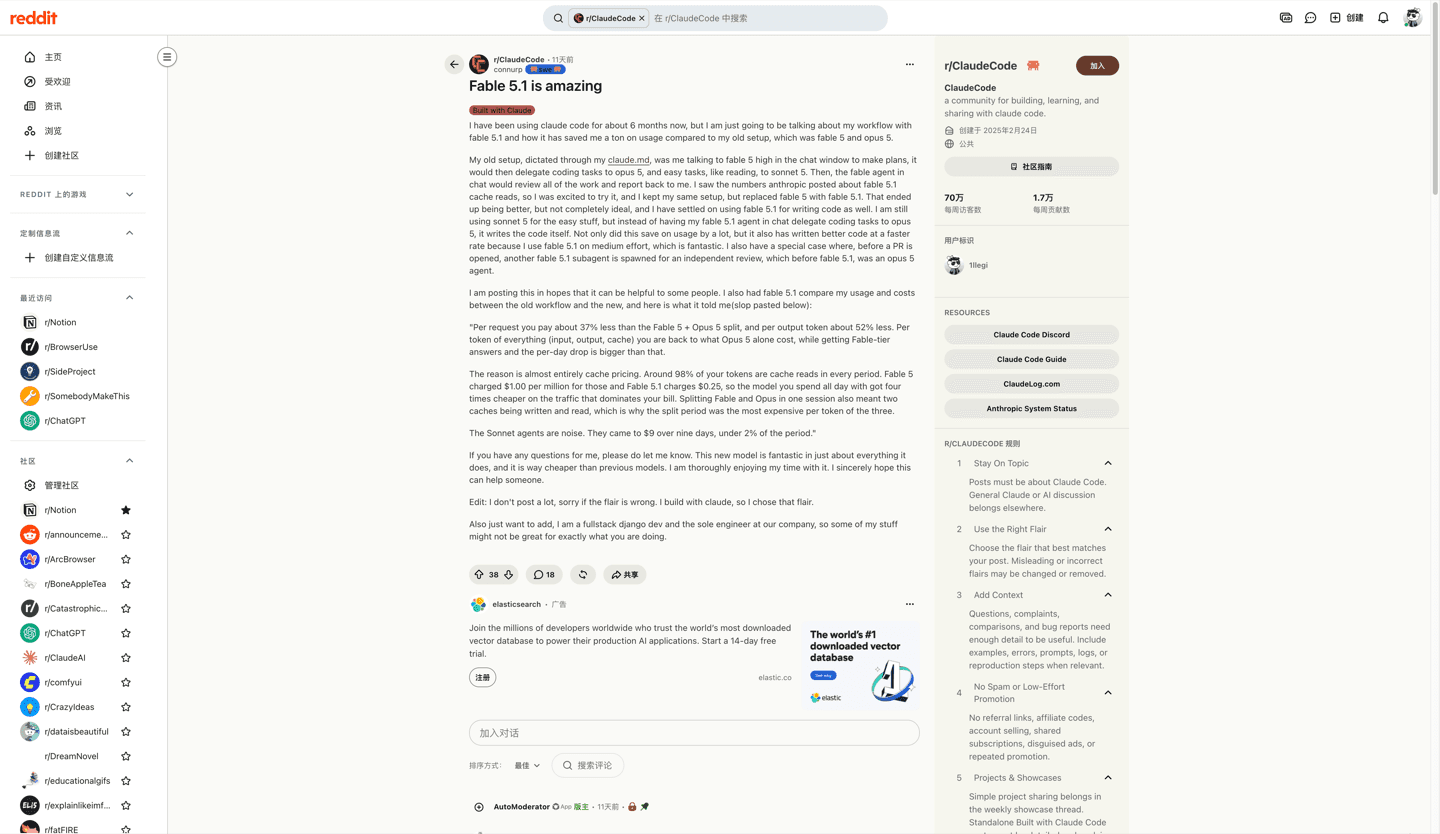
兩條報告的共同前提:快取省錢需要穩定的前綴。如果你的上下文每輪都在變——動態工具輸出、輪換的文件——你會不斷支付 1.25–2 倍的寫入罰金,而不是享受 0.025 倍的讀取價。這個失敗模式正是下一節要測量的東西。
「最多便宜 45%」到底什麼意思
Anthropic 的發布聲明有精確的適用條件,把它們拆開讀,是「預算」和「願望」之間的差別。動手做預算前有兩個必須知道的 caveat。
Caveat 一:基線與條件。「Fable 5.1 對典型負載估計比 Fable 5 便宜 25%……對高度 agentic 的工作,節省常常大得多——最多約 45%。」基線是 Fable 5,不是競品;聲明只涵蓋按 token 計費的用量;「高度 agentic」指反覆重讀大型穩定前綴的負載——即上一節的快取讀形狀。它不是對你「完成任務成本」的承諾。
Caveat 二:獨立測量發現了相反方向。Artificial Analysis 實測 Fable 5.1 在其智慧指數上消耗 1.4 億輸出 token,而 Fable 5 是 8,300 萬,把單任務成本推高 18%(3.14 → 3.69 美元)。Firecrawl 的57 次執行測量(2026 年 9 月 7 日)發現 Fable 5.1 在每一檔 effort 上都用了更多輸出 token——低檔 1.37 倍、高檔 1.12 倍、max 檔 1.30 倍——實際節省是帳單的 15–30%,而非 25–45%,「因為(1 小時)快取寫入每百萬 20 美元且不打折」。他們的結論值得引用:「Anthropic 說 Fable 5.1 更便宜……Artificial Analysis 實測它貴了 18%。兩邊都測對了。」你的帳單更像哪一邊,取決於哪種 token 占主導。
社群在野外找到了這個失敗模式。一位 r/ClaudeCode 開發者用同一個建置 prompt 跑兩個模型:Fable 5.1 花了 1,200 美元,Fable 5 花 500 美元——2.4 倍,headline 費率完全相同:
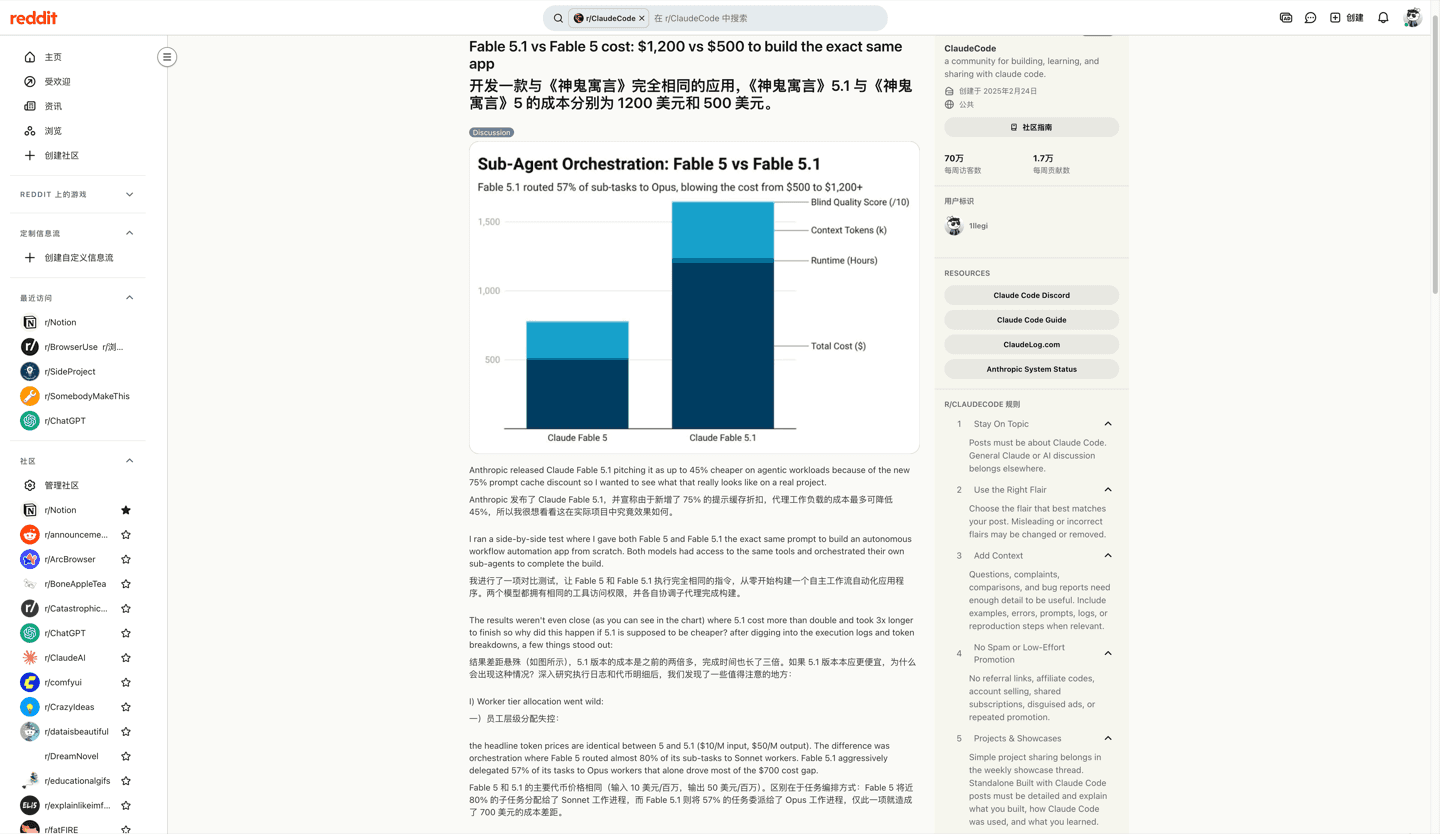
他的復盤:Fable 5.1 把 57% 的子任務委派給了Opus 工作模型(按 Opus 費率計費),而 Fable 5 有 80% 路由到 Sonnet;推理迴圈還把活躍上下文膨脹到 40 萬 token 以上——「支付沉重的寫入罰金,而不是搭上便宜的快取讀」。教訓不是「Fable 5.1 貴」,而是委派檔位和上下文抖動本身就是計費線項,任何費率卡上都沒有它們。這筆權衡的能力側見評測與我們的 agentic 推理指南。
推理檔槓桿:每任務 2.37 到 7.63 美元
Fable 5.1 提供自適應推理檔位(effort)——而費率卡上沒有任何一行告訴你,這個旋鈕對成本的影響超過所有價格線。Artificial Analysis 把它當作五個獨立條目追蹤;2026 年 9 月 22 日快照:
| 推理檔 | 智慧指數 | 每任務成本 | 輸出速度 |
|---|---|---|---|
| low | 47 | $2.37 | 55 t/s |
| medium | 49 | $2.98 | 57 t/s |
| high | 51 | $3.91 | 56 t/s |
| xhigh | 53 | $5.98 | 63 t/s |
| max | 53 | $7.63 | 67 t/s |
把外側兩欄一起讀:max 檔每任務成本是 low 檔的 3.2 倍,換來的智慧分只有 6 分。 low 檔的首 token 延遲也最低(同一快照 8.47 秒)。貴的檔位不自動等於更仔細;它只是在可計費輸出 token 裡想得更久——Firecrawl 的數據顯示差距幾乎全部來自隱藏推理 token(max 檔:推理 token 4,205 → 6,725,可見文字反而少了 6%)。
Anthropic 自己的預設值讓這成為一個現實決策:Fable 5.1 在 Claude Code 預設 High 檔,在 Claude Cowork 和 Claude.ai 預設 Medium 檔。同一個任務在兩個介面裡,從第一個 token 起就計費不同。發布說明難得直白:Low 或 Medium 檔「以低得多的成本取得與 Fable 5 相近或更好的結果」——廠商親口告訴你便宜檔通常夠用,這是禮物,收下。
headline 之外的計費線項
四條線決定大多數真實帳單,而發布報導通常只涵蓋第一條。
Batch:五折槓桿。 非同步 Batch 請求在 Fable 5.1 上按輸入 5 美元/輸出 25 美元計費——整卡最大的折扣,且與提示快取疊加。評測跑批、夜間重構、一切非使用者面對面工作,這一個開關比任何提示詞最佳化都省。託管 agent 會話不適用(有狀態、互動式)。
僅美國推理:全線 1.1 倍。 設定 inference_geo: "us"(或 Azure 美國資料區部署)會把每一類線項乘以 1.1,包括快取讀。合規驅動的區域為每一行安靜地多付 10%;global 路由是預設且更便宜的路徑。
工具開銷就是 token 帳單。 宣告 browser-use 工具集每次請求增加約 6,600 輸入 token;computer-use 約 4,500;bash 工具定義 325。伺服器端網頁搜尋在 token 之外按每千次 10 美元計費。一個「agent」是一種定價結構,不是一次聊天——瀏覽器自動化工作流應該把工具集這一行單列進預算。
Batch 和駐留都修不好的東西:重試、子代理扇出(每個路由到 Opus 的子任務按 Opus 費率計費),以及分詞器相對 4.7 前模型約 30% 的 token 膨脹。它們都不在費率卡上,但都會出現在帳單上。
家族階梯:Fable 5.1 vs Opus 5 vs Sonnet 5
| 線項(每百萬 token) | Fable 5.1 | Opus 5 | Sonnet 5 |
|---|---|---|---|
| 輸入 | $10.00 | $5.00 | $2.00 |
| 快取讀 | $0.25(0.025x) | $0.50(0.1x) | $0.20(0.1x) |
| 輸出 | $50.00 | $25.00 | $10.00 |
| Batch 輸入 / 輸出 | $5.00 / $25.00 | $2.50 / $12.50 | $1.00 / $5.00 |
反直覺的一行是快取讀:家族裡最貴的模型有最便宜的快取讀——比家族標準乘數低 4 倍。Anthropic 把 agent 迴圈砸得最狠的那條計費線,定出了最低的比率。如果你的流量反覆重讀大型穩定上下文,Fable 的有效輸入價會坍縮;如果不是,headline 減半、快取讀比率加倍的 Opus 5 可能更划算——Firecrawl 發現緊湊規格的任務在 Opus 5 上「每次」都更便宜,而開放式建置平均 Opus 11.83 美元、Fable 5.1 是 7.00 美元。
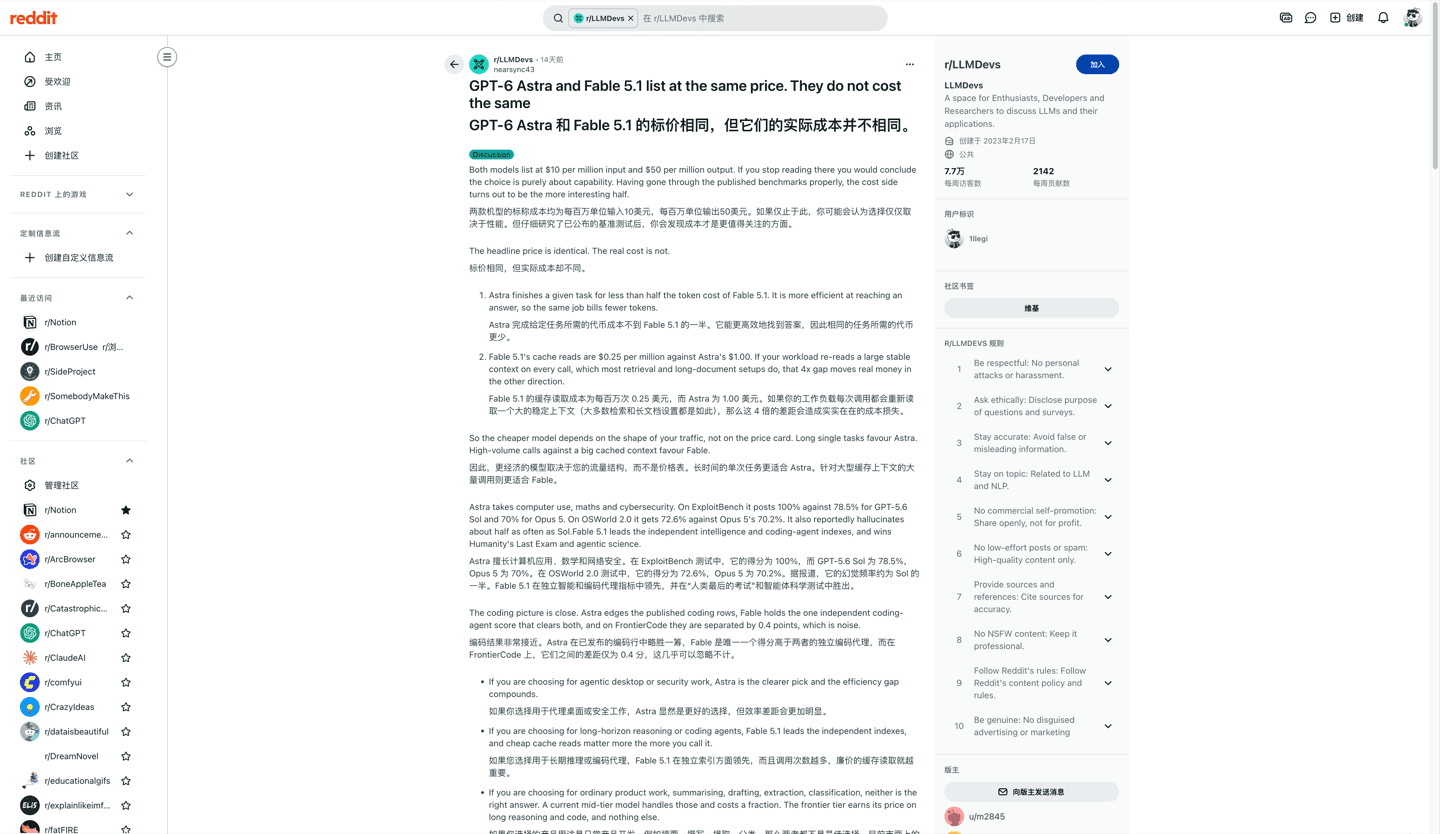
階梯上還有兩個值得釘死的事實:Sonnet 5 的 2/10 美元本是到 2026 年 8 月 31 日截止的促銷價——Anthropic 已將其轉為標準價,取消了原定 9 月 1 日漲到 3/15 美元的計畫。同價陷阱還跨家族存在:Fable 5.1 和 GPT-6 Astra 都標價 10/50 美元,實際成本方向相反——Astra 用更少 token 完成長單任務,Fable 的 0.25 美元讀取贏下任何高頻快取上下文負載。r/LLMDevs 的分析原文:
Anthropic 自己的定位與階梯一致:Fable 5.1 面向「雄心勃勃、長時間執行、非同步」的工作——評測涵蓋該結論何時成立——日常互動工作交給 Opus 和 Sonnet。
你不用付錢的部分
定價文件和產品頁劃出了幾條讀起來像退款政策的邊界,在 agentic 規模下它們真的影響帳單:
護欄轉寫不按 Fable 價格計費。 被網路安全或生物學護欄標記的查詢由 Opus 4.8 或 Opus 5 完成——產品頁原文:「轉寫請求不會按 Fable 價格向你收費。」安全話題上一個感覺被拒答的回答,可能 literally 是一個更便宜的 Opus 回答。
失敗的網頁搜尋不計費。 成功的搜尋按每千次 10 美元計費,出錯的那些不計。網頁擷取除 token 外不額外收費。
程式碼執行與搜尋/擷取同用時免費,且每個組織每月有 1,550 免費 container 小時,之後才開始按每小時 0.05 美元計。
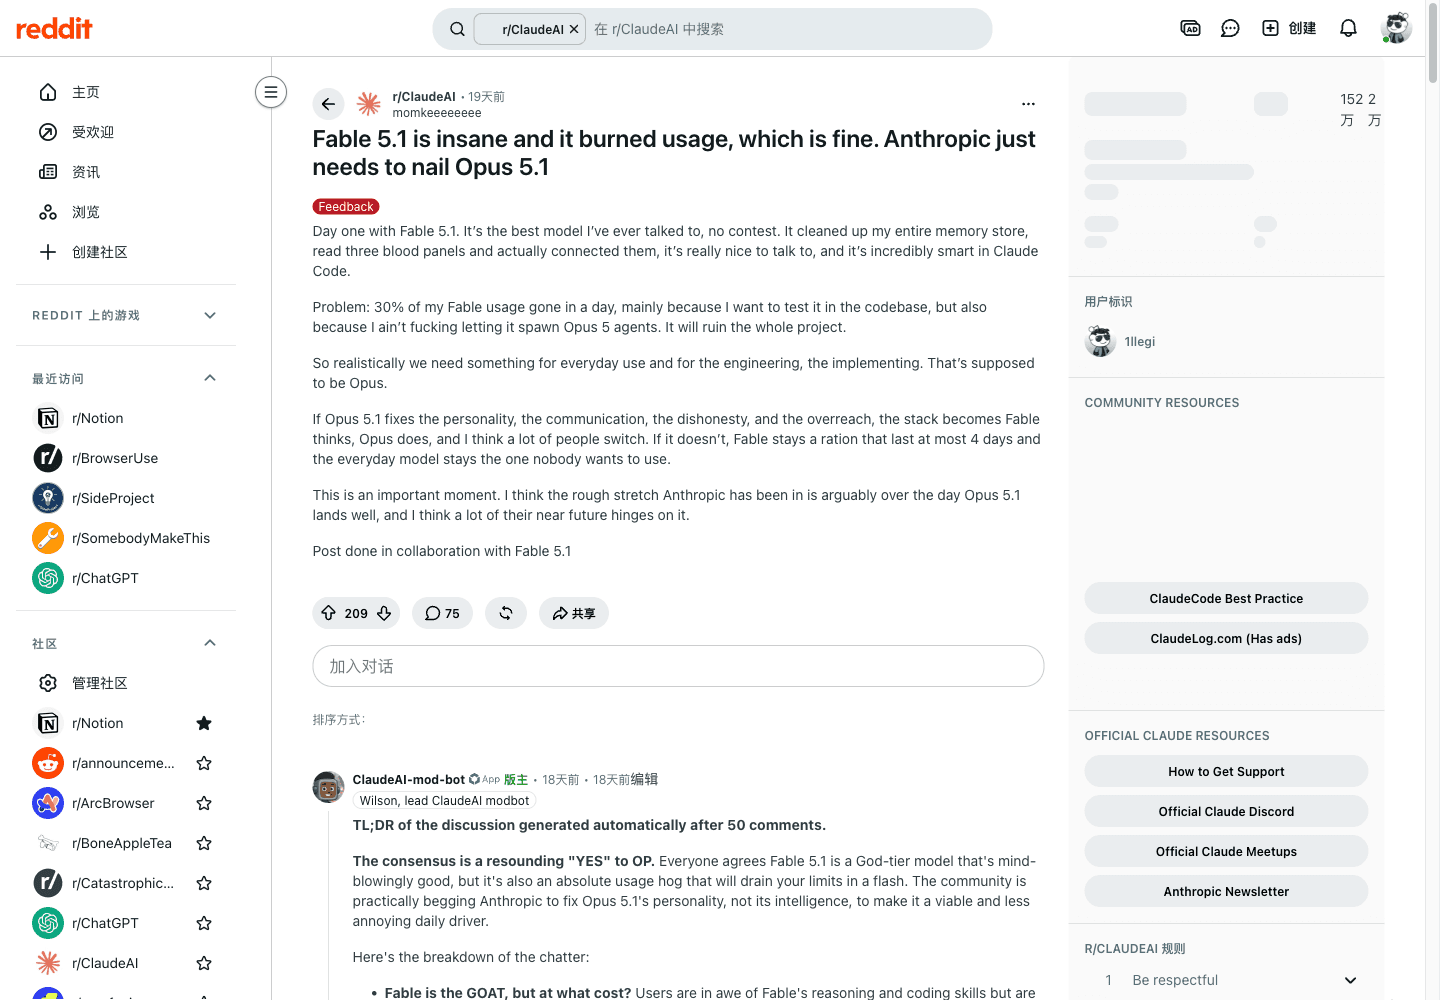
平衡的另一面:配額不是錢,但行為像錢。訂閱版上 Fable 消耗 5 小時視窗的速度很快——一位 r/ClaudeAI 使用者回報一天內 30% 用量消失在一次除錯會議裡(「我不會讓它去 spawn Opus 5 agent」),Every 週測影片的留言區也有人回報 10–20 分鐘耗盡一個 5 小時視窗。這些是自報的方案體驗、不是基準,但方向與 API 數學一致:委派和推理檔決定燃燒速度。付費方案的 usage credits 允許超限後按標準 API 費率繼續工作。
方案可得性:API、雲與消費訂閱
API 費率卡只是三套經濟系統之一。以下在 claude.com/pricing 與平台文件於 2026 年 9 月 22 日核對:
| 渠道 | 價格(頁面實際顯示) | Fable 5.1 可得性 |
|---|---|---|
| Anthropic API | 上文 token 費率 | 是——claude-fable-5-1 |
| 免費版 | $0 | 否(僅 Sonnet/Haiku) |
| Pro | 年付 $17/月(預付 $200)或月付 $20 | 是——usage credits,每週限額的 50% |
| Max 5x / 20x | $100/月起 | 是——同一 credits 規則,Pro 用量的 5x/20x |
| Team 標準 / 進階 | 年付每席位 $20 / $100,月付 $25 / $125 | 是——進階 = 標準的 5 倍 |
| Enterprise | 年付 $20/席位/月 + 按 API 費率的用量 | 是,含支出管控 |
| 雲平台 | AWS Bedrock、Google Cloud、Microsoft Foundry | 是;區域端點 +10%,Foundry 以 CCU 計量 |
決定真實成本的訂閱機制:用量按5 小時滾動工作階段視窗重置,付費方案再疊加每週限額;網頁、桌面、行動端和 Claude Code 共用一個池;Pro 每視窗「至少 5 倍」於免費版,Max 是 Pro 的 5x/20x。Fable 在 Pro/Max 上具體按每週限額 50% 的 usage credits 扣減——一小時的 Fable 對你的額度來說等於兩小時的 Sonnet,這就是上文「燒完視窗」報告背後的算術。
第三方通道各有條件:OpenRouter 的 Fable 頁面註明該通道資料保留不可豁免,其 Bedrock 端點遷移期間僅支援 BYOK。預設檔位也因介面而異——Claude Code 是 High,網頁是 Medium——同一份訂閱在不同工作介面的消耗速度不同。
兩組算例,所有假設攤開
標準費率,無重試、無工具、不含稅。這是算術示範,不是預測。
一個短問題和一段長思考。 輸入 10,000 token,輸出 2,000:
(10,000 × $10 + 2,000 × $50) / 1,000,000 = $0.20大型倉庫上的冷啟動 agent 迴圈。 輸入 300,000 token(仍是標準價——沒有長上下文档位),輸出 8,000:
(300,000 × $10 + 8,000 × $50) / 1,000,000 = $3.40同一迴圈的暖啟動版本。 同樣 300,000 token 上下文,90% 快取命中,每會話一次 1 小時寫入,輸出 8,000:
(270,000 × $0.25 + 30,000 × $10 + 300,000 × $20 + 8,000 × $50) / 1,000,000 = $0.97 + 寫入第三行就是這次發布的全部故事濃縮成一次計算:前綴保持穩定時,同樣的工作從 3.40 美元掉到 1 美元以下——而上下文抖動、重試或 Opus 路由的子代理一出現,它就爬回去。模型資源頁 (简体中文)與提示詞庫 (简体中文)收錄了可以用來實測你自己命中率的可重複任務。
本機計算
估算 Claude Fable 5.1 API token 成本
使用 2026-09-22 核對的官方美元費率。輸入值只在瀏覽器本機處理。
快取命中按每百萬 token $0.25 計費——Fable 系 0.025x 特例。此估算不含重試、工具開銷、護欄轉寫及供應商加價。僅美國模式對所有線項生效。 核對最新費率
計算器完全在本頁執行——任何資料都不會外傳。它對兩種快取寫入時長、Batch 與僅美國模式計價,並在本機校驗輸入。它刻意不建模的東西:重試、子代理檔位路由、工具開銷和護欄轉寫——這些屬於你的餘裕。提交預算前請重新核對官方費率卡;本文數字截至 2026 年 9 月 22 日。
一個實用選項:在 Tabbit 裡跑對比
預算算清之後是枯燥的部分:真正跑 Fable 形態的工作,需要一個頁面、檔案和模型呼叫待在一起的地方,讓「用 Medium 檔試 Fable、不合適退回 Sonnet」變成一次選擇而不是一個編排專案。這就是 Tabbit Browser填補的空檔——一個 agentic AI 瀏覽器,模型選擇器、即時分頁和本機檔案共享同一個介面。
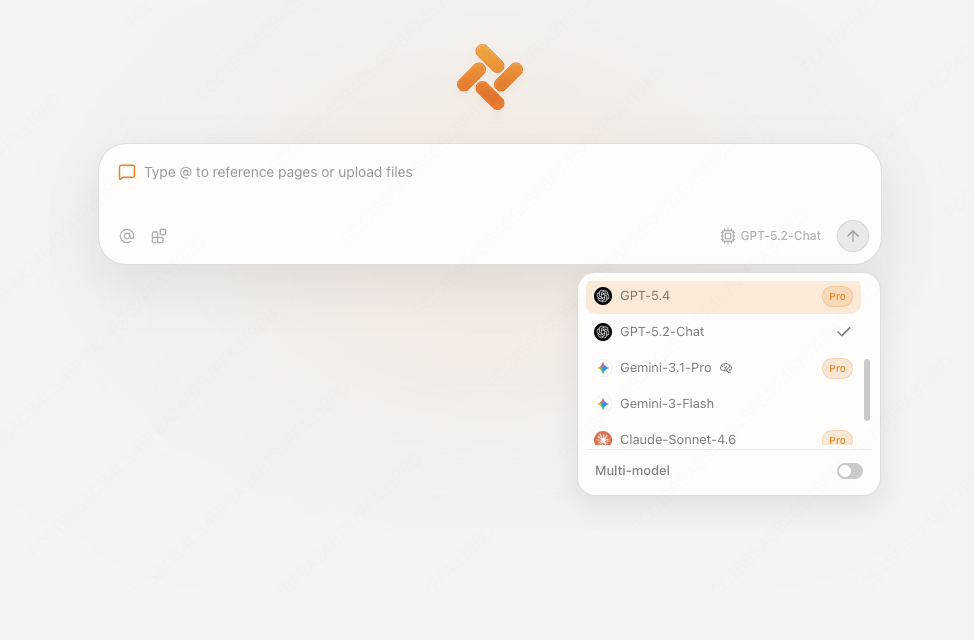
邊界照實說:Tabbit 是用戶端,不是 Anthropic 的計費層。模型可得性取決於你的帳戶與版本,瀏覽器裡的任何東西都不會改變 Anthropic 收什麼費——上文費率卡在 Fable 執行的任何地方都適用。本文沒有在 Tabbit 內執行 Fable 任務,因此在這裡不做任何可得性或效能聲明。瀏覽器改變的是設定成本:本文整頁都在說決定你帳單的兩個數字——你自己的快取命中率和推理檔閾值——在真實工作上測它們,在為這個場景打造的工作台裡最便宜。Tabbit 使用習慣指南講方法;AI 瀏覽器總覽是通用起點。
 Tabbit Browser
Claude Fable 5.1 定價決策表
| 你的負載 | 成本主導項 | 最佳起步路徑 | 注意 |
|---|---|---|---|
| 長 agent 迴圈、穩定倉庫/文件上下文 | 快取讀 | 標準檔 + 前綴穩定 + 1h 寫入 | 上下文抖動會把讀取變回 1.25–2 倍寫入 |
| 短對話、快改寫 | 輸出 token | 更低推理檔——或 Sonnet 5 | $50/M 輸出占主導;Fable 是殺雞用牛刀 |
| 夜間評測、批次重構 | 體量 | Batch API 五折 | 互動式/託管 agent 會話不適用 |
| 開放式自主建置 | 委派 + 輸出 | 限制子代理檔位;讓 Fable 自己寫碼 | Opus 路由的子代理按 Opus 費率計費 |
| 合規要求的美國內處理 | 每條線項 | 僅美國 1.1x + 允許處用 Batch | 加價同樣作用於快取讀 |
| 訂閱制日常使用 | 5 小時視窗 + credits | Pro/Max,credits 按每週限額 50% | High 預設檔幾分鐘就能燒完視窗 |
最終裁決
Claude Fable 5.1 的定價像一種面向長期工作的原材料,而且這次發布真的移動了一個數字:每百萬 0.25 美元的快取讀讓快取上下文 agent 迴圈比 Fable 5 顯著更便宜——獨立實測的落地節省在 15–30%,你的實際數字由命中率而非標價決定。為這種形狀的工作買它,用能通過驗收檢查的最低推理檔,限制委派檔位,能等的全部走 Batch。至於短互動任務、緊預算或高頻變化上下文——家族階梯存在的意義就是讓旗艦成為一個路由決策而非預設選擇;在訂閱上,請把 5 小時視窗當作真正的帳單。
每月覆核官方定價頁:Sonnet 5 的轉正說明這條階梯會動。總覽和評測講能力;上文社群記錄講負載證據;跨家族定價對比展示同樣標價在別處的成本。
來源
Anthropic 定價文件——費率卡、快取乘數、Batch、駐留、工具計價;2026 年 9 月 22 日核對
Anthropic 發布頁與 Claude Fable 產品頁——節省聲明、預設檔、轉寫計費、可得性;2026 年 9 月 22 日核對
claude.com/pricing——Free/Pro/Max/Team/Enterprise 方案與 Fable 可得規則;2026 年 9 月 22 日核對
Artificial Analysis 發布頁——推理檔智慧、速度、單任務成本快照;2026 年 9 月 22 日核對
Firecrawl:57 次執行成本測量——token 比率、落地節省、任務規格影響;2026 年 9 月 7 日
OpenRouter Fable 5.1——供應商費率與通道條件;2026 年 9 月 22 日核對
附截圖與條件的社群記錄:r/ClaudeCode $1,200 vs $500、r/ClaudeCode 省 37%、r/LLMDevs 同價分析、r/ClaudeAI 配額燃燒、Every 週測影片留言

常見問題
Claude Fable 5.1 多少錢?
在 Anthropic API 上,Claude Fable 5.1 為每百萬輸入 token 10 美元、每百萬輸出 token 50 美元,均於 2026 年 9 月 22 日在 Anthropic 官方定價文件核對。提示快取寫入為每百萬 12.50 美元(5 分鐘)或 20 美元(1 小時),快取讀取為每百萬 0.25 美元。Batch API 全線五折至 5/25 美元,僅美國推理對每條線項加收 1.1 倍。
Claude Fable 5.1 比 Fable 5 便宜嗎?
取決於哪種 token 占你帳單的主導。Anthropic 估計典型負載便宜約 25%,高度 agentic 負載最多便宜約 45%,全部來自快取讀降至每百萬 0.25 美元。但 Artificial Analysis 實測其單任務成本上升 18%,因為 Fable 5.1 輸出更多推理 token。反覆重讀穩定快取上下文的負載更省錢;持續產生新輸出或上下文頻繁變化的負載可能更貴。
Claude Fable 5.1 在免費版裡能用嗎?
不能。Anthropic 的方案對照表標註 Free 檔不含 Fable。它向 Pro、Max、Team 與 Enterprise 使用者開放;在 Pro 和 Max 上,Fable 用量按每週限額 50% 的 usage credits 扣減。免費版使用者只能使用 Sonnet 與 Haiku 系列模型。
執行 Claude Fable 5.1 最省錢的方式是什麼?
按順序疊加槓桿:保持提示前綴穩定,讓讀取按每百萬 0.25 美元而不是 10 美元計費;在能通過驗收檢查的前提下用最低推理檔;把不著急的工作走 Batch API 享五折;合規無要求就不要開僅美國推理。同時限制委派:被路由到 Opus 5 的子代理按 Opus 費率計費,是最常見的隱性成本項。
Claude Fable 5.1 長上下文要加錢嗎?
不用。Anthropic 對完整 100 萬 token 上下文視窗按標準單價計費,沒有長上下文档位或閾值重新定價;提示快取與 Batch 折扣涵蓋整個視窗。這不同於 GPT-6 Astra 等旗艦——其輸入超過 27.2 萬 token 後整個請求按更高的長上下文档率重新計價。
護欄轉寫或失敗的工具呼叫會按 Fable 價格計費嗎?
不會。Anthropic 明確說明被網路安全或生物學護欄自動轉寫的查詢不按 Fable 價格收費,而是由 Opus 4.8 或 Opus 5 完成回答。失敗的網頁搜尋不計費,網頁擷取不額外收費,與搜尋/擷取工具一起使用的程式碼執行也免費。