把整疊資料放進同一個工作階段
把 PDF 當作一等分頁,和引用它們的頁面並排開啟。輸入 @ 引用已開啟的分頁,或直接上傳檔案,讓每個問題都從你的真實來源出發——而不是面對空白輸入框。
 tabbit.
品牌核對 · AI 論文閱讀
你在搜尋時就帶上了產品名——很聰明。這裡給你一份誠實的匹配核對:Tabbit 是 AI 原生瀏覽器,把 PDF、引用鏈結和 AI 對話放進同一個研究工作階段,而不是又一個單檔案閱讀器。
為什麼這樣搜
泛泛的榜單是為截圖最佳化的;而你是在為一個明確的產品做判斷——多半因為你已經聽說 Tabbit 是擁有工作台級分頁體系的 AI 原生瀏覽器。
本頁刻意比 /best-ai-paper-reader 更窄:確認匹配度、講清取捨,並把你引導到官方下載,同時說明真實的限制(模型可用性依地區與政策而異)。
如果你的全部工作只是一個靜態 PDF、完全不碰網頁,極簡閱讀器或許夠用;如果你的工作是一個「工作階段」——PDF、網站、儲存庫、筆記交織——Tabbit 值得優先驗證。
閱讀循環
論文從不孤立存在:arXiv PDF、專案頁、GitHub 儲存庫、文件站。三個動作,一個工作階段——沒有匯出匯入的來回折騰。
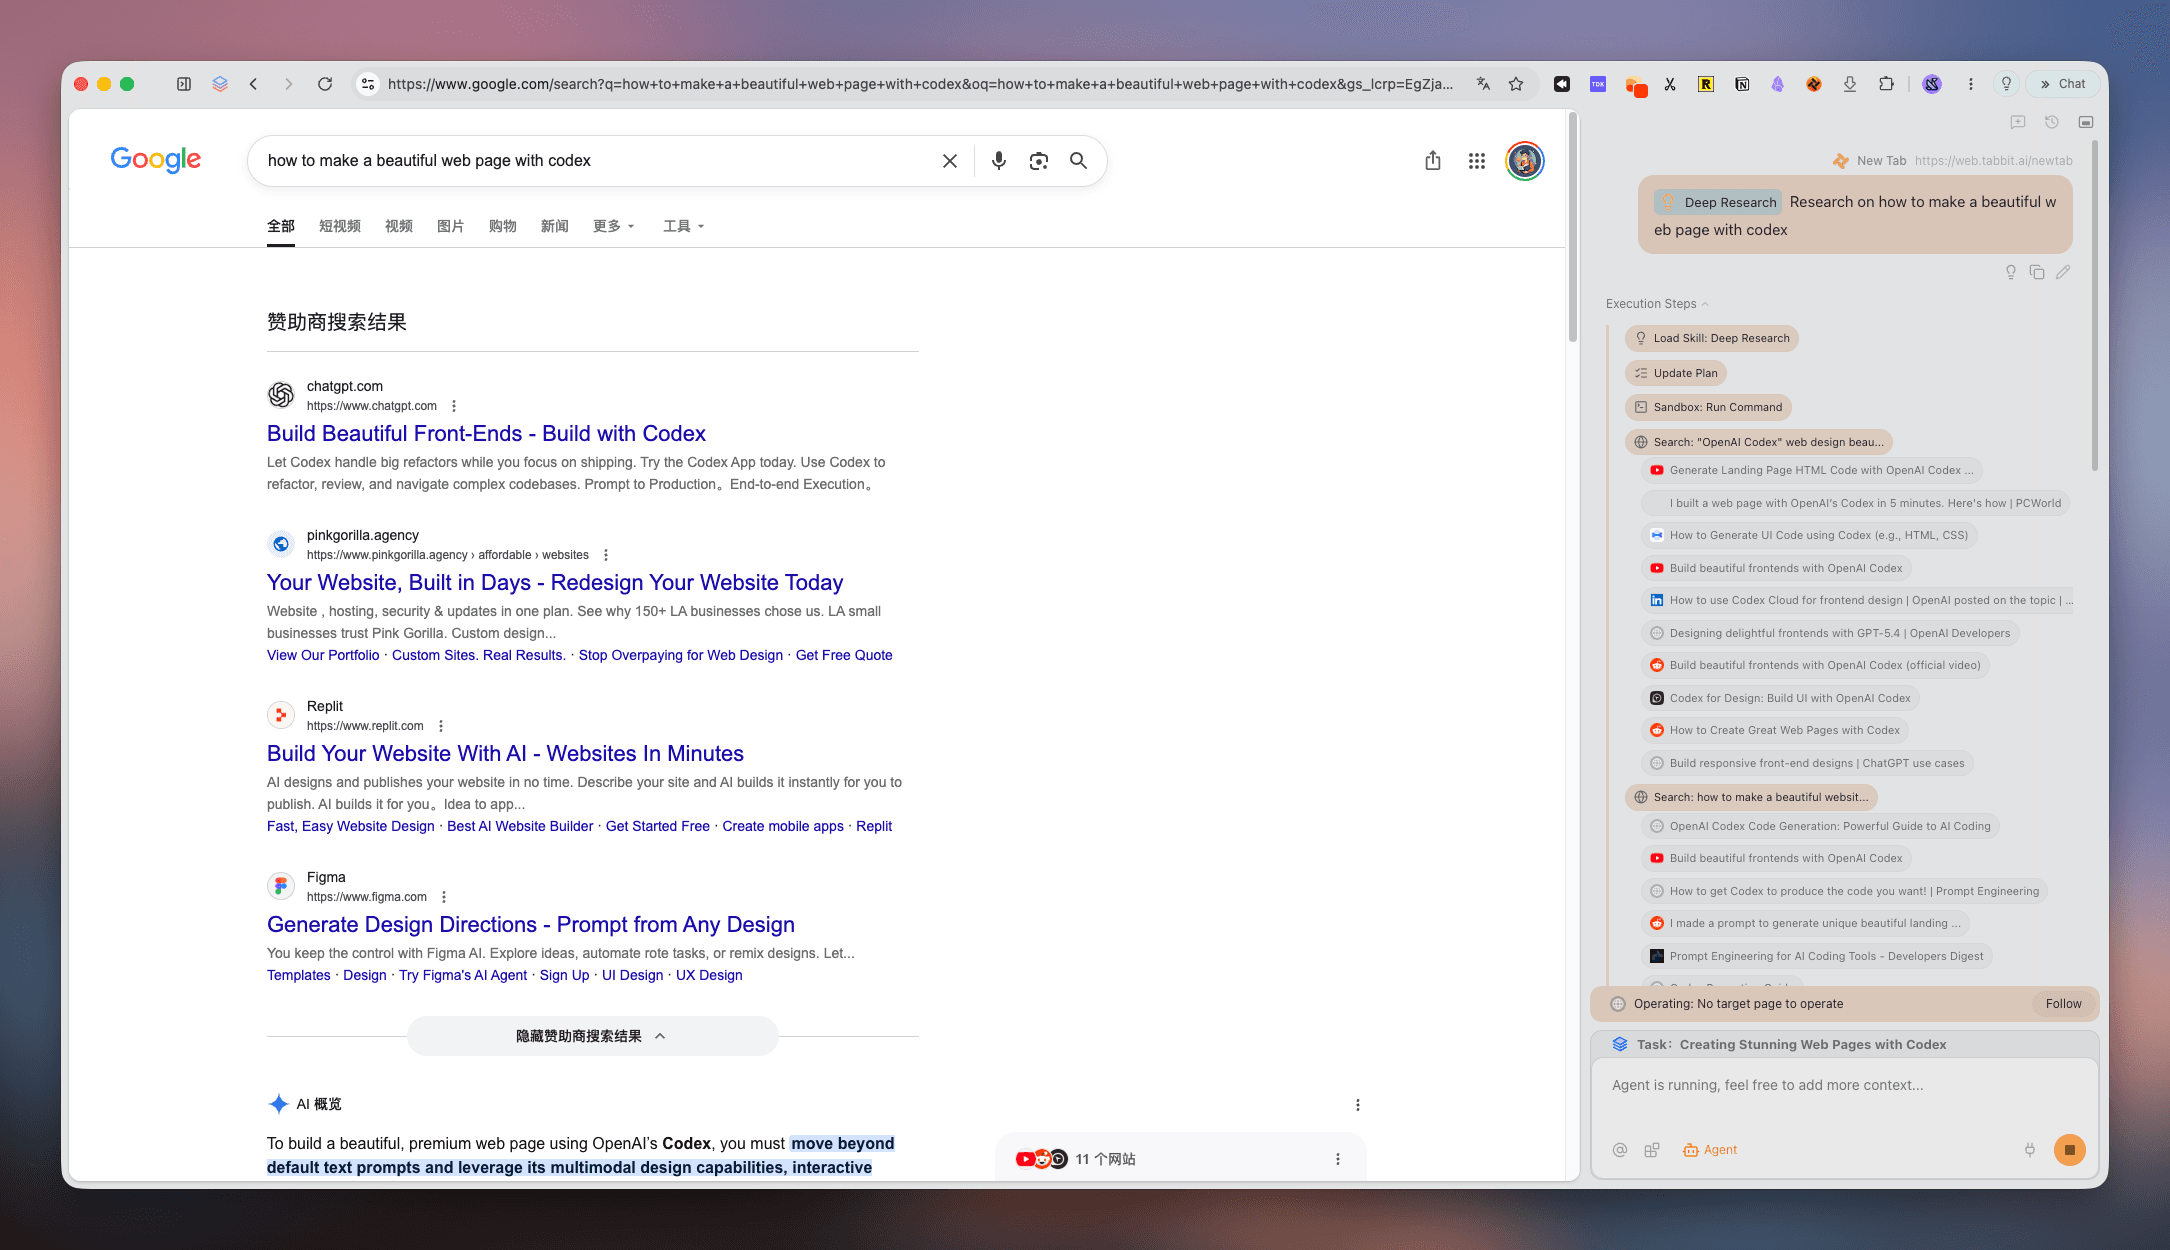
把 PDF 當作一等分頁,和引用它們的頁面並排開啟。輸入 @ 引用已開啟的分頁,或直接上傳檔案,讓每個問題都從你的真實來源出發——而不是面對空白輸入框。
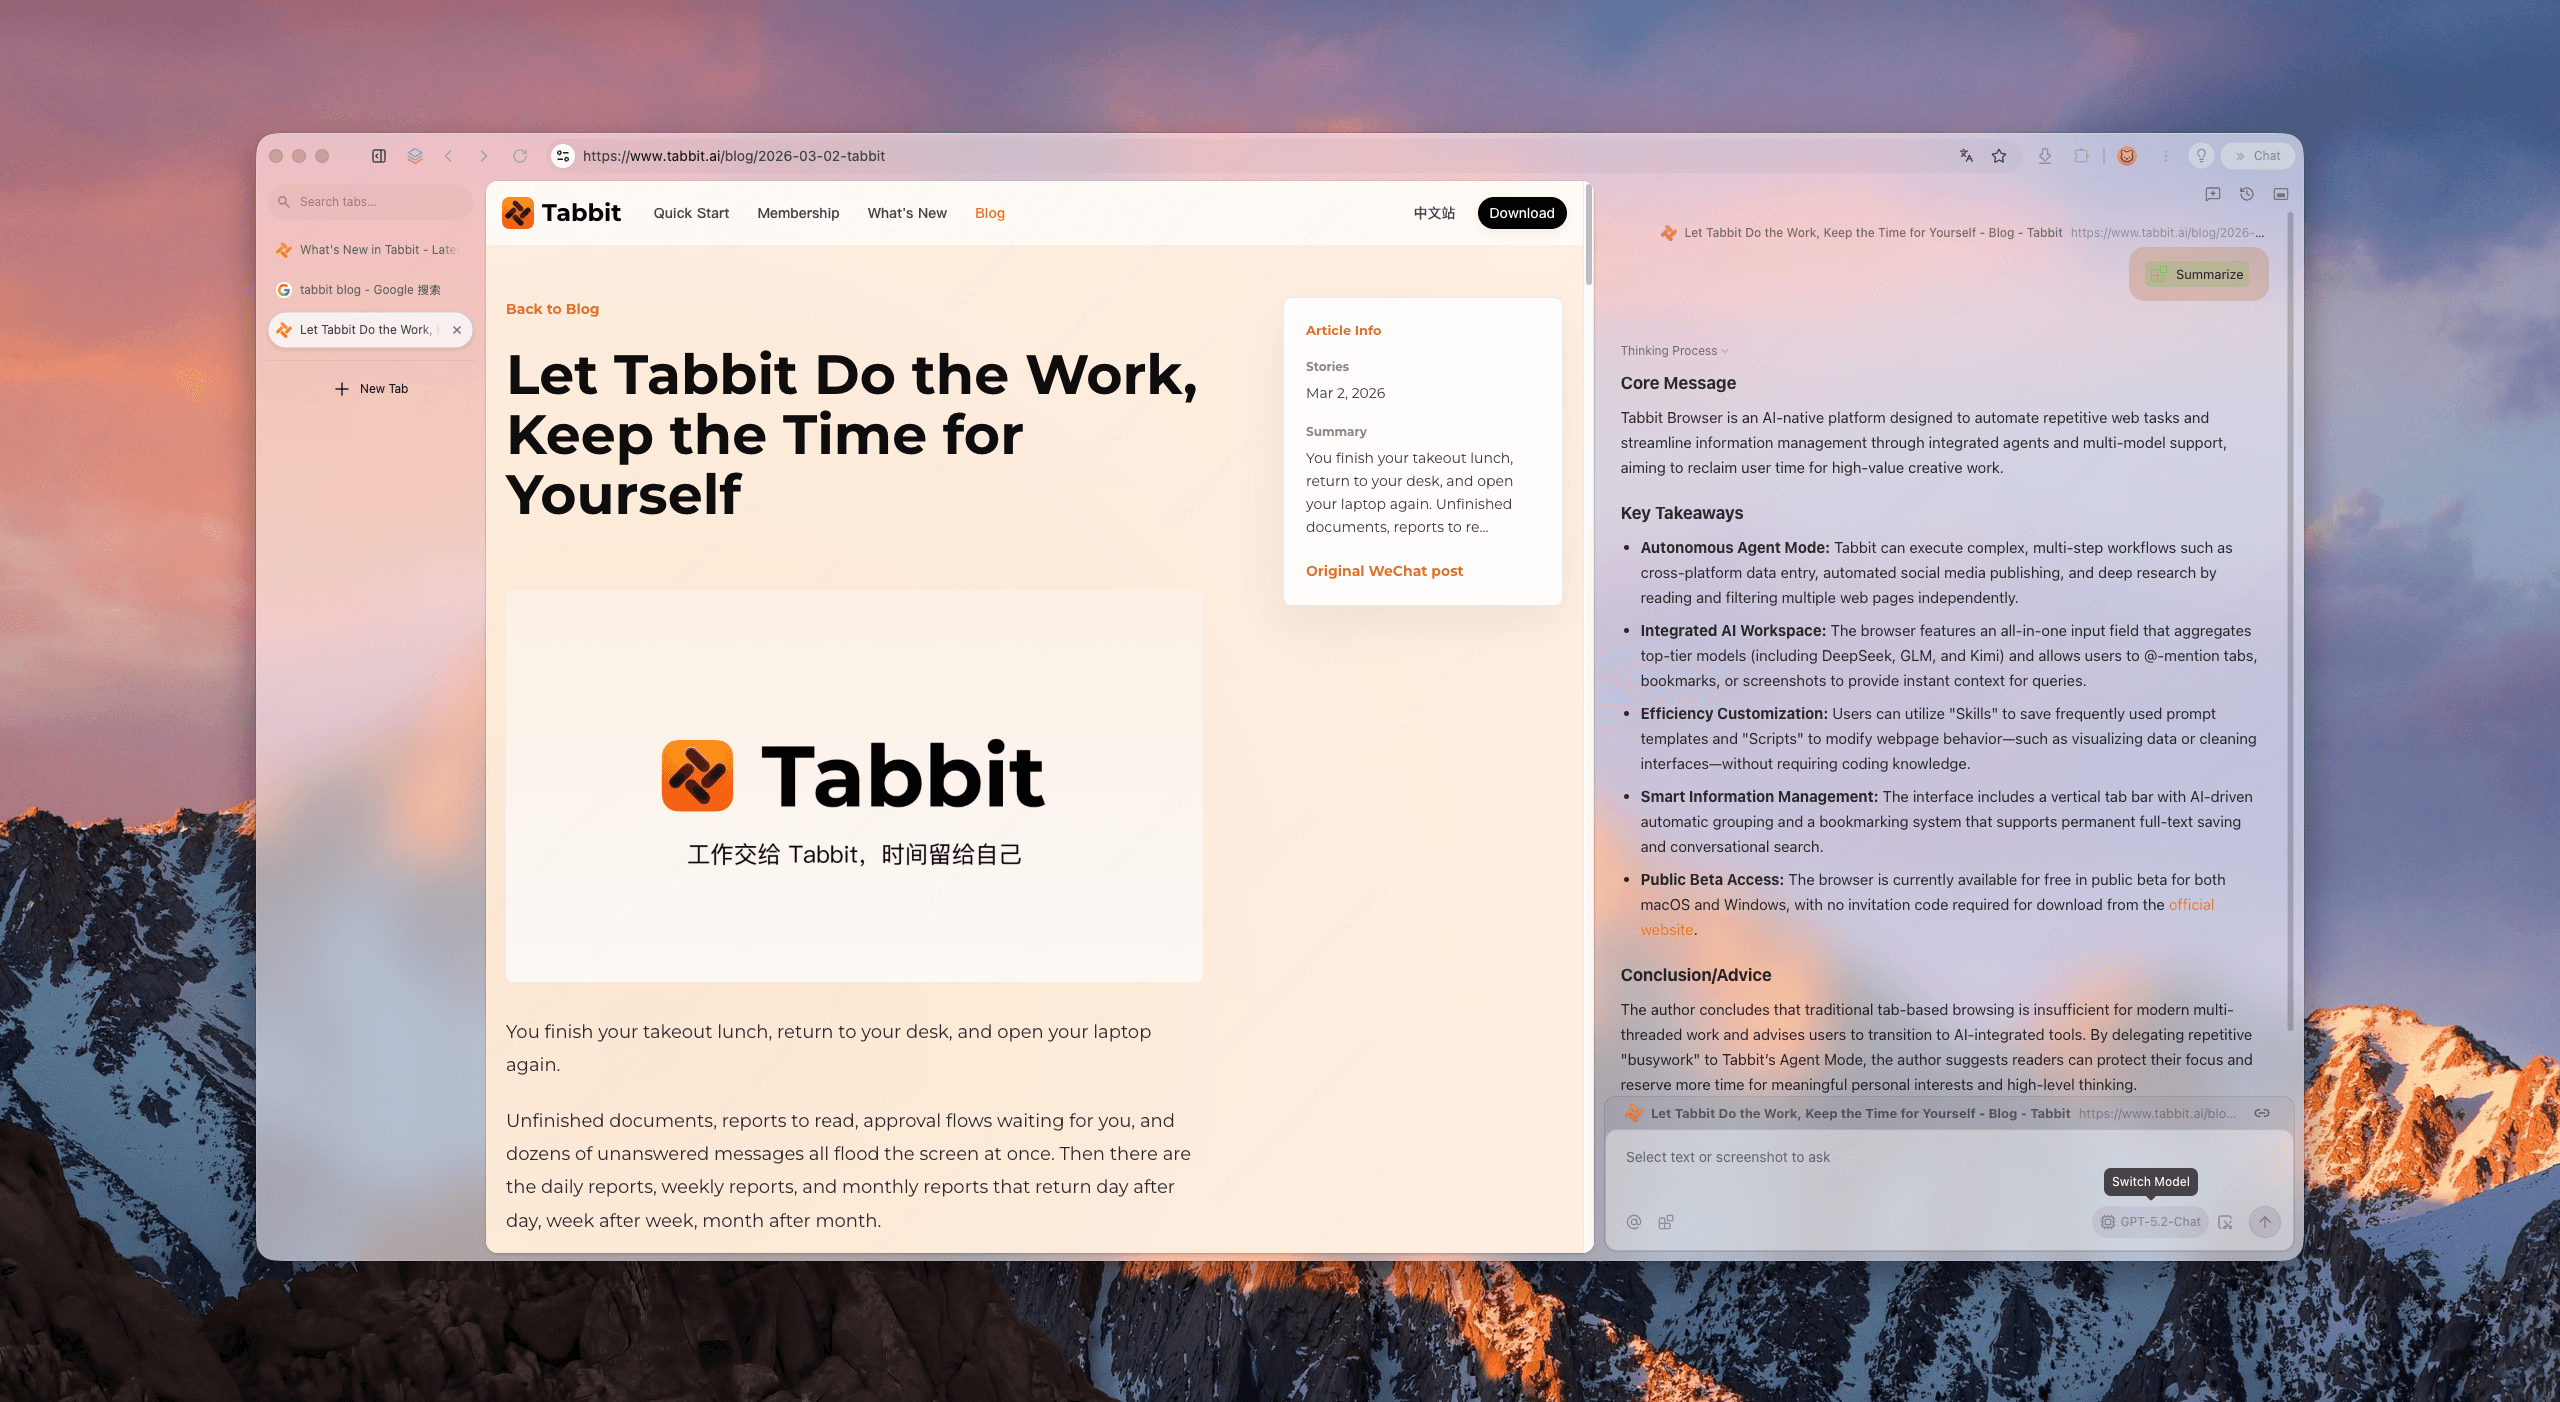
問一次,並排比較 GPT、Claude、Kimi、Qwen、GLM 等模型的回答。當模型對某個定理或圖表意見不一致時,你立刻知道該回 PDF 核對哪裡。
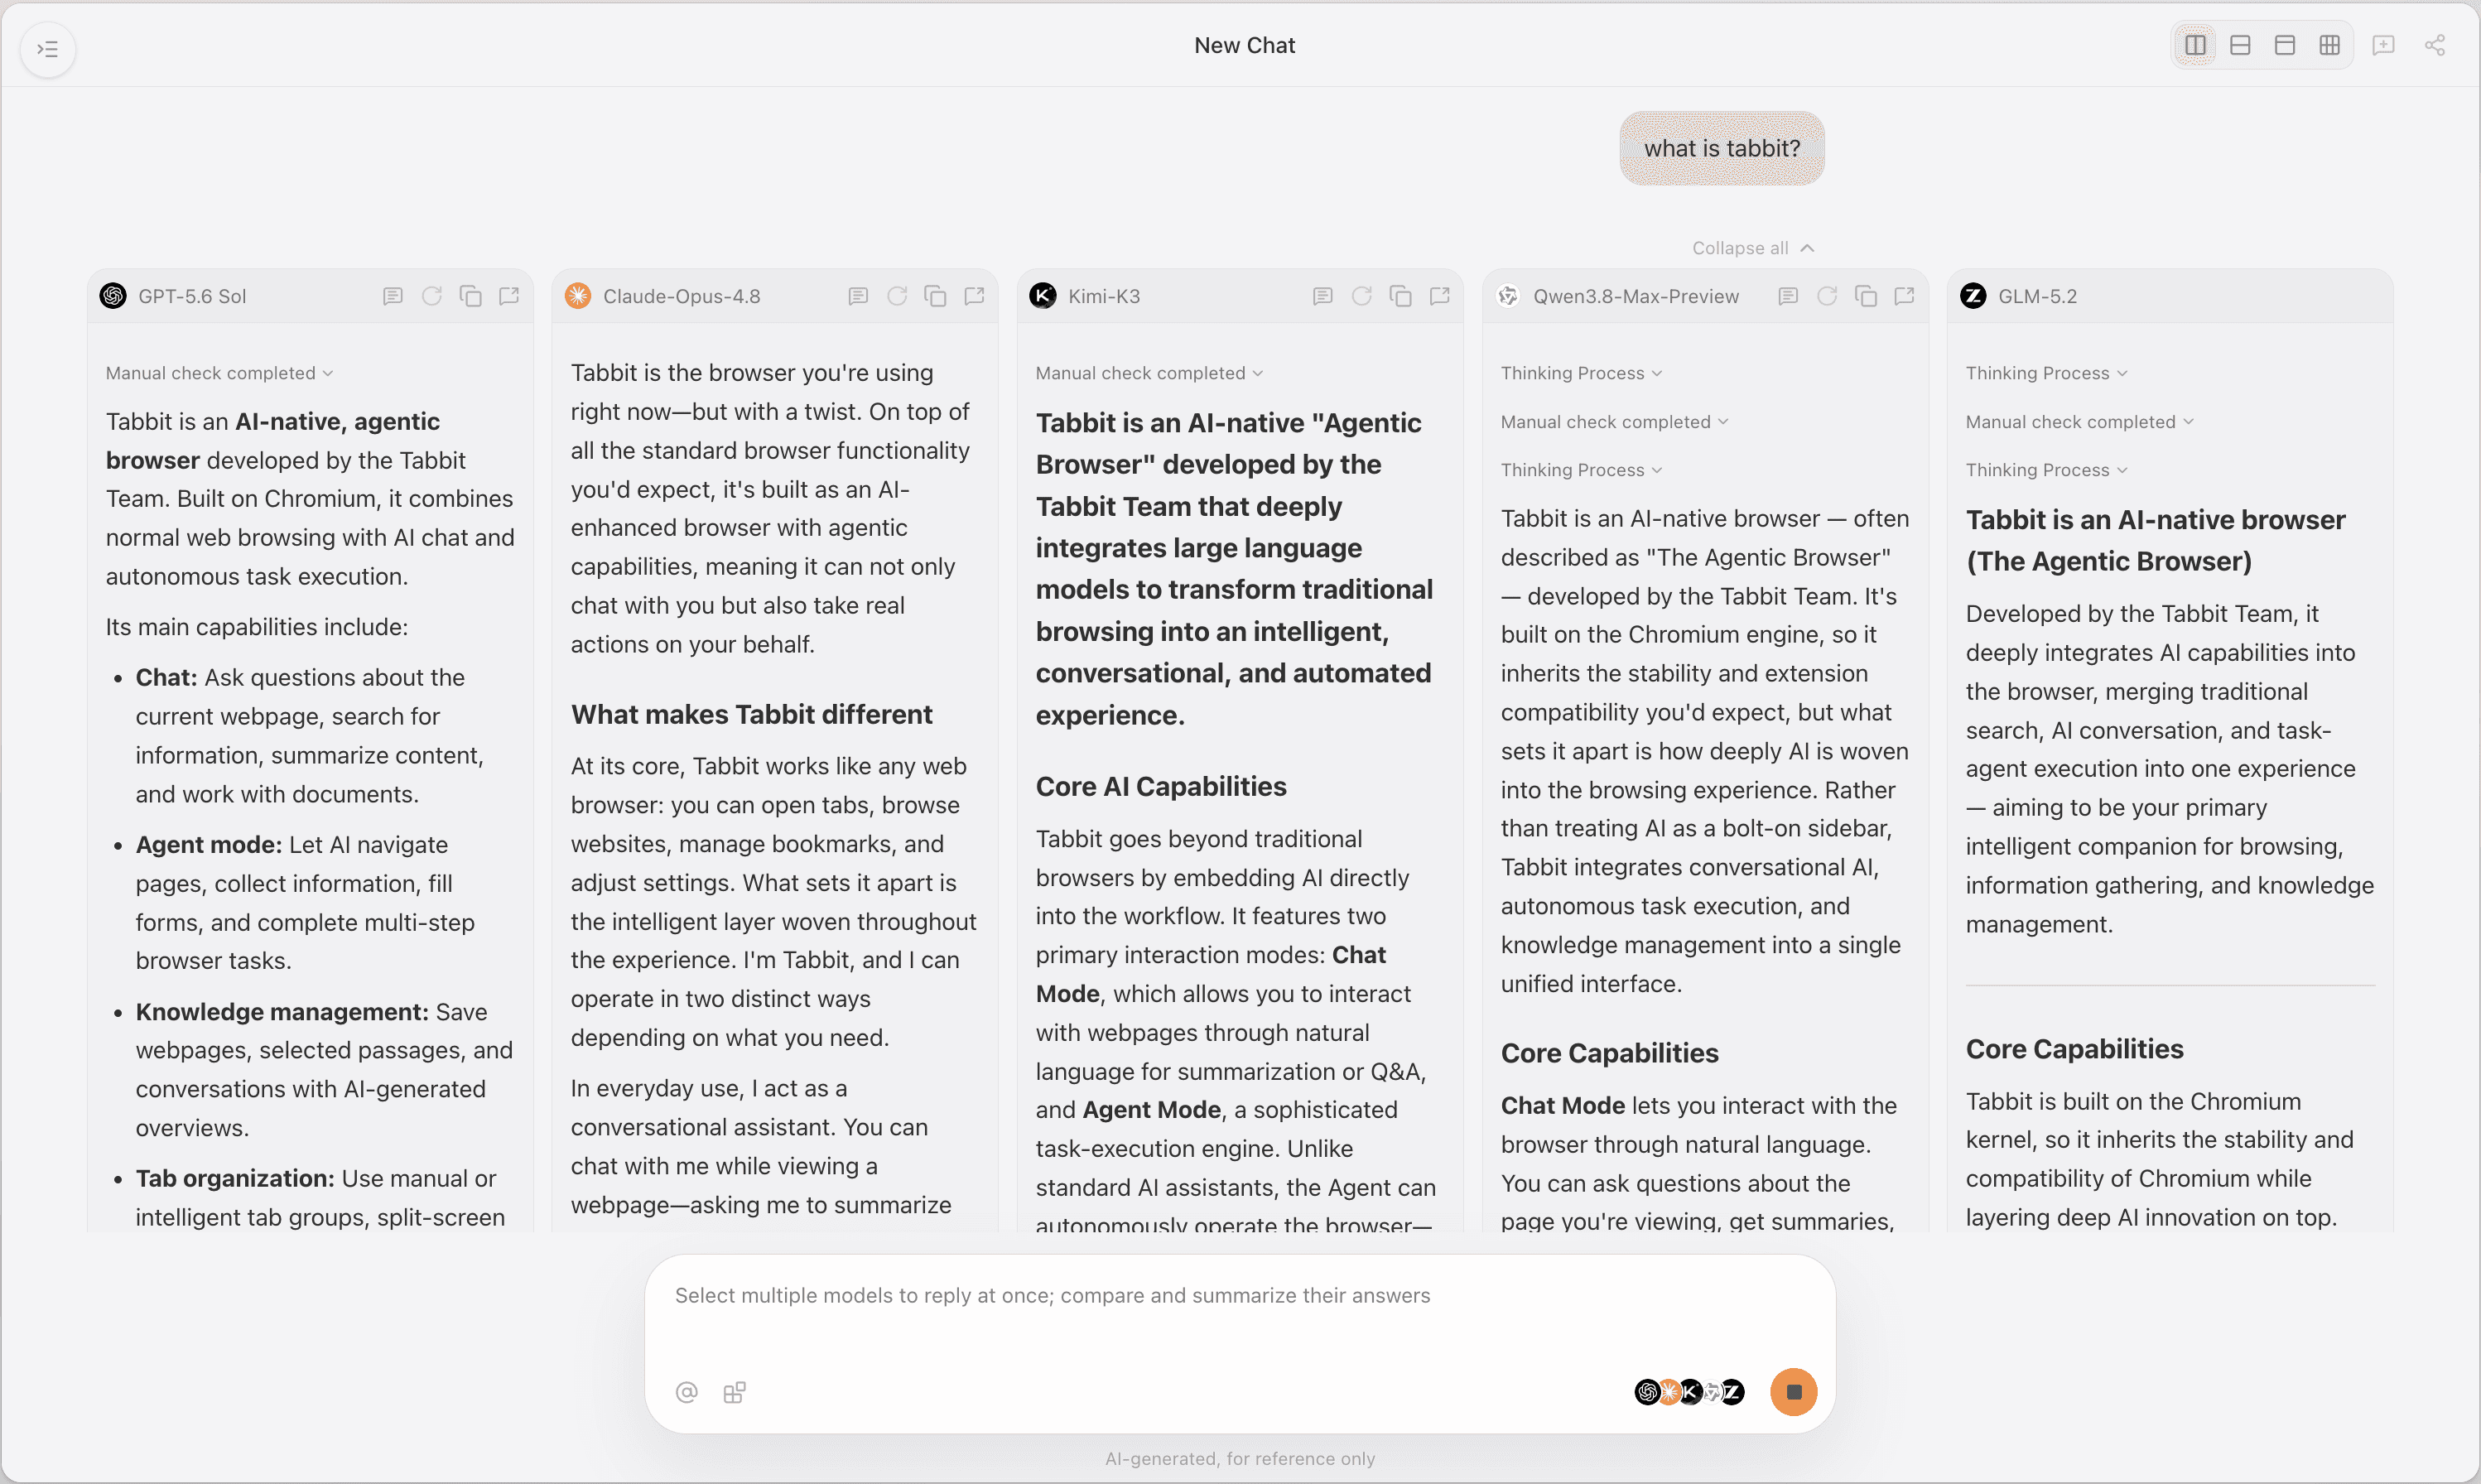
Deep Research 沿著 DOI 連結、專案頁和儲存庫一路追蹤,而你繼續讀原文。相關研究不再是情境切換,而是同一個故事的一部分。
決策矩陣
用這張表區分「PDF 小工具」和「瀏覽器級研究工作台」。如果你的瓶頸在工作階段設計而非字體渲染,請傾向右欄。
| 獨立 AI 閱讀器應用 | Tabbit(AI 原生瀏覽器) | |
|---|---|---|
| 主介面 | 廠商提供的 PDF 殼或上傳框。 | 完整瀏覽器:網址列、分頁與側欄 AI。 |
| 追引用 | 在多個應用間手動跳轉,心流被打斷。 | 沿 DOI、專案頁、儲存庫連結追蹤,不離開工作台。 |
| 組織方式 | 應用內的資料夾。 | 垂直分頁與群組,貼合長期研究線程。 |
| 合規與更新 | 你需要單獨稽核一個小眾工具。 | 資料策略仍由你負責,但安全性更新走瀏覽器級節奏。 |
誠實匹配核對
帶品牌詞的搜尋值得一個直接的回答,而不是形容詞堆砌。五個維度,不加行銷濾鏡。
論文很少孤立存在:arXiv PDF、專案頁、GitHub、文件站。
Tabbit 是瀏覽器:把 PDF 分頁、網站分頁和儲存庫放進同一個垂直分頁堆疊,避免切換應用導致的脈絡斷裂。
同一篇論文的不同部分,可能適合不同模型——或受不同政策約束。
在帳號與地區允許的範圍內使用 Tabbit 的多模型目錄;以產品內即時列表為準,警惕「一個模型通吃」的說法。
綜述與研究計畫申請往往要同時面對六到十二份材料。
垂直分頁與工作階段儲存貼近真實研究的展開方式——優於單窗格 PDF 小工具。
有時你需要的是即時網頁,而不只是 PDF 文字。
先把問題交給 Chat;確實需要跨分頁執行操作時,再在符合你所在組織合規要求的前提下升級到 Agent。
帶品牌詞的搜尋,應該落在可信的 TLS 官網——而不是來路不明的重新打包鏡像。
請依所在地區從 tabbit.ai 或 tabbit.com 下載 Tabbit。對所謂「無限額度」的第三方安裝包保持警惕。
常見問題
Tabbit 是 AI 原生瀏覽器。當論文、網站和儲存庫交錯出現時它更佔優勢——而這正是真實研究的常態。
那個頁面承接泛詞查詢;本頁假設你已經輸入了 Tabbit,需要的是品牌向的匹配核對和官方路徑。
不一定。引用圖譜仍交給文獻管理工具;Tabbit 負責瀏覽 + AI,與 PDF 和即時網頁同窗。
不能。模型可用性取決於目錄規則、地區和提供方——請在安裝後以模型選擇器內的即時列表為準。
公測條款與定價以各地區官網為準;請勿使用第三方鏡像安裝包。
會。把 AI 用於篩選和提問;任何結論在回論文核對之前都只當作假設。
下載頁列有官方 macOS 與 Windows 版本——在實驗室統一部署前請先確認。
可以繼續閱讀 /research-browser、/browser-for-researcher 和 /best-browser-for-research 等相鄰主題。
Tabbit
開啟官網,安裝你所在地區的版本,在下一次文獻回顧中跑通上面的循環。