把整摞资料放进同一个会话
把 PDF 当作一等标签,和引用它们的页面并排打开。输入 @ 引用已打开的标签页,或直接上传文件,让每个问题都从你的真实来源出发——而不是面对空白输入框。
 tabbit.
品牌核对 · AI 论文阅读
你在搜索时就带上了产品名——这很聪明。这里给你一份诚实的匹配核对:Tabbit 是 AI 原生浏览器,把 PDF、引用链路和 AI 对话放进同一个研究会话,而不是又一个单文件阅读器。
为什么这样搜
泛榜单是为截图优化的;而你是在为一个明确的产品做判断——多半因为你已经听说 Tabbit 是一个拥有工作台级标签体系的 AI 原生浏览器。
本页有意比 /best-ai-paper-reader 更窄:确认匹配度、讲清取舍,并把你引导到官方下载,同时说明真实的限制(模型可用性因地区与政策而异)。
如果你的全部工作只是一个静态 PDF、完全不碰网页,极简阅读器或许够用;如果你的工作是一个「会话」——PDF、网站、仓库、笔记交织——Tabbit 值得优先验证。
阅读循环
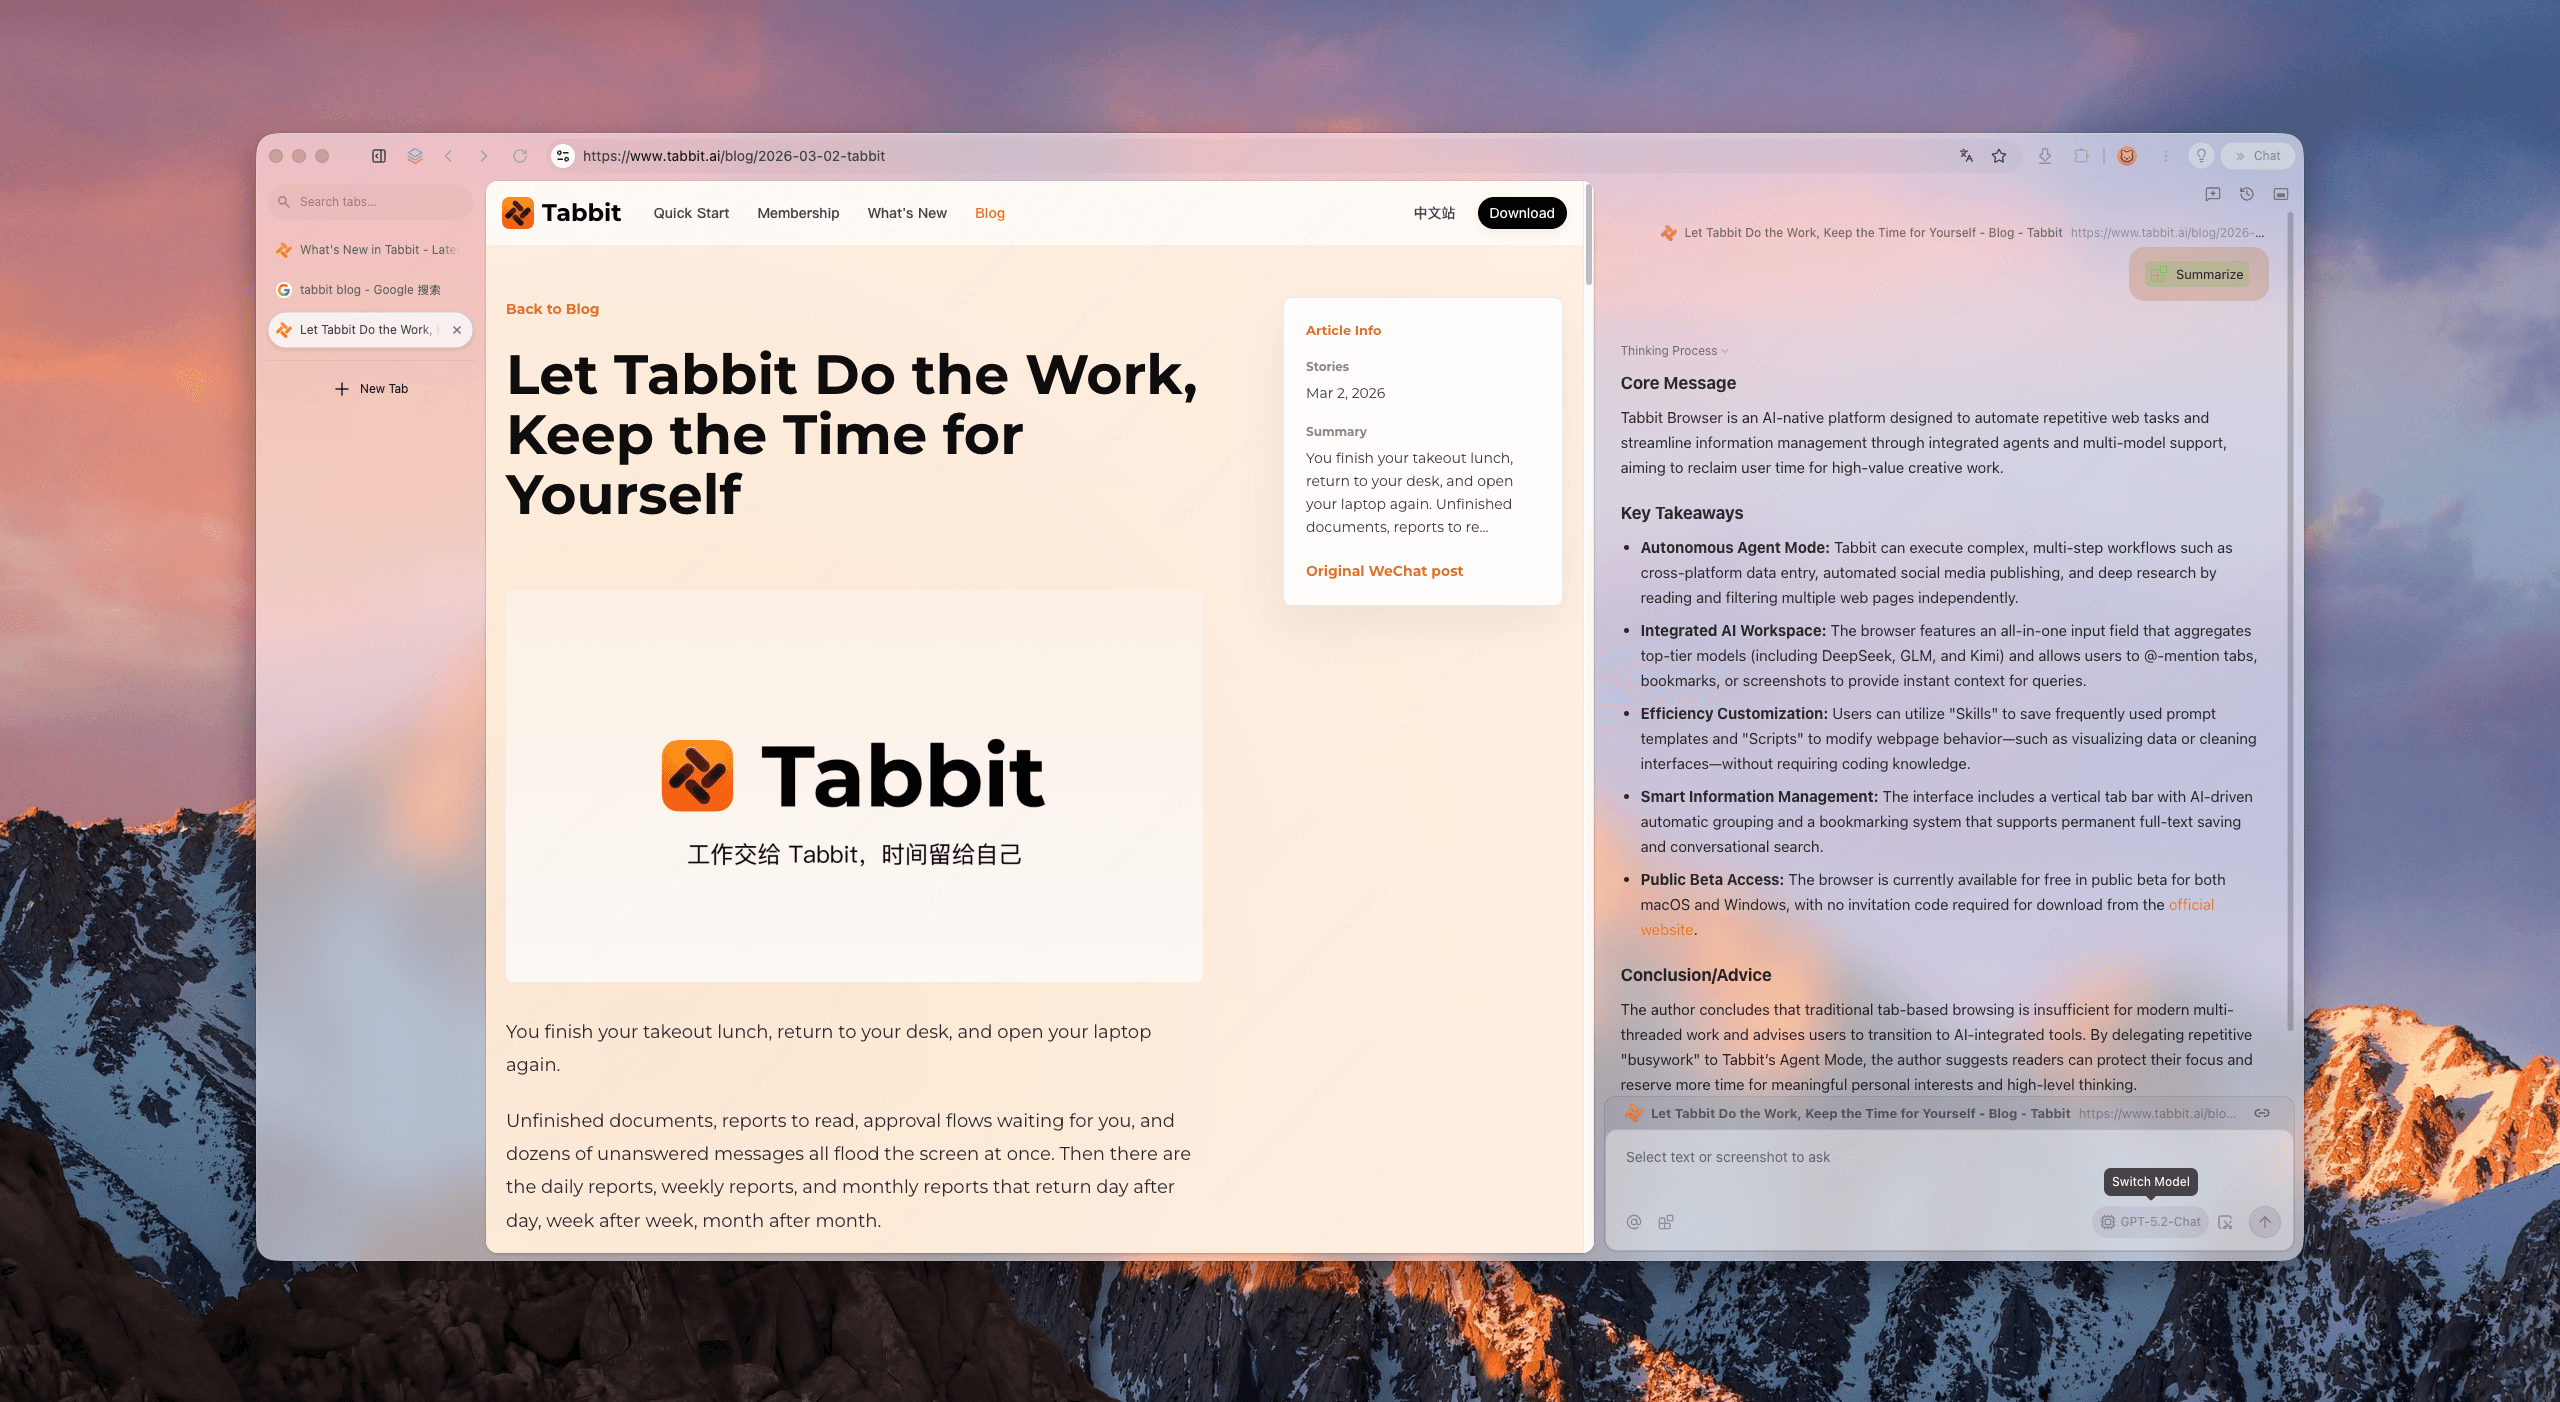
论文从不孤立存在:arXiv PDF、项目页、GitHub 仓库、文档站。三个动作,一个会话——没有导出导入的来回折腾。
把 PDF 当作一等标签,和引用它们的页面并排打开。输入 @ 引用已打开的标签页,或直接上传文件,让每个问题都从你的真实来源出发——而不是面对空白输入框。
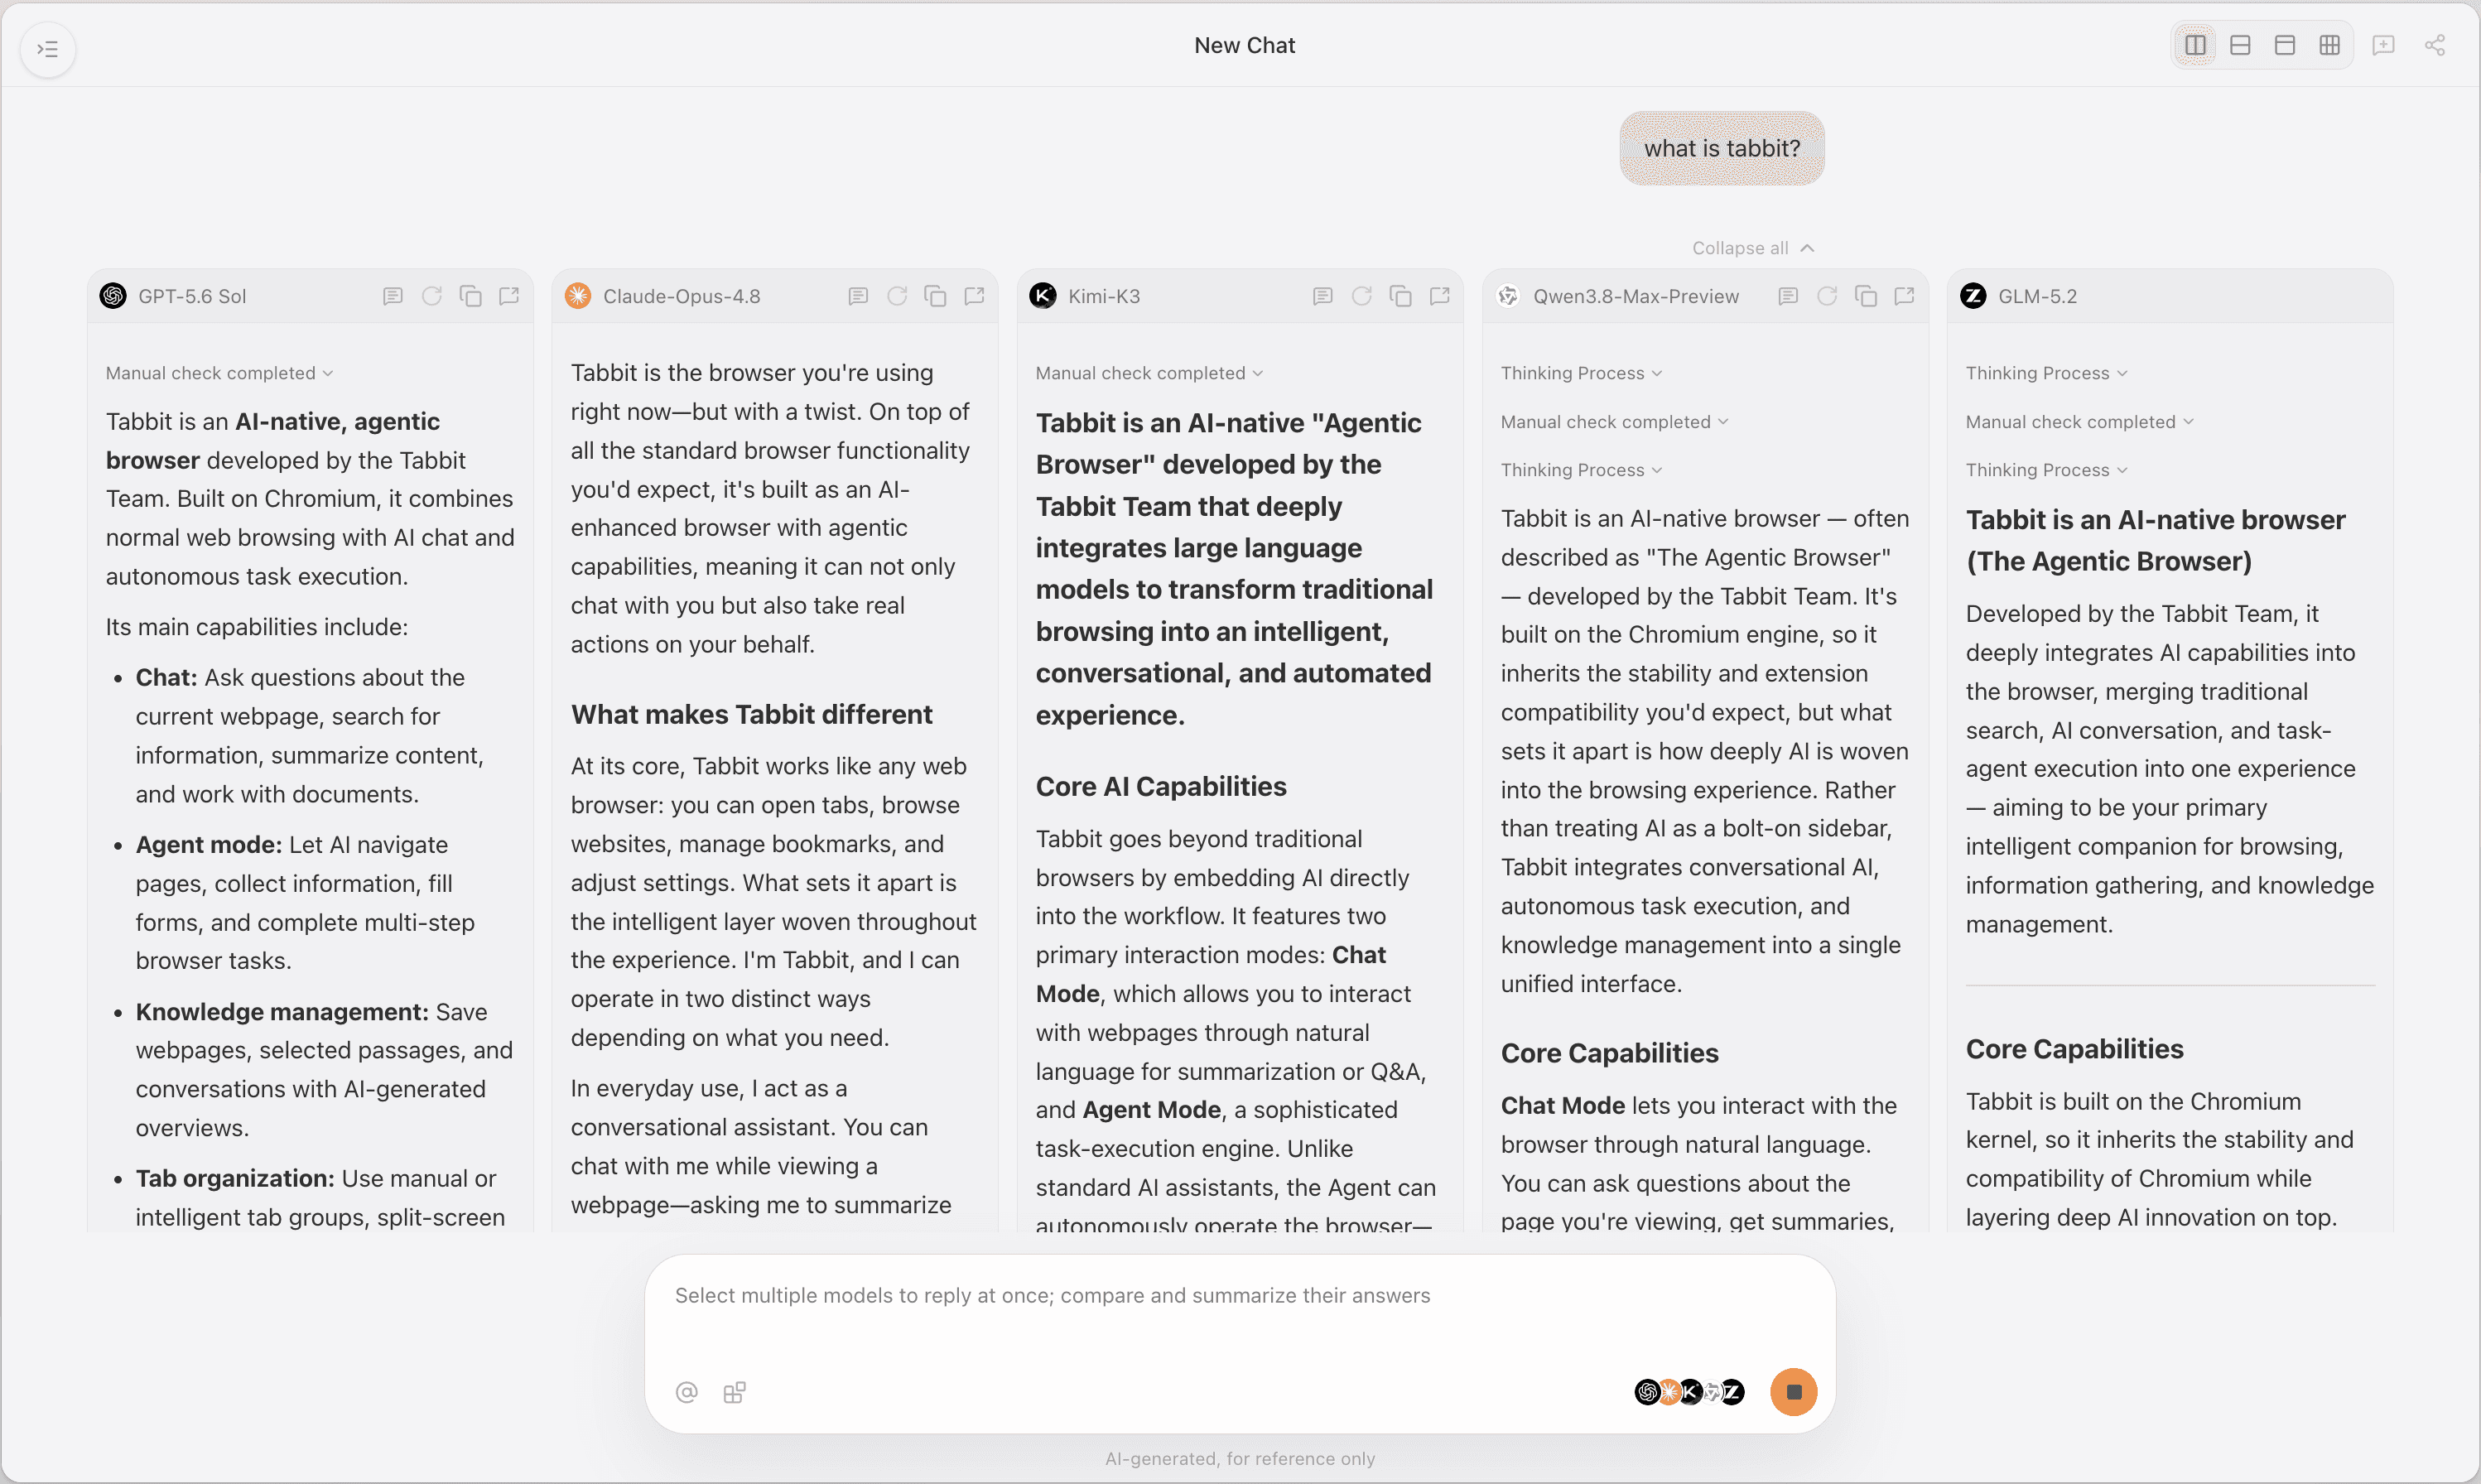
问一次,并排比较 GPT、Claude、Kimi、Qwen、GLM 等模型的回答。当模型对某个定理或图表意见不一致时,你立刻知道该回 PDF 核对哪里。
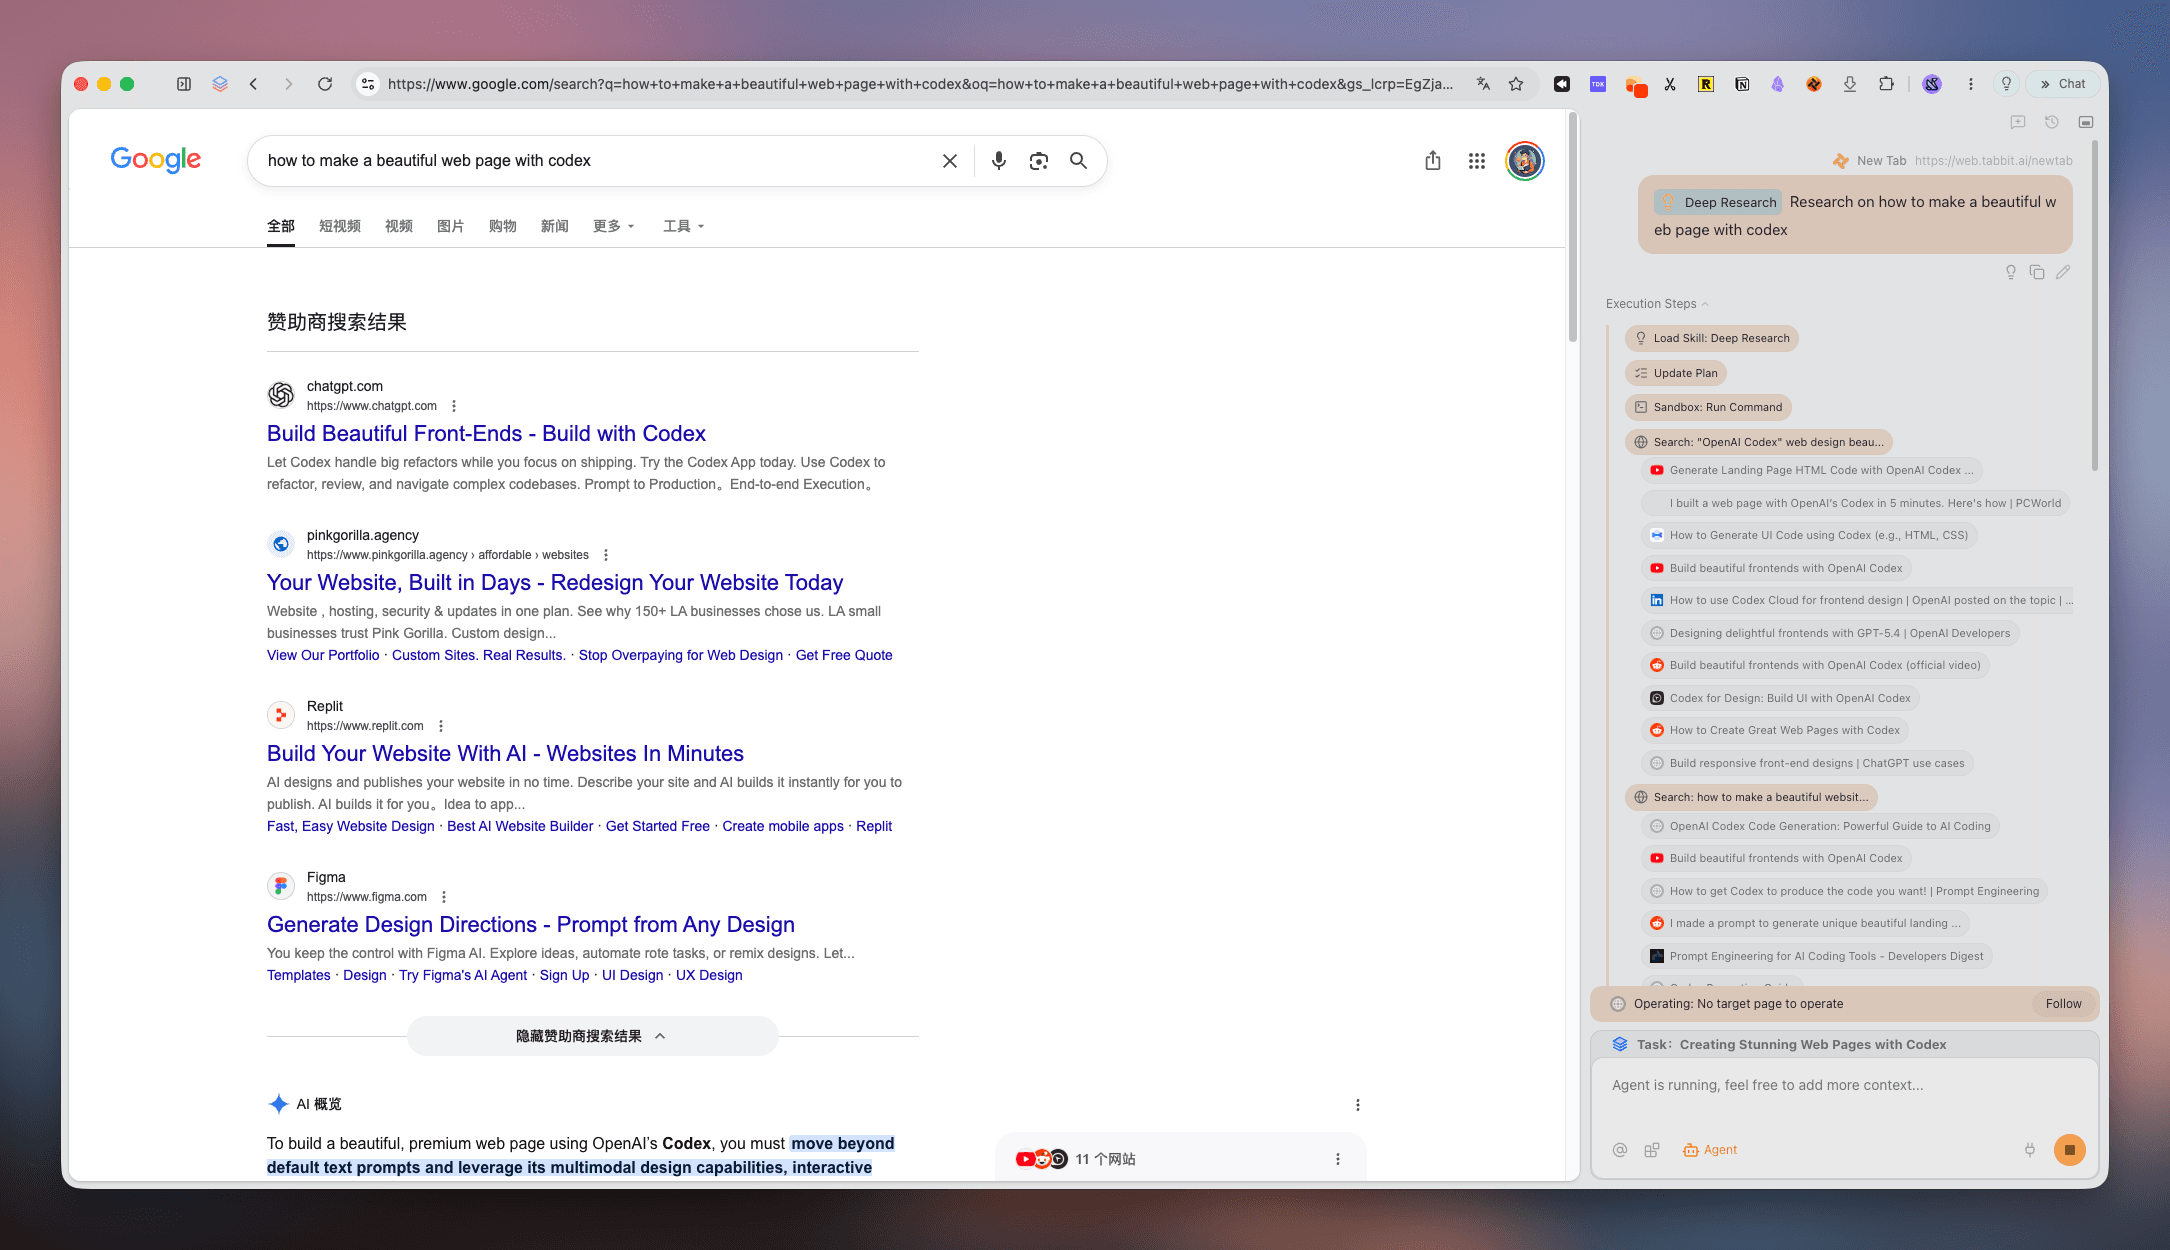
Deep Research 沿着 DOI 链接、项目页和仓库一路追踪,而你继续读原文。相关工作不再是上下文切换,而是同一个故事的一部分。
决策矩阵
用这张表区分「PDF 小工具」和「浏览器级研究工作台」。如果你的瓶颈在会话设计而非字体渲染,请倾向右列。
| 独立 AI 阅读器应用 | Tabbit(AI 原生浏览器) | |
|---|---|---|
| 主界面 | 厂商提供的 PDF 壳或上传框。 | 完整浏览器:地址栏、标签页与侧栏 AI。 |
| 追引用 | 在多个应用间手动跳转,心流被打断。 | 沿 DOI、项目页、仓库链接追踪,不离开工作台。 |
| 组织方式 | 应用内的文件夹。 | 垂直标签与分组,贴合长期研究线程。 |
| 合规与更新 | 你需要单独审计一个小众工具。 | 数据策略仍由你负责,但安全更新走浏览器级节奏。 |
诚实匹配核对
带品牌词的搜索值得一个直接的回答,而不是形容词堆砌。五个维度,不加营销滤镜。
论文很少孤立存在:arXiv PDF、项目页、GitHub、文档站。
Tabbit 是浏览器:把 PDF 标签、站点标签和仓库放进同一个垂直标签栈,避免切换应用导致的上下文断裂。
同一篇论文的不同部分,可能适合不同模型——或受不同策略约束。
在账号与地区允许的范围内使用 Tabbit 的多模型目录;以产品内实时列表为准,警惕「一个模型通吃」的话术。
综述与基金申请往往要同时面对六到十二份材料。
垂直标签与会话保存贴近真实研究的展开方式——优于单窗格 PDF 小工具。
有时你需要的是实时网页,而不只是 PDF 文本。
先把问题交给 Chat;确实需要跨标签执行操作时,再在符合你所在组织合规要求的前提下升级到 Agent。
带品牌词的搜索,应该落在可信的 TLS 官网——而不是来路不明的重打包镜像。
请按所在地区从 tabbit.ai 或 tabbit.com 下载 Tabbit。对所谓「无限额度」的第三方安装包保持警惕。
常见问题
Tabbit 是 AI 原生浏览器。当论文、网站和仓库交错出现时它更占优势——而这正是真实研究的常态。
那个页面承接泛词查询;本页假设你已经输入了 Tabbit,需要的是品牌向的匹配核对和官方路径。
不一定。引用图谱仍交给文献管理器;Tabbit 负责浏览 + AI,与 PDF 和实时网页同窗。
不能。模型可用性取决于目录规则、地区和提供方——请在安装后以模型选择器内的实时列表为准。
公测条款与定价以各地区官网为准;请勿使用第三方镜像安装包。
会。把 AI 用于筛选和提问;任何结论在回论文核对之前都只当作假设。
下载页列有官方 macOS 与 Windows 版本——在实验室统一部署前请先确认。
可以继续阅读 /research-browser、/browser-for-researcher 和 /best-browser-for-research 等相邻主题。
Tabbit
打开官网,安装你所在地区的版本,在下一次文献综述中跑通上面的循环。